Co to jest schemat split-plot?
Schemat split-plot (ang. split-plot design, plan z podzielonymi poletkami) to eksperyment czynnikowy z dwoma poziomami randomizacji. Poziomy czynnika trudnego do zmiany (A) losuje się dużym jednostkom – całym poletkom – a poziomy czynnika łatwego do zmiany (B) losuje się wewnątrz każdego poletka, na podpoletkach. Nazwa pochodzi z doświadczeń polowych; Kowalski i in. (2007) pokazują ten sam układ w eksperymentach przemysłowych: czynnik trudny lub drogi do zmiany ustawia się rzadko, co oszczędza koszty, lecz daje mniej informacji o jego efekcie. W badaniach społecznych odpowiednikiem jest metoda nauczania przydzielona klasom i warunek zadania losowany uczniom w klasie, a w badaniach z pomiarami powtarzanymi – ANOVA mieszana, w której osoba pełni rolę całego poletka.
Dwa człony błędu
W odróżnieniu od zwykłego schematu czynnikowego efekt A testuje się względem zmienności między nielicznymi całymi poletkami, a efekt B i interakcję A × B – względem mniejszej zmienności wewnątrz poletek. Dlatego B i A × B są szacowane precyzyjniej niż A. W analizie wariancji odpowiada temu model z warstwą błędu dla poletek, a w modelu wielopoziomowym – losowy efekt poletka. Jones i Nachtsheim (2009) przeglądają nowsze metody projektowania i analizy takich planów i podają wskazówki ich stosowania.
Przykład
Osiem całych poletek (dane symulowane) wylosowano po cztery do poziomów A, a każde podzielono na trzy podpoletka z poziomami B. W poprawnej analizie efekt A nie jest istotny, F(1, 6) = 3.03, p = .133, a efekt B jest, F(2, 12) = 8.34, p = .005. Analiza z jednym błędem daje odwrotny obraz: A „istotne” (F(1, 18) = 8.52, p = .009), B nie (p = .477).
Na rysunku
Rysunek pokazuje dane z przykładu (ten sam set.seed(662)). Przydział poletek 1, 3, 6 i 8 do poziomu a1 jest w kodzie ustalony ręcznie, a podpoletka mają stałą kolejność b1–b3. W prawdziwym badaniu oba przydziały się losuje.
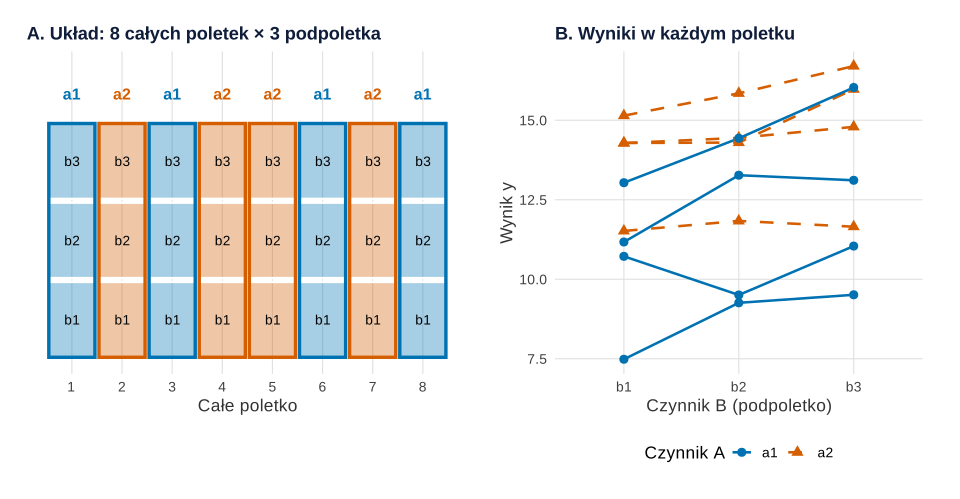
Co widać. Panel A pokazuje dwa poziomy losowania. Czynnik A dostaje całe poletko, a czynnik B – podpoletko w jego obrębie. W panelu B każda linia to jedno poletko. Średnie poletek a1 wahają się od 8.75 do 14.50, a poletek a2 od 11.67 do 15.90. Różnica średnich A (11.55 wobec 14.23) ginie w tym rozrzucie, a opiera się tylko na 4 i 4 poletkach. Stąd test A ma 6 stopni swobody błędu i p = .133. Czynnik B porównuje się wewnątrz linii. Różnica b3 − b1 jest dodatnia we wszystkich ośmiu poletkach (od 0.13 do 2.99), bo podpoletka tego samego poletka różnią się mało. Średni kwadrat błędu podpoletek, 0.47, jest ok. 30 razy mniejszy niż błędu całych poletek, 14.27.
Na co uważać. Na wykresie widać 24 punkty, ale dla czynnika A liczy się tylko 8 linii. Analiza, która traktuje punkty jak niezależne, to pseudoreplikacja. Wykres nie pokazuje też niepewności ani interakcji A × B w formie testu – nachylenia linii różnią się także przez sam błąd losowy. Jak model mieszany rozdziela zmienność między jednostkami i wewnątrz nich, pokazuje wpis Model mieszany w obrazkach.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu (średnie kwadraty błędów pochodzą z analizy w przykładzie). Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam, a dane losuje tym samym ziarnem co przykład. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Schemat split-plot: układ całych poletek i podpoletek (A) oraz wyniki w każdym poletku (B)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c(a1 = "#0072B2", a2 = "#D55E00")   # Okabe–Ito; poziom A niosą też etykiety, kształt punktu i typ linii

set.seed(662)                              # te same dane co w przykładzie
d <- expand.grid(B = factor(c("b1", "b2", "b3")), poletko = factor(1:8))
d$A <- factor(ifelse(as.integer(d$poletko) %in% c(1, 3, 6, 8), "a1", "a2"))
u <- rnorm(8, sd = 2)                                # błąd całych poletek
d$y <- 10 + 3 * (d$A == "a2") + c(0, 1, 2)[d$B] +
       u[d$poletko] + rnorm(nrow(d), sd = 1)         # błąd podpoletek

# Średnia każdego poletka i różnica b3 − b1 w jego obrębie
pol <- data.frame(poletko = 1:8, A = d$A[d$B == "b1"],
                  srednia = round(tapply(d$y, d$poletko, mean), 2),
                  b3_minus_b1 = round(d$y[d$B == "b3"] - d$y[d$B == "b1"], 2))
pol
round(tapply(pol$srednia, pol$A, mean), 2)          # średnie A: porównanie tylko 4 i 4 poletek

# A: każde całe poletko dostaje jeden poziom A, jego trzy podpoletka – poziomy B
pA <- ggplot(d, aes(x = as.integer(poletko), y = as.integer(B))) +
  geom_tile(aes(fill = A), colour = "white", linewidth = 0.8, alpha = 0.35, height = 0.95) +
  geom_tile(data = pol, aes(x = poletko, y = 2, colour = A), fill = NA, linewidth = 1.2,
            width = 0.92, height = 2.95, inherit.aes = FALSE) +
  geom_text(aes(label = B), size = 3.6) +
  geom_text(data = pol, aes(x = poletko, y = 3.85, label = A, colour = A), size = 4.2,
            fontface = "bold", inherit.aes = FALSE) +
  scale_fill_manual(values = kol, guide = "none") +
  scale_colour_manual(values = kol, guide = "none") +
  scale_x_continuous(breaks = 1:8) +
  scale_y_continuous(breaks = NULL, limits = c(0.5, 4.2)) +
  labs(title = "A. Układ: 8 całych poletek × 3 podpoletka", x = "Całe poletko", y = NULL) +
  motyw

# B: linie łączą trzy podpoletka tego samego poletka
pB <- ggplot(d, aes(B, y, group = poletko, colour = A, linetype = A, shape = A)) +
  geom_line(linewidth = 0.9) +
  geom_point(size = 2.8) +
  scale_colour_manual(values = kol, name = "Czynnik A") +
  scale_linetype_manual(values = c(a1 = "solid", a2 = "dashed"), name = "Czynnik A") +
  scale_shape_manual(values = c(a1 = 16, a2 = 17), name = "Czynnik A") +
  labs(title = "B. Wyniki w każdym poletku", x = "Czynnik B (podpoletko)", y = "Wynik y") +
  motyw
p1 <- pA + pB + plot_layout(widths = c(1.2, 1))
p1   # zapis: ggsave("schemat-split-plot-uklad.svg", p1, width = 10, height = 5)
Wynik w R
  poletko  A srednia b3_minus_b1
1       1 a1   12.52        1.94
2       2 a2   15.90        1.56
3       3 a1   10.42        0.32
4       4 a2   14.85        1.69
5       5 a2   14.51        0.51
6       6 a1   14.50        2.99
7       7 a2   11.67        0.13
8       8 a1    8.75        2.03
   a1    a2
11.55 14.23
Jak opisać w pracy
Na co uważać
- Analiza jak dla planu w pełni losowego. Podpoletka traktowane jako niezależne powtórzenia A to pseudoreplikacja.
- Mało całych poletek. Moc testu A zależy od ich liczby, nie od liczby pomiarów.
- Mylenie z blokami. W randomizacji blokowej wszystkie warunki występują w każdym bloku; tu całe poletko dostaje jeden poziom A. Poletka są zagnieżdżone w A – zob. czynniki zagnieżdżone i skrzyżowane.
Schemat split-plot w R
Kod symuluje plan z ośmioma całymi poletkami i trzema podpoletkami w każdym, a potem porównuje analizę z dwoma członami błędu (aov z Error() i lme4::lmer) z błędną analizą z jednym członem błędu.
Dwa człony błędu a jeden
R
# Schemat split-plot: czynnik A na całych poletkach, czynnik B na podpoletkach
set.seed(662)
d <- expand.grid(B = factor(c("b1", "b2", "b3")), poletko = factor(1:8))
d$A <- factor(ifelse(as.integer(d$poletko) %in% c(1, 3, 6, 8), "a1", "a2"))
u <- rnorm(8, sd = 2)                                # błąd całych poletek
d$y <- 10 + 3 * (d$A == "a2") + c(0, 1, 2)[d$B] +
       u[d$poletko] + rnorm(nrow(d), sd = 1)         # błąd podpoletek
# Poprawnie: dwa człony błędu (całe poletka i podpoletka)
summary(aov(y ~ A * B + Error(poletko), data = d))
# Błędnie: jeden człon błędu, jakby każdy pomiar był niezależny
summary(aov(y ~ A * B, data = d))
# To samo w modelu mieszanym
suppressPackageStartupMessages(library(lme4))
m <- lmer(y ~ A * B + (1 | poletko), data = d)
anova(m)
Wynik w R
Error: poletko
          Df Sum Sq Mean Sq F value Pr(>F)
A          1  43.21   43.21   3.027  0.133
Residuals  6  85.64   14.27

Error: Within
          Df Sum Sq Mean Sq F value  Pr(>F)
B          2  7.818   3.909   8.345 0.00535 **
A:B        2  0.832   0.416   0.889 0.43668
Residuals 12  5.621   0.468
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Df Sum Sq Mean Sq F value  Pr(>F)
A            1  43.21   43.21   8.522 0.00916 **
B            2   7.82    3.91   0.771 0.47726
A:B          2   0.83    0.42   0.082 0.92154
Residuals   18  91.27    5.07
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Analysis of Variance Table
    npar Sum Sq Mean Sq F value
A      1 1.4180  1.4180  3.0272
B      2 7.8179  3.9089  8.3449
A:B    2 0.8324  0.4162  0.8885
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lme4. Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym schemat split-plot różni się od zwykłego schematu czynnikowego?
W zwykłym schemacie każda kombinacja poziomów jest losowana jednostkom niezależnie. W split-plot jeden czynnik losuje się całym poletkom, a drugi podpoletkom, więc efekty mają różne człony błędu i różną precyzję.
Czy ANOVA mieszana to schemat split-plot?
Tak, formalnie to ten sam układ: osoba jest całym poletkiem, czynnik międzyobiektowy działa na poziomie osób, a pomiary powtarzane – na poziomie podpoletek. Stąd angielska nazwa split-plot ANOVA.
Jak policzyć schemat split-plot w R?
Użyj aov z członem Error(poletko) albo modelu mieszanego lme4::lmer z losowym efektem poletka. Kod na tej stronie pokazuje obie wersje i porównuje je z błędną analizą z jednym członem błędu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w pracy z rolnictwa, zootechniki i weterynarii
Poletka w blokach, krzywa plonu, kojec jako jednostka, ważenia w modelu mieszanym, dokumentacja stada i ankiety: analizy, zdania APA i kod R.
Czytaj →PoradnikANOVA mieszana krok po kroku
Sferyczność, test M Boxa, interakcja grupa × czas, efekty proste w emmeans i wzór opisu APA – na przykładzie trzech grup i trzech pomiarów.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Jones, B., & Nachtsheim, C. J. (2009). Split-plot designs: What, why, and how. Journal of Quality Technology, 41(4), 340–361. https://doi.org/10.1080/00224065.2009.11917790
- Kowalski, S. M., Parker, P. A., & Vining, G. G. (2007). Tutorial: Industrial split-plot experiments. Quality Engineering, 19(1), 1–15. https://doi.org/10.1080/08982110601057179
Cytowania BibTeX
@article{jones2009split, author={Jones, Bradley and Nachtsheim, Christopher J.}, title={{Split-plot designs: What, why, and how}}, journal={Journal of Quality Technology}, year={2009}, volume={41}, number={4}, pages={340--361}, doi={10.1080/00224065.2009.11917790}}@article{kowalski2007tutorial, author={Kowalski, Scott M. and Parker, Peter A. and Vining, G. Geoffrey}, title={{Tutorial: Industrial split-plot experiments}}, journal={Quality Engineering}, year={2007}, volume={19}, number={1}, pages={1--15}, doi={10.1080/08982110601057179}}