Sześć typowych projektów w pracy z rolnictwa, zootechniki i weterynarii
Prace dyplomowe z rolnictwa, zootechniki i weterynarii łączą dwa światy danych. Pierwszy to doświadczenia z przydziałem losowym: odmiany i nawożenie na poletkach, diety w kojcach, dodatki paszowe w grupach zwierząt. Drugi to dane obserwacyjne: dokumentacja stada lub lecznicy i ankiety wśród rolników, hodowców albo właścicieli zwierząt. W obu światach najważniejsza decyzja zapada przed wyborem testu – trzeba ustalić, co jest jednostką, której przydzielono warunek albo której dotyczy pytanie. Tabela porządkuje sześć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Jednostka eksperymentalna lub analizy | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Doświadczenie polowe w blokach | Czy cztery odmiany różnią się plonem? | poletko (blok = grupa poletek) | ANOVA dla układu bloków losowanych, test Tukeya; split-plot – dwa człony błędu | ω²p, różnice średnich z 95% CI |
| 2. Plon a dawka nawozu | Przy jakiej dawce azotu plon przestaje rosnąć? | poletko | regresja kwadratowa i kwadratowa z plateau, test braku dopasowania | dawka maksymalna z 95% CI, przyrost plonu |
| 3. Żywienie w kojcach | Czy dodatek paszowy zwiększa dzienne przyrosty? | kojec, nie zwierzę | test t lub ANCOVA na średnich kojców | różnica w g/dzień z 95% CI |
| 4. Przyrosty w powtarzanych ważeniach | Jak dieta zmienia tempo wzrostu? | kojec; ważenia zagnieżdżone w zwierzętach | model mieszany z masą początkową jako kowariantem | różnica nachyleń (g/dzień) z 95% CI |
| 5. Dokumentacja stada lub lecznicy | Czy kulawizny częściej dotyczą krów w starszych laktacjach? | zwierzę w stadzie; cechy stada – stado | regresja logistyczna z losowym efektem stada (GLMM) | iloraz szans (OR) z 95% CI |
| 6. Ankieta wśród rolników i hodowców | Czy postawy wobec dobrostanu zależą od wielkości gospodarstwa? | gospodarstwo (jedna ankieta na gospodarstwo) | α Cronbacha, test Kruskala–Wallisa, przedział dla proporcji, χ² | ε², V Craméra |
Wszystkie dane w przykładach są fikcyjne (symulowane), a liczby nie opisują żadnych rzeczywistych gospodarstw, zwierząt ani odmian. Wpis nie zawiera zaleceń nawozowych, żywieniowych ani weterynaryjnych – pokazuje wyłącznie, jak zaplanować i opisać analizę. Jeśli porównujesz stanowiska, liczebność organizmów w pułapkach albo różnorodność gatunkową, zajrzyj do poradnika statystyka w pracy z biologii i ochrony środowiska – tamtych tematów tu nie powtarzamy. Wybór testu do hipotezy ułatwi kreator doboru testu, a całą drogę od pytania do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: poletko, kojec, zwierzę czy stado?
W naukach rolniczych i weterynaryjnych ten sam pomiar może pochodzić z bardzo różnych układów. Waga prosięcia może być wynikiem doświadczenia, w którym dietę losowano każdemu zwierzęciu osobno, albo takiego, w którym dietę dostaje cały kojec. Liczba pomiarów jest w obu przypadkach taka sama, ale liczba niezależnych powtórzeń – zupełnie inna. Lazic, Clarke-Williams i Munafò (2018) proponują rozróżniać trzy rodzaje jednostek: biologiczną (o czym chcesz wnioskować), eksperymentalną (czemu przydzielono warunek) i obserwacyjną (na czym wykonano pomiar). W przejrzanej przez nich losowej próbie doświadczeń na zwierzętach, w których interwencję stosowano u rodziców, a skutki badano u potomstwa, tylko 22% badań powtarzało właściwą jednostkę, a około 46% miało pseudoreplikację.
| Układ | Komu przydzielono warunek | Na czym mierzysz | Co jest liczebnością n dla testu warunku |
|---|---|---|---|
| Odmiany na poletkach w blokach | poletku | poletko (czasem kilka próbek z poletka) | liczba poletek z daną odmianą |
| Split-plot: uprawa na całych poletkach, odmiany na podpoletkach | uprawa – całemu poletku, odmiana – podpoletku | podpoletko | dla uprawy: liczba całych poletek; dla odmiany: liczba podpoletek |
| Dieta podawana do wspólnego karmidła | kojcowi | zwierzę (masa, przyrost) | liczba kojców |
| Dodatek podawany każdemu zwierzęciu osobno, zwierzęta w kojcach | zwierzęciu | zwierzę | liczba zwierząt, ale kojec wchodzi do modelu jako efekt losowy |
| Ten sam lek lub zabieg na dwóch kończynach albo w kilku ćwiartkach wymienia | części ciała | część ciała | liczba części ciała, z efektem zwierzęcia w modelu |
| Cecha stada (system utrzymania, typ legowiska) | nikomu – to dane obserwacyjne | zwierzę | dla cechy stada: liczba stad |
Pytania kontrolne są te same co w każdej dziedzinie, ale tu łatwo je przeoczyć, bo zwierzę „wygląda” na naturalną jednostkę. Kto losował dietę – zwierzęta czy kojce? Czy zwierzęta w kojcu jedzą z jednego karmidła, konkurują o paszę, dzielą mikroklimat? Czy poletka z tą samą odmianą leżą obok siebie? Festing i Altman (2002) w wytycznych dla doświadczeń na zwierzętach laboratoryjnych omawiają m.in. jednostkę eksperymentalną, przydział losowy i formalne układy doświadczeń (np. bloki losowane), a liczbę zwierząt każą planować z analizy mocy – tak, by nie użyć ich ani za dużo, ani za mało. Bello i in. (2016) wrócili do tego tematu w naukach o mleczarstwie, w dyskusji o tym, jak publikować badania, w których dietę przydzielano kojcom – i pokazali, że od właściwej jednostki zależą wnioski statystyczne.
Zgody i liczba zwierząt – tylko ogólnie
Doświadczenie, w którym zmieniasz warunki utrzymania lub żywienia zwierząt, zwykle wymaga zgody właściwej komisji. Jakie zasady obowiązują w Twoim projekcie (także przy zwierzętach gospodarskich, w lecznicy albo przy wykorzystaniu danych z dokumentacji), sprawdź u promotora i w komisji, zanim zaczniesz – ten wpis nie omawia przepisów. Dla statystyki ważne jest jedno: plan liczby jednostek trzeba uzasadnić. Zbyt mało kojców to doświadczenie, które niczego nie rozstrzygnie (pokazujemy to w projekcie 3), a zbyt wiele to niepotrzebne obciążenie zwierząt i kosztów. Losowanie z blokami (np. kojce pogrupowane według masy początkowej zwierząt) opisuje hasło randomizacja blokowa.
Projekt 1. Doświadczenie polowe w blokach losowanych
Przykład: cztery odmiany pszenicy (A–D) wysiano na 20 poletkach w pięciu blokach. Każdy blok to pas pola o podobnej glebie i nachyleniu, a w każdym bloku każda odmiana ma jedno poletko w losowym miejscu. Pytanie brzmi: czy odmiany różnią się plonem (t/ha)? Jednostką eksperymentalną jest poletko, a blok to sposób na usunięcie z porównania zmienności wynikającej z położenia na polu.
W ANOVA dla układu bloków losowanych blok wchodzi do modelu jako czynnik: aov(plon ~ blok + odmiana). Odmiany różniły się plonem, F(3, 12) = 4.44, p = .026, ω²p = .34, 95% CI [.00, .61]. Bloki też się różniły, F(4, 12) = 4.75, p = .016. Ta sama analiza bez bloków – jak dla układu całkowicie losowego – dała F(3, 16) = 2.29, p = .117: zmienność między blokami trafiła do błędu i zamazała różnice odmian. Względna efektywność układu blokowego wyniosła 1.79, czyli bez bloków potrzebowałbyś mniej więcej 1.8 razy więcej poletek, by uzyskać tę samą precyzję. W porównaniach parami metodą Tukeya różniły się tylko odmiany A i C: odmiana A dała o 0.75 t/ha mniej, 95% CI [−1.41, −0.09], p = .024. ANOVA krok po kroku w programie z menu pokazuje wpis ANOVA w jamovi.
Dwie uwagi dla pracy. Po pierwsze, bloki uwzględnij w analizie zawsze, gdy zostały użyte przy losowaniu – także wtedy, gdy różnice między blokami wyglądają na małe. Usuwanie bloku „bo nieistotny” to zmiana analizy pod wynik. Po drugie, przy doświadczeniu wielolecie lub w kilku miejscowościach dochodzą kolejne losowe źródła zmienności (lata, miejscowości), a wtedy wygodniej przejść do modelu mieszanego. Piepho, Büchse i Emrich (2003) pokazują na przykładach z doświadczeń agronomicznych, jak budować taki model dla układów split-plot, serii doświadczeń i powtarzanych pomiarów na tych samych poletkach.
Split-plot: gdy jeden czynnik stosuje się na dużych poletkach
Jeśli porównujesz np. dwa sposoby uprawy roli i trzy odmiany, uprawę zwykle wykonuje się na całych poletkach (maszyną trudno uprawiać skrawki), a odmiany wysiewa na podpoletkach. To schemat split-plot: efekt uprawy testuje się względem zmienności między całymi poletkami, a efekt odmiany i interakcję – względem zmienności podpoletek. W R zapiszesz to jako aov(plon ~ uprawa * odmiana + Error(blok/uprawa)) albo lmer(plon ~ uprawa * odmiana + (1 | blok/uprawa)). Analiza jak dla zwykłego planu czynnikowego zawyża istotność czynnika na całych poletkach – liczbowy przykład tego błędu, z kodem, znajdziesz w haśle o split-plot. Jeśli czynników jest więcej, a pytanie dotyczy wyboru najlepszej kombinacji, zajrzyj do wpisu eksperyment czynnikowy i frakcyjny.
Projekt 2. Plon a dawka nawozu: krzywa odpowiedzi
Przykład: pięć dawek azotu (0, 50, 100, 150 i 200 kg N/ha) w czterech blokach, 20 poletek. Pytanie nie brzmi „czy dawki się różnią” – to oczywiste – tylko jak plon zmienia się z dawką i gdzie przestaje rosnąć. Dawka jest zmienną ilościową, więc zamiast porównywać każdą parę dawek testem post hoc, dopasuj krzywą. Ogólną ideę opisują hasła zależność dawka–odpowiedź i regresja krzywoliniowa, a podział sumy kwadratów na składnik liniowy i kwadratowy – wpis kontrasty planowane i analiza trendu.
Najczęściej używa się regresji kwadratowej: lm(plon ~ blok + N + I(N^2)). W przykładzie opisuje ona dane bardzo dobrze, R² = .955, a test braku dopasowania (porównanie z modelem, w którym każda dawka ma własną średnią) nie odrzuca krzywej, F(2, 12) = 1.30, p = .307. Maksimum paraboli przypada na 151 kg N/ha, 95% CI [135, 168] (przedział z metody delta). Model kwadratowy z plateau – parabola, która od pewnej dawki przechodzi w linię poziomą – wskazuje początek plateau przy 123 kg N/ha i ma niższe AIC (4.4 wobec 7.9). Oba modele przewidują podobny przyrost plonu od dawki zerowej do „najlepszej” (2.37 i 2.26 t/ha), ale różnią się o prawie 30 kg N/ha w tym, gdzie ta najlepsza dawka leży. Dane zasymulowano z plateau od 110 kg N/ha.
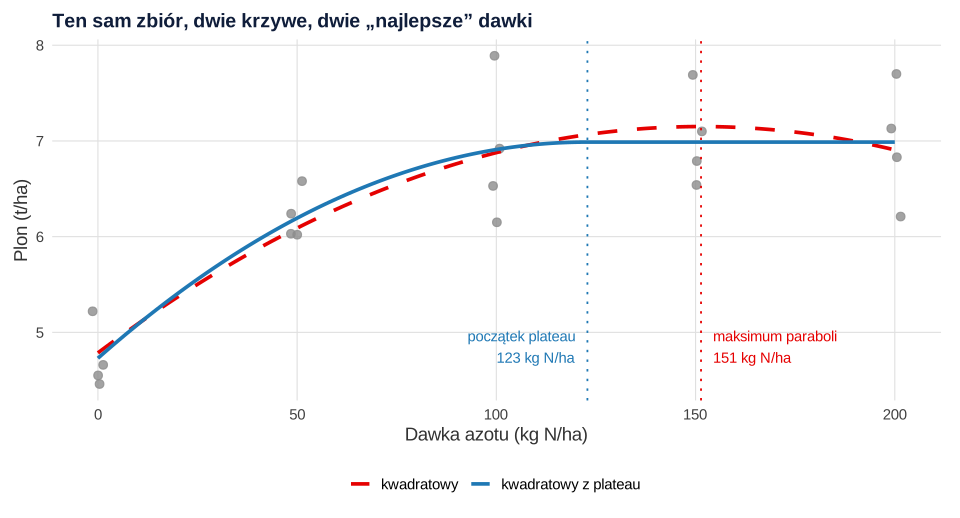
To nie jest przypadek tego jednego zbioru. Cerrato i Blackmer (1990) porównali pięć modeli odpowiedzi kukurydzy na azot w 12 doświadczeniach z dziesięcioma dawkami. Wszystkie modele pasowały do danych równie dobrze według R² i dawały podobne plony maksymalne, ale wskazywały bardzo różne dawki optymalne ekonomicznie. Model kwadratowy nie opisywał poprawnie odpowiedzi i zawyżał dawkę optymalną, a najlepiej wypadł model kwadratowy z plateau. Wniosek dla pracy: dobre R² nie uzasadnia wyboru krzywej. Zaplanuj kilka modeli, porównaj je (AIC, wykres reszt, test braku dopasowania), podaj dawkę z przedziałem ufności i napisz wprost, że inna krzywa przesunęłaby wynik. Przy pięciu dawkach rozstrzygnięcie bywa niemożliwe – to argument za większą liczbą dawek w planie. Dawkę optymalną ekonomicznie (z cenami nawozu i plonu) licz tylko wtedy, gdy wymaga tego temat, i opisz przyjęte ceny jako założenie.
Projekt 3. Żywienie w kojcach: kojec jest jednostką eksperymentalną
To najczęstsza pułapka prac z zootechniki. Przykład: 16 kojców, w każdym 10 prosiąt. Dietę z dodatkiem paszowym wylosowano ośmiu kojcom, a dietę kontrolną – pozostałym ośmiu. Pasza trafia do wspólnego karmidła, więc warunek przydzielono kojcowi. Zwierzęta z jednego kojca dzielą karmidło, poidło, mikroklimat, hierarchię w grupie i obsługę, dlatego ich przyrosty są do siebie podobne. Wynik to średni dzienny przyrost od ważenia początkowego do końcowego (g/dzień): 433.8 w grupie kontrolnej i 434.4 w grupie z dodatkiem.
Ile to podobieństwo znaczy, pokazuje współczynnik korelacji wewnątrzklasowej: ICC = .23, czyli 23% zmienności przyrostu przypada na różnice między kojcami. Przy 10 zwierzętach w kojcu efekt schematu wynosi 3.07, a 160 prosiąt niesie tyle informacji o diecie co około 52 niezależne zwierzęta. Jednocześnie informacja o diecie jest tylko w 16 kojcach – i to one wyznaczają stopnie swobody.
Porównaj cztery analizy tych samych danych:
- Test t na 160 prosiętach (błąd): różnica 0.7 g/dzień, 95% CI [−25.8, 27.2], t(158) = 0.05, p = .961. Przedział jest dwa razy węższy, niż powinien.
- Test t na 16 średnich kojców: ta sama różnica, ale 95% CI [−50.4, 51.7], t(14) = 0.03, p = .978.
- ANCOVA na 16 kojcach ze średnią masą początkową kojca jako kowariantem: −11.0 g/dzień, 95% CI [−60.2, 38.1], t(13) = −0.48, p = .636. Kowariant koryguje przypadkową nierównowagę – kojce z dodatkiem startowały średnio od 9.2 kg, a kontrolne od 9.0 kg.
- Model mieszany dla wszystkich ważeń (projekt 4): −11.1 g/dzień, 95% CI [−56.8, 34.6], t(14.5) = −0.52, p = .612. Stopnie swobody z poprawki Kenwarda–Rogera są bliskie liczbie kojców, a nie liczbie zwierząt.
W tym zbiorze żadna analiza nie dała wyniku istotnego, więc łatwo uznać, że wybór nie miał znaczenia. Symulacja pokazuje, że ma – i to w obie strony. W 1000 doświadczeniach o tej samej strukturze, w których dieta nie działała, test t na prosiętach dał p < .05 w 23.7% przypadków, a testy na kojcach w 5.0% (test t) i 4.6% (ANCOVA), czyli blisko nominalnych 5%. Gdy dodatek zwiększał przyrost o 30 g/dzień, poprawne analizy wykrywały to tylko w 27.2% i 25.7% doświadczeń. Osiem kojców na dietę to za mało. Przy założonej zmienności (odchylenie średniej kojca 39.8 g/dzień) moc 80% wymagałaby około 29 kojców na dietę. Dlatego w danych, w których prawdziwy efekt wynosił 30 g/dzień, oszacowanie z 16 kojców wyszło ujemne, a przedział objął zarówno 0, jak i 30.
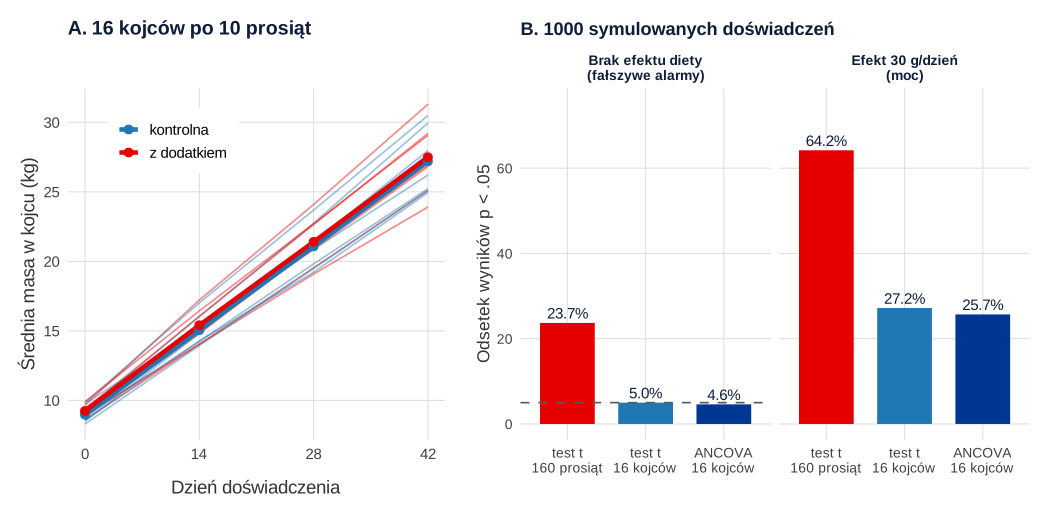
Wysoki „odsetek wykryć” testu na prosiętach w prawym panelu nie jest zaletą – to ten sam mechanizm, który w lewym panelu daje prawie co czwarty fałszywy alarm. Jeśli możesz, planuj więcej kojców z mniejszą liczbą zwierząt, a nie odwrotnie: przy ICC = .23 dziesiąte zwierzę w kojcu dodaje niewiele informacji. Jak policzyć moc dla takiego układu symulacją, pokazuje wpis analiza mocy dla modelu mieszanego. Zbyt mało kojców nie jest Twoją winą, jeśli tyle ma obiekt; wtedy napisz to wprost w ograniczeniach i nie interpretuj wyniku nieistotnego jako braku efektu.
Projekt 4. Przyrosty masy w powtarzanych ważeniach
Zwierzęta z projektu 3 ważono w dniach 0, 14, 28 i 42. Przyrost liczony tylko z pierwszego i ostatniego ważenia wyrzuca dwa pomiary pośrednie. Model mieszany wykorzystuje je wszystkie i pozwala opisać tempo wzrostu jako nachylenie masy względem czasu. Struktura danych ma trzy poziomy: ważenia w zwierzętach, zwierzęta w kojcach, kojce w dietach. Kojce i zwierzęta to czynniki zagnieżdżone – nadaj im unikalne identyfikatory (np. „K03-07”), inaczej program uzna, że zwierzę nr 7 z każdego kojca to to samo zwierzę.
W przykładzie model ma postać masa ~ masa0c * dzien + dieta * dzien + (0 + dzien | kojec) + (1 + dzien | zwierze) i obejmuje ważenia z dni 14, 28 i 42. Masa początkowa (wyśrodkowana) jest kowariantem, a nie pierwszym punktem krzywej, bo w dniu 0 diety jeszcze nie działały. Kluczowy jest współczynnik interakcji dieta × dzień – to różnica w dziennym przyroście: −11.1 g/dzień, 95% CI [−56.8, 34.6], t(14.5) = −0.52, p = .612. Wynik prawie pokrywa się z ANCOVA na średnich kojców, ale model dodatkowo pokazuje, że każdy kilogram masy początkowej więcej to 33.4 g/dzień szybszy wzrost. Losowe nachylenie kojca jest tu niezbędne: bez niego model traktowałby zwierzęta jako niezależne w ocenie efektu diety na tempo wzrostu i wrócilibyśmy do pseudoreplikacji.
Littell, Henry i Ammerman (1998) przypominają, że modele mieszane powstały w hodowli zwierząt, a przy pomiarach powtarzanych ich główną zaletą jest modelowanie struktury kowariancji: ważenia bliskie w czasie są zwykle silniej skorelowane niż odległe. Przy małej liczbie kojców używaj poprawki stopni swobody, np. Kenwarda–Rogera (Kenward i Roger, 1997), zamiast testu z. Jak opisać taki model, pokazuje wpis jak opisać wyniki modelu mieszanego, a krzywe wzrostu w R – modele wzrostu w lme4.
Projekt 5. Dane z dokumentacji stada lub lecznicy
Wiele prac z zootechniki i weterynarii opiera się na danych zebranych wcześniej: kartach zwierząt, programach do zarządzania stadem, dokumentacji lecznicy. To badanie retrospektywne i obserwacyjne – można w nim opisać częstość i związki, ale nie skutki zabiegów. Ogólne zasady (karta zbierania danych, definicje, „brak wpisu” to nie „nie wystąpiło”, zgodność dwóch osób przepisujących karty) opisuje wpis o analizie dokumentacji medycznej – stosują się wprost do dokumentacji zwierząt. Tu skupiamy się na tym, co specyficzne: zwierzęta są zgrupowane w stadach (albo u właścicieli), a część zmiennych to cechy stada.
Przykład: dokumentacja 10 stad krów mlecznych (5 z matami w legowiskach, 5 z piaskiem), łącznie 492 krowy. Wynik to kulawizna odnotowana w okresie badania (tak/nie; 18.5% krów), predyktory to numer laktacji (1, 2, 3 i więcej) i typ legowiska. U 20 krów brakowało numeru laktacji, więc model objął 472 zwierzęta – podaj to w tekście, a w ograniczeniach napisz, czy braki mogą zależeć od wyniku.
Zwykła regresja logistyczna dała dla piasku względem mat OR = 0.62, 95% CI [0.38, 1.00], p = .052 – wynik „na granicy”. GLMM z losowym wyrazem wolnym stada dał podobne OR = 0.60, ale przedział 95% CI [0.28, 1.32] i p = .205. Typ legowiska to cecha stada, a stad jest 10, więc o tym czynniku informuje 10 jednostek, nie 472 krowy. Wariancja między stadami wyniosła τ² = 0.23 (ICC na skali logitów = .06) – niewiele, a jednak przedział dla cechy stada poszerzył się wyraźnie. Dla numeru laktacji, który zmienia się między krowami w każdym stadzie, oba modele dały prawie to samo: krowy w trzeciej i dalszej laktacji miały wyższe szanse kulawizny niż pierwiastki, OR = 2.45, 95% CI [1.35, 4.43], p = .003. Krok po kroku taki model opisuje wpis wielopoziomowa regresja logistyczna.
Co jeszcze napisać w metodzie: kto i według jakiej skali oceniał kulawizny (różni lekarze i różne skale to różne definicje), z jakiego okresu pochodzą dane, czy krowa mogła trafić do bazy kilka razy (kilka laktacji, kilka wizyt w lecznicy – wtedy dochodzi poziom zwierzęcia) i jak potraktowano zwierzęta usunięte ze stada w trakcie okresu badania. W danych z lecznicy skupieniem bywa właściciel, a pacjenci zgłaszający się do jednej lecznicy nie są próbą wszystkich zwierząt w regionie. Wyniki opisuj językiem związku („wiązało się”), nie skutku. Jeśli Twój projekt opiera się na wynikach badań laboratoryjnych, plan porównania metod pomiaru znajdziesz we wpisie statystyka w pracy z analityki medycznej.
Projekt 6. Ankieta wśród rolników, hodowców i właścicieli zwierząt
Ankieta w tej dziedzinie różni się od ankiety studenckiej przede wszystkim jednostką i doborem. Jednostką jest zwykle gospodarstwo: jeśli odpowiada kilka osób z jednego gospodarstwa, ich odpowiedzi nie są niezależne, więc z góry ustal, kto wypełnia ankietę (np. osoba prowadząca gospodarstwo). Dobór to zwykle listy kontaktów, spotkania szkoleniowe, grupy producentów albo media społecznościowe – osoby, które się zgłaszają, bywają bardziej aktywne zawodowo niż przeciętne gospodarstwo, więc nie pisz o „rolnikach w Polsce”, tylko o badanej grupie. Pytania o wielkość gospodarstwa, liczbę zwierząt i dochody formułuj w jednostkach, których respondent używa na co dzień, i dopuść odpowiedź „wolę nie podawać”. Ogólne zasady budowy kwestionariusza opisuje wpis jak zrobić ankietę do pracy dyplomowej.
Przykład: 210 hodowców ocenia pięć stwierdzeń o dobrostanie zwierząt (1–5); wynik to średnia pozycji, α = .79, M = 3.20, SD = 0.79. Mediany rosły z wielkością gospodarstwa: 3.20 w małych (n = 84), 3.30 w średnich (n = 82) i 3.60 w dużych (n = 44). Test Kruskala–Wallisa wskazał różnicę, H(2) = 7.88, p = .019, ale jej wielkość była mała, ε² = .038. Z doradztwa żywieniowego korzystało 87 osób, czyli 41.4%, 95% CI [35.0, 48.2] (przedział Wilsona), a odsetek ten nie różnił się istotnie między grupami wielkości, χ²(2) = 2.83, p = .243, V = .12. Wielkość gospodarstwa nie była losowana, więc różnica postaw może wynikać z wieku, wykształcenia czy kierunku produkcji – to porównanie grup istniejących, nie efekt wielkości.
Jak opisać analizę w pracy z rolnictwa, zootechniki i weterynarii
Opis metody w tych dziedzinach ma jedną cechę szczególną: czytelnik musi z niego wyczytać układ doświadczenia i jednostkę eksperymentalną, zanim dojdzie do testów. Podaj liczbę bloków, poletek i ich wielkość, liczbę kojców i zwierząt w kojcu, sposób losowania (komu przydzielono warunek i jak), terminy pomiarów i to, kto mierzył lub oceniał (czy wiedział, która grupa jest która). Przy doświadczeniach na zwierzętach przydatna jest lista ARRIVE 2.0 (Percie du Sert i in., 2020): jej minimalny zestaw „ARRIVE Essential 10” pomaga sprawdzić, czy niczego nie pominąłeś, nawet jeśli Twoja praca nie trafi do czasopisma. Wymagania co do formy rozdziału ustala jednak promotor i uczelnia. Zdania z wynikami możesz porównać z generatorem opisu wyników APA.
Zdanie o mocy dopasuj do tego, co naprawdę zrobiłeś: jeśli analizę mocy wykonano przed doświadczeniem, napisz to i podaj założenia; jeśli nie, nie sugeruj, że była. Jeśli zabraknie Ci pewności, który model pasuje do Twojego układu albo jak odpowiedzieć na uwagi promotora o jednostce eksperymentalnej, możesz to skonsultować ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie. Do ćwiczeń przed obroną przydadzą się zadania z ANOVA z rozwiązaniami.
Przykład w R: kojce, ważenia i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1 – pełna analiza projektów 3 i 4: od przyrostów zwierząt, przez ICC i efekt schematu, błędny test na zwierzętach, test i ANCOVA na kojcach, po model mieszany dla wszystkich ważeń i symulację fałszywych alarmów oraz mocy. Przepis 2 zawiera projekty 1, 2, 5 i 6. Parametry symulacji (np. zmienność kojców 35 g/dzień i zwierząt 60 g/dzień, efekt 30 g/dzień, plateau od 110 kg N/ha) ustawiono ręcznie, by przykład odpowiadał opisanym sytuacjom; nie opisują one żadnej rzeczywistej hodowli ani uprawy. Fikcyjne ważenia z przepisu 1 możesz pobrać jako plik CSV (640 wierszy: kojec, dieta, zwierzę, dzień, masa).
1. Projekty 3 i 4: kojec jako jednostka, model mieszany i symulacja
R
# Doświadczenie żywieniowe w kojcach: dieta przydzielona kojcom, prosięta ważone co 14 dni (dane fikcyjne).
# 16 kojców (8 na dietę), w każdym 10 prosiąt; ważenia w dniach 0, 14, 28 i 42.
suppressPackageStartupMessages({ library(lme4); library(lmerTest) })
set.seed(524)
gen_kojce <- function(efekt = 0.030, sd_kojec = 0.035, sd_zw = 0.060) {
  kj <- data.frame(kojec = sprintf("K%02d", 1:16), dieta = rep(c("kontrolna", "z dodatkiem"), 8),
                   u = rnorm(16, 0, sd_kojec))                     # wpływ kojca na przyrost (kg/dzień)
  zw <- kj[rep(1:16, each = 10), ]
  zw$zwierze <- sprintf("%s-%02d", zw$kojec, 1:10)
  zw$masa0 <- round(rnorm(160, 9, 1.3), 1)                         # masa początkowa (kg)
  zw$adg <- 0.42 + 0.025 * (zw$masa0 - 9) + efekt * (zw$dieta == "z dodatkiem") +
    zw$u + rnorm(160, 0, sd_zw)                                    # prawdziwy dzienny przyrost
  d <- zw[rep(1:160, each = 4), c("kojec", "dieta", "zwierze", "masa0")]
  d$dzien <- rep(c(0, 14, 28, 42), 160)
  d$masa <- round(d$masa0 + rep(zw$adg, each = 4) * d$dzien + ifelse(d$dzien == 0, 0, rnorm(640, 0, 0.4)), 1)
  d$dieta <- factor(d$dieta, levels = c("kontrolna", "z dodatkiem"))
  rownames(d) <- NULL
  d
}
d <- gen_kojce()[, c("kojec", "dieta", "zwierze", "dzien", "masa")]
write.csv(d, "rolnictwo-kojce-wazenia-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Krok 1. Jedno zwierzę = jeden wiersz: masa początkowa, końcowa i dzienny przyrost (g/dzień)
zw <- reshape(d, idvar = c("zwierze", "kojec", "dieta"),
              timevar = "dzien", direction = "wide")
names(zw) <- sub("masa\\.", "m", names(zw))
zw$adg <- 1000 * (zw$m42 - zw$m0) / 42
aggregate(cbind(m0, m42, adg) ~ dieta, data = zw, FUN = function(x) round(mean(x), 1))
c(kojce = length(unique(zw$kojec)), zwierzeta = nrow(zw), wazenia = nrow(d))

# Krok 2. Ile zmienności przyrostu przypada na kojce? ICC i efekt schematu
m0 <- lmer(adg ~ dieta + (1 | kojec), data = zw)
vc <- as.data.frame(VarCorr(m0))$vcov
icc <- vc[1] / sum(vc)
round(c(ICC = icc, efekt_schematu = 1 + (10 - 1) * icc, n_efektywne = 160 / (1 + (10 - 1) * icc)), 2)

# Krok 3. Błąd: 160 prosiąt jako niezależne powtórzenia (pseudoreplikacja)
t_zw <- t.test(adg ~ dieta, data = zw, var.equal = TRUE)

# Krok 4. Jednostka eksperymentalna = kojec: 16 średnich, test t i ANCOVA ze średnią masą początkową
kj <- aggregate(cbind(adg, m0) ~ kojec + dieta, data = zw, FUN = mean)
t_kj <- t.test(adg ~ dieta, data = kj, var.equal = TRUE)
an_kj <- lm(adg ~ dieta + m0, data = kj)

# Krok 5. Model mieszany dla wszystkich ważeń: kojec i zwierzę jako efekty losowe, masa początkowa jako kowariant
dd <- merge(d[d$dzien > 0, ], zw[, c("zwierze", "m0")], by = "zwierze")
dd$masa0c <- dd$m0 - mean(zw$m0)
m_mix <- lmer(masa ~ masa0c * dzien + dieta * dzien + (0 + dzien | kojec) + (1 + dzien | zwierze), data = dd)
kr <- summary(m_mix, ddf = "Kenward-Roger")$coefficients["dzien:dietaz dodatkiem", ]

wiersz <- function(est, se, df) c(roznica_g_d = est, CI_d = est - qt(.975, df) * se,
                                  CI_g = est + qt(.975, df) * se, SE = se, t = est / se, df = df,
                                  p = 2 * pt(-abs(est / se), df))
wyn <- rbind(
  t_160_prosiat = wiersz(unname(diff(t_zw$estimate)), t_zw$stderr, unname(t_zw$parameter)),
  t_16_kojcow = wiersz(unname(diff(t_kj$estimate)), t_kj$stderr, unname(t_kj$parameter)),
  ANCOVA_16_kojcow = wiersz(unname(coef(an_kj)[2]), sqrt(vcov(an_kj)[2, 2]), df.residual(an_kj)),
  mieszany_KR = wiersz(1000 * unname(kr["Estimate"]), 1000 * unname(kr["Std. Error"]), unname(kr["df"])))
cbind(round(wyn[, 1:4], 1), t = round(wyn[, 5], 2), df = round(wyn[, 6], 1), p = round(wyn[, 7], 3))
round(c(b_masa0_ANCOVA = unname(coef(an_kj)["m0"]), b_masa0_mieszany = 1000 * unname(fixef(m_mix)["masa0c:dzien"])), 1)

# Krok 6. Ile kojców na dietę dla mocy 80% przy różnicy 30 g/dzień? SD średniej kojca z założeń symulacji
sd_sredniej_kojca <- sqrt(35^2 + 60^2 / 10)                      # g/dzień: kojce 35, zwierzęta 60, 10 zwierząt
round(c(SD = sd_sredniej_kojca, kojce_na_diete = power.t.test(delta = 30, sd = sd_sredniej_kojca, power = .80)$n), 1)

# Krok 7. Symulacja: 1000 doświadczeń bez efektu diety i 1000 z efektem 30 g/dzień
set.seed(5241)
R <- 1000
symuluj <- function(efekt) t(replicate(R, {
  s <- gen_kojce(efekt = efekt)
  a <- s[s$dzien == 0, c("zwierze", "kojec", "dieta", "masa0")]
  a$adg <- 1000 * (s$masa[s$dzien == 42] - s$masa[s$dzien == 0]) / 42
  k <- aggregate(cbind(adg, masa0) ~ kojec + dieta, data = a, FUN = mean)
  c(t_prosieta = t.test(adg ~ dieta, data = a, var.equal = TRUE)$p.value,
    t_kojce = t.test(adg ~ dieta, data = k, var.equal = TRUE)$p.value,
    ANCOVA_kojce = summary(lm(adg ~ dieta + masa0, data = k))$coefficients[2, 4])
}))
p0 <- symuluj(0); p30 <- symuluj(0.030)
odsetek <- rbind(bez_efektu = colMeans(p0 < .05), efekt_30_g = colMeans(p30 < .05))
round(100 * odsetek, 1)
round(100 * sqrt(odsetek * (1 - odsetek) / R), 1)                  # błąd Monte Carlo (punkty procentowe)
Wynik w R
        dieta  m0  m42   adg
1   kontrolna 9.0 27.2 433.8
2 z dodatkiem 9.2 27.5 434.4
    kojce zwierzeta   wazenia
       16       160       640
           ICC efekt_schematu    n_efektywne
          0.23           3.07          52.18
                 roznica_g_d  CI_d CI_g   SE     t    df     p
t_160_prosiat            0.7 -25.8 27.2 13.4  0.05 158.0 0.961
t_16_kojcow              0.7 -50.4 51.7 23.8  0.03  14.0 0.978
ANCOVA_16_kojcow       -11.0 -60.2 38.1 22.8 -0.48  13.0 0.636
mieszany_KR            -11.1 -56.8 34.6 21.4 -0.52  14.5 0.612
  b_masa0_ANCOVA b_masa0_mieszany
            43.4             33.4
            SD kojce_na_diete
          39.8           28.6
           t_prosieta t_kojce ANCOVA_kojce
bez_efektu       23.7     5.0          4.6
efekt_30_g       64.2    27.2         25.7
           t_prosieta t_kojce ANCOVA_kojce
bez_efektu        1.3     0.7          0.7
efekt_30_g        1.5     1.4          1.4
2. Projekty 1, 2, 5 i 6
R
# Projekty 1, 2, 5 i 6 (dane fikcyjne)
suppressPackageStartupMessages({ library(emmeans); library(effectsize); library(lme4) })

# PROJEKT 1. Cztery odmiany w układzie bloków losowanych: 5 bloków × 4 poletka
set.seed(5242)
p1 <- expand.grid(odmiana = factor(c("A", "B", "C", "D")), blok = factor(paste0("B", 1:5)))
p1$plon <- round(c(7.0, 7.5, 7.8, 7.1)[p1$odmiana] + rnorm(5, 0, 0.45)[p1$blok] + rnorm(20, 0, 0.30), 2)  # t/ha
a_blok <- aov(plon ~ blok + odmiana, data = p1)
a_bez <- aov(plon ~ odmiana, data = p1)                           # błąd: bloki pominięte
summary(a_blok); summary(a_bez)
omega_squared(a_blok, partial = TRUE, alternative = "two.sided")
ms <- summary(a_blok)[[1]][["Mean Sq"]]
c(efektywnosc_wzgledna = round(((5 - 1) * ms[1] + 5 * (4 - 1) * ms[3]) / ((5 * 4 - 1) * ms[3]), 2))
em <- emmeans(a_blok, ~ odmiana)
pr1 <- summary(pairs(em, adjust = "tukey"), infer = TRUE)
data.frame(para = pr1$contrast, roznica = round(pr1$estimate, 2), CI_d = round(pr1$lower.CL, 2),
           CI_g = round(pr1$upper.CL, 2), p = round(pr1$p.value, 3))

# PROJEKT 2. Pięć dawek azotu w 4 blokach: krzywa odpowiedzi plonu
set.seed(5243)
p2 <- expand.grid(N = c(0, 50, 100, 150, 200), blok = factor(paste0("B", 1:4)))
qp_prawda <- function(N) { x <- pmin(N, 110); 5.0 + 0.0352 * x - 0.00016 * x^2 }  # plateau od 110 kg N/ha
p2$plon <- round(qp_prawda(p2$N) + rnorm(4, 0, 0.30)[p2$blok] + rnorm(20, 0, 0.25), 2)
m_czyn <- lm(plon ~ blok + factor(N), data = p2)                  # dawka jako czynnik (5 poziomów)
m_kw <- lm(plon ~ blok + N + I(N^2), data = p2)                   # krzywa kwadratowa
anova(m_kw, m_czyn)                                               # brak dopasowania krzywej kwadratowej
b <- coef(m_kw); V <- vcov(m_kw)[c("N", "I(N^2)"), c("N", "I(N^2)")]
N_max <- -b[["N"]] / (2 * b[["I(N^2)"]])
grad <- c(-1 / (2 * b[["I(N^2)"]]), b[["N"]] / (2 * b[["I(N^2)"]]^2))
se_N <- sqrt(drop(t(grad) %*% V %*% grad))                        # metoda delta
round(c(b1 = b[["N"]], b2 = 1e4 * b[["I(N^2)"]], R2 = summary(m_kw)$r.squared,
        N_max = N_max, CI_d = N_max - qt(.975, df.residual(m_kw)) * se_N, CI_g = N_max + qt(.975, df.residual(m_kw)) * se_N), 3)
m_qp <- nls(plon ~ a[blok] + b1 * pmin(N, -b1 / (2 * b2)) + b2 * pmin(N, -b1 / (2 * b2))^2,
            data = p2, start = list(a = rep(5, 4), b1 = 0.03, b2 = -0.00015))
k <- coef(m_qp)
x0 <- -k[["b1"]] / (2 * k[["b2"]])
round(c(punkt_plateau = x0, AIC_kwadratowy = AIC(m_kw), AIC_kw_plateau = AIC(m_qp),
        przyrost_kw_0_do_Nmax = b[["N"]] * N_max + b[["I(N^2)"]] * N_max^2,
        przyrost_qp_0_do_plateau = k[["b1"]] * x0 + k[["b2"]] * x0^2), 2)

# PROJEKT 5. Dokumentacja 10 stad: kulawizna (0/1), numer laktacji, typ legowiska (cecha stada)
set.seed(5244)
st <- data.frame(stado = sprintf("S%02d", 1:10), legowisko = rep(c("maty", "piasek"), each = 5),
                 u = rnorm(10, 0, 0.6), n = sample(35:65, 10, replace = TRUE))
p5 <- st[rep(1:10, st$n), ]
p5$laktacja <- factor(sample(c("1", "2", "3+"), nrow(p5), replace = TRUE, prob = c(.35, .30, .35)))
p5$kulawizna <- rbinom(nrow(p5), 1, plogis(-1.6 + log(1.4) * (p5$laktacja == "2") + log(2.0) * (p5$laktacja == "3+") +
                                              log(0.7) * (p5$legowisko == "piasek") + p5$u))
p5$laktacja[sample(nrow(p5), 20)] <- NA                           # brak wpisu w karcie
c(krowy = nrow(p5), z_brakiem_laktacji = sum(is.na(p5$laktacja)), kulawe_proc = round(100 * mean(p5$kulawizna), 1))
g_zwykly <- glm(kulawizna ~ laktacja + legowisko, family = binomial, data = p5)
g_mieszany <- glmer(kulawizna ~ laktacja + legowisko + (1 | stado), family = binomial, data = p5)
or_tab <- function(est, se) round(cbind(OR = exp(est), CI_d = exp(est - 1.96 * se), CI_g = exp(est + 1.96 * se),
                                        p = 2 * pnorm(-abs(est / se))), 3)
or_tab(coef(g_zwykly)[-1], sqrt(diag(vcov(g_zwykly)))[-1])
or_tab(fixef(g_mieszany)[-1], sqrt(diag(as.matrix(vcov(g_mieszany))))[-1])
tau2 <- VarCorr(g_mieszany)$stado[1]
round(c(tau2 = tau2, ICC_latentne = tau2 / (tau2 + pi^2 / 3), n_w_modelu = nobs(g_mieszany)), 3)

# PROJEKT 6. Ankieta wśród 210 hodowców: 5 pozycji (1–5) o dobrostanie, wielkość gospodarstwa
set.seed(5245)
n6 <- 210
p6 <- data.frame(wielkosc = factor(sample(c("małe", "średnie", "duże"), n6, TRUE, c(.45, .35, .20)),
                                   levels = c("małe", "średnie", "duże")))
z <- rnorm(n6) + c(0, 0.25, 0.45)[p6$wielkosc]
poz <- sapply(1:5, function(j) pmin(pmax(round(3.1 + 0.8 * z + rnorm(n6, 0, 0.8)), 1), 5))
p6$dobrostan <- rowMeans(poz)
p6$doradca <- rbinom(n6, 1, c(.30, .42, .55)[p6$wielkosc])        # korzysta z doradztwa żywieniowego
k_alfa <- ncol(poz) / (ncol(poz) - 1) * (1 - sum(apply(poz, 2, var)) / var(rowSums(poz)))
round(c(alfa = k_alfa, M = mean(p6$dobrostan), SD = sd(p6$dobrostan)), 2)
aggregate(dobrostan ~ wielkosc, data = p6, FUN = function(x) round(c(Me = median(x), M = mean(x), n = length(x)), 2))
kw <- kruskal.test(dobrostan ~ wielkosc, data = p6)
round(c(H = unname(kw$statistic), df = unname(kw$parameter), p = kw$p.value, eps2 = unname(kw$statistic) / (n6 - 1)), 3)
pr <- prop.test(sum(p6$doradca), n6, correct = FALSE)             # przedział Wilsona
round(c(n = sum(p6$doradca), proc = 100 * unname(pr$estimate), CI_d = 100 * pr$conf.int[1], CI_g = 100 * pr$conf.int[2]), 1)
ch <- chisq.test(table(p6$wielkosc, p6$doradca))
round(c(chi2 = unname(ch$statistic), df = unname(ch$parameter), p = ch$p.value,
        V = sqrt(unname(ch$statistic) / n6)), 3)
Wynik w R
            Df Sum Sq Mean Sq F value Pr(>F)
blok         4  2.348  0.5870   4.747 0.0158 *
odmiana      3  1.648  0.5492   4.442 0.0255 *
Residuals   12  1.484  0.1236
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Df Sum Sq Mean Sq F value Pr(>F)
odmiana      3  1.648  0.5492   2.294  0.117
Residuals   16  3.832  0.2395
# Effect Size for ANOVA (Type I)

Parameter | Omega2 (partial) |       95% CI
-------------------------------------------
blok      |             0.43 | [0.00, 0.67]
odmiana   |             0.34 | [0.00, 0.61]
efektywnosc_wzgledna
                1.79
   para roznica  CI_d  CI_g     p
1 A - B   -0.54 -1.20  0.12 0.121
2 A - C   -0.75 -1.41 -0.09 0.024
3 A - D   -0.24 -0.90  0.42 0.698
4 B - C   -0.21 -0.87  0.45 0.782
5 B - D    0.30 -0.36  0.96 0.552
6 C - D    0.51 -0.15  1.17 0.154
Analysis of Variance Table

Model 1: plon ~ blok + N + I(N^2)
Model 2: plon ~ blok + factor(N)
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1     14 0.8627
2     12 0.7087  2     0.154 1.3038 0.3073
     b1      b2      R2   N_max    CI_d    CI_g
  0.031  -1.032   0.955 151.374 135.028 167.719
           punkt_plateau           AIC_kwadratowy           AIC_kw_plateau
                  122.85                     7.89                     4.42
   przyrost_kw_0_do_Nmax przyrost_qp_0_do_plateau
                    2.37                     2.26
             krowy z_brakiem_laktacji        kulawe_proc
             492.0               20.0               18.5
                   OR  CI_d  CI_g     p
laktacja2       1.399 0.737 2.656 0.305
laktacja3+      2.384 1.332 4.268 0.003
legowiskopiasek 0.617 0.380 1.004 0.052
                   OR  CI_d  CI_g     p
laktacja2       1.400 0.731 2.681 0.310
laktacja3+      2.446 1.352 4.425 0.003
legowiskopiasek 0.603 0.276 1.319 0.205
        tau2 ICC_latentne   n_w_modelu
       0.226        0.064      472.000
alfa    M   SD
0.79 3.20 0.79
  wielkosc dobrostan.Me dobrostan.M dobrostan.n
1     małe         3.20        3.07       84.00
2  średnie         3.30        3.21       82.00
3     duże         3.60        3.46       44.00
    H    df     p  eps2
7.879 2.000 0.019 0.038
   n proc CI_d CI_g
87.0 41.4 35.0 48.2
 chi2    df     p     V
2.831 2.000 0.243 0.116
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- pbkrtest (wersja 0.5.5): Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models – The R package pbkrtest. Journal of Statistical Software, 59(9), 1–30. https://doi.org/10.18637/jss.v059.i09
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z rolnictwa, zootechniki i weterynarii
- Zwierzęta zamiast kojców. Dieta podana do wspólnego karmidła, a test na zwierzętach – w symulacji prawie co czwarty fałszywy alarm. Analizuj średnie kojców albo model mieszany z kojcem.
- Pominięte bloki. Bloki wykorzystane przy losowaniu muszą być w modelu; bez nich zmienność pola trafia do błędu (w przykładzie p = .117 zamiast .026).
- Split-plot analizowany jak zwykły plan czynnikowy. Czynnik na całych poletkach testuje się względem błędu całych poletek.
- Testy post hoc dla dawek. Pięć dawek to zmienna ilościowa – dopasuj krzywą, a nie dziesięć porównań parami.
- Dawka optymalna z jednej paraboli bez przedziału. Inna krzywa może przesunąć wynik o kilkadziesiąt kg N/ha; podaj przedział i porównanie modeli.
- Przyrost tylko z pierwszego i ostatniego ważenia, gdy było ich więcej, albo masa początkowa jako zwykły punkt krzywej po rozpoczęciu żywienia.
- Powtórzone numery zwierząt w kojcach, przez które program łączy różne zwierzęta w jedno.
- Cecha stada oceniana na zwierzętach. Typ legowiska w 10 stadach to 10 obserwacji, nie kilkaset krów.
- Język przyczynowy w danych z dokumentacji i uogólnianie z jednej lecznicy lub kilku stad na całą populację.
- Kilka ankiet z jednego gospodarstwa liczonych jako niezależne odpowiedzi i opisywanie ochotników jako „rolników”.
- Wynik nieistotny przy kilku kojcach opisany jako brak efektu. Przy 8 kojcach na dietę przedział mieścił zarówno 0, jak i 30 g/dzień.
Najczęstsze pytania
Co jest jednostką eksperymentalną w doświadczeniu żywieniowym, gdy paszę podaje się całemu kojcowi?
Kojec. Warunek przydzielono kojcowi, a zwierzęta w nim dzielą karmidło, mikroklimat i hierarchię, więc ich przyrosty są skorelowane. Analizuj średnie kojców (test t albo ANCOVA z masą początkową) lub model mieszany z losowym efektem kojca; liczba stopni swobody dla diety wynika z liczby kojców. Test na wszystkich zwierzętach jak na niezależnych powtórzeniach to pseudoreplikacja.
Czy bloki w doświadczeniu polowym trzeba uwzględnić w ANOVA, jeśli nie interesuje mnie ich efekt?
Tak, jeśli zostały użyte przy losowaniu poletek. Blok usuwa z błędu zmienność wynikającą z położenia na polu; po jego pominięciu ta zmienność obciąża porównanie odmian i test traci moc. Bloku nie usuwa się z modelu dlatego, że wyszedł nieistotny – to byłaby zmiana analizy pod wynik.
Jak wyznaczyć dawkę nawozu, przy której plon przestaje rosnąć?
Potraktuj dawkę jako zmienną ilościową i dopasuj krzywą odpowiedzi, np. kwadratową i kwadratową z plateau, z blokiem w modelu. Dawkę maksymalną podaj z przedziałem ufności (np. z metody delta) i porównaj modele (AIC, reszty, test braku dopasowania). Różne krzywe mogą dobrze pasować do danych, a mimo to wskazywać wyraźnie różne dawki, więc napisz, jak wybór modelu wpływa na wynik.
Jak analizować masę zwierząt ważonych kilka razy w czasie doświadczenia?
Najczęściej liniowym modelem mieszanym: masa zależy od czasu, grupy i interakcji grupa × czas, a masa początkowa jest kowariantem. Uwzględnij losowe efekty zwierzęcia i – jeśli warunek przydzielono kojcom – losowe nachylenie kojca. Różnicę tempa przyrostu odczytasz z interakcji grupa × czas; przy kilkunastu kojcach użyj poprawki stopni swobody Kenwarda–Rogera.
Czy w pracy dyplomowej można wykorzystać dane z dokumentacji stada albo lecznicy weterynaryjnej?
Tak, jako badanie retrospektywne i obserwacyjne, po uzgodnieniu dostępu do danych i zasad z promotorem oraz właścicielem danych. Opisz źródło, okres, definicje zmiennych i braki wpisów. Zwierzęta w jednym stadzie lub u jednego właściciela są skupieniem, więc użyj modelu wielopoziomowego, a cechy stada oceniaj na poziomie stad. Wyniki opisuj jako związki, nie skutki.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z biologii i ochrony środowiska
Stanowiska, liczebność w pułapkach bez pseudoreplikacji, różnorodność gatunkowa, sezonowość w monitoringu i skala NEP: modele, efekty i kod R.
Czytaj →PoradnikModele wzrostu w lme4
Losowy wyraz wolny i nachylenie czasu, kodowanie czasu, nieregularne terminy, predyktor × czas, braki MAR, porównanie z LGM i wzór opisu APA.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z rolnictwa, zootechniki albo weterynarii i nie wiesz, jak policzyć wyniki?
Pomożemy ustalić jednostkę eksperymentalną, dobrać model do Twoich poletek, kojców, ważeń albo danych ze stada, policzyć go z wielkością efektu i wyjaśnić tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bello, N. M., Kramer, M., Tempelman, R. J., Stroup, W. W., St-Pierre, N. R., Craig, B. A., Young, L. J., & Gbur, E. E. (2016). Short communication: On recognizing the proper experimental unit in animal studies in the dairy sciences. Journal of Dairy Science, 99(11), 8871–8879. https://doi.org/10.3168/jds.2016-11516 ● Otwarty dostęp
- Cerrato, M. E., & Blackmer, A. M. (1990). Comparison of models for describing corn yield response to nitrogen fertilizer. Agronomy Journal, 82(1), 138–143. https://doi.org/10.2134/agronj1990.00021962008200010030x
- Festing, M. F. W., & Altman, D. G. (2002). Guidelines for the design and statistical analysis of experiments using laboratory animals. ILAR Journal, 43(4), 244–258. https://doi.org/10.1093/ilar.43.4.244
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Lazic, S. E., Clarke-Williams, C. J., & Munafò, M. R. (2018). What exactly is ‘N’ in cell culture and animal experiments? PLOS Biology, 16(4), Article e2005282. https://doi.org/10.1371/journal.pbio.2005282 ● Otwarty dostęp
- Littell, R. C., Henry, P. R., & Ammerman, C. B. (1998). Statistical analysis of repeated measures data using SAS procedures. Journal of Animal Science, 76(4), 1216–1231. https://doi.org/10.2527/1998.7641216x
- Percie du Sert, N., Hurst, V., Ahluwalia, A., Alam, S., Avey, M. T., Baker, M., Browne, W. J., Clark, A., Cuthill, I. C., Dirnagl, U., Emerson, M., Garner, P., Holgate, S. T., Howells, D. W., Karp, N. A., Lazic, S. E., Lidster, K., MacCallum, C. J., Macleod, M., . . . Würbel, H. (2020). The ARRIVE guidelines 2.0: Updated guidelines for reporting animal research. PLOS Biology, 18(7), Article e3000410. https://doi.org/10.1371/journal.pbio.3000410 ● Otwarty dostęp
- Piepho, H. P., Büchse, A., & Emrich, K. (2003). A hitchhiker’s guide to mixed models for randomized experiments. Journal of Agronomy and Crop Science, 189(5), 310–322. https://doi.org/10.1046/j.1439-037x.2003.00049.x
Cytowania BibTeX
@article{bello2016short, author={Bello, Nora M. and Kramer, Matthew and Tempelman, Robert J. and Stroup, Walter W. and St-Pierre, Normand R. and Craig, Bruce A. and Young, Linda J. and Gbur, Edward E.}, title={{Short communication: On recognizing the proper experimental unit in animal studies in the dairy sciences}}, journal={Journal of Dairy Science}, year={2016}, volume={99}, number={11}, pages={8871--8879}, doi={10.3168/jds.2016-11516}}@article{cerrato1990comparison, author={Cerrato, M. E. and Blackmer, A. M.}, title={{Comparison of models for describing corn yield response to nitrogen fertilizer}}, journal={Agronomy Journal}, year={1990}, volume={82}, number={1}, pages={138--143}, doi={10.2134/agronj1990.00021962008200010030x}}@article{festing2002guidelines, author={Festing, M. F. W. and Altman, D. G.}, title={{Guidelines for the design and statistical analysis of experiments using laboratory animals}}, journal={ILAR Journal}, year={2002}, volume={43}, number={4}, pages={244--258}, doi={10.1093/ilar.43.4.244}}@article{kenward1997small, author={Kenward, Michael G. and Roger, James H.}, title={{Small sample inference for fixed effects from restricted maximum likelihood}}, journal={Biometrics}, year={1997}, volume={53}, number={3}, pages={983--997}, doi={10.2307/2533558}}@article{lazic2018what, author={Lazic, Stanley E. and Clarke-Williams, Charlie J. and Munaf{\`o}, Marcus R.}, title={{What exactly is ‘N’ in cell culture and animal experiments?}}, journal={PLOS Biology}, year={2018}, volume={16}, number={4}, eid={e2005282}, doi={10.1371/journal.pbio.2005282}}@article{littell1998statistical, author={Littell, R. C. and Henry, P. R. and Ammerman, C. B.}, title={{Statistical analysis of repeated measures data using SAS procedures}}, journal={Journal of Animal Science}, year={1998}, volume={76}, number={4}, pages={1216--1231}, doi={10.2527/1998.7641216x}}@article{percie2020arrive, author={Percie du Sert, Nathalie and Hurst, Viki and Ahluwalia, Amrita and Alam, Sabina and Avey, Marc T. and Baker, Monya and Browne, William J. and Clark, Alejandra and Cuthill, Innes C. and Dirnagl, Ulrich and Emerson, Michael and Garner, Paul and Holgate, Stephen T. and Howells, David W. and Karp, Natasha A. and Lazic, Stanley E. and Lidster, Katie and MacCallum, Catriona J. and Macleod, Malcolm and Pearl, Esther J. and Petersen, Ole H. and Rawle, Frances and Reynolds, Penny and Rooney, Kieron and Sena, Emily S. and Silberberg, Shai D. and Steckler, Thomas and W{\"u}rbel, Hanno}, title={{The ARRIVE guidelines 2.0: Updated guidelines for reporting animal research}}, journal={PLOS Biology}, year={2020}, volume={18}, number={7}, eid={e3000410}, doi={10.1371/journal.pbio.3000410}}@article{piepho2003hitchhiker, author={Piepho, H. P. and B{\"u}chse, A. and Emrich, K.}, title={{A hitchhiker’s guide to mixed models for randomized experiments}}, journal={Journal of Agronomy and Crop Science}, year={2003}, volume={189}, number={5}, pages={310--322}, doi={10.1046/j.1439-037x.2003.00049.x}}