Sześć typowych projektów w pracy z analityki medycznej
Praca dyplomowa z analityki medycznej rzadko przypomina ankietę z psychologii czy pielęgniarstwa. Najczęściej jej „osobami badanymi” są próbki, serie pomiarowe i dni pracy analizatora, a pytanie dotyczy jakości samego pomiaru: czy nowy analizator daje te same wyniki co dotychczasowy, jak bardzo wynik zmienia się z dnia na dzień, gdzie leżą granice wartości typowych dla osób zdrowych, czy próbka po trzech dniach w lodówce daje ten sam wynik. Druga grupa prac korzysta z wyników zgromadzonych w systemie laboratoryjnym. Tabela porządkuje sześć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Co raportujesz |
|---|---|---|---|---|
| 1. Porównanie dwóch analizatorów | Czy nowy analizator może zastąpić dotychczasowy? | te same próbki zmierzone obiema metodami | Bland–Altman (często na różnicach procentowych), regresja Deminga lub Passinga–Babloka | średnia różnica i granice zgodności z CI, nachylenie i przecięcie |
| 2. Precyzja | Jak powtarzalny jest wynik w serii i między dniami? | materiał kontrolny: dni × serie × powtórzenia | model z losowym dniem i serią (składowe wariancji) | SD i CV powtarzalności, między seriami, między dniami i łącznie |
| 3. Przedział referencyjny | Jakie wartości są typowe dla osób zdrowych? | jeden wynik od każdej z kilkuset osób | percentyle 2.5 i 97.5 (nieparametrycznie) | granice z 90% CI, decyzja o podziale na podgrupy |
| 4. Stabilność próbki | Czy wynik zmienia się w czasie przechowywania? | te same próbki w kilku punktach czasu | odchylenie od wyniku wyjściowego, test równoważności | średnie odchylenie w % z 90% CI względem marginesu |
| 5. Analiza bazy laboratorium | Czy wyniki różnią się między grupami pacjentów? | eksport z systemu: wiele wyników na osobę, wpisy „<granica” | jeden wynik na pacjenta, model z cenzurowaniem lub test rangowy | iloraz średnich geometrycznych albo mediany z CI |
| 6. Wartość diagnostyczna | Jak dobrze oznaczenie odróżnia osoby z chorobą od pozostałych? | wynik oznaczenia i rozpoznanie według standardu referencyjnego | krzywa ROC, czułość i swoistość przy progu ustalonym z góry | AUC, czułość i swoistość z 95% CI |
Wszystkie dane w przykładach są symulowane, analit nazywamy po prostu „analitem A”, a wyniki podajemy w jednostkach umownych (j.). To celowe: wpis uczy analizy, a nie interpretacji wyników konkretnych badań, której w pracy dokonasz na podstawie literatury swojej dziedziny. Pełny kod znajdziesz w sekcji Przykład w R, a dane do projektu 2 – jako plik CSV (80 wyników). Jeśli nie wiesz, który test pasuje do Twojego pytania, zacznij od kreatora doboru testu, a całą drogę od pytania do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: próbka, seria, dzień czy pacjent?
Ustal jednostkę analizy. W analityce ta sama liczba „80 wyników” może oznaczać 80 niezależnych pacjentów albo jeden materiał kontrolny zmierzony 80 razy w ciągu 20 dni. W pierwszym przypadku masz 80 obserwacji, w drugim – 20 dni, 40 serii i po dwa powtórzenia w serii. Wyniki z tego samego dnia są do siebie podobne, bo dzielą kalibrację, odczynniki i warunki pracy. Jeśli policzysz je jak niezależne, pomylisz źródła zmienności i zaniżysz niepewność. Podobnie w bazie laboratorium: pacjent z sześcioma oznaczeniami nie jest sześcioma pacjentami.
Kryteria akceptacji ustal przed pomiarami. Statystyka nie powie, czy różnica 3% między analizatorami jest dopuszczalna. Giavarina (2015) przypomina, że dopuszczalne granice zgodności trzeba określić z góry, na podstawie potrzeb klinicznych lub innych celów. W pracy dyplomowej zwykle bierzesz je z deklaracji producenta, wymagań przyjętych w laboratorium albo z literatury – zapisz źródło i nie zmieniaj progu po obejrzeniu wyników. W przykładach poniżej progi są fikcyjne.
Wytyczne i normy czytaj w oryginale. Dla badań precyzji, porównania metod czy przedziałów referencyjnych istnieją szczegółowe wytyczne organizacji laboratoryjnych. Jeśli Twoje laboratorium lub promotor się na nie powołuje, sprawdź aktualną wersję dokumentu i opisz plan zgodnie z nią; nie cytuj wytycznych z drugiej ręki. Dane z laboratorium wynoś tylko zanonimizowane i za zgodą placówki, a w pracy nie podawaj nazwy aparatu, jeśli umowa lub promotor tego nie przewidują.
Projekt 1. Porównanie dwóch analizatorów
To najczęstszy temat pracy wykonywanej w laboratorium: nowy analizator albo nowa metoda ma zastąpić dotychczasową. Szczegóły liczenia współczynnika zgodności Lina, regresji Deminga i regresji Passinga–Babloka pokazuje osobny poradnik o zgodności dwóch metod pomiaru. Tutaj skupiamy się na tym, co specyficzne dla laboratorium: planie i wyborze skali różnic.
Plan badania porównawczego
Wybierz próbki tak, aby pokryły cały zakres stężeń spotykany w praktyce, a nie tylko wyniki „w normie” – zgodność w wąskim zakresie niewiele mówi o wynikach skrajnych. Każdą próbkę zmierz obiema metodami w krótkim odstępie czasu, w losowej lub naprzemiennej kolejności, a jeśli to możliwe – w dwóch powtórzeniach, bo pary pomiarów pozwalają ocenić powtarzalność każdej metody. Zapisz, które próbki wykluczono i dlaczego (hemoliza, za mała objętość), zanim porównasz wyniki.
Różnice bezwzględne czy procentowe
Przykład: 100 próbek o stężeniach od 2 do 40 j. zmierzono analizatorem dotychczasowym i nowym. Korelacja wyniosła r = .997, co nie mówi nic o zgodności – oba aparaty mogą rosnąć razem i stale się różnić. Analiza Blanda–Altmana na różnicach bezwzględnych dała średnią różnicę 0.50 j. i granice zgodności od −1.41 do 2.40 j. Rozrzut różnic rósł jednak ze stężeniem: bezwzględna różnica zwiększała się średnio o 0.055 j. na każdą jednostkę stężenia, p < .001. Przy niskich stężeniach granice ±2 j. byłyby ogromne, przy wysokich – za wąskie.
Na taką sytuację Bland i Altman (1999) proponują transformację logarytmiczną albo opisanie zależności różnicy od wielkości pomiaru regresją, a Giavarina (2015) pokazuje także wykres różnic wyrażonych w procentach średniej. W laboratorium ta ostatnia wersja jest najbardziej czytelna, bo kryteria akceptacji często podaje się właśnie w procentach. Na różnicach procentowych nowy analizator zawyżał wynik średnio o 3.10%, a granice zgodności wyniosły od −4.83% do 11.03%. Przyjmijmy fikcyjne kryterium: różnice pojedynczych wyników nie powinny przekraczać ±10%. Górna granica zgodności (11.03%, 95% CI [9.64, 12.41]) wychodzi poza to kryterium, więc metod nie można uznać za zamienne bez dalszych działań, np. korekty kalibracji. Zwróć uwagę, że przedział ufności granicy obejmuje także 10% – przy 100 próbkach wniosek jest więc niepewny i trzeba to napisać.
Projekt 2. Precyzja: powtarzalność i zmienność między dniami
Badanie precyzji odpowiada na pytanie, jak bardzo różnią się wyniki tego samego materiału zmierzonego wielokrotnie. Kluczowe jest rozróżnienie źródeł zmienności. Powtarzalność to rozrzut wyników w jednej serii, gdy warunki są możliwie stałe. Precyzja wewnątrzlaboratoryjna (pośrednia) obejmuje dodatkowo różnice między seriami i dniami: nową kalibrację, inną partię odczynnika, innego operatora. Precyzję zwykle wyraża się współczynnikiem zmienności (CV), czyli odchyleniem standardowym w procentach średniej.
Przykład: materiał kontrolny o stężeniu około 5.2 j. mierzono przez 20 dni, w dwóch seriach dziennie i w dwóch powtórzeniach w każdej serii – razem 80 wyników o średniej 5.189 j. Taki układ pozwala rozdzielić trzy źródła zmienności, ale tylko wtedy, gdy analiza odtworzy jego strukturę.
Model z losowym dniem i serią
Składowe wariancji szacujemy modelem mieszanym, w którym dzień i seria zagnieżdżona w dniu są efektami losowymi (to ten sam model, który w badaniach z ludźmi pozwala uwzględnić pomiary powtarzane; zob. ANOVA z powtarzanymi pomiarami czy model mieszany). Wyniki zebrano w tabeli.
| Składowa | SD (j.) | CV (%) | Udział w wariancji (%) |
|---|---|---|---|
| Powtarzalność (w serii) | 0.068 | 1.32 | 27.3 |
| Między seriami w obrębie dnia | 0.057 | 1.09 | 18.8 |
| Między dniami | 0.096 | 1.85 | 53.9 |
| Precyzja wewnątrzlaboratoryjna (razem) | 0.131 | 2.52 | 100.0 |
Ponad połowa zmienności (53.9%) pochodzi z różnic między dniami. To typowa informacja, której szuka laboratorium: jeśli precyzja jest niewystarczająca, poprawa będzie wymagała pracy nad tym, co zmienia się z dnia na dzień, a nie nad samą serią. Zwróć uwagę na składowe całkowitej wariancji: sumują się wariancje (kwadraty SD), a nie odchylenia standardowe. Dlatego CV łączny wynosi 2.52%, a nie 1.32 + 1.09 + 1.85.
Niepewność oszacowań i weryfikacja deklaracji producenta
Dwadzieścia dni to niewiele, jeśli chcesz oszacować zmienność między dniami. Przedział ufności z profilu wiarygodności dla SD między dniami wyniósł od 0.055 do 0.141 j., dla SD między seriami od 0.021 do 0.094 j., a dla SD powtarzalności – od 0.056 do 0.086 j. Najdokładniej oszacowana jest powtarzalność, bo na nią przypada najwięcej stopni swobody. Podawaj te przedziały w pracy; to uczciwsze niż jedna liczba z trzema miejscami po przecinku.
Częste zadanie to sprawdzenie, czy laboratorium osiąga precyzję deklarowaną przez producenta. Przyjmijmy fikcyjną deklarację: CV powtarzalności nie większy niż 2.0%. Statystyka χ² = df × s² / σ²deklarowane przy 40 stopniach swobody wyniosła 17.31 wobec wartości krytycznej 55.76, p = .999. Nie ma więc podstaw, by twierdzić, że powtarzalność jest gorsza niż deklarowana. Ten test sprawdza tylko jeden kierunek – czy precyzja nie jest gorsza – i tak go opisz.
Najczęstszy błąd: odchylenie wszystkich wyników jako „powtarzalność”
Odchylenie standardowe wszystkich 80 wyników wyniosło 0.13 j., czyli CV = 2.49%. To liczba bliska precyzji wewnątrzlaboratoryjnej, ale prawie dwa razy większa od powtarzalności (1.32%). Opisanie jej jako „powtarzalności” pomyliłoby źródła zmienności, a porównanie z deklaracją producenta wypadłoby fałszywie źle. Odwrotny błąd to policzenie CV z jednej serii 20 powtórzeń i nazwanie go precyzją: pominiesz wtedy różnice między dniami. Zgodność dwóch osób wykonujących oznaczenia lub odczyty to osobne pytanie – do niego służy ICC i plan opisany we wpisie o badaniu rzetelności pomiaru klinicznego.
Projekt 3. Przedział referencyjny
Przedział referencyjny obejmuje zwykle środkowe 95% wyników osób uznanych za zdrowe, więc jego granice to percentyle 2.5 i 97.5. Rozkłady wielu analitów są prawoskośne, dlatego najczęściej liczy się je nieparametrycznie, z uporządkowanych wyników. Linnet (2000) opisuje standardową procedurę: granice to obserwacje o rangach 0.025(n + 1) i 0.975(n + 1), z interpolacją, gdy ranga nie jest całkowita. W R odpowiada jej quantile(x, type = 6). Ważniejsze od wyboru wzoru są jednak trzy decyzje: kogo włączyć, ile osób zbadać i czy liczyć osobne przedziały dla podgrup.
Ile osób: przedział ufności granic
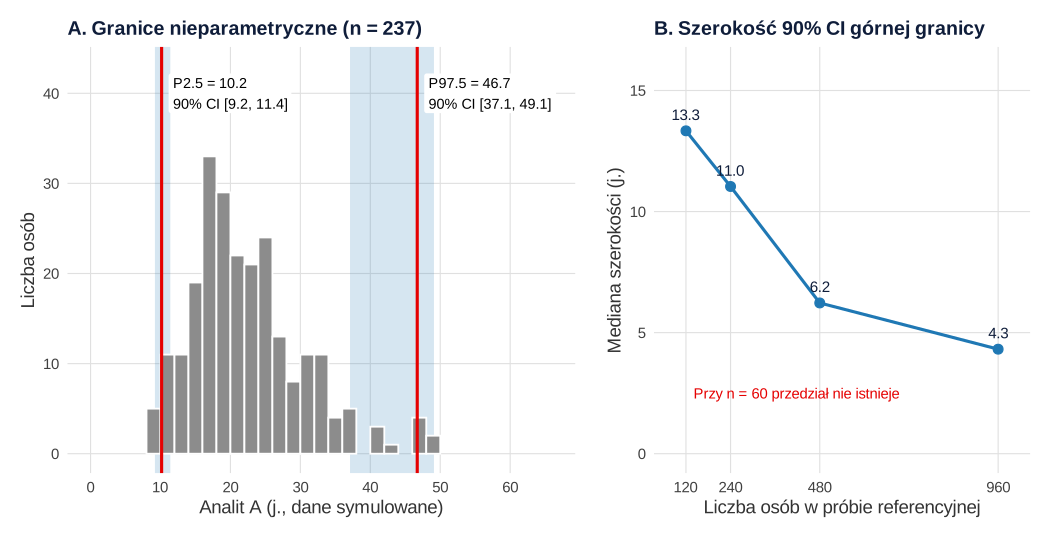
Każda granica jest oszacowaniem i ma własną niepewność. Nieparametryczny 90% przedział ufności dla percentyla 2.5 wyznacza się z rang obserwacji, a istnieje on dopiero wtedy, gdy najmniejsza obserwacja ma co najmniej 95% szans, by leżeć poniżej prawdziwego percentyla. Rachunek w R daje minimum 119 osób. Stąd bierze się spotykana w literaturze laboratoryjnej liczba około 120 osób na grupę – Linnet (2000) podaje ją właśnie jako warunek wyznaczenia 90% przedziałów ufności z posortowanych wartości i podkreśla, że przy małych i umiarkowanych próbach niepewność granic jest duża. Rysunek 1B pokazuje to na symulowanej populacji: przy 120 osobach mediana szerokości 90% CI górnej granicy wynosiła 13.3 j., przy 480 – 6.2 j., a przy 960 – 4.3 j. Czterokrotnie większa próba mniej więcej o połowę zwęża przedział.
Przykład: 240 osób i trzy wyniki odstające
Przykład: od 240 osób zakwalifikowanych jako zdrowe (120 kobiet i 120 mężczyzn) oznaczono analit A. Mediana wyniosła 21.4 j., a zakres od 8.6 do 118.0 j. Przed analizą przyjęto regułę wykluczania: wynik odstający to wartość poza płotami Tukeya (1.5 × IQR) po transformacji logarytmicznej. Reguła wskazała trzy wyniki: 96.0, 104.0 i 118.0 j. Horn i in. (2001) pokazali, że wartości odstające i osoby niezdrowe zdarzają się nawet w starannie dobranej grupie i poszerzają przedział. Tutaj górna granica spadła po ich wykluczeniu z 48.0 do 46.7 j. Reguła musi być jednak ustalona z góry i opisana, a każdy wykluczony wynik – wymieniony; więcej o tym, kiedy usuwanie jest uzasadnione, piszemy we wpisie czy można usunąć obserwacje odstające.
Dla 237 pozostałych osób przedział referencyjny wyniósł od 10.2 do 46.7 j. 90% przedział ufności dolnej granicy wyznaczony z rang to [9.2, 11.4], a górnej – [37.1, 49.1]; bootstrap dał bardzo podobne przedziały: [9.3, 11.4] i [37.3, 48.0]. Według Linneta (2000) wersja bootstrapowa daje nieco mniejsze błędy standardowe, ale przy bardzo małych próbach jej przedziały są zbyt optymistyczne. Górna granica jest wyraźnie mniej pewna niż dolna, bo prawy ogon rozkładu skośnego jest długi i rzadko obsadzony.
Metoda parametryczna i podział na podgrupy
Granice parametryczne po transformacji logarytmicznej wyniosły od 10.6 do 42.1 j. Górna granica jest wyraźnie niższa niż nieparametryczna, bo po zlogarytmowaniu połączona próba kobiet i mężczyzn nadal nie ma rozkładu normalnego. Metoda parametryczna jest dokładniejsza tylko wtedy, gdy jej założenie jest spełnione – sprawdź to, zanim jej użyjesz.
Mediany kobiet i mężczyzn różniły się wyraźnie, test Manna–Whitneya: p < .001. Sama istotność nie rozstrzyga jednak, czy liczyć osobne przedziały. Harris i Boyd (1990) pokazali, że podział na podgrupy może niewiele zmniejszać zmienność wyników, nawet gdy różnica średnich jest wysoce istotna statystycznie. Gdy jednak istnieje fizjologiczna podstawa podziału, osobne przedziały mogą być potrzebne, aby granice odcinały w każdej podgrupie zamierzone odsetki wyników niskich i wysokich. Sprawdź więc, czy wspólne granice odcinają w każdej podgrupie mniej więcej po 2.5% wyników na każdym końcu. Tu nie odcinały: poniżej wspólnej dolnej granicy znalazło się 4.2% kobiet i 0.0% mężczyzn, a powyżej górnej – 0.8% kobiet i 3.4% mężczyzn. Osobne przedziały wyniosły od 9.3 do 33.4 j. dla kobiet i od 12.8 do 47.5 j. dla mężczyzn. Uwaga praktyczna: po podziale każda podgrupa liczy około 119 osób, czyli tyle, ile minimum dla nieparametrycznego przedziału ufności. Planując badanie z podziałem, planuj liczebność dla każdej podgrupy osobno.
Projekt 4. Stabilność próbki w czasie przechowywania
Pytanie „czy analit jest stabilny przez 72 godziny w 4°C” brzmi jak zadanie dla testu t dla prób zależnych: wynik po przechowywaniu kontra wynik wyjściowy. To pułapka. Test istotności sprawdza, czy różnica jest różna od zera, a pytanie o stabilność dotyczy tego, czy różnica jest na tyle mała, że nie ma znaczenia. Brak istotności nie dowodzi stabilności (może wynikać z małej próby), a istotna różnica nie dowodzi niestabilności (może być bardzo mała). Właściwym narzędziem jest test równoważności TOST: najpierw ustalasz dopuszczalne odchylenie, np. ±5%, a potem sprawdzasz, czy 90% przedział ufności średniego odchylenia mieści się w tym marginesie. Schuirmann (1987) pokazał, że procedura dwóch testów jednostronnych prowadzi do tego samego wniosku co takie sprawdzenie przedziału 1 − 2α. Wybór marginesu i jego konsekwencje dla liczebności omawia wpis o badaniach non-inferiority i równoważności.
Przykład: 24 próbki zmierzono od razu po pobraniu i ponownie po 24 godzinach, 72 godzinach i 7 dniach przechowywania. Dla każdej próbki policzono odchylenie od wyniku wyjściowego w procentach. Margines ±5% przyjęto przed badaniem (wartość fikcyjna).
| Czas | M odchylenia (%) | SD | 90% CI | p (różnica od 0) | p TOST (±5%) | Wniosek |
|---|---|---|---|---|---|---|
| 24 h | 0.16 | 3.08 | [−0.91, 1.24] | .798 | < .001 | równoważne |
| 72 h | −3.20 | 2.55 | [−4.09, −2.30] | < .001 | .001 | różnica istotna, ale w marginesie |
| 7 dni | −6.76 | 2.90 | [−7.77, −5.74] | < .001 | .997 | poza marginesem |
Najciekawszy jest wiersz środkowy: po 72 godzinach wynik spadł istotnie, średnio o 3.20%, ale cały 90% przedział ufności mieści się w marginesie ±5%, więc w przyjętym kryterium próbkę można uznać za stabilną. Po 7 dniach przedział leży w całości poza marginesem. Gdybyś analizował tylko test t, uznałbyś próbkę za niestabilną już po 72 godzinach. Pomiary w kolejnych punktach czasu pochodzą od tych samych próbek, więc gdy punktów jest wiele albo zdarzają się braki, rozważ model mieszany z losowym efektem próbki.
Projekt 5. Retrospektywna analiza wyników z bazy laboratorium
Eksport z systemu laboratoryjnego to kuszące źródło danych: tysiące wyników bez zbierania próbek. Ma jednak dwie cechy, które psują analizę, jeśli ich nie zauważysz. Ogólne zasady pracy z dokumentacją (kryteria włączenia, karta zbierania danych, braki wpisów, zgody) opisuje wpis o analizie dokumentacji medycznej. Tu dwie sprawy typowe dla wyników laboratoryjnych.
Wielokrotne wyniki tej samej osoby
W przykładzie eksport z dwóch grup pacjentów (A i B) zawierał 1530 wyników od 600 pacjentów: część osób miała jedno oznaczenie, inne – do sześciu. Pacjenci z wieloma oznaczeniami zwykle różnią się od pozostałych (częściej są kontrolowani, bo coś jest nie tak), a ich wyniki są ze sobą skorelowane. Analiza 1530 wyników jak niezależnych obserwacji zawyżyłaby liczebność i dałaby tym pacjentom większą wagę. Najprostsze rozwiązanie: ustal z góry, który wynik bierzesz od każdej osoby (np. pierwszy w okresie badania). Gdy interesuje Cię zmiana w czasie, potrzebny jest model z losowym efektem pacjenta.
Wyniki „poniżej granicy oznaczalności”
Analizator nie podaje liczby, gdy stężenie jest zbyt niskie, by je wiarygodnie oznaczyć; w eksporcie zobaczysz wpis „<1.0”. Taki wynik nie jest brakiem danych ani zerem. To obserwacja cenzurowana lewostronnie: wiemy tylko, że wartość leży poniżej granicy. W przykładzie dotyczyło to 46.3% pierwszych wyników w grupie A i 27.3% w grupie B. Typowy odruch to podstawienie liczby: zera, granicy, połowy granicy. Helsel (2006) nazywa to wprost fabrykowaniem danych i pokazuje, że podstawianie może zarówno ukryć istniejące różnice, jak i stworzyć nieistniejące. Lubin i in. (2004) w symulacji stwierdzili, że podstawienie połowy granicy daje obciążone wyniki, chyba że takich pomiarów jest niewiele (5–10%), a nieobciążone oszacowania dają metody dla danych cenzurowanych, np. regresja Tobita, oraz imputacja wielokrotna.
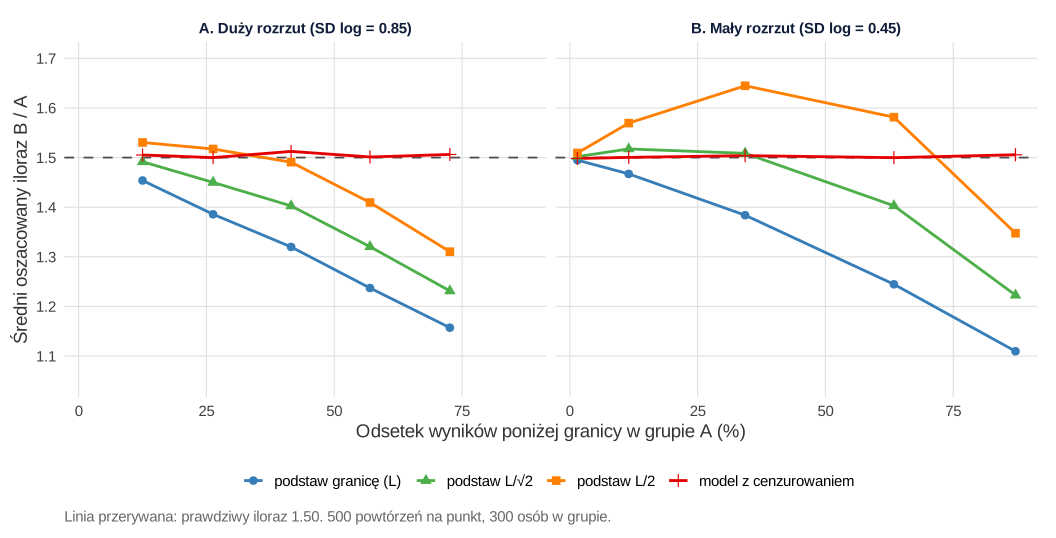
Ponieważ dane są symulowane, znamy prawdziwe wartości również poniżej granicy. Prawdziwy iloraz średnich geometrycznych grupy B do grupy A w tej próbie wynosił 1.72. Podstawienie granicy dało 1.46, podstawienie połowy granicy – 1.66, a model z lewostronnym cenzurowaniem na skali logarytmicznej – 1.75, 95% CI [1.49, 2.05]. Rysunek 2 pokazuje, że to nie przypadek jednej próby. Podstawienie granicy zaniża iloraz tym bardziej, im więcej wyników jest cenzurowanych. Podstawienie połowy granicy przy dużym rozrzucie wyników zaniżało go, a przy małym rozrzucie zawyżało – przy 34.3% wyników poniżej granicy średni iloraz wyniósł 1.64 zamiast 1.50. Model z cenzurowaniem trafiał w 1.50 we wszystkich warunkach.
Jeśli model z cenzurowaniem jest dla Ciebie za trudny, istnieje prostsza i uczciwa droga: test rangowy. Wszystkie wpisy „<1.0” są mniejsze od każdego zmierzonego wyniku, więc mogą dostać wspólną, najniższą rangę. Test Manna–Whitneya dał W = 30877.5, p < .001, przy medianach 1.1 j. w grupie A i 1.8 j. w grupie B. Medianę możesz podać, dopóki poniżej granicy jest mniej niż połowa wyników; jeśli więcej – raportuj odsetek wyników poniżej granicy. Zawsze podaj w pracy wartość granicy oznaczalności i liczbę takich wyników w każdej grupie. Samą granicę ustala producent lub laboratorium według przyjętej procedury; w pracy nie wyznaczaj jej na nowo bez promotora.
Projekt 6. Wartość diagnostyczna oznaczenia
Gdy pytanie brzmi „jak dobrze oznaczenie odróżnia osoby z chorobą od osób bez niej”, potrzebujesz rozpoznania ustalonego niezależnie od badanego oznaczenia (standardu referencyjnego) i analizy dokładności diagnostycznej. Krok po kroku – z krzywą ROC, tabelą progów i porównaniem dwóch testów – prowadzi poradnik krzywa ROC i punkt odcięcia, a liczebność próby omawia wpis o liczebności w badaniu dokładności diagnostycznej. Raport pisz według wytycznych STARD; Bossuyt i in. (2015) wymieniają w nich m.in. rozróżnienie progów ustalonych z góry i wybranych na podstawie danych.
Przykład: oznaczono analit A u 60 osób z chorobą i 90 osób bez niej. Pole pod krzywą ROC wyniosło AUC = .910, 95% CI [.862, .958]. Jako próg przyjęto z góry górną granicę przedziału referencyjnego z projektu 3 (46.7 j.). Czułość wyniosła 68.3% (41 z 60), 95% CI [55.0, 79.7], a swoistość 95.6% (86 z 90), 95% CI [89.0, 98.8]. Próg z przedziału referencyjnego nie jest „progiem diagnostycznym”: wyznaczono go u osób zdrowych, a swoistość mierzy się u osób bez choroby, które często mają inne schorzenia. Ransohoff i Feinstein (1978) pokazali, że zbyt wąskie spektrum badanych – np. wyraźnie chorzy wobec zdrowych ochotników – daje fałszywie wysoką czułość i swoistość (zob. błąd spektrum). Opisz więc dokładnie, skąd pochodzą obie grupy.
Jak opisać analizę w pracy z analityki medycznej
Rozdział o metodach w pracy laboratoryjnej ma dwie części: opis procedury pomiarowej (materiał, aparat i odczynniki w zakresie dopuszczonym przez laboratorium, kalibracja, kontrola jakości) i opis analizy statystycznej. W drugiej części podaj strukturę danych (dni, serie, powtórzenia, próbki, pacjenci), kryteria akceptacji wraz z ich źródłem, regułę wykluczania wyników i sposób postępowania z wynikami poniżej granicy oznaczalności. Poniżej wzór akapitu dla projektów 2, 3 i 4; gotowe zdania z wynikami możesz porównać z wynikiem generatora opisu wyników APA.
Jeśli Twoja praca łączy pomiary z niepewnością pomiaru w sensie metrologicznym, zajrzyj też do wpisu o statystyce w pracy inżynierskiej. Odczyt wyników testów diagnostycznych i przedziałów możesz przećwiczyć na zadaniach ze statystyki medycznej. Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: precyzja, przedział referencyjny i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1 z pełną analizą precyzji: od opisu wyników, przez model z losowym dniem i serią, przedziały ufności składowych i weryfikację deklaracji, po typowy błąd. Przepis 1 zapisuje też dane do pobrania (CSV). Przepis 2 dotyczy przedziału referencyjnego, przepis 3 – pozostałych projektów, a przepis 4 – symulacji, z których powstały rysunki. Każdy projekt tworzy własne dane symulowane; parametry (wielkości składowych zmienności, przesunięcia, odsetki) ustawiono ręcznie tak, by ilustrowały opisane sytuacje.
1. Projekt 2: precyzja – model z losowym dniem i serią
R
# Projekt 2: precyzja analizatora – powtarzalność, precyzja między seriami i między dniami (dane symulowane).
# Materiał kontrolny jednego poziomu, 20 dni × 2 serie dziennie × 2 powtórzenia w serii = 80 wyników.
suppressPackageStartupMessages(library(lme4))
set.seed(52501)
dni <- 20; serie <- 2; powt <- 2
d <- expand.grid(powtorzenie = 1:powt, seria = 1:serie, dzien = 1:dni)
d$dzien <- factor(sprintf("D%02d", d$dzien))
d$seria_dnia <- factor(paste(d$dzien, d$seria, sep = "-"))
efekt_dnia <- rnorm(dni, 0, 0.060)                 # zmienność między dniami
efekt_serii <- rnorm(dni * serie, 0, 0.040)        # zmienność między seriami w obrębie dnia
d$wynik <- round(5.20 + efekt_dnia[as.integer(d$dzien)] + efekt_serii[as.integer(d$seria_dnia)] +
                 rnorm(nrow(d), 0, 0.080), 2)      # błąd w serii (powtarzalność)
write.csv(d[c("dzien", "seria", "powtorzenie", "wynik")], "analityka-precyzja-dane.csv", row.names = FALSE)

# Krok 1. Opis wyników
round(c(N = nrow(d), M = mean(d$wynik), SD_wszystkich = sd(d$wynik)), 3)

# Krok 2. Model z losowym dniem i losową serią zagnieżdżoną w dniu (REML)
m <- lmer(wynik ~ 1 + (1 | dzien) + (1 | seria_dnia), data = d, REML = TRUE)
vc <- as.data.frame(VarCorr(m))
sd_dzien <- vc$sdcor[vc$grp == "dzien"]; sd_seria <- vc$sdcor[vc$grp == "seria_dnia"]
sd_powt <- vc$sdcor[vc$grp == "Residual"]
sd_lab <- sqrt(sd_dzien^2 + sd_seria^2 + sd_powt^2)      # precyzja wewnątrzlaboratoryjna
srednia <- fixef(m)[[1]]
skladowe <- data.frame(
  skladowa = c("powtarzalność (w serii)", "między seriami", "między dniami", "wewnątrzlaboratoryjna (razem)"),
  SD = round(c(sd_powt, sd_seria, sd_dzien, sd_lab), 3),
  CV_proc = round(100 * c(sd_powt, sd_seria, sd_dzien, sd_lab) / srednia, 2),
  udzial_wariancji_proc = round(100 * c(sd_powt, sd_seria, sd_dzien, sd_lab)^2 / sd_lab^2, 1))
print(skladowe, row.names = FALSE)
round(srednia, 3)

# Krok 3. 95% CI dla odchyleń standardowych (profil wiarygodności)
ci <- suppressMessages(confint(m, parm = "theta_", method = "profile"))
rownames(ci) <- c("SD między seriami", "SD między dniami", "SD powtarzalności")   # kolejność jak w modelu
round(ci, 3)

# Krok 4. Weryfikacja deklaracji producenta: CV powtarzalności ≤ 2.0% (wartość fikcyjna)
df_powt <- nrow(d) - nlevels(d$seria_dnia)                # 80 − 40 = 40 stopni swobody
sd_deklar <- 0.020 * srednia
statystyka <- df_powt * sd_powt^2 / sd_deklar^2
round(c(df = df_powt, chi2 = statystyka, gorna_granica_95 = qchisq(.95, df_powt),
        p = pchisq(statystyka, df_powt, lower.tail = FALSE)), 3)

# Krok 5. Błąd: powtarzalność policzona jako SD wszystkich 80 wyników
round(c(SD_wszystkich = sd(d$wynik), CV_wszystkich_proc = 100 * sd(d$wynik) / mean(d$wynik),
        CV_powtarzalnosci_proc = 100 * sd_powt / srednia), 2)
Wynik w R
            N             M SD_wszystkich
       80.000         5.189         0.129
                      skladowa    SD CV_proc udzial_wariancji_proc
       powtarzalność (w serii) 0.068    1.32                  27.3
                między seriami 0.057    1.09                  18.8
                 między dniami 0.096    1.85                  53.9
 wewnątrzlaboratoryjna (razem) 0.131    2.52                 100.0
[1] 5.189
                  2.5 % 97.5 %
SD między seriami 0.021  0.094
SD między dniami  0.055  0.141
SD powtarzalności 0.056  0.086
              df             chi2 gorna_granica_95                p
          40.000           17.311           55.758            0.999
         SD_wszystkich     CV_wszystkich_proc CV_powtarzalnosci_proc
                  0.13                   2.49                   1.32
2. Projekt 3: przedział referencyjny – granice, przedziały ufności, podgrupy
R
# Projekt 3: przedział referencyjny analitu A – percentyle 2.5 i 97.5 (dane symulowane, jednostki umowne j.).
# 240 osób zakwalifikowanych jako zdrowe (120 kobiet, 120 mężczyzn); rozkład prawoskośny; 3 wyniki odstające.
set.seed(52502)
n_k <- 120; n_m <- 120
ref <- data.frame(id = sprintf("R%03d", 1:(n_k + n_m)), plec = rep(c("K", "M"), c(n_k, n_m)))
ref$wynik <- round(exp(rnorm(nrow(ref), ifelse(ref$plec == "K", log(18), log(24)), 0.32)), 1)
ref$wynik[c(17, 133, 201)] <- c(96.0, 118.0, 104.0)        # np. osoby z nierozpoznaną chorobą

# Krok 1. Opis i reguła wykluczania ustalona przed analizą: płoty Tukeya (1.5 × IQR) na skali log
round(c(N = nrow(ref), Mediana = median(ref$wynik), Min = min(ref$wynik), Max = max(ref$wynik)), 1)
lw <- log(ref$wynik); q <- quantile(lw, c(.25, .75))
odstajace <- lw < q[1] - 1.5 * diff(q) | lw > q[2] + 1.5 * diff(q)
ref[odstajace, ]
czyste <- ref[!odstajace, ]

# Krok 2. Granice nieparametryczne: percentyle 2.5 i 97.5 z rang p(n + 1) (type = 6)
granice <- function(x) quantile(x, c(.025, .975), type = 6, names = FALSE)
round(rbind(z_odstajacymi = granice(ref$wynik), bez_odstajacych = granice(czyste$wynik)), 1)

# Krok 3. 90% CI granic z rang statystyk pozycyjnych (rozkład dwumianowy) i z bootstrapu
ci_rangi <- function(x, p, poziom = .90) {
  x <- sort(x); n <- length(x); a <- (1 - poziom) / 2
  c(x[max(1, qbinom(a, n, p))], x[min(n, qbinom(1 - a, n, p) + 1)])
}
x <- czyste$wynik
boot_gr <- replicate(2000, granice(sample(x, replace = TRUE)))
round(rbind(dolna_rangi = ci_rangi(x, .025), dolna_bootstrap = quantile(boot_gr[1, ], c(.05, .95), names = FALSE),
            gorna_rangi = ci_rangi(x, .975), gorna_bootstrap = quantile(boot_gr[2, ], c(.05, .95), names = FALSE)), 1)

# Krok 4. Najmniejsza liczebność, przy której istnieje nieparametryczny 90% CI dla granicy 2.5%
n_min <- min(which(1 - 0.975^(1:500) >= 0.95))
n_min

# Krok 5. Metoda parametryczna po transformacji logarytmicznej (porównanie)
m_log <- mean(log(x)); s_log <- sd(log(x))
round(exp(m_log + c(-1, 1) * qnorm(.975) * s_log), 1)

# Krok 6. Czy osobne przedziały dla płci? Granice w podgrupach i test różnicy median
round(rbind(K = granice(x[czyste$plec == "K"]), M = granice(x[czyste$plec == "M"])), 1)
table(czyste$plec)
w <- wilcox.test(wynik ~ plec, data = czyste, exact = FALSE)
signif(w$p.value, 3)
# Ile osób każdej płci wypadłoby poza wspólne granice?
wsp <- granice(x)
sapply(split(x, czyste$plec), function(v) round(100 * c(ponizej = mean(v < wsp[1]), powyzej = mean(v > wsp[2])), 1))
Wynik w R
      N Mediana     Min     Max
  240.0    21.4     8.6   118.0
      id plec wynik
17  R017    K    96
133 R133    M   118
201 R201    M   104
                [,1] [,2]
z_odstajacymi   10.2 48.0
bez_odstajacych 10.2 46.7
                [,1] [,2]
dolna_rangi      9.2 11.4
dolna_bootstrap  9.3 11.4
gorna_rangi     37.1 49.1
gorna_bootstrap 37.3 48.0
[1] 119
[1] 10.6 42.1
  [,1] [,2]
K  9.3 33.4
M 12.8 47.5

  K   M
119 118
[1] 2.87e-09
          K   M
ponizej 4.2 0.0
powyzej 0.8 3.4
3. Projekty 1, 4, 5 i 6: analizatory, stabilność, baza laboratorium, ROC
R
# Projekty 1, 4, 5 i 6: porównanie analizatorów, stabilność próbki, baza laboratorium, wartość diagnostyczna.
# Wszystkie dane są symulowane, jednostki umowne (j.).
suppressPackageStartupMessages({ library(survival); library(pROC) })
bz <- function(x, k = 3) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", k, "f"), x))

cat("PROJEKT 1. DWA ANALIZATORY: RÓŻNICE BEZWZGLĘDNE I PROCENTOWE\n")
set.seed(52503)
n <- 100
prawda <- exp(runif(n, log(2), log(40)))                       # zakres stężeń od 2 do 40 j.
stary <- round(prawda * (1 + rnorm(n, 0, .03)), 2)
nowy <- round(prawda * 1.03 * (1 + rnorm(n, 0, .03)), 2)       # nowy zawyża o ok. 3%
sr <- (nowy + stary) / 2; roz <- nowy - stary; proc <- 100 * roz / sr
loa <- function(r) { m <- mean(r); s <- sd(r); se <- sqrt(3 * s^2 / length(r))   # SE granicy (Bland i Altman)
  c(srednia = m, dolna = m - 1.96 * s, gorna = m + 1.96 * s, CI_gornej_d = m + 1.96 * s - 1.98 * se,
    CI_gornej_g = m + 1.96 * s + 1.98 * se) }
cat("r =", bz(cor(nowy, stary)), "\n")
round(rbind(bezwzgledne_j = loa(roz), procentowe = loa(proc)), 2)
nach <- summary(lm(abs(roz) ~ sr))$coefficients[2, ]           # czy rozrzut różnic rośnie ze stężeniem?
signif(nach, 3)

cat("\nPROJEKT 4. STABILNOŚĆ PRÓBKI: ODCHYLENIE OD WYNIKU WYJŚCIOWEGO, MARGINES ±5%\n")
set.seed(52504)
k <- 24
wyj <- exp(rnorm(k, log(15), .4))
czasy <- c("24 h" = -0.5, "72 h" = -2.8, "7 dni" = -6.0)       # prawdziwy średni dryf w %
stab <- t(sapply(names(czasy), function(cz) {
  pomiar <- wyj * (1 + rnorm(k, czasy[[cz]], 2.6) / 100)
  odch <- 100 * (pomiar - wyj) / wyj
  t0 <- t.test(odch)                                            # test „czy różni się od zera”
  p_dol <- t.test(odch, mu = -5, alternative = "greater")$p.value
  p_gor <- t.test(odch, mu = 5, alternative = "less")$p.value
  ci90 <- t.test(odch, conf.level = .90)$conf.int
  c(M = mean(odch), SD = sd(odch), CI90_d = ci90[1], CI90_g = ci90[2],
    p_rozne_od_0 = t0$p.value, p_TOST = max(p_dol, p_gor))
}))
print(data.frame(round(stab[, 1:4], 2), p_rozne_od_0 = signif(stab[, 5], 3), p_TOST = signif(stab[, 6], 3)))

cat("\nPROJEKT 5. BAZA LABORATORIUM: POWTÓRZONE WYNIKI I WARTOŚCI PONIŻEJ GRANICY OZNACZALNOŚCI\n")
set.seed(52505)
pac <- data.frame(id = 1:600, grupa = rep(c("A", "B"), each = 300))
pac$poziom <- rnorm(600, ifelse(pac$grupa == "A", log(1.2), log(1.8)), .8)  # osobniczy poziom (log)
pac$liczba <- sample(1:6, 600, replace = TRUE, prob = c(.35, .25, .15, .1, .1, .05))
baza <- pac[rep(1:600, pac$liczba), c("id", "grupa", "poziom")]
baza$kolejny <- ave(baza$id, baza$id, FUN = seq_along)
baza$prawda <- exp(baza$poziom + rnorm(nrow(baza), 0, .35))
LOQ <- 1.0
baza$zapis <- ifelse(baza$prawda < LOQ, "<1.0", sprintf("%.1f", baza$prawda))   # tak wygląda eksport
c(wyniki = nrow(baza), pacjenci = length(unique(baza$id)))
pierwszy <- baza[baza$kolejny == 1, ]
pierwszy$cenz <- pierwszy$zapis == "<1.0"
pierwszy$y <- ifelse(pierwszy$cenz, LOQ, as.numeric(sub("<", "", pierwszy$zapis)))
round(100 * tapply(pierwszy$cenz, pierwszy$grupa, mean), 1)
iloraz <- function(y, g) exp(diff(tapply(log(y), g, mean)))     # iloraz średnich geometrycznych B / A
pod <- function(w) ifelse(pierwszy$cenz, w, pierwszy$y)
tob <- survreg(Surv(log(y), !cenz, type = "left") ~ grupa, data = pierwszy, dist = "gaussian")
ci_tob <- exp(coef(tob)[2] + c(-1.96, 1.96) * sqrt(vcov(tob)[2, 2]))
round(c(prawdziwy_w_danych = iloraz(pierwszy$prawda, pierwszy$grupa)[[1]],
        podstawienie_LOQ = iloraz(pod(LOQ), pierwszy$grupa)[[1]],
        podstawienie_LOQ_przez_2 = iloraz(pod(LOQ / 2), pierwszy$grupa)[[1]],
        model_z_cenzurowaniem = exp(coef(tob)[[2]]), CI_d = ci_tob[1], CI_g = ci_tob[2]), 2)
mw <- wilcox.test(y ~ grupa, data = pierwszy, exact = FALSE)    # „<1.0” to najniższe, wspólne rangi
round(c(mediana_A = median(pierwszy$y[pierwszy$grupa == "A"]),
        mediana_B = median(pierwszy$y[pierwszy$grupa == "B"]), W = unname(mw$statistic)), 2)
signif(mw$p.value, 3)
# Błąd: wszystkie wyniki jako niezależne obserwacje (pacjenci z wieloma oznaczeniami ważą więcej)
round(c(N_wszystkie = nrow(baza), N_pierwsze = nrow(pierwszy)), 0)

cat("\nPROJEKT 6. WARTOŚĆ DIAGNOSTYCZNA: AUC I PRÓG USTALONY Z GÓRY\n")
set.seed(52506)
dg <- data.frame(stan = rep(c("bez choroby", "choroba"), c(90, 60)))
dg$wynik <- round(exp(rnorm(150, ifelse(dg$stan == "choroba", log(55), log(27)), ifelse(dg$stan == "choroba", .45, .40))), 1)
roc_a <- roc(dg$stan, dg$wynik, levels = c("bez choroby", "choroba"), direction = "<", quiet = TRUE)
ci_auc <- ci.auc(roc_a, method = "delong")
round(c(AUC = as.numeric(auc(roc_a)), CI_d = ci_auc[1], CI_g = ci_auc[3]), 3)
prog <- 46.7                                                    # górna granica referencyjna z projektu 3
tp <- sum(dg$wynik > prog & dg$stan == "choroba"); fn <- sum(dg$wynik <= prog & dg$stan == "choroba")
tn <- sum(dg$wynik <= prog & dg$stan == "bez choroby"); fp <- sum(dg$wynik > prog & dg$stan == "bez choroby")
wsk <- rbind(czulosc = c(tp / (tp + fn), binom.test(tp, tp + fn)$conf.int),     # CI Cloppera–Pearsona
             swoistosc = c(tn / (tn + fp), binom.test(tn, tn + fp)$conf.int))
colnames(wsk) <- c("wartosc", "CI_d", "CI_g")
round(wsk, 3)
c(TP = tp, FN = fn, TN = tn, FP = fp)
Wynik w R
PROJEKT 1. DWA ANALIZATORY: RÓŻNICE BEZWZGLĘDNE I PROCENTOWE
r = .997
              srednia dolna gorna CI_gornej_d CI_gornej_g
bezwzgledne_j     0.5 -1.41  2.40        2.07        2.73
procentowe        3.1 -4.83 11.03        9.64       12.41
  Estimate Std. Error    t value   Pr(>|t|)
  5.49e-02   6.03e-03   9.10e+00   1.09e-14

PROJEKT 4. STABILNOŚĆ PRÓBKI: ODCHYLENIE OD WYNIKU WYJŚCIOWEGO, MARGINES ±5%
          M   SD CI90_d CI90_g p_rozne_od_0   p_TOST
24 h   0.16 3.08  -0.91   1.24     7.98e-01 4.05e-08
72 h  -3.20 2.55  -4.09  -2.30     2.96e-06 1.06e-03
7 dni -6.76 2.90  -7.77  -5.74     5.76e-11 9.97e-01

PROJEKT 5. BAZA LABORATORIUM: POWTÓRZONE WYNIKI I WARTOŚCI PONIŻEJ GRANICY OZNACZALNOŚCI
  wyniki pacjenci
    1530      600
   A    B
46.3 27.3
      prawdziwy_w_danych         podstawienie_LOQ podstawienie_LOQ_przez_2    model_z_cenzurowaniem
                    1.72                     1.46                     1.66                     1.75
                    CI_d                     CI_g
                    1.49                     2.05
mediana_A mediana_B         W
      1.1       1.8   30877.5
[1] 6.78e-12
N_wszystkie  N_pierwsze
       1530         600

PROJEKT 6. WARTOŚĆ DIAGNOSTYCZNA: AUC I PRÓG USTALONY Z GÓRY
  AUC  CI_d  CI_g
0.910 0.862 0.958
          wartosc CI_d  CI_g
czulosc     0.683 0.55 0.797
swoistosc   0.956 0.89 0.988
TP FN TN FP
41 19 86  4
4. Symulacje do rysunków 1B i 2
R
# Dwie symulacje do rysunków: (A) szerokość 90% CI górnej granicy referencyjnej a liczebność,
# (B) iloraz średnich geometrycznych przy różnym odsetku wyników poniżej granicy oznaczalności.
suppressPackageStartupMessages(library(survival))
ci_rangi <- function(x, p, poziom = .90) {
  x <- sort(x); n <- length(x); a <- (1 - poziom) / 2
  r <- qbinom(a, n, p); s <- qbinom(1 - a, n, p) + 1
  if (r < 1 || s > n) return(c(NA, NA))                       # przedział nie istnieje
  c(x[r], x[s])
}
populacja <- function(n) exp(rnorm(n, ifelse(runif(n) < .5, log(18), log(24)), .32))

cat("A. SZEROKOŚĆ 90% CI GÓRNEJ GRANICY (P97.5) – 1000 PRÓB NA KAŻDĄ LICZEBNOŚĆ\n")
set.seed(52507)
liczebnosci <- c(60, 120, 240, 480, 960)
szer <- t(sapply(liczebnosci, function(n) {
  w <- replicate(1000, diff(ci_rangi(populacja(n), .975)))
  c(n = n, CI_istnieje_proc = 100 * mean(!is.na(w)), mediana_szerokosci = median(w, na.rm = TRUE))
}))
print(round(szer, 1))

cat("\nB. ILORAZ ŚREDNICH GEOMETRYCZNYCH B / A (PRAWDA = 1.50) – 300 OSÓB NA GRUPĘ, 500 POWTÓRZEŃ\n")
set.seed(52508)
loq_y <- c(0.45, 0.7, 1.0, 1.4, 2.0)                           # coraz wyższa granica oznaczalności
symuluj <- function(L, s_log) {
  sym <- replicate(500, {
    g <- rep(c("A", "B"), each = 300)
    y <- exp(rnorm(600, ifelse(g == "A", log(1.2), log(1.8)), s_log))
    c_ <- y < L; yo <- ifelse(c_, L, y)
    ilo <- function(v) exp(mean(log(v[g == "B"])) - mean(log(v[g == "A"])))
    tob <- survreg(Surv(log(yo), !c_, type = "left") ~ g, dist = "gaussian")
    c(cenz_A = 100 * mean(c_[g == "A"]), LOQ = ilo(ifelse(c_, L, y)), LOQ_2 = ilo(ifelse(c_, L / 2, y)),
      LOQ_pierw2 = ilo(ifelse(c_, L / sqrt(2), y)), model = exp(coef(tob)[[2]]))
  })
  data.frame(SD_log = s_log, granica = L, t(rowMeans(sym)))
}
wyniki_cenz <- do.call(rbind, c(lapply(loq_y, symuluj, s_log = .85), lapply(loq_y, symuluj, s_log = .45)))
print(round(wyniki_cenz, 2), row.names = FALSE)
Wynik w R
A. SZEROKOŚĆ 90% CI GÓRNEJ GRANICY (P97.5) – 1000 PRÓB NA KAŻDĄ LICZEBNOŚĆ
       n CI_istnieje_proc mediana_szerokosci
[1,]  60                0                 NA
[2,] 120              100               13.3
[3,] 240              100               11.0
[4,] 480              100                6.2
[5,] 960              100                4.3

B. ILORAZ ŚREDNICH GEOMETRYCZNYCH B / A (PRAWDA = 1.50) – 300 OSÓB NA GRUPĘ, 500 POWTÓRZEŃ
 SD_log granica cenz_A  LOQ LOQ_2 LOQ_pierw2 model
   0.85    0.45  12.50 1.45  1.53       1.49  1.51
   0.85    0.70  26.30 1.39  1.52       1.45  1.50
   0.85    1.00  41.56 1.32  1.49       1.40  1.51
   0.85    1.40  56.99 1.24  1.41       1.32  1.50
   0.85    2.00  72.62 1.16  1.31       1.23  1.51
   0.45    0.45   1.48 1.49  1.51       1.50  1.50
   0.45    0.70  11.51 1.47  1.57       1.52  1.50
   0.45    1.00  34.29 1.38  1.64       1.51  1.50
   0.45    1.40  63.40 1.24  1.58       1.40  1.50
   0.45    2.00  87.18 1.11  1.35       1.22  1.51
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje quantile(), t.test(), wilcox.test(), binom.test() i lm() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, Article 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z analityki medycznej
- Korelacja jako dowód zgodności analizatorów. W przykładzie r = .997, a górna granica zgodności przekroczyła kryterium ±10%.
- Granice zgodności w jednostkach bezwzględnych, gdy błąd rośnie ze stężeniem – zbyt szerokie dla niskich i zbyt wąskie dla wysokich wyników.
- Kryterium akceptacji wybrane po obejrzeniu wyników albo bez podania źródła.
- Odchylenie standardowe wszystkich wyników opisane jako powtarzalność. Tu CV = 2.49% zamiast 1.32%.
- Precyzja z jednej serii nazwana precyzją wewnątrzlaboratoryjną – pominięta zmienność między dniami, która odpowiadała tu za 53.9% wariancji.
- Przedział referencyjny z kilkudziesięciu osób bez przedziałów ufności granic. Poniżej 119 osób nieparametryczny 90% CI granicy 2.5% nie istnieje.
- Osobne przedziały dla podgrup tylko dlatego, że test wyszedł istotny – albo wspólny przedział, który w jednej podgrupie odcina 4% wyników, a w drugiej 0%.
- „Brak istotnej różnicy, więc próbka jest stabilna”. Stabilność wykazuje się testem równoważności względem marginesu ustalonego z góry.
- Wszystkie wyniki z bazy jako niezależne obserwacje – 1530 wyników to w przykładzie tylko 600 pacjentów.
- Zero, granica lub połowa granicy w miejsce wyniku „<granica” bez informacji, ilu wyników to dotyczy.
- Próg diagnostyczny wybrany na tych samych danych, na których podajesz czułość i swoistość, albo grupa porównawcza złożona tylko ze zdrowych ochotników.
- Interpretacja kliniczna wyników pojedynczych pacjentów w pracy, której celem jest ocena metody.
Najczęstsze pytania
Jak policzyć powtarzalność i precyzję między dniami w pracy z analityki?
Zmierz materiał kontrolny w kilku powtórzeniach w serii, w kilku seriach i przez kilkanaście–kilkadziesiąt dni, a składowe zmienności oszacuj modelem mieszanym z losowym efektem dnia i serii. Każde odchylenie standardowe podziel przez średnią, aby otrzymać CV. Nie licz powtarzalności jako odchylenia wszystkich wyników – w przykładzie z tego wpisu dawało to 2.49% zamiast 1.32%.
Ile osób potrzeba do wyznaczenia przedziału referencyjnego?
Przy metodzie nieparametrycznej 90% przedział ufności granicy 2.5% da się wyznaczyć z rang dopiero od 119 osób, stąd często spotykana liczba około 120 osób na grupę. Jeśli planujesz osobne przedziały dla kobiet i mężczyzn, ta liczba dotyczy każdej podgrupy. Większa próba wyraźnie zwęża przedziały ufności granic.
Co zrobić z wynikami „poniżej granicy oznaczalności” w analizie statystycznej?
Nie zastępuj ich zerem, granicą ani połową granicy, bo takie podstawienie może zarówno ukryć, jak i stworzyć różnice. Traktuj je jako obserwacje cenzurowane lewostronnie: użyj modelu z cenzurowaniem albo testu rangowego, w którym wszystkie takie wyniki dostają wspólną najniższą rangę. Podaj w pracy granicę oznaczalności i liczbę takich wyników w każdej grupie.
Jak wykazać w pracy, że próbka jest stabilna w czasie przechowywania?
Ustal przed badaniem dopuszczalne odchylenie od wyniku wyjściowego, np. ±5%, i sprawdź, czy 90% przedział ufności średniego odchylenia mieści się w tym marginesie (test równoważności TOST). Sam brak istotnej różnicy nie dowodzi stabilności, a istotna różnica nie dowodzi niestabilności, jeśli jest mała.
Powiązane hasła
Przeczytaj też
Zgodność dwóch metod pomiaru: CCC, Deming, Passing–Bablok
CCC Lina, regresja Deminga i Passinga–Babloka, błąd stały i proporcjonalny, bootstrapowe przedziały ufności, przykład w R i wzór opisu.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z analityki medycznej i nie wiesz, jak policzyć wyniki?
Pomożemy dobrać analizy do Twoich danych – porównania analizatorów, badania precyzji, przedziału referencyjnego, stabilności albo eksportu z bazy laboratorium – policzyć je z przedziałami ufności i wyjaśnić tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (1999). Measuring agreement in method comparison studies. Statistical Methods in Medical Research, 8(2), 135–160. https://doi.org/10.1177/096228029900800204
- Bossuyt, P. M., Reitsma, J. B., Bruns, D. E., Gatsonis, C. A., Glasziou, P. P., Irwig, L., Lijmer, J. G., Moher, D., Rennie, D., de Vet, H. C. W., Kressel, H. Y., Rifai, N., Golub, R. M., Altman, D. G., Hooft, L., Korevaar, D. A., & Cohen, J. F. (2015). STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies. BMJ, 351, Article h5527. https://doi.org/10.1136/bmj.h5527 ● Otwarty dostęp
- Giavarina, D. (2015). Understanding Bland Altman analysis. Biochemia Medica, 25(2), 141–151. https://doi.org/10.11613/bm.2015.015 ● Otwarty dostęp
- Harris, E. K., & Boyd, J. C. (1990). On dividing reference data into subgroups to produce separate reference ranges. Clinical Chemistry, 36(2), 265–270. https://doi.org/10.1093/clinchem/36.2.265
- Helsel, D. R. (2006). Fabricating data: How substituting values for nondetects can ruin results, and what can be done about it. Chemosphere, 65(11), 2434–2439. https://doi.org/10.1016/j.chemosphere.2006.04.051
- Horn, P. S., Feng, L., Li, Y., & Pesce, A. J. (2001). Effect of outliers and nonhealthy individuals on reference interval estimation. Clinical Chemistry, 47(12), 2137–2145. https://doi.org/10.1093/clinchem/47.12.2137
- Linnet, K. (2000). Nonparametric estimation of reference intervals by simple and bootstrap-based procedures. Clinical Chemistry, 46(6), 867–869. https://doi.org/10.1093/clinchem/46.6.867
- Lubin, J. H., Colt, J. S., Camann, D., Davis, S., Cerhan, J. R., Severson, R. K., Bernstein, L., & Hartge, P. (2004). Epidemiologic evaluation of measurement data in the presence of detection limits. Environmental Health Perspectives, 112(17), 1691–1696. https://doi.org/10.1289/ehp.7199 ● Otwarty dostęp
- Ransohoff, D. F., & Feinstein, A. R. (1978). Problems of spectrum and bias in evaluating the efficacy of diagnostic tests. New England Journal of Medicine, 299(17), 926–930. https://doi.org/10.1056/nejm197810262991705
- Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657–680. https://doi.org/10.1007/BF01068419 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bland1999measuring, author={Bland, J. Martin and Altman, Douglas G.}, title={{Measuring agreement in method comparison studies}}, journal={Statistical Methods in Medical Research}, year={1999}, volume={8}, number={2}, pages={135--160}, doi={10.1177/096228029900800204}}@article{bossuyt2015stard, author={Bossuyt, Patrick M. and Reitsma, Johannes B. and Bruns, David E. and Gatsonis, Constantine A. and Glasziou, Paul P. and Irwig, Les and Lijmer, Jeroen G. and Moher, David and Rennie, Drummond and de Vet, Henrica C. W. and Kressel, Herbert Y. and Rifai, Nader and Golub, Robert M. and Altman, Douglas G. and Hooft, Lotty and Korevaar, Daniël A. and Cohen, Jérémie F.}, title={{STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies}}, journal={BMJ}, year={2015}, volume={351}, eid={h5527}, doi={10.1136/bmj.h5527}}@article{giavarina2015understanding, author={Giavarina, Davide}, title={{Understanding Bland Altman analysis}}, journal={Biochemia Medica}, year={2015}, volume={25}, number={2}, pages={141--151}, doi={10.11613/bm.2015.015}}@article{harris1990dividing, author={Harris, E. K. and Boyd, J. C.}, title={{On dividing reference data into subgroups to produce separate reference ranges}}, journal={Clinical Chemistry}, year={1990}, volume={36}, number={2}, pages={265--270}, doi={10.1093/clinchem/36.2.265}}@article{helsel2006fabricating, author={Helsel, Dennis R.}, title={{Fabricating data: How substituting values for nondetects can ruin results, and what can be done about it}}, journal={Chemosphere}, year={2006}, volume={65}, number={11}, pages={2434--2439}, doi={10.1016/j.chemosphere.2006.04.051}}@article{horn2001effect, author={Horn, Paul S. and Feng, Lan and Li, Yanmei and Pesce, Amadeo J.}, title={{Effect of outliers and nonhealthy individuals on reference interval estimation}}, journal={Clinical Chemistry}, year={2001}, volume={47}, number={12}, pages={2137--2145}, doi={10.1093/clinchem/47.12.2137}}@article{linnet2000nonparametric, author={Linnet, Kristian}, title={{Nonparametric estimation of reference intervals by simple and bootstrap-based procedures}}, journal={Clinical Chemistry}, year={2000}, volume={46}, number={6}, pages={867--869}, doi={10.1093/clinchem/46.6.867}}@article{lubin2004epidemiologic, author={Lubin, Jay H. and Colt, Joanne S. and Camann, David and Davis, Scott and Cerhan, James R. and Severson, Richard K. and Bernstein, Leslie and Hartge, Patricia}, title={{Epidemiologic evaluation of measurement data in the presence of detection limits}}, journal={Environmental Health Perspectives}, year={2004}, volume={112}, number={17}, pages={1691--1696}, doi={10.1289/ehp.7199}}@article{ransohoff1978problems, author={Ransohoff, David F. and Feinstein, Alvan R.}, title={{Problems of spectrum and bias in evaluating the efficacy of diagnostic tests}}, journal={New England Journal of Medicine}, year={1978}, volume={299}, number={17}, pages={926--930}, doi={10.1056/nejm197810262991705}}@article{schuirmann1987comparison, author={Schuirmann, Donald J.}, title={{A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability}}, journal={Journal of Pharmacokinetics and Biopharmaceutics}, year={1987}, volume={15}, number={6}, pages={657--680}, doi={10.1007/bf01068419}}