Dlaczego w badaniu diagnostycznym zwykle brakuje chorych
Badanie dokładności diagnostycznej porównuje wynik nowego testu ze standardem referencyjnym. Może to być krótka skala przesiewowa depresji sprawdzana ustrukturyzowanym wywiadem klinicznym. Liczebność planuje się tu inaczej niż w badaniu z hipotezą o różnicy średnich. Czułość szacujesz tylko na osobach chorych, a swoistość tylko na zdrowych. Precyzja każdej z tych miar zależy więc od liczby osób w jednej z dwóch grup, a nie od całego N.
W praktyce o tym się zapomina. Bachmann i in. (2006) przejrzeli badania diagnostyczne opublikowane w 2002 roku w ośmiu czołowych czasopismach. Mediana liczebności wyniosła 118 osób, a mediana liczby chorych, z których liczy się czułość, tylko 49. Wyliczenie liczebności przed badaniem podały 2 z 43 prac (5%). Ten wpis pokazuje, jak zaplanować liczebność dla czułości i swoistości, dla porównania dwóch testów u tych samych osób, dla pola pod krzywą ROC i przy częściowej weryfikacji. Samą analizę gotowych danych opisują kalkulator testu diagnostycznego i wpis o krzywej ROC i punkcie odcięcia.
Czułość i swoistość z zadaną precyzją: wzór Buderera
Najprostszy plan zakłada, że chcesz oszacować czułość i swoistość z zadaną połową szerokości 95% przedziału ufności (d). Buderer (1996) pokazała, jak włączyć do obliczeń rozpowszechnienie choroby w badanej populacji (P). Najpierw liczysz, ilu chorych i ilu zdrowych potrzebujesz, a potem, ile osób trzeba zbadać, żeby tylu ich było:
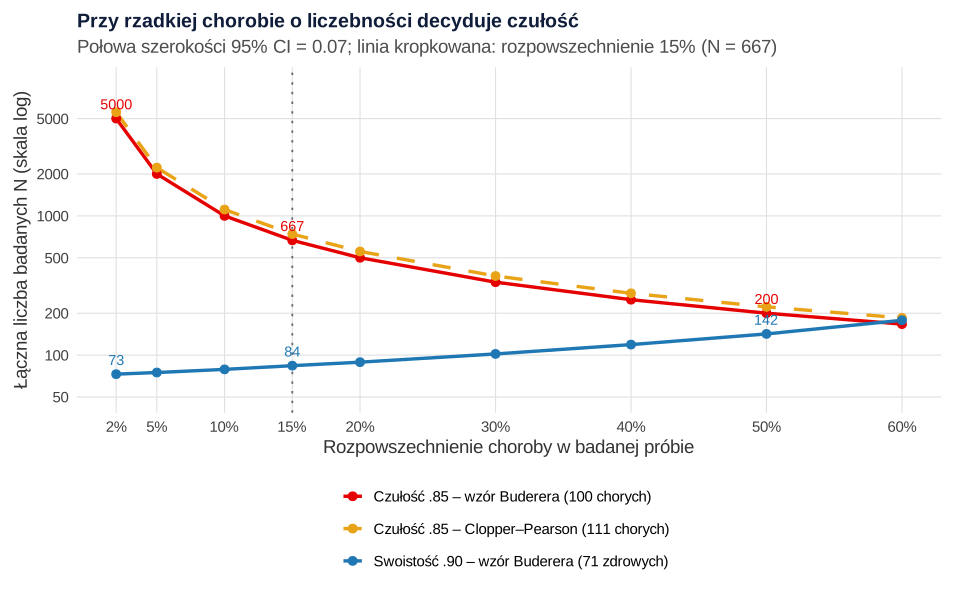
Liczebność nzdrowi liczysz tak samo, ze swoistością (Sp) zamiast czułości (Se). Ostateczne N to większa z dwóch liczb. W przykładzie zakładamy czułość .85, swoistość .90, d = 0.07 i rozpowszechnienie 15% wśród pacjentów badania przesiewowego w podstawowej opiece zdrowotnej. Potrzeba 100 chorych i 71 zdrowych. Dla czułości oznacza to N = 667, a dla swoistości tylko 84. Planujesz więc 667 osób, a swoistość zostanie oszacowana precyzyjniej, niż wymagałeś.
Rysunek 1 pokazuje, jak mocno wynik zależy od rozpowszechnienia. Przy 2% chorych potrzeba 5000 osób, przy 50% – 200. Dopiero przy 60% decydującą miarą staje się swoistość (178 osób). Dlatego rozpowszechnienie bierz z populacji, w której naprawdę zbierzesz dane, a nie z ogólnych statystyk zachorowań. W poradni specjalistycznej będzie wyższe niż w POZ, a wartości predykcyjne zmienią się razem z nim.
Wersja dokładna, pokrycie i zapewnienie
Wzór Buderera opiera się na przybliżeniu normalnym (przedział Walda). Przy czułości bliskiej 1 i małej liczbie chorych przedział Walda ma za niskie pokrycie, dlatego w analizie zwykle podaje się przedział Wilsona albo Cloppera–Pearsona (porównuje je hasło przedział ufności dla proporcji). Plan warto policzyć tą samą metodą, której użyjesz w analizie. Jeśli zażądasz, by oczekiwana połowa szerokości dokładnego przedziału Cloppera–Pearsona nie przekraczała 0.07, potrzebujesz 111 chorych i 82 zdrowych, czyli N = 740.
Flahault i in. (2005) proponują inne kryterium: tyle chorych, żeby dolna granica 95% przedziału ufności dla czułości z prawdopodobieństwem 95% nie spadła poniżej poziomu, który jest jeszcze akceptowalny. Tę liczbę wyznacza się z rozkładu dwumianowego. Gdy czułość wynosi .85, a dolna granica ma nie spaść poniżej .75, potrzeba 220 chorych, czyli 1467 osób przy 15% rozpowszechnienia. To kryterium pasuje do badań, w których test ma przekroczyć minimalny próg, np. wymagany przed wdrożeniem.
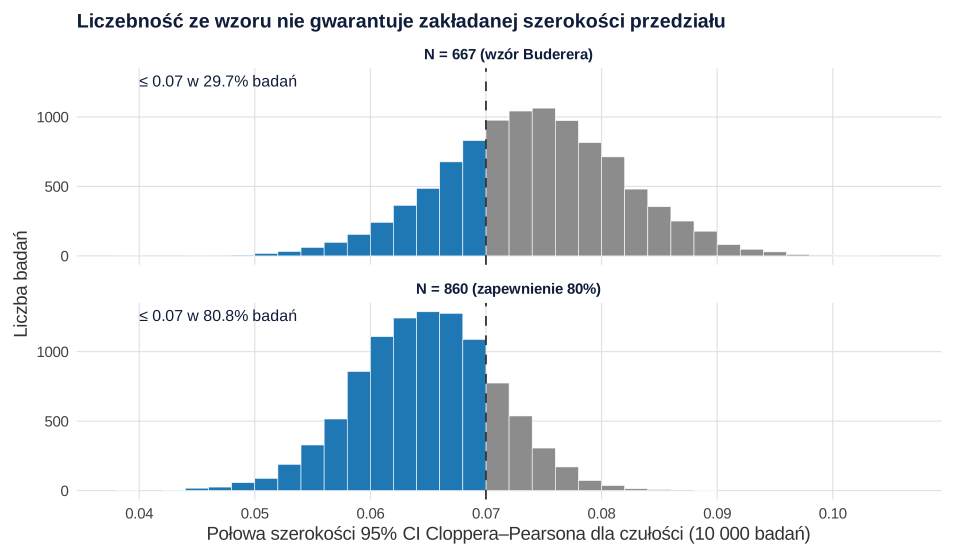
Wzór ma jeszcze jedną słabość. Liczba chorych w próbie jest losowa. Symulacja 10 000 badań z N = 667 pokazała, że co najmniej 100 chorych trafiło się tylko w 52.6% badań. Pokrycie przedziału wyniosło .936 dla Walda, .950 dla Wilsona i .964 dla Cloppera–Pearsona. Przeciętna połowa szerokości przedziału Cloppera–Pearsona była równa 0.074, a cel 0.07 osiągnęło tylko 29.7% badań. Jeśli chcesz, by szerokość nie przekroczyła celu z prawdopodobieństwem .80, potrzebujesz N = 860. Przy takiej próbie cel osiągnęło 80.8% badań (rysunek 2). Tę logikę planowania na „zapewnienie” szerzej opisuje wpis liczebność próby z precyzji (AIPE).
Dwa testy u tych samych osób
Często pytanie brzmi inaczej: czy nowa skala jest czulsza od dotychczasowej? Najlepszy plan to wykonanie obu testów i standardu referencyjnego u każdej osoby. Czułości porównujesz wtedy w parach, testem McNemara na chorych. Informację niosą tylko pary niezgodne, czyli chorzy wykryci przez jeden test, a przeoczeni przez drugi. Dlatego liczebność zależy od odsetka par niezgodnych (ψ), a nie tylko od różnicy czułości (δ). Connor (1987) podał proste, zachowawcze przybliżenie:
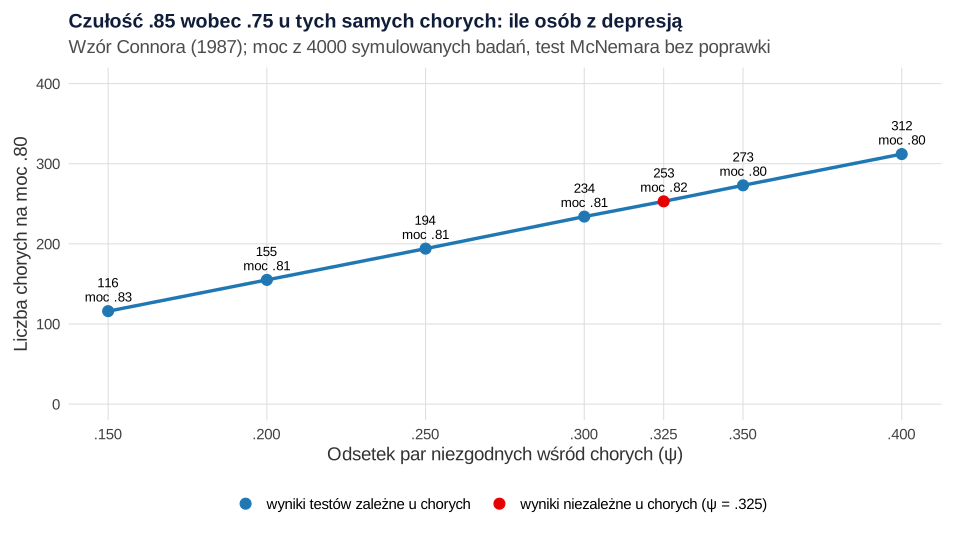
Przy czułości .85 i .75 oraz wynikach obu testów niezależnych u chorych ψ = .325. Na moc .80 potrzeba wtedy 253 chorych, czyli 1687 osób przy 15% rozpowszechnienia. Testy mierzące to samo zaburzenie są jednak zwykle dodatnio zależne: oba wykrywają ciężkie przypadki i oba przeoczają łagodne. Przy ψ = .20 wystarcza 155 chorych, a przy ψ = .15 – 116 (rysunek 3). Gdyby te same czułości porównywać w dwóch niezależnych grupach chorych, potrzeba by 250 osób w każdej grupie, czyli 500 chorych.
Symulacja 4000 badań przy każdej liczebności potwierdziła wzór: test McNemara bez poprawki miał moc od .797 do .832. Dokładny test dwumianowy na parach niezgodnych dawał moc .744–.785. Jeśli w analizie planujesz test dokładny, dodaj więc zapas. Odsetek par niezgodnych oszacuj z pilotażu albo z publikacji, które podają pełną tabelę par. Gdy go nie znasz, przyjmij wariant niezależności, bo jest zachowawczy.
Pole pod krzywą ROC: precyzja i porównanie
Gdy test daje wynik ciągły, a próg dopiero chcesz wybrać, główną miarą jest AUC (zob. krzywa ROC). Hanley i McNeil (1982) wyprowadzili wzór na błąd standardowy AUC, z którego można policzyć liczebność dla zadanej precyzji. Przy AUC = .80, połowie szerokości 95% CI równej 0.05 i 5.67 zdrowych na jednego chorego (rozpowszechnienie 15%) potrzeba 117 chorych i 663 zdrowych, razem 780 osób. W 1000 symulowanych badań przedział DeLonga miał przy tej liczebności pokrycie .957, a średnią połowę szerokości 0.043. Wzór okazał się więc w tym scenariuszu nieco zachowawczy. Przegląd podobnych wzorów dla czułości, ilorazów wiarygodności i AUC, z tabelami, podaje Hajian-Tilaki (2014).
Nie planuj natomiast badania na test hipotezy AUC = .5. Funkcja power.roc.test z pakietu pROC (Robin i in., 2011) wylicza, że do odróżnienia AUC = .80 od .5 z mocą .80 wystarcza 8 chorych i 45 zdrowych. Taki wynik nic nie mówi o przydatności klinicznej testu, a przedział ufności byłby bardzo szeroki.
Porównanie dwóch skal u tych samych osób to sprawa trudniejsza. Załóżmy AUC .90 dla pełnej skali i .85 dla skróconej oraz korelację wyników .6 u chorych i u zdrowych. Wariant power.roc.test z parametrami modelu dwunormalnego, oparty na metodzie Obuchowskiego i McClish (1997), wskazał 228 chorych i 1290 zdrowych. Symulacja z testem DeLonga dała jednak przy 228 chorych moc .986, a moc .804 już przy 100 chorych (667 osób). W tym scenariuszu wzór mocno zawyżał liczebność. Dlatego wynik wzoru traktuj jako punkt wyjścia i sprawdź go symulacją z założonym rozkładem wyników. Jak taką symulację zaplanować, opisuje wpis jak zaplanować badanie symulacyjne.
Częściowa weryfikacja: oszczędność, która kosztuje
Standard referencyjny bywa drogi. Kusi więc, żeby wywiad kliniczny przeprowadzić u wszystkich z wynikiem dodatnim i tylko u części osób z wynikiem ujemnym. Czułość policzona wtedy tylko na zweryfikowanych jest zawyżona (błąd weryfikacji). Korekta Begga i Greenesa (1983) usuwa to obciążenie, jeśli o weryfikacji decydował wyłącznie wynik testu. Hasło o błędzie weryfikacji pokazuje samą korektę. Tu liczy się jej koszt w precyzji.
| Weryfikowana część ujemnych | N | Czułość tylko u zweryfikowanych | Czułość po korekcie | SE po korekcie | Średnio zweryfikowanych |
|---|---|---|---|---|---|
| 100% | 667 | .851 | .851 | 0.036 | 667 |
| 50% | 667 | .919 | .851 | 0.049 | 405 |
| 25% | 667 | .957 | .853 | 0.067 | 273 |
| 10% | 667 | .983 | .861 | 0.101 | 194 |
| 50% | 1250 | – | – | 0.034 | 758 |
| 25% | 2300 | – | – | 0.036 | 941 |
Przy tej samej próbie 667 osób błąd standardowy czułości po korekcie rośnie z 0.036 do 0.067, gdy weryfikujesz co czwartą osobę z wynikiem ujemnym. Cel z wcześniejszych sekcji (SE ≤ 0.0357, czyli połowa 95% CI ≤ 0.07) wymaga wtedy 2300 osób i średnio 941 wywiadów. Przy pełnej weryfikacji wystarczyło 667 wywiadów. Powód jest prosty: o czułości decydują chorzy z wynikiem ujemnym, a tych w małej weryfikowanej podpróbie jest niewielu. Częściowa weryfikacja oszczędza więc wywiady tylko wtedy, gdy godzisz się na mniejszą precyzję. Jeśli ją planujesz, policz liczebność symulacją i opisz z góry mechanizm wyboru do weryfikacji.
Jak opisać liczebność w protokole i artykule
Wytyczne STARD 2015 wymagają podania zamierzonej liczebności próby i sposobu jej wyznaczenia (Bossuyt i in., 2015). Podaj miarę, na którą planujesz (czułość, AUC, różnica czułości), zakładane wartości i ich źródło, precyzję albo moc, rozpowszechnienie w badanej populacji, metodę obliczeń i zapas na braki. Wzór dla przykładu z czułością:
Jeśli porównujesz dwa testy, dopisz założony odsetek par niezgodnych i test (McNemara asymptotyczny czy dokładny). Przy AUC podaj model wyników (np. dwunormalny), korelację testów i liczbę powtórzeń symulacji. Ogólne zasady planowania liczebności zbiera wpis dobór liczebności próby.
Przykład w R
Trzy przepisy są niezależne i odtwarzają wszystkie liczby z tekstu (każdy działa kilka sekund). Pierwszy i drugi zapisują wyniki do plików CSV, z których powstały rysunki. Dane są symulowane.
1. Czułość i swoistość: wzór Buderera, wersja dokładna i symulacja
R
# Krok 1. Ile osób, żeby oszacować czułość i swoistość z zadaną precyzją (dane symulowane)
# Nowa krótka skala przesiewowa depresji w POZ; standard referencyjny: ustrukturyzowany wywiad kliniczny.
# Założenia: czułość .85, swoistość .90, połowa szerokości 95% CI (d) = 0.07, rozpowszechnienie 15%.
library(DescTools)
Se <- 0.85; Sp <- 0.90; d <- 0.07; prev <- 0.15; z <- qnorm(0.975)

# a) Wzór Buderera (1996): najpierw liczba chorych i zdrowych, potem podział przez rozpowszechnienie
n_chorzy <- ceiling(z^2 * Se * (1 - Se) / d^2)       # potrzebnych osób z depresją
n_zdrowi <- ceiling(z^2 * Sp * (1 - Sp) / d^2)       # potrzebnych osób bez depresji
N_Se <- ceiling(n_chorzy / prev); N_Sp <- ceiling(n_zdrowi / (1 - prev))
c(n_chorzy = n_chorzy, n_zdrowi = n_zdrowi, N_dla_Se = N_Se, N_dla_Sp = N_Sp, N = max(N_Se, N_Sp))

# b) Wersja dokładna: najmniejsze n chorych, przy którym OCZEKIWANA połowa szerokości
#    przedziału Cloppera–Pearsona nie przekracza d (średnia po rozkładzie dwumianowym x)
polowa_cp <- function(n, p) {
  x <- 0:n; ci <- BinomCI(x, n, method = "clopper-pearson")
  sum(dbinom(x, n, p) * (ci[, "upr.ci"] - ci[, "lwr.ci"]) / 2)
}
n_dokladne <- function(p, d) { n <- 10; while (polowa_cp(n, p) > d) n <- n + 1; n }
n_chorzy_cp <- n_dokladne(Se, d); n_zdrowi_cp <- n_dokladne(Sp, d)
c(n_chorzy_cp = n_chorzy_cp, n_zdrowi_cp = n_zdrowi_cp,
  N_cp = max(ceiling(n_chorzy_cp / prev), ceiling(n_zdrowi_cp / (1 - prev))))

# c) Kryterium Flahaulta i in. (2005): dolna granica 95% CI Cloppera–Pearsona ≥ .75
#    z prawdopodobieństwem co najmniej .95, gdy prawdziwa czułość = .85.
#    Moc dla rozkładu dwumianowego „piłuje”, więc bierzemy n, od którego warunek trwa do n = 400.
p_dolna <- function(n, p = Se, L = 0.75) {
  x <- 0:n; sum(dbinom(x, n, p)[BinomCI(x, n, method = "clopper-pearson")[, "lwr.ci"] >= L])
}
spelnia <- sapply(100:400, p_dolna) >= 0.95
n_flahault <- (100:400)[max(which(!spelnia)) + 1]
c(n_chorzy_flahault = n_flahault, N_flahault = ceiling(n_flahault / prev))

# d) Liczebność w funkcji rozpowszechnienia (do rysunku 1)
siatka <- data.frame(prev = c(0.02, 0.05, 0.10, 0.15, 0.20, 0.30, 0.40, 0.50, 0.60))
siatka$N_Se <- ceiling(n_chorzy / siatka$prev)
siatka$N_Sp <- ceiling(n_zdrowi / (1 - siatka$prev))
siatka$N_Se_cp <- ceiling(n_chorzy_cp / siatka$prev)
siatka$N <- pmax(siatka$N_Se, siatka$N_Sp)
print(siatka, row.names = FALSE)
write.csv(siatka, "n-rozpowszechnienie.csv", row.names = FALSE)

# e) Symulacja 10 000 badań z N = N_Se: liczba chorych jest losowa, x ~ Bin(n_chorych, .85)
symuluj <- function(N, R = 10000) {
  nD <- rbinom(R, N, prev); x <- rbinom(R, nD, Se)
  wald <- cbind(x / nD - z * sqrt(x / nD * (1 - x / nD) / nD), x / nD + z * sqrt(x / nD * (1 - x / nD) / nD))
  wil <- BinomCI(x, nD, method = "wilson")[, 2:3]; cp <- BinomCI(x, nD, method = "clopper-pearson")[, 2:3]
  pokr <- function(ci) mean(ci[, 1] <= Se & Se <= ci[, 2])
  pol <- (cp[, 2] - cp[, 1]) / 2
  list(wynik = c(N = N, P_chorych_co_najmniej = mean(nD >= n_chorzy), pokrycie_Wald = pokr(wald),
                 pokrycie_Wilson = pokr(wil), pokrycie_CP = pokr(cp), srednia_polowa_CP = mean(pol),
                 P_polowa_CP_do_d = mean(pol <= d)), polowa = pol)
}
set.seed(3531)
s1 <- symuluj(N_Se)
round(s1$wynik, 3)

# f) „Zapewnienie” (assurance): najmniejsze N, przy którym połowa szerokości CP ≤ d w 80% badań
set.seed(3532)
siatka_N <- seq(700, 1000, by = 10)
p_zapewn <- sapply(siatka_N, function(N) symuluj(N, R = 4000)$wynik[["P_polowa_CP_do_d"]])
N_zapewn <- siatka_N[min(which(p_zapewn >= 0.80))]
set.seed(3533)
s2 <- symuluj(N_zapewn)
round(s2$wynik, 3)
write.csv(data.frame(N = rep(c(N_Se, N_zapewn), each = 10000), polowa = c(s1$polowa, s2$polowa)),
          "polowa-szerokosci-symulacja.csv", row.names = FALSE)
Wynik w R
n_chorzy n_zdrowi N_dla_Se N_dla_Sp        N
     100       71      667       84      667
n_chorzy_cp n_zdrowi_cp        N_cp
        111          82         740
n_chorzy_flahault        N_flahault
              220              1467
 prev N_Se N_Sp N_Se_cp    N
 0.02 5000   73    5550 5000
 0.05 2000   75    2220 2000
 0.10 1000   79    1110 1000
 0.15  667   84     740  667
 0.20  500   89     555  500
 0.30  334  102     370  334
 0.40  250  119     278  250
 0.50  200  142     222  200
 0.60  167  178     185  178
                    N P_chorych_co_najmniej         pokrycie_Wald
              667.000                 0.526                 0.936
      pokrycie_Wilson           pokrycie_CP     srednia_polowa_CP
                0.950                 0.964                 0.074
     P_polowa_CP_do_d
                0.297
                    N P_chorych_co_najmniej         pokrycie_Wald
              860.000                 0.998                 0.939
      pokrycie_Wilson           pokrycie_CP     srednia_polowa_CP
                0.951                 0.962                 0.065
     P_polowa_CP_do_d
                0.808
2. Dwa testy u tych samych osób i AUC
R
# Krok 2. Porównanie dwóch testów u tych samych osób i AUC (dane symulowane)
# Nowa krótka skala (czułość .85) i dotychczasowa skala (czułość .75); obie u każdej osoby,
# standard referencyjny u wszystkich, rozpowszechnienie depresji 15%.
suppressPackageStartupMessages(library(pROC))
prev <- 0.15; z_a <- qnorm(0.975); z_b <- qnorm(0.80)

# a) Czułości w parach: test McNemara wśród chorych, wzór Connora (1987)
#    psi = odsetek par niezgodnych, delta = różnica czułości
n_connor <- function(delta, psi) ceiling((z_a * sqrt(psi) + z_b * sqrt(psi - delta^2))^2 / delta^2)
Se1 <- 0.85; Se2 <- 0.75; delta <- Se1 - Se2
psi_niezal <- Se1 * (1 - Se2) + Se2 * (1 - Se1)        # testy niezależne warunkowo na stan chorego
psi <- c(0.15, 0.20, 0.25, 0.30, psi_niezal, 0.35, 0.40)
mcn <- data.frame(psi = psi, n_chorych = n_connor(delta, psi))
mcn$N <- ceiling(mcn$n_chorych / prev)

# Sprawdzenie symulacją: 4000 badań przy wyliczonym n, test McNemara bez poprawki i dokładny
moc_mcnemar <- function(n, psi, R = 4000) {
  p10 <- (psi + delta) / 2; p01 <- (psi - delta) / 2  # nowy+/stary− oraz nowy−/stary+
  tab <- rmultinom(R, n, c(p10, p01, 1 - psi))
  b <- tab[1, ]; c <- tab[2, ]
  p_asym <- pchisq((b - c)^2 / (b + c), 1, lower.tail = FALSE)
  p_dokl <- mapply(function(b, c) binom.test(b, b + c)$p.value, b, c)
  c(moc_asymptotyczny = mean(p_asym < .05), moc_dokladny = mean(p_dokl < .05))
}
set.seed(3534)
mcn <- cbind(mcn, round(t(mapply(moc_mcnemar, mcn$n_chorych, mcn$psi)), 3))
print(mcn, row.names = FALSE)
write.csv(mcn, "n-mcnemar.csv", row.names = FALSE)
# Dla porównania: dwie niezależne grupy chorych (inny plan) – power.prop.test
ceiling(power.prop.test(p1 = Se1, p2 = Se2, power = 0.80)$n)

# b) AUC z zadaną precyzją: błąd standardowy Hanleya i McNeila (1982), 5.67 zdrowych na 1 chorego
se_hm <- function(A, n1, n0) {
  Q1 <- A / (2 - A); Q2 <- 2 * A^2 / (1 + A)
  sqrt((A * (1 - A) + (n1 - 1) * (Q1 - A^2) + (n0 - 1) * (Q2 - A^2)) / (n1 * n0))
}
k <- (1 - prev) / prev
n1_auc <- 10; while (z_a * se_hm(0.80, n1_auc, ceiling(k * n1_auc)) > 0.05) n1_auc <- n1_auc + 1
c(n_chorych = n1_auc, n_zdrowych = ceiling(k * n1_auc), N = n1_auc + ceiling(k * n1_auc))

# Sprawdzenie: 1000 badań z danymi dwunormalnymi (AUC = .80), przedział DeLonga
A_bin <- function(auc) sqrt(2) * qnorm(auc)              # parametr a przy b = 1
set.seed(3535)
ci <- t(replicate(1000, {
  y <- c(rep(0, ceiling(k * n1_auc)), rep(1, n1_auc))
  x <- c(rnorm(ceiling(k * n1_auc)), rnorm(n1_auc, A_bin(0.80)))
  as.numeric(ci.auc(roc(y, x, direction = "<", quiet = TRUE)))[c(1, 3)]
}))
round(c(pokrycie = mean(ci[, 1] <= 0.80 & 0.80 <= ci[, 2]), srednia_polowa = mean(ci[, 2] - ci[, 1]) / 2), 3)

# c) Test H0: AUC = .5 – prawie nic nie kosztuje, więc rzadko jest właściwym celem
power.roc.test(auc = 0.80, kappa = k, power = 0.80)

# d) Dwie skale u tych samych osób: AUC .90 i .85, korelacja wyników .6 w obu grupach
#    (metoda Obuchowskiego i McClish, parametry modelu dwunormalnego)
par <- list(A1 = A_bin(0.90), B1 = 1, A2 = A_bin(0.85), B2 = 1, rn = 0.6, ra = 0.6, delta = 0.05)
pw <- power.roc.test(par, kappa = k, power = 0.80)
pw
# Sprawdzenie symulacją: test DeLonga, 500 badań na liczbę chorych
moc_auc <- function(n1, R = 500) {
  n0 <- ceiling(k * n1); S <- matrix(c(1, 0.6, 0.6, 1), 2)
  mean(replicate(R, {
    z0 <- MASS::mvrnorm(n0, c(0, 0), S); z1 <- MASS::mvrnorm(n1, c(A_bin(0.90), A_bin(0.85)), S)
    y <- c(rep(0, n0), rep(1, n1))
    r1 <- roc(y, c(z0[, 1], z1[, 1]), direction = "<", quiet = TRUE)
    r2 <- roc(y, c(z0[, 2], z1[, 2]), direction = "<", quiet = TRUE)
    roc.test(r1, r2, method = "delong")$p.value < .05
  }))
}
set.seed(3536)
n1_siatka <- c(100, 125, 150, ceiling(pw$ncases))
data.frame(n_chorych = n1_siatka, N = n1_siatka + ceiling(k * n1_siatka), moc_DeLong = sapply(n1_siatka, moc_auc))
Wynik w R
   psi n_chorych    N moc_asymptotyczny moc_dokladny
 0.150       116  774             0.832        0.772
 0.200       155 1034             0.807        0.744
 0.250       194 1294             0.810        0.775
 0.300       234 1560             0.809        0.771
 0.325       253 1687             0.822        0.785
 0.350       273 1820             0.803        0.776
 0.400       312 2080             0.797        0.773
[1] 250
 n_chorych n_zdrowych          N
       117        663        780
      pokrycie srednia_polowa
         0.957          0.043

     One ROC curve power calculation

         ncases = 7.816837
      ncontrols = 44.29541
            auc = 0.8
      sig.level = 0.05
          power = 0.8


     Two ROC curves power calculation

         ncases = 227.5997
      ncontrols = 1289.732
      sig.level = 0.05
          power = 0.8

  n_chorych    N moc_DeLong
1       100  667      0.804
2       125  834      0.884
3       150 1000      0.934
4       228 1520      0.986
3. Częściowa weryfikacja i korekta Begga–Greenesa
R
# Krok 3. Częściowa weryfikacja: ile osób przebadać, gdy standard dostaje tylko część ujemnych (dane symulowane)
# Czułość .85, swoistość .90, rozpowszechnienie 15%; wywiad kliniczny u wszystkich z wynikiem dodatnim
# i u losowej części f osób z wynikiem ujemnym; czułość korygowana metodą Begga i Greenesa (1983).
Se <- 0.85; Sp <- 0.90; prev <- 0.15; d <- 0.07; se_cel <- d / qnorm(0.975)

badanie <- function(N, f) {
  D <- rbinom(N, 1, prev)
  T <- ifelse(D == 1, rbinom(N, 1, Se), rbinom(N, 1, 1 - Sp))
  V <- ifelse(T == 1, 1, rbinom(N, 1, f))              # kto dostaje standard referencyjny
  pT <- mean(T); pDp <- mean(D[V == 1 & T == 1]); pDm <- mean(D[V == 1 & T == 0])
  c(naiwna = mean(T[V == 1 & D == 1]),
    begg_greenes = pT * pDp / (pT * pDp + (1 - pT) * pDm),
    zweryfikowanych = sum(V))
}
podsumuj <- function(N, f, R = 4000) {
  w <- replicate(R, badanie(N, f))
  c(N = N, f = f, srednia_naiwna = mean(w[1, ]), srednia_BG = mean(w[2, ]),
    SE_BG = sd(w[2, ]), zweryfikowanych = mean(w[3, ]))
}
# a) Ta sama próba N = 667 (z wzoru Buderera) przy różnej części weryfikowanych ujemnych
set.seed(3537)
a <- as.data.frame(t(sapply(c(1, 0.5, 0.25, 0.10), podsumuj, N = 667)))
print(round(a, 3), row.names = FALSE)
round(se_cel, 4)                                       # SE odpowiadające połowie szerokości 0.07

# b) Jakie N daje SE czułości ≤ 0.0357 (połowa 95% CI ≤ 0.07) przy f = .50 i f = .25?
#    Siatka N wokół 667 × (SE przy N = 667 / 0.0357)², sprawdzenie 2000 badaniami na punkt
szukaj_N <- function(f, siatka) {
  b <- as.data.frame(t(sapply(siatka, podsumuj, f = f, R = 2000)))
  b[min(which(b$SE_BG <= se_cel)), c("N", "f", "SE_BG", "zweryfikowanych")]
}
set.seed(3538)
wynik_N <- rbind(szukaj_N(0.50, seq(1100, 1500, by = 50)), szukaj_N(0.25, seq(2000, 2800, by = 100)))
print(round(wynik_N, 4), row.names = FALSE)
Wynik w R
   N    f srednia_naiwna srednia_BG SE_BG zweryfikowanych
 667 1.00          0.851      0.851 0.036         667.000
 667 0.50          0.919      0.851 0.049         404.600
 667 0.25          0.957      0.853 0.067         273.066
 667 0.10          0.983      0.861 0.101         193.879
[1] 0.0357
    N    f  SE_BG zweryfikowanych
 1250 0.50 0.0337        758.1860
 2300 0.25 0.0356        940.9875
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (przepis 1: pakiet DescTools; przepis 2: pakiety pROC i MASS); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Liczebność dla całej próby zamiast dla chorych. Precyzję czułości wyznacza liczba chorych. Przy rozpowszechnieniu 15% nawet 667 badanych daje średnio około 100 chorych.
- Rozpowszechnienie z niewłaściwej populacji. Weź je z miejsca, w którym rekrutujesz. Dobór próby zmienia też spektrum chorych (błąd spektrum).
- Test AUC = .5 jako cel. Daje kilkudziesięcioosobowe próby i nic nie mówi o przydatności testu.
- Porównanie testów w osobnych grupach. Plan w parach wymagał w przykładzie 253 chorych zamiast 500, a przy zależnych wynikach testów jeszcze mniej.
- Planowanie analiz podgrup bez liczebności. Bachmann i in. (2006) zauważyli, że prawie połowa badań raportuje podgrupy, choć żadne nie planowało pod nie liczebności (zob. analiza podgrup).
- Moc liczona po fakcie. Po badaniu podaj przedziały ufności, a nie moc post hoc.
Najczęstsze pytania
Ile osób potrzeba do oszacowania czułości i swoistości testu?
Najpierw policz liczbę chorych potrzebną dla czułości i liczbę zdrowych dla swoistości, a potem podziel je przez rozpowszechnienie i jego dopełnienie (wzór Buderera). Dla czułości .85, swoistości .90 i połowy 95% CI 0.07 potrzeba 100 chorych i 71 zdrowych; przy 15% rozpowszechnienia daje to 667 badanych.
Jak rozpowszechnienie choroby wpływa na liczebność badania diagnostycznego?
Przy rzadkiej chorobie o liczebności decyduje czułość, bo chorych jest mało. W przykładzie potrzeba było 5000 osób przy 2% rozpowszechnienia, 667 przy 15% i 200 przy 50%. Rozpowszechnienie bierz z populacji, w której rekrutujesz, np. z poradni, a nie z ogólnych statystyk.
Ilu chorych potrzeba, żeby porównać czułość dwóch testów u tych samych osób?
To zależy od odsetka par niezgodnych, czyli chorych wykrytych tylko przez jeden test. Dla czułości .85 i .75 wzór Connora daje 253 chorych przy niezależnych wynikach testów i 155 przy odsetku par niezgodnych .20. Porównanie w dwóch niezależnych grupach wymagałoby 500 chorych.
Czy power.roc.test z pROC dobrze liczy liczebność dla porównania dwóch AUC?
Daje punkt wyjścia, ale warto go sprawdzić symulacją. W przykładzie z AUC .90 i .85 oraz korelacją skal .6 funkcja wskazała 228 chorych, a symulacja z testem DeLonga dała moc .804 już przy 100 chorych. Test AUC = .5 jako cel planowania nie ma sensu, bo wystarcza wtedy kilka osób chorych.
Czy częściowa weryfikacja standardem referencyjnym zmniejsza potrzebną próbę?
Zwykle nie. Po korekcie Begga–Greenesa błąd standardowy czułości rośnie, bo mało jest zweryfikowanych chorych z wynikiem ujemnym. W przykładzie przy weryfikacji 25% wyników ujemnych potrzeba było 2300 badanych i średnio 941 wywiadów zamiast 667 przy pełnej weryfikacji.
Powiązane hasła
Przeczytaj też
Krzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikKalkulator testu diagnostycznego
Czułość, swoistość, PPV, NPV, LR+ i LR− z przedziałami ufności z tabeli 2×2 oraz wykres wartości predykcyjnych w funkcji częstości.
Czytaj →PoradnikLiczebność próby z precyzji (AIPE)
Planowanie liczebności na szerokość przedziału ufności dla proporcji, d Cohena i korelacji, z pewnością osiągnięcia celu i kodem R.
Czytaj →Planujesz walidację testu przesiewowego i nie wiesz, ilu chorych potrzebujesz?
Pomożemy przełożyć założenia o czułości, rozpowszechnieniu i planie weryfikacji na liczebność, sprawdzić ją symulacją i przygotować opis, który samodzielnie obronisz przed komisją etyczną i recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bachmann, L. M., Puhan, M. A., ter Riet, G., & Bossuyt, P. M. (2006). Sample sizes of studies on diagnostic accuracy: Literature survey. BMJ, 332(7550), 1127–1129. https://doi.org/10.1136/bmj.38793.637789.2f ● Otwarty dostęp
- Begg, C. B., & Greenes, R. A. (1983). Assessment of diagnostic tests when disease verification is subject to selection bias. Biometrics, 39(1), 207–215. https://doi.org/10.2307/2530820
- Bossuyt, P. M., Reitsma, J. B., Bruns, D. E., Gatsonis, C. A., Glasziou, P. P., Irwig, L., Lijmer, J. G., Moher, D., Rennie, D., de Vet, H. C. W., Kressel, H. Y., Rifai, N., Golub, R. M., Altman, D. G., Hooft, L., Korevaar, D. A., & Cohen, J. F. (2015). STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies. BMJ, 351, Article h5527. https://doi.org/10.1136/bmj.h5527 ● Otwarty dostęp
- Buderer, N. M. F. (1996). Statistical methodology: I. Incorporating the prevalence of disease into the sample size calculation for sensitivity and specificity. Academic Emergency Medicine, 3(9), 895–900. https://doi.org/10.1111/j.1553-2712.1996.tb03538.x
- Connor, R. J. (1987). Sample size for testing differences in proportions for the paired-sample design. Biometrics, 43(1), 207–211. https://doi.org/10.2307/2531961
- Flahault, A., Cadilhac, M., & Thomas, G. (2005). Sample size calculation should be performed for design accuracy in diagnostic test studies. Journal of Clinical Epidemiology, 58(8), 859–862. https://doi.org/10.1016/j.jclinepi.2004.12.009 ● Otwarty dostęp: pełny tekst
- Hajian-Tilaki, K. (2014). Sample size estimation in diagnostic test studies of biomedical informatics. Journal of Biomedical Informatics, 48, 193–204. https://doi.org/10.1016/j.jbi.2014.02.013 ● Otwarty dostęp
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Obuchowski, N. A., & McClish, D. K. (1997). Sample size determination for diagnostic accuracy studies involving binormal ROC curve indices. Statistics in Medicine, 16(13), 1529–1542. https://doi.org/10.1002/(sici)1097-0258(19970715)16:13<1529::aid-sim565>3.0.co;2-h
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77 ● Otwarty dostęp
Cytowania BibTeX
@article{bachmann2006sample, author={Bachmann, Lucas M. and Puhan, Milo A. and ter Riet, Gerben and Bossuyt, Patrick M.}, title={{Sample sizes of studies on diagnostic accuracy: Literature survey}}, journal={BMJ}, year={2006}, volume={332}, number={7550}, pages={1127--1129}, doi={10.1136/bmj.38793.637789.2f}}@article{begg1983assessment, author={Begg, Colin B. and Greenes, Robert A.}, title={{Assessment of diagnostic tests when disease verification is subject to selection bias}}, journal={Biometrics}, year={1983}, volume={39}, number={1}, pages={207--215}, doi={10.2307/2530820}}@article{bossuyt2015stard, author={Bossuyt, Patrick M. and Reitsma, Johannes B. and Bruns, David E. and Gatsonis, Constantine A. and Glasziou, Paul P. and Irwig, Les and Lijmer, Jeroen G. and Moher, David and Rennie, Drummond and de Vet, Henrica C. W. and Kressel, Herbert Y. and Rifai, Nader and Golub, Robert M. and Altman, Douglas G. and Hooft, Lotty and Korevaar, Daniël A. and Cohen, Jérémie F.}, title={{STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies}}, journal={BMJ}, year={2015}, volume={351}, eid={h5527}, doi={10.1136/bmj.h5527}}@article{buderer1996statistical, author={Buderer, Nancy M. Fenn}, title={{Statistical methodology: I. Incorporating the prevalence of disease into the sample size calculation for sensitivity and specificity}}, journal={Academic Emergency Medicine}, year={1996}, volume={3}, number={9}, pages={895--900}, doi={10.1111/j.1553-2712.1996.tb03538.x}}@article{connor1987sample, author={Connor, Robert J.}, title={{Sample size for testing differences in proportions for the paired-sample design}}, journal={Biometrics}, year={1987}, volume={43}, number={1}, pages={207--211}, doi={10.2307/2531961}}@article{flahault2005sample, author={Flahault, Antoine and Cadilhac, Michel and Thomas, Guy}, title={{Sample size calculation should be performed for design accuracy in diagnostic test studies}}, journal={Journal of Clinical Epidemiology}, year={2005}, volume={58}, number={8}, pages={859--862}, doi={10.1016/j.jclinepi.2004.12.009}}@article{hajiantilaki2014sample, author={Hajian-Tilaki, Karimollah}, title={{Sample size estimation in diagnostic test studies of biomedical informatics}}, journal={Journal of Biomedical Informatics}, year={2014}, volume={48}, pages={193--204}, doi={10.1016/j.jbi.2014.02.013}}@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{obuchowski1997sample, author={Obuchowski, Nancy A. and McClish, Donna Katzman}, title={{Sample size determination for diagnostic accuracy studies involving binormal ROC curve indices}}, journal={Statistics in Medicine}, year={1997}, volume={16}, number={13}, pages={1529--1542}, doi={10.1002/(sici)1097-0258(19970715)16:13<1529::aid-sim565>3.0.co;2-h}}@article{robin2011proc, author={Robin, Xavier and Turck, Natacha and Hainard, Alexandre and Tiberti, Natalia and Lisacek, Frédérique and Sanchez, Jean-Charles and Müller, Markus}, title={{pROC: An open-source package for R and S+ to analyze and compare ROC curves}}, journal={BMC Bioinformatics}, year={2011}, volume={12}, number={1}, eid={77}, doi={10.1186/1471-2105-12-77}}