Co to jest błąd weryfikacji?
Błąd weryfikacji (ang. work-up bias, verification bias) powstaje, gdy decyzja o wykonaniu standardu referencyjnego zależy od wyniku ocenianego testu. Zwykle wszystkie osoby z wynikiem dodatnim kieruje się na biopsję albo pełny wywiad diagnostyczny, a z wynikiem ujemnym tylko nieliczne. Begg i Greenes (1983) zauważyli, że czułość i swoistość liczy się wtedy często tylko na osobach zweryfikowanych, a pominięcie pozostałych może poważnie obciążyć oszacowania. Whiting i in. (2004) odróżniają częściową weryfikację (część osób nie dostaje standardu) od weryfikacji różnicowej (dodatni i ujemni dostają różne standardy).
Przykład
W symulacji 2000 pacjentów test ma rzeczywistą czułość .799 i swoistość .909. Standard referencyjny wykonano u wszystkich z wynikiem dodatnim i u losowych 25% z ujemnym, łącznie u 882 osób. Analiza samych zweryfikowanych daje czułość .940 i swoistość .724: czułość jest zawyżona, bo brakuje ujemnych wyników u chorych, a swoistość zaniżona. Gdy wybór do weryfikacji zależy tylko od wyniku testu, korekta Begga–Greenesa łączy częstość wyników testu w całej próbie z odsetkiem chorych wśród zweryfikowanych i przywraca wartości .803 i .909.
Na rysunku
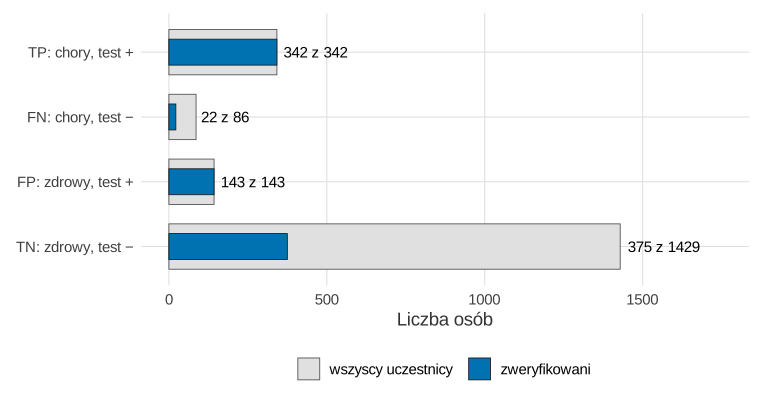
Co widać. Wszystkie wyniki dodatnie trafiły do standardu, ujemne – tylko co czwarty: 22 z 86 przeoczonych chorych (FN) i 375 z 1429 zdrowych z wynikiem ujemnym (TN). Analiza samych zweryfikowanych gubi więc większość przeoczonych chorych, przez co czułość rośnie, i większość prawidłowo ujemnych zdrowych, przez co swoistość spada.
Na co uważać. Pełne liczebności zna tylko symulacja. W prawdziwym badaniu stanu niezweryfikowanych nie znasz; widzisz jedynie, ilu dodatnich i ujemnych zweryfikowano – i właśnie to pokazuje diagram przepływu z wytycznych STARD.
Podpis do pracy:
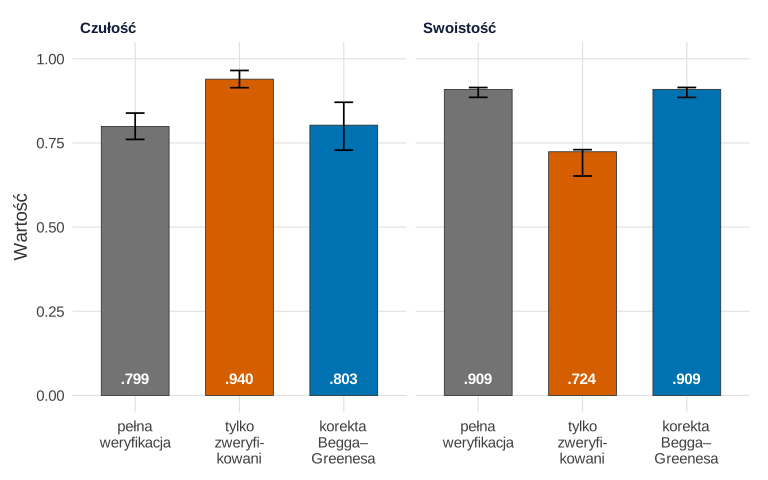
Co widać. Obciążenie nie jest przypadkiem jednej próby: w 1000 powtórzeniach analiza samych zweryfikowanych dawała średnio czułość .941 i swoistość .692, podczas gdy pełna weryfikacja – .801 i .900. Korekta Begga–Greenesa trafiała średnio w te same wartości (.801 i .900; błąd Monte Carlo średnich nie przekracza .002).
Na co uważać. Korekta ma cenę. Środkowe 95% oszacowań czułości po korekcie (.729–.871) jest prawie dwa razy szersze niż przy pełnej weryfikacji (.761–.839), bo opiera się na kilkudziesięciu zweryfikowanych chorych z wynikiem ujemnym. Wykres pokazuje też sytuację idealną: w symulacji o weryfikacji decydował wyłącznie wynik testu, więc założenie korekty jest spełnione z definicji.
Podpis do pracy:
Kod R rysunków 1–2
# Rysunki 1–2: kogo zweryfikowano i co z tego wynika dla czułości i swoistości (dane symulowane jak w przykładzie)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(prawda = "grey45", naiwnie = "#D55E00", korekta = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0),
        plot.background = element_rect(fill = "white", colour = NA))

# Jedno badanie: ziarno i parametry z przykładu w haśle
badanie <- function(n = 2000) {
  D <- rbinom(n, 1, 0.20)                                      # prawdziwy stan
  T <- ifelse(D == 1, rbinom(n, 1, 0.80), rbinom(n, 1, 0.10))  # czułość .80, swoistość .90
  V <- ifelse(T == 1, 1, rbinom(n, 1, 0.25))                   # weryfikacja: wszyscy dodatni, 25% ujemnych
  data.frame(D, T, V)
}
miary <- function(d) {
  pT <- mean(d$T); pDp <- mean(d$D[d$V == 1 & d$T == 1]); pDm <- mean(d$D[d$V == 1 & d$T == 0])
  c(czul_prawda  = mean(d$T[d$D == 1]), swoi_prawda = mean(1 - d$T[d$D == 0]),
    czul_naiwnie = mean(d$T[d$V == 1 & d$D == 1]), swoi_naiwnie = mean(1 - d$T[d$V == 1 & d$D == 0]),
    czul_korekta = pT * pDp / (pT * pDp + (1 - pT) * pDm),
    swoi_korekta = (1 - pT) * (1 - pDm) / ((1 - pT) * (1 - pDm) + pT * (1 - pDp)))
}
set.seed(606)
d <- badanie()

# Rysunek 1: cztery komórki tabeli test × stan – wszyscy i zweryfikowani
d$komorka <- factor(with(d, ifelse(D == 1, ifelse(T == 1, "TP: chory, test +", "FN: chory, test −"),
                                           ifelse(T == 1, "FP: zdrowy, test +", "TN: zdrowy, test −"))),
                    c("TP: chory, test +", "FN: chory, test −", "FP: zdrowy, test +", "TN: zdrowy, test −"))
kom <- data.frame(komorka = levels(d$komorka), wszyscy = as.vector(table(d$komorka)),
                  zweryfikowani = as.vector(table(d$komorka[d$V == 1])))
kom$komorka <- factor(kom$komorka, rev(levels(d$komorka)))
print(kom, row.names = FALSE)
p1 <- ggplot(kom, aes(y = komorka)) +
  geom_col(aes(x = wszyscy, fill = "wszyscy uczestnicy"), width = 0.7, colour = "grey30", linewidth = 0.3) +
  geom_col(aes(x = zweryfikowani, fill = "zweryfikowani"), width = 0.4, colour = "grey10", linewidth = 0.3) +
  geom_text(aes(x = wszyscy, label = sprintf("%d z %d", zweryfikowani, wszyscy)), hjust = -0.1, size = 4) +
  scale_fill_manual(values = c("wszyscy uczestnicy" = "grey88", "zweryfikowani" = "#0072B2"), name = NULL) +
  scale_x_continuous(limits = c(0, 1750), breaks = seq(0, 1500, 500)) +
  labs(x = "Liczba osób", y = NULL) + motyw

# Rysunek 2: czułość i swoistość z tej próby (słupki) i zakres z 1000 powtórzeń badania (wąsy)
set.seed(6061)                                                 # osobne ziarno dla powtórzeń
powt <- t(replicate(1000, miary(badanie())))
wyn <- data.frame(klucz = names(miary(d)), proba = miary(d),
                  q025 = apply(powt, 2, quantile, 0.025), q975 = apply(powt, 2, quantile, 0.975),
                  srednia = colMeans(powt), blad_MC = apply(powt, 2, sd) / sqrt(1000))   # błąd MC średniej
wyn$miara  <- ifelse(grepl("^czul", wyn$klucz), "Czułość", "Swoistość")
wyn$metoda <- factor(sub("^.*_", "", wyn$klucz), c("prawda", "naiwnie", "korekta"),
                     c("pełna weryfikacja", "tylko zweryfikowani", "korekta Begga–Greenesa"))
print(wyn[, c("miara", "metoda", "proba", "srednia", "blad_MC", "q025", "q975")], digits = 3, row.names = FALSE)
p2 <- ggplot(wyn, aes(metoda, proba, fill = metoda)) +
  geom_col(width = 0.65, colour = "grey20", linewidth = 0.3) +
  geom_errorbar(aes(ymin = q025, ymax = q975), width = 0.18, linewidth = 0.6) +
  geom_text(aes(y = 0.05, label = sub("^0", "", sprintf("%.3f", proba))), size = 4, colour = "white", fontface = "bold") +
  facet_wrap(~ miara) +
  scale_fill_manual(values = unname(kol), guide = "none") +
  scale_x_discrete(labels = c("pełna\nweryfikacja", "tylko\nzweryfi-\nkowani", "korekta\nBegga–\nGreenesa")) +
  coord_cartesian(ylim = c(0, 1)) +
  labs(x = NULL, y = "Wartość") + motyw

p1   # zapis: ggsave("blad-weryfikacji-komorki.svg", p1, width = 8, height = 4.2)
p2   # zapis: ggsave("blad-weryfikacji-miary.svg", p2, width = 8, height = 5)
Wynik w R
            komorka wszyscy zweryfikowani
  TP: chory, test +     342           342
  FN: chory, test −      86            22
 FP: zdrowy, test +     143           143
 TN: zdrowy, test −    1429           375
     miara                 metoda proba srednia  blad_MC  q025  q975
   Czułość      pełna weryfikacja 0.799   0.801 0.000638 0.761 0.839
 Swoistość      pełna weryfikacja 0.909   0.900 0.000234 0.886 0.915
   Czułość    tylko zweryfikowani 0.940   0.941 0.000405 0.914 0.965
 Swoistość    tylko zweryfikowani 0.724   0.692 0.000639 0.652 0.730
   Czułość korekta Begga–Greenesa 0.803   0.801 0.001139 0.729 0.871
 Swoistość korekta Begga–Greenesa 0.909   0.900 0.000236 0.885 0.915
Rysunki na stronie powstały z obiektów p1 i p2 z tego kodu z motywem serwisu; dane, geometrie i skale są identyczne. Ziarno 606 i parametry (chorobowość 20%, czułość .80, swoistość .90, weryfikacja 25% ujemnych) pochodzą z przykładu; 1000 powtórzeń używa osobnego ziarna 6061. Żadnego ziarna nie dobierano.
Jak tego uniknąć
- Planuj standard referencyjny dla wszystkich uczestników albo dla losowej, z góry ustalonej części osób z wynikiem ujemnym.
- Używaj jednego standardu dla wszystkich. Lijmer i in. (1999) wykazali, że różne testy referencyjne dla wyników dodatnich i ujemnych zawyżały dokładność w porównaniu z jednym standardem.
- Oceniaj standard bez znajomości wyniku testu (zaślepienie).
Jak opisać w pracy
Na co uważać
- Korekta wymaga założenia. Jeśli lekarz kierował na weryfikację także na podstawie objawów, których nie ma w danych, korekta nie usuwa obciążenia. To sytuacja podobna do braków typu MNAR w brakach danych.
- Obciążenie przechodzi dalej. Z błędnej czułości i swoistości wynikają błędne ilorazy wiarygodności i krzywa ROC.
- Pokrewne błędy. Błąd weryfikacji to odmiana błędu selekcji; sam dobór uczestników zniekształca natomiast błąd spektrum. Liczbę osób zweryfikowanych pokazuje diagram przepływu z wytycznych STARD.
Błąd weryfikacji w R
Kod symuluje stan chorobowy i wynik testu, weryfikuje wszystkie wyniki dodatnie i 25% ujemnych, a potem porównuje czułość i swoistość: przy pełnej weryfikacji, tylko u zweryfikowanych i po korekcie Begga–Greenesa. Liczby w tekście pochodzą z tego kodu.
Częściowa weryfikacja i korekta Begga–Greenesa
R
set.seed(606)                                    # 2000 pacjentów, chorobowość 20%
n <- 2000
D <- rbinom(n, 1, 0.20)                          # prawdziwy stan (standard referencyjny)
T <- ifelse(D == 1, rbinom(n, 1, 0.80), rbinom(n, 1, 0.10))  # czułość .80, swoistość .90
V <- ifelse(T == 1, 1, rbinom(n, 1, 0.25))       # weryfikacja: wszyscy dodatni, 25% ujemnych
pelne  <- c(czulosc = mean(T[D == 1]), swoistosc = mean(1 - T[D == 0]))
naiwne <- c(czulosc = mean(T[V == 1 & D == 1]), swoistosc = mean(1 - T[V == 1 & D == 0]))
pT  <- mean(T)                                   # P(T+) z całej próby
pDp <- mean(D[V == 1 & T == 1]); pDm <- mean(D[V == 1 & T == 0])  # P(D+ | T) wśród zweryfikowanych
begg <- c(czulosc   = pT * pDp / (pT * pDp + (1 - pT) * pDm),
          swoistosc = (1 - pT) * (1 - pDm) / ((1 - pT) * (1 - pDm) + pT * (1 - pDp)))
table(wynik_testu = T, zweryfikowany = V)               # kto dostał standard referencyjny
round(rbind(pelna_weryfikacja = pelne, tylko_zweryfikowani = naiwne, korekta_Begga_Greenesa = begg), 3)
Wynik w R
           zweryfikowany
wynik_testu    0    1
          0 1118  397
          1    0  485
                       czulosc swoistosc
pelna_weryfikacja        0.799     0.909
tylko_zweryfikowani      0.940     0.724
korekta_Begga_Greenesa   0.803     0.909
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia bez dodatkowych pakietów); rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego częściowa weryfikacja zawyża czułość testu?
Chorzy z wynikiem ujemnym rzadko trafiają na standard referencyjny, więc w danych brakuje fałszywie ujemnych wyników. Odsetek dodatnich wśród zweryfikowanych chorych rośnie, a swoistość spada, bo zweryfikowani zdrowi to głównie fałszywie dodatni.
Kiedy korekta Begga–Greenesa daje poprawny wynik?
Gdy o weryfikacji decydował tylko wynik testu (i ewentualnie zmienne zapisane w danych), a nie nieodnotowane objawy. Potrzebna jest też liczba osób z każdym wynikiem testu w całej próbie, także niezweryfikowanych.
Czy weryfikacja różnicowa to też błąd weryfikacji?
Tak, to jego odmiana: dodatni dostają np. biopsję, a ujemni tylko obserwację kliniczną. Dwa standardy różnią się trafnością, więc wyniki obu grup nie są porównywalne i dokładność testu bywa zawyżona.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Begg, C. B., & Greenes, R. A. (1983). Assessment of diagnostic tests when disease verification is subject to selection bias. Biometrics, 39(1), 207–215. https://doi.org/10.2307/2530820
- Lijmer, J. G., Mol, B. W., Heisterkamp, S., Bonsel, G. J., Prins, M. H., van der Meulen, J. H. P., & Bossuyt, P. M. M. (1999). Empirical evidence of design-related bias in studies of diagnostic tests. JAMA, 282(11), 1061–1066. https://doi.org/10.1001/jama.282.11.1061
- Whiting, P., Rutjes, A. W. S., Reitsma, J. B., Glas, A. S., Bossuyt, P. M. M., & Kleijnen, J. (2004). Sources of variation and bias in studies of diagnostic accuracy: A systematic review. Annals of Internal Medicine, 140(3), 189–202. https://doi.org/10.7326/0003-4819-140-3-200402030-00010 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{begg1983assessment, author={Begg, Colin B. and Greenes, Robert A.}, title={{Assessment of diagnostic tests when disease verification is subject to selection bias}}, journal={Biometrics}, year={1983}, volume={39}, number={1}, pages={207--215}, doi={10.2307/2530820}}@article{lijmer1999empirical, author={Lijmer, Jeroen G. and Mol, Ben Willem and Heisterkamp, Siem and Bonsel, Gouke J. and Prins, Martin H. and van der Meulen, Jan H. P. and Bossuyt, Patrick M. M.}, title={{Empirical evidence of design-related bias in studies of diagnostic tests}}, journal={JAMA}, year={1999}, volume={282}, number={11}, pages={1061--1066}, doi={10.1001/jama.282.11.1061}}@article{whiting2004sources, author={Whiting, Penny and Rutjes, Anne W. S. and Reitsma, Johannes B. and Glas, Afina S. and Bossuyt, Patrick M. M. and Kleijnen, Jos}, title={{Sources of variation and bias in studies of diagnostic accuracy: A systematic review}}, journal={Annals of Internal Medicine}, year={2004}, volume={140}, number={3}, pages={189--202}, doi={10.7326/0003-4819-140-3-200402030-00010}}