Co to jest błąd spektrum?
Błąd spektrum (ang. spectrum bias) to zawyżenie albo zaniżenie czułości i swoistości testu diagnostycznego, gdy osoby w badaniu nie przypominają pacjentów, u których test będzie potem stosowany. Ransohoff i Feinstein (1978) zwrócili uwagę, że jeśli grupa chorych i grupa bez choroby nie obejmują odpowiednio szerokiego spektrum przypadków, test może uzyskać fałszywie wysokie wartości. Typowa sytuacja to porównanie wyraźnie chorych ze zdrowymi ochotnikami: test łatwo rozróżnia skrajności, ale gorzej radzi sobie z przypadkami łagodnymi i z osobami, które mają podobne objawy z innej przyczyny.
Przykład
W symulacji ten sam test z tym samym progiem oceniono dwa razy. W schemacie dwugrupowym (200 osób w zaawansowanym stadium choroby i 200 zdrowych ochotników) czułość wyniosła .890, a swoistość .905. W pełnym spektrum klinicznym (dodatkowo 200 chorych we wczesnym stadium i 200 osób bez choroby, ale z podobnymi objawami) czułość spadła do .762, a swoistość do .767. Lijmer i in. (1999) w analizie 184 badań wykazali, że badania porównujące chorych z oddzielną grupą kontrolną zawyżały diagnostyczny iloraz szans około trzykrotnie w porównaniu z badaniami prowadzonymi w populacji klinicznej.
Na rysunku
Oba rysunki używają 800 osób z przykładu; zmienia się tylko to, kogo włączono do oceny.
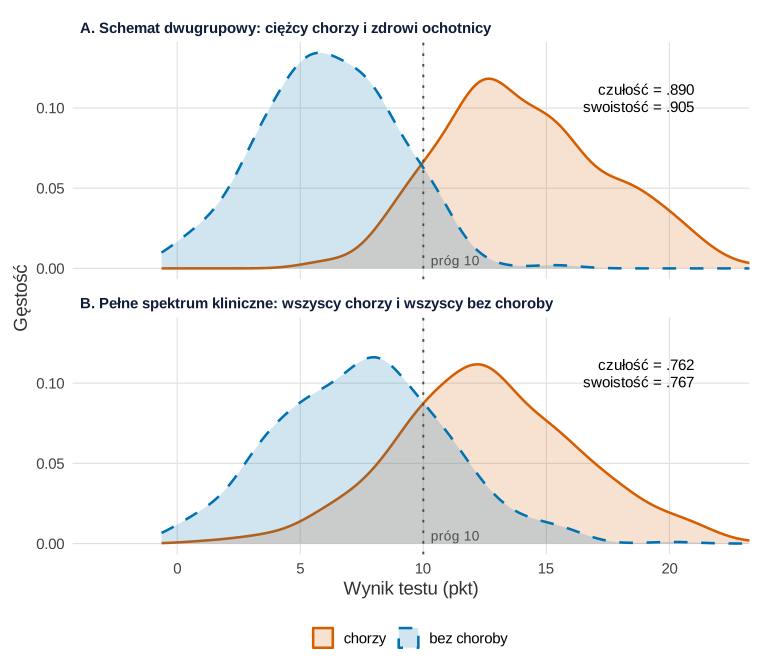
Co widać. W panelu A ciężko chorzy i zdrowi ochotnicy leżą daleko od siebie. W panelu B chorzy we wczesnym stadium przesuwają rozkład chorych w lewo, a osoby z podobnymi objawami – rozkład bez choroby w prawo. Strefa wspólna rośnie i przy tym samym progu czułość spada z .890 do .762, swoistość z .905 do .767. Test się nie zmienił – zmieniła się próba.
Na co uważać. Krzywe są wygładzone (pasmo 1 punkt, ustawione ręcznie). Chorzy to połowa próby – to cecha schematu, a nie chorobowość w populacji, więc z rysunku nie odczytasz wartości predykcyjnych.
Podpis do pracy:
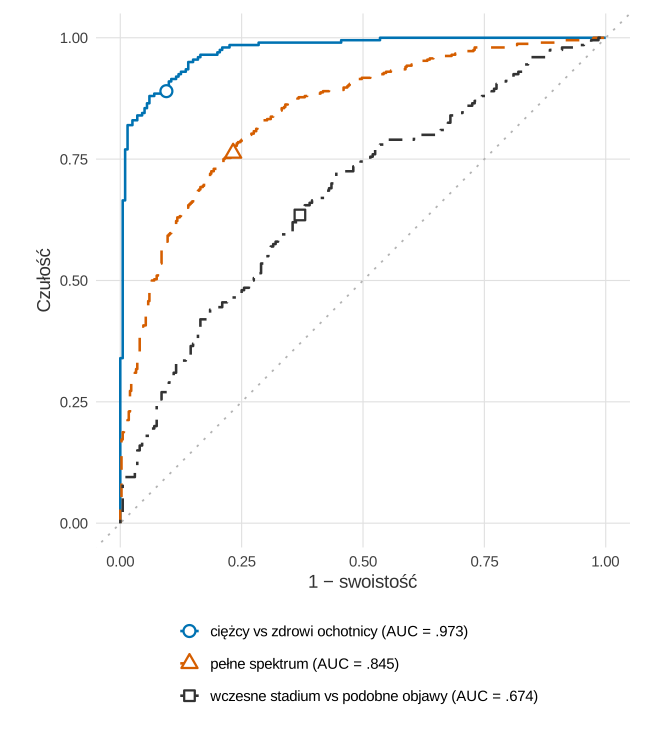
Co widać. W schemacie dwugrupowym krzywa przylega do lewego górnego rogu (AUC = .973). W pełnym spektrum leży niżej (AUC = .845), a w najtrudniejszym porównaniu – wczesne stadium wobec osób z podobnymi objawami – blisko przekątnej (AUC = .674; przy progu 10 czułość .635 i swoistość .630). Taka analiza w podgrupach (Mulherin i Miller, 2002) pokazuje, gdzie test zawodzi.
Na co uważać. Krzywa dla całej próby miesza podgrupy w proporcjach z badania; w poradni z przewagą łagodnych przypadków test zachowa się bliżej dolnej krzywej. Krzywe nie mają przedziałów ufności. Mechanikę krzywej i wybór progu pokazuje wpis Krzywa ROC w obrazkach.
Podpis do pracy:
Kod R rysunków 1–2
# Rysunki 1–2: ten sam test i ten sam próg w dwóch schematach doboru (dane symulowane jak w przykładzie)
library(ggplot2)

# Paleta Okabe–Ito (cynober i niebieski rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(chorzy = "#D55E00", bez = "#0072B2", trudne = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0),
        plot.background = element_rect(fill = "white", colour = NA))

set.seed(605)                                    # to samo ziarno i te same grupy co w przykładzie z hasła
prog <- 10
ciezcy   <- rnorm(200, 14, 3)                    # chorzy w zaawansowanym stadium
lagodni  <- rnorm(200, 11, 3)                    # chorzy we wczesnym stadium
zdrowi   <- rnorm(200,  6, 3)                    # zdrowi ochotnicy
podobni  <- rnorm(200,  9, 3)                    # bez choroby, ale z podobnymi objawami

schematy <- list("A. Schemat dwugrupowy: ciężcy chorzy i zdrowi ochotnicy" = list(ch = ciezcy, bez = zdrowi),
                 "B. Pełne spektrum kliniczne: wszyscy chorzy i wszyscy bez choroby" =
                   list(ch = c(ciezcy, lagodni), bez = c(zdrowi, podobni)))

# Rysunek 1: rozkłady wyniku testu u chorych i bez choroby z progiem 10
dane1 <- do.call(rbind, lapply(names(schematy), function(s) rbind(
  data.frame(schemat = s, grupa = "chorzy", wynik = schematy[[s]]$ch),
  data.frame(schemat = s, grupa = "bez choroby", wynik = schematy[[s]]$bez))))
dane1$grupa <- factor(dane1$grupa, c("chorzy", "bez choroby"))
miary <- data.frame(schemat = names(schematy),
                    czulosc = sapply(schematy, function(s) mean(s$ch >= prog)),
                    swoistosc = sapply(schematy, function(s) mean(s$bez < prog)))
bz <- function(x) sub("^0\\.", ".", sprintf("%.3f", x))      # zapis bez zera wiodącego
miary$etykieta <- sprintf("czułość = %s\nswoistość = %s", bz(miary$czulosc), bz(miary$swoistosc))
print(miary[, c("czulosc", "swoistosc")], digits = 3, row.names = FALSE)
p1 <- ggplot(dane1, aes(wynik, colour = grupa, fill = grupa, linetype = grupa)) +
  geom_density(alpha = 0.18, linewidth = 0.9, bw = 1, n = 256) +
  geom_vline(xintercept = prog, colour = "grey30", linetype = "dotted", linewidth = 0.7) +
  geom_text(data = miary, aes(x = 21, y = 0.115, label = etykieta), inherit.aes = FALSE,
            hjust = 1, vjust = 1, size = 4, lineheight = 0.95) +
  annotate("text", x = prog + 0.3, y = 0.005, label = "próg 10", hjust = 0, size = 3.6, colour = "grey30") +
  facet_wrap(~ schemat, ncol = 1) +
  scale_colour_manual(values = unname(kol[c("chorzy", "bez")]), name = NULL) +
  scale_fill_manual(values = unname(kol[c("chorzy", "bez")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  coord_cartesian(xlim = c(-3, 22)) +
  labs(x = "Wynik testu (pkt)", y = "Gęstość") + motyw

# Rysunek 2: krzywe ROC dla trzech porównań; punkt = próg 10
roc <- function(ch, bez, opis) {
  t <- c(Inf, sort(unique(c(ch, bez)), decreasing = TRUE), -Inf)
  data.frame(porownanie = opis, fpr = sapply(t, function(k) mean(bez >= k)), tpr = sapply(t, function(k) mean(ch >= k)))
}
auc <- function(ch, bez) mean(outer(ch, bez, ">"))          # AUC = P(wynik chorego > wynik osoby bez choroby)
por <- list("ciężcy vs zdrowi ochotnicy" = list(ciezcy, zdrowi),
            "pełne spektrum" = list(c(ciezcy, lagodni), c(zdrowi, podobni)),
            "wczesne stadium vs podobne objawy" = list(lagodni, podobni))
wyn <- data.frame(porownanie = names(por), AUC = sapply(por, function(p) auc(p[[1]], p[[2]])),
                  czulosc = sapply(por, function(p) mean(p[[1]] >= prog)),
                  swoistosc = sapply(por, function(p) mean(p[[2]] < prog)))
print(wyn, digits = 3, row.names = FALSE)
krzywe <- do.call(rbind, lapply(names(por), function(n) roc(por[[n]][[1]], por[[n]][[2]], n)))
krzywe$porownanie <- factor(krzywe$porownanie, names(por),
                            sprintf("%s (AUC = %s)", names(por), bz(wyn$AUC)))
punkty <- data.frame(porownanie = levels(krzywe$porownanie), fpr = 1 - wyn$swoistosc, tpr = wyn$czulosc)
punkty$porownanie <- factor(punkty$porownanie, levels(krzywe$porownanie))
p2 <- ggplot(krzywe, aes(fpr, tpr, colour = porownanie, linetype = porownanie)) +
  geom_abline(colour = "grey70", linetype = "dotted") +
  geom_step(direction = "vh", linewidth = 0.9) +
  geom_point(data = punkty, aes(shape = porownanie), size = 3.4, fill = "white", stroke = 1.2) +
  scale_colour_manual(values = unname(kol[c("bez", "chorzy", "trudne")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  scale_shape_manual(values = c(21, 24, 22), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  coord_equal() +
  labs(x = "1 − swoistość", y = "Czułość") + motyw

p1   # zapis: ggsave("blad-spektrum-rozklady.svg", p1, width = 8, height = 7)
p2   # zapis: ggsave("blad-spektrum-roc.svg", p2, width = 7, height = 7.6)
Wynik w R
 czulosc swoistosc
   0.890     0.905
   0.762     0.767
                        porownanie   AUC czulosc swoistosc
        ciężcy vs zdrowi ochotnicy 0.973   0.890     0.905
                    pełne spektrum 0.845   0.762     0.767
 wczesne stadium vs podobne objawy 0.674   0.635     0.630
Rysunki na stronie powstały z obiektów p1 i p2 z tego kodu z motywem serwisu; dane, geometrie i skale są identyczne. Ziarno 605 i parametry grup pochodzą z przykładu i nie były dobierane. AUC to odsetek par chory–osoba bez choroby, w których chory ma wyższy wynik.
Jak tego uniknąć
- Rekrutuj kolejnych pacjentów z grupy, w której test ma być używany, np. wszystkie osoby kierowane na diagnostykę, zamiast dobierać osobno chorych i zdrowych.
- Opisz rozkład nasilenia choroby, objawów i chorób współistniejących w próbie.
- Podawaj czułość i swoistość w podgrupach. Mulherin i Miller (2002) proponują nazwę efekt spektrum: różnice między podgrupami nie są błędem, jeśli zostaną przeanalizowane osobno, np. w warstwach, za pomocą ilorazów wiarygodności albo osobnych krzywych ROC.
Jak opisać w pracy
Na co uważać
- Zmieniają się też miary pochodne. Ilorazy wiarygodności i wartości predykcyjne liczy się z tych samych czułości i swoistości, więc dziedziczą zawyżenie.
- Inne miejsce, inne spektrum. Test oceniony w szpitalu specjalistycznym zwykle działa gorzej w badaniu przesiewowym, gdzie przeważają przypadki łagodne.
- Pokrewne problemy. Błąd spektrum jest szczególną postacią błędu selekcji. Osobnym problemem jest błąd weryfikacji, gdy standard referencyjny otrzymuje tylko część uczestników.
Błąd spektrum w R
Kod symuluje wyniki testu w czterech grupach i liczy czułość oraz swoistość przy tym samym progu raz w schemacie dwugrupowym, a raz w pełnym spektrum klinicznym. Liczby w tekście pochodzą z tego kodu.
Czułość i swoistość w dwóch schematach doboru
R
set.seed(605)                                    # wynik testu (skala ciągła), próg 10
prog <- 10
ciezcy   <- rnorm(200, 14, 3)                    # chorzy w zaawansowanym stadium
lagodni  <- rnorm(200, 11, 3)                    # chorzy we wczesnym stadium
zdrowi   <- rnorm(200,  6, 3)                    # zdrowi ochotnicy
podobni  <- rnorm(200,  9, 3)                    # bez choroby, ale z podobnymi objawami
czul <- function(x) mean(x >= prog); swoi <- function(x) mean(x < prog)
round(rbind(
  "kliniczno-kontrolny (ciężcy + zdrowi)" = c(czulosc = czul(ciezcy), swoistosc = swoi(zdrowi)),
  "pełne spektrum kliniczne"              = c(czulosc = czul(c(ciezcy, lagodni)),
                                              swoistosc = swoi(c(zdrowi, podobni)))), 3)
Wynik w R
                                      czulosc swoistosc
kliniczno-kontrolny (ciężcy + zdrowi)   0.890     0.905
pełne spektrum kliniczne                0.762     0.767
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia bez dodatkowych pakietów); rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy badanie kliniczno-kontrolne testu zawsze daje błąd spektrum?
Nie zawsze, ale ryzyko jest duże, gdy chorych dobiera się spośród ciężkich przypadków, a kontrole spośród zdrowych ochotników. Bezpieczniej rekrutować kolejnych pacjentów z podejrzeniem choroby i dopiero u nich ustalać rozpoznanie.
Czym błąd spektrum różni się od efektu spektrum?
Efekt spektrum to rzeczywista zmienność czułości i swoistości między podgrupami, np. stadiami choroby. Staje się błędem, gdy próba nie odpowiada populacji docelowej, a wynik podaje się jako jedną liczbę bez analizy podgrup.
Jak sprawdzić w danych, czy test działa inaczej w podgrupach?
Policz czułość i swoistość z przedziałami ufności osobno dla stadiów choroby, płci czy miejsca rekrutacji i porównaj je. Przy małych podgrupach przedziały będą szerokie, więc wnioski formułuj ostrożnie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lijmer, J. G., Mol, B. W., Heisterkamp, S., Bonsel, G. J., Prins, M. H., van der Meulen, J. H. P., & Bossuyt, P. M. M. (1999). Empirical evidence of design-related bias in studies of diagnostic tests. JAMA, 282(11), 1061–1066. https://doi.org/10.1001/jama.282.11.1061
- Mulherin, S. A., & Miller, W. C. (2002). Spectrum bias or spectrum effect? Subgroup variation in diagnostic test evaluation. Annals of Internal Medicine, 137(7), 598–602. https://doi.org/10.7326/0003-4819-137-7-200210010-00011
- Ransohoff, D. F., & Feinstein, A. R. (1978). Problems of spectrum and bias in evaluating the efficacy of diagnostic tests. New England Journal of Medicine, 299(17), 926–930. https://doi.org/10.1056/nejm197810262991705
Cytowania BibTeX
@article{lijmer1999empirical, author={Lijmer, Jeroen G. and Mol, Ben Willem and Heisterkamp, Siem and Bonsel, Gouke J. and Prins, Martin H. and van der Meulen, Jan H. P. and Bossuyt, Patrick M. M.}, title={{Empirical evidence of design-related bias in studies of diagnostic tests}}, journal={JAMA}, year={1999}, volume={282}, number={11}, pages={1061--1066}, doi={10.1001/jama.282.11.1061}}@article{mulherin2002spectrum, author={Mulherin, Stephanie A. and Miller, William C.}, title={{Spectrum bias or spectrum effect? Subgroup variation in diagnostic test evaluation}}, journal={Annals of Internal Medicine}, year={2002}, volume={137}, number={7}, pages={598--602}, doi={10.7326/0003-4819-137-7-200210010-00011}}@article{ransohoff1978problems, author={Ransohoff, David F. and Feinstein, Alvan R.}, title={{Problems of spectrum and bias in evaluating the efficacy of diagnostic tests}}, journal={New England Journal of Medicine}, year={1978}, volume={299}, number={17}, pages={926--930}, doi={10.1056/nejm197810262991705}}