Zanim zaczniesz: co musisz mieć
Analiza ROC odpowiada na jedno pytanie: jak dobrze wynik skali odróżnia osoby, które mają dany stan, od osób, które go nie mają. W pracy magisterskiej pojawia się zwykle przy walidacji skali przesiewowej, przy skracaniu kwestionariusza albo przy sprawdzaniu, czy opublikowany próg działa w nowej grupie. Pojęcia omawiają hasła krzywa ROC, czułość i swoistość oraz indeks Youdena. Ten wpis prowadzi przez całą analizę w R, od danych do opisu w pracy.
Potrzebujesz trzech rzeczy:
- Wynik ilościowy lub porządkowy, np. sumę punktów skali. Nie dziel go wcześniej na grupy.
- Standard referencyjny, czyli dwukategorialne kryterium „stan jest albo go nie ma”. Najczęściej to rozpoznanie w ustrukturyzowanym wywiadzie klinicznym. Analiza ROC jest tak dobra jak to kryterium. To jeden z dowodów trafności kryterialnej.
- Niezależną ocenę. Osoba ustalająca rozpoznanie nie powinna znać wyniku skali. W przeciwnym razie AUC wyjdzie zawyżone.
Plan badania i raport opisuje lista STARD 2015 (Bossuyt i in., 2015). Ma 30 punktów. Dla tego wpisu najważniejsze są trzy z nich. Musisz zaznaczyć, czy próg ustalono z góry, czy wyznaczono go eksploracyjnie. Musisz podać tabelę krzyżową wyników skali i standardu referencyjnego. Każde oszacowanie dokładności musi mieć miarę precyzji, np. 95% CI.
Przykład: pełna i skrócona wersja skali
W badaniu symulowanym 300 osób zgłaszających się do poradni studenckiej wypełniło skalę objawów depresyjnych w dwóch wersjach. Wersja pełna ma 12 pozycji (wynik 0–36), a skrócona to 4 z nich (wynik 0–12). Następnie psycholog, który nie znał wyników skali, przeprowadził ustrukturyzowany wywiad. Epizod depresyjny rozpoznał u 45 osób (15.0%). Dane możesz pobrać jako plik CSV (kolumny rozpoznanie, skala_pelna, skala_krotka). Cały kod jest w sekcji ROC w R.
Pytania badawcze są dwa. Jak dobrze wersja pełna wykrywa epizod depresyjny i jaki próg wybrać? Czy wersja skrócona traci na trafności?
Krok 1. Opisz grupy i ustal kierunek
Zacznij od statystyk opisowych w obu grupach. Osoby z rozpoznaniem miały w wersji pełnej M = 22.44 (SD = 6.33), a osoby bez rozpoznania M = 9.13 (SD = 6.41). W wersji skróconej było to 7.42 (SD = 2.65) wobec 3.18 (SD = 2.52).
Ta tabela mówi też, jaki jest kierunek: wyższy wynik oznacza więcej objawów. W funkcji roc() z pakietu pROC ustaw go jawnie (direction = "<") i podaj kolejność poziomów (levels = c("nie", "tak")). Bez tego pakiet zgaduje kierunek z danych. W słabej skali może go wtedy odwrócić i pokazać AUC powyżej .50 dla skali, która nie działa. Gdy wyższy wynik oznacza mniejsze ryzyko (np. skala dobrostanu), ustaw direction = ">".
Krok 2. Krzywa ROC i AUC z przedziałem ufności
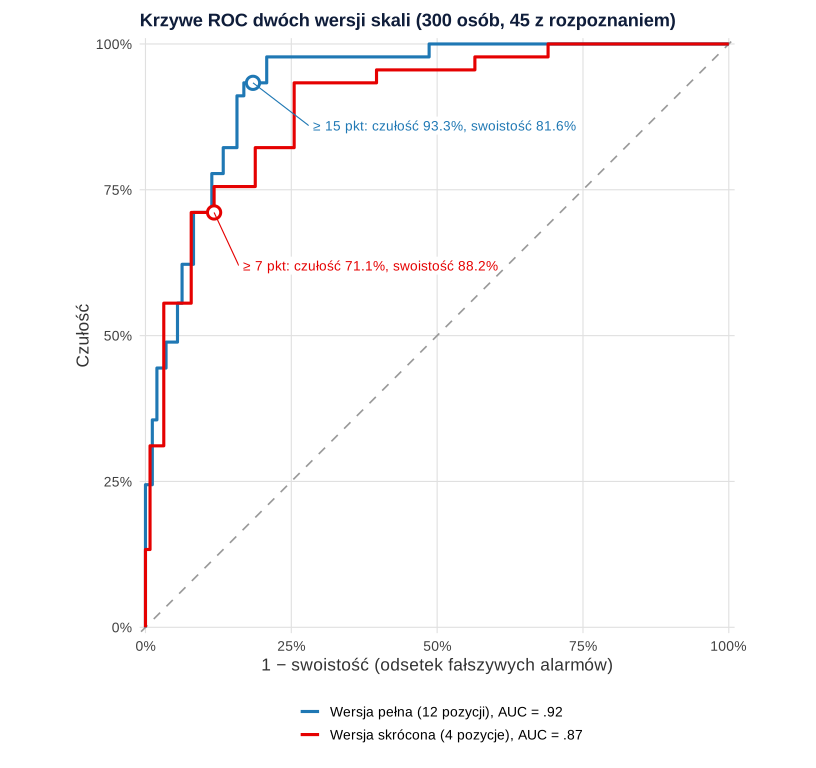
Pole pod krzywą wersji pełnej wyniosło AUC = .92, 95% CI [.89, .96]. Hanley i McNeil (1982) pokazali, że AUC to prawdopodobieństwo, że losowo wybrana osoba z rozpoznaniem uzyska wyższy wynik niż losowo wybrana osoba bez niego. To ta sama wielkość, którą szacuje statystyka Manna–Whitneya. W przykładzie w 92% takich par skala uporządkowała osoby poprawnie (remisy liczą się po połowie).
Pakiet pROC liczy przedział ufności dla AUC dwiema metodami (Robin i in., 2011):
- Metoda DeLonga (domyślna) to podejście nieparametryczne oparte na statystykach U (DeLong i in., 1988). Daje wynik od razu i nadaje się do większości prac. Tą samą metodą porównasz AUC dwóch skal na tych samych osobach (test DeLonga).
- Bootstrap losuje próby ze zwracaniem i liczy AUC w każdej z nich. W przykładzie 2000 prób dało 95% CI [.88, .95], czyli prawie to samo co metoda DeLonga.
Podaj jedną metodę i nazwij ją w tekście. Gdy grupa z rozpoznaniem jest mała, przedział będzie szeroki niezależnie od metody. Napisz to wprost. Orientacyjną skalę ocen AUC i jej ograniczenia omawia hasło krzywa ROC.
Krok 3. Tabela progów
Krzywa ROC to zbiór punktów (1 − swoistość, czułość) dla wszystkich możliwych progów. Do pracy potrzebujesz jednak liczb, a nie tylko rysunku. Funkcja coords(roc, "all") wypisuje czułość i swoistość dla każdego progu.
Uwaga na zapis progów w pROC. Pakiet podaje próg jako połowę odległości między sąsiednimi wynikami, np. 14.5. Przy wyniku całkowitym oznacza to regułę „wynik dodatni od 15 punktów”. W pracy pisz „≥ 15”, a nie „14.5”, bo nikt nie uzyska wyniku 14.5. W kodzie przeliczamy to funkcją ceiling().
| Wynik dodatni od | Czułość | Swoistość | J |
|---|---|---|---|
| 11 pkt | 97.8% | 63.9% | .617 |
| 12 pkt | 97.8% | 69.8% | .676 |
| 13 pkt | 97.8% | 75.3% | .731 |
| 14 pkt | 93.3% | 79.2% | .725 |
| 15 pkt | 93.3% | 81.6% | .749 |
| 16 pkt | 91.1% | 83.1% | .742 |
| 17 pkt | 82.2% | 84.3% | .665 |
| 18 pkt | 77.8% | 86.7% | .644 |
| 19 pkt | 71.1% | 88.6% | .597 |
Przy 45 osobach z rozpoznaniem każda osoba to 2.2 punktu procentowego czułości. Dlatego czułość zmienia się skokami: 97.8% to 44 z 45 osób, a 93.3% to 42 z 45. Rysunek 2 pokazuje tę samą tabelę w pełnym zakresie wyników.
Krok 4. Wybierz punkt odcięcia i uzasadnij regułę
Punkt odcięcia nie wynika z krzywej automatycznie. Wybierasz regułę, a ona wskazuje próg. Najczęstsze są trzy reguły.
- Indeks Youdena, J = czułość + swoistość − 1 (Youden, 1950). Wskazuje próg 15 pkt, J = .749. Traktuje przeoczenie i fałszywy alarm jako równie kosztowne.
- Punkt najbliżej lewego górnego rogu, czyli idealnej czułości i swoistości (
best.method = "closest.topleft"). Wskazuje 16 pkt. Perkins i Schisterman (2006) pokazali, że ta reguła i indeks Youdena czasem wskazują ten sam próg, a czasem różne. Spośród nich tylko J jest optymalny ze względu na łączny odsetek błędnych klasyfikacji. - Minimalna czułość ustalona z góry, np. co najmniej 95%. To reguła dla skali przesiewowej, która ma przeoczyć jak najmniej osób, bo wynik dodatni prowadzi tylko do pełnej diagnozy. Wskazuje 13 pkt: czułość 97.8%, swoistość 75.3%.
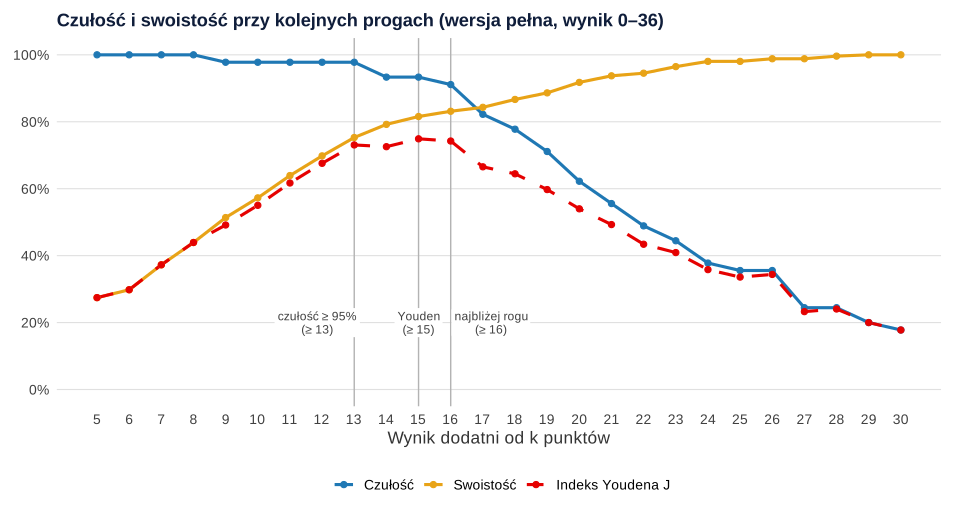
Rysunek 2 pokazuje coś ważnego: maksimum J jest płaskie. Progi 13, 14, 15 i 16 pkt dają J w przedziale .725–.749. Różnice między nimi wynikają z jednej lub dwóch osób. Wybór „najlepszego” progu z dokładnością do punktu jest więc w dużej mierze przypadkowy. Regułę wyboru zapisz przed analizą, najlepiej w planie badania, i uzasadnij ją celem skali, a nie tym, który próg ładniej wygląda.
Krok 5. Czułość i swoistość z przedziałami ufności
Dla wybranego progu zbuduj tabelę 2 × 2 (macierz pomyłek) i policz cztery miary z 95% CI. Każda z nich to proporcja, więc użyj przedziału Wilsona. Brown i in. (2001) pokazali, że standardowy przedział Walda zachowuje się zawodnie, i zalecają przy małych liczebnościach przedział Wilsona. Więcej o tej metodzie znajdziesz w haśle przedział ufności dla proporcji.
| Wynik skali | Rozpoznanie: tak | Rozpoznanie: nie |
|---|---|---|
| Dodatni (≥ 15 pkt) | 42 (TP) | 47 (FP) |
| Ujemny (≤ 14 pkt) | 3 (FN) | 208 (TN) |
Czułość wyniosła 93.3%, 95% CI [82.1, 97.7], a swoistość 81.6%, 95% CI [76.4, 85.8]. Przedział dla czułości jest szeroki, bo opiera się na 45 osobach. Swoistość liczona na 255 osobach ma przedział dużo węższy.
Wartości predykcyjne wyniosły PPV = 47.2%, 95% CI [37.2, 57.5], i NPV = 98.6%, 95% CI [95.9, 99.5]. Mniej niż połowa osób z wynikiem dodatnim miała więc rozpoznanie. Wynik ujemny prawie zawsze oznaczał jego brak. Trevethan (2017) zaleca podawać w badaniach przesiewowych wszystkie cztery miary. PPV i NPV zależą jednak od częstości zaburzenia, która tu wyniosła 15.0%. Jak je przeliczyć dla innej populacji, wyjaśniają hasła wartość predykcyjna i iloraz wiarygodności.
Ważne zastrzeżenie. Przedział Wilsona zakłada, że próg był znany przed zebraniem danych. Próg 15 pkt wybraliśmy jednak na tych samych danych, więc oszacowania są zbyt optymistyczne. Leeflang i in. (2008) pokazali, że przy prawdziwej czułości i swoistości 84% badania z 40 osobami dawały średnio około 90%, a z 200 osobami 86%. Jak oszacować ten optymizm bootstrapem i jak niestabilny bywa „optymalny” próg, pokazujemy w kroku 7 wpisu skala Tinetti – analiza wyników. Tutaj tylko zapamiętaj zasadę: próg wyznaczony na własnych danych opisz jako eksploracyjny i zaproponuj sprawdzenie go w niezależnej próbie (zob. walidacja krzyżowa).
Krok 6. Porównaj dwie skale testem DeLonga
Wersja skrócona miała AUC = .87, 95% CI [.81, .92]. Jej najlepszy próg według indeksu Youdena to 7 pkt (z 12): czułość 71.1%, swoistość 88.2%. Czy różnica AUC .92 i .87 jest większa, niż mógłby dać przypadek?
Obie skale wypełniły te same osoby, więc ich krzywe są skorelowane. Nie porównuj ich „na oko” po nakładaniu się przedziałów ufności. Użyj testu dla skorelowanych krzywych (DeLong i in., 1988), w pROC funkcji roc.test(..., paired = TRUE). Różnica wyniosła .053, 95% CI [.022, .084], z = 3.33, p < .001. Skrócenie skali z 12 do 4 pozycji wyraźnie obniżyło trafność. Przy progu Youdena wersja skrócona przeoczyłaby 13 z 45 osób, a pełna tylko 3. Gdy porównujesz skale wypełnione przez różne osoby, ustaw paired = FALSE.
Czy więc skracać skalę? Zależy od celu. Do szybkiego przesiewu w dużej grupie skrócona wersja z niższym progiem może wystarczyć, ale trzeba to pokazać na danych. Jak budować i skracać skale, opisuje wpis jak zbudować i zwalidować skalę psychometryczną. Przykład dwóch krótkich przesiewów pokazujemy we wpisie PHQ-2 i GAD-2.
Jak opisać analizę ROC w pracy
W metodzie podaj standard referencyjny i to, czy diagnosta znał wynik skali. Dodaj regułę wyboru progu i informację, czy ustalono ją przed analizą. Na koniec nazwij metodę liczenia przedziałów ufności. W wynikach podaj liczebności grup, AUC z CI, tabelę progów (np. jako tabelę w aneksie) i wybrany próg z czterema miarami. Wzór na podstawie przykładu:
Krzywą pokaż na rysunku z przekątną i zaznaczonym progiem, jak na rysunku 1. Gdy skala ma przewidywać przyszłe zdarzenie, a obok niej masz inne predyktory, przejdź do regresji logistycznej i oceny modelu opisanej we wpisie modele predykcyjne: walidacja i kalibracja.
ROC w R: AUC, progi, Youden i test DeLonga
Kod odtwarza wszystkie liczby z tekstu i zapisuje plik CSV do pobrania. Krzywe, AUC z przedziałami, tabelę progów i test DeLonga liczy pakiet pROC, a przedziały Wilsona dla czułości, swoistości, PPV i NPV – funkcja BinomCI() z pakietu DescTools.
Analiza ROC krok po kroku
R
# B187 – krzywa ROC i punkt odcięcia skali krok po kroku (dane symulowane, set.seed(1871))
# 300 osób zgłaszających się do poradni studenckiej wypełnia skalę objawów depresyjnych:
# wersję pełną (12 pozycji 0–3, wynik 0–36) i skróconą (4 pozycje, 0–12).
# Standard referencyjny: rozpoznanie epizodu depresyjnego w ustrukturyzowanym wywiadzie
# przeprowadzonym przez osobę, która nie znała wyników skali.
suppressPackageStartupMessages({ library(pROC); library(DescTools) })
set.seed(1871)
n <- 300
nasilenie <- rnorm(n)                                             # ukryte nasilenie objawów
rozp <- as.integer(nasilenie + rnorm(n, 0, 0.55) > 1.05)          # rozpoznanie w wywiadzie
progi <- c(-0.35, 0.55, 1.35)
poz <- sapply(1:12, function(j) findInterval(0.72 * nasilenie + rnorm(n, 0, 0.70),
                                             progi + c(-0.2, 0, 0.1, 0.2)[(j %% 4) + 1]))
dane <- data.frame(id = 1:n,
                   rozpoznanie = factor(ifelse(rozp == 1, "tak", "nie"), levels = c("nie", "tak")),
                   skala_pelna = rowSums(poz), skala_krotka = rowSums(poz[, 1:4]))
write.csv(dane, "../krzywa-roc-dane-przyklad.csv", row.names = FALSE)

# Krok 1. Liczebności i wyniki w obu grupach (kierunek: wyższy wynik = więcej objawów)
table(dane$rozpoznanie)
aggregate(cbind(skala_pelna, skala_krotka) ~ rozpoznanie, dane,
          function(x) round(c(M = mean(x), SD = sd(x)), 2))

# Krok 2. Krzywa ROC i AUC z 95% CI (DeLong i bootstrap)
roc_p <- roc(dane$rozpoznanie, dane$skala_pelna, levels = c("nie", "tak"), direction = "<", quiet = TRUE)
round(ci.auc(roc_p, method = "delong"), 3)
set.seed(18712)
round(ci.auc(roc_p, method = "bootstrap", boot.n = 2000), 3)

# Krok 3. Tabela progów: pROC podaje progi jako połowy między wynikami (np. 13.5 = „wynik >= 14”)
tp <- coords(roc_p, "all", ret = c("threshold", "sensitivity", "specificity"), transpose = FALSE)
tp$od <- ceiling(tp$threshold)
tp$J <- tp$sensitivity + tp$specificity - 1
print(round(subset(tp, od >= 11 & od <= 19)[, c("od", "sensitivity", "specificity", "J")], 3), row.names = FALSE)

# Krok 4. Trzy reguły wyboru progu
youden <- coords(roc_p, "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity"), transpose = FALSE)
lewy_gorny <- coords(roc_p, "best", best.method = "closest.topleft", ret = c("threshold", "sensitivity", "specificity"), transpose = FALSE)
czul95 <- tail(subset(tp, sensitivity >= .95), 1)                # najwyższy próg z czułością co najmniej 95%
wybor <- rbind(Youden = youden, najblizej_rogu = lewy_gorny, czulosc_95 = czul95[, 1:3])
wybor$od <- ceiling(wybor$threshold)
round(wybor[, c("od", "sensitivity", "specificity")], 3)

# Krok 5. Czułość i swoistość z 95% CI Wilsona oraz PPV i NPV dla progu „>= 15”
dodatni <- dane$skala_pelna >= 15
tab <- table(wynik = factor(dodatni, c(TRUE, FALSE), c("dodatni", "ujemny")), rozpoznanie = dane$rozpoznanie)[, c("tak", "nie")]
tab
TP <- tab["dodatni", "tak"]; FN <- tab["ujemny", "tak"]; FP <- tab["dodatni", "nie"]; TN <- tab["ujemny", "nie"]
round(100 * rbind(czulosc = BinomCI(TP, TP + FN, method = "wilson")[1, ],
                  swoistosc = BinomCI(TN, TN + FP, method = "wilson")[1, ],
                  PPV = BinomCI(TP, TP + FP, method = "wilson")[1, ],
                  NPV = BinomCI(TN, TN + FN, method = "wilson")[1, ]), 1)

# Krok 6. Wersja skrócona i porównanie dwóch skorelowanych krzywych (te same osoby)
roc_k <- roc(dane$rozpoznanie, dane$skala_krotka, levels = c("nie", "tak"), direction = "<", quiet = TRUE)
round(ci.auc(roc_k, method = "delong"), 3)
tk <- coords(roc_k, "all", ret = c("threshold", "sensitivity", "specificity"), transpose = FALSE)
tk$od <- ceiling(tk$threshold); tk$J <- tk$sensitivity + tk$specificity - 1
print(round(tk[which.max(tk$J), c("od", "sensitivity", "specificity", "J")], 3), row.names = FALSE)
rt <- roc.test(roc_p, roc_k, method = "delong", paired = TRUE)
round(c(AUC_pelna = unname(rt$estimate[1]), AUC_krotka = unname(rt$estimate[2]), z = unname(rt$statistic),
        roznica = unname(diff(rev(rt$estimate)))), 3)
format.pval(rt$p.value, digits = 3, eps = .001)
round(rt$conf.int, 3)
Wynik w R
nie tak
255  45
  rozpoznanie skala_pelna.M skala_pelna.SD skala_krotka.M skala_krotka.SD
1         nie          9.13           6.41           3.18            2.52
2         tak         22.44           6.33           7.42            2.65
[1] 0.888 0.922 0.956
 2.5%   50% 97.5%
0.884 0.924 0.953
 od sensitivity specificity     J
 11       0.978       0.639 0.617
 12       0.978       0.698 0.676
 13       0.978       0.753 0.731
 14       0.933       0.792 0.725
 15       0.933       0.816 0.749
 16       0.911       0.831 0.742
 17       0.822       0.843 0.665
 18       0.778       0.867 0.644
 19       0.711       0.886 0.597
               od sensitivity specificity
Youden         15       0.933       0.816
najblizej_rogu 16       0.911       0.831
czulosc_95     13       0.978       0.753
         rozpoznanie
wynik     tak nie
  dodatni  42  47
  ujemny    3 208
           est lwr.ci upr.ci
czulosc   93.3   82.1   97.7
swoistosc 81.6   76.4   85.8
PPV       47.2   37.2   57.5
NPV       98.6   95.9   99.5
[1] 0.815 0.869 0.923
 od sensitivity specificity     J
  7       0.711       0.882 0.593
 AUC_pelna AUC_krotka          z    roznica
     0.922      0.869      3.326      0.053
[1] "<0.001"
[1] 0.022 0.084
attr(,"conf.level")
[1] 0.95
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizie ROC
- Próg z własnych danych ogłoszony jako „norma”. To próg eksploracyjny, zawyżony i niestabilny. Napisz to wprost i zaproponuj sprawdzenie w nowej próbie.
- „14.5 punktu” w tekście. Przelicz próg z pROC na regułę dla wyników całkowitych („≥ 15”).
- Brak przedziałów ufności. Czułość 93.3% oparta na 45 osobach ma przedział od 82.1% do 97.7%. Bez niego czytelnik nie widzi, jak mało wie.
- Kierunek zgadywany przez program. Ustaw
directionilevelsjawnie, zwłaszcza dla skal, w których wyższy wynik oznacza mniejsze ryzyko. - Porównanie dwóch skal po nakładaniu się przedziałów. Dla tych samych osób użyj testu DeLonga dla krzywych skorelowanych.
- PPV przeniesione do innej populacji. Przy innej częstości zaburzenia PPV i NPV będą inne, nawet jeśli czułość i swoistość się nie zmienią.
- Dychotomizacja zamiast analizy ciągłej. Próg służy decyzjom przesiewowym. W analizach związków między zmiennymi używaj wyniku ciągłego (zob. dzielenie medianą).
Analiza ROC to zwykle jeden z kilku etapów walidacji skali. Pozostałe opisuje przewodnik po psychometrii i budowie skal. Jeśli chcesz, żeby ktoś sprawdził wybór standardu referencyjnego, reguły progu i opis wyników w Twojej pracy, zajrzyj do oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Dlaczego pROC podaje punkt odcięcia z połówką, np. 14.5?
Pakiet pROC zapisuje próg jako połowę odległości między sąsiednimi zaobserwowanymi wynikami. Przy wynikach całkowitych próg 14.5 oznacza regułę „wynik dodatni od 15 punktów”. W pracy podaj regułę „≥ 15 pkt”, bo wyniku 14.5 nikt nie uzyska.
Jaki przedział ufności podać dla czułości i swoistości?
Czułość i swoistość to proporcje, więc użyj przedziału Wilsona (Brown i in., 2001), np. funkcją BinomCI(..., method = "wilson") z pakietu DescTools. Pamiętaj, że przedział zakłada próg znany z góry. Gdy próg wybrano na tych samych danych, oszacowania są dodatkowo zawyżone.
Czy metoda DeLonga i bootstrap dają ten sam przedział dla AUC?
Zwykle bardzo podobny. W przykładzie z tego wpisu metoda DeLonga dała 95% CI [.89, .96], a 2000 prób bootstrapowych [.88, .95]. Metoda DeLonga jest domyślna w pROC i wystarcza w większości prac. Wybierz jedną i nazwij ją w tekście.
Jak porównać pole pod krzywą dwóch kwestionariuszy?
Jeśli oba kwestionariusze wypełniły te same osoby, krzywe są skorelowane. Użyj testu DeLonga dla krzywych skorelowanych, w pROC roc.test(roc1, roc2, paired = TRUE) (DeLong i in., 1988). Podaj różnicę AUC z 95% CI, statystykę z i p, zamiast porównywać nakładanie się dwóch przedziałów.
Który próg wybrać, gdy indeks Youdena i punkt najbliżej rogu wykresu się różnią?
Te dwie reguły nie zawsze wskazują ten sam próg (Perkins i Schisterman, 2006). Rozstrzyga cel skali: w przesiewie, gdzie przeoczenie jest kosztowne, wybierz próg o ustalonej z góry minimalnej czułości. Gdy oba błędy są równie ważne, zostań przy indeksie Youdena. Regułę zapisz przed analizą.
Powiązane hasła
Przeczytaj też
Skala Tinetti – analiza wyników
Wersje skali, wynik 0–28 i podskale, korelacja z TUG, OR, krzywa ROC i progi z literatury oraz optymizm progu Youdena – z przykładem w R.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikPHQ-2 i GAD-2 – krótkie przesiewy
Suma dwóch pozycji 0–6, próg ≥ 3 lub ≥ 2, PHQ-4 i przesiew dwustopniowy – z przykładem w R, rzetelnością dwóch pozycji i wzorem opisu.
Czytaj →Wyznaczasz punkt odcięcia skali w pracy i nie wiesz, który próg obronić?
Sprawdzimy standard referencyjny, regułę wyboru progu i przedziały ufności oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bossuyt, P. M., Reitsma, J. B., Bruns, D. E., Gatsonis, C. A., Glasziou, P. P., Irwig, L., Lijmer, J. G., Moher, D., Rennie, D., de Vet, H. C. W., Kressel, H. Y., Rifai, N., Golub, R. M., Altman, D. G., Hooft, L., Korevaar, D. A., & Cohen, J. F. (2015). STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies. BMJ, 351, Article h5527. https://doi.org/10.1136/bmj.h5527 ● Otwarty dostęp
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Leeflang, M. M. G., Moons, K. G. M., Reitsma, J. B., & Zwinderman, A. H. (2008). Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions. Clinical Chemistry, 54(4), 729–737. https://doi.org/10.1373/clinchem.2007.096032
- Perkins, N. J., & Schisterman, E. F. (2006). The inconsistency of “optimal” cutpoints obtained using two criteria based on the receiver operating characteristic curve. American Journal of Epidemiology, 163(7), 670–675. https://doi.org/10.1093/aje/kwj063 ● Otwarty dostęp
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77 ● Otwarty dostęp
- Trevethan, R. (2017). Sensitivity, specificity, and predictive values: Foundations, pliabilities, and pitfalls in research and practice. Frontiers in Public Health, 5, Article 307. https://doi.org/10.3389/fpubh.2017.00307 ● Otwarty dostęp
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32–35. https://doi.org/10.1002/1097-0142(1950)3:1<32::aid-cncr2820030106>3.0.co;2-3 ● Otwarty dostęp
Cytowania BibTeX
@article{bossuyt2015stard, author={Bossuyt, Patrick M. and Reitsma, Johannes B. and Bruns, David E. and Gatsonis, Constantine A. and Glasziou, Paul P. and Irwig, Les and Lijmer, Jeroen G. and Moher, David and Rennie, Drummond and de Vet, Henrica C. W. and Kressel, Herbert Y. and Rifai, Nader and Golub, Robert M. and Altman, Douglas G. and Hooft, Lotty and Korevaar, Daniël A. and Cohen, Jérémie F.}, title={{STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies}}, journal={BMJ}, year={2015}, volume={351}, eid={h5527}, doi={10.1136/bmj.h5527}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{leeflang2008bias, author={Leeflang, Mariska M. G. and Moons, Karel G. M. and Reitsma, Johannes B. and Zwinderman, Aeilko H.}, title={{Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions}}, journal={Clinical Chemistry}, year={2008}, volume={54}, number={4}, pages={729--737}, doi={10.1373/clinchem.2007.096032}}@article{perkins2006inconsistency, author={Perkins, Neil J. and Schisterman, Enrique F.}, title={{The inconsistency of “optimal” cutpoints obtained using two criteria based on the receiver operating characteristic curve}}, journal={American Journal of Epidemiology}, year={2006}, volume={163}, number={7}, pages={670--675}, doi={10.1093/aje/kwj063}}@article{robin2011proc, author={Robin, Xavier and Turck, Natacha and Hainard, Alexandre and Tiberti, Natalia and Lisacek, Frédérique and Sanchez, Jean-Charles and Müller, Markus}, title={{pROC: An open-source package for R and S+ to analyze and compare ROC curves}}, journal={BMC Bioinformatics}, year={2011}, volume={12}, number={1}, eid={77}, doi={10.1186/1471-2105-12-77}}@article{trevethan2017sensitivity, author={Trevethan, Robert}, title={{Sensitivity, specificity, and predictive values: Foundations, pliabilities, and pitfalls in research and practice}}, journal={Frontiers in Public Health}, year={2017}, volume={5}, eid={307}, doi={10.3389/fpubh.2017.00307}}@article{youden1950index, author={Youden, W. J.}, title={{Index for rating diagnostic tests}}, journal={Cancer}, year={1950}, volume={3}, number={1}, pages={32--35}, doi={10.1002/1097-0142(1950)3:1<32::aid-cncr2820030106>3.0.co;2-3}}