Czym są PHQ-2 i GAD-2
PHQ-2 i GAD-2 to dwupozycyjne skróty dwóch popularnych kwestionariuszy przesiewowych. PHQ-2 składa się z pierwszych dwóch pozycji PHQ-9 i pyta, jak często w ostatnich dwóch tygodniach występowały obniżony nastrój i anhedonia, czyli utrata zainteresowania i przyjemności (Kroenke i in., 2003; Levis i in., 2020). GAD-2 to dwie podstawowe pozycje GAD-7, dotyczące objawów lękowych (Kroenke i in., 2007). Połączone dają czteropozycyjny PHQ-4 (Kroenke i in., 2009).
Krótkie wersje powstały z myślą o zatłoczonych przychodniach i długich ankietach zdrowotnych, w których każda dodatkowa pozycja kosztuje. W pracach dyplomowych pojawiają się z dwóch powodów. Pierwszy to badanie, w którym objawy depresji i lęku są tylko jedną z wielu zmiennych, np. w ankiecie o stylu życia pacjentów. Drugi to przesiew dwustopniowy: krótka wersja dla wszystkich, a pełna tylko dla osób z wynikiem dodatnim. Pełne wersje, ich progi nasilenia i procedurę dla pozycji 9 opisaliśmy we wpisie GAD-7 i PHQ-9 – jak policzyć wynik. Tutaj zajmujemy się tym, co jest specyficzne dla wersji dwupozycyjnych: wąskim zakresem wyniku, wyborem progu i rzetelnością skali z dwóch pozycji.
Budowa i liczenie wyniku
Każdą pozycję ocenia się na tej samej czterostopniowej skali co w pełnych wersjach, od 0 („wcale”) do 3 („prawie codziennie”) (Kroenke i in., 2003). Okres odniesienia to ostatnie dwa tygodnie, tak jak w PHQ-9 i GAD-7 (Spitzer i in., 2006). Nie ma pozycji odwróconych. Treści pozycji nie przytaczamy: weź je z oficjalnego formularza.
| Cecha | PHQ-2 | GAD-2 | PHQ-4 |
|---|---|---|---|
| Pozycje | 2 (pierwsze dwie z PHQ-9) | 2 (podstawowe z GAD-7) | 4 (PHQ-2 + GAD-2) |
| Kodowanie | 0–3 | 0–3 | 0–3 |
| Wynik | suma, 0–6 | suma, 0–6 | suma, 0–12, oraz dwa wyniki składowe |
| Próg przesiewowy | ≥ 3 | ≥ 3 | ≥ 3 osobno w każdej części |
| Źródło | Kroenke i in. (2003); Levis i in. (2020) | Kroenke i in. (2007); Plummer i in. (2016) | Kroenke i in. (2009); Löwe i in. (2010) |
Liczenie sprowadza się do trzech kroków. Najpierw sprawdź klucz odpowiedzi: formularz online często zapisuje odpowiedzi jako 1–4, a wtedy każdy wynik dwupozycyjny jest zawyżony o 2 punkty, co przy zakresie 0–6 całkowicie zmienia obraz. Potem zsumuj dwie pozycje. Na koniec porównaj wynik z progiem albo zostaw go jako zmienną ciągłą. Ogólną procedurę, także w Excelu i SPSS, pokazuje poradnik jak policzyć wynik kwestionariusza, a o tym, kiedy suma, a kiedy średnia, piszemy w haśle wynik skali: średnia czy suma. Tu suma jest jedynym rozsądnym wyborem, bo progi z literatury dotyczą sumy.
Braki. Przy pełnym PHQ-9 lub GAD-7 jedną brakującą odpowiedź można czasem uzupełnić średnią z pozostałych. Przy dwóch pozycjach taka reguła oznaczałaby zgadywanie połowy wyniku. Bezpieczniej uznać, że osoba bez jednej z dwóch odpowiedzi nie ma wyniku danej części, i opisać to w pracy jako decyzję badacza. Jeśli braków jest dużo, zajrzyj do hasła braki danych MCAR, MAR i MNAR.
Gdy masz już PHQ-9 albo GAD-7, nie dodawaj do ankiety osobnego PHQ-2 czy GAD-2. Wynik krótkiej wersji policzysz z odpowiednich pozycji pełnej skali, a dwukrotne pytanie o to samo tylko męczy osoby badane.
Próg ≥ 3, próg ≥ 2 i co z nich wynika
W pierwotnym badaniu PHQ-2 wynik co najmniej 3 miał czułość 83% i swoistość 92% dla dużej depresji w porównaniu z niezależnym wywiadem 580 pacjentów, a analiza krzywej ROC wskazała 3 jako optymalny punkt odcięcia (Kroenke i in., 2003). Przegląd autorów narzędzi podaje próg ≥ 3 dla obu krótkich wersji, a GAD-2 dobrze wykrywał nie tylko zaburzenie lękowe uogólnione, lecz także napadowe, lęk społeczny i PTSD (Kroenke i in., 2010). W metaanalizie dla GAD-2 próg 3 dawał czułość 0.76 i swoistość 0.81 w wykrywaniu zaburzenia lękowego uogólnionego, ale opierała się ona tylko na sześciu próbach (Plummer i in., 2016).
Nowsze dane każą spojrzeć na PHQ-2 inaczej. W metaanalizie danych indywidualnych ze 100 badań, czyli 44 318 osób, przy progu ≥ 3 czułość spadła do 0.72 przy swoistości 0.85. Próg ≥ 2 wykrywał 91% przypadków dużej depresji, kosztem swoistości 0.67 (Levis i in., 2020). Dlatego wybór progu zależy od celu:
- PHQ-2 jako jedyna miara w badaniu – zwykle ≥ 3, bo tak robi większość literatury i tak łatwiej porównać wyniki;
- PHQ-2 jako pierwszy krok przed PHQ-9 – raczej ≥ 2, bo pominięta na tym etapie osoba nie dostanie już pełnego kwestionariusza.
Rysunek 1 przelicza te czułości i swoistości na 1000 osób przy częstości dużej depresji 10%, takiej jak w danych metaanalizy. Strategia dwustopniowa (PHQ-2 ≥ 2, potem PHQ-9 ≥ 10) przeocza 18 osób z depresją, a sam PHQ-9 ≥ 10 – 14. Za to daje 117 zamiast 135 wyników fałszywie dodatnich, a pełny PHQ-9 wypełnia tylko 388 osób na 1000. Według naszego przeliczenia ok. 61% badanych nie musi go wypełniać. Levis i in. (2020) na rzeczywistych danych oszacowali tę oszczędność na 57%.
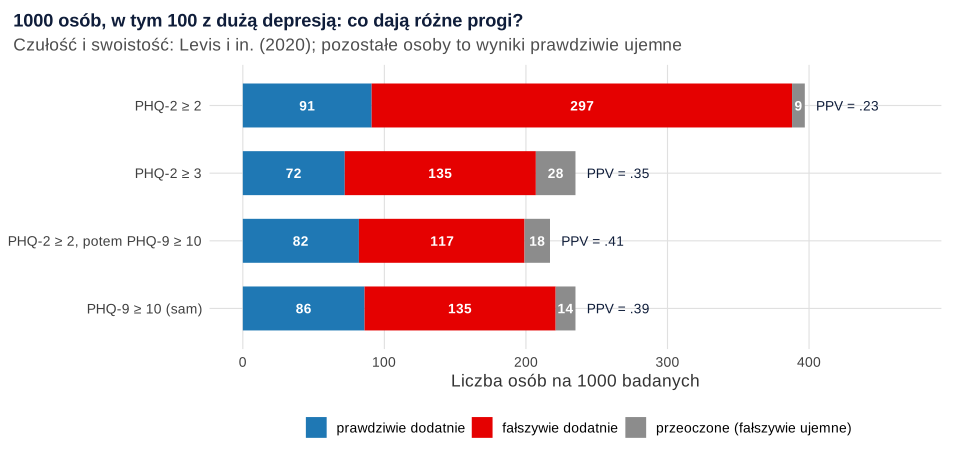
Najważniejszy wniosek dla autora pracy: nawet najlepsza z tych strategii daje wartość predykcyjną dodatnią około .41. Ponad połowa wyników dodatnich to osoby bez dużej depresji. Przy częstości 5% PPV progu PHQ-2 ≥ 3 spada do .202, a przy 20% rośnie do .545. Wynik ≥ 3 to sygnał do dalszej oceny, a nie rozpoznanie. Jak wartość predykcyjna zależy od częstości zaburzenia, szerzej pokazujemy na przykładzie PHQ-9 i WHO-5.
Wynik ≥ 3 jest w populacji ogólnej rzadki. W reprezentatywnej próbie mieszkańców Niemiec odpowiadał randze centylowej 93.4 w PHQ-2 i 95.2 w GAD-2 (Löwe i in., 2010). To dane niemieckie, nie polskie normy, ale pokazują, że w próbie nieklinicznej odsetek wyników dodatnich powinien być raczej niewielki. Jeśli wychodzi Ci 40%, najpierw sprawdź kodowanie.
Przykład: PHQ-4 u 380 pacjentów POZ
W pracy licencjackiej z pielęgniarstwa 380 dorosłych pacjentów poradni podstawowej opieki zdrowotnej wypełniło PHQ-4 w poczekalni. Dane są symulowane i możesz je pobrać jako plik CSV (kolumny phq_a, phq_b, gad_a, gad_b, kodowanie 0–3). Dwie osoby pominęły pozycję PHQ-2, a dwie inne – pozycję GAD-2. Zgodnie z przyjętą regułą wynik PHQ-2 i GAD-2 ma po 378 osób, a wynik PHQ-4 – 376.
| Wynik | n | M (SD) | Me [Q1, Q3] | ≥ 3: n (%) | 95% CI |
|---|---|---|---|---|---|
| PHQ-2 (0–6) | 378 | 1.19 (1.35) | 1 [0, 2] | 62 (16.4%) | [13.0, 20.5] |
| GAD-2 (0–6) | 378 | 1.29 (1.43) | 1 [0, 2] | 67 (17.7%) | [14.2, 21.9] |
| PHQ-4 (0–12) | 376 | 2.49 (2.39) | 2 [1, 4] | 100 (26.6%)a | [22.4, 31.3] |
a Osoby z wynikiem ≥ 3 w PHQ-2 lub w GAD-2. Przedziały ufności policzono metodą Wilsona (zob. przedział ufności dla proporcji i kalkulator przedziału ufności).
Rozkłady obu wyników są silnie prawostronnie skośne: najczęstszy wynik to 0, a wynik maksymalny 6 miały po 4 osoby (rysunek 2). Przy siedmiu możliwych wartościach średnia i odchylenie standardowe mówią niewiele, więc obok nich podaj medianę, kwartyle i rozkład liczebności. Gdyby zastosować próg ≥ 2, dodatni wynik PHQ-2 miałyby 126 osoby (33.3%, 95% CI [28.8, 38.2]), czyli dwa razy więcej.
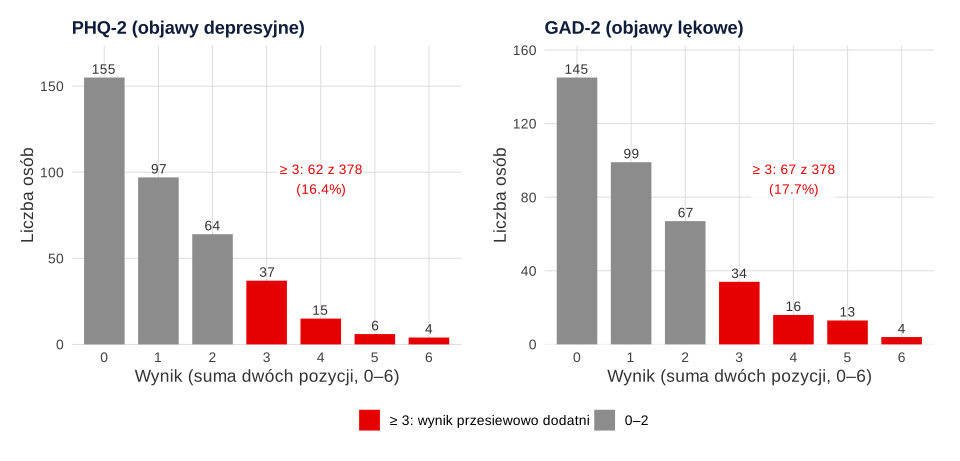
Wyniki dodatnie częściowo się pokrywały. Oba progi przekroczyło 29 osób, tylko próg PHQ-2 – 33 osoby, a tylko próg GAD-2 – 38 osób. Wyniki PHQ-2 i GAD-2 korelowały ze sobą, r(374) = .49, 95% CI [.40, .56]. Dwuczynnikowa CFA z estymatorem WLSMV dała ładunki od .76 do .82 i korelację czynników .74, 95% CI [.62, .86]. Model ma jednak tylko jeden stopień swobody, więc idealne dopasowanie (CFI = 1.000, RMSEA = .000) niewiele tu dowodzi. Strukturę dwuczynnikową na dużych próbach potwierdzili Kroenke i in. (2009) oraz Löwe i in. (2010).
Rzetelność skali z dwóch pozycji
Alfa Cronbacha dla dwóch pozycji nie jest błędem, ale warto wiedzieć, co oznacza. Przy dwóch pozycjach standaryzowana alfa jest dokładnie równa współczynnikowi Spearmana–Browna liczonemu z korelacji pozycji: 2r / (1 + r). W przykładzie korelacja pozycji PHQ-2 wyniosła .506, co daje α = .672. Dla GAD-2 było to .511 i α = .677. Zwykła alfa wyszła taka sama co do trzeciego miejsca po przecinku, bo obie pozycje miały podobną wariancję.
Wartości poniżej .70 nie dyskwalifikują tu narzędzia. Skala z dwóch pozycji nie może mieć wysokiej spójności wewnętrznej, chyba że pozycje są niemal identyczne, a wtedy druga pozycja niczego nie wnosi. Do przesiewu ważniejsze są czułość i swoistość względem wywiadu, a te zbadali autorzy narzędzia. Podaj więc w pracy korelację pozycji albo współczynnik Spearmana–Browna. Nie zastępuj przy tym trafności rzetelnością i nie przekreślaj skali za α = .67. Ogólne zasady i gotowe zdania są we wzorze raportowania alfy Cronbacha, a co robić, gdy recenzent kwestionuje niską alfę, opisuje wpis alfa Cronbacha poniżej .70.
Jak opisać PHQ-2 i GAD-2 w pracy
W części „Metoda” podaj, skąd pochodzą pozycje, skalę odpowiedzi, sposób liczenia, próg z cytowaniem, regułę braków i rzetelność we własnej próbie. Ogólny schemat jest w poradniku opis narzędzia badawczego – wzór.
Do dalszych analiz, np. porównania grup czy korelacji, możesz użyć wyniku 0–6 jako zmiennej porządkowej. Testy rangowe albo regresja porządkowa są tu bezpieczniejsze niż test t, bo wynik ma tylko siedem wartości i silną skośność.
Dostępność i wersje językowe
Według oficjalnej strony PHQ Screeners kwestionariusze PHQ i GAD-7 wraz z tłumaczeniami można pobrać bezpłatnie, a ich powielanie, tłumaczenie i rozpowszechnianie nie wymaga zgody. Różne wersje skal PHQ omawia instrukcja dostępna na tej stronie (Pfizer, b.d.). Mimo to zacytuj publikacje autorów i sprawdź, skąd pochodzi polskie tłumaczenie, którego używasz. Właściwości polskiej wersji opisuj tylko na podstawie publikacji, którą przeczytałeś (przeczytałaś). O szukaniu narzędzi piszemy w poradniku gdzie znaleźć kwestionariusze psychologiczne.
PHQ-2 i GAD-2 w R: wynik, próg i rzetelność
Pierwszy przepis odtwarza liczby z przykładu i zapisuje plik CSV z danymi. Wyniki to zwykłe sumy kolumn: suma dwóch kolumn daje NA, gdy brakuje którejkolwiek odpowiedzi, więc reguła braków działa sama. Przedziały Wilsona daje prop.test() bez poprawki na ciągłość, alfę – pakiet psych, a CFA – lavaan. Drugi przepis przelicza czułość i swoistość z metaanalizy na oczekiwane wyniki w grupie 1000 osób.
1. PHQ-2, GAD-2 i PHQ-4 krok po kroku
R
# B127 – PHQ-2, GAD-2 i PHQ-4: wynik, próg przesiewowy, rzetelność dwóch pozycji (dane symulowane, set.seed(1272)).
# 380 dorosłych pacjentów poradni POZ wypełnia PHQ-4 w poczekalni; odpowiedzi 0–3 (0 = wcale ... 3 = prawie codziennie).
# Zasady liczenia: PHQ-2 i GAD-2 to sumy dwóch pozycji (0–6), PHQ-4 to suma czterech (0–12); próg przesiewowy ≥ 3.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(1272)
n <- 380
dep <- rnorm(n)
lek <- .70 * dep + sqrt(1 - .70^2) * rnorm(n)                    # objawy lękowe i depresyjne silnie powiązane
poz <- function(cecha, lam, progi) findInterval(lam * cecha + sqrt(1 - lam^2) * rnorm(length(cecha)), progi)
dane <- data.frame(id = 1:n,
                   phq_a = poz(dep, .82, c(0.05, 1.05, 1.65)), phq_b = poz(dep, .80, c(0.15, 1.15, 1.75)),
                   gad_a = poz(lek, .84, c(0.00, 1.00, 1.60)), gad_b = poz(lek, .80, c(0.10, 1.10, 1.70)))
dane$gad_b[c(57, 203)] <- NA                                        # dwie osoby pominęły drugą pozycję GAD-2
dane$phq_a[c(118, 290)] <- NA                                       # dwie osoby pominęły pierwszą pozycję PHQ-2
write.csv(dane, "../phq-4-dane-przyklad.csv", row.names = FALSE)   # plik do pobrania

# Krok 1. Kontrola zakresu: tylko 0–3 albo brak
sapply(dane[, -1], function(x) all(x %in% c(0:3, NA)))
colSums(is.na(dane[, -1]))

# Krok 2. Wyniki: suma pozycji; przy braku którejkolwiek pozycji podskali – brak wyniku (reguła własna)
dane$PHQ2 <- dane$phq_a + dane$phq_b
dane$GAD2 <- dane$gad_a + dane$gad_b
dane$PHQ4 <- dane$PHQ2 + dane$GAD2
opis <- function(x) { x <- na.omit(x)
  round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)),
          Q3 = unname(quantile(x, .75)), min = min(x), max = max(x)), 2) }
rbind(PHQ2 = opis(dane$PHQ2), GAD2 = opis(dane$GAD2), PHQ4 = opis(dane$PHQ4))
rbind(PHQ2 = table(factor(dane$PHQ2, levels = 0:6)), GAD2 = table(factor(dane$GAD2, levels = 0:6)))

# Krok 3. Odsetek wyników przesiewowo dodatnich z 95% CI Wilsona (prop.test bez poprawki)
odsetek <- function(war) { war <- na.omit(war); k <- sum(war); N <- length(war)
  ci <- prop.test(k, N, correct = FALSE)$conf.int
  round(c(k = k, N = N, proc = 100 * k / N, lo = 100 * ci[1], hi = 100 * ci[2]), 1) }
rbind(PHQ2_ge3 = odsetek(dane$PHQ2 >= 3), PHQ2_ge2 = odsetek(dane$PHQ2 >= 2),
      GAD2_ge3 = odsetek(dane$GAD2 >= 3),
      dowolna_ge3 = odsetek(dane$PHQ2 >= 3 | dane$GAD2 >= 3))
# Nakładanie się wyników dodatnich (osoby z oboma wynikami)
table(PHQ2_ge3 = dane$PHQ2 >= 3, GAD2_ge3 = dane$GAD2 >= 3)

# Krok 4. Rzetelność skali z dwóch pozycji: r Pearsona, Spearman–Brown, alfa Cronbacha
rzet2 <- function(x) { x <- na.omit(x); r <- cor(x[, 1], x[, 2])
  a <- psych::alpha(x, warnings = FALSE)$total
  round(c(n = nrow(x), r = r, spearman_brown = 2 * r / (1 + r), alfa = a$raw_alpha, alfa_stand = a$std.alpha), 3) }
rbind(PHQ2 = rzet2(dane[c("phq_a", "phq_b")]), GAD2 = rzet2(dane[c("gad_a", "gad_b")]))

# Krok 5. Związek obu podskal i dwuczynnikowa CFA PHQ-4 (WLSMV, pozycje porządkowe)
ct <- cor.test(dane$PHQ2, dane$GAD2)
round(c(r = unname(ct$estimate), df = unname(ct$parameter), lo = ct$conf.int[1], hi = ct$conf.int[2]), 2)
m2 <- cfa("DEP =~ phq_a + phq_b\nLEK =~ gad_a + gad_b", data = na.omit(dane[2:5]),
          ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
round(fitMeasures(m2, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.scaled", "rmsea.scaled")), 3)
st <- standardizedSolution(m2)
st[st$op %in% c("=~", "~~") & st$lhs != st$rhs, c("lhs", "op", "rhs", "est.std", "ci.lower", "ci.upper")] |>
  transform(est.std = round(est.std, 2), ci.lower = round(ci.lower, 2), ci.upper = round(ci.upper, 2))
Wynik w R
phq_a phq_b gad_a gad_b
 TRUE  TRUE  TRUE  TRUE
phq_a phq_b gad_a gad_b
    2     0     0     2
       n    M   SD Me Q1 Q3 min max
PHQ2 378 1.19 1.35  1  0  2   0   6
GAD2 378 1.29 1.43  1  0  2   0   6
PHQ4 376 2.49 2.39  2  1  4   0  12
       0  1  2  3  4  5 6
PHQ2 155 97 64 37 15  6 4
GAD2 145 99 67 34 16 13 4
              k   N proc   lo   hi
PHQ2_ge3     62 378 16.4 13.0 20.5
PHQ2_ge2    126 378 33.3 28.8 38.2
GAD2_ge3     67 378 17.7 14.2 21.9
dowolna_ge3 100 376 26.6 22.4 31.3
        GAD2_ge3
PHQ2_ge3 FALSE TRUE
   FALSE   276   38
   TRUE     33   29
       n     r spearman_brown  alfa alfa_stand
PHQ2 378 0.506          0.672 0.672      0.672
GAD2 378 0.511          0.677 0.677      0.677
     r     df     lo     hi
  0.49 374.00   0.40   0.56
 chisq.scaled     df.scaled pvalue.scaled    cfi.scaled  rmsea.scaled
        0.091         1.000         0.763         1.000         0.000
   lhs op   rhs est.std ci.lower ci.upper
1  DEP =~ phq_a    0.82     0.73     0.92
2  DEP =~ phq_b    0.76     0.66     0.85
3  LEK =~ gad_a    0.79     0.70     0.88
4  LEK =~ gad_b    0.77     0.68     0.87
23 DEP ~~   LEK    0.74     0.62     0.86
2. Strategie przesiewu na 1000 osób
R
# B127 – co daje PHQ-2 jako pierwszy krok przesiewu? Oczekiwane wyniki na 1000 osób.
# Czułość i swoistość z metaanalizy danych indywidualnych (Levis i in., 2020; badania z wywiadem półustrukturalizowanym).
# Częstość dużej depresji 10% – taka jak w danych tej metaanalizy (4572 z 44 318 osób).
strategie <- data.frame(
  strategia = c("PHQ-2 >= 2", "PHQ-2 >= 3", "PHQ-2 >= 2, potem PHQ-9 >= 10", "PHQ-9 >= 10"),
  czulosc   = c(.91, .72, .82, .86),
  swoistosc = c(.67, .85, .87, .85))
N <- 1000; czestosc <- .10
chorzy <- N * czestosc; zdrowi <- N - chorzy
strategie$TP <- chorzy * strategie$czulosc
strategie$FN <- chorzy - strategie$TP
strategie$FP <- zdrowi * (1 - strategie$swoistosc)
strategie$TN <- zdrowi - strategie$FP
strategie$dodatnie <- strategie$TP + strategie$FP
strategie$PPV <- round(strategie$TP / strategie$dodatnie, 3)
strategie
# Ile osób w strategii dwustopniowej wypełnia pełny PHQ-9? (ci z PHQ-2 >= 2)
c(wypelnia_PHQ9 = strategie$dodatnie[1], odsetek_bez_PHQ9 = round(100 * (1 - strategie$dodatnie[1] / N), 1))
# Dla porównania: przy częstości 5% i 20%
sapply(c(.05, .20), function(p) with(strategie, round(czulosc * p / (czulosc * p + (1 - swoistosc) * (1 - p)), 3))) |>
  `dimnames<-`(list(strategie$strategia, c("PPV_5proc", "PPV_20proc")))
Wynik w R
                      strategia czulosc swoistosc TP FN  FP  TN dodatnie   PPV
1                    PHQ-2 >= 2    0.91      0.67 91  9 297 603      388 0.235
2                    PHQ-2 >= 3    0.72      0.85 72 28 135 765      207 0.348
3 PHQ-2 >= 2, potem PHQ-9 >= 10    0.82      0.87 82 18 117 783      199 0.412
4                   PHQ-9 >= 10    0.86      0.85 86 14 135 765      221 0.389
   wypelnia_PHQ9 odsetek_bez_PHQ9
           388.0             61.2
                              PPV_5proc PPV_20proc
PHQ-2 >= 2                        0.127      0.408
PHQ-2 >= 3                        0.202      0.545
PHQ-2 >= 2, potem PHQ-9 >= 10     0.249      0.612
PHQ-9 >= 10                       0.232      0.589
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje prop.test() i cor.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Kodowanie 1–4. Wynik 0–6 zamienia się w 2–8, a próg ≥ 3 spełnia prawie każdy.
- „16% pacjentów ma depresję”. Poprawnie: 16.4% osób uzyskało wynik PHQ-2 równy co najmniej 3, czyli przesiewowo dodatni.
- Zmiana progu po obejrzeniu danych. Wybierz ≥ 3 albo ≥ 2 przed badaniem i uzasadnij wybór celem przesiewu.
- Uzupełnianie brakującej pozycji średnią z jednej pozostałej. To nie jest wynik, tylko podwojona odpowiedź.
- Kategorie nasilenia z PHQ-9 przeniesione na PHQ-2. Przedziały 5–9, 10–14 itd. dotyczą pełnych skal i nie mają odpowiednika w wyniku 0–6.
- Odrzucenie skali za α < .70. Przy dwóch pozycjach to oczekiwana wartość, a nie dowód złego pomiaru.
Podobne krótkie skale opisaliśmy we wpisach o K10 i K6 oraz DASS-21, a analizę całej ankiety w pracy z pielęgniarstwa – w poradniku statystyka w pracy z pielęgniarstwa. Jeśli chcesz, żeby ktoś sprawdził Twoje kodowanie, progi i opis wyników, zajrzyj do oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jaki jest punkt odcięcia w PHQ-2?
Autorzy podają wynik co najmniej 3 na skali 0–6 (Kroenke i in., 2003). W metaanalizie Levisa i in. (2020) próg 3 miał czułość .72 i swoistość .85, a próg 2 – czułość .91 przy swoistości .67, dlatego próg 2 stosuje się, gdy PHQ-2 jest pierwszym krokiem przed pełnym PHQ-9.
Czy wynik GAD-2 równy 3 oznacza zaburzenie lękowe?
Nie. Wynik co najmniej 3 jest przesiewowo dodatni i wymaga dalszej oceny przez specjalistę. W metaanalizie Plummera i in. (2016) próg 3 miał czułość .76 i swoistość .81 dla zaburzenia lękowego uogólnionego, więc część wyników dodatnich jest fałszywa.
Jak policzyć wynik PHQ-4?
Zsumuj cztery odpowiedzi kodowane 0–3, co daje wynik 0–12. Osobno policz PHQ-2 (dwie pozycje depresyjne) i GAD-2 (dwie pozycje lękowe), bo próg 3 stosuje się do każdej części oddzielnie (Kroenke i in., 2009).
Czy można liczyć alfę Cronbacha dla dwóch pozycji?
Można, ale przy dwóch pozycjach standaryzowana alfa to współczynnik Spearmana–Browna z korelacji pozycji, czyli 2r/(1 + r). Wartości około .65–.70 są tu typowe i same w sobie nie dyskwalifikują skali; podaj w pracy korelację pozycji i ten współczynnik.
Czy PHQ-2 trzeba dodawać do ankiety, jeśli jest w niej PHQ-9?
Nie. PHQ-2 to pierwsze dwie pozycje PHQ-9 (Levis i in., 2020), więc jego wynik policzysz z odpowiedzi na pełną skalę. Osobne pytania tylko wydłużyłyby ankietę.
Powiązane hasła
Przeczytaj też
GAD-7 i PHQ-9 – jak policzyć wynik
Suma 0–21 i 0–27, braki, progi 5/10/15/20 ze źródłami, próg przesiewowy 10, pozycja 9 PHQ-9 i przykład w R z opisem do pracy.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikOpis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →Masz wyniki PHQ-4 i nie wiesz, jak je opisać?
Sprawdzimy kodowanie, progi i rzetelność w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Kroenke, K., Spitzer, R. L., & Williams, J. B. W. (2003). The Patient Health Questionnaire-2: Validity of a two-item depression screener. Medical Care, 41(11), 1284–1292. https://doi.org/10.1097/01.mlr.0000093487.78664.3c
- Kroenke, K., Spitzer, R. L., Williams, J. B. W., & Löwe, B. (2009). An ultra-brief screening scale for anxiety and depression: The PHQ-4. Psychosomatics, 50(6), 613–621. https://doi.org/10.1176/appi.psy.50.6.613
- Kroenke, K., Spitzer, R. L., Williams, J. B. W., & Löwe, B. (2010). The Patient Health Questionnaire Somatic, Anxiety, and Depressive Symptom Scales: A systematic review. General Hospital Psychiatry, 32(4), 345–359. https://doi.org/10.1016/j.genhosppsych.2010.03.006
- Kroenke, K., Spitzer, R. L., Williams, J. B. W., Monahan, P. O., & Löwe, B. (2007). Anxiety disorders in primary care: Prevalence, impairment, comorbidity, and detection. Annals of Internal Medicine, 146(5), 317–325. https://doi.org/10.7326/0003-4819-146-5-200703060-00004
- Levis, B., Sun, Y., He, C., Wu, Y., Krishnan, A., Bhandari, P. M., Neupane, D., Imran, M., Brehaut, E., Negeri, Z., Fischer, F. H., Benedetti, A., Thombs, B. D., & Depression Screening Data (DEPRESSD) PHQ Collaboration. (2020). Accuracy of the PHQ-2 alone and in combination with the PHQ-9 for screening to detect major depression: Systematic review and meta-analysis. JAMA, 323(22), 2290–2300. https://doi.org/10.1001/jama.2020.6504 ● Otwarty dostęp
- Löwe, B., Wahl, I., Rose, M., Spitzer, C., Glaesmer, H., Wingenfeld, K., Schneider, A., & Brähler, E. (2010). A 4-item measure of depression and anxiety: Validation and standardization of the Patient Health Questionnaire-4 (PHQ-4) in the general population. Journal of Affective Disorders, 122(1–2), 86–95. https://doi.org/10.1016/j.jad.2009.06.019
- Pfizer. (b.d.). Patient Health Questionnaire (PHQ) screeners. PHQ Screeners. https://www.phqscreeners.com/select-screener ● Otwarty dostęp
- Plummer, F., Manea, L., Trepel, D., & McMillan, D. (2016). Screening for anxiety disorders with the GAD-7 and GAD-2: A systematic review and diagnostic metaanalysis. General Hospital Psychiatry, 39, 24–31. https://doi.org/10.1016/j.genhosppsych.2015.11.005
- Spitzer, R. L., Kroenke, K., Williams, J. B. W., & Löwe, B. (2006). A brief measure for assessing generalized anxiety disorder: The GAD-7. Archives of Internal Medicine, 166(10), 1092–1097. https://doi.org/10.1001/archinte.166.10.1092
Cytowania BibTeX
@article{kroenke2003phq2, author={Kroenke, Kurt and Spitzer, Robert L. and Williams, Janet B. W.}, title={{The Patient Health Questionnaire-2: Validity of a two-item depression screener}}, journal={Medical Care}, year={2003}, volume={41}, number={11}, pages={1284--1292}, doi={10.1097/01.mlr.0000093487.78664.3c}}@article{kroenke2009ultra, author={Kroenke, Kurt and Spitzer, Robert L. and Williams, Janet B. W. and Löwe, Bernd}, title={{An ultra-brief screening scale for anxiety and depression: The PHQ-4}}, journal={Psychosomatics}, year={2009}, volume={50}, number={6}, pages={613--621}, doi={10.1176/appi.psy.50.6.613}}@article{kroenke2010patient, author={Kroenke, Kurt and Spitzer, Robert L. and Williams, Janet B. W. and Löwe, Bernd}, title={{The Patient Health Questionnaire Somatic, Anxiety, and Depressive Symptom Scales: A systematic review}}, journal={General Hospital Psychiatry}, year={2010}, volume={32}, number={4}, pages={345--359}, doi={10.1016/j.genhosppsych.2010.03.006}}@article{kroenke2007anxiety, author={Kroenke, Kurt and Spitzer, Robert L. and Williams, Janet B. W. and Monahan, Patrick O. and Löwe, Bernd}, title={{Anxiety disorders in primary care: Prevalence, impairment, comorbidity, and detection}}, journal={Annals of Internal Medicine}, year={2007}, volume={146}, number={5}, pages={317--325}, doi={10.7326/0003-4819-146-5-200703060-00004}}@article{levis2020accuracy, author={Levis, Brooke and Sun, Ying and He, Chen and Wu, Yin and Krishnan, Ankur and Bhandari, Parash Mani and Neupane, Dipika and Imran, Mahrukh and Brehaut, Eliana and Negeri, Zelalem and Fischer, Felix H. and Benedetti, Andrea and Thombs, Brett D. and {Depression Screening Data (DEPRESSD) PHQ Collaboration}}, title={{Accuracy of the PHQ-2 alone and in combination with the PHQ-9 for screening to detect major depression: Systematic review and meta-analysis}}, journal={JAMA}, year={2020}, volume={323}, number={22}, pages={2290--2300}, doi={10.1001/jama.2020.6504}}@article{lowe2010phq4, author={Löwe, Bernd and Wahl, Inka and Rose, Matthias and Spitzer, Carsten and Glaesmer, Heide and Wingenfeld, Katja and Schneider, Antonius and Brähler, Elmar}, title={{A 4-item measure of depression and anxiety: Validation and standardization of the Patient Health Questionnaire-4 (PHQ-4) in the general population}}, journal={Journal of Affective Disorders}, year={2010}, volume={122}, number={1–2}, pages={86--95}, doi={10.1016/j.jad.2009.06.019}}@misc{pfizerndphq, author={{Pfizer}}, title={{Patient Health Questionnaire (PHQ) screeners}}, howpublished={PHQ Screeners}, year={b.d.}, publisher={Pfizer}, url={https://www.phqscreeners.com/select-screener}}@article{plummer2016screening, author={Plummer, Faye and Manea, Laura and Trepel, Dominic and McMillan, Dean}, title={{Screening for anxiety disorders with the GAD-7 and GAD-2: A systematic review and diagnostic metaanalysis}}, journal={General Hospital Psychiatry}, year={2016}, volume={39}, pages={24--31}, doi={10.1016/j.genhosppsych.2015.11.005}}@article{spitzer2006brief, author={Spitzer, Robert L. and Kroenke, Kurt and Williams, Janet B. W. and Löwe, Bernd}, title={{A brief measure for assessing generalized anxiety disorder: The GAD-7}}, journal={Archives of Internal Medicine}, year={2006}, volume={166}, number={10}, pages={1092--1097}, doi={10.1001/archinte.166.10.1092}}