Czym jest DASS-21
DASS (Depression Anxiety Stress Scales) to kwestionariusz samoopisowy, który mierzy nasilenie trzech stanów emocjonalnych: depresji, lęku i stresu. Pełna wersja ma 42 pozycje, a DASS-21 jest jej skróceniem do 7 pozycji na każdą skalę (Psychology Foundation of Australia, b.d.). Lovibond i Lovibond (1995) sprawdzili narzędzie w próbie 717 osób z populacji ogólnej. Struktura trzech czynników znalazła potwierdzenie w eksploracyjnej i konfirmacyjnej analizie czynnikowej. Skala lęku korelowała .81 z Inwentarzem Lęku Becka, a skala depresji .74 z Inwentarzem Depresji Becka. Antony i in. (1998) pokazali, że także wersja 21-pozycyjna dobrze rozróżnia depresję, pobudzenie fizjologiczne i napięcie, zarówno w grupach klinicznych, jak i w próbie nieklinicznej.
Autorzy opierają DASS na dymensjonalnym, a nie kategorialnym rozumieniu zaburzeń. Narzędzie mierzy więc, jak nasilone są objawy, a nie to, czy ktoś spełnia kryteria rozpoznania (Psychology Foundation of Australia, b.d.). Ta jedna cecha porządkuje cały sposób liczenia i opisywania wyników. Ten wpis należy do serii o liczeniu wyników kwestionariuszy. Podobnie opisaliśmy PSS-10, GAD-7 i PHQ-9, K10 i K6 oraz CES-D.
Budowa: 21 pozycji, trzy podskale, ostatni tydzień
Osoba badana ocenia, w jakim stopniu każde stwierdzenie dotyczyło jej w ostatnim tygodniu. Używa czterostopniowej skali nasilenia lub częstości, punktowanej od 0 do 3. Wynik skali to suma odpowiedzi jej pozycji (Psychology Foundation of Australia, b.d.). Treści pozycji nie przytaczamy. Pobierz formularz ze strony autorów albo z opublikowanej wersji językowej.
| Podskala | Co obejmuje (według autorów) | Pozycje | Suma | Wynik × 2 |
|---|---|---|---|---|
| Depresja | dysforia, beznadziejność, deprecjonowanie życia i siebie, brak zainteresowania, anhedonia, inercja | 7 | 0–21 | 0–42 |
| Lęk | pobudzenie autonomiczne, objawy mięśniowe, lęk sytuacyjny, subiektywne odczucie lęku | 7 | 0–21 | 0–42 |
| Stres | przewlekłe, niespecyficzne pobudzenie: trudność z odprężeniem, napięcie, drażliwość, niecierpliwość | 7 | 0–21 | 0–42 |
DASS-21 nie ma pozycji odwróconych: wszystkie odpowiedzi sumuje się bez przekodowania. Pozycje trzech podskal są wymieszane w formularzu. Numery pozycji należących do każdej podskali weź z oficjalnego szablonu do liczenia, udostępnionego na stronie autorów razem z formularzem. Pomyłka w przypisaniu pozycji jest groźniejsza niż pomyłka w arytmetyce, bo daje wynik, który wygląda wiarygodnie. Ogólne zasady łączenia pozycji w podskale i wynik ogólny opisuje osobne hasło.
Jak policzyć wynik DASS-21 krok po kroku
Krok 1. Sprawdź kodowanie 0–3
Formularze online często zapisują odpowiedzi jako 1–4. Wtedy każda podskala przesuwa się o 7 punktów, a po pomnożeniu przez 2 – o 14. Sprawdź, czy w danych są tylko wartości 0–3. Przekodowanie w różnych programach pokazuje poradnik jak policzyć wynik kwestionariusza.
Krok 2. Zsumuj pozycje każdej podskali
Dla każdej podskali dodaj odpowiedzi jej siedmiu pozycji. Otrzymasz trzy wyniki w zakresie 0–21.
Krok 3. Pomnóż każdy wynik przez 2
Autorzy zalecają to mnożenie, aby wyniki DASS-21 dało się porównać z normami i opublikowanymi danymi pełnej wersji DASS (Psychology Foundation of Australia, b.d.). Jeśli w artykule podano średnie bez mnożenia, porównanie z danymi po mnożeniu jest błędne o połowę. Dlatego w pracy zawsze napisz, którą wersję zapisu przyjmujesz. Pojedyncze wyniki możesz sprawdzić w kalkulatorze wyniku skali.
Krok 4. Ustal regułę dla braków przed analizą
Strona autorów podaje regułę praktyczną: w 7-pozycyjnej podskali DASS-21 dopuszczalny jest najwyżej jeden brak. Wtedy uśrednia się pozostałe pozycje. Przy większej liczbie braków osoba w badaniu naukowym nie powinna dostać wyniku tej podskali. Kryterium trzeba podać w pracy (Psychology Foundation of Australia, b.d.). Uśrednianie zakłada jednak, że brakująca pozycja zachowuje się jak pozostałe. Mazza i in. (2015) pokazali, że takie przeliczenie może obciążać wyniki nawet przy brakach całkowicie losowych. W pracy dyplomowej reguła autorów wystarczy, jeśli braków jest niewiele. Mechanizmy braków opisuje hasło braki danych MCAR, MAR i MNAR.
Krok 5. Zdecyduj, czy potrzebujesz wyniku ogólnego
Według autorów trzy wyniki można zsumować albo uśrednić. Powstaje wtedy miara ogólnego nasilenia negatywnych emocji (Psychology Foundation of Australia, b.d.). Taki wynik ma zakres 0–126 po mnożeniu przez 2. Henry i Crawford (2005) przebadali 1794 dorosłych z populacji ogólnej. Najlepiej dopasowany był u nich model z ogólnym czynnikiem dystresu i trzema czynnikami specyficznymi. Każda podskala mierzy więc swój wymiar, ale także ogólny dystres. Z tego powodu korelacje między podskalami są wysokie i nie świadczą o błędzie.
Interpretacja: wynik ciągły, nie etykieta
Wyższy wynik oznacza silniejsze objawy w ostatnim tygodniu. W badaniu korelacyjnym albo w porównaniu grup analizuj wyniki ciągłe. Właśnie to autorzy zalecają do większości celów badawczych (Psychology Foundation of Australia, b.d.).
Etykiety nasilenia (prawidłowy, łagodny, umiarkowany, ciężki, skrajnie ciężki) i ich zakresy autorzy podają wyłącznie w podręczniku DASS. Celowo nie publikują ich na stronie, aby uniknąć traktowania umownych granic jak kategorii diagnostycznych. Według strony autorów etykiety opisują położenie wyniku względem populacji ogólnej, a nie stopień zaburzenia. Wybór jednego punktu odcięcia dla „klinicznego” nasilenia nazywają z konieczności arbitralnym (Psychology Foundation of Australia, b.d.). Jeśli promotor wymaga podziału na kategorie, weź zakresy z podręcznika albo z publikacji, którą sam(a) przeczytałeś (przeczytałaś), i zacytuj to źródło. Zakresy dotyczą wyników po mnożeniu przez 2. Nie twórz własnych przedziałów z kwartyli próby. Dlaczego, wyjaśniamy w poradniku niski, przeciętny, wysoki wynik. Wynik DASS-21 nie jest rozpoznaniem depresji ani zaburzenia lękowego.
Normy z innych krajów, np. brytyjskie dane Henry’ego i Crawforda (2005), nie są normami dla polskich studentów. Więcej o tym, kiedy wolno porównywać wyniki z normami testowymi, piszemy w haśle o normach.
Przykład: DASS-21 u 300 osób studiujących
Dane są symulowane i możesz je pobrać jako plik CSV. Kolumny d1–d7, a1–a7 i s1–s7 są już nazwane według podskal. W prawdziwych danych przypiszesz je według szablonu autorów. Pojedynczy brak w podskali wystąpił siedem razy, u sześciu osób, i wtedy wynik policzono z uśrednienia. Dwie osoby pominęły dwie pozycje lęku, więc nie mają wyniku tej podskali.
| Podskala | n | M (SD) | Me [Q1, Q3] | Skośność | Wynik 0 | α [95% CI] |
|---|---|---|---|---|---|---|
| Depresja | 300 | 10.23 (9.39) | 8 [2, 16] | 0.95 | 16.0% | .88 [.86, .90] |
| Lęk | 298 | 7.70 (7.12) | 6 [2, 12] | 0.96 | 20.5% | .77 [.73, .81] |
| Stres | 300 | 13.62 (8.87) | 12 [6, 18] | 0.65 | 3.0% | .82 [.79, .85] |
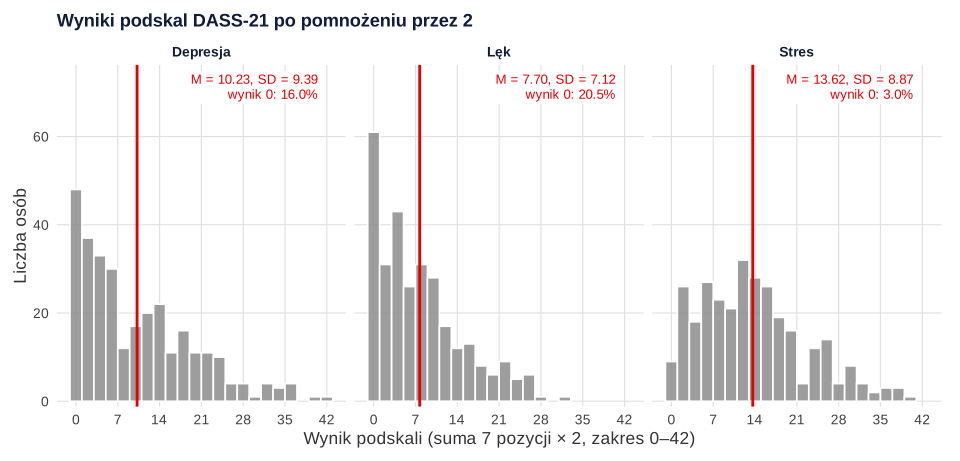
Rozkłady są prawostronnie skośne, a co piąta osoba ma w podskali lęku wynik 0. To typowy efekt podłogi w próbie nieklinicznej. Skala dobrze różnicuje osoby z nasilonymi objawami, a słabiej te, które objawów prawie nie mają. Gdyby pominąć mnożenie przez 2, średnie wyniosłyby 5.12, 3.85 i 6.81. Takie liczby w tabeli porównanej z literaturą sugerowałyby, że Twoja próba ma o połowę słabsze objawy.
Korelacje podskal i wynik ogólny
W 292 osobach z kompletem wyników korelacje Pearsona wyniosły r = .45 (depresja–lęk), .63 (depresja–stres) i .48 (lęk–stres). Wynik ogólny, czyli suma trzech podskal, miał M = 31.03 (SD = 20.87). Wysokie korelacje są zgodne z ogólnym czynnikiem dystresu. Jeśli w jednym modelu regresji wprowadzasz depresję i stres jako predyktory, sprawdź współliniowość.
Rzetelność i struktura
Alfa Cronbacha wyniosła .88 dla depresji, .77 dla lęku i .82 dla stresu (przedziały w tabeli). Alfa zakłada równe ładunki pozycji (McNeish, 2018), więc obok niej podaj omegę McDonalda. Następnie porównaliśmy dwa modele CFA z estymatorem MLR. Model trzech skorelowanych czynników: χ²(186) = 226.63, CFI = .977, RMSEA = .030, SRMR = .044. Model bifactor z czynnikiem ogólnym i trzema specyficznymi: χ²(168) = 217.88, CFI = .973, RMSEA = .034, SRMR = .039. Różnica dopasowania była nieistotna, Δχ²(18) = 12.76, p = .806, a AIC był niższy dla modelu trzech czynników (13415 wobec 13431). Same wskaźniki dopasowania nie rozstrzygają więc między modelami.
Więcej mówią omegi z modelu bifactor (Rodriguez i in., 2016). Omega total wyniku ogólnego wyniosła .92, a omega hierarchiczna czynnika ogólnego .77. Większość rzetelnej wariancji sumy to więc wspólny dystres. Dla podskal obraz jest zróżnicowany (rysunek 2). W stresie czynnik ogólny wyjaśnia .69 wariancji, a czynnik specyficzny tylko .14. Lęk ma najwięcej własnej wariancji (.44).
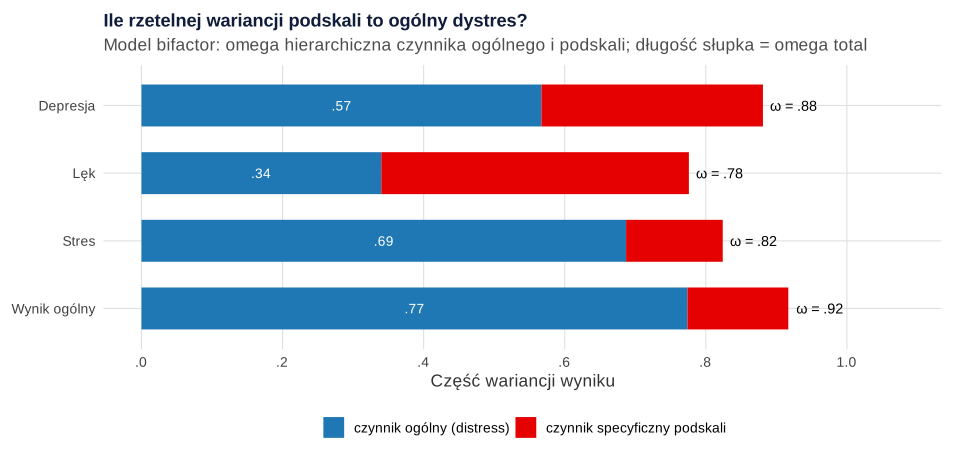
Wniosek praktyczny: korelacja „stresu” z inną zmienną w dużej mierze odzwierciedla ogólny dystres. Jeśli hipoteza dotyczy specyficznie stresu, kontroluj pozostałe podskale albo użyj modelu zmiennych latentnych. Szerzej o tych modelach piszemy we wpisie model bifactor i ESEM. W pracy licencjackiej zwykle wystarczy podać alfę i omegę każdej podskali. Model bifactor to rozszerzenie dla ambitniejszych prac.
Jak opisać DASS-21 w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane wersji, której używasz.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o rzetelności we wzorze raportowania alfy Cronbacha.
Licencja i polska wersja
Według strony autorów DASS jest w domenie publicznej. Do użycia nie potrzebujesz zgody, a formularze można pobierać i kopiować. Nie wolno jednak zmieniać skal ani ich sprzedawać. Podręcznik z dodatkowymi informacjami jest płatny (Psychology Foundation of Australia, b.d.). Strona zawiera też zakładkę z przekładami. Sprawdź, czy wersja polska, z której korzystasz, pochodzi z opublikowanej adaptacji, i zacytuj tę publikację. Nie przypisuj polskiej wersji właściwości z badań zagranicznych. Jak przebiega rzetelna adaptacja, opisuje wpis adaptacja kulturowa kwestionariusza, a gdzie szukać narzędzi – poradnik gdzie znaleźć kwestionariusze psychologiczne.
DASS-21 w R: podskale, braki, rzetelność i bifactor
Kod odtwarza liczby z tekstu i zapisuje plik CSV z danymi. Funkcja podskala() stosuje regułę autorów: najwyżej jeden brak, średnia z pozycji × 7, potem × 2. Alfę z przedziałem Feldta liczy pakiet psych, a modele CFA i bifactor – lavaan. Omegi liczymy ze standaryzowanych ładunków modelu bifactor.
Wynik DASS-21 krok po kroku
R
# B125 – DASS-21: wyniki podskal, braki, rozkład, korelacje, rzetelność i model bifactor (dane symulowane, set.seed(12521)).
# 300 osób studiujących; odpowiedzi 0–3 na 21 pozycji. Pozycje nazwano według podskal (d1–d7, a1–a7, s1–s7);
# w prawdziwych danych przypisz numery pozycji do podskal według oficjalnego szablonu autorów. Treści pozycji nie podajemy.
# Zasady liczenia (Lovibond i Lovibond, strona DASS): suma pozycji podskali, w DASS-21 pomnożona przez 2;
# przy jednym braku w podskali – średnia z pozostałych pozycji.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(12521)
n <- 300
G <- rnorm(n); Sd <- rnorm(n); Sa <- rnorm(n); Ss <- rnorm(n)        # czynnik ogólny i trzy specyficzne
lg <- c(.60, .62, .58, .64, .61, .57, .63,  .55, .52, .58, .50, .56, .54, .53,  .62, .60, .64, .59, .61, .58, .63)
ls <- c(.45, .50, .42, .48, .44, .40, .46,  .44, .48, .40, .46, .42, .45, .43,  .36, .40, .34, .38, .37, .41, .35)
spec <- cbind(matrix(Sd, n, 7), matrix(Sa, n, 7), matrix(Ss, n, 7))
progi <- list(D = c(0.10, 1.00, 1.70), A = c(0.30, 1.20, 1.90), S = c(-0.30, 0.70, 1.50))
pr <- rep(c("D", "A", "S"), each = 7)
odp <- sapply(1:21, function(j) {
  y <- lg[j] * G + ls[j] * spec[, j] + rnorm(n, 0, sqrt(1 - lg[j]^2 - ls[j]^2))
  findInterval(y, progi[[pr[j]]]) })
poz <- list(D = paste0("d", 1:7), A = paste0("a", 1:7), S = paste0("s", 1:7))
colnames(odp) <- unlist(poz)
dane <- data.frame(id = 1:n, odp)
dane$d4[c(17, 102, 233)] <- NA; dane$a3[c(58, 190)] <- NA; dane$s6[c(77, 233)] <- NA   # pojedyncze braki
dane$a5[c(140, 211)] <- NA; dane$a6[c(140, 211)] <- NA                                  # dwa braki w lęku u 2 osób
write.csv(dane, "../dass-21-dane-przyklad.csv", row.names = FALSE, na = "")             # plik do pobrania

# Krok 1. Kontrola kodowania: tylko 0–3 albo brak; liczba braków w podskalach
all(sapply(dane[, -1], function(x) all(x %in% c(0:3, NA))))
sapply(poz, function(p) table(factor(rowSums(is.na(dane[, p])), levels = 0:2)))

# Krok 2. Wynik podskali: przy co najwyżej 1 braku średnia z pozycji × 7 (suma 0–21), potem × 2 (0–42)
podskala <- function(p) { k <- rowSums(is.na(dane[, p])); w <- rowMeans(dane[, p], na.rm = TRUE) * 7 * 2
  ifelse(k <= 1, w, NA) }
for (s in names(poz)) dane[[s]] <- podskala(poz[[s]])
colSums(is.na(dane[, c("D", "A", "S")]))
opis <- function(x) { x <- na.omit(x); round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x),
  Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)), max = max(x), skosnosc = psych::skew(x), proc_0 = 100 * mean(x == 0)), 2) }
t(sapply(dane[, c("D", "A", "S")], opis))
# Typowy błąd: wynik bez mnożenia przez 2 (skala 0–21) – średnie dwa razy niższe
round(colMeans(dane[, c("D", "A", "S")] / 2, na.rm = TRUE), 2)

# Krok 3. Korelacje podskal (Pearson) i wynik ogólny (suma trzech podskal, 0–126)
pel <- na.omit(dane)
nrow(pel)
round(cor(pel[, c("D", "A", "S")]), 2)
pel$DASS <- pel$D + pel$A + pel$S
round(c(M = mean(pel$DASS), SD = sd(pel$DASS)), 2)

# Krok 4. Rzetelność podskal: alfa z 95% CI Feldta
for (s in names(poz)) { a <- alpha(pel[, poz[[s]]], warnings = FALSE)
  cat(s, round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 3), "\n") }

# Krok 5. CFA: trzy skorelowane czynniki a model bifactor (czynnik ogólny + trzy specyficzne, ortogonalne), MLR
m3 <- paste("Dep =~", paste(poz$D, collapse = " + "), "\nLek =~", paste(poz$A, collapse = " + "),
            "\nStr =~", paste(poz$S, collapse = " + "))
mb <- paste(m3, "\nG =~", paste(unlist(poz), collapse = " + "))
f3 <- cfa(m3, data = pel, estimator = "MLR", std.lv = TRUE)
fb <- cfa(mb, data = pel, estimator = "MLR", std.lv = TRUE, orthogonal = TRUE)
ind <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr")
round(rbind(trzy_czynniki = fitMeasures(f3, ind), bifactor = fitMeasures(fb, ind)), 3)
lavTestLRT(f3, fb)
round(lavInspect(f3, "cor.lv"), 2)

# Krok 6. Omegi z modelu bifactor: omega total, omega hierarchiczna (czynnik ogólny)
# i omega hierarchiczna podskali (wariancja rzetelna przypisana czynnikowi specyficznemu)
st <- standardizedSolution(fb); L <- st[st$op == "=~", ]
lam_g <- setNames(L$est.std[L$lhs == "G"], L$rhs[L$lhs == "G"])
lam_s <- setNames(L$est.std[L$lhs != "G"], L$rhs[L$lhs != "G"])
th <- setNames(st$est.std[st$op == "~~" & st$lhs == st$rhs & st$lhs %in% unlist(poz)], st$lhs[st$op == "~~" & st$lhs == st$rhs & st$lhs %in% unlist(poz)])
omegi <- function(p, cale = FALSE) {
  g <- sum(lam_g[p])^2
  sp <- if (cale) sum(sapply(poz, function(q) sum(lam_s[q])^2)) else sum(lam_s[p])^2
  calk <- g + sp + sum(th[p])
  round(c(omega_total = (g + sp) / calk, omega_h_ogolny = g / calk, omega_h_podskala = sp / calk), 3) }
rbind(D = omegi(poz$D), A = omegi(poz$A), S = omegi(poz$S), ogolny = omegi(unlist(poz), cale = TRUE))
Wynik w R
[1] TRUE
    D   A   S
0 297 296 298
1   3   2   2
2   0   2   0
D A S
0 2 0
    n     M   SD Me Q1 Q3 max skosnosc proc_0
D 300 10.23 9.39  8  2 16  42     0.95  16.00
A 298  7.70 7.12  6  2 12  32     0.96  20.47
S 300 13.62 8.87 12  6 18  40     0.65   3.00
   D    A    S
5.12 3.85 6.81
[1] 292
     D    A    S
D 1.00 0.45 0.63
A 0.45 1.00 0.48
S 0.63 0.48 1.00
    M    SD
31.03 20.87
D 0.879 0.856 0.899
A 0.774 0.732 0.811
S 0.822 0.789 0.851
              chisq.scaled df.scaled cfi.robust rmsea.robust  srmr
trzy_czynniki      226.626       186      0.977        0.030 0.044
bifactor           217.880       168      0.973        0.034 0.039

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the robust test that
   should be reported per model. A robust difference test is a function of two standard (not
   robust) statistics.

    Df   AIC   BIC  Chisq Chisq diff RMSEA Df diff Pr(>Chisq)
fb 168 13431 13662 243.36
f3 186 13415 13581 263.85     12.761     0      18     0.8056
     Dep  Lek  Str
Dep 1.00
Lek 0.54 1.00
Str 0.74 0.60 1.00
       omega_total omega_h_ogolny omega_h_podskala
D            0.881          0.567            0.314
A            0.776          0.340            0.436
S            0.824          0.687            0.137
ogolny       0.918          0.774            0.143
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy DASS-21
- Brak mnożenia przez 2. Wyniki 0–21 porównane z danymi DASS-42 lub z zakresami z podręcznika zaniżają objawy o połowę.
- Kodowanie 1–4 zamiast 0–3. Każda podskala rośnie o 7 punktów przed mnożeniem, czyli o 14 po nim.
- Złe przypisanie pozycji. Pozycje podskal są w formularzu wymieszane. Sprawdź je z szablonem autorów i porównaj korelacje pozycji z wynikiem własnej podskali.
- „Odsetek studentów z depresją”. DASS-21 mierzy nasilenie objawów. Nawet kategorie z podręcznika opisują położenie względem populacji, a nie rozpoznanie.
- Przeliczanie przy wielu brakach. Reguła autorów dopuszcza jeden brak na 7-pozycyjną podskalę. Przy dwóch brakach wynik podskali powinien zostać pusty.
- Porównywanie alf DASS-21 i DASS-42. Autorzy przypominają, że alfa silnie zależy od liczby pozycji, dlatego nie należy porównywać alf wersji o różnej długości (Psychology Foundation of Australia, b.d.).
Pełną ścieżkę analizy narzędzia, od kodowania po rzetelność, porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie wyników DASS-21 w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Dlaczego wynik DASS-21 mnoży się przez 2?
DASS-21 ma w każdej podskali połowę pozycji pełnej wersji DASS-42. Autorzy zalecają pomnożenie sumy przez 2, aby wyniki były porównywalne z normami i danymi publikowanymi dla DASS. Wynik podskali ma wtedy zakres 0–42.
Czy DASS-21 można policzyć jako jeden wynik ogólny?
Tak. Według autorów trzy wyniki można zsumować lub uśrednić jako miarę ogólnego nasilenia negatywnych emocji. Badania struktury DASS-21 pokazują silny czynnik ogólnego dystresu, dlatego wynik ogólny ma sens, ale nie zastępuje podskal, gdy hipoteza dotyczy np. tylko lęku.
Gdzie znaleźć progi nasilenia DASS-21: łagodny, umiarkowany, ciężki?
Autorzy podają zakresy etykiet tylko w podręczniku DASS, a na stronie zaznaczają, że granice są umowne i opisują położenie względem populacji ogólnej, nie rozpoznanie. Jeśli ich używasz, zacytuj podręcznik lub publikację, z której je wziąłeś, i stosuj je do wyników po pomnożeniu przez 2.
Co zrobić, gdy w DASS-21 brakuje jednej odpowiedzi?
Strona autorów dopuszcza najwyżej jeden brak w 7-pozycyjnej podskali: wtedy uśrednij pozostałe pozycje, pomnóż średnią przez 7, a potem przez 2. Przy dwóch i więcej brakach pozostaw wynik podskali pusty i opisz to kryterium w pracy.
Czy na użycie DASS-21 w pracy dyplomowej trzeba mieć zgodę?
Według strony autorów DASS jest w domenie publicznej, więc zgoda nie jest potrzebna, a formularze można kopiować. Skal nie wolno jednak modyfikować ani sprzedawać. Przy polskiej wersji zacytuj publikację adaptacji, z której korzystasz.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikCES-D – jak policzyć wynik
Dwadzieścia pozycji 0–3, odwrócenie 4, 8, 12, 16, wynik 0–60 i progi 16 lub 20 – z przykładem w R, wartością predykcyjną i wzorem opisu.
Czytaj →PoradnikModel bifactor i ESEM
Od CFA do bifactor-ESEM na jednym kwestionariuszu: ładunki krzyżowe, czynnik ogólny, omega H, ECV, trafność podskal, tabela APA i kod lavaan.
Czytaj →Masz wyniki DASS-21 i nie wiesz, jak je opisać?
Sprawdzimy przypisanie pozycji, liczenie podskal i rzetelność w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Antony, M. M., Bieling, P. J., Cox, B. J., Enns, M. W., & Swinson, R. P. (1998). Psychometric properties of the 42-item and 21-item versions of the Depression Anxiety Stress Scales in clinical groups and a community sample. Psychological Assessment, 10(2), 176–181. https://doi.org/10.1037/1040-3590.10.2.176
- Henry, J. D., & Crawford, J. R. (2005). The short-form version of the Depression Anxiety Stress Scales (DASS-21): Construct validity and normative data in a large non-clinical sample. British Journal of Clinical Psychology, 44(2), 227–239. https://doi.org/10.1348/014466505x29657
- Lovibond, P. F., & Lovibond, S. H. (1995). The structure of negative emotional states: Comparison of the Depression Anxiety Stress Scales (DASS) with the Beck Depression and Anxiety Inventories. Behaviour Research and Therapy, 33(3), 335–343. https://doi.org/10.1016/0005-7967(94)00075-u
- Mazza, G. L., Enders, C. K., & Ruehlman, L. S. (2015). Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation. Multivariate Behavioral Research, 50(5), 504–519. https://doi.org/10.1080/00273171.2015.1068157 ● Otwarty dostęp: pełny tekst
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Psychology Foundation of Australia. (b.d.). Depression Anxiety Stress Scales – DASS. UNSW Sydney, School of Psychology. Pobrano 26 października 2026 z https://www2.psy.unsw.edu.au/dass/ ● Otwarty dostęp
- Rodriguez, A., Reise, S. P., & Haviland, M. G. (2016). Evaluating bifactor models: Calculating and interpreting statistical indices. Psychological Methods, 21(2), 137–150. https://doi.org/10.1037/met0000045
Cytowania BibTeX
@article{antony1998psychometric, author={Antony, Martin M. and Bieling, Peter J. and Cox, Brian J. and Enns, Murray W. and Swinson, Richard P.}, title={{Psychometric properties of the 42-item and 21-item versions of the Depression Anxiety Stress Scales in clinical groups and a community sample}}, journal={Psychological Assessment}, year={1998}, volume={10}, number={2}, pages={176--181}, doi={10.1037/1040-3590.10.2.176}}@article{henry2005short, author={Henry, Julie D. and Crawford, John R.}, title={{The short-form version of the Depression Anxiety Stress Scales (DASS-21): Construct validity and normative data in a large non-clinical sample}}, journal={British Journal of Clinical Psychology}, year={2005}, volume={44}, number={2}, pages={227--239}, doi={10.1348/014466505x29657}}@article{lovibond1995structure, author={Lovibond, Peter F. and Lovibond, Sydney H.}, title={{The structure of negative emotional states: Comparison of the Depression Anxiety Stress Scales (DASS) with the Beck Depression and Anxiety Inventories}}, journal={Behaviour Research and Therapy}, year={1995}, volume={33}, number={3}, pages={335--343}, doi={10.1016/0005-7967(94)00075-u}}@article{mazza2015addressing, author={Mazza, Gina L. and Enders, Craig K. and Ruehlman, Linda S.}, title={{Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={5}, pages={504--519}, doi={10.1080/00273171.2015.1068157}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@misc{dasswebnd, author={{Psychology Foundation of Australia}}, title={{Depression Anxiety Stress Scales – DASS}}, publisher={UNSW Sydney, School of Psychology}, url={https://www2.psy.unsw.edu.au/dass/}}@article{rodriguez2016evaluating, author={Rodriguez, Anthony and Reise, Steven P. and Haviland, Mark G.}, title={{Evaluating bifactor models: Calculating and interpreting statistical indices}}, journal={Psychological Methods}, year={2016}, volume={21}, number={2}, pages={137--150}, doi={10.1037/met0000045}}