Czym jest CES-D
CES-D (Center for Epidemiologic Studies Depression Scale) to krótka skala samoopisowa, którą Lenore Radloff przygotowała do pomiaru objawów depresyjnych w populacji ogólnej. Pozycje wybrano spośród objawów używanych wcześniej w dłuższych, sprawdzonych skalach. W badaniach domowych i w placówkach psychiatrycznych skala miała bardzo wysoką spójność wewnętrzną, zadowalającą stabilność test–retest i trafność. Rzetelność, trafność i struktura czynnikowa były podobne w różnych grupach demograficznych (Radloff, 1977).
Cel narzędzia jest ważny dla interpretacji. CES-D powstał do badań epidemiologicznych, a nie do stawiania diagnozy. Mierzy nasilenie objawów w ostatnim tygodniu i dobrze sprawdza się jako zmienna ciągła albo jako przesiew. Ten wpis należy do serii o liczeniu wyników kwestionariuszy. Podobnie opisaliśmy GAD-7 i PHQ-9, PHQ-2 i GAD-2, WHO-5 oraz DASS-21.
Budowa: 20 pozycji, ostatni tydzień, skala 0–3
Osoba badana ocenia, jak często w ostatnim tygodniu występowało każde z 20 doświadczeń. Odpowiedzi punktuje się od 0 (rzadko lub wcale, mniej niż 1 dzień) do 3 (przez większość czasu lub cały czas, 5–7 dni) (Carleton i in., 2013). Szesnaście pozycji opisuje objawy, a cztery są sformułowane pozytywnie, np. dotyczą nadziei albo radości. Treści pozycji nie przytaczamy.
| Cecha | CES-D | Źródło |
|---|---|---|
| Liczba pozycji | 20, jeden wynik ogólny | Vilagut i in. (2016) |
| Okres odniesienia | ostatni tydzień | Carleton i in. (2013); Vilagut i in. (2016) |
| Skala odpowiedzi | 0–3, od „mniej niż 1 dzień” do „5–7 dni” | Carleton i in. (2013) |
| Pozycje odwrócone | 4, 8, 12, 16 (sformułowane pozytywnie) | Carleton i in. (2013) |
| Zakres wyniku | 0–60; wyższy = więcej objawów | Vilagut i in. (2016) |
| Typowy próg przesiewowy | 16 (w metaanalizie rozważany także 20) | Vilagut i in. (2016) |
| Wersja 10-pozycyjna (CESD-10) | osobna wersja, próg ≥ 10 | Andresen i in. (1994) |
Jak policzyć wynik CES-D krok po kroku
Krok 1. Sprawdź kodowanie 0–3
Upewnij się, że w danych są tylko wartości 0–3 i że 3 oznacza najczęstsze występowanie. Formularze online często zapisują odpowiedzi jako 1–4, co podnosi wynik o 20 punktów. Przekodowanie w różnych programach pokazuje poradnik jak policzyć wynik kwestionariusza.
Krok 2. Odwróć pozycje 4, 8, 12 i 16
Pozytywnie sformułowane pozycje są punktowane odwrotnie (Carleton i in., 2013). Po odwróceniu wysoka wartość oznacza brak afektu pozytywnego, a więc więcej objawów. Szczegóły odwracania w różnych programach opisuje hasło pozycja odwrócona.
Krok 3. Zsumuj 20 pozycji
Suma po odwróceniu daje wynik 0–60, gdzie 0 to najlepszy, a 60 najgorszy możliwy wynik (Vilagut i in., 2016). Pojedyncze wyniki możesz sprawdzić w kalkulatorze wyniku skali.
Krok 4. Ustal regułę dla braków przed analizą
W przeczytanych przez nas źródłach nie ma jednej reguły dla braków w CES-D. Jeśli korzystasz z podręcznika lub z publikacji polskiej adaptacji, która taką regułę podaje, zastosuj ją i zacytuj. W przeciwnym razie zapisz własną decyzję przed analizą. Najprostsza to brak wyniku przy jakimkolwiek braku. Uśrednianie dostępnych pozycji wygląda wygodnie, ale może obciążać wyniki nawet przy brakach całkowicie losowych (Mazza i in., 2015). Mechanizmy braków opisuje hasło braki danych MCAR, MAR i MNAR.
Interpretacja: próg 16, próg 20 i wartość predykcyjna
Podstawowa interpretacja jest ciągła: im wyższy wynik, tym więcej objawów depresyjnych w ostatnim tygodniu. W badaniu korelacyjnym albo w porównaniu grup progi nie są potrzebne.
Jako punkt odcięcia typowo zaleca się 16. Wynik 16 lub wyższy oznacza, że osoba zgłosiła co najmniej 6 z 20 objawów przez większość tygodnia albo większość objawów przez krótszy czas (Vilagut i in., 2016). Metaanaliza Vilagut i in. (2016) objęła 28 badań i 10 617 osób z populacji ogólnej i podstawowej opieki zdrowotnej. Przy progu 16 zbiorcza czułość wyniosła 0.87, a swoistość 0.70. Przy progu 20 czułość wyniosła 0.83, a swoistość 0.78. Autorzy uznali, że zależnie od celu próg 20 może być bardziej odpowiedni. CES-D nie powinien służyć jako samodzielne narzędzie rozpoznania depresji. W pracy pisz o „wynikach powyżej progu przesiewowego”, a nie o „osobach z depresją”.
Wersja 10-pozycyjna to inne narzędzie z innym progiem: ≥ 10 zamiast ≥ 16 (Andresen i in., 1994). Nie stosuj progu pełnej wersji do skróconej i odwrotnie.
Przykład: CES-D u 360 osób studiujących
Dane są symulowane i możesz je pobrać jako plik CSV. Kolumny c1–c20 zawierają odpowiedzi 0–3 w postaci z formularza, czyli przed odwróceniem pozycji 4, 8, 12 i 16. Cztery osoby miały braki i w przykładzie nie dostały wyniku, więc analiza obejmuje 356 osób.
Odwrócenie pozycji w danych
Przed odwróceniem skorygowane korelacje pozycja–reszta czterech pozytywnych pozycji były ujemne: od −.43 do −.38. Po odwróceniu wyniosły od .59 do .62. Ujemna korelacja pozycji z resztą skali to najszybszy sygnał, że odwrócenie pominięto. Gdyby zsumować pozycje bez odwracania, średnia wyniosłaby 17.40 zamiast 14.42. Korelacja błędnego wyniku z poprawnym wynosi tylko r = .80, więc błąd zmienia także uporządkowanie osób, a nie samo przesunięcie.
Wynik i progi
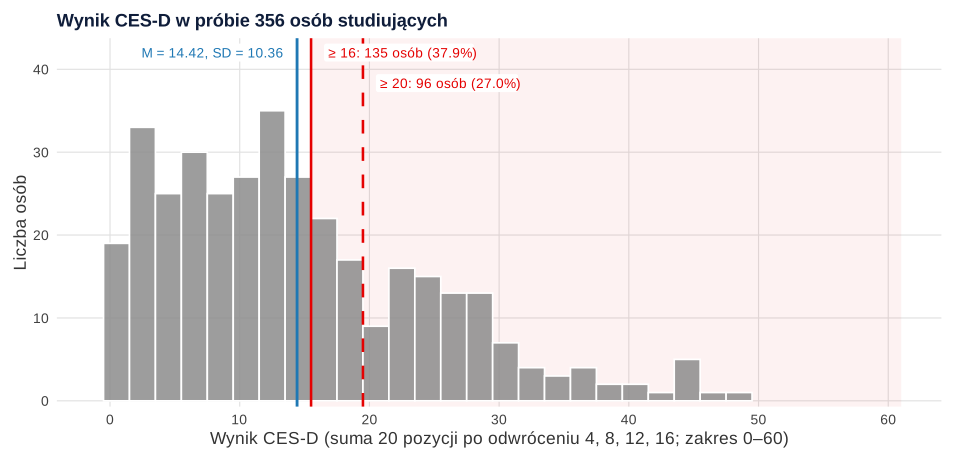
Średni wynik wyniósł M = 14.42 (SD = 10.36), mediana 13, połowa osób między 6 a 21, zakres 0–49. Rozkład jest prawostronnie skośny (skośność 0.87). Wynik 16 lub wyższy miało 135 osób, czyli 37.9%, 95% CI [33.0, 43.1]. Wynik 20 lub wyższy miało 96 osób (27.0%, 95% CI [22.6, 31.8]). Przedziały policzyliśmy metodą Wilsona (zob. przedział ufności dla proporcji).
Ile wyników dodatnich to rzeczywiście depresja?
Bez wywiadu diagnostycznego tego nie wiadomo, ale można to oszacować. Przyjmijmy częstość dużej depresji 8.8%, czyli medianę z metaanalizy, oraz zbiorczą czułość i swoistość (Vilagut i in., 2016). Wśród 1000 przebadanych osób próg 16 dałby 351 wyników dodatnich: 77 u osób z depresją i 274 fałszywie dodatnie. Wartość predykcyjna dodatnia wynosi wtedy .219. Próg 20 dałby 274 wyniki dodatnie, w tym 73 prawdziwie dodatnie, czyli PPV = .267. Przy progu 22 PPV wynosi .276. Wartość predykcyjna ujemna była we wszystkich trzech wariantach wysoka, od .975 do .982.
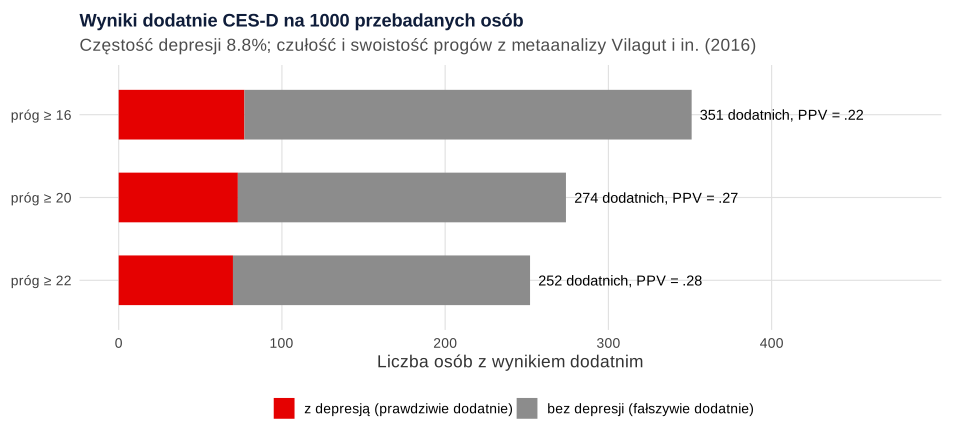
Wyższy próg zmniejsza liczbę fałszywych alarmów kosztem kilku przeoczonych osób z depresją. Wybór zależy od celu badania: w przesiewie z dalszą diagnostyką liczy się czułość, w opisie próby – mniejsza liczba fałszywie dodatnich. Próg wybierz przed zebraniem danych. Jak ocenia się cały zakres progów, pokazuje hasło krzywa ROC.
Rzetelność i struktura
Alfa Cronbacha wyniosła α = .90, 95% CI [.88, .91], a omega McDonalda z jednoczynnikowej CFA ω = .90. Alfa ma restrykcyjne założenia (McNeish, 2018), dlatego warto podawać obie wartości. Pierwotny model Radloff miał cztery czynniki: afekt depresyjny (pozycje 3, 6, 14, 17, 18), brak afektu pozytywnego (4, 8, 12, 16), objawy somatyczne (1, 2, 5, 7, 11, 20) i relacje interpersonalne (15, 19) (Carleton i in., 2013). Później opisano ponad 20 alternatywnych struktur. Carleton i in. (2013) uzyskali najlepsze dopasowanie dla nowego modelu trzech czynników na 14 pozycjach. Zwrócili też uwagę, że pozycje pozytywne mają łączyć dwa cele: przerywać schematyczne odpowiadanie i mierzyć afekt pozytywny. Te cele mogą się wykluczać.
W przykładzie widać to w CFA. Model jednoczynnikowy dopasował się słabiej: χ²(170) = 289.31, CFI = .930, RMSEA = .048, SRMR = .047. Model z dodatkowym czynnikiem dla czterech pozycji pozytywnych dopasował się dobrze: χ²(166) = 185.35, CFI = .989, RMSEA = .020, SRMR = .038, Δχ²(4) = 95.96, p < .001. Pozycje odwrócone dzielą więc wariancję niezwiązaną z nasileniem objawów. To znany problem takich pozycji: mogą obniżać rzetelność i jednowymiarowość skali (Suárez-Álvarez i in., 2018). Nie usuwaj ich jednak z wyniku ogólnego, bo progi i porównania z literaturą dotyczą sumy 20 pozycji. Wpływ stylu odpowiadania opisuje hasło tendencja do zgadzania się.
Jak opisać CES-D w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane wersji, której używasz.
Ogólny schemat opisu narzędzia jest w poradniku opis narzędzia badawczego – wzór, a zdania o rzetelności we wzorze raportowania alfy Cronbacha.
Dostępność i polska wersja
Carleton i in. (2013) opisują CES-D jako swobodnie dostępną miarę. Polskie adaptacje mogą jednak mieć własne warunki użycia, zwłaszcza gdy rozpowszechnia je wydawca testów. Sprawdź, skąd pochodzi Twoja wersja, i zacytuj publikację adaptacji. Nie przenoś do pracy norm ani progów z badań zagranicznych jako „polskich”. Narzędzia pomaga znaleźć poradnik gdzie znaleźć kwestionariusze psychologiczne.
CES-D w R: odwracanie, wynik, progi i struktura
Kod odtwarza liczby z tekstu i zapisuje plik CSV z danymi. Odwrócenie to jedna linia: 3 - x dla pozycji 4, 8, 12 i 16. Przedziały Wilsona daje prop.test() bez poprawki na ciągłość, alfę z przedziałem Feldta pakiet psych, CFA pakiet lavaan, a omegę compRelSEM() z pakietu semTools.
Wynik CES-D krok po kroku
R
# B126 – CES-D: odwracanie pozycji, wynik 0–60, progi 16 i 20, rzetelność i struktura (dane symulowane, set.seed(12620)).
# 360 dorosłych; odpowiedzi 0–3 na 20 pozycji (c1–c20) zapisane tak, jak w formularzu – pozycje 4, 8, 12 i 16
# (sformułowane pozytywnie) nie są jeszcze odwrócone. Treści pozycji nie podajemy.
# Zasady liczenia: pozycje 4, 8, 12, 16 odwracane (Carleton i in., 2013), suma 0–60 (Vilagut i in., 2016).
suppressPackageStartupMessages({ library(psych); library(lavaan); library(semTools) })
set.seed(12620)
n <- 360
dep <- rnorm(n); poz_met <- rnorm(n)                                   # nasilenie objawów i czynnik metody (pozycje pozytywne)
odwr <- c(4, 8, 12, 16)
lam <- c(.55, .52, .70, .58, .57, .74, .56, .60, .62, .58, .50, .63, .55, .66, .45, .60, .52, .72, .50, .58)
y <- sapply(1:20, function(j) {
  if (j %in% odwr) -lam[j] * dep + .45 * poz_met + rnorm(n, 0, sqrt(1 - lam[j]^2 - .45^2))
  else lam[j] * dep + rnorm(n, 0, sqrt(1 - lam[j]^2)) })
odp <- sapply(1:20, function(j) if (j %in% odwr) findInterval(y[, j], c(-1.30, -0.45, 0.35)) else findInterval(y[, j], c(0.25, 1.10, 1.75)))
colnames(odp) <- paste0("c", 1:20)
dane <- data.frame(id = 1:n, odp)
dane$c11[c(33, 210)] <- NA; dane$c17[c(95, 301)] <- NA; dane$c8[301] <- NA
write.csv(dane, "../ces-d-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania

# Krok 1. Kontrola kodowania i braków
pz <- paste0("c", 1:20); pzo <- paste0("c", odwr)
all(sapply(dane[, pz], function(x) all(x %in% c(0:3, NA))))
table(braki = rowSums(is.na(dane[, pz])))

# Krok 2. Przed odwróceniem: pozycje pozytywne korelują z resztą ujemnie
pel <- na.omit(dane)
nrow(pel)
round(alpha(pel[, pz], check.keys = FALSE, warnings = FALSE)$item.stats[pzo, "r.drop"], 2)
# Odwrócenie: 3 − x
for (v in pzo) pel[[v]] <- 3 - pel[[v]]
round(alpha(pel[, pz], warnings = FALSE)$item.stats[pzo, "r.drop"], 2)

# Krok 3. Wynik 0–60 i statystyki opisowe
pel$CESD <- rowSums(pel[, pz])
x <- pel$CESD
round(c(M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)),
        min = min(x), max = max(x), skosnosc = psych::skew(x)), 2)
# Typowy błąd: suma bez odwrócenia pozycji 4, 8, 12, 16
bez <- rowSums(na.omit(dane)[, pz])
round(c(M_bez_odwr = mean(bez), r_z_poprawnym = cor(bez, x)), 2)

# Krok 4. Odsetek wyników przy progach 16 i 20, z 95% CI Wilsona
prog <- function(k) { t <- prop.test(sum(x >= k), length(x), correct = FALSE)
  round(c(n = sum(x >= k), proc = 100 * mean(x >= k), lo = 100 * t$conf.int[1], hi = 100 * t$conf.int[2]), 1) }
rbind(od_16 = prog(16), od_20 = prog(20))

# Krok 5. Co oznacza wynik dodatni: na 1000 osób przy częstości depresji 8.8%
# (mediana z metaanalizy Vilagut i in., 2016) i zbiorczej czułości/swoistości dla progów 16, 20 i 22
cz <- .088
war <- data.frame(prog = c(16, 20, 22), czul = c(.87, .83, .79), swoi = c(.70, .78, .80))
war$TP <- round(1000 * cz * war$czul); war$FN <- round(1000 * cz) - war$TP
war$FP <- round(1000 * (1 - cz) * (1 - war$swoi)); war$TN <- round(1000 * (1 - cz)) - war$FP
war$PPV <- round(war$czul * cz / (war$czul * cz + (1 - war$swoi) * (1 - cz)), 3)
war$NPV <- round(war$swoi * (1 - cz) / (war$swoi * (1 - cz) + (1 - war$czul) * cz), 3)
war

# Krok 6. Rzetelność: alfa (95% CI Feldta) i omega; CFA: jeden czynnik a jeden czynnik + czynnik metody
a <- alpha(pel[, pz], warnings = FALSE)
round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 3)
m1 <- paste("DEP =~", paste(pz, collapse = " + "))
m2 <- paste(m1, "\nMET =~", paste(pzo, collapse = " + "))
f1 <- cfa(m1, data = pel, estimator = "MLR", std.lv = TRUE)
f2 <- cfa(m2, data = pel, estimator = "MLR", std.lv = TRUE, orthogonal = TRUE)
ind <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr")
round(rbind(jeden_czynnik = fitMeasures(f1, ind), z_czynnikiem_metody = fitMeasures(f2, ind)), 3)
lavTestLRT(f1, f2)
round(unlist(compRelSEM(f1)), 3)
Wynik w R
[1] TRUE
braki
  0   1   2
356   3   1
[1] 356
[1] -0.38 -0.43 -0.38 -0.40
[1] 0.59 0.62 0.61 0.60
       M       SD       Me       Q1       Q3      min      max skosnosc
   14.42    10.36    13.00     6.00    21.00     0.00    49.00     0.87
   M_bez_odwr r_z_poprawnym
         17.4           0.8
        n proc   lo   hi
od_16 135 37.9 33.0 43.1
od_20  96 27.0 22.6 31.8
  prog czul swoi TP FN  FP  TN   PPV   NPV
1   16 0.87 0.70 77 11 274 638 0.219 0.982
2   20 0.83 0.78 73 15 201 711 0.267 0.979
3   22 0.79 0.80 70 18 182 730 0.276 0.975
 alfa    lo    hi
0.898 0.882 0.913
                    chisq.scaled df.scaled cfi.robust rmsea.robust  srmr
jeden_czynnik            289.305       170      0.930        0.048 0.047
z_czynnikiem_metody      185.354       166      0.989        0.020 0.038

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the robust test that
   should be reported per model. A robust difference test is a function of two standard (not
   robust) statistics.

    Df   AIC   BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
f2 166 16418 16589 219.67
f1 170 16534 16689 343.58     95.962 0.28878       4  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  DEP
0.901
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy CES-D
- Pominięte odwrócenie pozycji 4, 8, 12 i 16. W przykładzie średnia rośnie z 14.42 do 17.40, a ranking osób się zmienia. Sprawdź korelacje pozycja–reszta.
- Kodowanie 1–4 zamiast 0–3. Wynik rośnie o 20 punktów, więc każda osoba przekracza próg 16.
- „Odsetek studentów z depresją”. Próg daje wynik przesiewowy. Przy częstości 8.8% większość wyników dodatnich to fałszywe alarmy.
- Próg dobrany po obejrzeniu danych. Wybierz 16 albo 20 przed analizą i uzasadnij wybór źródłem.
- Mieszanie wersji. Próg ≥ 10 dotyczy CESD-10, a nie pełnej skali. Nie licz wersji 10-pozycyjnej z 20 pozycji według własnego wyboru.
- Usuwanie pozycji pozytywnych z wyniku tylko dlatego, że obniżają alfę. Wynik przestaje być porównywalny z literaturą.
Pełną ścieżkę analizy narzędzia porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie wyniku CES-D i dobór progu w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Które pozycje CES-D są odwrócone?
Odwraca się cztery pozycje sformułowane pozytywnie: 4, 8, 12 i 16. Przy odpowiedziach 0–3 nowa wartość to 3 minus odpowiedź. Jeśli po zsumowaniu te pozycje korelują z resztą skali ujemnie, odwrócenie pominięto.
Jaki jest punkt odcięcia w CES-D: 16 czy 20?
Typowo zalecany próg to 16. W metaanalizie Vilagut i in. (2016) dawał czułość 0.87 i swoistość 0.70, a próg 20 czułość 0.83 i swoistość 0.78, czyli mniej fałszywych alarmów. Wybierz próg przed analizą i uzasadnij go źródłem.
Czy wynik CES-D powyżej 16 oznacza depresję?
Nie. To dodatni wynik przesiewowy, który wymaga dalszej oceny. Przy częstości depresji około 9% większość osób z wynikiem co najmniej 16 nie ma dużej depresji, więc w pracy pisz o wynikach powyżej progu, a nie o rozpoznaniach.
Czym różni się CESD-10 od pełnej skali CES-D?
CESD-10 to 10-pozycyjna wersja skrócona opracowana przez Andresen i in. (1994), z progiem co najmniej 10 zamiast 16. To osobne narzędzie: nie stosuj do niego progów pełnej skali i nie porównuj wprost wyników obu wersji.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikDASS-21 – jak policzyć wynik
Trzy podskale po 7 pozycji, odpowiedzi 0–3, suma × 2, braki i rzetelność – z przykładem w R, modelem bifactor i wzorem opisu w pracy.
Czytaj →PoradnikGAD-7 i PHQ-9 – jak policzyć wynik
Suma 0–21 i 0–27, braki, progi 5/10/15/20 ze źródłami, próg przesiewowy 10, pozycja 9 PHQ-9 i przykład w R z opisem do pracy.
Czytaj →Masz wyniki CES-D i nie wiesz, jak je opisać?
Sprawdzimy odwracanie pozycji, liczenie wyniku, dobór progu i rzetelność oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andresen, E. M., Malmgren, J. A., Carter, W. B., & Patrick, D. L. (1994). Screening for depression in well older adults: Evaluation of a short form of the CES-D. American Journal of Preventive Medicine, 10(2), 77–84. https://doi.org/10.1016/s0749-3797(18)30622-6 ● Otwarty dostęp
- Carleton, R. N., Thibodeau, M. A., Teale, M. J. N., Welch, P. G., Abrams, M. P., Robinson, T., & Asmundson, G. J. G. (2013). The Center for Epidemiologic Studies Depression Scale: A review with a theoretical and empirical examination of item content and factor structure. PLOS ONE, 8(3), Article e58067. https://doi.org/10.1371/journal.pone.0058067 ● Otwarty dostęp
- Mazza, G. L., Enders, C. K., & Ruehlman, L. S. (2015). Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation. Multivariate Behavioral Research, 50(5), 504–519. https://doi.org/10.1080/00273171.2015.1068157 ● Otwarty dostęp: pełny tekst
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Radloff, L. S. (1977). The CES-D Scale: A self-report depression scale for research in the general population. Applied Psychological Measurement, 1(3), 385–401. https://doi.org/10.1177/014662167700100306 ● Otwarty dostęp: pełny tekst
- Suárez-Álvarez, J., Pedrosa, I., Lozano, L. M., García-Cueto, E., Cuesta, M., & Muñiz, J. (2018). Using reversed items in Likert scales: A questionable practice. Psicothema, 2(30), 149–158. https://doi.org/10.7334/psicothema2018.33 ● Otwarty dostęp
- Vilagut, G., Forero, C. G., Barbaglia, G., & Alonso, J. (2016). Screening for depression in the general population with the Center for Epidemiologic Studies Depression (CES-D): A systematic review with meta-analysis. PLOS ONE, 11(5), Article e0155431. https://doi.org/10.1371/journal.pone.0155431 ● Otwarty dostęp
Cytowania BibTeX
@article{andresen1994screening, author={Andresen, Elena M. and Malmgren, Judith A. and Carter, William B. and Patrick, Donald L.}, title={{Screening for depression in well older adults: Evaluation of a short form of the CES-D}}, journal={American Journal of Preventive Medicine}, year={1994}, volume={10}, number={2}, pages={77--84}, doi={10.1016/s0749-3797(18)30622-6}}@article{carleton2013center, author={Carleton, R. Nicholas and Thibodeau, Michel A. and Teale, Michelle J. N. and Welch, Patrick G. and Abrams, Murray P. and Robinson, Thomas and Asmundson, Gordon J. G.}, title={{The Center for Epidemiologic Studies Depression Scale: A review with a theoretical and empirical examination of item content and factor structure}}, journal={PLOS ONE}, year={2013}, volume={8}, number={3}, eid={e58067}, doi={10.1371/journal.pone.0058067}}@article{mazza2015addressing, author={Mazza, Gina L. and Enders, Craig K. and Ruehlman, Linda S.}, title={{Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={5}, pages={504--519}, doi={10.1080/00273171.2015.1068157}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{radloff1977ces, author={Radloff, Lenore Sawyer}, title={{The CES-D Scale: A self-report depression scale for research in the general population}}, journal={Applied Psychological Measurement}, year={1977}, volume={1}, number={3}, pages={385--401}, doi={10.1177/014662167700100306}}@article{suarezalvarez2018using, author={Suárez-Álvarez, Javier and Pedrosa, Ignacio and Lozano, Luis M. and García-Cueto, Eduardo and Cuesta, Marcelino and Muñiz, José}, title={{Using reversed items in Likert scales: A questionable practice}}, journal={Psicothema}, year={2018}, volume={2}, number={30}, pages={149--158}, doi={10.7334/psicothema2018.33}}@article{vilagut2016screening, author={Vilagut, Gemma and Forero, Carlos G. and Barbaglia, Gabriela and Alonso, Jordi}, title={{Screening for depression in the general population with the Center for Epidemiologic Studies Depression (CES-D): A systematic review with meta-analysis}}, journal={PLOS ONE}, year={2016}, volume={11}, number={5}, eid={e0155431}, doi={10.1371/journal.pone.0155431}}