Czym jest WHO-5 i skąd pochodzi
WHO-5 (World Health Organization-Five Well-Being Index) to pięciopozycyjny kwestionariusz samoopisowy, który mierzy subiektywny dobrostan psychiczny. Pierwszy raz przedstawiono go na spotkaniu WHO w Sztokholmie w lutym 1998 roku. Powstał przez skrócenie wersji 10-pozycyjnej, a ta z kolei pochodzi z 28-pozycyjnej skali (Topp i in., 2015). Biuro Regionalne WHO dla Europy zainicjowało przekłady wersji angielskiej. Dziś narzędzie ma ponad 30 wersji językowych, a WHO udostępnia je w oficjalnej publikacji z 2024 roku, na liście jest też wersja polska (World Health Organization, 2024).
W pracach dyplomowych WHO-5 pojawia się w dwóch rolach. Najczęściej to krótka miara dobrostanu, np. jako zmienna zależna w badaniu studentów albo pracowników. Rzadziej służy jako narzędzie przesiewowe w kierunku depresji. Druga rola wymaga więcej ostrożności i omawiamy ją osobno. Ten wpis należy do serii o liczeniu wyników kwestionariuszy: podobnie opisaliśmy PSS-10, GAD-7 i PHQ-9, skalę SWLS oraz K10 i K6.
Budowa: pięć pozycji, dwa tygodnie, skala 0–5
Osoba badana ocenia pięć stwierdzeń o swoim samopoczuciu w ostatnich dwóch tygodniach. Dotyczą one m.in. nastroju, energii i zainteresowania codziennymi sprawami. Treści pozycji nie przytaczamy: weź je z oficjalnej wersji językowej. Każdą pozycję punktuje się od 5 (all of the time) do 0 (none of the time), więc skala odpowiedzi ma sześć stopni (Topp i in., 2015). Wszystkie pozycje mają ten sam kierunek: wyższy wynik oznacza lepszy dobrostan (World Health Organization, 2024). WHO-5 nie ma pozycji odwróconych ani podskal. Analizy Rascha potwierdziły, że pięć pozycji tworzy skalę jednowymiarową (Topp i in., 2015).
| Cecha | WHO-5 | Źródło |
|---|---|---|
| Liczba pozycji | 5, jeden wynik ogólny | World Health Organization (2024) |
| Okres odniesienia | ostatnie dwa tygodnie (14 dni) | World Health Organization (2024); Topp i in. (2015) |
| Skala odpowiedzi | 0–5, od none of the time do all of the time | Topp i in. (2015) |
| Pozycje odwrócone | brak | wynika z punktacji |
| Wynik surowy | suma 5 pozycji, 0–25 | Topp i in. (2015) |
| Wynik procentowy | wynik surowy × 4, 0–100; wyższy = lepszy dobrostan | Topp i in. (2015) |
| Próg przesiewowy w kierunku depresji | ≤ 50 (w części badań bardziej restrykcyjny ≤ 28) | Topp i in. (2015) |
| Klinicznie istotna zmiana | 10 punktów | Topp i in. (2015) |
Jak policzyć wynik WHO-5 krok po kroku
Krok 1. Sprawdź kodowanie 0–5
Formularze online zapisują odpowiedzi różnie: jako 1–6, jako tekst albo w odwrotnej kolejności, jeśli lista zaczyna się od „cały czas”. Sprawdź, czy w danych są tylko wartości 0–5 i czy 5 oznacza najczęstsze dobre samopoczucie. Przekodowanie w różnych programach pokazuje poradnik jak policzyć wynik kwestionariusza.
Krok 2. Zsumuj pięć pozycji
Suma daje wynik surowy od 0 (brak dobrostanu) do 25 (maksymalny dobrostan).
Krok 3. Pomnóż wynik surowy przez 4
Topp i in. (2015) zalecają przeliczenie na skalę 0–100, tak jak w innych miarach jakości życia. Próg ≤ 50 i zmiana o 10 punktów dotyczą właśnie tej skali. To przeliczenie przypomina POMP, bo minimum skali wynosi 0. Do sprawdzenia pojedynczych wyników możesz użyć kalkulatora wyniku skali.
Krok 4. Ustal regułę dla braków
Przegląd Toppa i in. (2015) nie omawia braków danych, a z pięciu pozycji trudno odtworzyć brakującą odpowiedź. Najprostsza reguła to brak wyniku u osoby z choćby jednym brakiem. Jeśli wybierzesz inną, np. średnią z czterech pozycji × 20, zapisz ją przed analizą i podaj w pracy jako własną decyzję. Szerzej o mechanizmach braków piszemy w haśle braki danych MCAR, MAR i MNAR.
Interpretacja: dobrostan, próg ≤ 50 i zmiana o 10 punktów
Podstawowa interpretacja jest ciągła: im wyższy wynik, tym lepszy dobrostan. W badaniu korelacyjnym albo w porównaniu grup to wystarczy i nie potrzebujesz żadnych progów.
Gdy WHO-5 służy do przesiewu w kierunku depresji, przegląd zaleca punkt odcięcia ≤ 50. Wynik w tym zakresie daje „przesiewowe rozpoznanie”, po którym klinicysta przeprowadza wywiad diagnostyczny. W części badań używano bardziej restrykcyjnego progu ≤ 28. Odpowiada on poziomowi dobrostanu typowemu dla osób z dużą depresją, ale przegląd nie podaje go jako ogólnego zalecenia (Topp i in., 2015). W 18 badaniach średnia czułość progu wyniosła 0.86, a swoistość 0.81. Wynik ≤ 50 to sygnał do dalszej oceny, a nie rozpoznanie depresji. W pracy pisz o „wynikach poniżej progu przesiewowego”, a nie o „osobach z depresją”.
Zmianę w czasie, np. po interwencji, ocenia się kryterium 10 punktów na skali 0–100. Topp i in. (2015) przytaczają je jako próg klinicznie istotnej zmiany. Jak łączyć takie kryterium z wiarygodną zmianą u jednej osoby, opisuje wpis RCI, MDC i MCID. Własnych przedziałów „niski, przeciętny, wysoki” nie ustala się na podstawie WHO-5. Jeśli promotor ich wymaga, przeczytaj najpierw poradnik niski, przeciętny, wysoki wynik.
Przykład: WHO-5 u 320 osób studiujących
Dane są symulowane i możesz je pobrać jako plik CSV (kolumny id i w1–w5, odpowiedzi 0–5). Trzy osoby pominęły pozycję 4, więc wynik ma 317 osób. Średni wynik surowy wyniósł 14.71 (SD = 4.56), a po przeliczeniu M = 58.83 (SD = 18.22), mediana 60, połowa osób między 48 a 72. Rozkład jest lekko lewostronnie skośny (skośność −0.40). Jedna osoba miała wynik 0, nikt nie uzyskał 100, więc efekt sufitu i podłogi nie stanowi problemu.
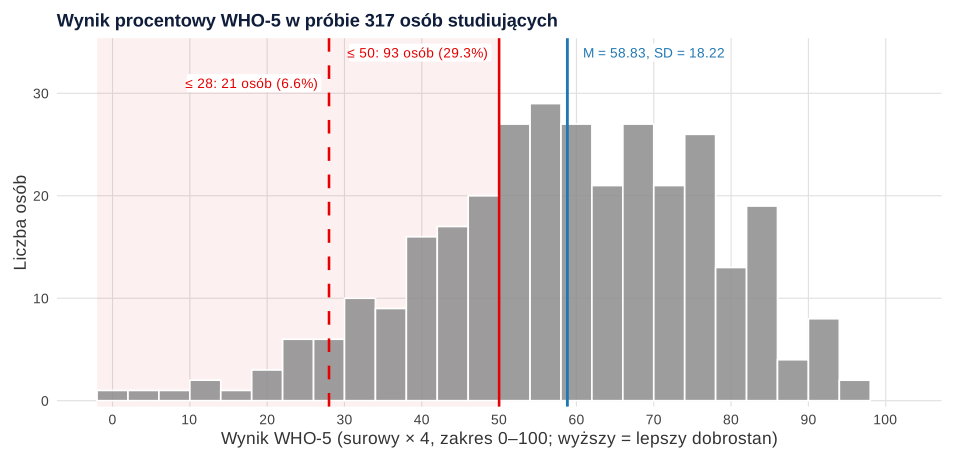
Wynik ≤ 50 miały 93 osoby, czyli 29.3%, 95% CI [24.6, 34.6]. Wynik ≤ 28 miała 21 osób (6.6%, 95% CI [4.4, 9.9]). Przedziały policzyliśmy metodą Wilsona (zob. przedział ufności dla proporcji). Te odsetki opisują wyniki przesiewowe, a nie częstość depresji w próbie.
Ile osób z wynikiem ≤ 50 rzeczywiście ma depresję?
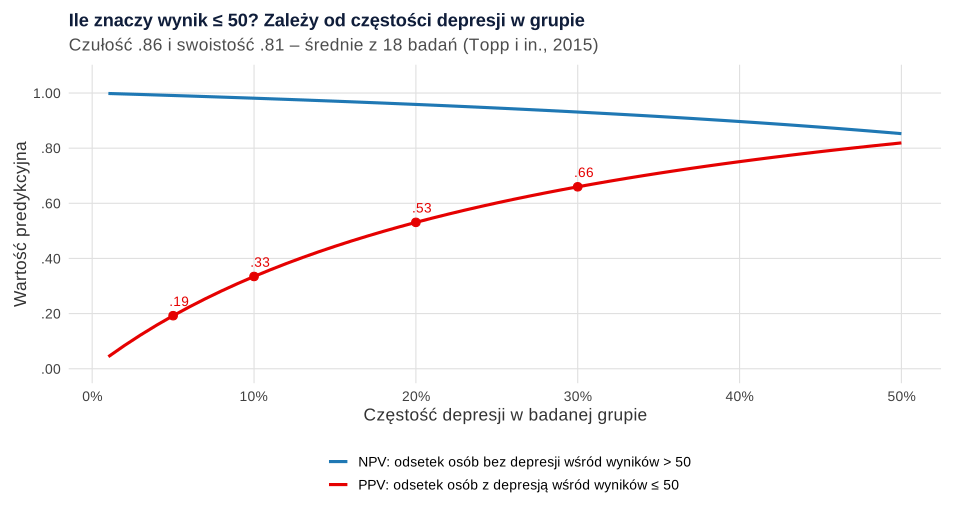
Tego nie wiadomo bez wywiadu diagnostycznego. Odpowiedź zależy też od tego, jak często depresja występuje w badanej grupie. Wartość predykcyjną dodatnią (PPV) możesz policzyć z czułości, swoistości i częstości. Przy czułości .86 i swoistości .81 oraz częstości depresji 10% PPV wynosi .335. Wśród wyników dodatnich byłaby więc mniej więcej jedna osoba z depresją na trzy. Przy częstości 30% PPV rośnie do .660, a przy 5% spada do .192 (rysunek 2). Wartość predykcyjna ujemna jest wysoka we wszystkich tych scenariuszach, od .931 do .991.
Rzetelność i struktura we własnej próbie
Alfa Cronbacha wyniosła α = .83, 95% CI [.80, .86], a skorygowane korelacje pozycja–reszta od .58 do .67. Ponieważ alfa ma restrykcyjne założenia (McNeish, 2018), podaj obok niej omegę McDonalda. Z jednoczynnikowej CFA wyniosła ona ω = .83. Model jednoczynnikowy z estymatorem WLSMV był dobrze dopasowany: CFI = 1.000, RMSEA = .000, SRMR = .011. Tak dobre dopasowanie wynika z symulacji z jednego czynnika, prawdziwe dane zwykle wypadają gorzej. Przy pięciu pozycjach model ma tylko 5 stopni swobody, więc wskaźniki dopasowania są mało czułe na błędy specyfikacji. Więcej o spójności wewnętrznej i gotowe zdania znajdziesz we wzorze raportowania alfy Cronbacha.
Jeśli porównujesz kraje albo grupy językowe, sama rzetelność nie wystarczy. Sischka i in. (2020) przeanalizowali dane z 35 krajów europejskich, ponad 43 tysiące osób pracujących. Model odpowiedzi stopniowanych z teorii reagowania na pozycje dopasowywał się najlepiej, a rzetelność była wysoka także w okolicy progów. Między krajami potwierdzono jednak inwariancję metryczną, ale nie skalarną. Porównanie surowych średnich między krajami może więc wprowadzać w błąd. Procedurę sprawdzania opisuje wpis inwariancja pomiaru krok po kroku.
Jak opisać WHO-5 w pracy
Wzór poniżej zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane wersji, z której korzystasz.
Jeśli raportujesz odsetek wyników poniżej progu, nazwij go ostrożnie:
Ogólny schemat opisu dowolnego narzędzia jest w poradniku opis narzędzia badawczego – wzór.
Polska wersja i warunki użycia
Wersję polską znajdziesz na stronie WHO razem z innymi przekładami. Publikacja ma licencję CC BY-NC-SA 3.0 (World Health Organization, 2024), czyli pozwala na użycie niekomercyjne z podaniem źródła, a utwory zależne trzeba udostępniać na tej samej licencji. Szczegóły sprawdź w samej licencji przed badaniem. Nie przenoś do pracy norm ani właściwości psychometrycznych z innych krajów jako „polskich”. Jeśli powołujesz się na badania polskiej wersji, cytuj publikację, którą sam(a) przeczytałeś (przeczytałaś). Dobre praktyki dotyczące narzędzi w badaniach naukowych opisuje stanowisko International Test Commission (2014), a o szukaniu narzędzi piszemy w poradniku gdzie znaleźć kwestionariusze psychologiczne.
WHO-5 w R: wynik, próg i rzetelność
Kod odtwarza liczby z tekstu i zapisuje plik CSV z danymi. Wynik procentowy to jedna linia: rowSums(...) * 4. Przedział Wilsona daje funkcja prop.test() bez poprawki na ciągłość, alfę z przedziałem Feldta liczy pakiet psych, CFA – lavaan, a omegę – compRelSEM() z pakietu semTools.
Wynik WHO-5 krok po kroku
R
# B99 – WHO-5: wynik surowy, wynik procentowy, próg przesiewowy, rzetelność (dane symulowane, set.seed(9905)).
# 320 osób studiujących; odpowiedzi 0–5 na 5 pozycji (w1–w5), wyższa odpowiedź = częściej dobre samopoczucie.
# Zasady liczenia (Topp i in., 2015): suma 0–25, pomnożona przez 4 daje wynik 0–100. Treści pozycji nie podajemy.
suppressPackageStartupMessages({ library(psych); library(lavaan); library(semTools) })
set.seed(9905)
n <- 320
lat <- rnorm(n)
lam <- c(.78, .74, .70, .66, .72)
progi <- c(-2.0, -1.15, -0.35, 0.45, 1.35)
odp <- sapply(1:5, function(j) findInterval(lam[j] * lat + rnorm(n, 0, sqrt(1 - lam[j]^2)) + 0.05, progi))
colnames(odp) <- paste0("w", 1:5)
dane <- data.frame(id = 1:n, odp)
dane$w4[c(41, 188, 260)] <- NA                                       # trzy osoby pominęły pozycję 4
write.csv(dane, "../who-5-dane-przyklad.csv", row.names = FALSE)     # plik do pobrania

# Krok 1. Kontrola zakresu: tylko wartości 0–5 albo brak
sapply(dane[, -1], function(x) all(x %in% c(0:5, NA)))
colSums(is.na(dane[, -1]))[colSums(is.na(dane[, -1])) > 0]

# Krok 2. Wynik surowy (0–25) i procentowy (0–100); osoby z brakiem – bez wyniku
dane$surowy <- rowSums(dane[, paste0("w", 1:5)])
dane$proc <- dane$surowy * 4
c(n_z_wynikiem = sum(!is.na(dane$proc)), bez_wyniku = sum(is.na(dane$proc)))
x <- na.omit(dane$proc)
round(c(M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x), skosnosc = psych::skew(x)), 2)
quantile(x, c(.25, .75))
round(c(M_surowy = mean(na.omit(dane$surowy)), SD_surowy = sd(na.omit(dane$surowy))), 2)
c(wynik_0 = sum(x == 0), wynik_100 = sum(x == 100))

# Krok 3. Odsetek wyników przy progach z literatury, z 95% CI Wilsona (prop.test bez poprawki)
prog <- function(k) { t <- prop.test(k, length(x), correct = FALSE)
  round(c(n = k, proc = 100 * k / length(x), lo = 100 * t$conf.int[1], hi = 100 * t$conf.int[2]), 1) }
rbind(do_50 = prog(sum(x <= 50)), do_28 = prog(sum(x <= 28)))
# Typowy błąd: porównanie wyniku surowego (0–25) z progiem 50
c(surowy_do_50 = mean(na.omit(dane$surowy) <= 50))

# Krok 4. Rzetelność: alfa (95% CI Feldta), korelacje pozycja–reszta, CFA jednoczynnikowa i omega
pelne <- na.omit(dane[, paste0("w", 1:5)])
a <- alpha(pelne, warnings = FALSE)
round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 3)
round(range(a$item.stats$r.drop), 2)
m1 <- cfa("WB =~ w1 + w2 + w3 + w4 + w5", data = pelne, ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
round(fitMeasures(m1, c("chisq.scaled", "df.scaled", "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr")), 3)
m1c <- cfa("WB =~ w1 + w2 + w3 + w4 + w5", data = pelne, std.lv = TRUE)
round(unlist(compRelSEM(m1c)), 3)

# Krok 5. Co znaczy wynik dodatni w przesiewie: PPV i NPV przy czułości .86 i swoistości .81
# (średnie z 18 badań w przeglądzie Topp i in., 2015) dla różnych częstości depresji w badanej grupie
se <- .86; sp <- .81
czestosc <- c(.05, .10, .20, .30)
ppv <- se * czestosc / (se * czestosc + (1 - sp) * (1 - czestosc))
npv <- sp * (1 - czestosc) / (sp * (1 - czestosc) + (1 - se) * czestosc)
round(data.frame(czestosc, PPV = ppv, NPV = npv), 3)
Wynik w R
  w1   w2   w3   w4   w5
TRUE TRUE TRUE TRUE TRUE
w4
 3
n_z_wynikiem   bez_wyniku
         317            3
       M       SD       Me      min      max skosnosc
   58.83    18.22    60.00     0.00    96.00    -0.40
25% 75%
 48  72
 M_surowy SD_surowy
    14.71      4.56
  wynik_0 wynik_100
        1         0
       n proc   lo   hi
do_50 93 29.3 24.6 34.6
do_28 21  6.6  4.4  9.9
surowy_do_50
           1
 alfa    lo    hi
0.827 0.795 0.856
[1] 0.58 0.67
chisq.scaled    df.scaled   cfi.scaled   tli.scaled rmsea.scaled         srmr
       1.676        5.000        1.000        1.006        0.000        0.011
   WB
0.829
  czestosc   PPV   NPV
1     0.05 0.192 0.991
2     0.10 0.335 0.981
3     0.20 0.531 0.959
4     0.30 0.660 0.931
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy WHO-5
- Porównanie wyniku surowego z progiem 50. Wynik surowy ma maksimum 25, więc w przykładzie „poniżej progu” znalazłyby się wszystkie osoby. Najpierw pomnóż przez 4.
- Kodowanie 1–6 zamiast 0–5. Wynik przesuwa się o 5 punktów surowych, czyli o 20 punktów na skali 0–100.
- Odwrócona kolejność odpowiedzi w formularzu. Jeśli „cały czas” zapisano jako 0, wyższy wynik oznacza gorszy dobrostan. Sprawdź korelację z inną miarą samopoczucia.
- „Odsetek studentów z depresją”. Próg ≤ 50 daje wynik przesiewowy. Bez wywiadu diagnostycznego pisz o wynikach poniżej progu.
- Mieszanie progów. Podaj, którego progu użyłeś (≤ 50 czy ≤ 28) i dlaczego, oraz nie zmieniaj go po obejrzeniu danych.
- Zmiana okresu odniesienia z dwóch tygodni na miesiąc bez informacji w pracy. Wtedy nie porównuj wyników wprost z literaturą.
Jeśli chcesz sprawdzić liczenie wyniku WHO-5 i analizy w swojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Dlaczego wynik WHO-5 mnoży się przez 4?
Suma pięciu pozycji ocenianych od 0 do 5 daje wynik 0–25. Pomnożenie przez 4 przelicza go na skalę 0–100, typową dla miar jakości życia, i tak zalecają Topp i in. (2015). Na tej skali podaje się próg ≤ 50 i klinicznie istotną zmianę o 10 punktów.
Czy wynik WHO-5 poniżej 50 oznacza depresję?
Nie. Wynik ≤ 50 to dodatni wynik przesiewowy, po którym potrzebny jest wywiad diagnostyczny. Ile osób z takim wynikiem rzeczywiście ma depresję, zależy od częstości depresji w grupie: przy czułości .86, swoistości .81 i częstości 10% byłaby to mniej więcej co trzecia osoba.
Czy WHO-5 ma pozycje odwrócone?
Nie. Wszystkie pięć pozycji punktuje się od 5 (cały czas) do 0 (wcale), w tym samym kierunku: wyższa odpowiedź oznacza lepsze samopoczucie. Jeśli w danych któraś pozycja koreluje z resztą ujemnie, problem leży w kodowaniu formularza.
Jaki okres obejmuje kwestionariusz WHO-5?
WHO-5 pyta o ostatnie dwa tygodnie (14 dni). Jeśli zmienisz instrukcję, np. na ostatni miesiąc, napisz o tym w pracy i ostrożnie porównuj wyniki z literaturą.
Czy na użycie WHO-5 w pracy dyplomowej potrzebna jest zgoda?
WHO udostępnia WHO-5 z wersjami językowymi, także polską, na licencji CC BY-NC-SA 3.0, która dopuszcza użycie niekomercyjne z podaniem źródła. Przed badaniem przeczytaj warunki licencji i zacytuj publikację WHO w opisie narzędzia.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikGAD-7 i PHQ-9 – jak policzyć wynik
Suma 0–21 i 0–27, braki, progi 5/10/15/20 ze źródłami, próg przesiewowy 10, pozycja 9 PHQ-9 i przykład w R z opisem do pracy.
Czytaj →PoradnikOpis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →Masz wyniki WHO-5 i nie wiesz, jak je opisać?
Sprawdzimy liczenie wyniku, progi i rzetelność w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- International Test Commission. (2014). ITC statement on the use of tests and other assessment instruments for research purposes (Version 1.2). https://www.intestcom.org/files/statement_using_tests_for_research.pdf ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Sischka, P. E., Costa, A. P., Steffgen, G., & Schmidt, A. F. (2020). The WHO-5 well-being index – validation based on item response theory and the analysis of measurement invariance across 35 countries. Journal of Affective Disorders Reports, 1, Article 100020. https://doi.org/10.1016/j.jadr.2020.100020 ● Otwarty dostęp
- Topp, C. W., Østergaard, S. D., Søndergaard, S., & Bech, P. (2015). The WHO-5 Well-Being Index: A systematic review of the literature. Psychotherapy and Psychosomatics, 84(3), 167–176. https://doi.org/10.1159/000376585 ● Otwarty dostęp
- World Health Organization. (2024). The World Health Organization-Five Well-Being Index (WHO-5). https://www.who.int/publications/m/item/WHO-UCN-MSD-MHE-2024.01 ● Otwarty dostęp
Cytowania BibTeX
@techreport{itc2014statement, author={{International Test Commission}}, title={{ITC statement on the use of tests and other assessment instruments for research purposes}}, year={2014}, institution={International Test Commission}, url={https://www.intestcom.org/files/statement_using_tests_for_research.pdf}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{sischka2020who5, author={Sischka, Philipp E. and Costa, Andreia P. and Steffgen, Georges and Schmidt, Alexander F.}, title={{The WHO-5 well-being index – validation based on item response theory and the analysis of measurement invariance across 35 countries}}, journal={Journal of Affective Disorders Reports}, year={2020}, volume={1}, eid={100020}, doi={10.1016/j.jadr.2020.100020}}@article{topp2015who5, author={Topp, Christian Winther and Østergaard, Søren Dinesen and Søndergaard, Susan and Bech, Per}, title={{The WHO-5 Well-Being Index: A systematic review of the literature}}, journal={Psychotherapy and Psychosomatics}, year={2015}, volume={84}, number={3}, pages={167--176}, doi={10.1159/000376585}}@techreport{who2024who5, author={{World Health Organization}}, title={{The World Health Organization-Five Well-Being Index (WHO-5)}}, year={2024}, institution={World Health Organization}, url={https://www.who.int/publications/m/item/WHO-UCN-MSD-MHE-2024.01}}