Czym są K10 i K6
Skala dystresu psychologicznego Kesslera (Kessler Psychological Distress Scale) występuje w dwóch wersjach: 10-pozycyjnej (K10) i 6-pozycyjnej (K6). Obie mierzą niespecyficzny dystres psychologiczny, czyli to, jak często w ostatnim czasie osoba czuła niepokój, napięcie, przygnębienie czy zmęczenie psychiczne. Nie mierzą natomiast żadnego konkretnego zaburzenia. Skale opracowano na potrzeby amerykańskiego badania zdrowia National Health Interview Survey. Pozycje wybrano z większej puli pytań na podstawie modeli teorii reagowania na pozycje testowe. Zwalidowano je w badaniu z ustrukturyzowanym wywiadem klinicznym (Kessler i in., 2002).
K10 i K6 najlepiej różnicują osoby w górnej części rozkładu, czyli tam, gdzie dystres jest wysoki. Dobrze odróżniały też osoby z zaburzeniami DSM-IV od osób bez nich: pole pod krzywą ROC wynosiło 0.87–0.88, a dla zaburzeń z większym upośledzeniem funkcjonowania 0.95–0.96 (Kessler i in., 2002). Z tego powodu obie skale trafiły do dużych badań populacyjnych w USA, Kanadzie i Australii oraz do badań WHO World Mental Health.
Ten wpis należy do serii o liczeniu wyników kwestionariuszy. Ogólne zasady, takie jak kontrola kodowania, odwracanie pozycji i sumy, opisuje poradnik jak policzyć wynik kwestionariusza. Tutaj skupiamy się na tym, co jest specyficzne dla K10 i K6: na dwóch systemach punktacji i na progach, które w każdym z nich mają inne wartości.
Budowa skali i odpowiedzi
K10 ma 10 pozycji o częstości stanów emocjonalnych, np. poczucia beznadziei czy bezwartościowości. Odpowiada się na pięciostopniowej skali częstości od none of the time do all of the time. K6 nie jest osobnym kwestionariuszem, tylko sześcioma pozycjami K10. W numeracji wersji z 2001 roku są to pozycje 2, 4, 5, 8, 9 i 10 (Australian Bureau of Statistics, 2012). Wszystkie pozycje opisują stany negatywne, więc w żadnej wersji nie ma pozycji odwróconych. Treści pozycji tu nie podajemy. W pracy użyj brzmienia z wersji, z której faktycznie korzystasz.
| Cecha | K10 | K6 |
|---|---|---|
| Liczba pozycji | 10 | 6 (pozycje 2, 4, 5, 8, 9, 10 K10 w wersji z 2001 r.) |
| Okres odniesienia | ostatnie 30 dni (wersja z 2001 r.) albo ostatnie 4 tygodnie (wersja z 1994 r.) | |
| Skala odpowiedzi | 5 stopni: od none of the time do all of the time | |
| Pozycje odwrócone | brak | |
| Wynik przy punktacji 0–4 (USA) | 0–40 | 0–24 |
| Wynik przy punktacji 1–5 (Australia) | 10–50 | 6–30 |
Źródło: Australian Bureau of Statistics (2012). Wersje z 1994 i 2001 roku różnią się okresem odniesienia, kolejnością części pozycji i drobnymi zmianami brzmienia. Dlatego numery pozycji K6 sprawdź w tej wersji K10, której używasz. W wywiadach trzy pytania uzupełniające pomija się, gdy na pytanie poprzedzające padła odpowiedź „wcale” (Australian Bureau of Statistics, 2012). Jeśli Twoja ankieta też ma takie przejścia, z góry ustal, jak zakodujesz pominięte pytania, i nie mieszaj ich z prawdziwymi brakami danych.
Jak policzyć wynik K10 i K6 krok po kroku
Krok 1. Ustal, w którym systemie punktacji pracujesz
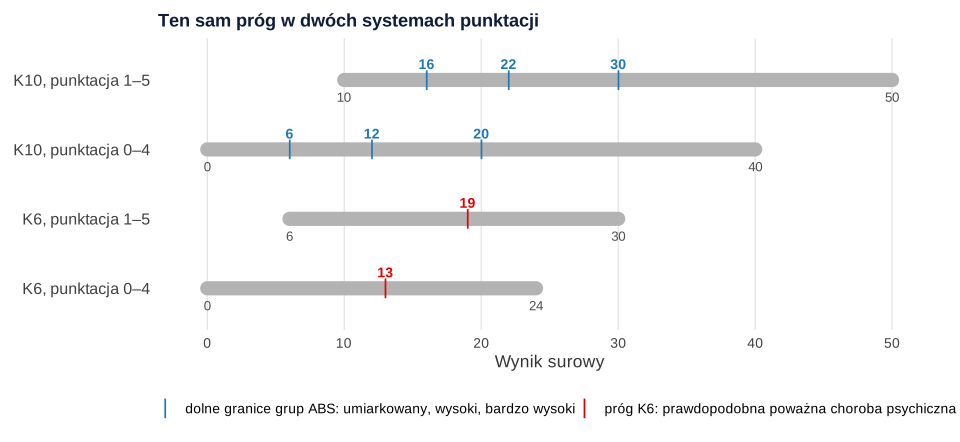
To najważniejsza decyzja przy K10. W badaniach australijskich odpowiedzi punktuje się od 1 do 5, więc K10 ma zakres 10–50. W USA punktuje się je od 0 do 4, co daje zakres 0–40 (Australian Bureau of Statistics, 2012). Oba systemy są poprawne i różnią się tylko stałą. Wynik w punktacji 0–4 to wynik w punktacji 1–5 minus 10 dla K10 i minus 6 dla K6. Formularze online zwykle zapisują odpowiedzi jako 1–5. Sprawdź więc w danych, jakie wartości faktycznie występują, i napisz w pracy, której punktacji użyłeś (zob. rekodowanie).
Krok 2. Zsumuj pozycje
K10 to suma 10 pozycji, a K6 suma sześciu wybranych pozycji. Niczego nie odwracasz. Wyższy wynik oznacza większy dystres. Oba wyniki możesz policzyć z jednego zestawu danych, bo K6 zawiera się w K10. Tę samą sumę policzysz bez programowania w kalkulatorze wyniku skali.
Krok 3. Zdecyduj, co zrobisz z brakami
Źródła, które tu cytujemy, nie podają reguły dla pojedynczych braków. Najbezpieczniej jest liczyć wynik tylko dla osób z kompletem odpowiedzi. Jeśli wybierzesz regułę proporcjonalną, zapisz ją przed analizą i podaj w pracy, ilu osób dotyczyła. Pamiętaj, że brak w pozycji spoza K6 nie przeszkadza w policzeniu K6, ale uniemożliwia policzenie K10. Liczebności obu wyników mogą się więc różnić.
Interpretacja: grupy wyniku i progi
Wyższy wynik oznacza większy dystres. Grupy wyniku i progi istnieją, ale nie są jednym oficjalnym kluczem. Australian Bureau of Statistics (2012) pisze wprost, że nie ma powszechnie uzgodnionych kategorii wyniku K10, a w Australii stosuje się kilka podziałów, zależnie od celu i miejsca badania.
| Podział | Punktacja 1–5 | Punktacja 0–4 | Źródło |
|---|---|---|---|
| K10, grupy ABS: niski, umiarkowany, wysoki, bardzo wysoki dystres | 10–15, 16–21, 22–29, 30–50 | 0–5, 6–11, 12–19, 20–40 | Australian Bureau of Statistics (2012), na podstawie m.in. Andrews i Slade (2001) |
| K10, grupy z podstawowej opieki zdrowotnej (monitorowanie dystresu) | 10–19, 20–24, 25–29, 30–50 | 0–9, 10–14, 15–19, 20–40 | Australian Bureau of Statistics (2012) |
| K6, prawdopodobna poważna choroba psychiczna | 19–30 | 13–24 | Kessler i in. (2003, 2010); Australian Bureau of Statistics (2012) |
| K6, umiarkowany dystres | 11–18 | 5–12 | Prochaska i in. (2012) |
Wartości w punktacji 0–4 dla grup K10 są przeliczeniem granic podanych przez ABS (minus 10 punktów). Tak samo przeliczono próg 5+ z pracy Prochaski i in. (2012) na punktację 1–5 (plus 6). Andrews i Slade (2001) opisali na australijskich danych populacyjnych, jak wynik K10 wiąże się z objawami, niepełnosprawnością, korzystaniem z pomocy i diagnozą. Na tych danych oparto grupy ABS. Próg 13 dla K6 wynika z badań walidacyjnych, w których poważną chorobę psychiczną zdefiniowano jako zaburzenie DSM-IV z wyraźnie obniżonym funkcjonowaniem (Kessler i in., 2003). W 14 krajach badań WHO zgodność K6 z takim rozpoznaniem była zwykle znaczna, z medianą AUC 0.83 (Kessler i in., 2010). Prochaska i in. (2012) wyznaczyli na danych z Kalifornii dolny próg umiarkowanego dystresu: K6 ≥ 5.
Wynik powyżej progu nie jest rozpoznaniem. W badaniu Kesslera i in. (2003) K6 miał wysoką swoistość (0.96), ale niską czułość (0.36). Wiele osób z poważnym zaburzeniem nie przekraczało więc progu. Ile wyników dodatnich jest trafnych, zależy od częstości zaburzenia w próbie. Mechanizm ten opisuje hasło wartość predykcyjna dodatnia i ujemna, a na przykładzie PHQ-9 pokazuje go poradnik GAD-7 i PHQ-9. W pracy pisz o „odsetku osób z wynikiem K6 ≥ 13”, a nie o „odsetku osób chorych”.
K10 czy K6? Furukawa i in. (2003) w australijskim badaniu populacyjnym uzyskali dla K10 nieznacznie wyższe AUC niż dla K6 (0.90 wobec 0.89). K6 był jednak stabilniejszy w podgrupach i autorzy zalecili go do przesiewu w kierunku dowolnego zaburzenia nastroju lub lękowego. Jeśli ankieta jest długa, K6 wystarczy. Jeśli chcesz używać grup ABS albo porównywać się z badaniami australijskimi, wybierz K10.
Przykład: dystres u 300 osób studiujących
Wyobraź sobie badanie 300 osób studiujących w czasie sesji. Odpowiedzi zapisano jak w formularzu online, czyli 1–5. Dane są symulowane i możesz je pobrać jako plik CSV (kolumny id i k1–k10). Trzy osoby pominęły po jednej pozycji: dwie pozycję 7, a jedna pozycję 3. Żadna z nich nie należy do K6. Wynik K10 ma więc 297 osób, a wynik K6 wszystkie 300.
Średni wynik K10 wyniósł M = 21.47 (SD = 7.40) w punktacji 1–5, czyli 11.47 w punktacji 0–4. Mediana wynosiła 21, a połowa osób miała od 15 do 27 punktów. Rozkład jest prawostronnie skośny (skośność 0.57), co przy miarach dystresu jest typowe. Większość osób ma niskie lub umiarkowane wyniki, a nieliczne bardzo wysokie (maksimum 47). K6 miał średnią 12.83 (SD = 4.67) w punktacji 1–5, czyli 6.83 w punktacji 0–4.
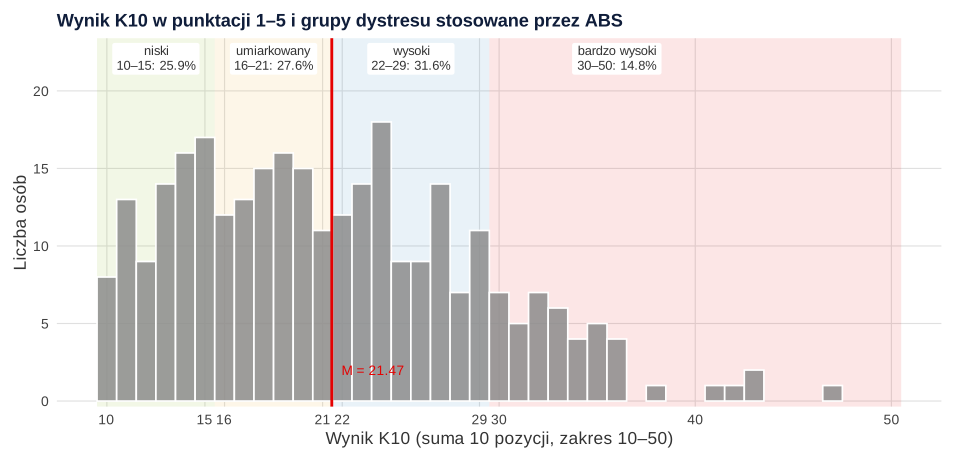
Według grup ABS 77 osób (25.9%) miało niski dystres, 82 (27.6%) umiarkowany, 94 (31.6%) wysoki, a 44 (14.8%) bardzo wysoki (rysunek 1). Ten sam rozkład pocięty według grup z podstawowej opieki zdrowotnej wygląda inaczej. W przedziale 10–19 znalazły się 133 osoby (44.8%), w przedziale 20–24 – 70 osób (23.6%), a w przedziale 25–29 – 50 osób (16.8%). Dlatego w pracy zawsze podawaj, czyich granic użyłeś.
W K6 wynik co najmniej 13 w punktacji 0–4 miały 42 osoby z 300, czyli 14.0%, 95% CI [10.5, 18.4]. Próg 19 w punktacji 1–5 klasyfikuje identycznie. Przedział ufności dla odsetka policzyliśmy metodą Wilsona (zob. przedział ufności dla proporcji). Wynik od 5 do 12 punktów, czyli umiarkowany dystres według Prochaski i in. (2012), miało 159 osób. Wśród 297 osób z oboma wynikami 36 z 41 osób z K6 ≥ 13 było w grupie „bardzo wysoki” K10, a 5 w grupie „wysoki”. Z kolei 8 osób z grupy „bardzo wysoki” nie przekroczyło progu K6. Progi różnych skal nie są więc wymienne.
Rzetelność we własnej próbie
Spójność wewnętrzna K10 wyniosła α = .89, 95% CI [.87, .91], a skorygowane korelacje pozycja–reszta mieściły się w przedziale od .50 do .73. Dla K6 α = .84, 95% CI [.81, .87]. Alfa ma założenia, które rzadko są spełnione (McNeish, 2018), dlatego obok niej podaj omegę McDonalda. Z modelu jednoczynnikowego wyniosła ona ω = .89 dla K10 i ω = .84 dla K6. Korelacja K6 z K10 wyniosła r = .97, ale nie świadczy ona o trafności zbieżnej, bo sześć pozycji należy do obu wyników. Gotowe zdania o rzetelności znajdziesz we wzorze raportowania alfy Cronbacha.
Jak opisać K10 i K6 w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane wersji językowej, której użyłeś. Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór.
W rozdziale z wynikami najpierw opisz wynik ciągły, a dopiero potem grupy:
W analizach wnioskujących, np. w korelacjach, porównaniach grup czy regresji, używaj wyniku ciągłego. Grupy dobrze opisują próbę, ale przy dzieleniu wyniku tracisz informację (zob. podział względem mediany i poradnik niski, przeciętny, wysoki wynik).
Polska wersja, zgoda i bezpieczeństwo osób badanych
Australian Bureau of Statistics (2012) przytacza uwagę Andrewsa i Slade’a, że K10 jest w domenie publicznej i można go używać bezpłatnie. Nie oznacza to jednak, że każdy przekład jest równie dobry. Sprawdź, z jakiej polskiej wersji korzystasz, kto ją opracował i jakie ma właściwości psychometryczne. Normy i dane porównawcze bierz z publikacji tej wersji, a nie z badań australijskich czy amerykańskich. Własny przekład bez procedury adaptacji opisz jako ograniczenie (zob. adaptacja kulturowa kwestionariusza). Jak szukać narzędzi, opisuje poradnik gdzie znaleźć kwestionariusze psychologiczne.
Przy skali dystresu część osób uzyska bardzo wysokie wyniki. Ustal z promotorem i komisją etyczną, jaką informację o możliwościach pomocy dostaną wszyscy uczestnicy na końcu ankiety, zwłaszcza w badaniu anonimowym. Nie przekazuj osobom badanym „wyniku diagnozy”.
K10 i K6 w R: wynik, grupy i rzetelność
Kod odtwarza wszystkie liczby z tekstu i rysunków, a na początku zapisuje plik CSV do pobrania. Obie punktacje to jedna linia, bo wynik 0–4 to wynik 1–5 minus 10 (K10) albo minus 6 (K6). Grupy tworzy funkcja cut(), alfę z przedziałem Feldta liczy pakiet psych, a omegę funkcja compRelSEM() z pakietu semTools. Na własnych danych zmień tylko nazwy kolumn i sprawdź numery pozycji K6 w swojej wersji K10.
Wynik K10 i K6 krok po kroku
R
# B101 – K10 i K6: liczenie wyniku w dwóch systemach punktacji, grupy wyniku, rzetelność (dane symulowane, set.seed(10106)).
# 300 osób studiujących; odpowiedzi na 10 pozycji K10 zapisane jak w formularzu online: 1 (nigdy) – 5 (cały czas).
# Zasady (Australian Bureau of Statistics, 2012): brak pozycji odwróconych; K10 = suma 10 pozycji; K6 = pozycje 2, 4, 5, 8, 9 i 10 wersji K10 z 2001 r.
# Treści pozycji nie podajemy – w danych są tylko numery.
suppressPackageStartupMessages({ library(psych); library(lavaan); library(semTools) })
set.seed(10106)
n <- 300
czynnik <- rnorm(n)
lam <- c(.62, .74, .70, .76, .66, .64, .80, .72, .70, .74)
progi <- c(-0.45, 0.45, 1.20, 1.95)
odp <- sapply(lam, function(l) findInterval(l * czynnik + rnorm(n, 0, sqrt(1 - l^2)), progi) + 1)
colnames(odp) <- paste0("k", 1:10)
dane <- data.frame(id = 1:n, odp)
dane$k7[c(41, 188)] <- NA; dane$k3[230] <- NA                      # trzy osoby pominęły po jednej pozycji
write.csv(dane, "../k10-k6-dane-przyklad.csv", row.names = FALSE)    # plik do pobrania

# Krok 1. Kontrola kodowania: tylko 1–5 albo brak
sapply(dane[, -1], function(x) all(x %in% c(1:5, NA)))
colSums(is.na(dane[, -1]))[colSums(is.na(dane[, -1])) > 0]

# Krok 2. Wynik K10 i K6 w punktacji 1–5 (Australia) i 0–4 (USA); osoby z brakiem – bez wyniku
k10 <- paste0("k", 1:10); k6 <- paste0("k", c(2, 4, 5, 8, 9, 10))
dane$K10_au <- rowSums(dane[, k10]);  dane$K10_us <- dane$K10_au - 10   # 10–50 oraz 0–40
dane$K6_au  <- rowSums(dane[, k6]);   dane$K6_us  <- dane$K6_au - 6     # 6–30 oraz 0–24
c(z_wynikiem_K10 = sum(!is.na(dane$K10_au)), z_wynikiem_K6 = sum(!is.na(dane$K6_au)))
pel <- dane[!is.na(dane$K10_au), ]
opis <- function(x) round(c(M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)),
                            Q3 = unname(quantile(x, .75)), min = min(x), max = max(x), skosnosc = psych::skew(x)), 2)
rbind(K10_au = opis(pel$K10_au), K10_us = opis(pel$K10_us), K6_au = opis(pel$K6_au), K6_us = opis(pel$K6_us))

# Krok 3. Grupy K10 stosowane przez ABS (10–15, 16–21, 22–29, 30–50) i grupy CRUfAD/GPcare (10–19, 20–24, 25–29, 30–50)
abs_gr <- cut(pel$K10_au, c(9, 15, 21, 29, 50), labels = c("niski", "umiarkowany", "wysoki", "bardzo wysoki"))
cbind(n = table(abs_gr), proc = round(100 * prop.table(table(abs_gr)), 1))
cru_gr <- cut(pel$K10_au, c(9, 19, 24, 29, 50), labels = c("10-19", "20-24", "25-29", "30-50"))
cbind(n = table(cru_gr), proc = round(100 * prop.table(table(cru_gr)), 1))

# Krok 4. K6: próg 13+ w punktacji 0–24 (= 19+ w punktacji 6–30) i próg 5+ dla umiarkowanego dystresu
k6p <- dane$K6_us[!is.na(dane$K6_us)]
c(n = length(k6p), K6_13plus = sum(k6p >= 13), K6_5_12 = sum(k6p >= 5 & k6p <= 12), K6_ponizej5 = sum(k6p < 5))
all((dane$K6_us >= 13) == (dane$K6_au >= 19), na.rm = TRUE)          # oba zapisy progu dają tę samą klasyfikację
pt <- prop.test(sum(k6p >= 13), length(k6p), correct = FALSE)       # 95% CI Wilsona dla odsetka
round(100 * c(odsetek = unname(pt$estimate), lo = pt$conf.int[1], hi = pt$conf.int[2]), 1)
table(K6_13plus = pel$K6_us >= 13, K10_ABS = abs_gr)                 # te same osoby w dwóch klasyfikacjach

# Krok 5. Rzetelność: alfa (95% CI Feldta) i omega z modelu jednoczynnikowego; zgodność K6 z K10
r_alfa <- function(d) { a <- alpha(d, check.keys = FALSE, warnings = FALSE)
  round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]],
          r_min = min(a$item.stats$r.drop), r_max = max(a$item.stats$r.drop)), 3) }
rbind(K10 = r_alfa(na.omit(dane[, k10])), K6 = r_alfa(na.omit(dane[, k6])))
m10 <- cfa(paste("D =~", paste(k10, collapse = " + ")), data = na.omit(dane[, k10]), std.lv = TRUE)
m6  <- cfa(paste("D =~", paste(k6, collapse = " + ")), data = na.omit(dane[, k6]), std.lv = TRUE)
round(c(omega_K10 = unlist(compRelSEM(m10))[[1]], omega_K6 = unlist(compRelSEM(m6))[[1]]), 3)
round(cor(pel$K10_au, pel$K6_au), 3)

# Wartości w zapisie do tekstu
bz <- function(v) sub("^(-?)0\\.", "\\1.", formatC(v, format = "f", digits = 2))
a10 <- r_alfa(na.omit(dane[, k10])); a6 <- r_alfa(na.omit(dane[, k6]))
noquote(c(alfa_K10 = bz(a10[["alfa"]]), lo = bz(a10[["lo"]]), hi = bz(a10[["hi"]]),
          alfa_K6 = bz(a6[["alfa"]]), lo6 = bz(a6[["lo"]]), hi6 = bz(a6[["hi"]]),
          omega_K10 = bz(unlist(compRelSEM(m10))[[1]]), omega_K6 = bz(unlist(compRelSEM(m6))[[1]]), r_K6_K10 = bz(cor(pel$K10_au, pel$K6_au))))
Wynik w R
  k1   k2   k3   k4   k5   k6   k7   k8   k9  k10
TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE
k3 k7
 1  2
z_wynikiem_K10  z_wynikiem_K6
           297            300
           M   SD Me Q1 Q3 min max skosnosc
K10_au 21.47 7.40 21 15 27  10  47     0.57
K10_us 11.47 7.40 11  5 17   0  37     0.57
K6_au  12.83 4.67 12  9 16   6  29     0.59
K6_us   6.83 4.67  6  3 10   0  23     0.59
               n proc
niski         77 25.9
umiarkowany   82 27.6
wysoki        94 31.6
bardzo wysoki 44 14.8
        n proc
10-19 133 44.8
20-24  70 23.6
25-29  50 16.8
30-50  44 14.8
          n   K6_13plus     K6_5_12 K6_ponizej5
        300          42         159          99
[1] TRUE
odsetek      lo      hi
   14.0    10.5    18.4
         K10_ABS
K6_13plus niski umiarkowany wysoki bardzo wysoki
    FALSE    77          82     89             8
    TRUE      0           0      5            36
     alfa    lo    hi r_min r_max
K10 0.890 0.870 0.907 0.498 0.727
K6  0.842 0.813 0.868 0.598 0.646
omega_K10  omega_K6
    0.891     0.842
[1] 0.967
 alfa_K10        lo        hi   alfa_K6       lo6       hi6 omega_K10  omega_K6  r_K6_K10
      .89       .87       .91       .84       .81       .87       .89       .84       .97
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy K10 i K6
- Mieszanie punktacji 0–4 i 1–5. Próg 20 ma zupełnie inny sens w punktacji 0–40 niż w punktacji 10–50. Zawsze podawaj zakres wyniku.
- Grupy bez źródła. Podziałów K10 jest kilka. Napisz, czyje granice przyjąłeś, i nie łącz granic z różnych źródeł.
- Nazywanie wyniku powyżej progu rozpoznaniem. K10 i K6 to skale przesiewowe. Piszesz o dystresie albo o wyniku przesiewowo dodatnim, a nie o depresji czy zaburzeniu.
- Złe pozycje K6. Wersje K10 z 1994 i 2001 roku mają różną kolejność części pozycji. Sprawdź numerację w swojej wersji.
- Porównywanie średniej z normami australijskimi bez zastrzeżenia, że to inna populacja, inny okres badania i często inna wersja językowa.
- Tylko rzetelność z literatury. Podaj α i ω z własnej próby, z przedziałem ufności.
Jeśli chcesz sprawdzić, czy dobrze policzyłeś wynik K10 lub K6 i jak opisać grupy w swojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik w skali K10?
Zakoduj każdą z 10 odpowiedzi od 1 do 5 (albo od 0 do 4) i zsumuj je. Pozycji odwróconych nie ma. Wynik mieści się w zakresie 10–50 przy punktacji 1–5 i 0–40 przy punktacji 0–4, a wyższy oznacza większy dystres (Australian Bureau of Statistics, 2012).
Jakie są progi K10: niski, umiarkowany, wysoki i bardzo wysoki dystres?
Australian Bureau of Statistics stosuje w punktacji 1–5 grupy 10–15, 16–21, 22–29 i 30–50, oparte m.in. na pracy Andrewsa i Slade’a (2001). Zaznacza przy tym, że nie ma jednego powszechnie uzgodnionego podziału. W punktacji 0–4 te same granice to 0–5, 6–11, 12–19 i 20–40.
Od ilu punktów K6 wskazuje na poważny dystres?
W punktacji 0–24 wynik co najmniej 13 oznacza prawdopodobną poważną chorobę psychiczną (Kessler i in., 2003, 2010). W punktacji 6–30 odpowiada mu wynik co najmniej 19. Prochaska i in. (2012) zaproponowali dodatkowo próg 5 dla umiarkowanego dystresu. To progi przesiewowe, a nie rozpoznanie.
Czym różni się K6 od K10?
K6 to sześć pozycji K10, punktowanych tak samo. W australijskim badaniu K10 miał nieznacznie wyższe AUC (0.90 wobec 0.89), ale K6 był stabilniejszy w podgrupach i autorzy zalecili go do przesiewu (Furukawa i in., 2003). Oba wyniki policzysz z jednego zestawu odpowiedzi K10.
Czy K10 można stosować bez zgody autora?
Australian Bureau of Statistics (2012) przytacza uwagę Andrewsa i Slade’a, że K10 jest w domenie publicznej i można go używać bezpłatnie. Sprawdź jednak, kto opracował polską wersję, z której korzystasz, i podaj ją w opisie narzędzia.
Powiązane hasła
Przeczytaj też
GAD-7 i PHQ-9 – jak policzyć wynik
Suma 0–21 i 0–27, braki, progi 5/10/15/20 ze źródłami, próg przesiewowy 10, pozycja 9 PHQ-9 i przykład w R z opisem do pracy.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikPSS-10 – jak policzyć wynik
Skala 0–4, pozycje odwrócone 4, 5, 7 i 8, suma 0–40, brak punktów odcięcia, rzetelność i struktura – z przykładem w R i wzorem opisu w pracy.
Czytaj →Masz wyniki K10 lub K6 i nie wiesz, jak je opisać?
Sprawdzimy liczenie wyniku, dobór grup i rzetelność skali w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andrews, G., & Slade, T. (2001). Interpreting scores on the Kessler Psychological Distress Scale (K10). Australian and New Zealand Journal of Public Health, 25(6), 494–497. https://doi.org/10.1111/j.1467-842x.2001.tb00310.x ● Otwarty dostęp
- Australian Bureau of Statistics. (2012). Information paper: Use of the Kessler Psychological Distress Scale in ABS health surveys, Australia, 2007–08 (Cat. No. 4817.0.55.001). https://www.abs.gov.au/AUSSTATS/abs@.nsf/2f762f95845417aeca25706c00834efa/34333D54F054CE51CA2579D50015D786 ● Otwarty dostęp
- Furukawa, T. A., Kessler, R. C., Slade, T., & Andrews, G. (2003). The performance of the K6 and K10 screening scales for psychological distress in the Australian National Survey of Mental Health and Well-Being. Psychological Medicine, 33(2), 357–362. https://doi.org/10.1017/s0033291702006700
- Kessler, R. C., Andrews, G., Colpe, L. J., Hiripi, E., Mroczek, D. K., Normand, S.-L. T., Walters, E. E., & Zaslavsky, A. M. (2002). Short screening scales to monitor population prevalences and trends in non-specific psychological distress. Psychological Medicine, 32(6), 959–976. https://doi.org/10.1017/s0033291702006074
- Kessler, R. C., Barker, P. R., Colpe, L. J., Epstein, J. F., Gfroerer, J. C., Hiripi, E., Howes, M. J., Normand, S.-L. T., Manderscheid, R. W., Walters, E. E., & Zaslavsky, A. M. (2003). Screening for serious mental illness in the general population. Archives of General Psychiatry, 60(2), 184–189. https://doi.org/10.1001/archpsyc.60.2.184
- Kessler, R. C., Green, J. G., Gruber, M. J., Sampson, N. A., Bromet, E., Cuitan, M., Furukawa, T. A., Gureje, O., Hinkov, H., Hu, C.-Y., Lara, C., Lee, S., Mneimneh, Z., Myer, L., Oakley-Browne, M., Posada-Villa, J., Sagar, R., Viana, M. C., & Zaslavsky, A. M. (2010). Screening for serious mental illness in the general population with the K6 screening scale: Results from the WHO World Mental Health (WMH) survey initiative. International Journal of Methods in Psychiatric Research, 19(S1), 4–22. https://doi.org/10.1002/mpr.310 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Prochaska, J. J., Sung, H.-Y., Max, W., Shi, Y., & Ong, M. (2012). Validity study of the K6 scale as a measure of moderate mental distress based on mental health treatment need and utilization. International Journal of Methods in Psychiatric Research, 21(2), 88–97. https://doi.org/10.1002/mpr.1349 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{andrews2001interpreting, author={Andrews, Gavin and Slade, Tim}, title={{Interpreting scores on the Kessler Psychological Distress Scale (K10)}}, journal={Australian and New Zealand Journal of Public Health}, year={2001}, volume={25}, number={6}, pages={494--497}, doi={10.1111/j.1467-842x.2001.tb00310.x}}@techreport{abs2012k10, author={{Australian Bureau of Statistics}}, title={{Information paper: Use of the Kessler Psychological Distress Scale in ABS health surveys, Australia, 2007–08 (Cat. No. 4817.0.55.001)}}, year={2012}, institution={Australian Bureau of Statistics}, url={https://www.abs.gov.au/AUSSTATS/abs@.nsf/2f762f95845417aeca25706c00834efa/34333D54F054CE51CA2579D50015D786}}@article{furukawa2003performance, author={Furukawa, Toshi A. and Kessler, Ronald C. and Slade, Tim and Andrews, Gavin}, title={{The performance of the K6 and K10 screening scales for psychological distress in the Australian National Survey of Mental Health and Well-Being}}, journal={Psychological Medicine}, year={2003}, volume={33}, number={2}, pages={357--362}, doi={10.1017/s0033291702006700}}@article{kessler2002short, author={Kessler, Ronald C. and Andrews, Gavin and Colpe, Lisa J. and Hiripi, Eva and Mroczek, Daniel K. and Normand, Sharon-Lise T. and Walters, Ellen E. and Zaslavsky, Alan M.}, title={{Short screening scales to monitor population prevalences and trends in non-specific psychological distress}}, journal={Psychological Medicine}, year={2002}, volume={32}, number={6}, pages={959--976}, doi={10.1017/s0033291702006074}}@article{kessler2003screening, author={Kessler, Ronald C. and Barker, Peggy R. and Colpe, Lisa J. and Epstein, Joan F. and Gfroerer, Joseph C. and Hiripi, Eva and Howes, Mary J. and Normand, Sharon-Lise T. and Manderscheid, Ronald W. and Walters, Ellen E. and Zaslavsky, Alan M.}, title={{Screening for serious mental illness in the general population}}, journal={Archives of General Psychiatry}, year={2003}, volume={60}, number={2}, pages={184--189}, doi={10.1001/archpsyc.60.2.184}}@article{kessler2010screening, author={Kessler, Ronald C. and Green, Jennifer Greif and Gruber, Michael J. and Sampson, Nancy A. and Bromet, Evelyn and Cuitan, Marius and Furukawa, Toshi A. and Gureje, Oye and Hinkov, Hristo and Hu, Chi-Yi and Lara, Carmen and Lee, Sing and Mneimneh, Zeina and Myer, Landon and Oakley-Browne, Mark and Posada-Villa, Jose and Sagar, Rajesh and Viana, Maria Carmen and Zaslavsky, Alan M.}, title={{Screening for serious mental illness in the general population with the K6 screening scale: Results from the WHO World Mental Health (WMH) survey initiative}}, journal={International Journal of Methods in Psychiatric Research}, year={2010}, volume={19}, number={S1}, pages={4--22}, doi={10.1002/mpr.310}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{prochaska2012validity, author={Prochaska, Judith J. and Sung, Hai-Yen and Max, Wendy and Shi, Yanling and Ong, Michael}, title={{Validity study of the K6 scale as a measure of moderate mental distress based on mental health treatment need and utilization}}, journal={International Journal of Methods in Psychiatric Research}, year={2012}, volume={21}, number={2}, pages={88--97}, doi={10.1002/mpr.1349}}