Dwa problemy, których zwykła CFA nie rozwiązuje
Walidujesz kwestionariusz z trzema podskalami. Konfirmacyjna analiza czynnikowa z trzema skorelowanymi czynnikami dopasowuje się przyzwoicie, ale korelacje czynników sięgają .70, a recenzent pyta, czy w ogóle wolno liczyć podskale i czy wynik ogólny nie wystarczy. Takie pytania często słyszą doktoranci, którzy adaptują albo budują narzędzie w ramach rozprawy, i badacze przygotowujący artykuł walidacyjny. Standardowa CFA nie odpowie na nie z dwóch powodów.
Po pierwsze, CFA ustala na zero wszystkie ładunki krzyżowe. Pozycja o zamartwianiu się, która trochę mierzy też unikanie, musi wtedy „przemycić” tę wspólną wariancję przez korelację czynników. Asparouhov i Muthén (2009) wskazują, że błędnie wyzerowane ładunki krzyżowe zwykle zniekształcają czynniki i zawyżają ich korelacje. Po drugie, w CFA trzech skorelowanych czynników nie widać, ile wariancji pozycji wynika z jednego, ogólnego konstruktu, a ile przypada specyficznym podskalom. Morin, Arens i Marsh (2016) nazywają te zjawiska dwoma źródłami wielowymiarowości istotnej dla konstruktu: pozycje nie są idealnymi wskaźnikami jednego czynnika, a same konstrukty mają strukturę hierarchiczną.
Na pierwszy problem odpowiada ESEM (eksploracyjne modelowanie równań strukturalnych), na drugi – model bifactor. Ich połączenie to bifactor-ESEM. Definicje obu modeli znajdziesz w hasłach słownika, a różnicę między czynnikiem drugiego rzędu a kompozytem we wpisie o modelowaniu konstruktów wyższego rzędu. Tutaj przejdziesz całą sekwencję modeli na jednym zbiorze danych w pakiecie lavaan: od CFA do bifactor-ESEM, z wskaźnikami ωH, ECV i PUC, testem trafności kryterialnej i gotowym opisem do artykułu. Jeśli EFA i CFA są dla ciebie nowe, zacznij od wpisu analiza czynnikowa EFA i CFA.
Sześć modeli pomiarowych i pytania, na które odpowiadają
Sekwencję modeli warto zaplanować przed analizą i zapisać w planie analiz albo prerejestracji. Każdy model w tabeli to inna hipoteza o strukturze narzędzia. Kolejne różnią się dwiema decyzjami: czy pozycje mogą ładować „nie swoje” czynniki i czy wariancja wspólna dzieli się na ogólną i specyficzną.
| Model | Co zakłada | Na jakie pytanie odpowiada | Typowe ryzyko |
|---|---|---|---|
| CFA jednoczynnikowa | Jeden czynnik wyjaśnia wszystkie korelacje pozycji | Czy narzędzie jest jednowymiarowe? | Prawie zawsze odrzucana przy kilkunastu pozycjach, nawet gdy wielowymiarowość jest niegroźna |
| CFA z czynnikami skorelowanymi | Każda pozycja ładuje tylko swoją podskalę, ładunki krzyżowe = 0 | Czy podskale są rozróżnialne? | Zawyżone korelacje czynników, gdy ładunki krzyżowe nie są zerowe |
| Model drugiego rzędu | Czynnik ogólny działa na pozycje tylko przez podskale | Czy podskale mają wspólną przyczynę? | Przy trzech podskalach równoważny modelowi czynników skorelowanych |
| Bifactor CFA | Pozycja ładuje czynnik ogólny G i jeden czynnik specyficzny; czynniki nieskorelowane | Ile zostaje podskalom po wydzieleniu G? | Lepsze dopasowanie z powodu większej elastyczności, „znikające” czynniki specyficzne |
| ESEM | Wszystkie pozycje ładują wszystkie czynniki; rotacja (np. geomin) | Jak wyglądają czynniki bez wymuszonych zer? | Ładunki krzyżowe mogą zastępować nieuwzględniony czynnik ogólny |
| Bifactor-ESEM | G + czynniki specyficzne + ładunki krzyżowe; rotacja ortogonalna target lub bifactor | Oba źródła wielowymiarowości naraz | Duża liczba parametrów, zależność wyniku od rotacji, wymaga dużej próby |
Uwaga na model drugiego rzędu. Przy trzech czynnikach pierwszego rzędu jego część strukturalna ma zero stopni swobody, więc dopasowanie jest identyczne jak w modelu trzech skorelowanych czynników. Rindskopf i Rose (1988) opisują taką sytuację, w której dwa zidentyfikowane modele mają identyczne dopasowanie. Porównanie „drugi rząd kontra czynniki skorelowane” niczego wtedy nie rozstrzyga, o czym piszemy szerzej w haśle o konstrukcie wyższego rzędu i identyfikacji modelu SEM.
Badanie przykładowe: kwestionariusz lęku z trzema podskalami
W przykładzie 800 dorosłych wypełniło 15-pozycyjny kwestionariusz lęku z odpowiedziami 1–5 (dane symulowane). Podskale mają po pięć pozycji: objawy somatyczne (som1–som5), zamartwianie się (zam1–zam5) i unikanie społeczne (unk1–unk5). Osoby wypełniły też skalę upośledzenia funkcjonowania (0–40; M = 20.27, SD = 5.80), która posłuży jako kryterium. Dane wygenerowano z modelu bifactor z czterema małymi ładunkami krzyżowymi. Czynnik specyficzny zamartwiania się był w populacji słaby, a upośledzenie zależało od czynnika ogólnego i od specyficznego unikania. Wiemy więc, co analiza „powinna” znaleźć, i możemy sprawdzić, które modele to pokazują.
Plik z danymi pobierzesz tutaj: model-bifactor-i-esem-dane.csv (800 wierszy, 15 pozycji i kolumna funk). Wszystkie modele szacujemy odporną metodą największej wiarygodności (MLR) i traktujemy pięciostopniowe odpowiedzi jak dane ciągłe. Przy skali Likerta z mniejszą liczbą kategorii albo silną asymetrią rozważ WLSMV na korelacjach polichorycznych. Bloki efa() w lavaan działają także z pozycjami porządkowymi, ale obliczenia trwają wtedy dłużej.
Krok 1. Punkt wyjścia: CFA jednoczynnikowa, trzy czynniki i model drugiego rzędu
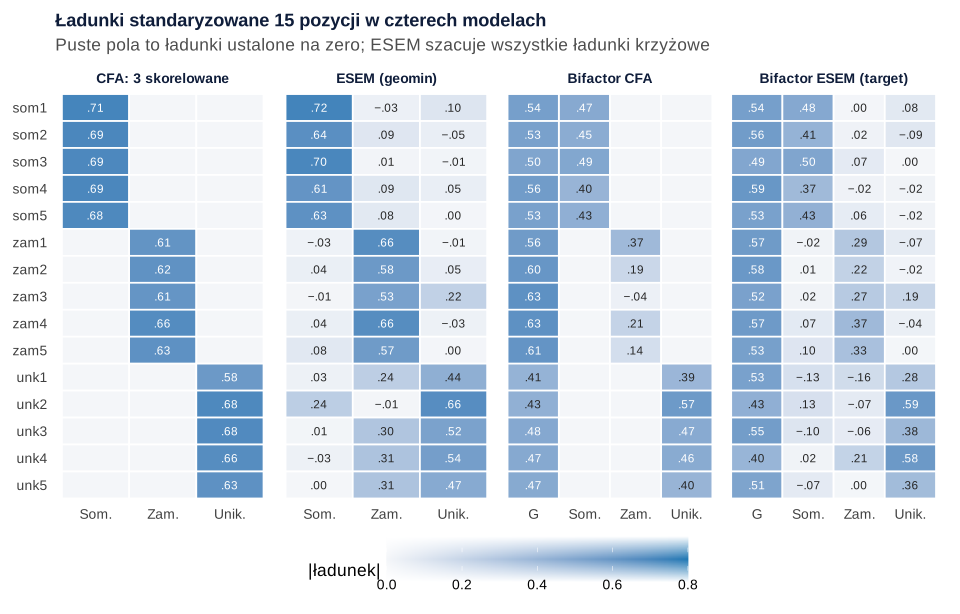
Model jednoczynnikowy dopasował się słabo: χ²(90) = 762.73, CFI = .817, TLI = .786, RMSEA = .097, SRMR = .074. Model trzech skorelowanych czynników był dobrze dopasowany: χ²(87) = 148.67, CFI = .983, TLI = .979, RMSEA = .030, SRMR = .031. Ładunki standaryzowane wyniosły .68–.71 dla objawów somatycznych, .61–.66 dla zamartwiania się i .58–.68 dla unikania. Gdyby analiza skończyła się tutaj, raport brzmiałby: „struktura trójczynnikowa potwierdzona”.
Korelacje czynników są jednak wysokie: .75 między objawami somatycznymi a zamartwianiem, .66 między zamartwianiem a unikaniem i .55 między objawami somatycznymi a unikaniem. Model drugiego rzędu ma dokładnie to samo dopasowanie, χ²(87) = 148.67, a ładunki czynnika ogólnego na podskalach wyniosły .79, .95 i .69. Ładunek .95 dla zamartwiania się to pierwszy sygnał: ta podskala prawie pokrywa się z czynnikiem ogólnym. Wysoka korelacja czynników nie mówi jednak, czy wynika ona z ogólnego lęku, czy z wyzerowanych ładunków krzyżowych. Do tego potrzebne są dwa następne modele.
Krok 2. ESEM: co się dzieje, gdy zwolnisz ładunki krzyżowe
W lavaan model ESEM zapisujesz blokiem efa("e")*som + efa("e")*zam + efa("e")*unk =~ …, w którym wszystkie pozycje ładują wszystkie trzy czynniki. Tożsamość czynników ustala rotacja ukośna geomin, a nie ograniczenia modelu. Browne (2001) omawia wybór kryterium rotacji, zwłaszcza przy złożonym wzorze ładunków, w którym standardowe metody dają słabe rozwiązania. Marsh i in. (2014) pokazują, że ESEM łączy zalety EFA z możliwościami CFA i SEM: testami dopasowania, korelacjami z innymi zmiennymi i inwariancją pomiaru.
ESEM dopasował się prawie idealnie: χ²(63) = 61.39, CFI = 1.000, TLI = 1.001, RMSEA = .000, SRMR = .015. Ważniejsze są jednak korelacje czynników. Związek objawów somatycznych z zamartwianiem zmalał tylko z .75 do .68, ale korelacja zamartwiania z unikaniem spadła z .66 do .24, a objawów somatycznych z unikaniem z .55 do .23. Sześć ładunków krzyżowych przekroczyło .20, maksymalnie .31. Co zaskakujące, cztery z pięciu pozycji unikania ładowały też czynnik zamartwiania (.24–.31).
Taki wzór, czyli wiele małych ładunków krzyżowych o tym samym znaku, rzadko świadczy o złych pozycjach. Częściej jest śladem czynnika ogólnego, którego model nie uwzględnia. Morin i in. (2016) zalecają w takiej sytuacji porównanie ESEM z bifactor-ESEM. Jeśli ładunki krzyżowe znikną po dodaniu czynnika G, odzwierciedlały strukturę hierarchiczną, a nie niedoskonałość pozycji.
Krok 3. Bifactor CFA: czynnik ogólny i trzy czynniki specyficzne
W modelu bifactor CFA każda pozycja ładuje czynnik ogólny G i czynnik swojej podskali. W lavaan wystarczy dodać linię G =~ ze wszystkimi pozycjami i opcję orthogonal = TRUE. Model był dobrze dopasowany: χ²(75) = 129.01, CFI = .985, TLI = .980, RMSEA = .030, SRMR = .028. Dopasowanie poprawiło się więc niewiele w porównaniu z trzema czynnikami skorelowanymi, ale obraz pomiaru zmienił się zasadniczo.
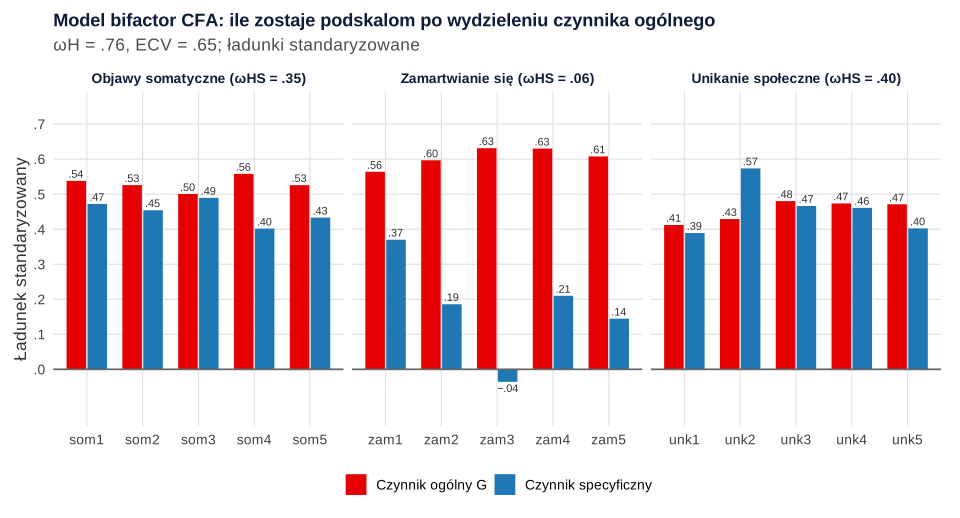
Ładunki czynnika ogólnego wyniosły .41–.63. Podskale objawów somatycznych (.40–.49) i unikania (.39–.57) zachowały wyraźne czynniki specyficzne. Czynnik specyficzny zamartwiania prawie zniknął: ładunki wyniosły .37, .19, −.04, .21 i .14. Eid, Geiser, Koch i Heene (2017) nazywają takie wyniki anomaliami modeli z czynnikiem G: znikające czynniki specyficzne i nieregularne wzory ładunków. Według autorów należy się ich spodziewać, gdy model bifactor stosuje się do zwykłego, jednopoziomowego doboru osób. Proponują modele bifactor-(S−1), w których jedną podskalę traktuje się jako domenę odniesienia, bez własnego czynnika specyficznego. Słaby czynnik specyficzny bywa też źródłem problemów technicznych: braku zbieżności albo przypadku Heywooda.
W przykładzie słabość czynnika zamartwiania nie jest artefaktem. Tak wygenerowano dane. W realnym badaniu nie wiesz tego z góry, dlatego interpretuj czynnik specyficzny dopiero wtedy, gdy ma kilka wyraźnych ładunków i sens teoretyczny.
Krok 4. Bifactor-ESEM z rotacją target
Bifactor-ESEM łączy oba poprzednie modele. Wszystkie pozycje ładują czynnik G i trzy czynniki specyficzne, a ładunki krzyżowe są szacowane, nie zerowane. Jennrich i Bentler (2011) opisali eksploracyjną analizę bifactor jako zwykłą EFA z kryterium rotacji bifactor. W lavaan wygodniej jest użyć ortogonalnej rotacji target, bo pozwala wprost wskazać, która pozycja należy do której podskali. W rotacji target podajesz macierz celu: NA oznacza ładunek główny (G na wszystkich pozycjach, czynnik specyficzny na pozycjach swojej podskali), a 0 – ładunek, który rotacja ma zbliżyć do zera, ale go nie zeruje. W lavaan służą do tego argumenty rotation = "target" i rotation.args = list(target = cel, orthogonal = TRUE). Szczegóły rotacji geomin i target znajdziesz w haśle ESEM.
Model dopasował się bardzo dobrze: χ²(51) = 33.56, CFI = 1.000, TLI = 1.009, RMSEA = .000, SRMR = .010. Ładunki czynnika ogólnego wyniosły .40–.59. Czynniki specyficzne objawów somatycznych (.37–.50) i unikania (.28–.59) były dobrze zdefiniowane, a czynnik zamartwiania słabszy (.22–.37). Najważniejsza zmiana dotyczy ładunków krzyżowych pozycji unikania na czynniku zamartwiania. W ESEM cztery z nich wynosiły .24–.31, a po dodaniu czynnika G spadły do przedziału od −.16 do .21. Zostały głównie te ładunki, które rzeczywiście wbudowano w dane: zam3 na unikaniu (.19) i unk4 na zamartwianiu (.21). Rysunek 1 zestawia ładunki z czterech modeli.
Krok 5. Porównanie modeli: dopasowanie to za mało
Tabela 1 zbiera dopasowanie wszystkich modeli. Ułóż ją w kolejności teoretycznej, a nie od najlepszego wyniku. Czytelnik zobaczy wtedy, co zmienia każde kolejne założenie.
Tabela 1
Dopasowanie modeli pomiarowych kwestionariusza lęku (N = 800)
| Model | χ² | df | CFI | TLI | RMSEA | SRMR | AIC | BIC |
|---|---|---|---|---|---|---|---|---|
| 1. CFA jednoczynnikowa | 762.73 | 90 | .817 | .786 | .097 | .074 | 34612.39 | 34752.93 |
| 2. CFA, trzy czynniki skorelowane | 148.67 | 87 | .983 | .979 | .030 | .031 | 34000.12 | 34154.71 |
| 3. CFA drugiego rzędu | 148.67 | 87 | .983 | .979 | .030 | .031 | 34000.12 | 34154.71 |
| 4. Bifactor CFA | 129.01 | 75 | .985 | .980 | .030 | .028 | 34001.63 | 34212.43 |
| 5. ESEM (geomin) | 61.39 | 63 | 1.000 | 1.001 | .000 | .015 | 33958.30 | 34225.32 |
| 6. Bifactor-ESEM (target) | 33.56 | 51 | 1.000 | 1.009 | .000 | .010 | 33952.55 | 34275.79 |
Uwaga. Estymacja MLR; χ² ze skalowaniem Yuana–Bentlera, CFI, TLI i RMSEA w wersji odpornej. Model 3 jest równoważny modelowi 2 (trzy czynniki pierwszego rzędu). W modelach 4 i 6 czynniki są nieskorelowane. Dane symulowane.
Wskaźniki dopasowania pokazują poprawę z każdym krokiem, ale kryteria informacyjne się rozchodzą. AIC najlepiej ocenia bifactor-ESEM (33952.55), a BIC – model trzech skorelowanych czynników (34154.71). BIC mocniej karze 69 swobodnych parametrów bifactor-ESEM wobec 33 w CFA. Konwencjonalne progi Hu i Bentlera (1999), czyli CFI i TLI bliskie .95, RMSEA około .06 i SRMR około .08, spełniają tu wszystkie modele poza jednoczynnikowym. Nie pomogą więc w wyborze. Morin i in. (2016) proponują inny porządek: najpierw porównanie CFA z ESEM, potem modeli pierwszego rzędu, hierarchicznych i bifactor. W każdym porównaniu patrz przede wszystkim na parametry, a nie na same indeksy:
- CFA kontra ESEM. Jeśli ESEM wyraźnie obniża korelacje czynników, a ładunki główne pozostają mocne, ESEM lepiej odtwarza strukturę. W przykładzie korelacje spadły z .55–.75 do .23–.68.
- ESEM kontra bifactor-ESEM. Jeśli czynnik G jest dobrze zdefiniowany (wszystkie ładunki wyraźne), a ładunki krzyżowe maleją, model bifactor-ESEM wyjaśnia strukturę lepiej. W przykładzie ładunki G wyniosły .40–.59, a krzyżowe ładunki pozycji unikania zmalały.
- Bifactor CFA kontra bifactor-ESEM. To samo pytanie co w punkcie 1, tylko z czynnikiem G w obu modelach. Tu różnica jest mniejsza, bo ładunki krzyżowe w danych są małe.
Dopasowanie modelu bifactor jest przy tym z natury lepsze, bo model ma więcej swobodnych parametrów. Porównanie z modelem drugiego rzędu opisujemy w haśle model bifactor i nie będziemy go tu powtarzać.
Krok 6. Wskaźniki bifactor: ωH, ECV, PUC i H
Model bifactor jest najbardziej użyteczny, gdy z jego ładunków policzysz wskaźniki, które mówią, czy wynik ogólny i wyniki podskal mają sens. Rodriguez, Reise i Haviland (2016) omawiają je razem jako narzędzie oceny wyników liczonych jako suma lub średnia pozycji. Wszystkie policzysz z macierzy standaryzowanych ładunków i wariancji błędów. W przepisie 2 robi to krótka funkcja w R, bez dodatkowych pakietów.
| Wskaźnik | Co mierzy | Wynik w przykładzie |
|---|---|---|
| ω (omega ogólna) | Rzetelność wyniku ogólnego: udział wariancji wspólnej (G i czynniki specyficzne) w wariancji sumy | .898 |
| ωH (omega hierarchiczna) | Udział samego czynnika G w wariancji sumy wszystkich pozycji | .764 |
| ωH/ω | Jaka część rzetelnej wariancji wyniku ogólnego pochodzi od G | .851 |
| ECV | Udział G w całej wariancji wspólnej pozycji | .647 (bifactor-ESEM: .613) |
| PUC | Odsetek korelacji między pozycjami z różnych podskal, czyli „nieskażonych” czynnikami specyficznymi | .714 |
| H dla G | Jak dobrze zestaw pozycji odtwarza czynnik G (rzetelność konstruktu) | .861 |
| ωHS podskal | Udział czynnika specyficznego w wariancji sumy pozycji podskali | som .346; zam .059; unk .395 |
| H podskal | Jak dobrze pozycje podskali odtwarzają jej czynnik specyficzny | som .562; zam .208; unk .585 |
Wynik ogólny jest tu dobrze uzasadniony: ω = .898, a 85.1% jego rzetelnej wariancji pochodzi od czynnika G. Podskale wyglądają inaczej. Każda ma przyzwoitą omegę (ωS = .824, .773 i .782), ale tylko część tej rzetelności należy do podskali. W unikaniu jest to 50.6%, w objawach somatycznych 41.9%, a w zamartwianiu zaledwie 7.7%. Wysoka alfa albo omega podskali nie dowodzi, że podskala mierzy coś odrębnego. Suma pozycji zamartwiania jest w praktyce drugim, krótszym pomiarem ogólnego lęku. Reise, Bonifay i Haviland (2013) piszą, że wykazanie wielowymiarowości w CFA nie przesądza ani o nieadekwatności wyniku ogólnego, ani o konieczności liczenia podskal. Decyzję o wyniku całkowitym i podskalach omawia hasło podskala i wynik ogólny, a różne odmiany omegi – Flora (2020).
ECV i PUC mówią, czy można traktować narzędzie jak jednowymiarowe, np. w modelu strukturalnym z jednym czynnikiem lęku. Reise, Scheines, Widaman i Haviland (2013) pokazali w symulacjach, że obciążenie współczynników strukturalnych przy dopasowaniu modelu jednoczynnikowego do danych wielowymiarowych zależy silnie i odwrotnie od ECV. Efekt ten łagodzi wysoki PUC. Jednocześnie popularne wskaźniki dopasowania odrzucały modele jednoczynnikowe także wtedy, gdy obciążenie było małe. Słabe dopasowanie modelu 1 w tabeli 1 nie wystarcza więc jako argument przeciw wynikowi ogólnemu.
Dla porównania funkcja omega() z pakietu psych, oparta na eksploracyjnym rozwiązaniu Schmida–Leimana, dała ωh = .687 i ω = .899. Wartość ωh jest niższa niż z modelu CFA, bo to inna metoda szacowania. W artykule podaj, z którego modelu liczysz wskaźniki. Reise (2012) omawia procedurę Schmida–Leimana obok konfirmacyjnych modeli bifactor.
Krok 7. Trafność kryterialna: czy podskale coś dodają?
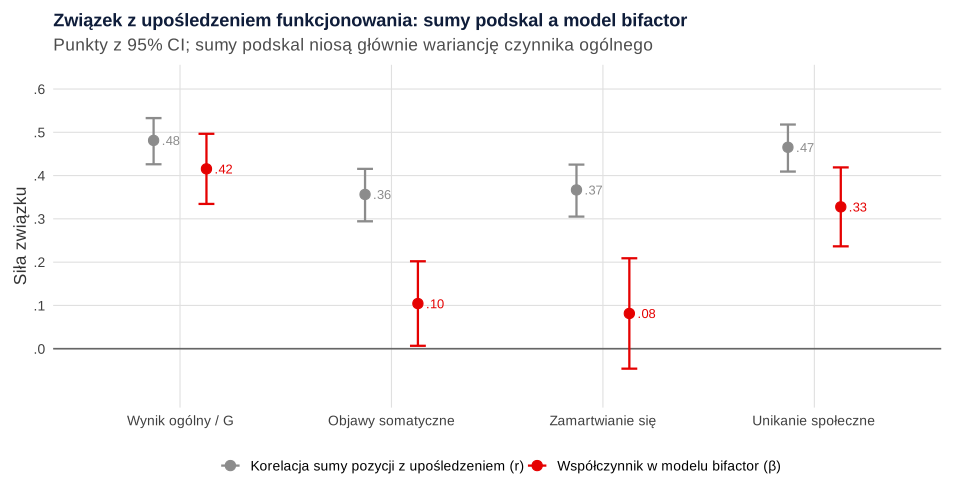
Ostatni test to związki ze zmienną zewnętrzną. Chen, West i Sousa (2006) pokazali, że model bifactor ułatwia interpretację związków czynników specyficznych ze zmiennymi zewnętrznymi ponad czynnik ogólny. W przykładzie suma wszystkich pozycji korelowała z upośledzeniem funkcjonowania na poziomie r = .48, 95% CI [.43, .53], a sumy podskal na poziomie .36 (objawy somatyczne), .37 (zamartwianie) i .47 (unikanie). Na tej podstawie wszystkie trzy podskale wyglądają na trafne.
W modelu bifactor z regresją upośledzenia na cztery czynniki obraz jest inny. Czynnik ogólny przewidywał upośledzenie, β = .42, 95% CI [.33, .50], p < .001, i niezależnie od niego czynnik specyficzny unikania, β = .33, 95% CI [.24, .42], p < .001. Specyficzne objawy somatyczne dodawały niewiele, β = .10, 95% CI [.01, .20], p = .036, a specyficzne zamartwianie – nic, β = .08, 95% CI [−.05, .21], p = .211. Model wyjaśnił 29.8% wariancji upośledzenia. Rysunek 3 pokazuje tę różnicę. Korelacje sum podskal z kryterium niosą głównie wariancję czynnika ogólnego. Dlatego w analizie trafności kryterialnej podawaj oba poziomy, jeśli chcesz bronić odrębności podskal.
Krok 8. Jak opisać bifactor i ESEM w artykule (APA)
Opis powinien pozwolić odtworzyć analizę. Podaj sekwencję modeli i jej uzasadnienie, estymator i sposób traktowania odpowiedzi, rotację z macierzą celu (jeśli ją stosujesz), dopasowanie w tabeli, zakresy ładunków, korelacje czynników w CFA i ESEM, wskaźniki bifactor z informacją, z którego modelu pochodzą, oraz decyzję o wyniku ogólnym i podskalach. Ogólne zasady raportowania modeli strukturalnych zbiera wpis wytyczne APA i JARS-Quant, a tabelę dopasowania – hasło tabela dopasowania modelu CFA w APA.
Jeśli recenzent kwestionuje wybór modelu, odpowiedź opieraj na tej samej logice: co zmienia każdy model w parametrach i jakie są tego konsekwencje dla wyników. Wzory takich odpowiedzi znajdziesz we wpisach o zarzutach recenzentów do statystyki i odpowiedziach recenzentom. Gdy analizujesz narzędzie w kilku grupach albo pomiarach, model wybrany w tym kroku staje się punktem wyjścia do badania inwariancji pomiaru. Marsh i in. (2014) podkreślają, że ESEM pozwala testować pełną inwariancję także w modelach z ładunkami krzyżowymi.
Bifactor i ESEM w R (lavaan)
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Przepis 0 tworzy plik model-bifactor-i-esem-dane.csv. Możesz go pominąć i pobrać gotowy plik do katalogu nadrzędnego względem katalogu roboczego, bo skrypty czytają ../model-bifactor-i-esem-dane.csv. Przepis 2 korzysta z obiektów utworzonych w przepisie 1, więc uruchom je w jednej sesji R. Szacowanie sześciu modeli trwa kilka sekund.
0. Symulacja danych
R
# Model bifactor i ESEM – przepis 0: symulacja danych (plik model-bifactor-i-esem-dane.csv)
# Dane symulowane: 800 dorosłych wypełniło 15-pozycyjny kwestionariusz lęku (odpowiedzi 1–5)
# i skalę upośledzenia funkcjonowania (funk). Podskale: objawy somatyczne (som1–som5),
# zamartwianie się (zam1–zam5), unikanie społeczne (unk1–unk5).
# Model populacyjny: czynnik ogólny G + trzy czynniki specyficzne (nieskorelowane)
# + cztery małe ładunki krzyżowe; funk zależy od G i od czynnika specyficznego unikania.
set.seed(87)
n <- 800
lg <- c(.55, .60, .50, .58, .52,  .62, .65, .60, .66, .58,  .45, .40, .50, .42, .48)  # czynnik ogólny
ls <- c(.45, .40, .50, .38, .42,  .25, .20, .30, .22, .28,  .50, .55, .45, .52, .40)  # czynniki specyficzne
L <- matrix(0, 15, 4)
L[, 1] <- lg
for (j in 1:3) L[(5 * j - 4):(5 * j), j + 1] <- ls[(5 * j - 4):(5 * j)]
L[cbind(c(3, 8, 12, 14), c(3, 4, 2, 3))] <- c(.20, .22, .18, .20)   # ładunki krzyżowe
F <- matrix(rnorm(n * 4), n)                                          # G, S_som, S_zam, S_unk
X <- F %*% t(L) + sapply(1 - rowSums(L^2), function(v) rnorm(n, 0, sqrt(v)))
progi <- c(-Inf, -1.2, -0.35, 0.45, 1.25, Inf)                        # odpowiedzi 1–5
dane <- as.data.frame(apply(X, 2, function(x) as.integer(cut(x, progi))))
names(dane) <- c(paste0("som", 1:5), paste0("zam", 1:5), paste0("unk", 1:5))
dane$funk <- round(20 + 6 * (0.45 * F[, 1] + 0.30 * F[, 4] + rnorm(n, 0, sqrt(1 - 0.45^2 - 0.30^2))))
dane$funk <- pmin(pmax(dane$funk, 0), 40)                             # skala 0–40
write.csv(dane, "../model-bifactor-i-esem-dane.csv", row.names = FALSE)

round(c(N = nrow(dane), M_funk = mean(dane$funk), SD_funk = sd(dane$funk)), 2)
table(unlist(dane[1:15]))   # rozkład odpowiedzi 1–5 we wszystkich pozycjach
Wynik w R
      N  M_funk SD_funk
 800.00   20.27    5.80

   1    2    3    4    5
1392 3088 3716 2557 1247
1. Sześć modeli: CFA, drugi rząd, bifactor, ESEM i bifactor-ESEM
R
# Model bifactor i ESEM – przepis 1: pięć modeli pomiarowych na tych samych danych
library(lavaan)
dane <- read.csv("../model-bifactor-i-esem-dane.csv")
poz <- names(dane)[1:15]
suma <- function(x) paste(x, collapse = " + ")
m_1f  <- paste("lek =~", suma(poz))
m_3f  <- paste("som =~", suma(poz[1:5]), "\n zam =~", suma(poz[6:10]), "\n unk =~", suma(poz[11:15]))
m_2rz <- paste(m_3f, "\n G =~ som + zam + unk")
m_bif <- paste(m_3f, "\n G =~", suma(poz))
m_esem <- paste('efa("e")*som + efa("e")*zam + efa("e")*unk =~', suma(poz))
m_besem <- paste('efa("b")*G + efa("b")*som + efa("b")*zam + efa("b")*unk =~', suma(poz))
cel <- matrix(0, 15, 4); cel[, 1] <- NA                       # macierz celu: NA = ładunek swobodny,
for (j in 1:3) cel[(5 * j - 4):(5 * j), j + 1] <- NA          # 0 = ładunek „docelowo” bliski zera

f_1f    <- cfa(m_1f,  data = dane, estimator = "MLR", std.lv = TRUE)
f_3f    <- cfa(m_3f,  data = dane, estimator = "MLR", std.lv = TRUE)
f_2rz   <- cfa(m_2rz, data = dane, estimator = "MLR", std.lv = TRUE)
f_bif   <- cfa(m_bif, data = dane, estimator = "MLR", std.lv = TRUE, orthogonal = TRUE)
f_esem  <- sem(m_esem, data = dane, estimator = "MLR", rotation = "geomin")
f_besem <- sem(m_besem, data = dane, estimator = "MLR", rotation = "target",
               rotation.args = list(target = cel, orthogonal = TRUE))

wsk <- c("npar", "chisq.scaled", "df", "cfi.robust", "tli.robust", "rmsea.robust", "srmr", "aic", "bic")
dop <- t(sapply(list(jeden = f_1f, trzy_CFA = f_3f, drugi_rzad = f_2rz, bifactor_CFA = f_bif,
                     ESEM = f_esem, bifactor_ESEM = f_besem), fitMeasures, wsk))
print(round(dop, 3))

# Korelacje czynników: CFA a ESEM
round(lavInspect(f_3f, "cor.lv"), 2)
round(lavInspect(f_esem, "cor.lv"), 2)

# Ładunki standaryzowane ESEM i bifactor-ESEM
round(lavInspect(f_esem, "std")$lambda, 2)
round(lavInspect(f_besem, "std")$lambda, 2)
lam_e <- lavInspect(f_esem, "std")$lambda
cel_e <- matrix(FALSE, 15, 3); for (j in 1:3) cel_e[(5 * j - 4):(5 * j), j] <- TRUE
round(c(krzyzowe_max = max(abs(lam_e[!cel_e])), krzyzowe_ponad_.20 = sum(abs(lam_e[!cel_e]) >= .20)), 2)

# Ładunki standaryzowane bifactor-CFA
round(lavInspect(f_bif, "std")$lambda, 2)

# Model trzech skorelowanych czynników i model drugiego rzędu: zakres ładunków, ładunki drugiego rzędu
lam_3 <- lavInspect(f_3f, "std")$lambda
round(t(sapply(colnames(lam_3), function(f) range(lam_3[lam_3[, f] != 0, f]))), 2)
round(lavInspect(f_2rz, "std")$beta[c("som", "zam", "unk"), "G"], 2)
Wynik w R
              npar chisq.scaled df cfi.robust tli.robust rmsea.robust  srmr      aic      bic
jeden           30      762.728 90      0.817      0.786        0.097 0.074 34612.39 34752.93
trzy_CFA        33      148.667 87      0.983      0.979        0.030 0.031 34000.12 34154.71
drugi_rzad      33      148.667 87      0.983      0.979        0.030 0.031 34000.12 34154.71
bifactor_CFA    45      129.006 75      0.985      0.980        0.030 0.028 34001.63 34212.43
ESEM            57       61.394 63      1.000      1.001        0.000 0.015 33958.30 34225.32
bifactor_ESEM   69       33.561 51      1.000      1.009        0.000 0.010 33952.55 34275.79
     som  zam  unk
som 1.00
zam 0.75 1.00
unk 0.55 0.66 1.00
     som  zam  unk
som 1.00
zam 0.68 1.00
unk 0.23 0.24 1.00
       som   zam   unk
som1  0.72 -0.03  0.10
som2  0.64  0.09 -0.05
som3  0.70  0.01 -0.01
som4  0.61  0.09  0.05
som5  0.63  0.08  0.00
zam1 -0.03  0.66 -0.01
zam2  0.04  0.58  0.05
zam3 -0.01  0.53  0.22
zam4  0.04  0.66 -0.03
zam5  0.08  0.57  0.00
unk1  0.03  0.24  0.44
unk2  0.24 -0.01  0.66
unk3  0.01  0.30  0.52
unk4 -0.03  0.31  0.54
unk5  0.00  0.31  0.47
        G   som   zam   unk
som1 0.54  0.48  0.00  0.08
som2 0.56  0.41  0.02 -0.09
som3 0.49  0.50  0.07  0.00
som4 0.59  0.37 -0.02 -0.02
som5 0.53  0.43  0.06 -0.02
zam1 0.57 -0.02  0.29 -0.07
zam2 0.58  0.01  0.22 -0.02
zam3 0.52  0.02  0.27  0.19
zam4 0.57  0.07  0.37 -0.04
zam5 0.53  0.10  0.33  0.00
unk1 0.53 -0.13 -0.16  0.28
unk2 0.43  0.13 -0.07  0.59
unk3 0.55 -0.10 -0.06  0.38
unk4 0.40  0.02  0.21  0.58
unk5 0.51 -0.07  0.00  0.36
      krzyzowe_max krzyzowe_ponad_.20
              0.31               6.00
      som   zam  unk    G
som1 0.47  0.00 0.00 0.54
som2 0.45  0.00 0.00 0.53
som3 0.49  0.00 0.00 0.50
som4 0.40  0.00 0.00 0.56
som5 0.43  0.00 0.00 0.53
zam1 0.00  0.37 0.00 0.56
zam2 0.00  0.19 0.00 0.60
zam3 0.00 -0.04 0.00 0.63
zam4 0.00  0.21 0.00 0.63
zam5 0.00  0.14 0.00 0.61
unk1 0.00  0.00 0.39 0.41
unk2 0.00  0.00 0.57 0.43
unk3 0.00  0.00 0.47 0.48
unk4 0.00  0.00 0.46 0.47
unk5 0.00  0.00 0.40 0.47
    [,1] [,2]
som 0.68 0.71
zam 0.61 0.66
unk 0.58 0.68
 som  zam  unk
0.79 0.95 0.69
2. Wskaźniki bifactor i trafność kryterialna
R
# Model bifactor i ESEM – przepis 2: wskaźniki modelu bifactor (omega H, ECV, PUC, H) i kryterium
# Wymaga obiektów z przepisu 1 (f_bif, f_besem, dane, poz).
lam_b <- lavInspect(f_bif, "std")$lambda
th_b  <- diag(lavInspect(f_bif, "std")$theta)
gr <- list(som = 1:5, zam = 6:10, unk = 11:15)
omegi <- function(lam, th) {
  G <- lam[, "G"]
  S <- lam[, c("som", "zam", "unk")]
  wsp <- sum(G)^2 + sum(colSums(S)^2)
  c(omega_ogolna = wsp / (wsp + sum(th)),
    omega_H = sum(G)^2 / (wsp + sum(th)),
    ECV = sum(G^2) / sum(lam^2),
    H_G = 1 / (1 + 1 / sum(G^2 / (1 - G^2))))
}
round(omegi(lam_b, th_b), 3)
podskale <- t(sapply(names(gr), function(s) {
  i <- gr[[s]]; G <- lam_b[i, "G"]; S <- lam_b[i, s]; e <- sum(th_b[i])
  c(omega_S = (sum(G)^2 + sum(S)^2) / (sum(G)^2 + sum(S)^2 + e),
    omega_HS = sum(S)^2 / (sum(G)^2 + sum(S)^2 + e),
    ECV_S = sum(S^2) / sum(G^2 + S^2),
    H_S = 1 / (1 + 1 / sum(S^2 / (1 - S^2))))
}))
round(podskale, 3)
# Jaką część rzetelnej wariancji wyniku ogólnego i podskal niesie czynnik ogólny / specyficzny?
round(c(omega_H_do_omega = unname(omegi(lam_b, th_b)["omega_H"] / omegi(lam_b, th_b)["omega_ogolna"]),
        podskale[, "omega_HS"] / podskale[, "omega_S"]), 3)
k <- 15; puc <- (k * (k - 1) / 2 - sum(sapply(gr, function(i) length(i) * (length(i) - 1) / 2))) / (k * (k - 1) / 2)
round(c(PUC = puc), 3)

# ECV w bifactor-ESEM (ładunki krzyżowe liczone do czynnika, który ładują)
lam_be <- lavInspect(f_besem, "std")$lambda
round(c(ECV_bifactor_ESEM = sum(lam_be[, "G"]^2) / sum(lam_be^2)), 3)

# Kontrola: rozwiązanie Schmida–Leimana z pakietu psych (eksploracyjne, korelacje Pearsona)
library(psych)
om <- omega(dane[poz], nfactors = 3, plot = FALSE)
round(c(omega_h_SL = om$omega_h, omega_tot_SL = om$omega.tot), 3)

# Kryterium: surowe sumy podskal a czynniki modelu bifactor
dane$s_som <- rowSums(dane[poz[1:5]]); dane$s_zam <- rowSums(dane[poz[6:10]]); dane$s_unk <- rowSums(dane[poz[11:15]])
round(cor(dane[c("s_som", "s_zam", "s_unk")], dane$funk), 2)
m_kr <- paste(m_bif, "\n funk ~ G + som + zam + unk")
f_kr <- sem(m_kr, data = dane, estimator = "MLR", std.lv = TRUE, orthogonal = TRUE)
st <- standardizedSolution(f_kr)
st[st$op == "~", c("lhs", "rhs", "est.std", "se", "pvalue", "ci.lower", "ci.upper")] |>
  transform(est.std = round(est.std, 2), se = round(se, 3), pvalue = round(pvalue, 4),
            ci.lower = round(ci.lower, 2), ci.upper = round(ci.upper, 2))
round(c(R2_funk = lavInspect(f_kr, "r2")[["funk"]]), 3)
Wynik w R
omega_ogolna      omega_H          ECV          H_G
       0.898        0.764        0.647        0.861
    omega_S omega_HS ECV_S   H_S
som   0.824    0.346 0.420 0.562
zam   0.773    0.059 0.114 0.208
unk   0.782    0.395 0.510 0.585
omega_H_do_omega              som              zam              unk
           0.851            0.419            0.077            0.506
  PUC
0.714
ECV_bifactor_ESEM
            0.613

  omega_h_SL omega_tot_SL
       0.687        0.899
      [,1]
s_som 0.36
s_zam 0.37
s_unk 0.47
    lhs rhs est.std    se pvalue ci.lower ci.upper
31 funk   G    0.42 0.041 0.0000     0.33     0.50
32 funk som    0.10 0.050 0.0363     0.01     0.20
33 funk zam    0.08 0.065 0.2109    -0.05     0.21
34 funk unk    0.33 0.047 0.0000     0.24     0.42
R2_funk
  0.298
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag New York. https://ggplot2.tidyverse.org
Najczęstsze błędy przy modelach bifactor i ESEM
- Wybór modelu bifactor tylko dlatego, że ma najlepsze CFI. Model z większą liczbą parametrów prawie zawsze lepiej odtwarza dane. Uzasadniaj wybór wzorem ładunków, wskaźnikami ωH i ECV, kryteriami informacyjnymi i teorią.
- Interpretowanie każdego czynnika specyficznego. Czynnik z ładunkami .19, −.04 i .14, jak zamartwianie w przykładzie, nie jest odrębnym wymiarem, tylko resztą po czynniku ogólnym. Eid i in. (2017) radzą w takiej sytuacji rozważyć model bifactor-(S−1).
- Raportowanie alfy albo omegi podskal bez ωHS. W przykładzie podskala zamartwiania ma ωS = .773, a jej czynnik specyficzny – ωHS = .059. Sama rzetelność sumy niczego nie mówi o odrębności podskali.
- Usuwanie pozycji z ładunkami krzyżowymi w ESEM. Wiele małych ładunków krzyżowych o tym samym kierunku często oznacza nieuwzględniony czynnik ogólny. Najpierw sprawdź bifactor-ESEM, a dopiero potem oceniaj pozycje.
- Porównywanie modelu drugiego rzędu z modelem skorelowanych czynników przy trzech podskalach. Te modele są wtedy równoważne. Identyczne χ² nie jest „potwierdzeniem” czynnika drugiego rzędu.
- Rotacja bez opisu. Wynik ESEM zależy od kryterium rotacji. Podaj je w tekście, a przy rotacji target dołącz macierz celu w materiałach uzupełniających.
- Za mała próba. Bifactor-ESEM z 15 pozycjami i czterema czynnikami ma w przykładzie 69 swobodnych parametrów. Przy kilkuset osobach rozwiązanie bywa niestabilne, a czynniki specyficzne łatwo „znikają”. Przy planowaniu badania pomoże wpis o analizie statystycznej w doktoracie.
- Zbyt ogólne wnioski z ECV i PUC. Wysoki ECV uzasadnia użycie wyniku ogólnego w modelu strukturalnym, ale nie oznacza, że podskale są bezużyteczne. Unikanie w przykładzie ma wyraźną trafność przyrostową.
Jeśli przygotowujesz artykuł walidacyjny albo rozdział doktoratu i chcesz, żeby ktoś sprawdził sekwencję modeli, policzył wskaźniki bifactor i pomógł przygotować odpowiedź na recenzję, zajrzyj do oferty analiz dla badaczy. Wyniki opiszesz samodzielnie, a my wyjaśnimy każdą decyzję tak, żebyś mógł ją obronić.
Najczęstsze pytania
Jak wybrać między CFA, ESEM i bifactor-ESEM?
Porównuj modele parami. Najpierw CFA z ESEM: jeśli ESEM wyraźnie obniża korelacje czynników przy mocnych ładunkach głównych, wyzerowane ładunki krzyżowe zniekształcały CFA. Potem ESEM z bifactor-ESEM: jeśli czynnik ogólny ma wyraźne ładunki na wszystkich pozycjach, a ładunki krzyżowe maleją, struktura ma składnik ogólny. Indeksy dopasowania traktuj jako tło, bo bardziej złożony model prawie zawsze dopasowuje się lepiej.
Co oznacza niska omega hierarchiczna podskali (ωHS)?
Niska ωHS oznacza, że po odjęciu czynnika ogólnego w sumie pozycji podskali zostaje mało rzetelnej wariancji specyficznej. Podskala może mieć wysoką alfę, a i tak mierzyć głównie to samo co wynik ogólny. W przykładzie podskala zamartwiania miała ωS = .773, ale ωHS = .059, więc nie warto jej interpretować jako odrębnego wymiaru.
Dlaczego w ESEM korelacje czynników są niższe niż w CFA?
W CFA pozycja może ładować tylko swój czynnik, więc jej związek z innym wymiarem musi przejść przez korelację czynników. ESEM szacuje ładunki krzyżowe i ta część wspólnej wariancji trafia do nich. Dlatego korelacje czynników w ESEM są zwykle niższe i bliższe prawdzie, jeśli ładunki krzyżowe naprawdę istnieją (Asparouhov i Muthén, 2009).
Jak ustawić macierz celu w rotacji target w lavaan?
Utwórz macierz o liczbie wierszy równej liczbie pozycji i liczbie kolumn równej liczbie czynników. W miejscach ładunków głównych wpisz NA, a w pozostałych 0. W bifactor-ESEM pierwsza kolumna (czynnik ogólny) ma same NA. Następnie podaj rotation = "target" i rotation.args = list(target = cel, orthogonal = TRUE). Zera nie są ograniczeniami, tylko celem rotacji, więc ładunki krzyżowe nadal są szacowane.
Czy przy wysokim ECV można używać tylko wyniku ogólnego?
Wysoki ECV i wysoki PUC wskazują, że model jednoczynnikowy da mało obciążone współczynniki strukturalne, więc wynik ogólny jest uzasadniony. Nie wynika z tego, że podskale są bezużyteczne. Sprawdź ωHS i trafność przyrostową czynników specyficznych: w przykładzie przy ECV = .647 specyficzne unikanie przewidywało upośledzenie funkcjonowania ponad czynnik ogólny (β = .33).
Powiązane hasła
Przeczytaj też
Modelowanie zmiennych i konstruktów wyższego rzędu
Jak odróżnić wspólny czynnik od kompozytu, wybrać typ modelu drugiego rzędu, zwalidować obie warstwy i poprawnie opisać wynik.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →Recenzent pyta o model bifactor albo ESEM?
Przeliczymy sekwencję modeli na twoich danych, policzymy ωH, ECV i trafność podskal oraz wyjaśnimy każdą decyzję tak, żebyś mógł ją opisać w artykule lub doktoracie i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Asparouhov, T., & Muthén, B. (2009). Exploratory structural equation modeling. Structural Equation Modeling: A Multidisciplinary Journal, 16(3), 397–438. https://doi.org/10.1080/10705510903008204
- Browne, M. W. (2001). An overview of analytic rotation in exploratory factor analysis. Multivariate Behavioral Research, 36(1), 111–150. https://doi.org/10.1207/s15327906mbr3601_05
- Chen, F. F., West, S., & Sousa, K. (2006). A comparison of bifactor and second-order models of quality of life. Multivariate Behavioral Research, 41(2), 189–225. https://doi.org/10.1207/s15327906mbr4102_5
- Eid, M., Geiser, C., Koch, T., & Heene, M. (2017). Anomalous results in G-factor models: Explanations and alternatives. Psychological Methods, 22(3), 541–562. https://doi.org/10.1037/met0000083
- Flora, D. B. (2020). Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates. Advances in Methods and Practices in Psychological Science, 3(4), 484–501. https://doi.org/10.1177/2515245920951747 ● Otwarty dostęp
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Jennrich, R. I., & Bentler, P. M. (2011). Exploratory bi-factor analysis. Psychometrika, 76(4), 537–549. https://doi.org/10.1007/s11336-011-9218-4 ● Otwarty dostęp: pełny tekst
- Marsh, H. W., Morin, A. J. S., Parker, P. D., & Kaur, G. (2014). Exploratory structural equation modeling: An integration of the best features of exploratory and confirmatory factor analysis. Annual Review of Clinical Psychology, 10(1), 85–110. https://doi.org/10.1146/annurev-clinpsy-032813-153700
- Morin, A. J. S., Arens, A. K., & Marsh, H. W. (2016). A bifactor exploratory structural equation modeling framework for the identification of distinct sources of construct-relevant psychometric multidimensionality. Structural Equation Modeling: A Multidisciplinary Journal, 23(1), 116–139. https://doi.org/10.1080/10705511.2014.961800
- Reise, S. P. (2012). The rediscovery of bifactor measurement models. Multivariate Behavioral Research, 47(5), 667–696. https://doi.org/10.1080/00273171.2012.715555 ● Otwarty dostęp
- Reise, S. P., Bonifay, W. E., & Haviland, M. G. (2013). Scoring and modeling psychological measures in the presence of multidimensionality. Journal of Personality Assessment, 95(2), 129–140. https://doi.org/10.1080/00223891.2012.725437
- Reise, S. P., Scheines, R., Widaman, K. F., & Haviland, M. G. (2013). Multidimensionality and structural coefficient bias in structural equation modeling: A bifactor perspective. Educational and Psychological Measurement, 73(1), 5–26. https://doi.org/10.1177/0013164412449831 ● Otwarty dostęp: pełny tekst
- Rindskopf, D., & Rose, T. (1988). Some theory and applications of confirmatory second-order factor analysis. Multivariate Behavioral Research, 23(1), 51–67. https://doi.org/10.1207/s15327906mbr2301_3
- Rodriguez, A., Reise, S. P., & Haviland, M. G. (2016). Evaluating bifactor models: Calculating and interpreting statistical indices. Psychological Methods, 21(2), 137–150. https://doi.org/10.1037/met0000045
Cytowania BibTeX
@article{asparouhov2009exploratory, author={Asparouhov, Tihomir and Muthén, Bengt}, title={{Exploratory structural equation modeling}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={3}, pages={397--438}, doi={10.1080/10705510903008204}}@article{browne2001overview, author={Browne, Michael W.}, title={{An overview of analytic rotation in exploratory factor analysis}}, journal={Multivariate Behavioral Research}, year={2001}, volume={36}, number={1}, pages={111--150}, doi={10.1207/s15327906mbr3601_05}}@article{chen2006comparison, author={Chen, Fang Fang and West, Stephen and Sousa, Karen}, title={{A comparison of bifactor and second-order models of quality of life}}, journal={Multivariate Behavioral Research}, year={2006}, volume={41}, number={2}, pages={189--225}, doi={10.1207/s15327906mbr4102_5}}@article{eid2017anomalous, author={Eid, Michael and Geiser, Christian and Koch, Tobias and Heene, Moritz}, title={{Anomalous results in G-factor models: Explanations and alternatives}}, journal={Psychological Methods}, year={2017}, volume={22}, number={3}, pages={541--562}, doi={10.1037/met0000083}}@article{flora2020your, author={Flora, David B.}, title={{Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={484--501}, doi={10.1177/2515245920951747}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{jennrich2011exploratory, author={Jennrich, Robert I. and Bentler, Peter M.}, title={{Exploratory bi-factor analysis}}, journal={Psychometrika}, year={2011}, volume={76}, number={4}, pages={537--549}, doi={10.1007/s11336-011-9218-4}}@article{marsh2014exploratory, author={Marsh, Herbert W. and Morin, Alexandre J. S. and Parker, Philip D. and Kaur, Gurvinder}, title={{Exploratory structural equation modeling: An integration of the best features of exploratory and confirmatory factor analysis}}, journal={Annual Review of Clinical Psychology}, year={2014}, volume={10}, number={1}, pages={85--110}, doi={10.1146/annurev-clinpsy-032813-153700}}@article{morin2016bifactor, author={Morin, Alexandre J. S. and Arens, A. Katrin and Marsh, Herbert W.}, title={{A bifactor exploratory structural equation modeling framework for the identification of distinct sources of construct-relevant psychometric multidimensionality}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2016}, volume={23}, number={1}, pages={116--139}, doi={10.1080/10705511.2014.961800}}@article{reise2012rediscovery, author={Reise, Steven P.}, title={{The rediscovery of bifactor measurement models}}, journal={Multivariate Behavioral Research}, year={2012}, volume={47}, number={5}, pages={667--696}, doi={10.1080/00273171.2012.715555}}@article{reise2013scoring, author={Reise, Steven P. and Bonifay, Wes E. and Haviland, Mark G.}, title={{Scoring and modeling psychological measures in the presence of multidimensionality}}, journal={Journal of Personality Assessment}, year={2013}, volume={95}, number={2}, pages={129--140}, doi={10.1080/00223891.2012.725437}}@article{reise2013multidimensionality, author={Reise, Steven P. and Scheines, Richard and Widaman, Keith F. and Haviland, Mark G.}, title={{Multidimensionality and structural coefficient bias in structural equation modeling: A bifactor perspective}}, journal={Educational and Psychological Measurement}, year={2013}, volume={73}, number={1}, pages={5--26}, doi={10.1177/0013164412449831}}@article{rindskopf1988some, author={Rindskopf, David and Rose, Tedd}, title={{Some theory and applications of confirmatory second-order factor analysis}}, journal={Multivariate Behavioral Research}, year={1988}, volume={23}, number={1}, pages={51--67}, doi={10.1207/s15327906mbr2301_3}}@article{rodriguez2016evaluating, author={Rodriguez, Anthony and Reise, Steven P. and Haviland, Mark G.}, title={{Evaluating bifactor models: Calculating and interpreting statistical indices}}, journal={Psychological Methods}, year={2016}, volume={21}, number={2}, pages={137--150}, doi={10.1037/met0000045}}