Co to jest test DeLonga?
Test DeLonga (ang. DeLong's test) porównuje pola pod dwiema krzywymi ROC (AUC), gdy oba wskaźniki zmierzono u tych samych osób. Tak jest, gdy pełną i skróconą wersję skali wypełnia ta sama próba. Obie krzywe mają wtedy wspólny wzorzec rozpoznań, więc ich AUC są skorelowane. DeLong i in. (1988) zaproponowali nieparametryczną metodę opartą na uogólnionych statystykach U. Szacuje ona wariancje obu AUC i ich kowariancję.
Jak to działa?
Statystyka testu to z = (AUC₁ − AUC₂) / SE różnicy. Wariancja różnicy to Var₁ + Var₂ − 2Cov. Im silniej skorelowane są wyniki obu narzędzi, tym większa kowariancja i tym węższy przedział ufności różnicy. Dla krzywych z dwóch niezależnych prób (np. ta sama skala u kobiet i mężczyzn) kowariancja wynosi zero i stosuje się wersję niesparowaną. W pakiecie pROC obie wersje daje funkcja roc.test() z argumentem paired (Robin i in., 2011).
Przykład
W symulowanych danych 240 osób (74 z rozpoznaniem depresji) wypełniło pełną i skróconą skalę objawów. Wyniki obu wersji korelowały na poziomie r = .78. Pełna skala miała AUC = .808, skrócona – .752. Test DeLonga dla krzywych skorelowanych dał różnicę .056, 95% CI [.011, .101], z = 2.45, p = .014. Ten sam test w wersji dla prób niezależnych, z pominiętą korelacją, dał p = .193.
Na rysunku
Przedział ufności pojedynczego AUC (DeLong i bootstrap) pokazuje wpis Krzywa ROC w obrazkach. Tu dane z przykładu i pytanie, które zadaje test DeLonga: czy dwa AUC zmierzone na tych samych osobach się różnią.
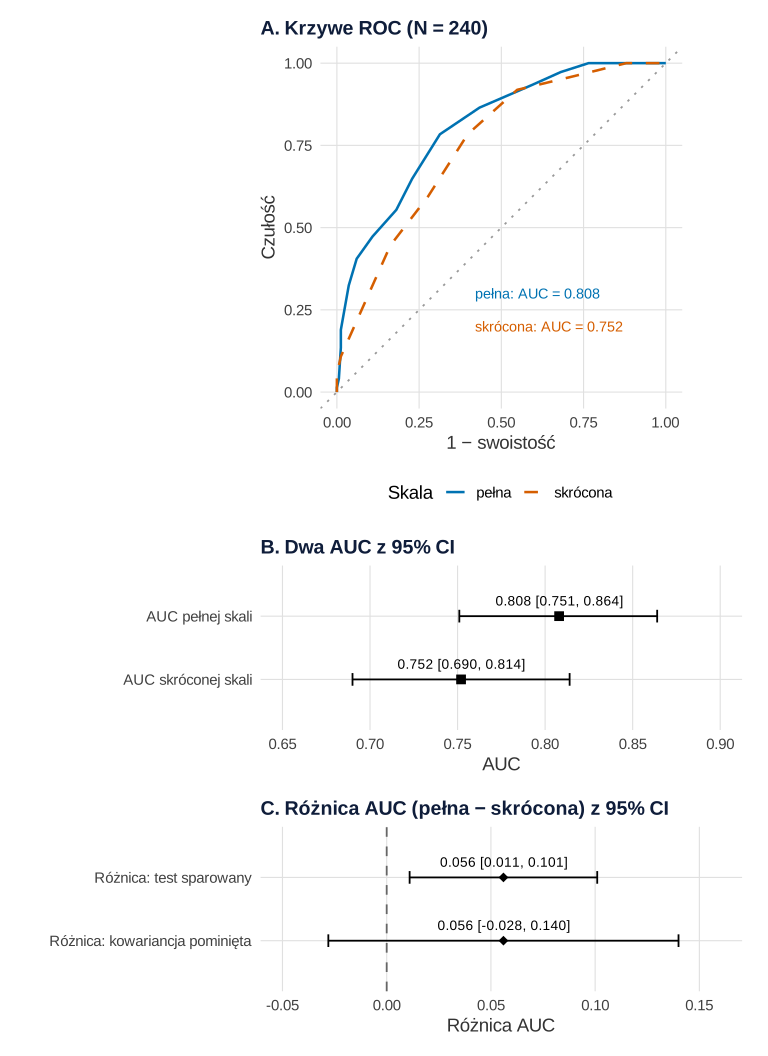
Co widać. W panelu A krzywa pełnej skali (niebieska, ciągła) leży nad krzywą skróconej (pomarańczowa, przerywana) przez większą część wykresu. W panelu B przedziały obu AUC w dużej części zachodzą na siebie. Panel C pokazuje, dlaczego mimo to różnica jest istotna. AUC obu wersji liczone na tych samych osobach są skorelowane (r = .72), więc błąd standardowy różnicy wynosi 0.023 zamiast 0.043. Przedział testu sparowanego [.011, .101] nie obejmuje zera. Ten sam przedział z pominiętą kowariancją [−.028, .140] obejmuje zero – to obraz błędu, który daje p = .193 zamiast .014.
Na co uważać. Panelu B nie da się użyć do porównania – to dwa osobne przedziały, a nie przedział różnicy. Rysunek nie pokazuje, przy jakich progach skale różnią się najbardziej: równe lub zbliżone AUC może ukrywać krzyżujące się krzywe, wtedy ważniejsze bywa częściowe pole pod krzywą. Korelacja wyników obu wersji (r = .78) wynika z ręcznie ustawionych parametrów symulacji, takich jak w przykładzie hasła. Przy słabszej korelacji kowariancja AUC jest mniejsza i zysk z testu sparowanego maleje.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tych samych obiektów pa, pb i pc z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Ziarno set.seed(3292) jest to samo co w kodzie hasła i nie było dobierane.
Kod R rysunku 1
# Rysunek 1. Dwie krzywe ROC na tych samych osobach (A), oba AUC z 95% CI (B) i różnica AUC z 95% CI (C)
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(pROC))

# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw); wersje skali rozróżnia też typ linii i kształt
kol <- c("pełna" = "#0072B2", "skrócona" = "#D55E00")
lin <- c("pełna" = "solid", "skrócona" = "dashed")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Dane z przykładu hasła: 240 osób, pełna i skrócona skala objawów
set.seed(3292)
n <- 240
depresja <- rbinom(n, 1, 0.3)                     # rozpoznanie w wywiadzie klinicznym
cecha <- rnorm(n) + 1.3 * depresja                # nasilenie objawów
dluga <- round(10 + 3 * (cecha + rnorm(n, sd = 0.4)))   # pełna skala, 12 pozycji
krotka <- round(5 + 1.5 * (cecha + rnorm(n, sd = 0.9))) # wersja skrócona, 4 pozycje
r_dl <- roc(depresja, dluga, quiet = TRUE)
r_kr <- roc(depresja, krotka, quiet = TRUE)

# Wariancje i kowariancja AUC metodą DeLonga
v_dl <- var(r_dl); v_kr <- var(r_kr); kow <- cov(r_dl, r_kr)
roznica <- as.numeric(auc(r_dl) - auc(r_kr))
se_spar <- sqrt(v_dl + v_kr - 2 * kow)            # te same osoby: odejmujemy kowariancję
se_niez <- sqrt(v_dl + v_kr)                      # pominięta kowariancja
z <- qnorm(0.975)
round(c(kor_AUC = kow / sqrt(v_dl * v_kr), SE_sparowany = se_spar, SE_bez_kowariancji = se_niez), 4)
przedzialy <- data.frame(
  co = c("AUC pełnej skali", "AUC skróconej skali", "Różnica: test sparowany", "Różnica: kowariancja pominięta"),
  panel = rep(c("AUC", "roznica"), each = 2),
  est = c(auc(r_dl), auc(r_kr), roznica, roznica),
  se = sqrt(c(v_dl, v_kr, se_spar^2, se_niez^2)))
przedzialy$dolna <- przedzialy$est - z * przedzialy$se
przedzialy$gorna <- przedzialy$est + z * przedzialy$se
przedzialy[, 3:6] <- round(przedzialy[, 3:6], 3)
przedzialy

krzywe <- rbind(
  data.frame(fpr = 1 - r_dl$specificities, czulosc = r_dl$sensitivities, skala = "pełna"),
  data.frame(fpr = 1 - r_kr$specificities, czulosc = r_kr$sensitivities, skala = "skrócona"))
krzywe <- krzywe[order(krzywe$skala, krzywe$fpr, krzywe$czulosc), ]
etyk <- data.frame(skala = c("pełna", "skrócona"), fpr = 0.42, czulosc = c(0.30, 0.20),
                   tekst = sprintf("%s: AUC = %.3f", c("pełna", "skrócona"), przedzialy$est[1:2]))
pa <- ggplot(krzywe, aes(fpr, czulosc, colour = skala, linetype = skala)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60", linetype = "dotted") +
  geom_path(linewidth = 0.9) +
  geom_text(data = etyk, aes(label = tekst), hjust = 0, size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = kol, name = "Skala") +
  scale_linetype_manual(values = lin, name = "Skala") +
  coord_equal() +
  labs(title = "A. Krzywe ROC (N = 240)", x = "1 − swoistość", y = "Czułość") + motyw

przedzialy$co <- factor(przedzialy$co, rev(przedzialy$co))
pb <- ggplot(przedzialy[przedzialy$panel == "AUC", ], aes(est, co)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y") +
  geom_point(size = 3, shape = 15) +
  geom_text(aes(label = sprintf("%.3f [%.3f, %.3f]", est, dolna, gorna)), vjust = -1.1, size = 3.6) +
  scale_x_continuous(limits = c(0.65, 0.90)) +
  scale_y_discrete(expand = expansion(add = 0.8)) +
  labs(title = "B. Dwa AUC z 95% CI", x = "AUC", y = NULL) + motyw

pc <- ggplot(przedzialy[przedzialy$panel == "roznica", ], aes(est, co)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y") +
  geom_point(size = 3, shape = 18) +
  geom_text(aes(label = sprintf("%.3f [%.3f, %.3f]", est, dolna, gorna)), vjust = -1.1, size = 3.6) +
  scale_x_continuous(limits = c(-0.05, 0.16)) +
  scale_y_discrete(expand = expansion(add = 0.8)) +
  labs(title = "C. Różnica AUC (pełna − skrócona) z 95% CI", x = "Różnica AUC", y = NULL) + motyw

p1 <- pa / pb / pc + plot_layout(heights = c(2.2, 1, 1))
p1   # zapis: ggsave("test-delonga-krzywe.svg", p1, width = 8, height = 11)
Wynik w R
           kor_AUC       SE_sparowany SE_bez_kowariancji
            0.7202             0.0228             0.0428
                              co   panel   est    se  dolna gorna
1               AUC pełnej skali     AUC 0.808 0.029  0.751 0.864
2            AUC skróconej skali     AUC 0.752 0.032  0.690 0.814
3        Różnica: test sparowany roznica 0.056 0.023  0.011 0.101
4 Różnica: kowariancja pominięta roznica 0.056 0.043 -0.028 0.140
Jak opisać w pracy
Na co uważać
- Nie porównuj AUC „na oko”. Nakładające się przedziały ufności dwóch AUC nie oznaczają braku różnicy. W przykładzie zachodzą na siebie (.751–.864 i .690–.814), a różnica jest istotna.
- Wersja niesparowana dla danych sparowanych traci moc. pROC ostrzega wtedy, że krzywe wyglądają na sparowane.
- AUC to nie wszystko. Równe AUC nie oznacza takiej samej czułości i swoistości w wybranym punkcie odcięcia. Przy modelach predykcyjnych oceń też kalibrację.
Cały przebieg analizy, od AUC po wybór punktu odcięcia, pokazuje wpis Krzywa ROC i punkt odcięcia skali krok po kroku. Porównywanie modeli na nowych danych opisuje poradnik o walidacji modeli predykcyjnych.
Test DeLonga w R
Kod tworzy dane z przykładu, liczy dwie krzywe ROC w pakiecie pROC i porównuje ich AUC testem DeLonga w wersji sparowanej i niesparowanej.
Pełna a skrócona skala: dwa skorelowane AUC
R
suppressPackageStartupMessages(library(pROC))
set.seed(3292)
n <- 240
depresja <- rbinom(n, 1, 0.3)                     # rozpoznanie w wywiadzie klinicznym
cecha <- rnorm(n) + 1.3 * depresja                # nasilenie objawów
dluga <- round(10 + 3 * (cecha + rnorm(n, sd = 0.4)))   # pełna skala, 12 pozycji
krotka <- round(5 + 1.5 * (cecha + rnorm(n, sd = 0.9))) # wersja skrócona, 4 pozycje
r_dl <- roc(depresja, dluga, quiet = TRUE)
r_kr <- roc(depresja, krotka, quiet = TRUE)
round(c(AUC_dluga = auc(r_dl), AUC_krotka = auc(r_kr), r = cor(dluga, krotka)), 3)
roc.test(r_dl, r_kr, method = "delong", paired = TRUE)   # te same osoby
roc.test(r_dl, r_kr, method = "delong", paired = FALSE)  # błąd: pominięta korelacja
Wynik w R
 AUC_dluga AUC_krotka          r
     0.808      0.752      0.775

	DeLong's test for two correlated ROC curves

data:  r_dl and r_kr
Z = 2.4516, p-value = 0.01422
alternative hypothesis: true difference in AUC is not equal to 0
95 percent confidence interval:
 0.01120753 0.10056388
sample estimates:
AUC of roc1 AUC of roc2
  0.8076359   0.7517502


	DeLong's test for two ROC curves

data:  r_dl and r_kr
D = 1.3045, df = 473.64, p-value = 0.1927
alternative hypothesis: true difference in AUC is not equal to 0
sample estimates:
AUC of roc1 AUC of roc2
  0.8076359   0.7517502

Warning message:
In roc.test.roc(r_dl, r_kr, method = "delong", paired = FALSE) :
  The ROC curves seem to be paired. Consider performing a paired roc.test.
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet pROC). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy użyć testu DeLonga w wersji sparowanej?
Gdy oba wskaźniki, np. dwie skale albo dwa modele, oceniono u tych samych osób. W pROC ustaw roc.test(..., paired = TRUE). Wersję niesparowaną stosuj tylko dla dwóch niezależnych prób.
Czy test DeLonga nadaje się do porównania dwóch modeli regresji logistycznej?
Tak, jeśli porównujesz AUC przewidywań obu modeli na tych samych osobach. Licz AUC na danych niewykorzystanych do dopasowania, bo w próbie uczącej bardziej złożony model jest faworyzowany.
Co oznacza ostrzeżenie pROC, że krzywe wyglądają na sparowane?
Funkcja roc.test() wykryła, że obie krzywe pochodzą z tych samych obserwacji, a wybrano test dla prób niezależnych. Taki test pomija kowariancję AUC i zwykle ma mniejszą moc.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Porównanie skal Braden i Norton
Korelacja to nie zgodność: tabela krzyżowa, kappa i kappa ważona, McNemar i Bowker, czułość, swoistość i AUC z testem DeLonga – z przykładem w R i wzorem opisu.
Czytaj →PoradnikLiczebność w badaniu diagnostycznym
Czułość i swoistość przy danym rozpowszechnieniu, dwa testy u tych samych osób, AUC i częściowa weryfikacja – wzory sprawdzone symulacją w R.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikModele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikCSAT, CES czy NPS – który przewiduje odejście
8000 kontaktów z obsługą światłowodu: krzywe ROC, test DeLonga, kalibracja i przyrost AUC trzech wskaźników – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77 ● Otwarty dostęp
Cytowania BibTeX
@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{robin2011proc, author={Robin, Xavier and Turck, Natacha and Hainard, Alexandre and Tiberti, Natalia and Lisacek, Frédérique and Sanchez, Jean-Charles and Müller, Markus}, title={{pROC: An open-source package for R and S+ to analyze and compare ROC curves}}, journal={BMC Bioinformatics}, year={2011}, volume={12}, number={1}, eid={77}, doi={10.1186/1471-2105-12-77}}