Dwa rozkłady, jeden próg, jedna krzywa
Krzywa ROC zwykle pojawia się w pracy jako gotowy obrazek z programu: niebieska linia, przekątna i liczba AUC. Ten wpis rozkłada ją na części. Zaczynamy od dwóch rozkładów wyników – osób z rozpoznaniem i bez – i przesuwamy po nich próg. Każde położenie progu daje jedną parę liczb, każda para to jeden punkt, a punkty składają się w krzywą. Potem sprawdzamy na liczbach, dlaczego pole pod krzywą to po prostu odsetek wygranych par, skąd bierze się kształt krzywej i dlaczego „najlepszy” próg zależy od kosztów błędów.
Pełną procedurę analizy (tabela progów, przedziały dla czułości i swoistości, test DeLonga, opis w pracy) znajdziesz we wpisie krzywa ROC i punkt odcięcia krok po kroku, a okna programu – w poradniku krzywa ROC w SPSS. Tu zajmujemy się wyłącznie obrazem.
Przykład jest fikcyjny: 250 osób wypełniło skalę przesiewową, a niezależna diagnoza kliniczna rozpoznała zaburzenie u 100 z nich. Wyniki wylosowaliśmy w R z rozkładów normalnych o średnich 62 i 50 punktów i SD = 10. Parametry ustawiliśmy ręcznie tak, by rozkłady wyraźnie na siebie zachodziły, a skala mimo to dobrze rozróżniała grupy. Ziarna 583 nie zmienialiśmy. W próbie osoby z rozpoznaniem miały średnio M = 63.77 pkt (SD = 10.90), a osoby bez rozpoznania M = 48.55 pkt (SD = 11.31). Dane pobierzesz jako plik CSV (link w sekcji z kodem).
Rysunek 1: dwa rozkłady i ruchomy próg
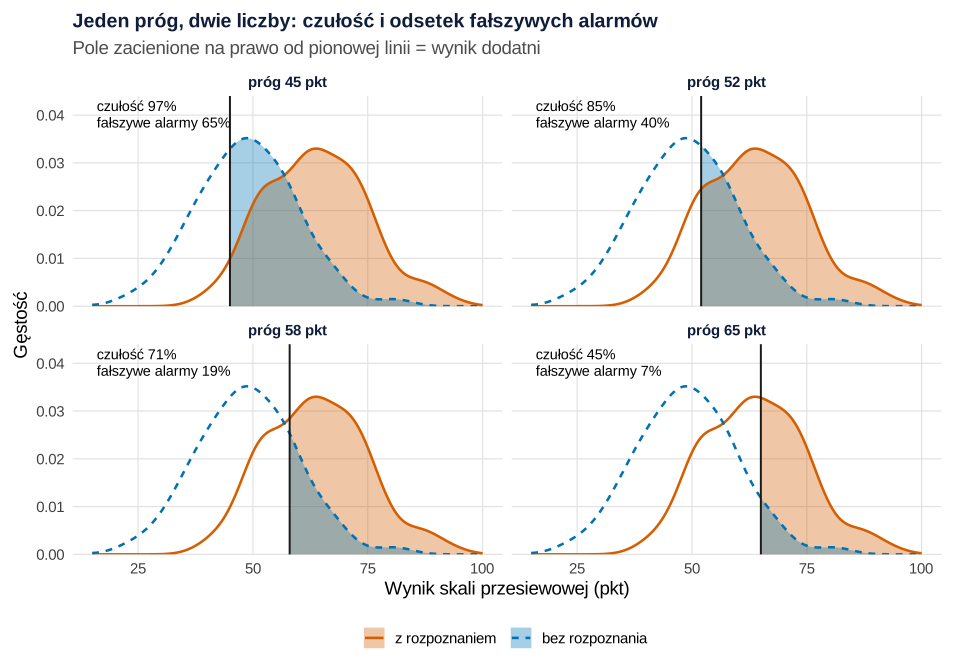
set.seed(583)).Co widać. Ciągła linia to rozkład wyników osób z rozpoznaniem, przerywana – osób bez rozpoznania. Pionowa linia to próg: wynik równy progowi lub wyższy uznajemy za dodatni. Zacienione pole pod ciągłą linią na prawo od progu to czułość (odsetek osób z rozpoznaniem wykrytych przez skalę). Pole pod linią przerywaną na prawo od progu to odsetek fałszywych alarmów, czyli 1 − swoistość. Przesuwając próg w prawo, zmniejszasz oba pola naraz. Z liczb wygląda to tak:
| Wynik dodatni od | TP / FN | FP / TN | Czułość | Swoistość | 1 − swoistość |
|---|---|---|---|---|---|
| 45 pkt | 97 / 3 | 97 / 53 | 97.0% | 35.3% | 64.7% |
| 52 pkt | 85 / 15 | 60 / 90 | 85.0% | 60.0% | 40.0% |
| 58 pkt | 71 / 29 | 29 / 121 | 71.0% | 80.7% | 19.3% |
| 65 pkt | 45 / 55 | 11 / 139 | 45.0% | 92.7% | 7.3% |
Czego ten wykres nie pokazuje. Krzywe to wygładzone gęstości, a liczby w tabeli pochodzą z samych danych. Wykres nie mówi też nic o tym, jak często zaburzenie występuje w populacji: obie krzywe mają pole równe 1, choć grupy liczą 100 i 150 osób. Dlatego z rysunku nie odczytasz wartości predykcyjnych – te zależą od częstości zaburzenia. Pełny zestaw miar z tabeli 2 × 2 opisuje hasło macierz pomyłek.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: każdy próg to punkt na krzywej
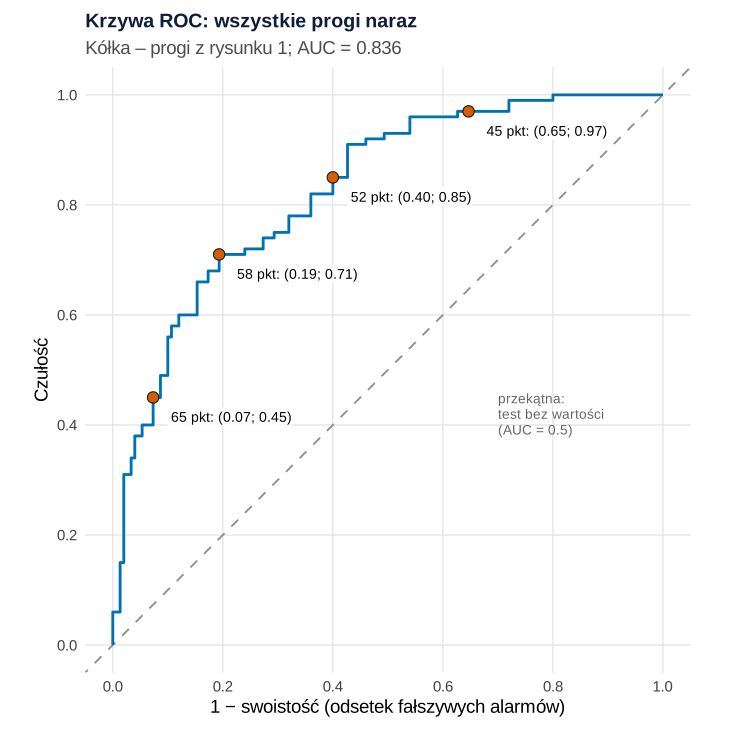
Co widać. Cztery progi z rysunku 1 zamieniły się w cztery kółka o współrzędnych (1 − swoistość; czułość). Krzywa łączy wszystkie progi, jakie dają dane – tu 62 punkty, od lewego dolnego rogu (próg wyższy od każdego wyniku: nikt nie jest dodatni) do prawego górnego (próg niższy od każdego wyniku: wszyscy są dodatni). Obniżanie punktu odcięcia przesuwa nas po krzywej w prawo i w górę. Pole pod krzywą wynosi AUC = .836. Przekątna to skala, która nie rozróżnia grup: czułość rośnie dokładnie tak samo jak odsetek fałszywych alarmów.
Jak może zmylić. Na krzywej nie widać samych progów. Punkt (0.19; 0.71) jest wartościowy dopiero wtedy, gdy wiesz, że odpowiada wynikowi 58 pkt – dlatego warto podpisać kilka progów bezpośrednio na wykresie. Schodki są cechą małej próby: każdy krok w górę to jedna lub kilka osób z rozpoznaniem, każdy krok w prawo – osoby bez rozpoznania. Wygładzona, „ładna” krzywa z programu zwykle pochodzi z modelu, a nie z danych.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: AUC to odsetek wygranych par
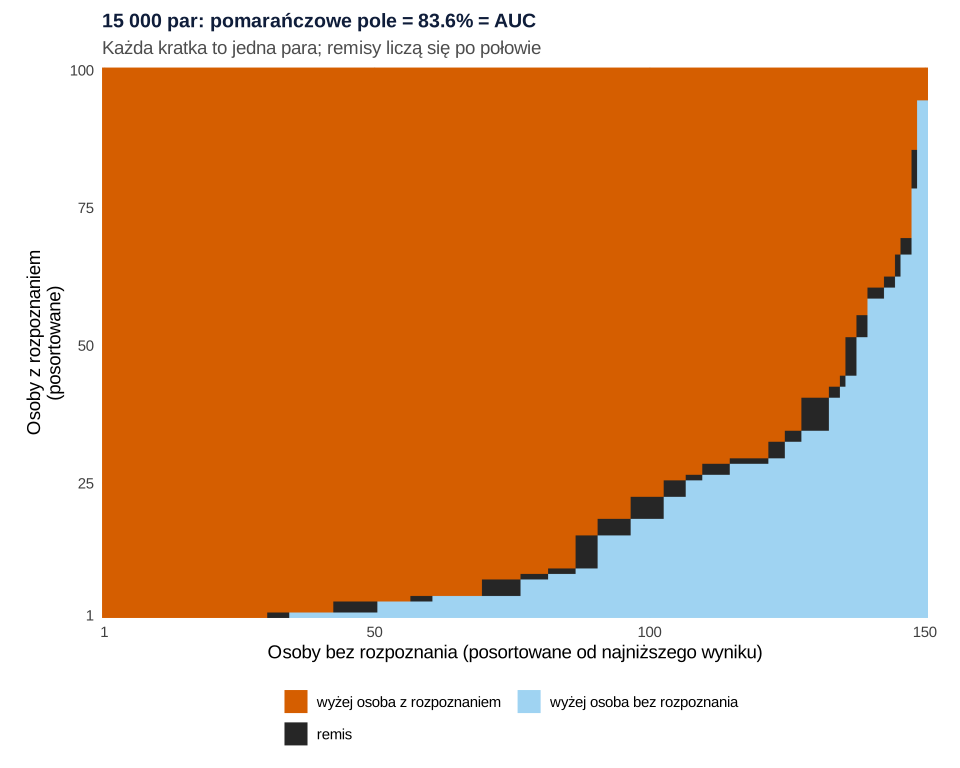
Co widać. Każda kratka to jedna para: osoba z rozpoznaniem (oś pionowa) kontra osoba bez rozpoznania (oś pozioma), obie grupy posortowane od najniższego wyniku. Par jest 100 × 150 = 15 000. Osoba z rozpoznaniem miała wyższy wynik w 12 420 parach (pole pomarańczowe), niższy w 2327 (pole jasnoniebieskie), a w 253 parach był remis (czarne prostokąty). Odsetek wygranych, z remisami liczonymi po połowie, to (12 420 + 253/2) / 15 000 = .836 – dokładnie AUC z rysunku 2. Hanley i McNeil (1982) opisali tę zależność wprost: pole pod krzywą ROC to prawdopodobieństwo, że losowo wybrana osoba chora uzyska wynik bardziej „podejrzany” niż losowo wybrana osoba zdrowa, i ta sama wielkość, którą szacuje statystyka Wilcoxona. Granica między pomarańczowym a niebieskim polem to zresztą ta sama krzywa ROC, tylko obrócona o 180°.
Stąd prosty związek z testem U Manna–Whitneya. Funkcja wilcox.test() w R zwraca W = 12 546.5, czyli liczbę wygranych par z remisami po połowie; podzielona przez 15 000 daje znowu .8364. AUC jest więc wielkością efektu dla testu U – tym samym prawdopodobieństwem przewagi, które opisują wpisy wielkość efektu w testach nieparametrycznych i test U Manna–Whitneya w obrazkach.
Czego ten wykres nie pokazuje. Progu. AUC uśrednia wszystkie progi naraz, także te, których nikt nie użyje. Dwie skale o tym samym AUC mogą mieć zupełnie różną czułość przy wysokiej swoistości – jeśli liczy się tylko fragment krzywej, rozważ częściowe pole pod krzywą (pAUC). Istotny wynik testu U (p < .001) mówi tylko, że AUC różni się od .50, a nie że skala nadaje się do diagnozy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: nakładanie się rozkładów a kształt krzywej
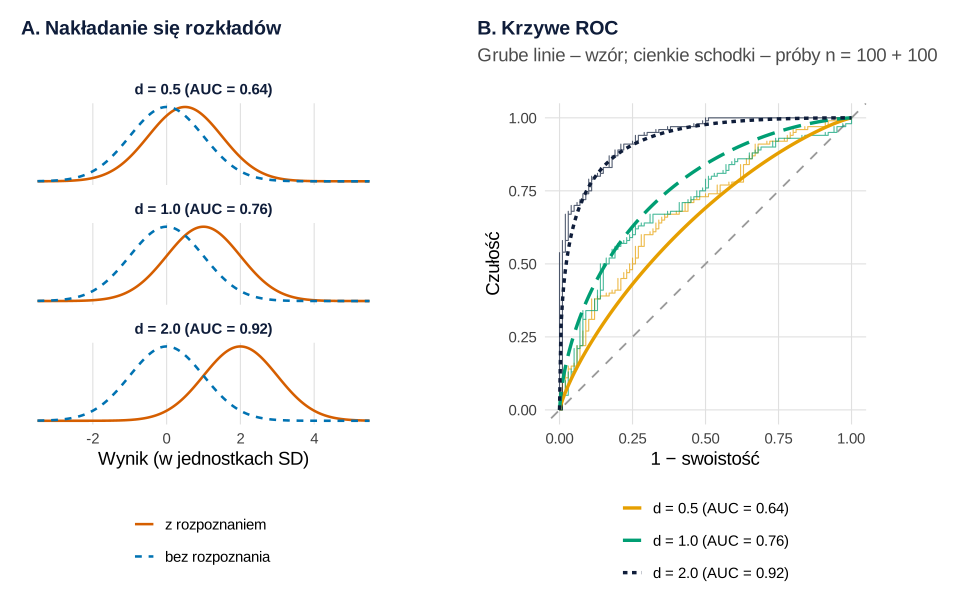
set.seed(583)).Co widać. Panel A pokazuje trzy pary rozkładów normalnych o tym samym SD, przesunięte o d = 0.5, 1 i 2 odchylenia standardowe. Panel B – odpowiadające im krzywe ROC. Im mniej rozkłady na siebie zachodzą, tym bardziej krzywa wybrzusza się ku lewemu górnemu rogowi. W tym modelu AUC zależy tylko od d: AUC = Φ(d/√2), czyli .638, .760 i .921. Te same liczby jako „prawdopodobieństwo przewagi” znajdziesz we wpisie wielkość efektu w obrazkach. Nasza skala z rysunków 1–3 (AUC = .836) leży między krzywymi dla d = 1 i d = 2.
Jak może zmylić. Cienkie schodki to krzywe z prób po 100 osób w grupie. Dla d = 0.5 próba dała AUC = .694 zamiast .638, a dla d = 1 – .717 zamiast .760; dla d = 0.5 i 1 schodki chwilami zamieniają się kolejnością. Przy takich liczebnościach dwie skale o „prawdziwej” różnicy AUC rzędu .1 mogą w próbie wypaść odwrotnie. Wzór zakłada też równe SD w obu grupach – gdy SD się różnią, krzywa przestaje być symetryczna i może przeciąć przekątną.
Podpis do pracy:
Zdanie do Metody (gdy uzasadniasz oczekiwane AUC):
Rysunek 5: indeks Youdena i koszty błędów
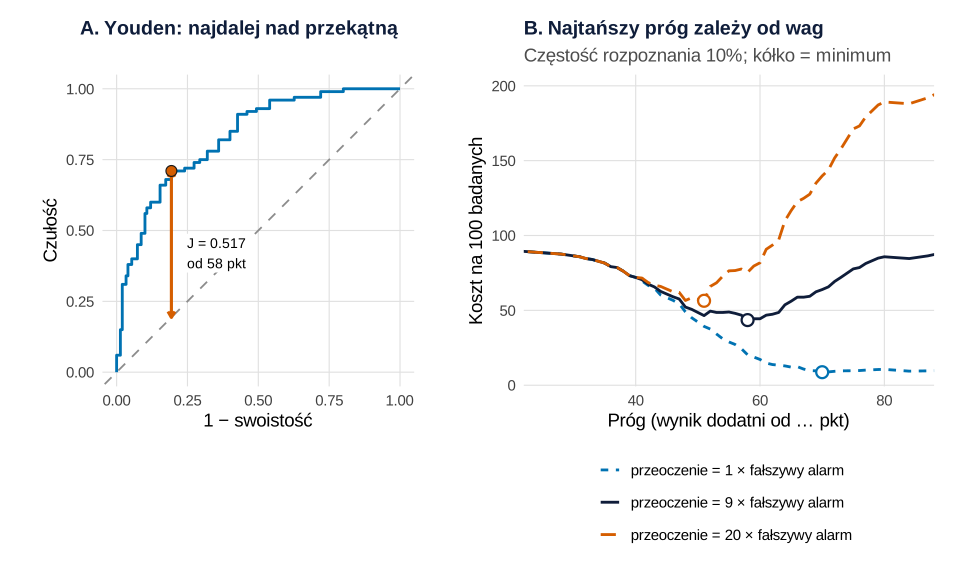
Co widać. Panel A: indeks Youdena J = czułość + swoistość − 1 to pionowa odległość punktu krzywej od przekątnej. Największa jest przy progu 58 pkt: czułość 71.0%, swoistość 80.7%, J = .517. Fluss i in. (2005) opisują J jako często stosowane podsumowanie krzywej ROC, które jednocześnie wskazuje punkt odcięcia. Panel B pokazuje, co J zakłada. Policzyliśmy oczekiwany koszt błędów na 100 badanych przy częstości zaburzenia 10%, przyjmując koszt fałszywego alarmu za 1. Gdy przeoczenie kosztuje tyle samo co fałszywy alarm, najtańszy jest próg 70 pkt (czułość tylko 31.0%). Gdy kosztuje 20 razy więcej – próg 51 pkt (czułość 91.0%, swoistość 57.3%). Próg Youdena wychodzi dokładnie przy wadze 9, czyli wtedy, gdy przeoczenie jest tyle razy droższe, ile razy więcej jest w populacji osób zdrowych niż chorych (90 : 10).
Jak może zmylić. Youden nie jest „neutralny” – przyjmuje konkretną relację kosztów i częstości, zwykle nigdzie niezapisaną. W badaniu przesiewowym, gdzie przeoczenie jest poważniejsze niż dodatkowa wizyta, rozsądny próg leży niżej. Różne kryteria „optymalności” potrafią też wskazać różne progi przy tej samej krzywej (Perkins i Schisterman, 2006). Do tego próg wybrany na tych samych danych daje zbyt optymistyczną czułość i swoistość, zwłaszcza w małych próbach (Leeflang i in., 2008). W symulacjach Flussa i in. (2005) najczęściej używana, empiryczna metoda szacowania J (ta z panelu A) wypadła ogólnie najgorzej. Wagi kosztów w panelu B są przykładowe – w pracy uzasadnij je merytorycznie.
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: przedział ufności dla AUC
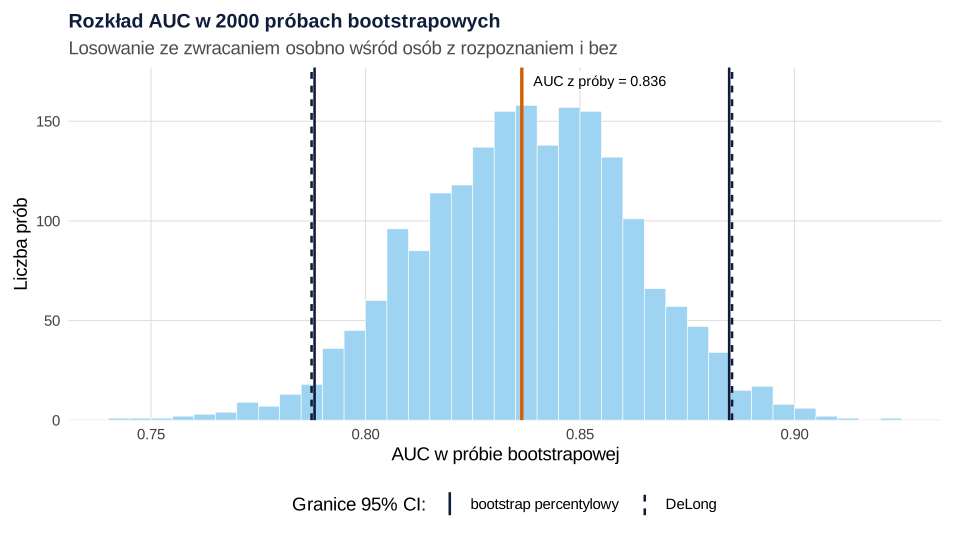
set.seed(583)).Co widać. Histogram 2000 wartości AUC z prób bootstrapowych. Każda próba powstała przez losowanie ze zwracaniem 100 osób z rozpoznaniem i 150 bez rozpoznania (osobno w grupach, żeby proporcje grup się nie zmieniały). Środkowe 95% wartości wyznacza przedział percentylowy [.788, .885]; błąd standardowy AUC to .025. Linie przerywane to przedział [.787, .885] policzony metodą DeLonga i in. (1988), nieparametryczną, opartą na statystykach U i opracowaną pierwotnie do porównywania pól pod skorelowanymi krzywymi (test DeLonga). Oba przedziały prawie się pokrywają, a funkcja ci.auc() z pakietu pROC (Robin i in., 2011) daje przy bootstrapie [.786, .882] – nieco inne granice, bo losuje inne próby.
Czego ten wykres nie pokazuje. Przedział dotyczy AUC, a nie czułości i swoistości przy wybranym progu – te potrzebują własnych przedziałów. Bootstrap też nie naprawi próby: jeśli osoby z rozpoznaniem pochodzą z kliniki, a bez rozpoznania – z populacji ogólnej, AUC będzie zawyżone niezależnie od szerokości przedziału. Co znaczy „95%” w przedziale ufności, pokazuje wpis przedział ufności w obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Co z tych rysunków przenieść do pracy
- W Wynikach: krzywa ROC z podpisanymi 2–4 progami (rysunek 2) i tabela progów z czułością i swoistością. AUC podaj z przedziałem ufności i metodą jego wyznaczenia.
- Gdy uzasadniasz próg: rysunek 1 albo panel B rysunku 5 – pokazują cenę każdego przesunięcia progu. Napisz, jaką relację kosztów przyjmujesz.
- Gdy recenzent pyta, „co znaczy AUC = .84”: jedno zdanie o parach (rysunek 3) wystarcza; samego rysunku par zwykle nie trzeba drukować.
- Gdy wynik pochodzi z modelu (np. przewidywane prawdopodobieństwo z regresji logistycznej), krzywą buduje się tak samo – patrz regresja logistyczna w obrazkach. AUC jest wtedy jednym z dowodów trafności kryterialnej, ale nie mówi nic o kalibracji.
- Ogólne zasady rysunków (rozmiar, czcionki, eksport) – we wpisie wykresy w pracy dyplomowej.
Kod R wszystkich rysunków i liczb
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje motyw, paletę i dane, z których korzystają następne. Każdy przepis tworzy obiekt wykresu (p1–p6); wpisz jego nazwę, żeby go wyświetlić, a do zapisu użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG.
Dane są fikcyjne. Średnie (62 i 50 pkt), SD = 10 i liczebności grup (100 i 150) ustaliliśmy ręcznie, tak by rozkłady wyraźnie zachodziły na siebie, a AUC było wysokie; cztery progi na rysunku 1 też wybraliśmy ręcznie. Każdy blok, który losuje (przepisy 1, 4 i 6), zaczyna od set.seed(583); ziarno ustaliliśmy raz i go nie zmienialiśmy. Bootstrap w przepisie 6 ma 2000 powtórzeń. Te same 250 obserwacji pobierzesz jako plik krzywa-roc-wyniki-przesiewowe.csv (kolumny grupa, wynik i chory: 1 – rozpoznanie, 0 – brak).
1. Motyw, paleta, dane i dwa rozkłady z progami: Rysunek 1
R
# Rysunek 1. Dwa rozkłady wyników (z rozpoznaniem / bez rozpoznania) i próg w czterech miejscach
options(width = 100)
library(ggplot2)

# Krótki motyw i paleta Okabe–Ito (sprawdzona w symulacji deuteranopii; kolor wspiera rodzaj linii)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kol <- c("z rozpoznaniem" = "#D55E00", "bez rozpoznania" = "#0072B2")
lin <- c("z rozpoznaniem" = "solid", "bez rozpoznania" = "22")

# Dane fikcyjne: wynik skali przesiewowej (punkty) u 100 osób z rozpoznaniem i 150 bez rozpoznania
set.seed(583)                                   # ziarno ustalone raz, bez dobierania pod wynik
n_chorzy <- 100; n_zdrowi <- 150
dane <- data.frame(
  grupa = factor(rep(c("z rozpoznaniem", "bez rozpoznania"), c(n_chorzy, n_zdrowi)), levels = names(kol)),
  wynik = round(c(rnorm(n_chorzy, mean = 62, sd = 10),     # parametry ustawione ręcznie: d = 1.2
                  rnorm(n_zdrowi, mean = 50, sd = 10))))
dane$chory <- as.integer(dane$grupa == "z rozpoznaniem")
# write.csv(dane, "krzywa-roc-wyniki-przesiewowe.csv", row.names = FALSE)   # te same dane co w pliku CSV
aggregate(wynik ~ grupa, dane, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))

# Cztery progi: wynik dodatni, gdy wynik >= próg
progi <- c(45, 52, 58, 65)
tabela <- t(sapply(progi, function(p) {
  ch <- dane$wynik[dane$chory == 1]; zd <- dane$wynik[dane$chory == 0]
  c(prog = p, TP = sum(ch >= p), FN = sum(ch < p), FP = sum(zd >= p), TN = sum(zd < p),
    czulosc = mean(ch >= p), swoistosc = mean(zd < p))
}))
tabela <- as.data.frame(tabela)
tabela$fpr <- 1 - tabela$swoistosc               # 1 − swoistość = odsetek fałszywych alarmów
cbind(tabela[, 1:5], round(tabela[, 6:8], 3))

# Gęstości jądrowe obu grup na wspólnej siatce; pole na prawo od progu = wynik dodatni
siatka <- seq(15, 100, by = 0.5)
gest <- do.call(rbind, lapply(levels(dane$grupa), function(g) {
  dd <- density(dane$wynik[dane$grupa == g], from = min(siatka), to = max(siatka), n = length(siatka))
  data.frame(grupa = g, x = dd$x, y = dd$y)
}))
gest$grupa <- factor(gest$grupa, levels = names(kol))
etyk <- function(p) sprintf("próg %d pkt", p)
d1 <- do.call(rbind, lapply(progi, function(p) cbind(gest, panel = etyk(p), prog = p)))
d1$panel <- factor(d1$panel, levels = etyk(progi))
opis1 <- data.frame(panel = factor(etyk(progi), levels = etyk(progi)), prog = progi,
                    tekst = sprintf("czułość %.0f%%\nfałszywe alarmy %.0f%%", 100 * tabela$czulosc, 100 * tabela$fpr))

p1 <- ggplot(d1, aes(x, y)) +
  geom_area(data = subset(d1, x >= prog), aes(fill = grupa), alpha = 0.35, position = "identity") +
  geom_line(aes(colour = grupa, linetype = grupa), linewidth = 0.9) +
  geom_vline(aes(xintercept = prog), colour = "grey10", linewidth = 0.7) +
  geom_text(data = opis1, aes(x = 16, y = 0.043, label = tekst), hjust = 0, vjust = 1, size = 3.8, lineheight = 0.95) +
  facet_wrap(~ panel, ncol = 2) +
  scale_fill_manual(values = kol, name = NULL) + scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = lin, name = NULL) +
  scale_y_continuous(limits = c(0, 0.044), expand = expansion(0)) +
  labs(x = "Wynik skali przesiewowej (pkt)", y = "Gęstość",
       title = "Jeden próg, dwie liczby: czułość i odsetek fałszywych alarmów",
       subtitle = "Pole zacienione na prawo od pionowej linii = wynik dodatni") + motyw
# p1   # zapis: ggsave("krzywa-roc-dwa-rozklady-progi.svg", p1, width = 10, height = 7)
Wynik w R
            grupa wynik.n wynik.M wynik.SD
1  z rozpoznaniem  100.00   63.77    10.90
2 bez rozpoznania  150.00   48.55    11.31
  prog TP FN FP  TN czulosc swoistosc   fpr
1   45 97  3 97  53    0.97     0.353 0.647
2   52 85 15 60  90    0.85     0.600 0.400
3   58 71 29 29 121    0.71     0.807 0.193
4   65 45 55 11 139    0.45     0.927 0.073
2. Krzywa ROC z pakietu pROC: Rysunek 2
R
# Rysunek 2. Każdy próg to jeden punkt (1 − swoistość, czułość); wszystkie progi razem dają krzywą ROC
library(pROC)                                    # kontynuacja: dane, tabela, kol, motyw z bloku 1

roc1 <- roc(dane$chory, dane$wynik, levels = c(0, 1), direction = "<", quiet = TRUE)
wsp <- coords(roc1, "all", ret = c("threshold", "sensitivity", "specificity"))
nrow(wsp)                                        # liczba punktów krzywej (progi + dwa końce)
auc(roc1)

d2 <- data.frame(fpr = 1 - wsp$specificity, czulosc = wsp$sensitivity)
d2 <- d2[order(d2$fpr, d2$czulosc), ]
pkt <- data.frame(fpr = tabela$fpr, czulosc = tabela$czulosc,
                  etykieta = sprintf("%d pkt: (%.2f; %.2f)", tabela$prog, tabela$fpr, tabela$czulosc))

p2 <- ggplot(d2, aes(fpr, czulosc)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey55") +
  geom_step(colour = "#0072B2", linewidth = 1) +
  geom_point(data = pkt, size = 3.6, shape = 21, fill = "#D55E00", colour = "grey10", stroke = 0.6) +
  geom_label(data = pkt, aes(label = etykieta), hjust = 0, nudge_x = 0.025, nudge_y = -0.035,
             size = 3.7, linewidth = 0, fill = "white", alpha = 0.9) +
  annotate("text", x = 0.7, y = 0.42, label = "przekątna:\ntest bez wartości\n(AUC = 0.5)",
           size = 3.6, colour = "grey40", hjust = 0, lineheight = 0.95) +
  coord_equal() +
  scale_x_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  labs(x = "1 − swoistość (odsetek fałszywych alarmów)", y = "Czułość",
       title = "Krzywa ROC: wszystkie progi naraz",
       subtitle = sprintf("Kółka – progi z rysunku 1; AUC = %.3f", as.numeric(auc(roc1)))) + motyw
# p2   # zapis: ggsave("krzywa-roc-progi-na-krzywej.svg", p2, width = 7.6, height = 7.6)
Wynik w R
[1] 62
Area under the curve: 0.8364
3. AUC jako odsetek wygranych par i test U: Rysunek 3
R
# Rysunek 3. AUC = odsetek par (osoba z rozpoznaniem, osoba bez), w których pierwsza ma wyższy wynik
# (kontynuacja: dane, roc1, motyw z bloków 1–2)
ch <- sort(dane$wynik[dane$chory == 1]); zd <- sort(dane$wynik[dane$chory == 0])
porownanie <- sign(outer(zd, ch, function(z, c) c - z))   # +1: wyżej osoba z rozpoznaniem, 0: remis
c(par = length(porownanie), wygrane = sum(porownanie > 0), remisy = sum(porownanie == 0),
  przegrane = sum(porownanie < 0))
auc_pary <- (sum(porownanie > 0) + 0.5 * sum(porownanie == 0)) / length(porownanie)

# Test U Manna–Whitneya: W w R to liczba wygranych par osób z rozpoznaniem (remisy po połowie)
mw <- suppressWarnings(wilcox.test(ch, zd, exact = FALSE))
round(c(AUC_pROC = as.numeric(auc(roc1)), AUC_z_par = auc_pary,
        U_przez_liczbe_par = unname(mw$statistic) / (length(ch) * length(zd))), 4)
mw$statistic; signif(mw$p.value, 3)

d3 <- expand.grid(i = seq_along(zd), j = seq_along(ch))
d3$wynik <- factor(as.vector(porownanie), levels = c(1, 0, -1),
                   labels = c("wyżej osoba z rozpoznaniem", "remis", "wyżej osoba bez rozpoznania"))
p3 <- ggplot(d3, aes(i, j, fill = wynik)) +
  geom_raster() +
  scale_fill_manual(values = c("#D55E00", "grey15", "#9FD3F2"), name = NULL) +
  guides(fill = guide_legend(nrow = 2)) +
  scale_x_continuous(expand = expansion(0), breaks = c(1, 50, 100, 150)) +
  scale_y_continuous(expand = expansion(0), breaks = c(1, 25, 50, 75, 100)) +
  coord_fixed(ratio = 1) +
  labs(x = "Osoby bez rozpoznania (posortowane od najniższego wyniku)",
       y = "Osoby z rozpoznaniem\n(posortowane)",
       title = sprintf("15 000 par: pomarańczowe pole = %.1f%% = AUC", 100 * auc_pary),
       subtitle = "Każda kratka to jedna para; remisy liczą się po połowie") + motyw
# p3   # zapis: ggsave("krzywa-roc-auc-jako-pary.svg", p3, width = 10, height = 8)
Wynik w R
      par   wygrane    remisy przegrane
    15000     12420       253      2327
          AUC_pROC          AUC_z_par U_przez_liczbe_par
            0.8364             0.8364             0.8364
      W
12546.5
[1] 2.03e-19
4. Nakładanie się rozkładów (d = 0.5, 1, 2) a kształt krzywej: Rysunek 4
R
# Rysunek 4. Im mniej rozkłady na siebie zachodzą (większe d), tym bardziej krzywa ROC wybrzusza się ku górnemu lewemu rogowi
library(patchwork)                               # kontynuacja: kol, motyw z bloku 1; pROC z bloku 2
dd <- c(0.5, 1, 2)
# Model dwunormalny (równe SD): krzywa ROC i AUC ze wzoru, AUC = Φ(d / √2)
round(data.frame(d = dd, AUC_wzor = pnorm(dd / sqrt(2))), 3)

# Próba: po 100 osób w każdej grupie dla każdego d
set.seed(583)
proby <- lapply(dd, function(d) data.frame(d = d, chory = rep(1:0, each = 100),
                                           wynik = c(rnorm(100, d), rnorm(100, 0))))
auc_proby <- sapply(proby, function(p) as.numeric(auc(roc(p$chory, p$wynik, levels = c(0, 1), direction = "<", quiet = TRUE))))
round(setNames(auc_proby, sprintf("d = %.1f", dd)), 3)

etyk_d <- function(d) sprintf("d = %.1f (AUC = %.2f)", d, pnorm(d / sqrt(2)))
x <- seq(-3.5, 5.5, by = 0.05)
d4a <- do.call(rbind, lapply(dd, function(d) rbind(
  data.frame(panel = etyk_d(d), grupa = "bez rozpoznania", x = x, y = dnorm(x, 0)),
  data.frame(panel = etyk_d(d), grupa = "z rozpoznaniem", x = x, y = dnorm(x, d)))))
d4a$panel <- factor(d4a$panel, levels = etyk_d(dd)); d4a$grupa <- factor(d4a$grupa, levels = names(kol))
fpr <- seq(0, 1, by = 0.005)
d4b <- do.call(rbind, lapply(dd, function(d) data.frame(panel = etyk_d(d), fpr = fpr, czulosc = pnorm(d + qnorm(fpr)))))
d4b_emp <- do.call(rbind, lapply(seq_along(dd), function(k) {
  r <- roc(proby[[k]]$chory, proby[[k]]$wynik, levels = c(0, 1), direction = "<", quiet = TRUE)
  data.frame(panel = etyk_d(dd[k]), fpr = 1 - r$specificities, czulosc = r$sensitivities)
}))
d4b$panel <- factor(d4b$panel, levels = etyk_d(dd)); d4b_emp$panel <- factor(d4b_emp$panel, levels = etyk_d(dd))
kol_d <- setNames(c("#E69F00", "#009E73", "#0f1d3a"), etyk_d(dd))
lin_d <- setNames(c("solid", "42", "11"), etyk_d(dd))

p4a <- ggplot(d4a, aes(x, y, colour = grupa, linetype = grupa)) +
  geom_line(linewidth = 0.9) + facet_wrap(~ panel, ncol = 1) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = lin, name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  scale_y_continuous(breaks = NULL) +
  labs(x = "Wynik (w jednostkach SD)", y = NULL, title = "A. Nakładanie się rozkładów") + motyw
p4b <- ggplot(d4b, aes(fpr, czulosc, colour = panel, linetype = panel)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60", linetype = "dashed") +
  geom_step(data = d4b_emp, linewidth = 0.4, alpha = 0.7, linetype = "solid", show.legend = FALSE) +
  geom_line(linewidth = 1.2) +
  scale_colour_manual(values = kol_d, name = NULL) + scale_linetype_manual(values = lin_d, name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  coord_equal() + scale_x_continuous(breaks = seq(0, 1, 0.25)) + scale_y_continuous(breaks = seq(0, 1, 0.25)) +
  labs(x = "1 − swoistość", y = "Czułość", title = "B. Krzywe ROC",
       subtitle = "Grube linie – wzór; cienkie schodki – próby n = 100 + 100") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1, 1.25))
# p4   # zapis: ggsave("krzywa-roc-nakladanie-d.svg", p4, width = 10, height = 6.4)
Wynik w R
    d AUC_wzor
1 0.5    0.638
2 1.0    0.760
3 2.0    0.921
d = 0.5 d = 1.0 d = 2.0
  0.694   0.717   0.937
5. Indeks Youdena i próg o najmniejszym koszcie: Rysunek 5
R
# Rysunek 5. Indeks Youdena na krzywej ROC i próg minimalizujący koszt błędów przy różnych wagach
# (kontynuacja: dane, d2, kol, motyw z bloków 1–2; patchwork z bloku 4)
ch <- dane$wynik[dane$chory == 1]; zd <- dane$wynik[dane$chory == 0]
progi_all <- sort(unique(dane$wynik))            # wynik dodatni, gdy wynik >= próg
wsz <- data.frame(prog = progi_all,              # wszystkie progi z danych
                  czulosc = sapply(progi_all, function(p) mean(ch >= p)),
                  swoistosc = sapply(progi_all, function(p) mean(zd < p)))
wsz$J <- wsz$czulosc + wsz$swoistosc - 1
youden <- wsz[which.max(wsz$J), ]
round(youden, 3)

# Oczekiwany koszt na 100 osób badanych przy częstości rozpoznania 10% (koszt fałszywego alarmu = 1)
czestosc <- 0.10
koszt <- function(r) 100 * (r * czestosc * (1 - wsz$czulosc) + (1 - czestosc) * (1 - wsz$swoistosc))
wagi <- c(1, 9, 20)                              # ile razy przeoczenie kosztuje więcej niż fałszywy alarm
# przy wadze (1 − częstość) / częstość = 9 minimum kosztu wypada w progu Youdena
najtaniej <- do.call(rbind, lapply(wagi, function(r) {
  k <- koszt(r); i <- which.min(k)
  data.frame(waga = r, prog = wsz$prog[i], czulosc = wsz$czulosc[i], swoistosc = wsz$swoistosc[i], koszt = k[i])
}))
round(najtaniej, 3)

etyk_w <- sprintf("przeoczenie = %d × fałszywy alarm", wagi)
d5b <- do.call(rbind, lapply(seq_along(wagi), function(k) data.frame(waga = etyk_w[k], prog = wsz$prog, koszt = koszt(wagi[k]))))
d5b$waga <- factor(d5b$waga, levels = etyk_w)
min5 <- data.frame(waga = factor(etyk_w, levels = etyk_w), prog = najtaniej$prog, koszt = najtaniej$koszt)
kol_w <- setNames(c("#0072B2", "#0f1d3a", "#D55E00"), etyk_w)
lin_w <- setNames(c("22", "solid", "42"), etyk_w)

p5a <- ggplot(d2, aes(fpr, czulosc)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey55") +
  geom_step(colour = "#0072B2", linewidth = 1) +
  annotate("segment", x = 1 - youden$swoistosc, xend = 1 - youden$swoistosc,
           y = 1 - youden$swoistosc, yend = youden$czulosc, colour = "#D55E00", linewidth = 1.1,
           arrow = arrow(length = unit(0.18, "cm"), ends = "both")) +
  annotate("point", x = 1 - youden$swoistosc, y = youden$czulosc, size = 3.4, shape = 21,
           fill = "#D55E00", colour = "grey10") +
  annotate("label", x = 1 - youden$swoistosc + 0.04, y = 0.42, hjust = 0, size = 3.7, linewidth = 0,
           label = sprintf("J = %.3f\nod %d pkt", youden$J, youden$prog)) +
  coord_equal() + scale_x_continuous(breaks = seq(0, 1, 0.25)) + scale_y_continuous(breaks = seq(0, 1, 0.25)) +
  labs(x = "1 − swoistość", y = "Czułość", title = "A. Youden: najdalej nad przekątną") + motyw
p5b <- ggplot(d5b, aes(prog, koszt, colour = waga, linetype = waga)) +
  geom_line(linewidth = 1) +
  geom_point(data = min5, size = 3.4, shape = 21, fill = "white", stroke = 1.2, show.legend = FALSE) +
  scale_colour_manual(values = kol_w, name = NULL) + scale_linetype_manual(values = lin_w, name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  coord_cartesian(xlim = c(25, 85)) +
  labs(x = "Próg (wynik dodatni od … pkt)", y = "Koszt na 100 badanych",
       title = "B. Najtańszy próg zależy od wag",
       subtitle = "Częstość rozpoznania 10%; kółko = minimum") + motyw
p5 <- p5a + p5b + plot_layout(widths = c(1, 1.15))
# p5   # zapis: ggsave("krzywa-roc-youden-koszty.svg", p5, width = 10, height = 6)
Wynik w R
   prog czulosc swoistosc     J
35   58    0.71     0.807 0.517
  waga prog czulosc swoistosc koszt
1    1   70    0.31     0.980   8.7
2    9   58    0.71     0.807  43.5
3   20   51    0.91     0.573  56.4
6. Przedział ufności dla AUC: DeLong i bootstrap: Rysunek 6
R
# Rysunek 6. Przedział ufności dla AUC: metoda DeLonga i bootstrap (2000 prób, losowanie osobno w grupach)
# (kontynuacja: dane, roc1, motyw z bloków 1–2)
ci_delong <- ci.auc(roc1, method = "delong")
set.seed(583)
ci_boot <- ci.auc(roc1, method = "bootstrap", boot.n = 2000, boot.stratified = TRUE)
round(rbind(DeLong = as.numeric(ci_delong), bootstrap_pROC = as.numeric(ci_boot)), 3)   # dolna, AUC, górna

# Ten sam bootstrap „ręcznie”: AUC jako odsetek wygranych par w każdej próbie bootstrapowej
auc_par <- function(c, z) { s <- sign(outer(c, z, "-")); mean(s > 0) + 0.5 * mean(s == 0) }
ch <- dane$wynik[dane$chory == 1]; zd <- dane$wynik[dane$chory == 0]
set.seed(583)
B <- 2000
auc_b <- replicate(B, auc_par(sample(ch, replace = TRUE), sample(zd, replace = TRUE)))
granice <- quantile(auc_b, c(.025, .975))
round(c(srednia_bootstrap = mean(auc_b), SE_bootstrap = sd(auc_b), granice), 3)

d6 <- data.frame(auc = auc_b)
linie6 <- data.frame(x = c(granice, as.numeric(ci_delong)[c(1, 3)]),
                     rodzaj = rep(c("bootstrap percentylowy", "DeLong"), each = 2))
p6 <- ggplot(d6, aes(auc)) +
  geom_histogram(binwidth = 0.005, boundary = 0, fill = "#9FD3F2", colour = "white", linewidth = 0.2) +
  geom_vline(data = linie6, aes(xintercept = x, linetype = rodzaj), colour = "#0f1d3a", linewidth = 0.9) +
  geom_vline(xintercept = as.numeric(auc(roc1)), colour = "#D55E00", linewidth = 1.2) +
  annotate("label", x = as.numeric(auc(roc1)), y = Inf, vjust = 1.2, hjust = -0.05, size = 3.8, linewidth = 0,
           label = sprintf("AUC z próby = %.3f", as.numeric(auc(roc1)))) +
  scale_linetype_manual(values = c("bootstrap percentylowy" = "solid", "DeLong" = "22"), name = "Granice 95% CI:") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(x = "AUC w próbie bootstrapowej", y = "Liczba prób",
       title = "Rozkład AUC w 2000 próbach bootstrapowych",
       subtitle = "Losowanie ze zwracaniem osobno wśród osób z rozpoznaniem i bez") + motyw
# p6   # zapis: ggsave("krzywa-roc-przedzial-auc.svg", p6, width = 10, height = 5.6)
Wynik w R
                [,1]  [,2]  [,3]
DeLong         0.787 0.836 0.885
bootstrap_pROC 0.786 0.839 0.882
srednia_bootstrap      SE_bootstrap              2.5%             97.5%
            0.837             0.025             0.788             0.885
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory rysunków przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
roznica <- function(k) {                        # najmniejsza odległość ΔE (CIELAB) między kolorami zestawu
  lab <- coords(as(hex2RGB(k), "LAB")); min(dist(lab))
}
zestawy <- list("2 grupy (rysunki 1, 2, 4A, 5A)" = c("#D55E00", "#0072B2"),
                "3 wartości d (rysunek 4B)" = c("#E69F00", "#009E73", "#0f1d3a"),
                "pary: wygrana, remis, przegrana (rysunek 3)" = c("#D55E00", "grey15", "#9FD3F2"),
                "3 wagi kosztów (rysunek 5B)" = c("#0072B2", "#0f1d3a", "#D55E00"),
                "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
zestawy <- lapply(zestawy, function(k) rgb(t(col2rgb(k)), maxColorValue = 255))
round(t(sapply(zestawy, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                      protanopia = roznica(protan(k))))), 1)
Wynik w R
                                            widzenie_typowe deuteranopia protanopia
2 grupy (rysunki 1, 2, 4A, 5A)                        114.6        108.3       91.9
3 wartości d (rysunek 4B)                              76.8         54.9       51.5
pary: wygrana, remis, przegrana (rysunek 3)            70.6         69.4       62.8
3 wagi kosztów (rysunek 5B)                            41.3         40.8       41.3
czerwony – zielony (dla porównania)                   121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, gęstości jądrowe, test U Manna–Whitneya i bootstrap ręczny – pakiet stats). Krzywe ROC, AUC i przedziały ufności (DeLong, bootstrap) policzono pakietem pROC. Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, Article 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Krzywa bez progów. Czytelnik nie wie, który punkt odpowiada jakiemu wynikowi skali (rysunek 2).
- AUC jako „trafność diagnozy”. AUC = .84 znaczy, że skala wygrywa w 84% par – nie, że trafnie klasyfikuje 84% osób (rysunek 3).
- Youden jako jedyny słuszny próg bez słowa o kosztach błędów i częstości zaburzenia (rysunek 5).
- Próg i czułość z tej samej małej próby podane bez zastrzeżenia, że są optymistyczne.
- AUC bez przedziału ufności albo bez informacji, jak go policzono (rysunek 6).
- Wartości predykcyjne odczytane z próby, w której częstość zaburzenia ustalił dobór grup, a nie populacja.
Najczęstsze pytania
Dlaczego krzywa ROC z moich danych ma kształt schodków?
Bo każdy punkt krzywej odpowiada jednemu progowi, a próg zmienia decyzję tylko dla konkretnych osób. Krok w górę to jedna lub kilka osób z rozpoznaniem, które stają się „dodatnie”, krok w prawo – osoby bez rozpoznania. W przykładzie na tej stronie 250 osób dało krzywą z 62 punktów. Gładką krzywą otrzymasz tylko z modelu (np. dwunormalnego) albo przy bardzo dużej próbie.
Jaki jest związek AUC z testem U Manna–Whitneya?
AUC to odsetek par „osoba z rozpoznaniem – osoba bez rozpoznania”, w których pierwsza ma wyższy wynik (remisy liczą się po połowie). Statystyka W z funkcji wilcox.test() w R to właśnie liczba takich par, więc W podzielone przez iloczyn liczebności grup daje AUC. W przykładzie: 12 546.5 / 15 000 = .836. Test U sprawdza, czy AUC różni się od .50.
Jakie AUC odpowiada d Cohena równemu 0.5, 1 albo 2?
Jeśli wyniki w obu grupach mają rozkład normalny o tym samym SD, AUC = Φ(d/√2): dla d = 0.5 to .638, dla d = 1 – .760, a dla d = 2 – .921. Przy różnych SD albo rozkładach skośnych ten przelicznik przestaje być dokładny, a w próbie po 100 osób w grupie AUC może odbiegać od wartości ze wzoru o kilka setnych.
Czy indeks Youdena zawsze wskazuje najlepszy próg?
Nie. Youden traktuje sumę czułości i swoistości jako jedyne kryterium, co odpowiada konkretnej relacji kosztów: przeoczenie jest tyle razy droższe od fałszywego alarmu, ile razy więcej jest w populacji osób zdrowych niż chorych. Przy częstości 10% to waga 9. Jeśli przeoczenie kosztuje więcej, optymalny próg leży niżej; jeśli mniej – wyżej. Próg wybrany na tych samych danych daje też zbyt optymistyczną czułość i swoistość.
Jak narysować krzywą ROC w ggplot2?
Policz współrzędne funkcją roc() i coords() z pakietu pROC (albo samodzielnie: czułość i swoistość dla każdego progu), a potem narysuj je jako geom_step() z osią x = 1 − swoistość i y = czułość, dodając przekątną geom_abline() i coord_equal(). Wybrane progi zaznacz punktami z etykietą – pełny kod jest w sekcji z kodem na tej stronie.
Powiązane hasła
Przeczytaj też
Krzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikTest Manna–Whitneya w obrazkach
Rangi, wszystkie pary i P(X > Y), równe mediany a istotny wynik, mała próba i estymator Hodgesa–Lehmanna – pięć symulacji z kodem R.
Czytaj →PoradnikWielkość efektu w obrazkach: d = 0.2, 0.5 i 0.8
Nakładanie rozkładów, U3 i przewaga sprawdzone symulacją, d z małej i dużej próby, r na wykresie rozrzutu i OR jako słupki ryzyka – z kodem R.
Czytaj →Wyznaczasz punkt odcięcia skali?
Pomożemy policzyć krzywą ROC, AUC z przedziałem ufności, czułość i swoistość, uzasadnić wybór progu i opisać wynik w pracy – tak, żebyś umiał(a) go wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Fluss, R., Faraggi, D., & Reiser, B. (2005). Estimation of the Youden index and its associated cutoff point. Biometrical Journal, 47(4), 458–472. https://doi.org/10.1002/bimj.200410135
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Leeflang, M. M. G., Moons, K. G. M., Reitsma, J. B., & Zwinderman, A. H. (2008). Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions. Clinical Chemistry, 54(4), 729–737. https://doi.org/10.1373/clinchem.2007.096032
- Perkins, N. J., & Schisterman, E. F. (2006). The inconsistency of “optimal” cutpoints obtained using two criteria based on the receiver operating characteristic curve. American Journal of Epidemiology, 163(7), 670–675. https://doi.org/10.1093/aje/kwj063 ● Otwarty dostęp
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77 ● Otwarty dostęp
Cytowania BibTeX
@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{fluss2005estimation, author={Fluss, Ronen and Faraggi, David and Reiser, Benjamin}, title={{Estimation of the Youden index and its associated cutoff point}}, journal={Biometrical Journal}, year={2005}, volume={47}, number={4}, pages={458--472}, doi={10.1002/bimj.200410135}}@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{leeflang2008bias, author={Leeflang, Mariska M. G. and Moons, Karel G. M. and Reitsma, Johannes B. and Zwinderman, Aeilko H.}, title={{Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions}}, journal={Clinical Chemistry}, year={2008}, volume={54}, number={4}, pages={729--737}, doi={10.1373/clinchem.2007.096032}}@article{perkins2006inconsistency, author={Perkins, Neil J. and Schisterman, Enrique F.}, title={{The inconsistency of “optimal” cutpoints obtained using two criteria based on the receiver operating characteristic curve}}, journal={American Journal of Epidemiology}, year={2006}, volume={163}, number={7}, pages={670--675}, doi={10.1093/aje/kwj063}}@article{robin2011proc, author={Robin, Xavier and Turck, Natacha and Hainard, Alexandre and Tiberti, Natalia and Lisacek, Frédérique and Sanchez, Jean-Charles and Müller, Markus}, title={{pROC: An open-source package for R and S+ to analyze and compare ROC curves}}, journal={BMC Bioinformatics}, year={2011}, volume={12}, number={1}, eid={77}, doi={10.1186/1471-2105-12-77}}