Kiedy krzywa ROC i które okno w SPSS
Krzywa ROC pokazuje, jak dobrze wynik ilościowy, np. suma punktów skali przesiewowej albo prawdopodobieństwo z modelu, odróżnia osoby z danym stanem od osób bez niego. Pojęcia omawiają hasła czułość i swoistość oraz indeks Youdena. Cały przebieg analizy w R, z trzema regułami wyboru progu i przedziałami ufności, opisuje poradnik krzywa ROC i punkt odcięcia krok po kroku. Tutaj pokazujemy tylko SPSS: co kliknąć, które tabele czytać i co z nich przepisać.
Które okno? W SPSS 31 i 32 analiza ROC to Analyze → Classify → ROC Analysis. Procedurę wprowadzono w wersji 26. Liczy AUC z przedziałem ufności, podaje współrzędne krzywej, rysuje krzywe precision–recall i porównuje dwie krzywe. Starsze okno ROC Curve według dokumentacji IBM usunięto w wersji 29.0.1. Polecenie ROC działa już tylko w składni (IBM Corp., b.d.). W wersjach starszych niż 26 jest tylko okno ROC Curve – jego tabele czyta się tak samo.
Menu, opcje i składnię sprawdziliśmy w dokumentacji IBM SPSS Statistics 32 (IBM Corp., b.d.). Podajemy je po angielsku, a polskie nazwy tylko te, które potwierdza polska dokumentacja IBM. W interfejsie mogą brzmieć inaczej. Ogólne zasady czytania wydruków opisuje wpis jak czytać wyniki z SPSS.
Przykład. 240 studentów (dane symulowane) wypełniło przesiewową skalę problemów ze snem (skala_snu, 0–24 pkt; wyżej = więcej problemów) i jedno pytanie o złą jakość snu (jakosc_snu, 0–10). Psycholog, który nie znał tych wyników, przeprowadził potem wywiad kliniczny i rozpoznał bezsenność (bezsennosc: 1 = tak, 0 = nie) u 41 osób. Cztery osoby nie wypełniły skali. Dane pobierzesz jako plik SPSS .sav (z etykietami zmiennych i wartości) albo plik CSV.
Przygotowanie danych
- Zmienna stanu (standard referencyjny) musi mieć wartość oznaczającą obecność stanu, tu 1. Tę wartość wpiszesz w oknie. Etykiety wartości zdefiniuj w widoku zmiennych (zob. przygotowanie danych w SPSS).
- Zmienna testowa musi być liczbowa i niepodzielona na grupy – próg wybierzesz na końcu.
- Kierunek. Sprawdź, czy wyższy wynik oznacza większe nasilenie. W przykładzie tak: osoby z bezsennością miały w skali M = 12.03 (SD = 3.95), a osoby bez niej M = 6.71 (SD = 3.32).
- Braki danych. Osoba z brakiem w zmiennej testowej albo w zmiennej stanu wypada z analizy. Tu w analizie zostaje 236 osób: 40 z bezsennością i 196 bez niej.
Krok 1. Okno Analyze → Classify → ROC Analysis
W polskiej dokumentacji IBM ta ścieżka to Analiza → Klasyfikacja → Analiza ROC (IBM Corp., b.d.).
- Przenieś
skala_snudo pola Test Variable. - Przenieś
bezsennoscdo pola State Variable. - W polu Value of State Variable wpisz 1. Wpisanie 0 odwróci analizę: SPSS potraktuje osoby bez rozpoznania jako „dodatnie”.
- Na razie nie zaznaczaj Paired-sample design (Próby parami) ani Grouping Variable (Zmienna grupująca). Wrócisz do nich w kroku 6. Można wybrać tylko jedną z tych opcji.
Krok 2. Options i Display
- Options → Test Direction (Opcje): zostaw ustawienie domyślne, w którym większy wynik oznacza silniejsze wskazanie na stan. Przy skali, w której wyższy wynik oznacza mniejsze ryzyko (np. dobrostan), zmień kierunek.
- Options → Parameters for Standard Error of Area: zostaw metodę Nonparametric (domyślna, bez założeń o rozkładzie). Drugą możliwością jest Bi-negative exponential. Poziom ufności zostaw na 95%.
- Options → Classification decyduje, czy wartość równa progowi jest wynikiem dodatnim. Według dokumentacji IBM to ustawienie obecnie nie zmienia wydruku.
- Display (Wyświetl): zaznacz ROC Curve z With diagonal reference line, a w części Print – Standard error and confidence interval i Coordinate points of ROC Curve. Bez pierwszej opcji tabela AUC zawiera samo pole, bez drugiej nie dostaniesz progów.
- Youden's Index (od wersji 29.0.1) dopisuje do współrzędnych indeks Youdena. Pokażemy, jak policzyć go ręcznie.
W tym samym oknie są też krzywa precision–recall i tabela Classifier evaluation metrics (współczynnik Giniego i maksimum K-S). Krzywa precision–recall pokazuje, jaki odsetek wyników dodatnich jest trafny. Dokumentacja IBM i Saito i Rehmsmeier (2015) zalecają ją przy silnie niezrównoważonych grupach, gdy przypadków dodatnich jest bardzo mało. Na koniec kliknij Paste zamiast OK, żeby zapisać polecenie w oknie składni.
Składnia do wklejenia
Polecenie zbudowaliśmy według Command Syntax Reference IBM dla ROC ANALYSIS (IBM Corp., b.d.). Odpowiada ustawieniom z kroków 1–2. Nie uruchamialiśmy go w SPSS. Liczby na tej stronie pochodzą z R. Słowo YOUDEN usuń, jeśli masz wersję starszą niż 29.0.1.
ROC ANALYSIS skala_snu BY bezsennosc(1)
/CRITERIA CUTOFF=INCLUDE TESTPOS=LARGE DISTRIBUTION=FREE CI=95
/MISSING USERMISSING=EXCLUDE
/PLOT CURVE=ROC(REFERENCE)
/PRINT SE=TRUE COORDINATES=ROC(YOUDEN).
TESTPOS=LARGE to kierunek „większy wynik = dodatni”, a DISTRIBUTION=FREE to nieparametryczny błąd standardowy. W starszym poleceniu ROC odpowiednikiem jest ROC skala_snu BY bezsennosc (1) /PRINT=SE COORDINATES.
Krok 3. Tabela Area Under the Curve
Pierwsza tabela (Case Processing Summary) podaje liczbę przypadków dodatnich i ujemnych: 40 i 196. Jeśli są zamienione, wpisałeś złą wartość zmiennej stanu.
Tabela 1. Area Under the Curve. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Nagłówki kolumn i przypisy odtworzyliśmy z typowego wydruku – dokumentacja IBM potwierdza tylko zawartość tabeli (pole, błąd standardowy, asymptotyczna istotność i granice przedziału).
| Test Result Variable(s) | Area | Std. Errora | Asymptotic Sig.b | Asymptotic 95% Confidence Interval | |
|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||
| skala_snu | .841 | .034 | .000 | .774 | .908 |
a. Under the nonparametric assumption. b. Null hypothesis: true area = 0.5. Typowy wydruk zawiera też przypis o remisach między grupami (np. „has at least one tie…”) – przy wyniku w punktach całkowitych jest on normalny.
- Area to AUC = .84. Hanley i McNeil (1982) pokazali, że to prawdopodobieństwo, że losowa osoba z bezsennością ma wyższy wynik niż losowa osoba bez niej. To ta sama wielkość, którą szacuje statystyka Manna–Whitneya (remisy liczą się po połowie). W 84% par skala uporządkowała osoby poprawnie.
- Asymptotic Sig. testuje hipotezę, że AUC = .50 (IBM Corp., b.d.), czyli że skala odróżnia grupy na poziomie przypadku. Wartość .000 zapisz jako p < .001. Ważniejszy jest przedział ufności.
- Std. Error i przedział: 95% CI [.77, .91]. Dokumentacja IBM nazywa tę metodę tylko „nieparametryczną” i nie podaje wzoru. W R użyliśmy nieparametrycznej metody DeLonga i in. (1988), a przedział policzyliśmy jako AUC ± 1.96 × SE. Jeśli SPSS stosuje inny wzór, Twój wynik może się różnić w trzecim miejscu po przecinku. W pracy podaj nazwę metody z wydruku.
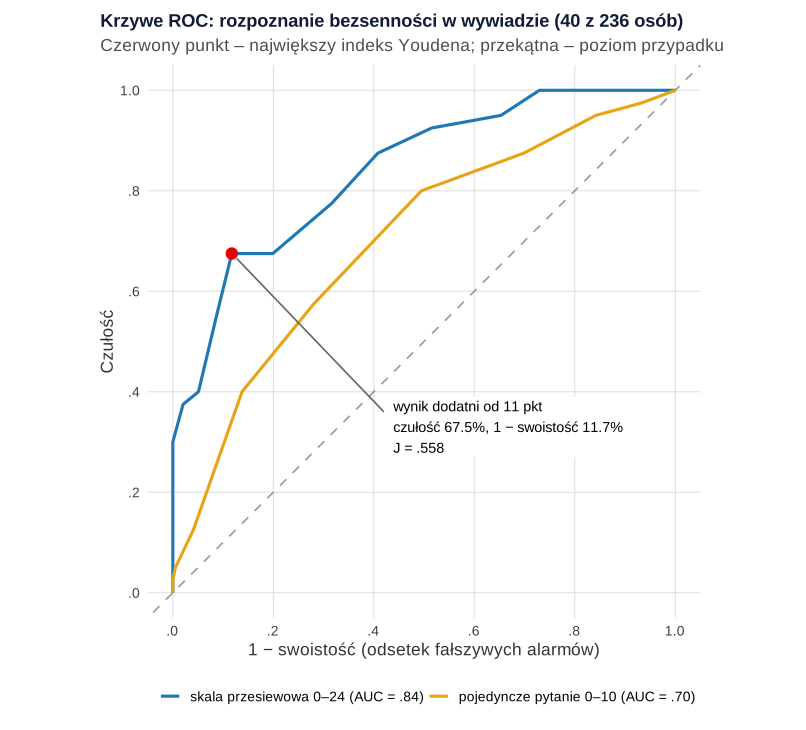
Rysunek 1 pokazuje krzywą z przykładu.
Krok 4. Współrzędne krzywej i indeks Youdena
Tabela współrzędnych podaje dla każdej wartości progu czułość (Sensitivity) i odsetek fałszywych alarmów (1 - Specificity). Indeks Youdena (Youden, 1950) liczysz ręcznie dla każdego wiersza: J = czułość − (1 − swoistość).
Tabela 2. Coordinates of the Curve (fragment: progi od 6.5 do 15.5). Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Nagłówek pierwszej kolumny odtworzyliśmy z typowego wydruku. Kolumnę J policzyliśmy ręcznie; ostatnia kolumna to nasze tłumaczenie progu na punkty.
| Positive if Greater Than or Equal Toa | Sensitivity | 1 - Specificity | J (ręcznie) | Wynik dodatni od |
|---|---|---|---|---|
| 6.50 | .925 | .515 | .410 | 7 pkt |
| 7.50 | .875 | .408 | .467 | 8 pkt |
| 8.50 | .775 | .316 | .459 | 9 pkt |
| 9.50 | .675 | .199 | .476 | 10 pkt |
| 10.50 | .675 | .117 | .558 | 11 pkt |
| 11.50 | .550 | .087 | .463 | 12 pkt |
| 12.50 | .400 | .051 | .349 | 13 pkt |
| 13.50 | .375 | .020 | .355 | 14 pkt |
| 14.50 | .300 | .000 | .300 | 15 pkt |
| 15.50 | .225 | .000 | .225 | 16 pkt |
a. Progi policzyliśmy jako połowę odległości między sąsiednimi wynikami (tak robi pakiet pROC). Typowy wydruk SPSS ma przypis o takiej samej konwencji, ale dokumentacja IBM, do której dotarliśmy, jej nie opisuje – sprawdź przypis pod własną tabelą.
Jak czytać próg 10.50? Nikt nie ma 10.5 punktu, więc w praktyce to reguła „wynik dodatni od 11 pkt”. Przy wyniku w punktach całkowitych każdy próg między 10 a 11 dzieli osoby tak samo. Dlatego czułość i swoistość w wierszu nie zależą od tego, jak program zapisze próg. W pracy pisz „≥ 11 pkt”, a nie „10.5”.
Co mówi J? Największe J = .558 daje reguła „od 11 pkt”: czułość 67.5%, a swoistość 1 − .117 = 88.3%. Indeks Youdena traktuje przeoczenie i fałszywy alarm jako równie kosztowne. Fluss i in. (2005) pokazali, że empiryczne oszacowanie J z tej samej próby jest obciążone. Zauważ też, że J dla progów 8, 9, 10 i 12 pkt mieści się w przedziale .46–.48. Wybór „najlepszego” progu z dokładnością do punktu jest więc w dużej mierze przypadkowy. Regułę wyboru (np. minimalną czułość dla skali przesiewowej) ustal przed analizą.
Krok 5. Tabela 2 × 2 dla wybranego progu
ROC Analysis nie podaje tabeli krzyżowej dla jednego progu ani przedziałów ufności dla czułości i swoistości. Zbuduj zmienną 0/1 i użyj Crosstabs (zob. chi-kwadrat w SPSS – tabele krzyżowe):
EXECUTE.
CROSSTABS /TABLES=dodatni_11 BY bezsennosc /CELLS=COUNT COLUMN ROW.
Wyrażenie w nawiasie daje 1 albo 0, a brak zostaje brakiem. Tej składni też nie uruchamialiśmy w SPSS.
Tabela 3. Tabela krzyżowa wyniku skali przy progu 11 pkt i rozpoznania w wywiadzie (dane symulowane, liczby policzone w R).
| Wynik skali | Bezsenność: tak | Bezsenność: nie |
|---|---|---|
| Dodatni (≥ 11 pkt) | 27 (TP) | 23 (FP) |
| Ujemny (≤ 10 pkt) | 13 (FN) | 173 (TN) |
Procenty w kolumnach to czułość (27/40 = 67.5%) i swoistość (173/196 = 88.3%), a w wierszach – wartości predykcyjne: PPV = 54.0% i NPV = 93.0%. PPV to ta sama wielkość co precision na krzywej precision–recall. Przedziały ufności Wilsona policzyliśmy w R: czułość 95% CI [52.0, 79.9], swoistość [83.0, 92.1]. Przedział dla czułości jest szeroki, bo opiera się na 40 osobach. Próg wybraliśmy na tych samych danych, więc te liczby są zawyżone i wymagają sprawdzenia w nowej próbie (więcej w poradniku krzywa ROC krok po kroku).
Krok 6. Dwie krzywe: skala a pojedyncze pytanie
Czy pełna skala odróżnia osoby lepiej niż jedno pytanie? Obie miary wypełniły te same osoby, więc ich AUC są skorelowane. W oknie ROC Analysis przenieś obie zmienne do Test Variable i zaznacz Paired-sample design. Według dokumentacji IBM ta opcja porównuje dwie krzywe ROC u tych samych osób i wyłącza wybór założenia o rozkładzie. Dla dwóch niezależnych grup (np. ta sama skala u kobiet i mężczyzn) służy Grouping Variable z Define Groups. Składnia (nieuruchamiana):
/DESIGN PAIR=TRUE
/PLOT CURVE=ROC(REFERENCE)
/PRINT SE=TRUE.
Dokumentacja IBM nie podaje, jakim testem SPSS porównuje krzywe sparowane, dlatego nie pokazujemy tej tabeli w układzie SPSS. W R policzyliśmy test DeLonga dla krzywych skorelowanych (DeLong i in., 1988; Robin i in., 2011). Skala miała AUC = .84, a pytanie .70. Różnica wyniosła ΔAUC = .14, 95% CI [.04, .24], z = 2.66, p = .008. Gdy Twój wydruk poda inną statystykę, raportuj ją i nazwij metodę.
Zapis wyników w stylu APA
Podaj standard referencyjny i liczebność obu grup, AUC z 95% CI i metodą błędu standardowego, regułę wyboru progu oraz czułość i swoistość z przedziałami. Gotowy opis innych analiz złożysz w generatorze opisu wyników APA.
Jeśli nie wiesz, czy Twoje pytanie wymaga analizy ROC, czy np. porównania średnich (test t w SPSS), sprawdź kreator doboru testu. Prawdopodobieństwa z modelu do analizy ROC zapiszesz w regresji logistycznej w SPSS (Save → Probabilities).
Te same liczby w R
SPSS nie był używany przy przygotowaniu tej strony. Liczby z tabel 1–3 i z porównania dwóch krzywych policzyliśmy w R (pakiet pROC; Robin i in., 2011): AUC jako statystykę Manna–Whitneya podzieloną przez liczbę par, nieparametryczny błąd standardowy metodą DeLonga, asymptotyczny przedział AUC ± 1.96 × SE, progi w połowie między sąsiednimi wynikami (przy kierunku „większy wynik = dodatni”), indeks Youdena jako czułość − (1 − swoistość), przedziały Wilsona dla czułości i swoistości oraz test DeLonga dla krzywych skorelowanych. Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych. Przepis 1 tworzy plik CSV i plik .sav (pakiet haven).
1. Dane: CSV i plik SPSS .sav z etykietami
R
# B310 – dane przykładowe: przesiewowa skala problemów ze snem a rozpoznanie bezsenności (dane symulowane, set.seed(3101))
# 240 studentów; plik CSV i plik SPSS .sav z etykietami zmiennych i wartości
suppressPackageStartupMessages(library(haven))
set.seed(3101)
n <- 240
bezsennosc <- rbinom(n, 1, .20)                                            # 1 = bezsenność rozpoznana w wywiadzie, 0 = brak
skala_snu <- round(pmin(pmax(rnorm(n, 7 + 6 * bezsennosc, 3.6), 0), 24))   # skala przesiewowa 0–24 pkt (wyżej = więcej problemów)
jakosc_snu <- round(pmin(pmax(0.25 * skala_snu + rnorm(n, 1.6 + 0.6 * bezsennosc, 1.6), 0), 10))  # pytanie 0–10: zła jakość snu
skala_snu[sample(which(bezsennosc == 0), 3)] <- NA                         # braki: 4 osoby nie wypełniły skali
skala_snu[sample(which(bezsennosc == 1), 1)] <- NA
dane <- data.frame(id = 1:n, bezsennosc, skala_snu, jakosc_snu)
write.csv(dane, "../krzywa-roc-spss-dane.csv", row.names = FALSE, na = "")

sav <- dane
attr(sav$id, "label") <- "Numer osoby"
sav$bezsennosc <- labelled(sav$bezsennosc, c("brak" = 0, "bezsenność" = 1), label = "Bezsenność w wywiadzie klinicznym")
attr(sav$skala_snu, "label") <- "Skala przesiewowa problemów ze snem (0–24)"
attr(sav$jakosc_snu, "label") <- "Ocena złej jakości snu, jedno pytanie (0–10)"
write_sav(sav, "../krzywa-roc-spss-dane.sav")

summary(dane[, -1])
table(bezsennosc = dane$bezsennosc, brak_skali = is.na(dane$skala_snu))
# M, SD i liczba ważnych odpowiedzi w obu grupach
opis <- function(x) c(M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE), n = sum(!is.na(x)))
round(rbind(skala_brak = opis(dane$skala_snu[dane$bezsennosc == 0]), skala_bezsennosc = opis(dane$skala_snu[dane$bezsennosc == 1]),
            pytanie_brak = opis(dane$jakosc_snu[dane$bezsennosc == 0]), pytanie_bezsennosc = opis(dane$jakosc_snu[dane$bezsennosc == 1])), 2)
Wynik w R
   bezsennosc       skala_snu       jakosc_snu
 Min.   :0.0000   Min.   : 0.00   Min.   :0.00
 1st Qu.:0.0000   1st Qu.: 5.00   1st Qu.:2.00
 Median :0.0000   Median : 7.00   Median :4.00
 Mean   :0.1708   Mean   : 7.61   Mean   :3.65
 3rd Qu.:0.0000   3rd Qu.:10.00   3rd Qu.:5.00
 Max.   :1.0000   Max.   :21.00   Max.   :9.00
                  NA's   :4
          brak_skali
bezsennosc FALSE TRUE
         0   196    3
         1    40    1
                       M   SD   n
skala_brak          6.71 3.32 196
skala_bezsennosc   12.03 3.95  40
pytanie_brak        3.41 1.83 199
pytanie_bezsennosc  4.83 1.87  41
2. ROC Analysis: AUC, współrzędne, indeks Youdena i dwie krzywe
R
# ROC Analysis: skala_snu (zmienna testowa) a bezsennosc (zmienna stanu, wartość dodatnia = 1)
# Te same ustawienia co w składni: większy wynik = wynik dodatni, nieparametryczny błąd standardowy, 95% CI
suppressPackageStartupMessages(library(pROC))
dane <- read.csv("../krzywa-roc-spss-dane.csv")
d <- dane[!is.na(dane$skala_snu), ]                       # osoby z brakiem w zmiennej testowej są pomijane
# Case Processing Summary: liczba przypadków dodatnich i ujemnych
table(bezsennosc = d$bezsennosc)
r <- roc(d$bezsennosc, d$skala_snu, levels = c(0, 1), direction = "<", quiet = TRUE)
# Area Under the Curve: AUC, nieparametryczny SE (DeLong), asymptotyczny 95% CI = AUC ± 1.96 × SE, test H0: AUC = .5
auc_r <- as.numeric(auc(r)); se_r <- sqrt(var(r, method = "delong"))
z <- (auc_r - .5) / se_r
round(c(Area = auc_r, Std_Error = se_r, Lower = auc_r - qnorm(.975) * se_r, Upper = auc_r + qnorm(.975) * se_r), 3)
signif(c(z = z, Sig = 2 * pnorm(-abs(z))), 3)
# Kontrola: AUC jako statystyka Manna–Whitneya podzielona przez liczbę par (remisy po połowie)
x1 <- d$skala_snu[d$bezsennosc == 1]; x0 <- d$skala_snu[d$bezsennosc == 0]
round(mean(outer(x1, x0, ">") + 0.5 * outer(x1, x0, "==")), 3)
# Coordinates of the Curve: progi w połowie między sąsiednimi wynikami, czułość i 1 − swoistość,
# indeks Youdena J = czułość − (1 − swoistość) policzony ręcznie
k <- coords(r, "all", ret = c("threshold", "sensitivity", "specificity"), transpose = FALSE)
k$jeden_minus_swoistosc <- 1 - k$specificity
k$J <- k$sensitivity - k$jeden_minus_swoistosc
k$wynik_dodatni_od <- ceiling(k$threshold)
print(round(k[k$threshold > 6 & k$threshold < 16, c("threshold", "wynik_dodatni_od", "sensitivity", "jeden_minus_swoistosc", "J")], 3), row.names = FALSE)
k[which.max(k$J), c("threshold", "wynik_dodatni_od", "J")]
# Tabela 2 × 2 dla progu „wynik dodatni od 11 pkt”: czułość, swoistość, PPV (precision) i NPV
tab <- table(Wynik = factor(d$skala_snu >= 11, c(TRUE, FALSE), c("dodatni", "ujemny")),
             Bezsennosc = factor(d$bezsennosc, c(1, 0), c("tak", "nie")))
print(tab)
round(c(czulosc = tab[1, 1] / sum(tab[, 1]), swoistosc = tab[2, 2] / sum(tab[, 2]),
        PPV = tab[1, 1] / sum(tab[1, ]), NPV = tab[2, 2] / sum(tab[2, ])), 3)
# 95% CI Wilsona dla czułości i swoistości (prop.test bez poprawki na ciągłość)
wilson <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int[1:2]
round(rbind(czulosc = wilson(tab[1, 1], sum(tab[, 1])), swoistosc = wilson(tab[2, 2], sum(tab[, 2]))), 3)
# Wskaźnik Giniego = 2 × AUC − 1 i maksymalna różnica czułości i 1 − swoistości (statystyka K-S)
round(c(Gini = 2 * auc_r - 1, Max_KS = max(k$J)), 3)
# Projekt sparowany: skala a pojedyncze pytanie u tych samych 236 osób, test DeLonga dla krzywych skorelowanych
r2 <- roc(d$bezsennosc, d$jakosc_snu, levels = c(0, 1), direction = "<", quiet = TRUE)
round(c(AUC_skala = auc_r, AUC_pytanie = as.numeric(auc(r2)), r_wynikow = cor(d$skala_snu, d$jakosc_snu)), 3)
t2 <- roc.test(r, r2, method = "delong", paired = TRUE)
round(c(roznica = unname(diff(rev(t2$estimate))), z = unname(t2$statistic), p = t2$p.value,
        CI_dolna = t2$conf.int[1], CI_gorna = t2$conf.int[2]), 3)
Wynik w R
bezsennosc
  0   1
196  40
     Area Std_Error     Lower     Upper
    0.841     0.034     0.774     0.908
       z      Sig
9.94e+00 2.90e-23
[1] 0.841
 threshold wynik_dodatni_od sensitivity jeden_minus_swoistosc     J
       6.5                7       0.925                 0.515 0.410
       7.5                8       0.875                 0.408 0.467
       8.5                9       0.775                 0.316 0.459
       9.5               10       0.675                 0.199 0.476
      10.5               11       0.675                 0.117 0.558
      11.5               12       0.550                 0.087 0.463
      12.5               13       0.400                 0.051 0.349
      13.5               14       0.375                 0.020 0.355
      14.5               15       0.300                 0.000 0.300
      15.5               16       0.225                 0.000 0.225
   threshold wynik_dodatni_od         J
12      10.5               11 0.5576531
         Bezsennosc
Wynik     tak nie
  dodatni  27  23
  ujemny   13 173
  czulosc swoistosc       PPV       NPV
    0.675     0.883     0.540     0.930
          [,1]  [,2]
czulosc   0.52 0.799
swoistosc 0.83 0.921
  Gini Max_KS
 0.682  0.558
  AUC_skala AUC_pytanie   r_wynikow
      0.841       0.701       0.417
 roznica        z        p CI_dolna CI_gorna
   0.140    2.663    0.008    0.037    0.243
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet pROC); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files (R package version 2.5.5) [Computer software]. https://CRAN.R-project.org/package=haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizie ROC w SPSS
- Zła wartość zmiennej stanu (0 zamiast 1). SPSS policzy krzywą dla „braku stanu”, a AUC wyjdzie 1 − właściwe AUC.
- Odwrócony kierunek testu. AUC poniżej .50 przy sensownej skali prawie zawsze oznacza, że wyższy wynik oznacza mniejsze ryzyko, a w Options został kierunek domyślny.
- Samo AUC bez przedziału ufności, bo nie zaznaczono Standard error and confidence interval, i zapis p = .000 zamiast p < .001.
- Próg „10.50” w tekście pracy zamiast reguły „wynik dodatni od 11 pkt”.
- Próg wybrany na tych samych danych opisany jak potwierdzony. Napisz, że jest eksploracyjny, i podaj czułość oraz swoistość z przedziałami.
- Dwie skale tych samych osób porównane jak niezależne albo „na oko” – użyj projektu sparowanego.
Ustawienia analizy i opis wyników sprawdzimy w ramach oferty analizy statystyczne dla studentów.
Najczęstsze pytania
Gdzie w SPSS jest krzywa ROC?
W SPSS 31 i 32 wybierz Analyze → Classify → ROC Analysis (w polskiej dokumentacji: Analiza → Klasyfikacja → Analiza ROC). Według dokumentacji IBM od wersji 29.0.1 starsze okno ROC Curve usunięto, a polecenie ROC działa już tylko w składni (IBM Corp., b.d.).
Dlaczego SPSS nie pokazuje przedziału ufności dla AUC?
Domyślnie tabela Area Under the Curve zawiera samo pole. Błąd standardowy, asymptotyczny przedział ufności i istotność dodasz w Display opcją Standard error and confidence interval (w składni /PRINT SE=TRUE).
Jak policzyć indeks Youdena w SPSS?
Zaznacz Coordinate points of ROC Curve i dla każdego progu policz J = czułość − (1 − swoistość). Wybierz próg o największym J. Od wersji 29.0.1 SPSS doda tę kolumnę sam po zaznaczeniu Youden's Index. W przykładzie największe J = .558 daje reguła „wynik dodatni od 11 pkt”.
Co zrobić, gdy AUC w SPSS wychodzi poniżej .5?
Najpewniej kierunek testu jest odwrotny: SPSS domyślnie uznaje wyższy wynik za bardziej wskazujący na stan. Gdy wyższy wynik oznacza mniejsze ryzyko, zmień Test Direction w Options (w składni TESTPOS=SMALL) albo sprawdź, czy wpisałeś właściwą wartość zmiennej stanu.
Czy SPSS porówna dwie krzywe ROC?
Tak. Okno ROC Analysis ma projekt sparowany (Paired-sample design) dla dwóch wyników tych samych osób i projekt grup niezależnych ze zmienną grupującą. Jeśli porównujesz dwie skale wypełnione przez te same osoby, wybierz projekt sparowany i podaj różnicę AUC z testem.
Powiązane hasła
Przeczytaj też
Krzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →Masz analizę ROC w SPSS i nie wiesz, jaki próg wybrać?
Sprawdzimy ustawienia analizy, kierunek testu i wybór punktu odcięcia oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Fluss, R., Faraggi, D., & Reiser, B. (2005). Estimation of the Youden index and its associated cutoff point. Biometrical Journal, 47(4), 458–472. https://doi.org/10.1002/bimj.200410135
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- IBM Corp. (b.d.). ROC Analysis (Options, Display); ROC ANALYSIS command; ROC command. IBM SPSS Statistics 32.0.0 documentation. Pobrano 1 listopada 2026 z https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-roc-analysis ● Otwarty dostęp
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77 ● Otwarty dostęp
- Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432 ● Otwarty dostęp
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32–35. https://doi.org/10.1002/1097-0142(1950)3:1<32::aid-cncr2820030106>3.0.co;2-3 ● Otwarty dostęp
Cytowania BibTeX
@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{fluss2005estimation, author={Fluss, Ronen and Faraggi, David and Reiser, Benjamin}, title={{Estimation of the Youden index and its associated cutoff point}}, journal={Biometrical Journal}, year={2005}, volume={47}, number={4}, pages={458--472}, doi={10.1002/bimj.200410135}}@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@misc{ibmnd32rocanalysis, author={{IBM Corp.}}, title={{ROC Analysis (Options, Display); ROC ANALYSIS command; ROC command}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-roc-analysis}}@article{robin2011proc, author={Robin, Xavier and Turck, Natacha and Hainard, Alexandre and Tiberti, Natalia and Lisacek, Frédérique and Sanchez, Jean-Charles and Müller, Markus}, title={{pROC: An open-source package for R and S+ to analyze and compare ROC curves}}, journal={BMC Bioinformatics}, year={2011}, volume={12}, number={1}, eid={77}, doi={10.1186/1471-2105-12-77}}@article{saito2015precision, author={Saito, Takaya and Rehmsmeier, Marc}, title={{The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets}}, journal={PLOS ONE}, year={2015}, volume={10}, number={3}, eid={e0118432}, doi={10.1371/journal.pone.0118432}}@article{youden1950index, author={Youden, W. J.}, title={{Index for rating diagnostic tests}}, journal={Cancer}, year={1950}, volume={3}, number={1}, pages={32--35}, doi={10.1002/1097-0142(1950)3:1<32::aid-cncr2820030106>3.0.co;2-3}}