Kiedy regresja logistyczna i co zrobisz w SPSS
Regresja logistyczna przewiduje wynik o dwóch wartościach, a jej współczynniki przelicza się na ilorazy szans (OR). Logikę modelu, założenia, separację i kalibrację omawia poradnik regresja logistyczna krok po kroku (z kodem w R). Tutaj pokazujemy tylko SPSS: co kliknąć, które tabele wydruku czytać i co z nich przepisać.
Menu, opcje i składnię sprawdziliśmy w dokumentacji IBM SPSS Statistics 32 (IBM Corp., b.d.). Podajemy je po angielsku, a polskie nazwy tylko wtedy, gdy potwierdza je polska dokumentacja IBM; w interfejsie mogą się różnić. Ogólne zasady czytania wydruków opisuje wpis jak czytać wyniki z SPSS.
Przykład. 256 osób po pierwszym roku studiów (dane symulowane). Zmienna zależna to rezygnacja (1 = zrezygnowała ze studiów, 0 = kontynuuje). Predyktory: zaangażowanie w naukę, czyli średnia ze skali 1–5 (zaangazowanie), godziny pracy zarobkowej tygodniowo (praca) i miejsce zamieszkania (zamieszkanie: 1 = z rodzicami, 2 = akademik, 3 = wynajem). Sześć osób nie wypełniło skali zaangażowania. Dane pobierzesz jako plik SPSS .sav (z etykietami zmiennych i wartości) albo plik CSV.
Przygotowanie danych
- Zmienna zależna 0/1. Zakoduj interesujące Cię zdarzenie jako 1 i sprawdź to w tabeli Dependent Variable Encoding – odwrócone kodowanie odwraca znaki wszystkich B.
- Zmienne nominalne o 3+ kategoriach (tu
zamieszkanie) nie mogą wejść do modelu jak liczby 1–3. SPSS zamieni je na zmienne zero-jedynkowe (dummy coding), jeśli wskażesz je w oknie Categorical (krok 2). - Braki danych. Osoba z brakiem w którejkolwiek zmiennej modelu wypada z analizy. Kody typu 99 zdefiniuj jako braki (zob. przygotowanie danych w SPSS).
- Liczba zdarzeń. Sprawdź, ile osób ma wynik 1. Tu zrezygnowało 81 z 250 osób z kompletem danych, a model ma 4 parametry. Reguła „10 zdarzeń na predyktor” nie ma mocnego uzasadnienia, a stabilność ocen zależy też od całkowitej liczebności (van Smeden i in., 2016; zob. EPV).
Statystyki opisowe: zaangażowanie M = 3.33 (SD = 0.66), praca M = 10.44 godziny (SD = 12.52). W całym pliku (256 osób) zrezygnowało 21% osób mieszkających z rodzicami, 38% mieszkających w akademiku i 39% wynajmujących mieszkanie.
Krok 1. Okno Analyze → Regression → Binary Logistic
W polskiej dokumentacji IBM ta ścieżka to Analiza → Regresja → Logistyczna dwuwariantowa (IBM Corp., b.d.).
- Przenieś
rezygnacjado pola Dependent. Musi to być zmienna dychotomiczna. - Przenieś
zaangazowanie,pracaizamieszkaniedo listy Covariates. Tak SPSS nazywa wszystkie predyktory. - Zostaw metodę Enter. Metody Forward i Backward (z kryterium Conditional, LR albo Wald) dobierają predyktory za Ciebie (zob. metoda krokowa). W pracy sprawdzającej hipotezy wprowadź predyktory wybrane z teorii. Bloki predyktorów dodasz przyciskiem Next.
Krok 2. Categorical: kodowanie i kategoria odniesienia
- Kliknij Categorical i przenieś
zamieszkaniedo Categorical Covariates. - W Change Contrast zostaw kontrast Indicator (po polsku: Wskaźnik). Każda kategoria jest wtedy porównywana z kategorią odniesienia, a Exp(B) to zwykły iloraz szans względem tej grupy.
- Jako Reference Category wybierz First (Pierwsza), czyli „z rodzicami”, i kliknij Change (Zmień). Bez tego kliknięcia wybór się nie zapisze (IBM Corp., b.d.).
Dlaczego ustawiamy kategorię odniesienia ręcznie? Według Command Syntax Reference w wersji 26 domyślną kategorią odniesienia kontrastu Indicator jest ostatnia kategoria. Dokumentacja wersji 31 i 32 podaje jednak, że domyślna jest pierwsza (IBM Corp., b.d.). Wybierz więc kategorię sam i sprawdź ją w tabeli Categorical Variables Codings: kategoria odniesienia ma same zera.
Tabela 1. Categorical Variables Codings. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| Frequency | Parameter coding | |||
|---|---|---|---|---|
| (1) | (2) | |||
| zamieszkanie | z rodzicami | 94 | .000 | .000 |
| akademik | 68 | 1.000 | .000 | |
| wynajem | 88 | .000 | 1.000 | |
Kolumny (1) i (2) to „akademik” i „wynajem”; w tabeli współczynników pojawią się jako zamieszkanie(1) i zamieszkanie(2).
Krok 3. Options i Save
- Options → Statistics and Plots: zaznacz Hosmer-Lemeshow goodness-of-fit i CI for exp(B) (95%).
- Display: At last step skraca wydruk do końcowego modelu.
- Classification cutoff: zostaw .5. Osoba trafia do grupy „1”, gdy przewidywane prawdopodobieństwo jest co najmniej równe progowi (IBM Corp., b.d.).
- Save: zaznacz Probabilities. SPSS dopisze kolumnę z przewidywanym prawdopodobieństwem. Wykorzystasz ją w procedurze ROC Curve (zob. krzywa ROC krok po kroku).
Na koniec kliknij Paste zamiast OK, żeby zapisać polecenie w oknie składni.
Składnia do wklejenia
Polecenie zbudowaliśmy według Command Syntax Reference IBM dla LOGISTIC REGRESSION (IBM Corp., b.d.). Odpowiada ustawieniom z kroków 1–3. Nie uruchamialiśmy go w SPSS. Liczby na tej stronie pochodzą z R. DEFAULT w PRINT jest potrzebne: bez niego SPSS wyświetli tylko GOODFIT i CI.
* kategoria odniesienia: pierwsza (z rodzicami).
LOGISTIC REGRESSION VARIABLES=rezygnacja WITH zaangazowanie praca zamieszkanie
/CATEGORICAL=zamieszkanie
/CONTRAST (zamieszkanie)=INDICATOR(1)
/METHOD=ENTER zaangazowanie praca zamieszkanie
/PRINT=DEFAULT GOODFIT CI(95)
/CRITERIA=PIN(.05) POUT(.10) ITERATE(20) CUT(.5)
/SAVE=PRED.
Liczba w INDICATOR(1) to numer kolejny kategorii, a nie jej wartość. Dla kategorii odniesienia „wynajem” napisz INDICATOR(3).
Krok 4. Tabele dopasowania modelu
Case Processing Summary pokazuje 250 osób w analizie i 6 pominiętych (braki) – ten N podaj w opisie. Block 0: Beginning Block to model z samą stałą: przypisuje wszystkich do częstszej grupy i trafia w 67.6% przypadków. Nie raportujesz go, to tylko punkt odniesienia. Właściwy model jest w części Block 1: Method = Enter.
Tabela 2. Omnibus Tests of Model Coefficients i Model Summary. Liczby policzone w R tymi samymi metodami co SPSS; układ tabel jak w SPSS.
| Chi-square | df | Sig. | ||
|---|---|---|---|---|
| Step 1 | Step | 58.616 | 4 | .000 |
| Block | 58.616 | 4 | .000 | |
| Model | 58.616 | 4 | .000 |
| Step | −2 Log likelihood | Cox & Snell R Square | Nagelkerke R Square |
|---|---|---|---|
| 1 | 256.308 | .209 | .292 |
Omnibus Tests to test ilorazu wiarygodności całego modelu: różnica dewiancji modelu z samą stałą (−2LL = 314.924) i modelu z predyktorami (256.308). Przy metodzie Enter wiersze Step, Block i Model są identyczne. Przepisz wiersz Model: χ²(4) = 58.62, p < .001.
Model Summary podaje dwa pseudo-R². R² Coxa i Snella nie może osiągnąć 1, dlatego Nagelkerke (1991) przeskalował je do zakresu 0–1. W pracy podaj jedną nazwaną miarę, zwykle R² Nagelkerkego = .29. Nie pisz, że model „wyjaśnia 29% wariancji”. Takie miary zależą od częstości zdarzenia i nie są odpowiednikiem R² z regresji liniowej (Menard, 2000). Samo −2LL przyda się przy porównaniu modeli zagnieżdżonych.
Krok 5. Hosmer and Lemeshow Test
Test dzieli osoby na mniej więcej 10 grup według przewidywanego prawdopodobieństwa (decyle ryzyka). Potem porównuje liczby zdarzeń obserwowanych i oczekiwanych z modelu (Hosmer i Lemeshow, 1980). W R odtworzyliśmy ten podział: 250 osób posortowanych rosnąco według prawdopodobieństwa, 10 grup po 25 osób. Remisy pozostają w tej samej grupie, ale w tych danych żaden nie wypadł na granicy grup. Przy remisach na granicach liczebności grup mogą się różnić, a z nimi wynik.
Tabela 3. Hosmer and Lemeshow Test i Contingency Table for Hosmer and Lemeshow Test. Liczby policzone w R tymi samymi metodami co SPSS; układ tabel jak w SPSS.
| Step | Chi-square | df | Sig. |
|---|---|---|---|
| 1 | 6.317 | 8 | .612 |
| rezygnacja = kontynuacja | rezygnacja = rezygnacja | Total | ||||
|---|---|---|---|---|---|---|
| Observed | Expected | Observed | Expected | |||
| Step 1 | 1 | 25 | 23.986 | 0 | 1.014 | 25 |
| 2 | 23 | 22.578 | 2 | 2.422 | 25 | |
| 3 | 19 | 21.641 | 6 | 3.359 | 25 | |
| 4 | 18 | 20.253 | 7 | 4.747 | 25 | |
| 5 | 20 | 18.804 | 5 | 6.196 | 25 | |
| 6 | 18 | 16.910 | 7 | 8.090 | 25 | |
| 7 | 16 | 15.043 | 9 | 9.957 | 25 | |
| 8 | 15 | 13.203 | 10 | 11.797 | 25 | |
| 9 | 10 | 10.625 | 15 | 14.375 | 25 | |
| 10 | 5 | 5.956 | 20 | 19.044 | 25 | |
Hipoteza zerowa mówi, że model jest dobrze dopasowany. Wynik χ²(8) = 6.32, p = .612 oznacza więc tylko brak dowodów złego dopasowania. Nie dowodzi, że model jest dobry. Przy małej próbie test ma małą moc, a przy bardzo dużej odrzuca prawie każdy model (Paul i in., 2013; zob. test Hosmera–Lemeshowa). Więcej powie tabela kontyngencji (rysunek 1).
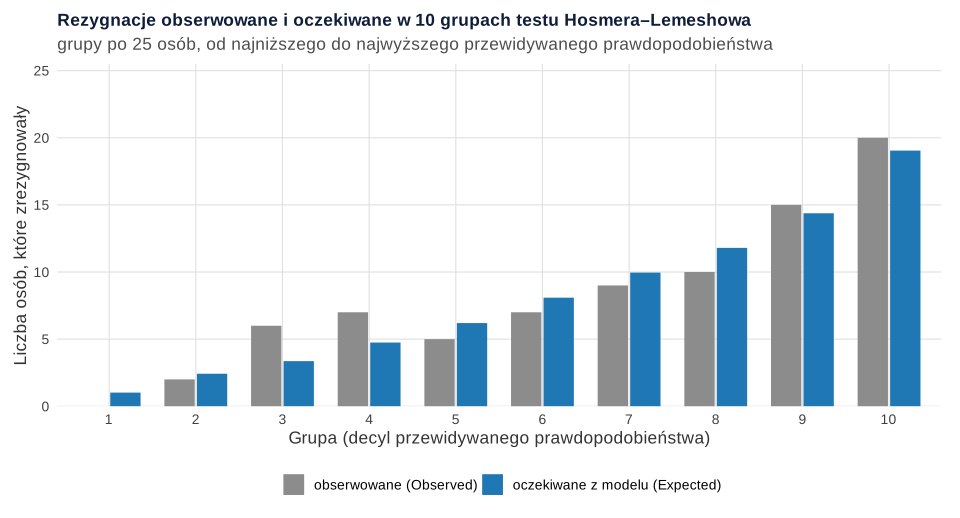
W ośmiu grupach liczby obserwowane i oczekiwane różnią się o mniej niż 2 osoby. Tylko w grupach 3 i 4 rezygnacji było o ponad 2 więcej, niż przewidywał model. Taki obraz uzupełnia kalibrację modelu, czyli zgodność przewidywań z odsetkami.
Krok 6. Classification Table
Tabela 4. Classification Table (Block 1, punkt odcięcia .500). Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| Observed | Predicted | |||
|---|---|---|---|---|
| kontynuacja | rezygnacja | Percentage Correct | ||
| Step 1 rezygnacja | kontynuacja | 153 | 16 | 90.5 |
| rezygnacja | 43 | 38 | 46.9 | |
| Overall Percentage | 76.4 | |||
Model trafnie zaklasyfikował 76.4% osób, wobec 67.6% w Block 0. Spośród 81 osób, które zrezygnowały, rozpoznał jednak tylko 38 (46.9%) – to czułość; swoistość wyniosła 90.5%. Oba odsetki zależą od punktu odcięcia i zmieniają się w przeciwnych kierunkach. Ocena na tych samych danych, na których dopasowano model, jest też zwykle zbyt optymistyczna (IBM Corp., b.d.). Zdolność modelu do rozróżniania grup niezależnie od progu lepiej opisuje pole pod krzywą ROC. Tu AUC = .78, policzone z zapisanych prawdopodobieństw.
Krok 7. Variables in the Equation
Tabela 5. Variables in the Equation. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| B | S.E. | Wald | df | Sig. | Exp(B) | 95% C.I. for EXP(B) | ||
|---|---|---|---|---|---|---|---|---|
| Lower | Upper | |||||||
| Step 1a zaangazowanie | −1.375 | .271 | 25.685 | 1 | .000 | .253 | .149 | .430 |
| praca | .057 | .012 | 20.953 | 1 | .000 | 1.058 | 1.033 | 1.084 |
| zamieszkanie | 9.106 | 2 | .011 | |||||
| zamieszkanie(1) | 1.049 | .396 | 7.034 | 1 | .008 | 2.855 | 1.315 | 6.200 |
| zamieszkanie(2) | .998 | .376 | 7.030 | 1 | .008 | 2.713 | 1.297 | 5.673 |
| Constant | 2.376 | .846 | 7.880 | 1 | .005 | 10.762 | ||
a. Variable(s) entered on step 1: zaangazowanie, praca, zamieszkanie.
- B to zmiana logitu, a Exp(B) to iloraz szans. Kolumna Wald to (B / S.E.)², czyli test Walda z 1 df (IBM Corp., b.d.).
- Zaangażowanie: OR = 0.25. Wzrost o 1 punkt skali zmniejsza szanse rezygnacji mniej więcej czterokrotnie, przy tej samej pracy i miejscu zamieszkania. Jeden punkt to jednak półtora odchylenia standardowego. Dla 0.5 punktu OR = e0.5 × (−1.375) = 0.50.
- Praca: OR = 1.06 na godzinę, czyli szanse rosną o 6% z każdą godziną. Dla 10 godzin tygodniowo OR = 1.0610 ≈ 1.76. Ilorazy szans się mnożą, a nie dodają.
- Wiersz „zamieszkanie” bez B to łączny test Walda całej zmiennej, Wald(2) = 9.11, p = .011. Od niego zacznij. Wiersze (1) i (2) porównują akademik (OR = 2.86) i wynajem (OR = 2.71) z mieszkaniem z rodzicami. Porównania akademika z wynajmem ta tabela nie zawiera. Uzyskasz je po zmianie kategorii odniesienia.
- Constant to logit przy zerowych predyktorach. Skala zaangażowania zaczyna się od 1, więc tego wiersza nie interpretujesz.
OR nie jest ryzykiem względnym, więc nie pisz, że wynajem „zwiększa prawdopodobieństwo 2.7 raza”. Skalę efektu pokażą prawdopodobieństwa. Osoba wynajmująca, która pracuje 20 godzin tygodniowo, ma przy zaangażowaniu 2.5 przewidywane prawdopodobieństwo rezygnacji .75, a przy zaangażowaniu 4.0 – .27. Gdy B i S.E. są ogromne, a estymacja kończy się po maksymalnej liczbie iteracji (domyślnie 20), podejrzewaj separację.
Zapis wyników w stylu APA
Peng i in. (2002) zalecają podać test całego modelu, miarę dopasowania, współczynniki z błędami standardowymi, Walda, p i OR oraz tabelę klasyfikacji. Tabelę przygotuj według wzoru tabeli regresji logistycznej w APA. Opisy innych analiz złożysz w generatorze opisu wyników APA.
Jeśli nie wiesz, czy Twoje pytanie wymaga regresji logistycznej, czy prostszego testu (np. chi-kwadrat w SPSS), sprawdź kreator doboru testu.
Te same liczby w R
SPSS nie był używany przy przygotowaniu tej strony. Wszystkie liczby z tabel 1–5 policzyliśmy w R tymi samymi metodami, których używa SPSS: model metodą największej wiarygodności z usuwaniem braków wierszami, kodowanie Indicator z pierwszą kategorią odniesienia, test omnibus jako różnicę −2LL, R² Coxa i Snella oraz Nagelkerkego ze wzorów, test Hosmera–Lemeshowa w 10 grupach według posortowanych prawdopodobieństw (remisy w jednej grupie), klasyfikację przy progu .5 (p ≥ .5), statystykę Walda jako (B / SE)², łączny test Walda dla zmiennej kategorialnej i przedziały ufności dla Exp(B) jako exp(B ± 1.96 × SE). Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych. Przepis 1 tworzy plik CSV i plik .sav (pakiet haven).
1. Dane: CSV i plik SPSS .sav z etykietami
R
# B292 – dane przykładowe: rezygnacja ze studiów po pierwszym roku (dane symulowane, set.seed(2921))
# 256 osób; plik CSV i plik SPSS .sav z etykietami zmiennych i wartości
suppressPackageStartupMessages(library(haven))
set.seed(2921)
n <- 256
zamieszkanie <- sample(1:3, n, replace = TRUE, prob = c(.35, .30, .35))   # 1 = z rodzicami, 2 = akademik, 3 = wynajem
zaangazowanie <- round(pmin(pmax(rnorm(n, 3.4, 0.7), 1), 5), 2)          # zaangażowanie w naukę, średnia 1–5
praca <- ifelse(runif(n) < .45, 0, round(pmin(rgamma(n, shape = 3, rate = 0.15), 40)))  # godziny pracy zarobkowej tygodniowo
logit <- -1.9 - 1.2 * (zaangazowanie - 3.4) + 0.05 * praca + 0.35 * (zamieszkanie == 2) + 0.85 * (zamieszkanie == 3)
rezygnacja <- rbinom(n, 1, plogis(logit))                                 # 1 = rezygnacja po I roku, 0 = kontynuacja
zaangazowanie[sample(1:n, 6)] <- NA                                        # braki: 6 osób nie wypełniło skali
dane <- data.frame(id = 1:n, rezygnacja, zaangazowanie, praca, zamieszkanie)
write.csv(dane, "../regresja-logistyczna-spss-dane.csv", row.names = FALSE, na = "")

sav <- dane
attr(sav$id, "label") <- "Numer osoby"
sav$rezygnacja <- labelled(sav$rezygnacja, c("kontynuacja" = 0, "rezygnacja" = 1), label = "Rezygnacja ze studiów po I roku")
attr(sav$zaangazowanie, "label") <- "Zaangażowanie w naukę (średnia 1–5)"
attr(sav$praca, "label") <- "Praca zarobkowa – godziny tygodniowo"
sav$zamieszkanie <- labelled(sav$zamieszkanie, c("z rodzicami" = 1, "akademik" = 2, "wynajem" = 3), label = "Miejsce zamieszkania")
write_sav(sav, "../regresja-logistyczna-spss-dane.sav")

summary(dane[, -1])
table(rezygnacja = dane$rezygnacja, zamieszkanie = dane$zamieszkanie)
round(sapply(dane[, c("zaangazowanie", "praca")], function(x) c(M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE), n = sum(!is.na(x)))), 2)
Wynik w R
   rezygnacja     zaangazowanie       praca        zamieszkanie
 Min.   :0.0000   Min.   :1.440   Min.   : 0.00   Min.   :1.000
 1st Qu.:0.0000   1st Qu.:2.902   1st Qu.: 0.00   1st Qu.:1.000
 Median :0.0000   Median :3.315   Median : 5.50   Median :2.000
 Mean   :0.3203   Mean   :3.332   Mean   :10.44   Mean   :1.973
 3rd Qu.:1.0000   3rd Qu.:3.790   3rd Qu.:19.00   3rd Qu.:3.000
 Max.   :1.0000   Max.   :5.000   Max.   :40.00   Max.   :3.000
                  NA's   :6
          zamieszkanie
rezygnacja  1  2  3
         0 76 44 54
         1 20 27 35
   zaangazowanie  praca
M           3.33  10.44
SD          0.66  12.52
n         250.00 256.00
2. Binary Logistic: wszystkie tabele wydruku
R
# Binary Logistic (metoda Enter): rezygnacja ~ zaangazowanie + praca + zamieszkanie
# zamieszkanie jako zmienna kategorialna, kontrast Indicator, kategoria odniesienia: pierwsza (z rodzicami)
dane <- read.csv("../regresja-logistyczna-spss-dane.csv")
# Case Processing Summary: osoby z brakiem w którejkolwiek zmiennej modelu są pomijane
d <- na.omit(dane[, c("id", "rezygnacja", "zaangazowanie", "praca", "zamieszkanie")])
c(Included = nrow(d), Missing = nrow(dane) - nrow(d), Total = nrow(dane))
d$zamieszkanie <- factor(d$zamieszkanie, levels = 1:3, labels = c("z rodzicami", "akademik", "wynajem"))
# Categorical Variables Codings: liczebności i kodowanie parametrów (1), (2)
cbind(Frequency = table(d$zamieszkanie), contrasts(d$zamieszkanie))
# Block 0: model z samą stałą
m0 <- glm(rezygnacja ~ 1, family = binomial, data = d)
b0 <- coef(summary(m0))
round(c(B = b0[1, 1], SE = b0[1, 2], Wald = (b0[1, 1] / b0[1, 2])^2, Sig = 2 * pnorm(-abs(b0[1, 3])),
        ExpB = exp(b0[1, 1]), Procent_poprawnych = 100 * mean(d$rezygnacja == 0)), 3)
# Block 1: pełny model
m <- glm(rezygnacja ~ zaangazowanie + praca + zamieszkanie, family = binomial, data = d)
n <- nrow(d)
# Omnibus Tests of Model Coefficients (Step = Block = Model przy metodzie Enter)
chi2 <- m$null.deviance - m$deviance; df_m <- m$df.null - m$df.residual
round(c(Chi_square = chi2, df = df_m), 3)
signif(pchisq(chi2, df_m, lower.tail = FALSE), 3)
# Model Summary: -2 Log likelihood, Cox & Snell R Square, Nagelkerke R Square
cs <- 1 - exp(-chi2 / n); nk <- cs / (1 - exp(-m$null.deviance / n))
round(c(minus2LL_0 = m$null.deviance, minus2LL = m$deviance, CoxSnell = cs, Nagelkerke = nk), 3)
# Hosmer and Lemeshow Test: osoby posortowane rosnąco według przewidywanego prawdopodobieństwa,
# podział na 10 grup możliwie równej liczebności (decyle ryzyka), remisy zawsze w tej samej grupie
p <- fitted(m); o <- order(p); ps <- p[o]; ys <- d$rezygnacja[o]
cat("Remisy w przewidywanych prawdopodobieństwach:", sum(duplicated(round(ps, 10))), "\n")
granice <- round(n * (1:10) / 10)
grupa <- integer(n); start <- 1
for (g in 1:10) {
  koniec <- granice[g]
  while (koniec < n && isTRUE(all.equal(ps[koniec], ps[koniec + 1]))) koniec <- koniec + 1  # remisy razem
  if (koniec >= start) grupa[start:koniec] <- g
  start <- koniec + 1
}
tab_hl <- data.frame(Group = 1:max(grupa),
                     Obs_0 = tapply(1 - ys, grupa, sum), Exp_0 = tapply(1 - ps, grupa, sum),
                     Obs_1 = tapply(ys, grupa, sum), Exp_1 = tapply(ps, grupa, sum),
                     Total = tapply(ys, grupa, length))
print(transform(tab_hl, Exp_0 = round(Exp_0, 3), Exp_1 = round(Exp_1, 3)), row.names = FALSE)
hl <- sum((tab_hl$Obs_1 - tab_hl$Exp_1)^2 / tab_hl$Exp_1 + (tab_hl$Obs_0 - tab_hl$Exp_0)^2 / tab_hl$Exp_0)
df_hl <- nrow(tab_hl) - 2
round(c(Chi_square = hl, df = df_hl, Sig = pchisq(hl, df_hl, lower.tail = FALSE)), 3)
# Classification Table (punkt odcięcia .5)
pred <- as.integer(p >= .5)   # CUT: przypisanie do grupy 1, gdy p ≥ .5
kl <- table(Observed = d$rezygnacja, Predicted = pred); print(kl)
round(c(Proc_0 = 100 * kl[1, 1] / sum(kl[1, ]), Proc_1 = 100 * kl[2, 2] / sum(kl[2, ]),
        Overall = 100 * mean(pred == d$rezygnacja)), 1)
# Variables in the Equation: B, S.E., Wald, df, Sig., Exp(B) i 95% C.I. for EXP(B) (przedział Walda)
s <- coef(summary(m))
B <- s[, 1]; SE <- s[, 2]; Wald <- (B / SE)^2
tab <- cbind(B = B, SE = SE, Wald = Wald, df = 1, Sig = pchisq(Wald, 1, lower.tail = FALSE), ExpB = exp(B),
             Lower = exp(B - qnorm(.975) * SE), Upper = exp(B + qnorm(.975) * SE))
print(round(tab[c(2, 3, 4, 5, 1), ], 3))
signif(tab[, "Sig"], 3)
# Łączny test Walda dla zmiennej zamieszkanie (2 df) – wiersz „zamieszkanie” w SPSS
k <- c("zamieszkanieakademik", "zamieszkaniewynajem")
w2 <- drop(t(B[k]) %*% solve(vcov(m)[k, k]) %*% B[k])
round(c(Wald = w2, df = 2, Sig = pchisq(w2, 2, lower.tail = FALSE)), 3)
# Przewidywane prawdopodobieństwa dla dwóch przykładowych osób (wynajem, praca 20 h, zaangażowanie 2.5 i 4.0)
round(predict(m, newdata = data.frame(zaangazowanie = c(2.5, 4.0), praca = 20, zamieszkanie = "wynajem"), type = "response"), 3)
# Ilorazy szans dla zmiany o 0.5 punktu zaangażowania i o 10 godzin pracy
round(c(OR_zaang_0.5 = exp(0.5 * B[["zaangazowanie"]]), OR_praca_10h = exp(10 * B[["praca"]])), 3)
# Kontrola: test ilorazu wiarygodności dla zamieszkania (model bez tej zmiennej)
m_bez <- update(m, . ~ . - zamieszkanie)
lr <- m_bez$deviance - m$deviance
round(c(LR_chi2 = lr, df = 2, p = pchisq(lr, 2, lower.tail = FALSE)), 3)
# AUC (pole pod krzywą ROC) z przewidywanych prawdopodobieństw
r <- rank(p); n1 <- sum(d$rezygnacja); n0 <- n - n1
round(c(AUC = (sum(r[d$rezygnacja == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0)), 3)
Wynik w R
Included  Missing    Total
     250        6      256
            Frequency akademik wynajem
z rodzicami        94        0       0
akademik           68        1       0
wynajem            88        0       1
                 B                 SE               Wald                Sig               ExpB
            -0.735              0.135             29.617              0.000              0.479
Procent_poprawnych
            67.600
Chi_square         df
    58.616      4.000
[1] 5.66e-12
minus2LL_0   minus2LL   CoxSnell Nagelkerke
   314.924    256.308      0.209      0.292
Remisy w przewidywanych prawdopodobieństwach: 10
 Group Obs_0  Exp_0 Obs_1  Exp_1 Total
     1    25 23.986     0  1.014    25
     2    23 22.578     2  2.422    25
     3    19 21.641     6  3.359    25
     4    18 20.253     7  4.747    25
     5    20 18.804     5  6.196    25
     6    18 16.910     7  8.090    25
     7    16 15.043     9  9.957    25
     8    15 13.203    10 11.797    25
     9    10 10.625    15 14.375    25
    10     5  5.956    20 19.044    25
Chi_square         df        Sig
     6.317      8.000      0.612
        Predicted
Observed   0   1
       0 153  16
       1  43  38
 Proc_0  Proc_1 Overall
   90.5    46.9    76.4
                          B    SE   Wald df   Sig   ExpB Lower  Upper
zaangazowanie        -1.375 0.271 25.685  1 0.000  0.253 0.149  0.430
praca                 0.057 0.012 20.953  1 0.000  1.058 1.033  1.084
zamieszkanieakademik  1.049 0.396  7.034  1 0.008  2.855 1.315  6.200
zamieszkaniewynajem   0.998 0.376  7.030  1 0.008  2.713 1.297  5.673
(Intercept)           2.376 0.846  7.880  1 0.005 10.762 2.048 56.547
         (Intercept)        zaangazowanie                praca zamieszkanieakademik
            5.00e-03             4.02e-07             4.71e-06             8.00e-03
 zamieszkaniewynajem
            8.02e-03
 Wald    df   Sig
9.106 2.000 0.011
    1     2
0.745 0.271
OR_zaang_0.5 OR_praca_10h
       0.503        1.763
LR_chi2      df       p
  9.800   2.000   0.007
  AUC
0.777
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja glm z pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files (R package version 2.5.5) [Computer software]. https://CRAN.R-project.org/package=haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w regresji logistycznej w SPSS
- Zmienna nominalna bez okna Categorical. SPSS potraktuje kody 1–3 jak liczby i policzy jeden „efekt miejsca zamieszkania” na jednostkę kodu.
- Nieznana kategoria odniesienia – podaj ją w tekście.
- Zapomniane CI for exp(B) i zapis p = .000 zamiast p < .001.
- „Model wyjaśnia 29% wariancji” na podstawie R² Nagelkerkego oraz traktowanie nieistotnego testu Hosmera–Lemeshowa jako dowodu dobrego modelu.
- Sam ogólny odsetek trafnych klasyfikacji, bez Block 0 i czułości.
Ustawienia modelu i opis wyników sprawdzimy w ramach oferty analizy statystyczne dla studentów. Wynik o kilku kategoriach wymaga innej analizy, np. regresji wielomianowej albo regresji porządkowej.
Najczęstsze pytania
Gdzie w SPSS jest regresja logistyczna i co w niej zaznaczyć?
Wybierz Analyze → Regression → Binary Logistic, przenieś zmienną 0/1 do Dependent, a predyktory do Covariates. Zmienne nominalne wskaż w oknie Categorical, a w Options zaznacz Hosmer-Lemeshow goodness-of-fit i CI for exp(B) (IBM Corp., b.d.). Kliknij Paste, żeby zachować składnię.
Która kategoria jest kategorią odniesienia w SPSS?
Dokumentacja IBM nie jest tu spójna: w wersji 26 domyślnie była to ostatnia kategoria, a dokumentacja wersji 31 i 32 podaje pierwszą. Dlatego w oknie Categorical wybierz First albo Last i kliknij Change, a potem sprawdź tabelę Categorical Variables Codings – kategoria odniesienia ma same zera.
Jak interpretować Exp(B) w SPSS?
Exp(B) to iloraz szans. Wartość 0.25 przy zaangażowaniu oznacza, że wzrost o punkt zmniejsza szanse rezygnacji mniej więcej czterokrotnie przy stałych pozostałych predyktorach, a 2.71 przy „wynajmie” – że szanse są 2.71 raza większe niż w kategorii odniesienia. To nie jest iloraz prawdopodobieństw.
Co oznacza nieistotny test Hosmera–Lemeshowa?
Brak dowodów na złe dopasowanie, a nie dowód dobrego modelu. W przykładzie χ²(8) = 6.32, p = .612. Test ma małą moc w małych próbach i odrzuca prawie każdy model w bardzo dużych, więc obejrzyj też tabelę liczebności obserwowanych i oczekiwanych w grupach.
Które pseudo-R² podać z wydruku SPSS?
SPSS podaje R² Coxa i Snella oraz Nagelkerkego. Zwykle raportuje się Nagelkerkego, bo sięga od 0 do 1. Podaj nazwę miary i nie pisz, że model wyjaśnia określony procent wariancji.
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikKorelacja i regresja w SPSS
Bivariate i Linear Regression krok po kroku: które opcje zaznaczyć, jak czytać Model Summary, Coefficients i Collinearity Diagnostics, wykresy reszt i zapis APA.
Czytaj →Masz wydruk regresji logistycznej z SPSS i nie wiesz, co z niego przepisać?
Sprawdzimy kodowanie zmiennych, kategorię odniesienia i dopasowanie modelu oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hosmer, D. W., & Lemeshow, S. (1980). Goodness of fit tests for the multiple logistic regression model. Communications in Statistics – Theory and Methods, 9(10), 1043–1069. https://doi.org/10.1080/03610928008827941
- IBM Corp. (b.d.). Logistic Regression (Define Categorical Variables, Save New Variables, Options); LOGISTIC REGRESSION command; Using Binary Logistic Regression to Assess Credit Risk. IBM SPSS Statistics 32.0.0 documentation. Pobrano 1 listopada 2026 z https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=regression-logistic ● Otwarty dostęp
- Menard, S. (2000). Coefficients of determination for multiple logistic regression analysis. The American Statistician, 54(1), 17–24. https://doi.org/10.1080/00031305.2000.10474502
- Nagelkerke, N. J. D. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Paul, P., Pennell, M. L., & Lemeshow, S. (2013). Standardizing the power of the Hosmer–Lemeshow goodness of fit test in large data sets. Statistics in Medicine, 32(1), 67–80. https://doi.org/10.1002/sim.5525
- Peng, C.-Y. J., Lee, K. L., & Ingersoll, G. M. (2002). An introduction to logistic regression analysis and reporting. The Journal of Educational Research, 96(1), 3–14. https://doi.org/10.1080/00220670209598786
- van Smeden, M., de Groot, J. A. H., Moons, K. G. M., Collins, G. S., Altman, D. G., Eijkemans, M. J. C., & Reitsma, J. B. (2016). No rationale for 1 variable per 10 events criterion for binary logistic regression analysis. BMC Medical Research Methodology, 16(1), Article 163. https://doi.org/10.1186/s12874-016-0267-3 ● Otwarty dostęp
Cytowania BibTeX
@article{hosmer1980goodness, author={Hosmer, David W. and Lemeshow, Stanley}, title={{Goodness of fit tests for the multiple logistic regression model}}, journal={Communications in Statistics – Theory and Methods}, year={1980}, volume={9}, number={10}, pages={1043--1069}, doi={10.1080/03610928008827941}}@misc{ibmnd32regresjalogistyczna, author={{IBM Corp.}}, title={{Logistic Regression (Define Categorical Variables, Save New Variables, Options); LOGISTIC REGRESSION command; Using Binary Logistic Regression to Assess Credit Risk}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=regression-logistic}}@article{menard2000coefficients, author={Menard, Scott}, title={{Coefficients of determination for multiple logistic regression analysis}}, journal={The American Statistician}, year={2000}, volume={54}, number={1}, pages={17--24}, doi={10.1080/00031305.2000.10474502}}@article{nagelkerke1991note, author={Nagelkerke, N. J. D.}, title={{A note on a general definition of the coefficient of determination}}, journal={Biometrika}, year={1991}, volume={78}, number={3}, pages={691--692}, doi={10.1093/biomet/78.3.691}}@article{paul2013standardizing, author={Paul, Prabasaj and Pennell, Michael L. and Lemeshow, Stanley}, title={{Standardizing the power of the Hosmer–Lemeshow goodness of fit test in large data sets}}, journal={Statistics in Medicine}, year={2013}, volume={32}, number={1}, pages={67--80}, doi={10.1002/sim.5525}}@article{peng2002introduction, author={Peng, Chao-Ying Joanne and Lee, Kuk Lida and Ingersoll, Gary M.}, title={{An introduction to logistic regression analysis and reporting}}, journal={The Journal of Educational Research}, year={2002}, volume={96}, number={1}, pages={3--14}, doi={10.1080/00220670209598786}}@article{vansmeden2016no, author={van Smeden, Maarten and de Groot, Joris A. H. and Moons, Karel G. M. and Collins, Gary S. and Altman, Douglas G. and Eijkemans, Marinus J. C. and Reitsma, Johannes B.}, title={{No rationale for 1 variable per 10 events criterion for binary logistic regression analysis}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={163}, doi={10.1186/s12874-016-0267-3}}