Korelacja czy regresja: na jakie pytanie odpowiadasz
Korelacja Pearsona mówi, jak silnie i w jakim kierunku dwie zmienne ilościowe wiążą się liniowo. Regresja liniowa idzie krok dalej: przewiduje jedną zmienną (zależną) na podstawie kilku predyktorów naraz i pokazuje, ile każdy z nich wnosi przy kontroli pozostałych. W pracy zwykle robisz obie analizy. Obie analizy na danych z jednego pomiaru opisują współwystępowanie, a nie przyczynę (zob. korelacja a przyczynowość).
Ten wpis pokazuje, co kliknąć w SPSS i co z tego wynika. Ogólne zasady czytania wydruków omawia osobny poradnik jak czytać wyniki z SPSS, a teorię regresji – regresja wieloraka krok po kroku (z kodem w R). Ścieżki menu podajemy po angielsku, tak jak w dokumentacji IBM dla wersji 32 (IBM Corp., b.d.). W polskiej wersji interfejsu nazwy mogą się różnić.
Przykład. 184 osoby studiujące (dane symulowane) podały, ile godzin tygodniowo uczyły się do egzaminu ze statystyki (nauka), wypełniły skalę lęku przed egzaminem 10–50 (lek) i podały średni czas snu w tygodniu przed egzaminem (sen). Zmienna zależna to wynik egzaminu 0–100 punktów (wynik). Cztery osoby nie wypełniły skali lęku, a sześć nie podało czasu snu. Dane pobierzesz jako plik SPSS .sav (z etykietami zmiennych i wartości) albo plik CSV.
Przygotowanie danych w widoku zmiennych
Zanim otworzysz okna analiz, sprawdź zakładkę Variable View. Zmienne do korelacji i regresji muszą być liczbowe (Numeric), a w kolumnie Measure warto oznaczyć je jako Scale. Tryb studiów (tryb: 1 = stacjonarne, 2 = niestacjonarne) to zmienna nominalna – do regresji wprowadziłbyś ją dopiero jako zmienną 0–1. Braki zostaw puste albo zdefiniuj jako braki użytkownika. Niezdefiniowany kod 99 SPSS policzy jak prawdziwy wynik. Szczegóły – etykiety, braki i liczenie wyniku skali – opisuje wpis przygotowanie danych w SPSS.
Statystyki opisowe w przykładzie: nauka M = 6.83 (SD = 3.43), lęk M = 32.53 (SD = 6.78), sen M = 6.75 (SD = 0.82), wynik M = 57.62 (SD = 11.48).
Krok 1. Korelacje: Analyze → Correlate → Bivariate
- Wybierz Analyze → Correlate → Bivariate i przenieś do listy Variables zmienne
nauka,lek,seniwynik. - W Correlation Coefficients zostaw Pearson. Kendall’s tau-b i Spearman są przeznaczone dla danych porządkowych albo wyraźnie nienormalnych (IBM Corp., b.d.). Wybór miary omawia wpis korelacja Pearsona i Spearmana krok po kroku.
- W Test of Significance zostaw Two-tailed. Test jednostronny wybieraj tylko wtedy, gdy kierunek związku zapisałeś w hipotezie przed zebraniem danych.
- Kliknij Confidence Interval i zaznacz szacowanie przedziału ufności (domyślnie 95%). W Options zostaw Exclude cases pairwise.
Tabela 1. Correlations. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| nauka | lek | sen | wynik | ||
|---|---|---|---|---|---|
| nauka | Pearson Correlation | 1 | −.138 | −.019 | .501** |
| Sig. (2-tailed) | .064 | .800 | .000 | ||
| N | 184 | 180 | 178 | 184 | |
| lek | Pearson Correlation | −.138 | 1 | −.101 | −.309** |
| Sig. (2-tailed) | .064 | .185 | .000 | ||
| N | 180 | 180 | 174 | 180 | |
| sen | Pearson Correlation | −.019 | −.101 | 1 | .233** |
| Sig. (2-tailed) | .800 | .185 | .002 | ||
| N | 178 | 174 | 178 | 178 | |
| wynik | Pearson Correlation | .501** | −.309** | .233** | 1 |
| Sig. (2-tailed) | .000 | .000 | .002 | ||
| N | 184 | 180 | 178 | 184 |
Czytasz połowę macierzy; dwie gwiazdki oznaczają p < .01. Najsilniej z wynikiem wiązała się nauka, r = .50. Lęk wiązał się z wynikiem ujemnie (r = −.31), a sen dodatnio (r = .23). Predyktory słabo korelowały ze sobą (od −.14 do −.02), co zapowiada brak problemu ze współliniowością.
Zwróć uwagę na wiersz N. Korelacja nauki z wynikiem opiera się na 184 osobach, a lęku ze snem – na 174. Przy usuwaniu braków parami każda para korzysta ze wszystkich osób z kompletem danych w tej parze, więc współczynniki mogą pochodzić z różnych podgrup (IBM Corp., b.d.). W pracy podaj zakres N w nocie pod tabelą. Zamiast przepisywać tę macierz, przygotuj tabelę korelacji w APA – wskazówki daje wpis jak opisać tabelę korelacji.
Przedział ufności Fishera dla korelacji nauki z wynikiem to 95% CI [.38, .60]. Pearson zakłada liniowość i jest wrażliwy na obserwacje odstające; przy skośnych danych lepiej sprawdzają się inne metody (Bishara i Hittner, 2012; Schober i in., 2018).
Krok 2. Okno Analyze → Regression → Linear
- Zmienne. Przenieś
wynikdo pola Dependent, anauka,lekisendo Independent(s). - Metoda. Zostaw Enter, czyli wszystkie predyktory w jednym kroku. Metody Stepwise, Forward i Backward wybierają zmienne za Ciebie. Wartości istotności są wtedy na ogół nieprawidłowe, bo wydruk traktuje wynik selekcji jak jeden z góry zaplanowany model (IBM, 2026; zob. metoda krokowa). Jeśli predyktory wchodzą w blokach, użyj przycisku Next – opisuje to regresja hierarchiczna krok po kroku.
- Statistics. Zostaw Estimates i Model fit. Dodaj Confidence intervals (95%), Collinearity diagnostics i Casewise diagnostics z progiem 3 odchyleń standardowych. Durbin-Watson zaznacz tylko wtedy, gdy obserwacje mają naturalny porządek w czasie.
- Plots. Przenieś *ZRESID na oś Y, a *ZPRED na oś X. Zaznacz histogram i wykres normalności reszt (Normal probability plot). Dokumentacja IBM zaleca ten wykres rozrzutu do sprawdzenia liniowości i równości wariancji (IBM Corp., b.d.).
- Save. Zaznacz odległość Cooka i reszty standaryzowane. SPSS dopisze je jako nowe kolumny.
- Zamiast OK kliknij Paste. Polecenie trafi do okna składni, gdzie je uruchomisz i zapiszesz.
Składnia do wklejenia
Poniższe polecenia zbudowaliśmy według Command Syntax Reference IBM dla CORRELATIONS i REGRESSION (IBM Corp., b.d.). Odpowiadają ustawieniom z kroków 1–2. Nie uruchamialiśmy ich w SPSS. Liczby na tej stronie pochodzą z R.
CORRELATIONS
/VARIABLES=nauka lek sen wynik
/PRINT=TWOTAIL
/CI CILEVEL=95
/MISSING=PAIRWISE.
* Regresja liniowa (Enter) z VIF, diagnostyką przypadków i wykresami reszt.
REGRESSION
/MISSING=LISTWISE
/STATISTICS=COEFF OUTS CI(95) R ANOVA COLLIN TOL
/CRITERIA=PIN(.05) POUT(.10)
/NOORIGIN
/DEPENDENT=wynik
/METHOD=ENTER nauka lek sen
/SCATTERPLOT (*ZRESID,*ZPRED)
/RESIDUALS=HISTOGRAM(ZRESID) NORMPROB(ZRESID)
/CASEWISE=PLOT(ZRESID) OUTLIERS(3)
/SAVE=COOK ZRESID.
Krok 3. Tabele regresji: co przepisać, a co pominąć
Regresja objęła 174 osoby, a nie 184, bo REGRESSION domyślnie usuwa każdy wiersz z brakiem w którejkolwiek zmiennej modelu (IBM Corp., b.d.). Tę liczbę podaj w opisie wyników.
Tabela 2. Model Summary i ANOVA. Liczby policzone w R tymi samymi metodami co SPSS; układ tabel jak w SPSS.
| Model | R | R Square | Adjusted R Square | Std. Error of the Estimate |
|---|---|---|---|---|
| 1 | .600 | .360 | .349 | 9.233 |
| Model | Sum of Squares | df | Mean Square | F | Sig. | |
|---|---|---|---|---|---|---|
| 1 | Regression | 8154.715 | 3 | 2718.238 | 31.885 | .000 |
| Residual | 14492.641 | 170 | 85.251 | |||
| Total | 22647.356 | 173 |
Model Summary: przepisz R² = .36 i skorygowane R² = .35 (zob. R² skorygowany). Trzy predyktory wyjaśniały razem 36% wariancji wyniku. Kolumny R zwykle się nie raportuje. ANOVA: to test całego modelu, F(3, 170) = 31.89. Sig. = .000 zapisz jako p < .001, nigdy jako p = .000.
Tabela 3. Coefficients. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| Model 1 | Unstandardized Coefficients | Standardized Coefficients | t | Sig. | 95.0% Confidence Interval for B | Collinearity Statistics | |||
|---|---|---|---|---|---|---|---|---|---|
| B | Std. Error | Beta | Lower Bound | Upper Bound | Tolerance | VIF | |||
| (Constant) | 35.836 | 7.286 | 4.919 | .000 | 21.454 | 50.219 | |||
| nauka | 1.641 | .212 | .478 | 7.739 | .000 | 1.223 | 2.060 | .985 | 1.015 |
| lek | −.358 | .105 | −.212 | −3.411 | .001 | −.566 | −.151 | .975 | 1.025 |
| sen | 3.270 | .852 | .237 | 3.839 | .000 | 1.588 | 4.951 | .989 | 1.011 |
Kolumna B to b w jednostkach zmiennych. Każda dodatkowa godzina nauki tygodniowo wiązała się z wynikiem wyższym średnio o 1.64 punktu przy tym samym lęku i śnie. Kolumna Beta (β) pokazuje to samo w odchyleniach standardowych, więc pozwala porównać predyktory mierzone na różnych skalach. Kiedy raportować którą, wyjaśnia wpis współczynniki standaryzowane czy niestandaryzowane. Wiersz (Constant) to przewidywany wynik przy zerowych predyktorach; jego Sig. nie testuje żadnej hipotezy. Przy lęku Sig. = .001 to zaokrąglenie z p = .0008, dlatego w tekście piszesz p < .001.
Tolerance i VIF pochodzą z opcji Collinearity diagnostics. VIF bliskie 1 (tu 1.01–1.03) oznacza, że predyktory prawie się nie pokrywają. Sztywnych progów typu „VIF powyżej 10” nie stosuj mechanicznie. Wariancja współczynnika zależy też od liczebności próby i R² modelu (O’Brien, 2007). Co robić przy wysokim VIF, opisuje wpis wysoki VIF – co zrobić.
Tabela 4. Collinearity Diagnostics. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| Model | Dimension | Eigenvalue | Condition Index | Variance Proportions | |||
|---|---|---|---|---|---|---|---|
| (Constant) | nauka | lek | sen | ||||
| 1 | 1 | 3.803 | 1.000 | .00 | .01 | .00 | .00 |
| 2 | .160 | 4.878 | .00 | .90 | .03 | .01 | |
| 3 | .032 | 10.961 | .02 | .05 | .74 | .16 | |
| 4 | .006 | 25.341 | .98 | .04 | .22 | .83 | |
Ostatni wymiar ma wysoki wskaźnik uwarunkowania (25.34). SPSS liczy ją jednak na niecentrowanej macierzy razem ze stałą (IBM Corp., b.d.). Ostatni wiersz łączy więc stałą (.98) ze snem (.83), a ich związek wynika tylko z tego, że sen zawsze ma wartości daleko od zera (4.9–9 godzin). Po wycentrowaniu predyktorów najwyższy wskaźnik spada do 1.17, a VIF się nie zmienia. Tabela ma znaczenie dopiero wtedy, gdy wysoki wskaźnik łączy dwa predyktory, a nie predyktor ze stałą; zwykle wystarczy podać VIF.
Krok 4. Wykresy reszt i obserwacje nietypowe
Założenia regresji dotyczą reszt, a nie rozkładów samych zmiennych (Williams i in., 2013). W przeglądzie badań z psychologii klinicznej większość artykułów nie raportowała jasno, czy założenia sprawdzono (Ernst i Albers, 2017). Rysunek 1 pokazuje odpowiedniki dwóch wykresów z okna Plots. To wykresy z R, nie zrzuty ekranu z SPSS.
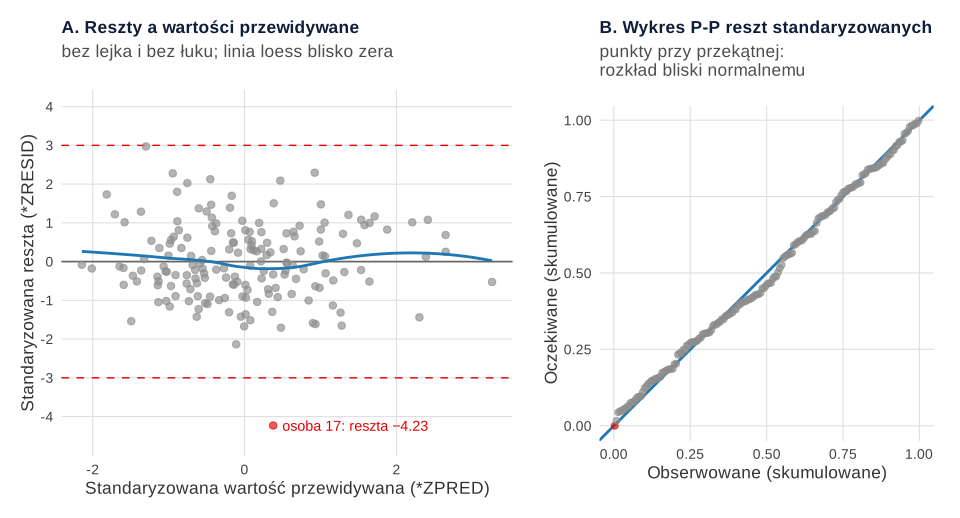
Panel A sprawdza liniowość i homoskedastyczność. Łuk sugerowałby nieliniowość, a lejek – niestałą wariancję; tu widać chmurę bez wzoru. Panel B porównuje rozkład reszt z rozkładem normalnym. Punkty leżą przy przekątnej, a największe odchylenie wynosi .047. Kiedy normalność reszt ma znaczenie, wyjaśnia wpis normalność reszt czy zmiennych.
Tabela Casewise Diagnostics wskazała jedną osobę z resztą standaryzowaną poza ±3. Osoba nr 17 uczyła się 7.6 godziny tygodniowo, a model przewidywał dla niej 60.06 punktu. Uzyskała jednak 21 punktów (Residual = −39.06, Std. Residual = −4.23). Duża reszta nie znaczy jeszcze, że osoba zmienia wyniki. Jej odległość Cooka, czyli miara wpływu obserwacji na współczynniki (Cook, 1977), wyniosła .032, a największa w próbie .066. Bez tej osoby R² rośnie z .36 do .39, ale b dla nauki zmienia się tylko z 1.64 na 1.66. Nie usuwaj jej po cichu. Sprawdź, czy to błąd danych (np. przerwany egzamin), i opisz analizę wrażliwości (zob. czy można usunąć obserwacje odstające). Pełną diagnostykę z dźwignią i DFBETAS pokazuje wpis diagnostyka regresji w R.
Zapis wyników w stylu APA
Wzory zawierają liczby z przykładu. Korelację zapisuj ze stopniami swobody (N − 2), a regresję z R², testem F i współczynnikami predyktorów. Tabelę współczynników przygotuj według wzoru tabeli regresji w APA. Zdania do innych wyników złożysz w generatorze opisu wyników APA.
Jeśli nie masz pewności, czy Twoje pytanie wymaga korelacji, regresji, czy innego testu, sprawdź kreator doboru testu.
Te same liczby w R
SPSS nie był używany przy przygotowaniu tej strony. Wszystkie liczby z tabel 1–4 policzyliśmy w R tymi samymi metodami, których używa SPSS: korelacje Pearsona z dwustronnym p i usuwaniem braków parami, przedział ufności Fishera, regresję metodą najmniejszych kwadratów z usuwaniem braków wierszami, β jako b × SDx / SDy, tolerancję i VIF z pakietu car oraz diagnostykę współliniowości na przeskalowanej, niecentrowanej macierzy predyktorów ze stałą. Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych. Przepis 1 tworzy plik CSV i plik .sav (pakiet haven).
1. Dane: CSV i plik SPSS .sav z etykietami
R
# B266 – dane przykładowe: wynik egzaminu ze statystyki a nauka, lęk i sen (dane symulowane, set.seed(2661))
# 184 osoby studiujące; plik CSV i plik SPSS .sav z etykietami zmiennych i wartości
suppressPackageStartupMessages(library(haven))
set.seed(2661)
n <- 184
tryb  <- sample(1:2, n, replace = TRUE, prob = c(.7, .3))           # 1 = stacjonarne, 2 = niestacjonarne
nauka <- round(pmin(pmax(rgamma(n, shape = 4, rate = 0.6), 0), 20), 1)  # godziny nauki tygodniowo
lek   <- round(pmin(pmax(36 - 0.55 * nauka + rnorm(n, 0, 7), 10), 50)) # lęk przed egzaminem (10–50)
sen   <- round(pmin(pmax(rnorm(n, 6.8, 0.9), 4), 9.5), 1)             # średni sen w tygodniu przed egzaminem (godz.)
wynik <- round(pmin(pmax(38 + 1.7 * nauka - 0.42 * lek + 3.2 * sen + rnorm(n, 0, 9.5), 0), 100))
wynik[17] <- 21                                                        # osoba, która przerwała egzamin
lek[sample(setdiff(1:n, 17), 4)] <- NA                                               # braki: nie wypełniono skali lęku
sen[sample(setdiff(1:n, 17), 6)] <- NA                                               # braki: nie podano czasu snu
dane <- data.frame(id = 1:n, tryb, nauka, lek, sen, wynik)
write.csv(dane, "../korelacja-regresja-spss-dane.csv", row.names = FALSE, na = "")

sav <- dane
sav$tryb  <- labelled(sav$tryb, c("stacjonarne" = 1, "niestacjonarne" = 2), label = "Tryb studiów")
attr(sav$id, "label")    <- "Numer osoby"
attr(sav$nauka, "label") <- "Nauka – godziny tygodniowo"
attr(sav$lek, "label")   <- "Lęk przed egzaminem (10–50)"
attr(sav$sen, "label")   <- "Sen – średnio godzin na dobę"
attr(sav$wynik, "label") <- "Wynik egzaminu (0–100 pkt)"
write_sav(sav, "../korelacja-regresja-spss-dane.sav")

summary(dane[, -1])
table(tryb = dane$tryb)
round(sapply(dane[, c("nauka", "lek", "sen", "wynik")], function(x) c(M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE), n = sum(!is.na(x)))), 2)
Wynik w R
      tryb           nauka             lek             sen            wynik
 Min.   :1.000   Min.   : 0.900   Min.   :17.00   Min.   :4.900   Min.   :21.00
 1st Qu.:1.000   1st Qu.: 4.575   1st Qu.:27.75   1st Qu.:6.025   1st Qu.:49.00
 Median :1.000   Median : 6.000   Median :33.00   Median :6.750   Median :57.00
 Mean   :1.266   Mean   : 6.833   Mean   :32.53   Mean   :6.749   Mean   :57.62
 3rd Qu.:2.000   3rd Qu.: 8.625   3rd Qu.:37.25   3rd Qu.:7.300   3rd Qu.:65.00
 Max.   :2.000   Max.   :20.000   Max.   :49.00   Max.   :9.000   Max.   :85.00
                                  NA's   :4       NA's   :6
tryb
  1   2
135  49
    nauka    lek    sen  wynik
M    6.83  32.53   6.75  57.62
SD   3.43   6.78   0.82  11.48
n  184.00 180.00 178.00 184.00
2. Correlations: r, p dwustronne, N i 95% CI
R
# Krok 2. Correlations: r Pearsona, Sig. (2-tailed) i N – braki usuwane parami (domyślnie w Bivariate)
dane <- read.csv("../korelacja-regresja-spss-dane.csv")
zm <- c("nauka", "lek", "sen", "wynik")
r_tab <- function(x, y) { ok <- complete.cases(x, y); ct <- cor.test(x[ok], y[ok])
  c(r = unname(ct$estimate), p = ct$p.value, N = sum(ok), lo = ct$conf.int[1], hi = ct$conf.int[2]) }
wyniki <- expand.grid(x = zm, y = zm, stringsAsFactors = FALSE)
wyniki <- wyniki[wyniki$x != wyniki$y, ]
wyniki <- cbind(wyniki, t(mapply(function(a, b) r_tab(dane[[a]], dane[[b]]), wyniki$x, wyniki$y)))
print(transform(subset(wyniki, match(x, zm) < match(y, zm)), r = round(r, 3), p = signif(p, 3),
                lo = round(lo, 3), hi = round(hi, 3)), row.names = FALSE)
# 95% CI metodą Fishera (jak domyślne METHOD=FISHER w CORRELATIONS /CI) dla związku nauki z wynikiem
ct <- cor.test(dane$nauka, dane$wynik)
round(c(r = unname(ct$estimate), df = unname(ct$parameter), lo = ct$conf.int[1], hi = ct$conf.int[2]), 3)
format.pval(ct$p.value, digits = 3)
Wynik w R
     x     y      r        p   N     lo     hi
 nauka   lek -0.138 6.40e-02 180 -0.279  0.008
 nauka   sen -0.019 8.00e-01 178 -0.166  0.128
   lek   sen -0.101 1.85e-01 174 -0.246  0.049
 nauka wynik  0.501 4.55e-13 184  0.384  0.602
   lek wynik -0.309 2.38e-05 180 -0.436 -0.171
   sen wynik  0.233 1.74e-03 178  0.089  0.368
      r      df      lo      hi
  0.501 182.000   0.384   0.602
[1] "4.55e-13"
3. Linear Regression: Model Summary, ANOVA, Coefficients, Collinearity Diagnostics i reszty
R
# Krok 3. Linear Regression (metoda Enter): wynik ~ nauka + lek + sen; braki usuwane wierszami (listwise)
suppressPackageStartupMessages(library(car))
dane <- read.csv("../korelacja-regresja-spss-dane.csv")
d <- na.omit(dane[, c("id", "nauka", "lek", "sen", "wynik")])
nrow(d)
m <- lm(wynik ~ nauka + lek + sen, data = d)
s <- summary(m)
# Model Summary: R, R Square, Adjusted R Square, Std. Error of the Estimate
round(c(R = sqrt(s$r.squared), R2 = s$r.squared, R2_adj = s$adj.r.squared, SE_est = s$sigma), 3)
# ANOVA: Regression, Residual, Total
ss_res <- sum(resid(m)^2); ss_tot <- sum((d$wynik - mean(d$wynik))^2); ss_reg <- ss_tot - ss_res
df1 <- 3; df2 <- m$df.residual
round(c(SS_reg = ss_reg, SS_res = ss_res, SS_tot = ss_tot, df1 = df1, df2 = df2,
        MS_reg = ss_reg / df1, MS_res = ss_res / df2, F = unname(s$fstatistic[1])), 3)
format.pval(pf(s$fstatistic[1], df1, df2, lower.tail = FALSE), digits = 3)
# Coefficients: B, Std. Error, Beta (b × SD_x / SD_y), t, Sig., 95% CI dla B, Tolerance, VIF
sdy <- sd(d$wynik); beta <- coef(m)[-1] * sapply(d[, c("nauka", "lek", "sen")], sd) / sdy
v <- vif(m)
tab <- cbind(coef(s)[, 1:3], p = coef(s)[, 4], confint(m), Beta = c(NA, beta), Tol = c(NA, 1 / v), VIF = c(NA, v))
print(round(tab, 3))
signif(coef(s)[, 4], 3)
signif(pf(s$fstatistic[1], df1, df2, lower.tail = FALSE), 3)
# Collinearity Diagnostics: wartości własne przeskalowanej, niecentrowanej macierzy X'X,
# wskaźniki uwarunkowania i proporcje wariancji (Belsley, Kuh i Welsch)
X <- model.matrix(m); Xs <- sweep(X, 2, sqrt(colSums(X^2)), "/")
sv <- svd(Xs); ev <- sv$d^2
phi <- sweep(sv$v^2, 2, sv$d^2, "/"); prop <- t(sweep(phi, 1, rowSums(phi), "/"))
colnames(prop) <- colnames(X)
round(cbind(Eigenvalue = ev, Condition_Index = sqrt(max(ev) / ev), prop), 3)
# Ten sam model po wycentrowaniu predyktorów: VIF bez zmian, najwyższy wskaźnik uwarunkowania spada
dc <- transform(d, nauka = nauka - mean(nauka), lek = lek - mean(lek), sen = sen - mean(sen))
Xc <- model.matrix(lm(wynik ~ nauka + lek + sen, data = dc)); evc <- svd(sweep(Xc, 2, sqrt(colSums(Xc^2)), "/"))$d^2
round(c(max_CI_centr = sqrt(max(evc) / min(evc))), 3)
# Casewise Diagnostics (|*ZRESID| > 3) i odległość Cooka
zres <- resid(m) / s$sigma
d$zresid <- zres; d$cook <- cooks.distance(m); d$pred <- fitted(m); d$resid <- resid(m)
print(transform(d[abs(zres) > 3, c("id", "wynik", "pred", "resid", "zresid", "cook")], pred = round(pred, 3), resid = round(resid, 3),
                zresid = round(zresid, 3), cook = round(cook, 3)), row.names = FALSE)
round(c(max_cook = max(d$cook), drugi_cook = sort(d$cook, decreasing = TRUE)[2]), 3)
# Analiza wrażliwości: model bez osoby 17
m2 <- update(m, data = subset(d, id != 17)); s2 <- summary(m2)
round(c(R2 = s2$r.squared, coef(m2)), 3)
# Residuals Statistics: zakres *ZPRED i *ZRESID
zpred <- (fitted(m) - mean(fitted(m))) / sd(fitted(m))
round(rbind(ZPRED = range(zpred), ZRESID = range(zres)), 3)
Wynik w R
[1] 174
     R     R2 R2_adj SE_est
 0.600  0.360  0.349  9.233
   SS_reg    SS_res    SS_tot       df1       df2    MS_reg    MS_res         F
 8154.715 14492.641 22647.356     3.000   170.000  2718.238    85.251    31.885
[1] "<2e-16"
            Estimate Std. Error t value     p  2.5 % 97.5 %   Beta   Tol   VIF
(Intercept)   35.836      7.286   4.919 0.000 21.454 50.219     NA    NA    NA
nauka          1.641      0.212   7.739 0.000  1.223  2.060  0.478 0.985 1.015
lek           -0.358      0.105  -3.411 0.001 -0.566 -0.151 -0.212 0.975 1.025
sen            3.270      0.852   3.839 0.000  1.588  4.951  0.237 0.989 1.011
(Intercept)       nauka         lek         sen
   2.04e-06    8.52e-13    8.09e-04    1.74e-04
  value
2.1e-16
     Eigenvalue Condition_Index (Intercept) nauka   lek   sen
[1,]      3.803           1.000       0.001 0.011 0.003 0.001
[2,]      0.160           4.878       0.003 0.897 0.034 0.005
[3,]      0.032          10.961       0.019 0.050 0.740 0.160
[4,]      0.006          25.341       0.978 0.041 0.224 0.834
max_CI_centr
       1.172
 id wynik   pred   resid zresid  cook
 17    21 60.059 -39.059  -4.23 0.032
  max_cook drugi_cook
     0.066      0.054
         R2 (Intercept)       nauka         lek         sen
      0.392      35.173       1.658      -0.358       3.386
         [,1]  [,2]
ZPRED  -2.143 3.260
ZRESID -4.230 2.972
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE. https://www.john-fox.ca/Companion/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files (R package version 2.5.5) [Computer software]. https://CRAN.R-project.org/package=haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy korelacji i regresji w SPSS
- Wklejenie całej macierzy Correlations do pracy, z wierszami Sig. i N oraz z gwiazdkami w tekście („r = .501**”). W tekście podaj r, df, CI i p, a macierz przerób na tabelę APA.
- Metoda Stepwise w pracy sprawdzającej hipotezy. Wartości p po selekcji są zawyżone, a dobór predyktorów zależy od przypadku w danych.
- Mylenie B z Beta i nazywanie predyktora o największym B „najważniejszym”, choć zmienne mają różne skale.
- Zapis p = .000 zamiast p < .001 i przepisanie Sig. = .001 jako „p = .001”, gdy dokładne p jest mniejsze.
- Sprawdzanie normalności zmiennych zamiast reszt i brak wykresu *ZRESID względem *ZPRED.
Jeśli chcesz, żeby ktoś sprawdził ustawienia regresji i opis wyników w Twojej pracy, możesz skorzystać z oferty analizy statystyczne dla studentów.
Najczęstsze pytania
Jak zrobić korelację Pearsona w SPSS?
Wybierz Analyze → Correlate → Bivariate, przenieś zmienne ilościowe do listy Variables, zaznacz Pearson i Two-tailed. Przycisk Confidence Interval doda przedziały ufności. W tabeli Correlations odczytasz dla każdej pary r (Pearson Correlation), p (Sig. (2-tailed)) i liczbę osób (N).
Gdzie w SPSS jest VIF?
W oknie Linear Regression kliknij Statistics i zaznacz Collinearity diagnostics. Tolerancja i VIF pojawią się w tabeli Coefficients jako ostatnie kolumny, a dodatkowa tabela Collinearity Diagnostics pokaże wartości własne i wskaźniki uwarunkowania (IBM Corp., b.d.).
Dlaczego N w korelacjach i w regresji jest inne?
W oknie Bivariate SPSS domyślnie usuwa braki parami, więc każda korelacja korzysta ze wszystkich osób z kompletem danych w danej parze. Regresja domyślnie usuwa całe wiersze z jakimkolwiek brakiem w zmiennych modelu. W przykładzie korelacja nauki z wynikiem opiera się na 184 osobach, a regresja na 174.
Które wykresy reszt zrobić w regresji w SPSS?
W oknie Plots ustaw *ZRESID na osi Y i *ZPRED na osi X oraz zaznacz histogram i wykres normalności reszt. Pierwszy wykres pokazuje, czy związek jest liniowy, a wariancja reszt stała. Drugi pokazuje, czy rozkład reszt (nie zmiennych!) jest zbliżony do normalnego.
Czy w regresji w SPSS używać metody Stepwise?
W pracy, która sprawdza hipotezy, nie. Zostaw metodę Enter i wprowadź predyktory wybrane na podstawie teorii. Dokumentacja IBM ostrzega, że przy metodach krokowych wartości istotności w wydruku są na ogół nieprawidłowe (IBM, 2026).
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikKorelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →Masz wydruk regresji z SPSS i nie wiesz, co z niego przepisać?
Sprawdzimy ustawienia analizy, wykresy reszt i dobór predyktorów oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bishara, A. J., & Hittner, J. B. (2012). Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches. Psychological Methods, 17(3), 399–417. https://doi.org/10.1037/a0028087
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Ernst, A. F., & Albers, C. J. (2017). Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions. PeerJ, 5, Article e3323. https://doi.org/10.7717/peerj.3323 ● Otwarty dostęp
- IBM Corp. (b.d.). Bivariate Correlations; Linear Regression (Statistics, Plots, Saving New Variables); CORRELATIONS and REGRESSION commands. IBM SPSS Statistics 32.0.0 documentation. Pobrano 1 listopada 2026 z https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-linear-regression ● Otwarty dostęp
- IBM. (2026). Linear Regression variable selection methods (IBM SPSS Statistics 31.0.0). https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=regression-linear-variable-selection-methods ● Otwarty dostęp
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bishara2012testing, author={Bishara, Anthony J. and Hittner, James B.}, title={{Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={399--417}, doi={10.1037/a0028087}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{ernst2017regression, author={Ernst, Anja F. and Albers, Casper J.}, title={{Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions}}, journal={PeerJ}, year={2017}, volume={5}, eid={e3323}, doi={10.7717/peerj.3323}}@misc{ibmnd32korelacjaregresja, author={{IBM Corp.}}, title={{Bivariate Correlations; Linear Regression (Statistics, Plots, Saving New Variables); CORRELATIONS and REGRESSION commands}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-linear-regression}}@misc{ibm2026regresjametody, author={{IBM}}, title={{Linear Regression variable selection methods (IBM SPSS Statistics 31.0.0)}}, year={2026}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=regression-linear-variable-selection-methods}}@article{obrien2007caution, author={O’Brien, Robert M.}, title={{A caution regarding rules of thumb for variance inflation factors}}, journal={Quality \& Quantity}, year={2007}, volume={41}, number={5}, pages={673--690}, doi={10.1007/s11135-006-9018-6}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}