Na jakie pytanie odpowiada regresja hierarchiczna
Regresja hierarchiczna odpowiada na pytanie „czy X wyjaśnia wynik ponad to, co wyjaśniają inne zmienne?”. Predyktory wprowadzasz w blokach, w kolejności ustalonej przed analizą. Po każdym kroku sprawdzasz, o ile wzrosło R² (ΔR²) i czy ten przyrost jest istotny w teście F zmiany. Definicję, wzory i różnicę wobec metody krokowej omawia hasło regresja hierarchiczna. Ten wpis prowadzi przez całą analizę do pracy dyplomowej, od planu bloków po tabelę APA.
Model z ostatniego kroku to zwykła regresja wieloraka, więc obowiązują te same założenia i ta sama interpretacja współczynników co w poradniku regresja wieloraka krok po kroku. Nowe są trzy rzeczy: plan bloków, wspólna próba dla wszystkich kroków i raport przyrostów.
Przykład: stres, wsparcie i satysfakcja z życia
W badaniu symulowanym 240 osób studiujących wypełniło skale satysfakcji z życia (5–35), stresu (0–40) i wsparcia społecznego (1–7). Podało też wiek, płeć i kierunek studiów (humanistyczny, ścisły, medyczny). Dane są w pliku CSV. Hipotezy brzmią:
- H1: wsparcie społeczne wiąże się z wyższą satysfakcją także po uwzględnieniu stresu i zmiennych demograficznych;
- H2: wsparcie osłabia ujemny związek stresu z satysfakcją (efekt buforujący, czyli moderacja).
Krok 1. Zaplanuj bloki przed analizą
Każdy blok to osobne pytanie. Kolejność wynika z hipotez, a nie z wyników.
| Krok | Dodane zmienne | Pytanie |
|---|---|---|
| 1 | Wiek, płeć, kierunek studiów | Ile wyjaśniają zmienne kontrolne? |
| 2 | Stres | Czy stres wyjaśnia satysfakcję ponad demografię? |
| 3 | Wsparcie społeczne | H1: czy wsparcie wnosi coś ponad stres i demografię? |
| 4 | Stres × wsparcie | H2: czy związek stresu zależy od wsparcia? |
Zasady są proste. Zmienne kontrolne idą na początek, ale tylko te, które mają uzasadnienie (zob. czy kontrolować wiek i płeć). Zmienna, której wkład chcesz wykazać, idzie po zmiennych, „ponad” które ma działać. Iloczyn wchodzi zawsze po swoich składnikach, bo interakcję testuje się przy kontroli efektów głównych (Aiken i West, 1991). Zmienną kategorialną o trzech poziomach wprowadzasz w całości, jako dwie zmienne zero-jedynkowe w jednym bloku (zob. dummy coding).
Krok 2. Ustal jedną próbę dla wszystkich kroków
To najczęstszy błąd techniczny. W przykładzie 14 osób nie wypełniło skali wsparcia. Model z kroku 1 liczy się więc na 240 osobach, a model z kroku 3 już na 226. R przerywa wtedy porównanie komunikatem „models were not all fitted to the same size of dataset”. Gdy kroki liczysz na różnych osobach, ΔR² miesza wkład zmiennych ze zmianą próby.
Najprostsze rozwiązanie to wybranie osób z kompletem danych przed dopasowaniem pierwszego modelu. W przykładzie zostało 226 osób. Podaj tę liczbę w pracy i wyjaśnij, skąd się wzięła. Gdy braków jest więcej, sprawdź ich mechanizm (zob. braki danych MCAR, MAR, MNAR). Graham (2009) w praktycznym przeglądzie omawia dwa podstawowe rozwiązania: imputację wielokrotną i metody największej wiarygodności. Jak połączyć ΔR² z wielu imputacji, opisuje wpis imputacja wielokrotna i reguły Rubina.
Krok 3. Przygotuj predyktory do interakcji
Przed utworzeniem iloczynu odejmij od stresu i wsparcia ich średnie z próby analitycznej (M = 19.43 i 5.04). To centrowanie zmiennych. Dalal i Zickar (2012) pokazują, że centrowanie nie zmienia dopasowania modelu ani testu interakcji. Zmienia za to współczynniki niższego rzędu. Po centrowaniu współczynnik stresu w kroku 4 opisuje związek przy średnim wsparciu, a nie przy wsparciu równym zero, którego skala 1–7 w ogóle nie przewiduje.
Krok 4. Dopasuj modele i porównaj kroki
Cztery zagnieżdżone modele porównujesz jedną funkcją anova(m1, m2, m3, m4). Każdy wiersz to test F zmiany względem poprzedniego kroku.
| Krok | R² | Skoryg. R² | ΔR² | Test F zmiany | p | f² |
|---|---|---|---|---|---|---|
| 1. Demografia | .011 | −.007 | .011 | F(4, 221) = 0.63 | .641 | 0.011 |
| 2. + stres | .134 | .115 | .123 | F(1, 220) = 33.77 | < .001 | 0.142 |
| 3. + wsparcie | .187 | .165 | .053 | F(1, 219) = 14.43 | < .001 | 0.065 |
| 4. + stres × wsparcie | .206 | .180 | .019 | F(1, 218) = 5.12 | .025 | 0.023 |
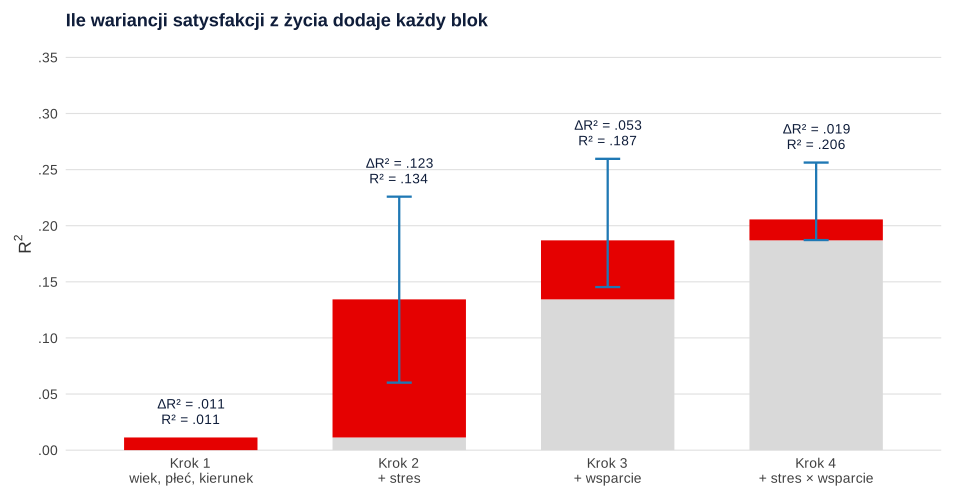
Demografia nie wyjaśniała satysfakcji. Skorygowane R² jest nawet ujemne, bo kara za cztery predyktory przewyższa ich wkład. Stres dodał 12.3% wyjaśnionej wariancji. Wsparcie dodało kolejne 5.3% ponad stres i demografię, co potwierdza H1. Interakcja dodała 1.9%, co potwierdza H2. Rysunek 1 pokazuje, jak rośnie R² w kolejnych krokach.
Krok 5. Oceń wielkość przyrostu
Istotność nie mówi, czy przyrost jest duży. Do opisu wielkości służy f² = ΔR² / (1 − R²pełny), czyli lokalna wielkość efektu bloku w kontekście całego modelu (Selya i in., 2012). Więcej o tej mierze znajdziesz w haśle f Cohena. Cohen (1992) przyjął umownie 0.02 jako efekt mały, 0.15 jako średni i 0.35 jako duży. W przykładzie wsparcie ma f² = 0.065, a interakcja 0.023. Oba efekty są więc małe.
ΔR² jest oszacowaniem z próby, więc warto podać jego niepewność. Prosty sposób to bootstrap. Losujesz osoby ze zwracaniem, dopasowujesz wszystkie kroki od nowa i liczysz przyrosty. Percentylowe 95% CI wyniosły [.049, .215] dla stresu, [.011, .125] dla wsparcia i [.000, .069] dla interakcji. ΔR² nie może być ujemne, więc dolna granica dla małego efektu przylega do zera. Szeroki przedział dla interakcji przypomina, że przy 226 osobach jej wielkość jest słabo oszacowana.
Krok 6. Zinterpretuj przyrosty zgodnie z kolejnością
ΔR² odpowiada na pytanie „ile blok wnosi ponad bloki wcześniejsze”, a nie „jak ważna jest zmienna”. Stres i wsparcie korelują (r = −.25), więc część wyjaśnianej przez nie wariancji jest wspólna. Ta część trafia do bloku, który wchodzi wcześniej. Kraha i in. (2012) pokazują, jak rozdzielić R² na części unikalne i wspólne. Gdyby wsparcie weszło przed stresem, dodałoby ΔR² = .095 zamiast .053, a stres – .081 zamiast .123. Pełne porównanie dwóch kolejności z rysunkiem znajdziesz w haśle o regresji hierarchicznej.
Wniosek do pracy: przyrost w kroku 3 opisuj dosłownie jako „wsparcie wyjaśniało dodatkowe 5.3% wariancji ponad stres i zmienne demograficzne”. Przyrost pojedynczej zmiennej w ostatnim kroku równa się kwadratowi jej korelacji semicząstkowej (sr²). To jej unikalny wkład w modelu pełnym. W przykładzie interakcja ma sr² = .019, czyli dokładnie tyle, ile wynosi ΔR² w kroku 4.
Krok 7. Rozłóż interakcję z ostatniego bloku
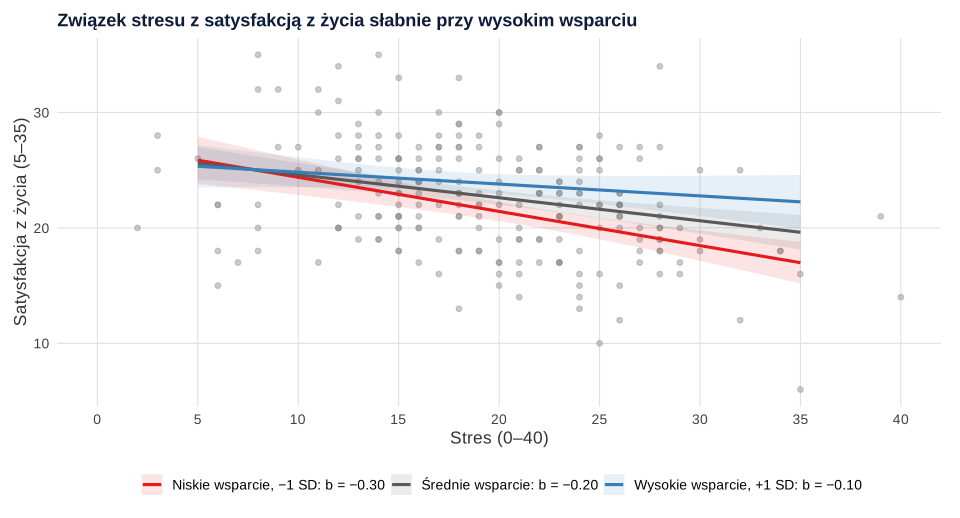
Istotny przyrost w kroku 4 mówi, że nachylenie stresu zależy od wsparcia. Kierunek pokażą efekty proste, czyli nachylenia stresu przy wybranych poziomach wsparcia. Przy niskim wsparciu (−1 SD) każdy punkt stresu wiązał się ze spadkiem satysfakcji o 0.30 punktu, 95% CI [−0.41, −0.18], t(218) = −5.05, p < .001. Przy średnim wsparciu spadek wynosił 0.20 punktu, 95% CI [−0.29, −0.11]. Przy wysokim wsparciu (+1 SD) nachylenie było bliskie zera, b = −0.10, 95% CI [−0.23, 0.02], t(218) = −1.59, p = .113. Ten wzór pasuje do efektu buforującego (Rysunek 2).
Wartości ±1 SD to tylko konwencja. Spiller i in. (2013) zalecają efekty proste przy wartościach moderatora ważnych merytorycznie. Gdy takich wartości nie ma, proponują przedział Johnsona–Neymana. Pełną procedurę opisuje wpis analiza moderacji krok po kroku.
Krok 8. Sprawdź założenia na modelu końcowym
Diagnostykę robisz raz, na modelu z ostatniego kroku. Sprawdź liniowość, stałość wariancji i normalność reszt oraz obserwacje wpływowe (zob. diagnostyka regresji w R). Williams i in. (2013) przypominają, że założenie normalności dotyczy błędów, a nie zmiennych (zob. normalność reszt czy zmiennych). W przykładzie współczynniki VIF w modelu bez iloczynu nie przekroczyły 1.07, więc współliniowość nie stanowi problemu. VIF dla iloczynu i jego składników bywa wysoki bez centrowania, ale to współliniowość techniczna, która nie zmienia testu interakcji (Dalal i Zickar, 2012).
Ile osób potrzebujesz
Moc liczysz dla testu F zmiany w bloku, który odpowiada na hipotezę. Przy N = 226, siedmiu predyktorach i jednym predyktorze w bloku efekt f² = 0.02 zostałby wykryty z mocą tylko .562. Do mocy .80 potrzeba 395 osób przy f² = 0.02 i 159 osób przy f² = 0.05 (rozkład F niecentralny, kod niżej). Interakcje bywają małe, więc planuj próbę pod nie, a nie pod efekty główne. Ogólne reguły omawia wpis ile predyktorów może mieć regresja, a obliczenia ułatwia kalkulator liczebności próby.
Krok 9. Przygotuj tabelę i opis APA
Petrocelli (2003), analizując artykuły z psychologii poradnictwa, opisał typowe problemy w raportowaniu regresji hierarchicznej i sposoby ich uniknięcia. Najprostszy sposób, by ich uniknąć, to podać dla każdego kroku R², ΔR² i test F zmiany, a dla modelu końcowego współczynniki z przedziałami ufności. Tabela 1 łączy obie części w jednym zestawieniu. Inny układ, ze współczynnikami w każdym kroku, pokazuje hasło tabela regresji w APA.
Tabela 1
Regresja hierarchiczna satysfakcji z życia: przyrosty R² w czterech krokach i współczynniki modelu końcowego
| Krok i predyktor | b [95% CI] | SE | β | sr2 | p |
|---|---|---|---|---|---|
| Panel A. Przyrosty wyjaśnionej wariancji | |||||
| Krok 1: wiek, płeć, kierunek | R2 = .011, ΔR2 = .011 | F(4, 221) = 0.63 | .641 | ||
| Krok 2: stres | R2 = .134, ΔR2 = .123 | F(1, 220) = 33.77 | < .001 | ||
| Krok 3: wsparcie społeczne | R2 = .187, ΔR2 = .053 | F(1, 219) = 14.43 | < .001 | ||
| Krok 4: stres × wsparcie | R2 = .206, ΔR2 = .019 | F(1, 218) = 5.12 | .025 | ||
| Panel B. Model końcowy (krok 4) | |||||
| Wiek | −0.04 [−0.29, 0.20] | 0.12 | −0.02 | .000 | .713 |
| Płeć (mężczyzna) | 0.90 [−0.29, 2.09] | 0.60 | 0.19 | .008 | .136 |
| Kierunek ścisły (vs humanistyczny) | 0.55 [−0.80, 1.91] | 0.69 | 0.12 | .002 | .422 |
| Kierunek medyczny (vs humanistyczny) | 0.41 [−1.02, 1.83] | 0.72 | 0.08 | .001 | .575 |
| Stres (centrowany) | −0.20 [−0.29, −0.11] | 0.04 | −0.28 | .073 | < .001 |
| Wsparcie społeczne (centrowane) | 1.07 [0.51, 1.62] | 0.28 | 0.24 | .052 | < .001 |
| Stres × wsparcie | 0.09 [0.01, 0.17] | 0.04 | 0.14 | .019 | .025 |
Uwaga. N = 226 (osoby z kompletem danych). W panelu A test F dla kroku 1 porównuje model z modelem pustym, a dla kroków 2–4 jest testem F zmiany. Model końcowy: R2 = .206, skorygowane R2 = .180, F(7, 218) = 8.06, p < .001. β obliczono po standaryzacji zmiennych ilościowych; dla płci i kierunku β to różnica w odchyleniach standardowych satysfakcji. sr2 – kwadrat korelacji semicząstkowej. Dane symulowane.
Kolumna β wymaga ostrożności przy zmiennych zero-jedynkowych i iloczynach. Kiedy podawać β, a kiedy b, wyjaśnia wpis współczynniki standaryzowane czy niestandaryzowane.
Regresja hierarchiczna w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Na początku symuluje dane i zapisuje plik CSV do pobrania; ze swoimi danymi zacznij od wczytania pliku (read.csv()) i kroku 1. Bootstrap (2000 prób) trwa kilkanaście sekund. Potrzebne pakiety: car, emmeans i boot.
Cztery kroki, ΔR², bootstrap, efekty proste i moc
R
# B184 – regresja hierarchiczna w czterech krokach: wspólna próba, ΔR², test F zmiany, f², bootstrap,
# interakcja w ostatnim bloku, efekty proste, kolejność bloków, moc dla ΔR² (dane symulowane, set.seed(1184)).
# 240 osób studiujących: satysfakcja z życia (5–35), wiek, płeć, kierunek studiów, stres (0–40),
# wsparcie społeczne (1–7; 14 osób nie wypełniło tej skali).
suppressPackageStartupMessages({ library(car); library(emmeans); library(boot) })
set.seed(1184)
n <- 240
wiek <- round(runif(n, 19, 27))
plec <- factor(sample(c("kobieta", "mężczyzna"), n, TRUE, prob = c(.65, .35)))
kierunek <- factor(sample(c("humanistyczny", "ścisły", "medyczny"), n, TRUE),
                   levels = c("humanistyczny", "ścisły", "medyczny"))
stres <- round(pmin(pmax(rnorm(n, 19, 6.5), 0), 40))
wsparcie <- round(pmin(pmax(5.0 - 0.045 * (stres - 19) + rnorm(n, 0, 1.0), 1), 7), 1)
satysf <- 23 + 0.10 * (wiek - 23) + 0.4 * (plec == "mężczyzna") - 0.6 * (kierunek == "medyczny") -
  0.22 * (stres - 19) + 1.35 * (wsparcie - 5) + 0.09 * (stres - 19) * (wsparcie - 5) + rnorm(n, 0, 4.3)
satysf <- round(pmin(pmax(satysf, 5), 35))
wsparcie[sample(n, 14)] <- NA
dane <- data.frame(id = 1:n, wiek, plec, kierunek, stres, wsparcie, satysf)
write.csv(dane, "../regresja-hierarchiczna-dane-przyklad.csv", row.names = FALSE, na = "")

# Krok 1. Pułapka: modele dopasowane osobno mają różne N, więc nie można ich porównać
m1_zle <- lm(satysf ~ wiek + plec + kierunek, data = dane)
m3_zle <- lm(satysf ~ wiek + plec + kierunek + stres + wsparcie, data = dane)
c(N_krok1 = nobs(m1_zle), N_krok3 = nobs(m3_zle))
tryCatch(anova(m1_zle, m3_zle), error = function(e) conditionMessage(e))

# Krok 2. Jedna próba dla wszystkich kroków + centrowanie predyktorów interakcji (średnia z tej próby)
d <- na.omit(dane)
nrow(d)
d$stres_c <- d$stres - mean(d$stres)
d$wsparcie_c <- d$wsparcie - mean(d$wsparcie)
round(sapply(d[c("satysf", "stres", "wsparcie", "wiek")], function(x) c(M = mean(x), SD = sd(x))), 2)
round(c(r_stres_wsparcie = cor(d$stres, d$wsparcie), r_stres_satysf = cor(d$stres, d$satysf),
        r_wsparcie_satysf = cor(d$wsparcie, d$satysf)), 2)

# Krok 3. Cztery modele zagnieżdżone (bloki ustalone przed analizą)
m1 <- lm(satysf ~ wiek + plec + kierunek, data = d)                       # blok 1: zmienne kontrolne
m2 <- update(m1, . ~ . + stres_c)                                           # blok 2: stres
m3 <- update(m2, . ~ . + wsparcie_c)                                        # blok 3: wsparcie (H1)
m4 <- update(m3, . ~ . + stres_c:wsparcie_c)                                # blok 4: interakcja (H2)
modele <- list(m1, m2, m3, m4)
R2 <- sapply(modele, function(m) summary(m)$r.squared)
R2_adj <- sapply(modele, function(m) summary(m)$adj.r.squared)
porownanie <- anova(m1, m2, m3, m4)                                          # test F zmiany dla kroków 2–4
F1 <- summary(m1)$fstatistic                                                 # krok 1 porównany z modelem pustym
kroki <- data.frame(krok = 1:4, R2 = R2, R2_skor = R2_adj, dR2 = c(R2[1], diff(R2)),
                    F_zm = c(F1[["value"]], porownanie$F[-1]), df1 = c(F1[["numdf"]], porownanie$Df[-1]),
                    df2 = sapply(modele, df.residual),
                    p = c(pf(F1[["value"]], F1[["numdf"]], F1[["dendf"]], lower.tail = FALSE), porownanie$`Pr(>F)`[-1]))
kroki$f2 <- kroki$dR2 / (1 - kroki$R2)                                      # f² dla przyrostu w danym kroku
print(within(kroki, { R2 <- round(R2, 3); R2_skor <- round(R2_skor, 3); dR2 <- round(dR2, 3)
                      F_zm <- round(F_zm, 2); f2 <- round(f2, 3); p <- signif(p, 3) }), row.names = FALSE)

# Krok 4. Bootstrap: 95% CI dla ΔR² w krokach 2–4 (2000 prób, percentylowy)
dR2_boot <- function(dd, i) {
  b <- dd[i, ]
  r <- sapply(list(formula(m1), formula(m2), formula(m3), formula(m4)),
              function(f) summary(lm(f, data = b))$r.squared)
  diff(r)
}
set.seed(2184)
bt <- boot(d, dR2_boot, R = 2000)
round(t(sapply(1:3, function(j) c(krok = j + 1, dR2 = bt$t0[j], boot.ci(bt, type = "perc", index = j)$percent[4:5]))), 4)

# Krok 5. Model końcowy: test całego modelu, b z 95% CI, β (zmienne ilościowe standaryzowane), sr² i VIF
F4 <- summary(m4)$fstatistic
round(F4, 2)
signif(pf(F4[["value"]], F4[["numdf"]], F4[["dendf"]], lower.tail = FALSE), 3)
koef <- cbind(round(cbind(b = coef(m4), confint(m4), SE = coef(summary(m4))[, 2],
                          t = coef(summary(m4))[, 3]), 2), p = signif(coef(summary(m4))[, 4], 3))
koef
dz <- transform(d, satysf = scale(satysf)[, 1], wiek = scale(wiek)[, 1],
                stres_c = scale(stres_c)[, 1], wsparcie_c = scale(wsparcie_c)[, 1])
round(coef(update(m4, data = dz))[-1], 2)                                   # β
round(coef(summary(m4))[-1, 3]^2 * (1 - R2[4]) / df.residual(m4), 3)        # sr² = t²(1 − R²)/df
round(vif(m3), 2)                                                         # VIF bez iloczynu

# Krok 6. Efekty proste: nachylenie stresu przy niskim (−1 SD), średnim i wysokim (+1 SD) wsparciu
sd_w <- sd(d$wsparcie_c)
summary(emtrends(m4, ~ wsparcie_c, var = "stres_c", at = list(wsparcie_c = c(-sd_w, 0, sd_w))), infer = TRUE)

# Krok 7. Kolejność ma znaczenie: wsparcie wprowadzone przed stresem
m2b <- update(m1, . ~ . + wsparcie_c)
round(c(dR2_wsparcie_jako_krok2 = summary(m2b)$r.squared - R2[1], dR2_wsparcie_jako_krok3 = R2[3] - R2[2],
        dR2_stres_jako_krok3 = R2[3] - summary(m2b)$r.squared, dR2_stres_jako_krok2 = R2[2] - R2[1]), 3)

# Krok 8. Moc testu F zmiany (rozkład F niecentralny, λ = f² × N): blok 1 predyktora w modelu z 7 predyktorami
moc <- function(f2, N, m = 1, p = 7, alfa = .05) {
  df2 <- N - p - 1
  pf(qf(1 - alfa, m, df2), m, df2, ncp = f2 * N, lower.tail = FALSE)
}
round(c(moc_f2_02_N226 = moc(.02, 226), moc_f2_15_N226 = moc(.15, 226)), 3)
N <- 20:1000; c(N_80proc_f2_02 = min(N[moc(.02, N) >= .80]), N_80proc_f2_05 = min(N[moc(.05, N) >= .80]))
Wynik w R
N_krok1 N_krok3
    240     226
[1] "models were not all fitted to the same size of dataset"
[1] 226
   satysf stres wsparcie  wiek
M   22.43 19.43     5.04 22.91
SD   4.79  6.74     1.06  2.38
 r_stres_wsparcie    r_stres_satysf r_wsparcie_satysf
            -0.25             -0.35              0.31
 krok    R2 R2_skor   dR2  F_zm df1 df2        p    f2
    1 0.011  -0.007 0.011  0.63   4 221 6.41e-01 0.011
    2 0.134   0.115 0.123 33.77   1 220 2.18e-08 0.142
    3 0.187   0.165 0.053 14.43   1 219 1.88e-04 0.065
    4 0.206   0.180 0.019  5.12   1 218 2.46e-02 0.023
     krok    dR2
[1,]    2 0.1231 0.0489 0.2146
[2,]    3 0.0526 0.0110 0.1253
[3,]    4 0.0187 0.0003 0.0693
 value  numdf  dendf
  8.06   7.00 218.00
[1] 1.03e-08
                       b 2.5 % 97.5 %   SE     t        p
(Intercept)        22.99 17.39  28.58 2.84  8.10 3.91e-14
wiek               -0.04 -0.29   0.20 0.12 -0.37 7.13e-01
plecmężczyzna       0.90 -0.29   2.09 0.60  1.50 1.36e-01
kierunekścisły      0.55 -0.80   1.91 0.69  0.81 4.22e-01
kierunekmedyczny    0.41 -1.02   1.83 0.72  0.56 5.75e-01
stres_c            -0.20 -0.29  -0.11 0.04 -4.48 1.22e-05
wsparcie_c          1.07  0.51   1.62 0.28  3.80 1.91e-04
stres_c:wsparcie_c  0.09  0.01   0.17 0.04  2.26 2.46e-02
              wiek      plecmężczyzna     kierunekścisły   kierunekmedyczny            stres_c
             -0.02               0.19               0.12               0.08              -0.28
        wsparcie_c stres_c:wsparcie_c
              0.24               0.14
              wiek      plecmężczyzna     kierunekścisły   kierunekmedyczny            stres_c
             0.000              0.008              0.002              0.001              0.073
        wsparcie_c stres_c:wsparcie_c
             0.052              0.019
           GVIF Df GVIF^(1/(2*Df))
wiek       1.01  1            1.00
plec       1.00  1            1.00
kierunek   1.01  2            1.00
stres_c    1.07  1            1.03
wsparcie_c 1.07  1            1.03
 wsparcie_c stres_c.trend     SE  df lower.CL upper.CL t.ratio p.value
      -1.06        -0.296 0.0586 218   -0.412  -0.1804  -5.048 <0.0001
       0.00        -0.199 0.0445 218   -0.287  -0.1116  -4.477 <0.0001
       1.06        -0.103 0.0646 218   -0.230   0.0247  -1.589  0.1134

Results are averaged over the levels of: plec, kierunek
Confidence level used: 0.95
dR2_wsparcie_jako_krok2 dR2_wsparcie_jako_krok3    dR2_stres_jako_krok3    dR2_stres_jako_krok2
                  0.095                   0.053                   0.081                   0.123
moc_f2_02_N226 moc_f2_15_N226
         0.562          1.000
N_80proc_f2_02 N_80proc_f2_05
           395            159
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w regresji hierarchicznej
- Różne N w kolejnych krokach. Ustal próbę analityczną przed pierwszym modelem.
- Kolejność bloków dobrana po obejrzeniu wyników. Przestawianie bloków, aż „Twoja” zmienna da istotne ΔR², to forma p-hackingu.
- Mylenie z metodą krokową. W metodzie krokowej kolejność wybiera algorytm, co zwiększa szansę fałszywej istotności i słabo się replikuje (Thompson, 1995).
- Interakcja bez efektów głównych w poprzednim kroku. Iloczyn testuje się przy kontroli jego składników.
- Raport samego modelu końcowego. Bez ΔR² i testu F zmiany nie widać odpowiedzi na hipotezę.
- „Wsparcie wyjaśnia 5.3% satysfakcji”. Poprawnie: 5.3% ponad stres i demografię.
Jeśli chcesz, żeby ktoś sprawdził plan bloków, kodowanie i opis wyników w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Dlaczego R nie chce porównać modeli w regresji hierarchicznej?
Komunikat „models were not all fitted to the same size of dataset” oznacza, że kolejne modele policzono na różnej liczbie osób, bo zmienne z późniejszych bloków mają braki. Wybierz osoby z kompletem danych przed dopasowaniem pierwszego modelu (np. na.omit() na wszystkich zmiennych z planu) albo zastosuj imputację wielokrotną.
Jaki przyrost R² w regresji hierarchicznej jest duży?
Wielkość przyrostu opisuje f² = ΔR² / (1 − R²pełny). Cohen (1992) przyjął umownie 0.02 jako efekt mały, 0.15 jako średni i 0.35 jako duży. Podaj też przedział ufności ΔR², np. z bootstrapu, bo w małych próbach przyrost jest słabo oszacowany.
Czy zmienne kontrolne zawsze wprowadza się w pierwszym kroku?
Zwykle tak, bo hipoteza brzmi „X wyjaśnia wynik ponad zmienne kontrolne”. Do modelu wprowadzaj jednak tylko zmienne kontrolne uzasadnione teorią albo wcześniejszymi badaniami. Nieistotny pierwszy krok nie jest powodem, by go usuwać.
Jak dodać interakcję w regresji hierarchicznej?
Wprowadź iloczyn predyktorów w ostatnim kroku, po krokach z obiema zmiennymi. Zmienne ciągłe wcześniej wycentruj, żeby współczynniki niższego rzędu dało się interpretować. ΔR² ostatniego kroku to test interakcji, a jej kierunek pokazują efekty proste.
Co napisać, gdy ostatni blok nie zwiększył istotnie R²?
Podaj ΔR², test F zmiany i przedział ufności przyrostu, a potem napisz, że blok nie wyjaśniał istotnej części wariancji ponad wcześniejsze zmienne. Nie usuwaj bloku z tabeli i nie zmieniaj kolejności kroków po fakcie. Model z poprzedniego kroku możesz opisać jako najlepiej uzasadniony.
Powiązane hasła
Przeczytaj też
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikCzy kontrolować wiek i płeć?
Kiedy wiek i płeć usuwają zakłócenie, kiedy tylko zwiększają precyzję, a kiedy szkodzą – z przykładem czterech modeli w R i wzorem opisu.
Czytaj →Nie wiesz, w jakiej kolejności wprowadzić bloki albo jak opisać przyrost R²?
Sprawdzimy plan bloków, przygotowanie danych i tabelę wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage.
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Dalal, D. K., & Zickar, M. J. (2012). Some common myths about centering predictor variables in moderated multiple regression and polynomial regression. Organizational Research Methods, 15(3), 339–362. https://doi.org/10.1177/1094428111430540
- Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60(1), 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
- Kraha, A., Turner, H., Nimon, K., Zientek, L. R., & Henson, R. K. (2012). Tools to support interpreting multiple regression in the face of multicollinearity. Frontiers in Psychology, 3, Article 44. https://doi.org/10.3389/fpsyg.2012.00044 ● Otwarty dostęp
- Petrocelli, J. V. (2003). Hierarchical multiple regression in counseling research: Common problems and possible remedies. Measurement and Evaluation in Counseling and Development, 36(1), 9–22. https://doi.org/10.1080/07481756.2003.12069076
- Selya, A. S., Rose, J. S., Dierker, L. C., Hedeker, D., & Mermelstein, R. J. (2012). A practical guide to calculating Cohen’s f², a measure of local effect size, from PROC MIXED. Frontiers in Psychology, 3, Article 111. https://doi.org/10.3389/fpsyg.2012.00111 ● Otwarty dostęp
- Spiller, S. A., Fitzsimons, G. J., Lynch, J. G., Jr., & McClelland, G. H. (2013). Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression. Journal of Marketing Research, 50(2), 277–288. https://doi.org/10.1509/jmr.12.0420
- Thompson, B. (1995). Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial. Educational and Psychological Measurement, 55(4), 525–534. https://doi.org/10.1177/0013164495055004001
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@book{aiken1991multiple, author={Aiken, Leona S. and West, Stephen G.}, title={{Multiple regression: Testing and interpreting interactions}}, year={1991}, publisher={Sage}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{dalal2012some, author={Dalal, Dev K. and Zickar, Michael J.}, title={{Some common myths about centering predictor variables in moderated multiple regression and polynomial regression}}, journal={Organizational Research Methods}, year={2012}, volume={15}, number={3}, pages={339--362}, doi={10.1177/1094428111430540}}@article{graham2009missing, author={Graham, John W.}, title={{Missing data analysis: Making it work in the real world}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={549--576}, doi={10.1146/annurev.psych.58.110405.085530}}@article{kraha2012tools, author={Kraha, Amanda and Turner, Heather and Nimon, Kim and Zientek, Linda Reichwein and Henson, Robin K.}, title={{Tools to support interpreting multiple regression in the face of multicollinearity}}, journal={Frontiers in Psychology}, year={2012}, volume={3}, eid={44}, doi={10.3389/fpsyg.2012.00044}}@article{petrocelli2003hierarchical, author={Petrocelli, John V.}, title={{Hierarchical multiple regression in counseling research: Common problems and possible remedies}}, journal={Measurement and Evaluation in Counseling and Development}, year={2003}, volume={36}, number={1}, pages={9--22}, doi={10.1080/07481756.2003.12069076}}@article{selya2012practical, author={Selya, Arielle S. and Rose, Jennifer S. and Dierker, Lisa C. and Hedeker, Donald and Mermelstein, Robin J.}, title={{A practical guide to calculating Cohen’s f², a measure of local effect size, from PROC MIXED}}, journal={Frontiers in Psychology}, year={2012}, volume={3}, eid={111}, doi={10.3389/fpsyg.2012.00111}}@article{spiller2013spotlights, author={Spiller, Stephen A. and Fitzsimons, Gavan J. and Lynch, Jr., John G. and McClelland, Gary H.}, title={{Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression}}, journal={Journal of Marketing Research}, year={2013}, volume={50}, number={2}, pages={277--288}, doi={10.1509/jmr.12.0420}}@article{thompson1995stepwise, author={Thompson, Bruce}, title={{Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial}}, journal={Educational and Psychological Measurement}, year={1995}, volume={55}, number={4}, pages={525--534}, doi={10.1177/0013164495055004001}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}