Od trzech kroków do analizy w artykule
Trzy kroki imputacji wielokrotnej (imputacja, analiza, łączenie) i wzory Rubina (1987) opisujemy w haśle słownikowym. Diagnozę braków, wybór liczby imputacji i analizę wrażliwości na odstępstwa od MAR pokazuje poradnik braki danych i imputacja wielokrotna w R. Ten wpis zaczyna się tam, gdzie tamte się kończą. Zajmujemy się problemami, które pojawiają się dopiero w prawdziwym modelu do artykułu:
- jak czytać wszystkie kolumny wydruku
pool()i co z nich raportować; - jak imputować, gdy model zawiera interakcję albo inną funkcję zmiennych;
- jak połączyć R², test bloku predyktorów i statystykę χ², których nie wolno po prostu uśrednić;
- jak przeprowadzić SEM na danych imputowanych i kiedy wystarczy FIML.
Wszystkie liczby pochodzą z pakietu mice (van Buuren i Groothuis-Oudshoorn, 2011) i lavaan, a dane są symulowane, więc znamy wynik przed usunięciem wartości.
Przykład: wypalenie nauczycieli
W badaniu 400 nauczycieli wypalenie (1–7) wyjaśniamy obciążeniem pracą i wsparciem przełożonego (1–5). Hipoteza dotyczy interakcji: wsparcie ma osłabiać związek obciążenia z wypaleniem. Zmienną kontrolną jest staż pracy. Kwestionariusz zawierał też pytanie o zmęczenie, które nie wchodzi do modelu analizy. Zmęczone osoby częściej przerywały jednak wypełnianie ankiety. Brakuje 26.2% wyników wypalenia i 18.0% wyników obciążenia, a niepełne dane ma 36% osób. Braki są typu MAR względem zmęczenia i stażu (zob. MCAR, MAR i MNAR), więc zmęczenie jest zmienną pomocniczą. Według Grahama (2003) taka zmienna poprawia estymację, gdy jest skorelowana ze zmiennymi z brakami, nawet jeśli nie wiąże się z samym brakiem.
Przed imputacją obie zmienne wycentrowaliśmy średnimi obserwowanymi i policzyliśmy ich iloczyn. Imputacja objęła staż, obie wycentrowane zmienne, iloczyn, wypalenie i zmęczenie. Użyliśmy metody norm (regresja liniowa z losowaniem parametrów modelu) i utworzyliśmy 40 zbiorów. Wartości imputowane wypalenia mają w poszczególnych zbiorach średnie od 4.05 do 4.32, a średnia obserwowana wynosi 3.40. Wyższe wartości imputowane są oczekiwanym skutkiem MAR, bo brakuje głównie zmęczonych osób.
Jak czytać wydruk pool()
Funkcja pool() łączy wyniki 40 regresji. Oprócz oszacowania zwraca składniki, z których powstaje błąd standardowy. Dla interakcji wyglądają one tak:
| Kolumna | Co oznacza | Interakcja w przykładzie |
|---|---|---|
estimate | średnia oszacowań z m zbiorów | −0.444 |
ubar | średnia wariancja wewnątrz zbiorów (kwadrat SE) | 0.0031 |
b | wariancja oszacowań między zbiorami | 0.0020 |
t | wariancja całkowita: ubar + (1 + 1/m) × b | 0.0051, czyli SE = 0.072 |
df | stopnie swobody Barnarda–Rubina | 123.8 |
riv | względny przyrost wariancji z powodu braków | 0.64 |
lambda | część wariancji całkowitej przypadająca na braki | .39 |
fmi | frakcja brakującej informacji | .40 |
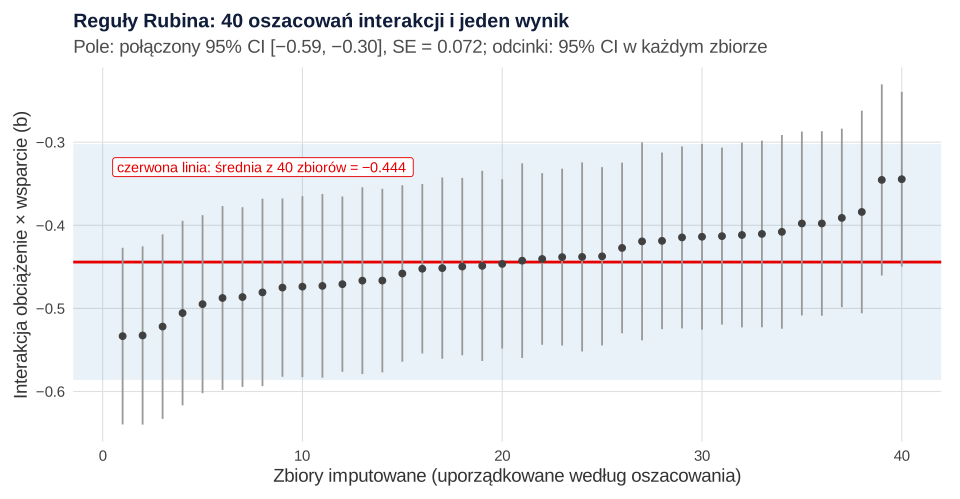
Rysunek 1 pokazuje, skąd bierze się wariancja między zbiorami. Oszacowanie interakcji waha się od −0.533 do −0.345 zależnie od tego, jakie wartości wylosowano w miejsce braków. Wariancja tych 40 liczb (b) to dodatkowa niepewność, której nie ma żaden pojedynczy zbiór. Dlatego połączony przedział ufności jest szerszy niż przedziały w każdym zbiorze.
Do artykułu wystarczą zwykle oszacowanie, SE, CI, p i FMI. FMI pokazuje, ile informacji o danym parametrze utracono przez braki, i bywa wyraźnie różna dla różnych parametrów. U nas wynosi .17 dla stażu, .22 dla obciążenia, .33 dla wsparcia i .40 dla interakcji. Najwięcej informacji traci interakcja. Stopnie swobody wynikają z liczby imputacji i FMI (por. stopnie swobody). Przy dużej FMI i małej liczbie imputacji są niskie, a przedział ufności szerszy.
Interakcje: najpierw przekształć, potem imputuj
Model imputacji musi zawierać wszystko, co jest w modelu analizy, także interakcje i składniki nieliniowe. Gdy imputujesz same zmienne główne, a iloczyn liczysz dopiero z uzupełnionych danych, wartości imputowane powstają tak, jakby interakcji nie było. Von Hippel (2009) przeanalizował kilka sposobów imputowania interakcji i kwadratów. Zaleca regułę „najpierw przekształć, potem imputuj”: policz iloczyn w danych niepełnych i imputuj go jak każdą inną zmienną. W literaturze to podejście nazywa się często JAV (ang. just another variable). Wartości imputowanego iloczynu nie będą się zgadzać z iloczynem imputowanych składników, ale oszacowania regresji są trafne. Metody, które tę niespójność „naprawiają”, w tym imputacja pasywna, prowadzą według von Hippla do obciążonych wyników.
| Predyktor | Pełne dane (N = 400) | Przypadki kompletne (n = 256) | MI bez iloczynu | MI z iloczynem (JAV) |
|---|---|---|---|---|
| Obciążenie | 0.61 (0.05) | 0.55 (0.06) | 0.53 (0.06) | 0.59 (0.06) |
| Wsparcie | −0.36 (0.05) | −0.27 (0.06) | −0.30 (0.05) | −0.35 (0.05) |
| Obciążenie × wsparcie | −0.46 (0.06) | −0.42 (0.07) | −0.31 (0.07) | −0.44 (0.07) |
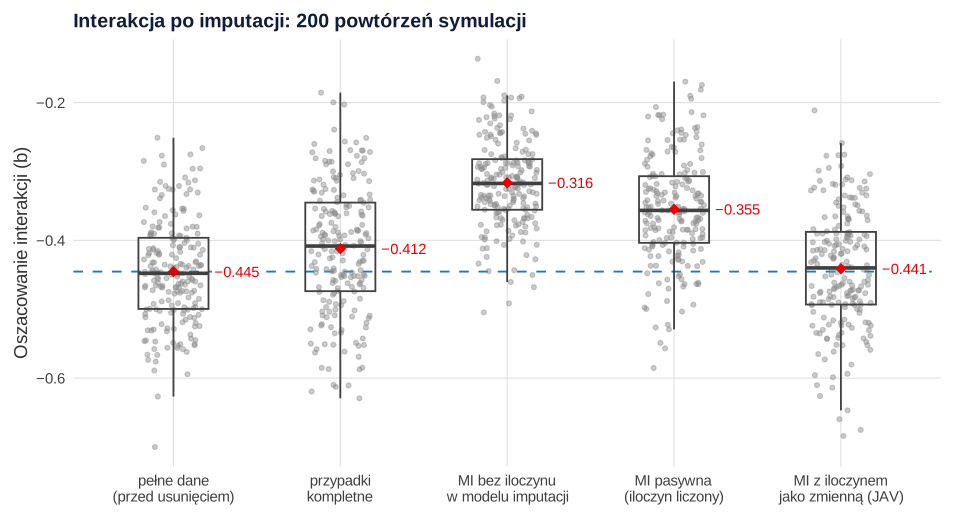
Pełne dane to zbiór sprzed usunięcia wartości. Imputacja bez iloczynu osłabiła interakcję o jedną trzecią, a imputacja JAV dała wynik bliski pełnym danym. Jedno badanie może być jednak dziełem przypadku, dlatego powtórzyliśmy całą procedurę 200 razy (Rysunek 2). Średnie oszacowanie interakcji wyniosło −0.445 w pełnych danych i −0.441 po imputacji JAV. W analizie przypadków kompletnych spadło do −0.412, w imputacji pasywnej do −0.355, a w imputacji bez iloczynu do −0.316. Imputacja pasywna przekazuje iloczyn do modelu wypalenia, ale samo obciążenie imputuje bez interakcji, więc nadal jej nie odtwarza. Te same zasady dotyczą kwadratów i splajnów (zob. splajny i GAM) oraz interakcji zmiennych latentnych.
Co wolno uśrednić, a czego nie
Reguły Rubina zakładają, że oszacowanie ma w przybliżeniu rozkład normalny, a jego wariancja jest znana. Współczynniki regresji i ścieżek spełniają ten warunek. Inne statystyki trzeba najpierw przekształcić albo połączyć osobną procedurą.
- R². Harel (2009) proponuje szacować R² i skorygowane R² po imputacji wielokrotnej zamiast na przypadkach kompletnych. W mice robi to
pool.r.squared(), która uśrednia wartości po transformacji Fishera. W przykładzie R² = .45, 95% CI [.36, .54], a skorygowane R² = .45. - Test bloku predyktorów. W regresji hierarchicznej zamiast testu F zmiany użyj statystyki D1. To wielowymiarowy test Walda z połączoną macierzą kowariancji. Statystyki D1, D2 i D3 opisuje van Buuren (2018). Obciążenie, wsparcie i interakcja dodane do stażu dają F(3, 288.0) = 73.92, p < .001.
- Wartości p i statystyki χ². Nie uśredniaj ich. Średnia χ² z kilku zbiorów jest zawyżona przez zmienność między imputacjami. Połącz je statystyką D2 albo D3.
SEM na danych imputowanych
W SEM masz dwie drogi: imputację wielokrotną pozycji i analizę każdego zbioru albo estymację metodą największej wiarygodności z pełną informacją (FIML). Funkcję runMI() usunięto z pakietu semTools w wersji 0.5-8, a jej następcą jest pakiet lavaan.mi (informacja z pliku NEWS pakietu semTools). Gdy lavaan.mi nie jest zainstalowany, wystarczy pętla: dopasuj model w każdym zbiorze i połącz ścieżki regułami Rubina. Tak robi przepis 2.
W wersji SEM wypalenie mierzą cztery pozycje, a obciążenie i wsparcie po trzy (skala 1–5). Gdy brakuje wypalenia lub obciążenia, brakuje całego bloku pozycji. Niepełne dane ma 39.5% osób. Model strukturalny to WYP ~ OBC + WSP, a kod lavaan jest standardowy (std.lv = TRUE, więc wariancje czynników egzogenicznych i wariancja resztowa wypalenia są równe 1).
| Metoda | OBC → WYP (SE) | WSP → WYP (SE) |
|---|---|---|
| Pełne dane (przed usunięciem) | 0.78 | −0.58 |
| Imputacja wielokrotna (40 zbiorów, ze zmęczeniem) | 0.73 (0.12) | −0.61 (0.11) |
| FIML bez zmiennej pomocniczej | 0.63 (0.13) | −0.52 (0.11) |
| FIML z modelem nasyconych korelatów | 0.72 (0.13) | −0.60 (0.11) |
Imputacja wielokrotna i FIML z nasyconymi korelatami dają niemal te same ścieżki, bo korzystają z tej samej informacji o zmęczeniu. FIML bez zmęczenia zaniża obie ścieżki, bo z punktu widzenia samego modelu braki nie są MAR. Graham (2003) pokazał, że w modelu nasyconych korelatów zmienne pomocnicze dołącza się do SEM bez zmiany modelu analizy. W semTools robi to funkcja auxiliary(). Lavaan zgłasza przy tym ostrzeżenie o macierzy reszt (theta), bo w tym modelu przechowuje ona kowariancje zmiennej pomocniczej z resztami pozycji. Sprawdziliśmy, że macierz kowariancji implikowana przez model jest dodatnio określona. Enders i Bandalos (2001) pokazali w symulacji, że przy brakach MCAR i MAR FIML daje w SEM nieobciążone i efektywne oszacowania. Lee i Shi (2021) potwierdzili, że przy poprawnie określonym modelu FIML i imputacja dają praktycznie te same wyniki. Różnice pojawiają się, gdy model nie pasuje dokładnie w populacji.
Dopasowanie modelu po imputacji wymaga osobnej uwagi. Statystyka χ² wynosi w poszczególnych zbiorach od 37.48 do 77.70 (df = 32, mediana 56.19). Połączona statystyka D2 daje F(32, 500.7) = 1.05, p = .389, więc dopasowanie jest dobre. CFI wynosi w zbiorach od .960 do .995, RMSEA od .021 do .060, a SRMR od .030 do .045. Dla tych indeksów nie ma jednej przyjętej reguły łączenia, dlatego podaj ich zakres i przyjętą metodę. Jeśli ważne jest dokładne dopasowanie, rozważ FIML z nasyconymi korelatami jako analizę główną albo uzupełniającą. Ogólną procedurę oceny modelu omawia przewodnik po SEM.
Jak opisać imputację w artykule
Lista informacji o brakach i imputacji, której oczekują recenzenci, jest we wpisie o imputacji w R. W modelu z interakcją lub w SEM dodaj sposób imputacji przekształceń, zmienne pomocnicze, metodę łączenia testów i dopasowania oraz FMI kluczowych parametrów. Wynik bez imputacji podaj w analizie wrażliwości.
Jeśli recenzent pyta o model imputacji albo o połączenie wyników SEM, możemy sprawdzić analizę i przygotować odpowiedź w ramach wsparcia statystycznego dla badaczy.
Imputacja wielokrotna w regresji i SEM w R
Trzy przepisy: regresja z interakcją w mice z pełnym wydrukiem pool(), R² i D1; SEM na 40 zbiorach z ręcznym łączeniem, D2 i porównaniem z FIML; symulacja 200 powtórzeń do Rysunku 2. Potrzebne pakiety: mice, lavaan i semTools.
1. Regresja z interakcją: trzy sposoby imputacji i reguły Rubina
R
# Dane symulowane: 400 nauczycieli; wypalenie (1–7) a obciążenie pracą i wsparcie przełożonego (1–5) z interakcją
# Braki MAR: częściej brakuje wypalenia i obciążenia u osób bardziej zmęczonych (zmienna pomocnicza) i z krótszym stażem
suppressPackageStartupMessages(library(mice))
set.seed(2051)
n <- 400
staz <- round(runif(n, 1, 35))
obc <- pmin(pmax(rnorm(n, 3.2, 0.7), 1), 5)
wsp <- pmin(pmax(3.4 - 0.25 * (obc - 3.2) + rnorm(n, 0, 0.75), 1), 5)
wyp <- 3.6 + 0.60 * (obc - 3.2) - 0.40 * (wsp - 3.4) - 0.45 * (obc - 3.2) * (wsp - 3.4) - 0.01 * (staz - 18) + rnorm(n, 0, 0.75)
wyp <- pmin(pmax(wyp, 1), 7)
zmecz <- round(pmin(pmax(3 + 0.8 * (wyp - 3.6) + rnorm(n, 0, 0.55), 1), 5), 1)   # zmęczenie: zmienna pomocnicza
pelne <- data.frame(staz, obc, wsp, wyp, zmecz)

# usuwanie wartości (MAR względem zmęczenia i stażu)
dane <- pelne
dane$wyp[runif(n) < plogis(-1.4 + 1.3 * (zmecz - 3))] <- NA
dane$obc[runif(n) < plogis(-1.9 + 0.9 * (zmecz - 3) - 0.04 * (staz - 18))] <- NA
round(colMeans(is.na(dane)) * 100, 1)
round(mean(!complete.cases(dane)) * 100, 1)

# centrowanie średnimi obserwowanymi i iloczyn liczony PRZED imputacją („transform, then impute”)
sr_obc <- mean(dane$obc, na.rm = TRUE); sr_wsp <- mean(dane$wsp)
centruj <- function(d) within(d, { obc_c <- obc - sr_obc; wsp_c <- wsp - sr_wsp; ilo <- obc_c * wsp_c })
dane <- centruj(dane); pelne <- centruj(pelne)
model <- wyp ~ obc_c + wsp_c + ilo + staz

# A. pełne dane (przed usunięciem) i analiza przypadków kompletnych
coef_tab <- function(f) round(cbind(b = coef(f), SE = sqrt(diag(vcov(f)))), 3)
coef_tab(lm(model, data = pelne))
cc <- lm(model, data = dane); nobs(cc); coef_tab(cc)

# B. imputacja bez interakcji: iloczyn liczony dopiero z wartości imputowanych
d_b <- dane[, c("staz", "obc_c", "wsp_c", "wyp", "zmecz")]
imp_b <- mice(d_b, m = 40, method = "norm", maxit = 20, seed = 51, printFlag = FALSE)
fit_b <- with(imp_b, lm(wyp ~ obc_c + wsp_c + I(obc_c * wsp_c) + staz))

# C. imputacja z iloczynem jako zwykłą zmienną (JAV)
d_c <- dane[, c("staz", "obc_c", "wsp_c", "ilo", "wyp", "zmecz")]
imp_c <- mice(d_c, m = 40, method = "norm", maxit = 20, seed = 52, printFlag = FALSE)
fit_c <- with(imp_c, lm(wyp ~ obc_c + wsp_c + ilo + staz))

# Reguły Rubina: pełny wydruk pool() dla wariantu C
pc <- pool(fit_c)
print(cbind(pc$pooled[, "term", drop = FALSE], round(pc$pooled[, c("estimate", "ubar", "b", "t", "df", "riv", "lambda", "fmi")], 4)), row.names = FALSE)
s_c <- summary(pc, conf.int = TRUE)
round(range(sapply(fit_c$analyses, function(f) coef(f)[["ilo"]])), 3)   # rozrzut interakcji między 40 zbiorami
print(cbind(s_c[, "term", drop = FALSE], round(s_c[, c("estimate", "std.error", "statistic", "df", "p.value", "2.5 %", "97.5 %")], 3)), row.names = FALSE)

# Porównanie wariantów: współczynniki (SE) dla obciążenia, wsparcia i interakcji
s_b <- summary(pool(fit_b), conf.int = TRUE)
porown <- function(b, se) sprintf("%.3f (%.3f)", b, se)
tab <- data.frame(term = c("obc_c", "wsp_c", "ilo"),
  pelne = porown(coef(lm(model, data = pelne))[2:4], sqrt(diag(vcov(lm(model, data = pelne))))[2:4]),
  cc = porown(coef(cc)[2:4], sqrt(diag(vcov(cc)))[2:4]),
  bez_interakcji = porown(s_b$estimate[2:4], s_b$std.error[2:4]),
  JAV = porown(s_c$estimate[2:4], s_c$std.error[2:4]))
print(tab, row.names = FALSE)
round(summary(lm(model, data = pelne))$r.squared, 3)

# R² po imputacji (transformacja Fishera) i test bloku predyktorów D1 (zamiast F zmiany)
round(pool.r.squared(fit_c), 3)
round(pool.r.squared(fit_c, adjusted = TRUE), 3)
fit_0 <- with(imp_c, lm(wyp ~ staz))
D1(fit_c, fit_0)

# Diagnostyka zbieżności: średnia imputowanego wypalenia w kolejnych iteracjach (wykres: plot(imp_c))
round(range(sapply(complete(imp_c, "all"), function(d) mean(d$wyp[is.na(dane$wyp)]))), 2)
round(mean(dane$wyp, na.rm = TRUE), 2)
Wynik w R
 staz   obc   wsp   wyp zmecz
  0.0  18.0   0.0  26.2   0.0
[1] 36
                 b    SE
(Intercept)  3.655 0.070
obc_c        0.610 0.051
wsp_c       -0.361 0.045
ilo         -0.455 0.055
staz        -0.006 0.004
[1] 256
                 b    SE
(Intercept)  3.448 0.085
obc_c        0.547 0.060
wsp_c       -0.272 0.055
ilo         -0.422 0.072
staz        -0.003 0.004
        term estimate   ubar      b      t       df    riv lambda    fmi
 (Intercept)   3.6041 0.0042 0.0012 0.0055 219.2094 0.2883 0.2238 0.2308
       obc_c   0.5898 0.0024 0.0007 0.0031 224.6533 0.2765 0.2166 0.2235
       wsp_c  -0.3462 0.0018 0.0008 0.0026 155.3385 0.4775 0.3232 0.3317
         ilo  -0.4442 0.0031 0.0020 0.0051 123.8229 0.6398 0.3902 0.3998
        staz  -0.0041 0.0000 0.0000 0.0000 265.4750 0.2001 0.1668 0.1730
[1] -0.533 -0.345
        term estimate std.error statistic      df p.value  2.5 % 97.5 %
 (Intercept)    3.604     0.074    48.735 219.209    0.00  3.458  3.750
       obc_c    0.590     0.056    10.611 224.653    0.00  0.480  0.699
       wsp_c   -0.346     0.051    -6.739 155.338    0.00 -0.448 -0.245
         ilo   -0.444     0.072    -6.198 123.823    0.00 -0.586 -0.302
        staz   -0.004     0.004    -1.129 265.475    0.26 -0.011  0.003
  term          pelne             cc bez_interakcji            JAV
 obc_c  0.610 (0.051)  0.547 (0.060)  0.529 (0.060)  0.590 (0.056)
 wsp_c -0.361 (0.045) -0.272 (0.055) -0.298 (0.053) -0.346 (0.051)
   ilo -0.455 (0.055) -0.422 (0.072) -0.309 (0.067) -0.444 (0.072)
[1] 0.488
      est lo 95 hi 95   fmi
R^2 0.452 0.356 0.541 0.403
          est lo 95 hi 95   fmi
adj R^2 0.446  0.35 0.537 0.406
   test statistic df1      df2 dfcom      p.value       riv
 1 ~~ 2  73.91913   3 287.9919   395 1.763438e-35 0.4566764
[1] 4.05 4.32
[1] 3.4
2. SEM: imputacja pozycji, łączenie ścieżek, D2 i FIML
R
# Ten sam scenariusz w SEM: obciążenie (3 pozycje), wsparcie (3 pozycje) i wypalenie (4 pozycje) jako zmienne latentne
# Braki w pozycjach wypalenia i obciążenia zależą od zmęczenia (MAR); zmęczenie nie występuje w modelu analizy
suppressPackageStartupMessages({ library(mice); library(lavaan); library(semTools) })
set.seed(2052)
n <- 400
OBC <- rnorm(n); WSP <- -0.25 * OBC + rnorm(n, 0, sqrt(1 - 0.25^2))
WYP <- 0.55 * OBC - 0.35 * WSP + rnorm(n, 0, 0.7)
pozycje <- function(f, lad, k) sapply(1:k, function(j) pmin(pmax(round(3 + 0.9 * (lad[j] * f + rnorm(n, 0, sqrt(1 - lad[j]^2)))), 1), 5))
X <- data.frame(pozycje(OBC, c(.80, .75, .70), 3), pozycje(WSP, c(.80, .80, .70), 3), pozycje(WYP / sd(WYP), c(.85, .80, .75, .70), 4))
names(X) <- c(paste0("obc", 1:3), paste0("wsp", 1:3), paste0("wyp", 1:4))
zmecz <- round(pmin(pmax(3 + 0.9 * as.numeric(scale(WYP)) + rnorm(n, 0, 0.45), 1), 5), 1)
pelne <- cbind(X, zmecz)
dane <- pelne
r_wyp <- runif(n) < plogis(-1.4 + 2.0 * (zmecz - 3)); dane[r_wyp, paste0("wyp", 1:4)] <- NA   # brak całego bloku
r_obc <- runif(n) < plogis(-2.0 + 1.5 * (zmecz - 3)); dane[r_obc, paste0("obc", 1:3)] <- NA
round(mean(!complete.cases(dane)) * 100, 1)

model <- '
  OBC =~ obc1 + obc2 + obc3
  WSP =~ wsp1 + wsp2 + wsp3
  WYP =~ wyp1 + wyp2 + wyp3 + wyp4
  WYP ~ b1 * OBC + b2 * WSP
'
sciezki <- function(f) { p <- parameterEstimates(f); p[p$op == "~", c("label", "est", "se")] }

# 1. Imputacja wielokrotna pozycji (pmm), SEM w każdym zbiorze, łączenie regułami Rubina
imp <- mice(dane, m = 40, method = "pmm", maxit = 20, seed = 2052, printFlag = FALSE)
fity <- lapply(complete(imp, "all"), function(d) sem(model, data = d, std.lv = TRUE))
Q <- sapply(fity, function(f) sciezki(f)$est); U <- sapply(fity, function(f) sciezki(f)$se^2)
rubin <- function(q, u) {
  m <- length(q); qbar <- mean(q); W <- mean(u); B <- var(q); T <- W + (1 + 1 / m) * B
  r <- (1 + 1 / m) * B / W; df <- (m - 1) * (1 + 1 / r)^2                 # df Rubina (próba duża)
  c(est = qbar, SE = sqrt(T), lo = qbar - qt(.975, df) * sqrt(T), hi = qbar + qt(.975, df) * sqrt(T), fmi = (r + 2 / (df + 3)) / (r + 1))
}
mi <- t(sapply(1:2, function(i) rubin(Q[i, ], U[i, ]))); rownames(mi) <- c("OBC", "WSP")
round(mi, 3)

# Dopasowanie: chi-kwadrat w każdym zbiorze i łączna statystyka D2 (opis: van Buuren, 2018)
chi <- unname(sapply(fity, fitMeasures, "chisq")); df_mod <- unname(fitMeasures(fity[[1]], "df"))
round(c(min = min(chi), mediana = median(chi), max = max(chi)), 2)
D2 <- function(d, k) {
  m <- length(d); r <- (1 + 1 / m) * var(sqrt(d))
  F <- (mean(d) / k - (m + 1) / (m - 1) * r) / (1 + r); v <- k^(-3 / m) * (m - 1) * (1 + 1 / r)^2
  c(F = F, df1 = k, df2 = v, p = pf(F, k, v, lower.tail = FALSE))
}
round(D2(chi, df_mod), 3)
round(apply(sapply(fity, fitMeasures, c("cfi", "rmsea", "srmr")), 1, range), 3)

# 2. FIML bez zmiennych pomocniczych i z modelem nasyconych korelatów (zmęczenie skorelowane z resztami)
fiml <- sem(model, data = dane, std.lv = TRUE, missing = "fiml")
fiml_aux <- auxiliary(model, data = dane, aux = "zmecz", fun = "sem", std.lv = TRUE)
min(eigen(fitted(fiml_aux)$cov)$values) > 0   # macierz implikowana przez model jest dodatnio określona
pelne_fit <- sem(model, data = pelne, std.lv = TRUE)
porown <- rbind(pelne_dane = sciezki(pelne_fit)$est, MI = mi[, "est"], FIML = sciezki(fiml)$est, FIML_aux = sciezki(fiml_aux)$est)
colnames(porown) <- c("OBC", "WSP"); round(porown, 3)
round(rbind(MI = mi[, "SE"], FIML = sciezki(fiml)$se, FIML_aux = sciezki(fiml_aux)$se), 3)
Wynik w R
[1] 39.5
       est    SE     lo     hi   fmi
OBC  0.727 0.123  0.486  0.967 0.249
WSP -0.612 0.107 -0.823 -0.402 0.182
    min mediana     max
  37.48   56.19   77.70
      F     df1     df2       p
  1.054  32.000 500.670   0.389
       cfi rmsea  srmr
[1,] 0.960 0.021 0.030
[2,] 0.995 0.060 0.045
Warning: lavaan->lav_object_post_check():
   the covariance matrix of the residuals of the observed variables (theta)
   is not positive definite ; use lavInspect(fit, "theta") to investigate.
[1] TRUE
             OBC    WSP
pelne_dane 0.780 -0.578
MI         0.727 -0.612
FIML       0.633 -0.520
FIML_aux   0.718 -0.604
           OBC   WSP
MI       0.123 0.107
FIML     0.133 0.109
FIML_aux 0.130 0.106
3. Symulacja: imputacja interakcji w 200 powtórzeniach
R
# Symulacja: jak sposób imputacji wpływa na oszacowanie interakcji (200 powtórzeń, ten sam model co w przepisie 1)
# Obciążenie liczone względem średniej z pełnych danych (przed usunięciem wartości); czas: kilka minut
suppressPackageStartupMessages(library(mice))
generuj <- function(n = 400) {
  staz <- round(runif(n, 1, 35)); obc <- pmin(pmax(rnorm(n, 3.2, 0.7), 1), 5)
  wsp <- pmin(pmax(3.4 - 0.25 * (obc - 3.2) + rnorm(n, 0, 0.75), 1), 5)
  wyp <- pmin(pmax(3.6 + 0.60 * (obc - 3.2) - 0.40 * (wsp - 3.4) - 0.45 * (obc - 3.2) * (wsp - 3.4) -
                   0.01 * (staz - 18) + rnorm(n, 0, 0.75), 1), 7)
  zmecz <- round(pmin(pmax(3 + 0.8 * (wyp - 3.6) + rnorm(n, 0, 0.55), 1), 5), 1)
  p <- data.frame(staz, obc, wsp, wyp, zmecz); d <- p
  d$wyp[runif(n) < plogis(-1.4 + 1.3 * (zmecz - 3))] <- NA
  d$obc[runif(n) < plogis(-1.9 + 0.9 * (zmecz - 3) - 0.04 * (staz - 18))] <- NA
  c_obc <- mean(d$obc, na.rm = TRUE); c_wsp <- mean(d$wsp)
  f <- function(x) within(x, { obc_c <- obc - c_obc; wsp_c <- wsp - c_wsp; ilo <- obc_c * wsp_c })
  list(pelne = f(p)[, c("staz", "obc_c", "wsp_c", "ilo", "wyp", "zmecz")], dane = f(d)[, c("staz", "obc_c", "wsp_c", "ilo", "wyp", "zmecz")])
}
interakcja_mi <- function(imp) summary(pool(with(imp, lm(wyp ~ obc_c + wsp_c + I(obc_c * wsp_c) + staz))))$estimate[4]
jedna <- function() {
  g <- generuj(); d <- g$dane
  bez <- mice(d[, -4], m = 10, method = "norm", maxit = 10, printFlag = FALSE)
  jav <- mice(d, m = 10, method = "norm", maxit = 10, printFlag = FALSE)
  met <- make.method(d); met["ilo"] <- "~I(obc_c * wsp_c)"
  pm <- make.predictorMatrix(d); pm[c("obc_c", "wsp_c"), "ilo"] <- 0
  pas <- mice(d, m = 10, method = met, predictorMatrix = pm, maxit = 10, printFlag = FALSE)
  c(pelne = coef(lm(wyp ~ obc_c + wsp_c + ilo + staz, g$pelne))[["ilo"]],
    cc = coef(lm(wyp ~ obc_c + wsp_c + ilo + staz, d))[["ilo"]],
    bez_interakcji = interakcja_mi(bez), pasywna = interakcja_mi(pas),
    JAV = summary(pool(with(jav, lm(wyp ~ obc_c + wsp_c + ilo + staz))))$estimate[4])
}
set.seed(2053)
sym <- t(replicate(200, jedna()))
round(rbind(srednia = colMeans(sym), SD = apply(sym, 2, sd), obciazenie = colMeans(sym) - mean(sym[, "pelne"])), 3)
Wynik w R
            pelne     cc bez_interakcji pasywna    JAV
srednia    -0.445 -0.412         -0.316  -0.355 -0.441
SD          0.076  0.093          0.064   0.079  0.086
obciazenie  0.000  0.033          0.129   0.090  0.004
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mice (wersja 3.19.0): van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2025). semTools: Useful tools for structural equation modeling [R package]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Imputacja bez interakcji, która jest w modelu analizy. Efekt interakcji słabnie, a wniosek o moderacji może zniknąć (zob. analiza moderacji).
- Uśrednianie wartości p, χ² albo R² bez przekształcenia. Do testów użyj D1–D3, do R² transformacji Fishera.
- Analiza na jednym zbiorze imputowanym albo na zbiorze „uśrednionym” z 40 imputacji. Oba sposoby gubią wariancję między zbiorami i zaniżają SE.
- FIML bez zmiennych pomocniczych, gdy wiadomo, od czego zależą braki. Dołącz je modelem nasyconych korelatów.
- Raport bez FMI i bez opisu modelu imputacji. Czytelnik nie oceni, ile wyników pochodzi z danych, a ile z założeń. Jeśli braki są liczne, dodaj przedziały ufności i porównanie z analizą przypadków kompletnych.
Najczęstsze pytania
Jak odczytać wynik funkcji pool() w pakiecie mice?
Kolumna estimate to średnia oszacowań z wszystkich zbiorów, ubar – średnia wariancja wewnątrz zbiorów, b – wariancja między zbiorami, a t = ubar + (1 + 1/m) × b to wariancja całkowita (SE = √t). Kolumny riv, lambda i fmi mówią, ile niepewności dodały braki, a df to stopnie swobody Barnarda–Rubina. Do artykułu zwykle wystarczą oszacowanie, SE, CI, p i FMI.
Jak imputować interakcję dwóch zmiennych?
Policz iloczyn (najlepiej wycentrowanych zmiennych) przed imputacją i imputuj go jak zwykłą zmienną, razem ze składnikami i zmienną zależną. Von Hippel (2009) pokazał, że ta reguła „najpierw przekształć, potem imputuj” daje trafne oszacowania, a imputacja pasywna i liczenie iloczynu dopiero po imputacji osłabiają interakcję. W przykładzie imputacja bez iloczynu zaniżyła interakcję z −0.44 do −0.31.
Jak połączyć R² po imputacji wielokrotnej?
Nie uśredniaj R² bezpośrednio. Funkcja pool.r.squared() z pakietu mice łączy R² albo skorygowane R² po transformacji Fishera z i podaje 95% CI oraz FMI (Harel, 2009). Do testu przyrostu wyjaśnionej wariancji użyj statystyki D1 zamiast zwykłego testu F zmiany.
Jak zrobić SEM na danych po imputacji wielokrotnej w lavaan?
Dopasuj ten sam model w każdym zbiorze, połącz ścieżki regułami Rubina, a statystykę χ² – procedurą D2 lub D3. Gotowe funkcje ma pakiet lavaan.mi, następca usuniętej z semTools funkcji runMI(). Bez niego wystarczy pętla lapply() i kilka linii kodu, jak w przykładzie z tego wpisu.
Imputacja wielokrotna czy FIML w SEM – co wybrać?
Przy poprawnie określonym modelu obie metody dają praktycznie te same wyniki (Lee i Shi, 2021), pod warunkiem że korzystają z tej samej informacji. FIML bez zmiennych pomocniczych, od których zależą braki, może być obciążona; dołącz je modelem nasyconych korelatów (Graham, 2003). Imputacja jest wygodniejsza, gdy ten sam zbiór służy wielu analizom.
Powiązane hasła
Przeczytaj też
Braki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikAnaliza wrażliwości w artykule naukowym
Jak dobrać warianty, policzyć je w R (braki danych, obserwacje odstające, specyfikacje), zbudować krzywą specyfikacji i opisać wyniki w artykule.
Czytaj →Recenzent pyta o model imputacji albo o połączenie wyników SEM?
Sprawdzimy model imputacji, łączenie wyników i analizę wrażliwości oraz wyjaśnimy je tak, żebyś mógł(a) samodzielnie opisać i obronić decyzje w artykule.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Enders, C. K., & Bandalos, D. L. (2001). The relative performance of full information maximum likelihood estimation for missing data in structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 430–457. https://doi.org/10.1207/s15328007sem0803_5
- Graham, J. W. (2003). Adding missing-data-relevant variables to FIML-based structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 10(1), 80–100. https://doi.org/10.1207/s15328007sem1001_4
- Harel, O. (2009). The estimation of R² and adjusted R² in incomplete data sets using multiple imputation. Journal of Applied Statistics, 36(10), 1109–1118. https://doi.org/10.1080/02664760802553000
- Lee, T., & Shi, D. (2021). A comparison of full information maximum likelihood and multiple imputation in structural equation modeling with missing data. Psychological Methods, 26(4), 466–485. https://doi.org/10.1037/met0000381
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. Wiley. https://doi.org/10.1002/9780470316696
- van Buuren, S. (2018). Flexible imputation of missing data (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429492259 ● Otwarty dostęp: pełny tekst
- van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03 ● Otwarty dostęp
- von Hippel, P. T. (2009). How to impute interactions, squares, and other transformed variables. Sociological Methodology, 39(1), 265–291. https://doi.org/10.1111/j.1467-9531.2009.01215.x
Cytowania BibTeX
@article{enders2001relative, author={Enders, Craig K. and Bandalos, Deborah L.}, title={{The relative performance of full information maximum likelihood estimation for missing data in structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={430--457}, doi={10.1207/s15328007sem0803_5}}@article{graham2003adding, author={Graham, John W.}, title={{Adding missing-data-relevant variables to FIML-based structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2003}, volume={10}, number={1}, pages={80--100}, doi={10.1207/s15328007sem1001_4}}@article{harel2009estimation, author={Harel, Ofer}, title={{The estimation of R² and adjusted R² in incomplete data sets using multiple imputation}}, journal={Journal of Applied Statistics}, year={2009}, volume={36}, number={10}, pages={1109--1118}, doi={10.1080/02664760802553000}}@article{lee2021comparison, author={Lee, Taehun and Shi, Dexin}, title={{A comparison of full information maximum likelihood and multiple imputation in structural equation modeling with missing data}}, journal={Psychological Methods}, year={2021}, volume={26}, number={4}, pages={466--485}, doi={10.1037/met0000381}}@book{rubin1987multiple, author={Rubin, Donald B.}, title={{Multiple imputation for nonresponse in surveys}}, year={1987}, publisher={Wiley}, doi={10.1002/9780470316696}}@book{vanbuuren2018flexible, author={van Buuren, Stef}, title={{Flexible imputation of missing data (2nd ed.)}}, year={2018}, publisher={Chapman \& Hall/CRC}, doi={10.1201/9780429492259}}@article{vanbuuren2011mice, author={van Buuren, Stef and Groothuis-Oudshoorn, Karin}, title={{mice: Multivariate imputation by chained equations in R}}, journal={Journal of Statistical Software}, year={2011}, volume={45}, number={3}, pages={1--67}, doi={10.18637/jss.v045.i03}}@article{vonhippel2009how, author={von Hippel, Paul T.}, title={{How to impute interactions, squares, and other transformed variables}}, journal={Sociological Methodology}, year={2009}, volume={39}, number={1}, pages={265--291}, doi={10.1111/j.1467-9531.2009.01215.x}}