semTools::indProd (pary dopasowane, podwójne centrowanie), oszacuj model w lavaan i zinterpretuj interakcję prostymi nachyleniami.Kiedy interakcja latentna zamiast iloczynu średnich
Hipoteza moderacyjna mówi, że związek predyktora z wynikiem zależy od trzeciej zmiennej. W regresji testujesz ją iloczynem dwóch predyktorów (zob. interakcja zmiennych) – tę procedurę, z prostymi nachyleniami i przedziałem Johnsona–Neymana, opisuje poradnik analiza moderacji krok po kroku. W SEM predyktory są jednak zmiennymi latentnymi mierzonymi kilkoma wskaźnikami. Iloczyn średnich skal przenosi wtedy do modelu błąd pomiaru obu skal naraz.
Rzetelność iloczynu dwóch wycentrowanych zmiennych o rozkładzie normalnym wynosi (ρX × ρZ + r²) / (1 + r²), gdzie r to korelacja między nimi. Jest więc zwykle niższa niż rzetelność każdej skali osobno. W przykładzie poniżej skale mają α = .83 i .82, a ich iloczyn tylko .70. Niska rzetelność iloczynu zaniża współczynnik interakcji. Model z interakcją zmiennych latentnych oddziela wariancję prawdziwą od błędu także dla członu interakcyjnego.
Ten wpis zakłada, że znasz składnię lavaan i model pomiarowy w CFA (zob. CB-SEM w R (lavaan)). Gdy moderator jest kategorialny, np. płeć albo kraj, zamiast interakcji latentnej zwykle porównujesz grupy w modelu wielogrupowym, po sprawdzeniu inwariancji pomiaru. Szerszy plan pracy z modelem znajdziesz w przewodniku po modelowaniu SEM.
Dwie rodziny metod
Pierwsza rodzina to iloczyny wskaźników (product indicators). Tworzysz nowe zmienne obserwowane, mnożąc wskaźniki obu czynników, i traktujesz je jako wskaźniki czynnika interakcyjnego. Pierwszą propozycję szacowania interakcji zmiennych latentnych przedstawili Kenny i Judd (1984). Marsh i in. (2004) porównali w symulacjach kilka strategii. Tradycyjne podejście z ograniczeniami wypadło gorzej od nowszych, a wersja bez ograniczeń (unconstrained) była najłatwiejsza w użyciu i przy wskaźnikach o rozkładzie normalnym dawała względnie nieobciążone oszacowania. Little i in. (2006) zaproponowali ortogonalizację, czyli centrowanie resztowe iloczynów. Lin i in. (2010) pokazali, że podwójne centrowanie średnią nie wymaga ani modelowania średnich, ani dwuetapowej procedury.
Druga rodzina modeluje nienormalny rozkład, który powstaje, gdy w modelu jest iloczyn dwóch czynników. Najbardziej znana jest metoda LMS (latent moderated structural equations) Kleina i Moosbruggera (2000). Omawiamy ją niżej, w sekcji o LMS.
| Metoda | Na czym polega | Program |
|---|---|---|
| Iloczyny z ograniczeniami (podejście tradycyjne) | ładunki i wariancje czynnika interakcyjnego wyrażone nieliniowo przez parametry efektów głównych | każdy program SEM z ograniczeniami nieliniowymi |
| Iloczyny bez ograniczeń (Marsh i in., 2004) | parametry czynnika interakcyjnego szacowane swobodnie; wskaźniki wycentrowane | każdy program SEM, np. lavaan |
| Ortogonalizacja (Little i in., 2006) | iloczyny zastąpione resztami z ich regresji na wskaźnikach efektów głównych | każdy program SEM; w R semTools::indProd |
| Podwójne centrowanie (Lin i in., 2010) | wskaźniki centrowane przed mnożeniem, a iloczyny – ponownie po nim | każdy program SEM; domyślne w indProd |
| LMS (Klein i Moosbrugger, 2000) | największa wiarygodność z rozkładem wskaźników jako mieszaniną rozkładów normalnych; bez iloczynów wskaźników | Mplus; w R tylko pakiety dodatkowe |
Schoemann i Jorgensen (2021) opisują iloczyny wskaźników jako trafną metodę, którą można zastosować w każdym programie do modelowania zmiennych latentnych, i pokazują ją w pakiecie semTools. Tę drogę wybieramy w przykładzie.
Przykład: obciążenie, wsparcie i wyczerpanie
Czterysta pielęgniarek wypełniło trzy kwestionariusze: obciążenie pracą, wsparcie zespołu i wyczerpanie emocjonalne. Każdy konstrukt ma trzy wskaźniki. Są to wyniki krótkich podskal (skala 1–5), czyli parcele, a nie pojedyncze pozycje. Hipoteza buforująca mówi, że przy silniejszym wsparciu związek obciążenia z wyczerpaniem jest słabszy. Dane są symulowane, a w populacji interakcja w jednostkach odchylenia standardowego wynosi −0.221. Liczby pochodzą z kodu R na końcu strony. Zbiór możesz pobrać jako plik CSV (400 wierszy, kolumny o1–o3, w1–w3, y1–y3).
Krok 1. Model bez interakcji
Zacznij od modelu pomiarowego i efektów głównych bez członu interakcyjnego. Tu oceniasz dopasowanie, ładunki czynnikowe i rzetelność w zwykły sposób. Iloczyny wskaźników nie mają rozkładu normalnego, dlatego w obu modelach używamy estymatora MLR. Model bez interakcji był dopasowany akceptowalnie: χ²(24) = 45.14, p = .006, CFI = .983, RMSEA = .046, SRMR = .042 (wskaźniki odporne). Ładunki standaryzowane mieściły się w przedziale .63–.85. Gdy model pomiarowy jest słaby, interakcja latentna go nie naprawi. Wariancję i ładunki z tego modelu wykorzystasz w następnym kroku.
Krok 2. Iloczyny wskaźników w semTools
Funkcja indProd() z pakietu semTools tworzy iloczyny, a model szacujesz potem w lavaan (Rosseel, 2012). Trzeba podjąć trzy decyzje:
- Ile iloczynów. Przy trzech wskaźnikach na czynnik możesz utworzyć wszystkie 9 iloczynów albo 3 pary dopasowane (matched pairs). W parach dopasowanych każdy wskaźnik występuje raz, więc nie musisz dodawać korelacji reszt między iloczynami, które dzielą wskaźnik. To ustawienie domyślne (
match = TRUE), opisane przez Marsha i in. (2004). - Które wskaźniki połączyć. Ustal pary przed analizą, np. według ładunków z modelu bez interakcji. W przykładzie najsilniejszy wskaźnik obciążenia (
o1, .85) połączyliśmy z najsilniejszym wskaźnikiem wsparcia (w2, .82), a dalejo2 × w3io3 × w1. Inne pary dają nieco inny czynnik interakcyjny, więc zapisz tę decyzję w raporcie. - Centrowanie. Wskaźniki centrujesz przed mnożeniem (
meanC = TRUE), a iloczyny ponownie po nim (doubleMC = TRUE). To podwójne centrowanie Lin i in. (2010). Alternatywą jest ortogonalizacja (residualC = TRUE); wtedy do sondowania interakcji służy funkcjaprobe2WayRC().
Czynnik interakcyjny ObcWsp ma trzy wskaźniki: o1.w2, o2.w3 i o3.w1. Jego ładunki, wariancja i kowariancje z czynnikami głównymi są szacowane swobodnie, jak w podejściu bez ograniczeń.
Krok 3. Model z interakcją latentną
Model z czynnikiem interakcyjnym był dobrze dopasowany według CFI, RMSEA i SRMR: χ²(48) = 54.87, p = .230, CFI = .995, RMSEA = .020, SRMR = .036. Te wskaźniki opisują jednak głównie część pomiarową i nie mówią, czy interakcja jest potrzebna. O tym decyduje test współczynnika β3.
| Ścieżka | b | SE | 95% CI | z | p |
|---|---|---|---|---|---|
| Obciążenie → wyczerpanie (przy średnim wsparciu) | 0.373 | 0.049 | [0.277, 0.468] | 7.63 | < .001 |
| Wsparcie → wyczerpanie (przy średnim obciążeniu) | −0.306 | 0.063 | [−0.430, −0.183] | −4.88 | < .001 |
| Obciążenie × wsparcie | −0.237 | 0.062 | [−0.358, −0.116] | −3.83 | < .001 |
Współczynniki są w jednostkach pierwszych wskaźników (zmienne markerowe). Ponieważ czynniki są wycentrowane, efekty główne są warunkowe: opisują związek przy średnim poziomie drugiej zmiennej. Ujemna interakcja oznacza, że przy silniejszym wsparciu związek obciążenia z wyczerpaniem słabnie.
Uwaga na rozwiązanie standaryzowane. lavaan standaryzuje czynnik ObcWsp jak każdy inny czynnik, przez jego własne odchylenie standardowe, a ono nie jest iloczynem odchyleń standardowych obciążenia i wsparcia. Dlatego interakcję w jednostkach SD policz ręcznie: β3 × SD(Obc) × SD(Wsp) / SD(Wycz), z wariancji czynników z lavInspect(fit, "cov.lv"). W przykładzie wynosi ona −0.194, a w regresji na średnich skal −0.183. W tej jednej próbie oba oszacowania są więc zbliżone. Czy to przypadek, pokazuje symulacja w dalszej części wpisu.
Krok 4. Proste nachylenia i wykres
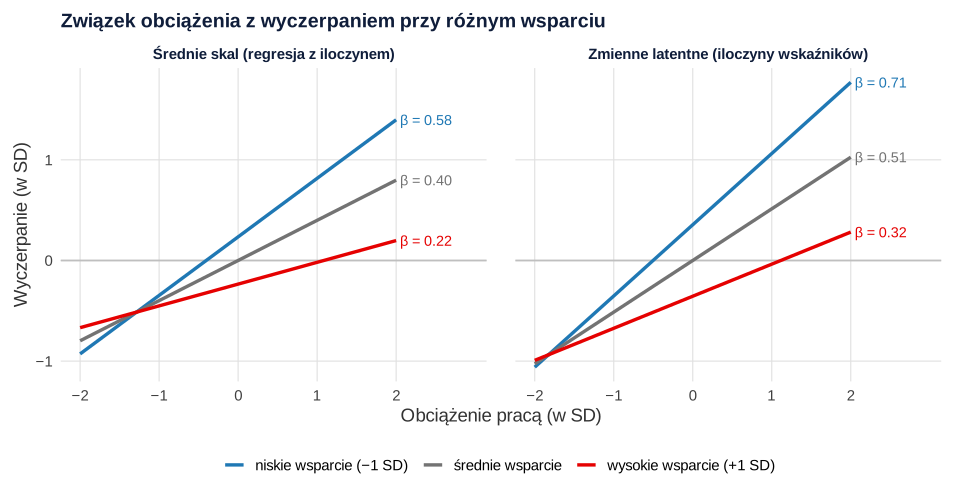
Istotną interakcję trzeba zinterpretować: narysować i sprawdzić proste nachylenia (Schoemann i Jorgensen, 2021). Funkcja probe2WayMC() liczy je dla czynników centrowanych. Wybraliśmy wartości wsparcia −1 SD, średnią i +1 SD, gdzie SD czynnika wynosi 0.597:
- przy niskim wsparciu: b = 0.514, SE = 0.067, z = 7.71, p < .001;
- przy średnim wsparciu: b = 0.373, SE = 0.049, z = 7.63, p < .001;
- przy wysokim wsparciu: b = 0.231, SE = 0.055, z = 4.19, p < .001.
Związek obciążenia z wyczerpaniem jest więc przy wysokim wsparciu ponad dwa razy słabszy niż przy niskim, ale nie znika. Rysunek 1 pokazuje te same nachylenia w jednostkach SD obok wyników regresji na średnich skal. Zasady czytelnego wykresu interakcji są takie same jak w regresji.
Średnie skal a zmienne latentne: symulacja
Jedna próba może przypadkiem dać wyższe albo niższe oszacowanie. Dlatego powtórzyliśmy analizę na 300 próbach po 400 osób z tej samej populacji. Wszystkie modele latentne osiągnęły zbieżność.
| Analiza | Średnie oszacowanie | SD oszacowań | Obciążenie | Moc (p < .05) |
|---|---|---|---|---|
| Wartość prawdziwa | −0.221 | – | – | – |
| Regresja na średnich skal | −0.156 | 0.048 | zaniżenie o 29.7% | 91.7% |
| Iloczyny wskaźników (lavaan) | −0.213 | 0.075 | zaniżenie o 3.8% | 83.0% |
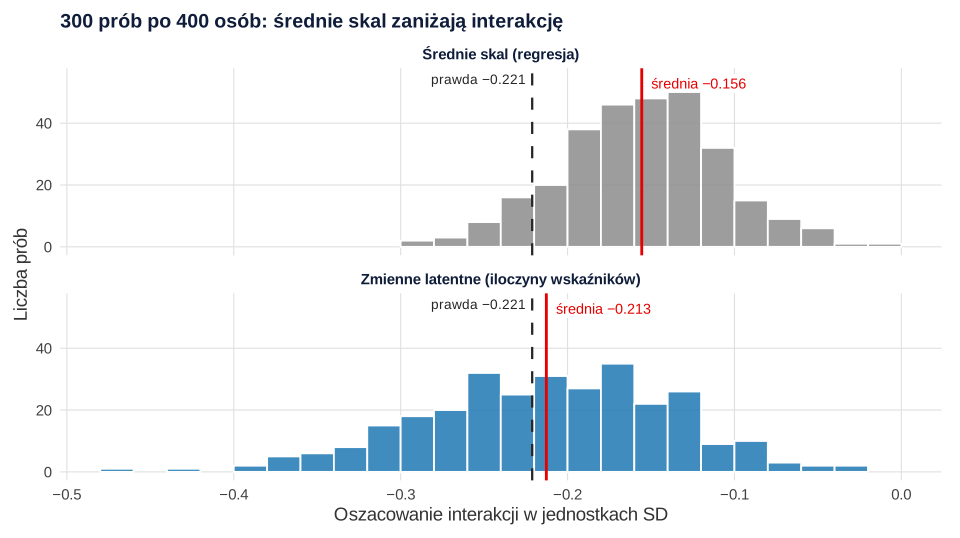
Regresja na średnich skal zaniżyła interakcję średnio o 30%, bo iloczyn średnich ma rzetelność około .70. Model latentny zaniżył ją tylko o 3.8%, ale był mniej precyzyjny. W tych warunkach (rzetelność skal .71–.83, N = 400) nie miał przez to większej mocy: 83.0% wobec 91.7%. Schoemann i Jorgensen (2021) piszą, że modele latentne dają dodatkową moc w porównaniu z regresją. Nasz wynik pokazuje, że nie musi tak być w każdych warunkach. Główną korzyścią modelu latentnego jest trafna wielkość efektu, a nie zawsze moc. Jeśli planujesz badanie, policz moc symulacyjnie dla swojego modelu, jak we wpisie o liczebności próby do SEM.
LMS i inne metody rozkładowe
LMS nie tworzy iloczynów wskaźników. Szacuje model metodą największej wiarygodności, przedstawiając nienormalny łączny rozkład wskaźników jako mieszaninę rozkładów normalnych (Klein i Moosbrugger, 2000). Jest wbudowana w Mplus (polecenie XWITH). Ma jednak praktyczne ograniczenie: nie daje zwykłych wskaźników dopasowania, współczynników standaryzowanych ani wielkości efektu interakcji. Maslowsky i in. (2015) zebrali sposoby obejścia tego problemu i zalecaną kolejność analiz. Zwykle najpierw ocenia się dopasowanie modelu bez interakcji, a potem porównuje oba modele testem ilorazu wiarygodności.
Marsh i in. (2004) porównali też metodę QML (quasi-maximum likelihood), która miała większą moc, ale wyższy odsetek błędów I rodzaju, i była bardziej obciążona przy wskaźnikach o rozkładzie nienormalnym. W lavaan LMS nie jest dostępna w podstawowej instalacji. Gdy pracujesz w R, iloczyny wskaźników są najprostszym wyborem; gdy recenzent prosi o LMS, wynik z Mplus możesz zestawić z wynikiem z iloczynów jako analizę wrażliwości.
Jak opisać interakcję latentną (APA)
W części „Metoda” podaj metodę (iloczyny wskaźników, pary dopasowane, sposób centrowania), program i estymator. Podaj też dopasowanie modelu bez interakcji, współczynnik interakcji z SE, CI i p, interakcję w jednostkach SD z opisem, jak ją policzono, oraz proste nachylenia przy wybranych wartościach moderatora. Tabelę dopasowania przygotuj według wzoru tabeli dopasowania modelu w APA.
Jeśli recenzent pyta, dlaczego nie użyłeś(-aś) PROCESS na średnich skal, odpowiedz rzetelnością iloczynu i wynikiem z symulacji. Przy moderowanej mediacji z konstruktami latentnymi zacznij od wpisu moderowana mediacja i modele PROCESS w R. Przy złożonym modelu możemy go sprawdzić razem w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik interakcja-latentna-dane.csv (możesz go pobrać tutaj), liczy regresję na średnich skal, model bez interakcji i model z iloczynami wskaźników, a na końcu proste nachylenia. Drugi powtarza obie analizy na 300 symulowanych próbach (około 20 sekund). Potrzebne pakiety: lavaan i semTools.
1. Dane, regresja na średnich i model z iloczynami wskaźników
R
# Dane symulowane: 400 pielęgniarek. Obciążenie pracą (o1–o3), wsparcie zespołu (w1–w3) i wyczerpanie (y1–y3)
# mierzone wynikami trzech krótkich podskal (skala 1–5). Hipoteza: wsparcie osłabia związek obciążenia z wyczerpaniem.
suppressPackageStartupMessages({library(lavaan); library(semTools)})
set.seed(20404)
N <- 400
X <- rnorm(N); Z <- 0.30 * X + sqrt(1 - 0.30^2) * rnorm(N)             # latentne: obciążenie i wsparcie, r = .30
Y <- 0.45 * X - 0.30 * Z - 0.20 * X * Z + rnorm(N, 0, 0.75)             # latentne wyczerpanie z interakcją
wsk <- function(f, lad, sr) sapply(seq_along(lad), function(j) round(sr[j] + lad[j] * f + rnorm(N, 0, 0.50), 2))
dane <- data.frame(wsk(X, c(.62, .58, .55), c(3.1, 3.0, 2.9)), wsk(Z, c(.60, .64, .57), c(3.4, 3.3, 3.5)),
                   wsk(Y, c(.50, .55, .48), c(2.6, 2.7, 2.5)))
names(dane) <- c(paste0("o", 1:3), paste0("w", 1:3), paste0("y", 1:3))
write.csv(dane, "interakcja-latentna-dane.csv", row.names = FALSE)
alfa <- function(d) ncol(d) / (ncol(d) - 1) * (1 - sum(apply(d, 2, var)) / var(rowSums(d)))
round(sapply(list(obciazenie = dane[1:3], wsparcie = dane[4:6], wyczerpanie = dane[7:9]), alfa), 2)
# Prawdziwa interakcja w jednostkach SD (z parametrów symulacji): −0.20 / SD(Y latentnego)
var_Y <- 0.45^2 + 0.30^2 + 2 * 0.45 * (-0.30) * 0.30 + 0.20^2 * (1 + 0.30^2) + 0.75^2
round(-0.20 / sqrt(var_Y), 3)

# A. Regresja na średnich skal z iloczynem wycentrowanych średnich (błąd pomiaru pominięty)
dane$O <- rowMeans(dane[1:3]); dane$W <- rowMeans(dane[4:6]); dane$Y <- rowMeans(dane[7:9])
dane$Oc <- dane$O - mean(dane$O); dane$Wc <- dane$W - mean(dane$W)
m_obs <- lm(Y ~ Oc * Wc, data = dane)
round(cbind(summary(m_obs)$coefficients, confint(m_obs)), 3)
# Rzetelność iloczynu wycentrowanych średnich: (ρ_O × ρ_W + r²) / (1 + r²)
r_ow <- cor(dane$O, dane$W); rel <- sapply(list(dane[1:3], dane[4:6]), alfa)
round(c(r_OW = r_ow, rzetelnosc_iloczynu = (rel[1] * rel[2] + r_ow^2) / (1 + r_ow^2)), 3)

# B. Iloczyny wskaźników: pary dopasowane według ładunków z modelu bez interakcji (o1–w2, o2–w3, o3–w1),
#    centrowanie średnią i podwójne centrowanie (semTools::indProd)
dane <- indProd(dane, var1 = c("o1", "o2", "o3"), var2 = c("w2", "w3", "w1"),
                match = TRUE, meanC = TRUE, residualC = FALSE, doubleMC = TRUE)
names(dane)[grep("\\.", names(dane))]
model <- '
  Obc =~ o1 + o2 + o3
  Wsp =~ w1 + w2 + w3
  ObcWsp =~ o1.w2 + o2.w3 + o3.w1
  Wycz =~ y1 + y2 + y3
  Wycz ~ Obc + Wsp + ObcWsp
'
# Najpierw model bez interakcji: dopasowanie części pomiarowej i efektów głównych
model0 <- '
  Obc =~ o1 + o2 + o3
  Wsp =~ w1 + w2 + w3
  Wycz =~ y1 + y2 + y3
  Wycz ~ Obc + Wsp
'
fit0 <- sem(model0, data = dane, estimator = "MLR")
round(fitMeasures(fit0, c("chisq.scaled", "df", "pvalue.scaled", "cfi.robust", "rmsea.robust", "srmr")), 3)
round(subset(standardizedSolution(fit0), op == "=~")$est.std, 2)
fit <- sem(model, data = dane, estimator = "MLR")
round(fitMeasures(fit, c("chisq.scaled", "df", "pvalue.scaled", "cfi.robust", "rmsea.robust", "srmr")), 3)
subset(parameterEstimates(fit), op == "~", select = c(lhs, rhs, est, se, z, pvalue, ci.lower, ci.upper))
# Wariancje i kowariancje czynników (w jednostkach pierwszego wskaźnika)
round(lavInspect(fit, "cov.lv"), 3)

# C. Interakcja w jednostkach odchyleń standardowych: b × SD(Obc) × SD(Wsp) / SD(Wycz)
cl <- lavInspect(fit, "cov.lv"); b <- coef(fit)
beta_lat <- b[["Wycz~ObcWsp"]] * sqrt(cl["Obc", "Obc"] * cl["Wsp", "Wsp"]) / sqrt(cl["Wycz", "Wycz"])
beta_obs <- coef(m_obs)[["Oc:Wc"]] * sd(dane$O) * sd(dane$W) / sd(dane$Y)
round(c(obserwowane_srednie = beta_obs, latentne_iloczyny = beta_lat), 3)

# D. Proste nachylenia obciążenia przy wsparciu −1 SD, średnim i +1 SD (czynniki wycentrowane, średnia = 0)
sd_w <- sqrt(cl["Wsp", "Wsp"])
pr <- probe2WayMC(fit, nameX = c("Obc", "Wsp", "ObcWsp"), nameY = "Wycz", modVar = "Wsp", valProbe = c(-sd_w, 0, sd_w))
pr$SimpleSlope
round(sd_w, 3)
Wynik w R
 obciazenie    wsparcie wyczerpanie
       0.83        0.82        0.71
[1] -0.221
            Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)    2.598      0.025 102.140        0  2.548  2.648
Oc             0.317      0.037   8.563        0  0.244  0.390
Wc            -0.187      0.037  -5.006        0 -0.260 -0.113
Oc:Wc         -0.210      0.048  -4.334        0 -0.305 -0.115
               r_OW rzetelnosc_iloczynu
              0.258               0.699
[1] "o1.w2" "o2.w3" "o3.w1"
 chisq.scaled            df pvalue.scaled    cfi.robust  rmsea.robust
       45.140        24.000         0.006         0.983         0.046
         srmr
        0.042
[1] 0.85 0.78 0.72 0.75 0.82 0.77 0.73 0.66 0.63
 chisq.scaled            df pvalue.scaled    cfi.robust  rmsea.robust
       54.871        48.000         0.230         0.995         0.020
         srmr
        0.036
    lhs    rhs    est    se      z pvalue ci.lower ci.upper
13 Wycz    Obc  0.373 0.049  7.631      0    0.277    0.468
14 Wycz    Wsp -0.306 0.063 -4.882      0   -0.430   -0.183
15 Wycz ObcWsp -0.237 0.062 -3.831      0   -0.358   -0.116
          Obc    Wsp ObcWsp   Wycz
Obc     0.503
Wsp     0.136  0.356
ObcWsp -0.014 -0.043  0.325
Wycz    0.149 -0.048 -0.069  0.265
obserwowane_srednie   latentne_iloczyny
             -0.183              -0.194
     Wsp   est    se     z pvalue
1 -0.597 0.514 0.067 7.714      0
2  0.000 0.373 0.049 7.631      0
3  0.597 0.231 0.055 4.190      0
[1] 0.597
2. Symulacja: obciążenie i moc obu analiz
R
# Symulacja Monte Carlo: 300 prób po 400 osób z tej samej populacji co w przepisie 1.
# Porównujemy interakcję w jednostkach SD z regresji na średnich skal i z modelu z iloczynami wskaźników.
# Wymaga obiektów model, alfa i var_Y z przepisu 1 (ta sama sesja R).
jedna_proba <- function(N = 400) {
  X <- rnorm(N); Z <- 0.30 * X + sqrt(1 - 0.30^2) * rnorm(N)
  Y <- 0.45 * X - 0.30 * Z - 0.20 * X * Z + rnorm(N, 0, 0.75)
  wsk <- function(f, lad, sr) sapply(seq_along(lad), function(j) round(sr[j] + lad[j] * f + rnorm(N, 0, 0.50), 2))
  d <- data.frame(wsk(X, c(.62, .58, .55), c(3.1, 3.0, 2.9)), wsk(Z, c(.60, .64, .57), c(3.4, 3.3, 3.5)),
                  wsk(Y, c(.50, .55, .48), c(2.6, 2.7, 2.5)))
  names(d) <- c(paste0("o", 1:3), paste0("w", 1:3), paste0("y", 1:3))
  O <- rowMeans(d[1:3]); W <- rowMeans(d[4:6]); Yo <- rowMeans(d[7:9])
  m <- lm(Yo ~ I(O - mean(O)) * I(W - mean(W)))
  b_obs <- coef(summary(m))[4, ]
  d <- indProd(d, var1 = c("o1", "o2", "o3"), var2 = c("w2", "w3", "w1"))
  f <- tryCatch(sem(model, data = d, estimator = "MLR"), error = function(e) NULL)
  if (is.null(f) || !lavInspect(f, "converged")) return(c(b_obs = NA, p_obs = NA, b_lat = NA, p_lat = NA))
  cl <- lavInspect(f, "cov.lv"); pe <- parameterEstimates(f)
  r <- pe[pe$lhs == "Wycz" & pe$op == "~" & pe$rhs == "ObcWsp", ]
  c(b_obs = b_obs[[1]] * sd(O) * sd(W) / sd(Yo), p_obs = b_obs[[4]],
    b_lat = r$est * sqrt(cl["Obc", "Obc"] * cl["Wsp", "Wsp"] / cl["Wycz", "Wycz"]), p_lat = r$pvalue)
}
set.seed(20441)
mc <- as.data.frame(t(replicate(300, jedna_proba())))
prawda <- -0.20 / sqrt(var_Y)
c(zbiezne = sum(!is.na(mc$b_lat)), z_300 = 300)
podsum <- function(b, p) c(srednia = mean(b, na.rm = TRUE), SD = sd(b, na.rm = TRUE),
                           obciazenie_proc = 100 * (mean(b, na.rm = TRUE) - prawda) / abs(prawda),
                           moc = mean(p < .05, na.rm = TRUE))
round(rbind(prawda = c(prawda, NA, NA, NA), obserwowane_srednie = podsum(mc$b_obs, mc$p_obs),
            latentne_iloczyny = podsum(mc$b_lat, mc$p_lat)), 3)
Wynik w R
zbiezne   z_300
    300     300
                    srednia    SD obciazenie_proc   moc
prawda               -0.221    NA              NA    NA
obserwowane_srednie  -0.156 0.048          29.677 0.917
latentne_iloczyny    -0.213 0.075           3.834 0.830
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan i semTools; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling [R package]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Iloczyn średnich skal w modelu z konstruktami latentnymi. Łączy dwa błędy pomiaru i zaniża interakcję; w przykładzie średnio o 30%.
- Wskaźniki bez centrowania. Czynnik interakcyjny silnie koreluje wtedy z czynnikami głównymi, a efekty główne opisują związek przy zerze skali, której nikt nie ma.
- Standaryzowany współczynnik interakcji odczytany wprost z lavaan. Policz go z wariancji czynników albo raportuj proste nachylenia.
- Ocena interakcji na podstawie CFI i RMSEA. Wskaźniki dopasowania opisują głównie część pomiarową; o interakcji decyduje test jej współczynnika.
- Brak sondowania interakcji. Sam znak i p interakcji nie mówią, przy jakich wartościach moderatora związek jest istotny.
Najczęstsze pytania
Czy w SEM mogę po prostu pomnożyć średnie dwóch skal i dodać iloczyn do modelu?
Możesz, ale wtedy iloczyn zawiera błąd pomiaru obu skal i ma niższą rzetelność niż każda z nich. W przykładzie skale miały α = .83 i .82, a iloczyn tylko .70, a w 300 symulowanych próbach interakcja z regresji na średnich była zaniżona średnio o 30%. Model z iloczynami wskaźników zaniżył ją tylko o 3.8%.
Ile iloczynów wskaźników utworzyć do interakcji latentnej?
Najczęściej tyle, ile wskaźników ma mniejszy czynnik, w parach dopasowanych: każdy wskaźnik występuje w jednym iloczynie. Przy trzech wskaźnikach na czynnik daje to trzy iloczyny zamiast dziewięciu i nie wymaga korelowania reszt iloczynów, które dzielą wskaźnik. Pary ustal przed analizą, np. według ładunków.
Jak policzyć standaryzowany współczynnik interakcji latentnej w lavaan?
Nie odczytuj go z rozwiązania standaryzowanego, bo lavaan dzieli go przez odchylenie standardowe czynnika interakcyjnego, a nie przez iloczyn odchyleń standardowych obu czynników. Pomnóż niestandaryzowany współczynnik przez SD obu czynników i podziel przez SD zmiennej zależnej, korzystając z wariancji z lavInspect(fit, "cov.lv").
Czym różni się metoda LMS od iloczynów wskaźników?
LMS nie tworzy nowych zmiennych, tylko modeluje nienormalny rozkład wskaźników jako mieszaninę rozkładów normalnych i szacuje interakcję metodą największej wiarygodności. Jest dostępna w Mplus, ale nie daje zwykłych wskaźników dopasowania ani współczynników standaryzowanych. Iloczyny wskaźników działają w każdym programie do SEM, także w lavaan.
Czy dobre dopasowanie modelu potwierdza interakcję latentną?
Nie. CFI, RMSEA i SRMR opisują głównie model pomiarowy, a model z czynnikiem interakcyjnym może być dobrze dopasowany także wtedy, gdy interakcji nie ma. O interakcji decyduje test jej współczynnika i proste nachylenia przy wybranych wartościach moderatora.
Powiązane hasła
Przeczytaj też
Analiza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM) – przewodnik
Osiem etapów analizy SEM: identyfikacja, pomiar, CB-SEM czy PLS-SEM, CFA i kompozyty, efekty pośrednie, inwariancja, rozszerzenia i raport.
Czytaj →Testujesz moderację między konstruktami latentnymi i recenzent pyta o metodę?
Pomożemy dobrać metodę interakcji latentnej, oszacować i sprawdzić model oraz wyjaśnić wyniki tak, żebyś mógł(a) samodzielnie je opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Kenny, D. A., & Judd, C. M. (1984). Estimating the nonlinear and interactive effects of latent variables. Psychological Bulletin, 96(1), 201–210. https://doi.org/10.1037/0033-2909.96.1.201
- Klein, A., & Moosbrugger, H. (2000). Maximum likelihood estimation of latent interaction effects with the LMS method. Psychometrika, 65(4), 457–474. https://doi.org/10.1007/bf02296338
- Lin, G.-C., Wen, Z., Marsh, H. W., & Lin, H.-S. (2010). Structural equation models of latent interactions: Clarification of orthogonalizing and double-mean-centering strategies. Structural Equation Modeling: A Multidisciplinary Journal, 17(3), 374–391. https://doi.org/10.1080/10705511.2010.488999
- Little, T. D., Bovaird, J. A., & Widaman, K. F. (2006). On the merits of orthogonalizing powered and product terms: Implications for modeling interactions among latent variables. Structural Equation Modeling: A Multidisciplinary Journal, 13(4), 497–519. https://doi.org/10.1207/s15328007sem1304_1
- Marsh, H. W., Wen, Z., & Hau, K.-T. (2004). Structural equation models of latent interactions: Evaluation of alternative estimation strategies and indicator construction. Psychological Methods, 9(3), 275–300. https://doi.org/10.1037/1082-989x.9.3.275
- Maslowsky, J., Jager, J., & Hemken, D. (2015). Estimating and interpreting latent variable interactions: A tutorial for applying the latent moderated structural equations method. International Journal of Behavioral Development, 39(1), 87–96. https://doi.org/10.1177/0165025414552301 ● Otwarty dostęp: pełny tekst
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Schoemann, A. M., & Jorgensen, T. D. (2021). Testing and interpreting latent variable interactions using the semTools package. Psych, 3(3), 322–335. https://doi.org/10.3390/psych3030024 ● Otwarty dostęp
Cytowania BibTeX
@article{kenny1984estimating, author={Kenny, David A. and Judd, Charles M.}, title={{Estimating the nonlinear and interactive effects of latent variables}}, journal={Psychological Bulletin}, year={1984}, volume={96}, number={1}, pages={201--210}, doi={10.1037/0033-2909.96.1.201}}@article{klein2000maximum, author={Klein, Andreas and Moosbrugger, Helfried}, title={{Maximum likelihood estimation of latent interaction effects with the LMS method}}, journal={Psychometrika}, year={2000}, volume={65}, number={4}, pages={457--474}, doi={10.1007/bf02296338}}@article{lin2010structural, author={Lin, Guan-Chyun and Wen, Zhonglin and Marsh, Herbert W. and Lin, Huey-Shyan}, title={{Structural equation models of latent interactions: Clarification of orthogonalizing and double-mean-centering strategies}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2010}, volume={17}, number={3}, pages={374--391}, doi={10.1080/10705511.2010.488999}}@article{little2006merits, author={Little, Todd D. and Bovaird, James A. and Widaman, Keith F.}, title={{On the merits of orthogonalizing powered and product terms: Implications for modeling interactions among latent variables}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2006}, volume={13}, number={4}, pages={497--519}, doi={10.1207/s15328007sem1304_1}}@article{marsh2004structural, author={Marsh, Herbert W. and Wen, Zhonglin and Hau, Kit-Tai}, title={{Structural equation models of latent interactions: Evaluation of alternative estimation strategies and indicator construction}}, journal={Psychological Methods}, year={2004}, volume={9}, number={3}, pages={275--300}, doi={10.1037/1082-989x.9.3.275}}@article{maslowsky2015estimating, author={Maslowsky, Julie and Jager, Justin and Hemken, Douglas}, title={{Estimating and interpreting latent variable interactions: A tutorial for applying the latent moderated structural equations method}}, journal={International Journal of Behavioral Development}, year={2015}, volume={39}, number={1}, pages={87--96}, doi={10.1177/0165025414552301}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{schoemann2021testing, author={Schoemann, Alexander M. and Jorgensen, Terrence D.}, title={{Testing and interpreting latent variable interactions using the semTools package}}, journal={Psych}, year={2021}, volume={3}, number={3}, pages={322--335}, doi={10.3390/psych3030024}}