Co to jest moderacja?
Moderacja (ang. moderation) występuje wtedy, gdy siła albo kierunek związku między zmienną niezależną X a zmienną zależną Y zależy od poziomu trzeciej zmiennej – moderatora W (ang. moderator). Moderacja odpowiada na pytania „kiedy?” i „dla kogo?”: czy wsparcie społeczne osłabia związek stresu z dobrostanem, czy terapia działa lepiej u osób z cięższymi objawami, czy nauka przynosi większe korzyści przy jednej strategii niż przy innej.
Statystycznie moderację wyraża efekt interakcji – w regresji jest to współczynnik iloczynu X i W, a w analizie wariancji składnik interakcji dwóch czynników. Słowa „moderacja” używa się wtedy, gdy teoria przypisuje zmiennym role: jedna jest predyktorem, druga zmienia jej związek z wynikiem. Samo pojęcie interakcji zmiennych jest szersze i symetryczne. MacKinnon i in. (2007) w przeglądzie analizy mediacji wyraźnie odróżniają moderatory od mediatorów, zmiennych zakłócających i kowariantów – to cztery różne role trzeciej zmiennej.
Moderator może być kategorialny (płeć, warunek eksperymentalny, strategia nauki) albo ilościowy (wynik w skali). Ze względu na kształt interakcji wyróżnia się moderację:
- wzmacniającą – związek X z Y jest silniejszy przy wyższych wartościach W;
- osłabiającą (buforową) – związek słabnie wraz ze wzrostem W, jak w hipotezie, że wsparcie społeczne chroni przed skutkami stresu;
- odwracającą – przy jednych wartościach W związek jest dodatni, przy innych ujemny.
Wzór: model regresji z interakcją
Najczęściej moderację testuje się w regresji liniowej z iloczynem predyktora i moderatora:
- b3 – współczynnik interakcji: o ile zmienia się nachylenie X, gdy W rośnie o jednostkę. To on testuje moderację;
- b1 – nachylenie X przy W = 0;
- b2 – związek W z Y przy X = 0;
- b0 – przewidywany wynik, gdy X = 0 i W = 0; e – błąd (reszta).
Po przegrupowaniu składników nachylenie X ma postać efektu warunkowego: θ = b1 + b3W. Gdy b3 = 0, związek X z Y jest taki sam przy każdym poziomie moderatora. W tym ujęciu – regresji MNK z efektami warunkowymi – moderację opisuje podręcznik Hayesa (2022), który pokazuje też jej łączenie z mediacją.
Ponieważ b1 i b2 opisują efekty przy zerze drugiej zmiennej, przed analizą zwykle centruje się predyktory ilościowe (odejmuje średnią). Wtedy b1 to efekt X przy przeciętnym W, a b2 – efekt W przy przeciętnym X. Wpływ takiego skalowania na współczynniki szczegółowo omawiają Aiken i West (1991). Centrowanie nie zmienia b3 ani jego testu. Jeśli chcesz podać β, standaryzuj zmienne przed utworzeniem iloczynu. Gdy moderator jest kategorialny, wchodzi do modelu jako zmienna zero-jedynkowa (dummy coding), a b3 jest różnicą nachyleń X między grupami.
Istotny b3 to dopiero początek. Kształt interakcji opisują proste nachylenia – efekty X przy wybranych wartościach W – oraz przedział Johnsona–Neymana, czyli zakres W, w którym efekt X jest istotny. Obie techniki krok po kroku, z wykresami i kodem, pokazujemy w poradniku analiza moderacji krok po kroku.
Moderacja a mediacja
Moderacja i mediacja to dwie różne odpowiedzi na pytanie o rolę trzeciej zmiennej. Najważniejsze różnice zebraliśmy w tabeli.
| Cecha | Moderacja | Mediacja |
|---|---|---|
| Pytanie badawcze | Kiedy i dla kogo X wiąże się z Y? | Dlaczego i przez jaki mechanizm X wiąże się z Y? |
| Rola trzeciej zmiennej | Moderator W zmienia siłę lub kierunek związku X–Y | Mediator M przenosi wpływ X na Y (X → M → Y) |
| Związek z X | Moderator nie musi korelować z X | Mediator powinien zależeć od X (ścieżka a) |
| Model statystyczny | Regresja z iloczynem XW | Dwa równania: M na X oraz Y na X i M |
| Kluczowy parametr | Współczynnik interakcji b3 | Efekt pośredni a × b z bootstrapowym przedziałem ufności |
| Typowa ilustracja | Wykres prostych nachyleń, wykres Johnsona–Neymana | Diagram ścieżek |
| Przykład | Wsparcie społeczne osłabia związek stresu z dobrostanem | Stres nasila ruminacje, a te pogarszają sen |
Ta sama zmienna może być moderatorem w jednej hipotezie i mediatorem w innej – decyduje teoria, a nie dane. Oba procesy można też połączyć w jednym modelu: gdy efekt pośredni zależy od moderatora, mówimy o moderowanej mediacji (warunkowej analizie procesu, Hayes, 2022).
Przykład: strategia nauki jako moderator
Załóżmy, że 160 studentów (dane symulowane) przygotowywało się do egzaminu: 80 osób powtarzało materiał, czytając notatki ponownie, a 80 – testując się (fiszki, quizy). Notowaliśmy liczbę godzin nauki w tygodniu przed egzaminem (M = 7.77) i wynik egzaminu (0–100 punktów). Hipoteza: każda godzina nauki przynosi większy przyrost wyniku przy testowaniu się niż przy ponownym czytaniu. Predyktorem jest czas nauki (wycentrowany), moderatorem – strategia (0 = czytanie, 1 = testowanie).
Model wyjaśniał 32% wariancji wyników, R² = .32, F(3, 156) = 24.64, p < .001. Interakcja była istotna: b3 = 1.22, 95% CI [0.37, 2.06], t(156) = 2.83, p = .005. Proste nachylenia pokazują, co to znaczy:
- przy ponownym czytaniu każda dodatkowa godzina nauki wiązała się z wynikiem wyższym o 1.00 punktu, 95% CI [0.42, 1.57], p < .001;
- przy testowaniu się – o 2.21 punktu, 95% CI [1.59, 2.83], p < .001.
Różnica nachyleń (2.21 − 1.00 ≈ 1.22) to właśnie b3. Współczynnik b2 = 5.56, 95% CI [2.86, 8.27], mówi, że przy przeciętnym czasie nauki (7.77 godziny) osoby testujące się uzyskały średnio o 5.56 punktu więcej. Przewidywana przewaga rośnie wraz z czasem nauki: przy 4 godzinach to 51.18 wobec 50.20 punktu, a przy 12 godzinach – 68.89 wobec 58.18 punktu.
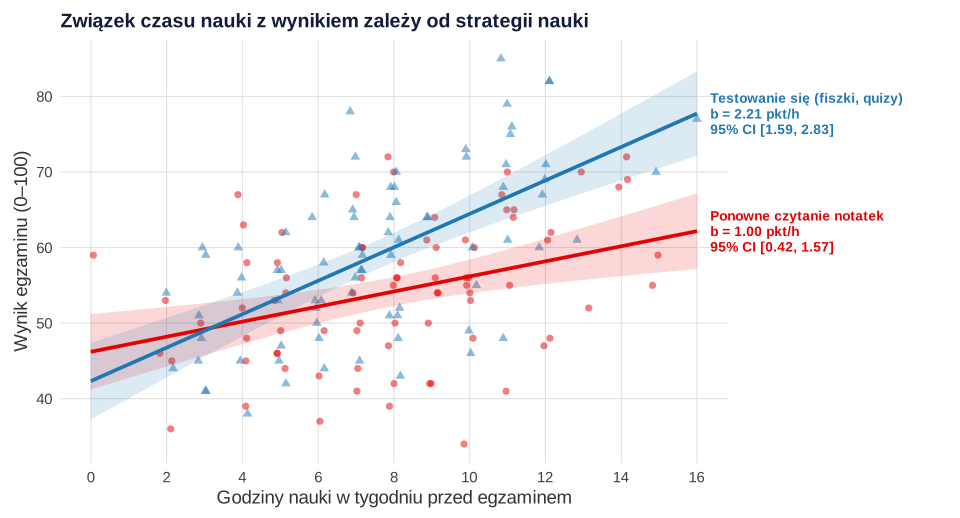
Wykres pokazuje dane i niepewność, a nie tylko dwie linie – McCabe i in. (2018) zwracają uwagę, że wykresy prostych nachyleń bez obserwacji i przedziałów ufności mogą prowadzić do błędnych wniosków o moderacji. Przecięcie się linii przy 2–3 godzinach nauki leży na skraju danych, gdzie obserwacji jest mało, więc nie należy go interpretować. Ponieważ studenci sami wybierali strategię, wynik pokazuje zależność, a nie skutek przyczynowy; wniosek przyczynowy uzasadniałby dopiero eksperyment z losowym przydziałem do strategii.
Jak opisać moderację w pracy (APA)
Memon i in. (2019) zaliczają raportowanie do kluczowych etapów analizy moderacji. Podaj sposób przygotowania predyktorów, b3 z 95% CI i testem, proste nachylenia przy uzasadnionych wartościach moderatora oraz wykres. Wzór opisu dla przykładu:
Pełne współczynniki modelu przedstaw w tabeli – wzór znajdziesz w haśle tabela regresji w APA, a przykład tabeli dla moderacji z moderatorem ilościowym – w poradniku o analizie moderacji. Ogólne zasady zapisu statystyk opisujemy w tekście jak opisać wyniki w stylu APA.
Przykład w R
Kod tworzy dane z przykładu, szacuje model z interakcją i liczy proste nachylenia w obu grupach. Liczby w tekście pochodzą z tego kodu; rysunek 1 przedstawia te same wyniki w szacie graficznej serwisu.
Model z interakcją i proste nachylenia
R
library(interactions)   # sim_slopes(), interact_plot()

# Dane symulowane: godziny nauki w tygodniu, strategia nauki i wynik egzaminu (0–100), N = 160
set.seed(423)
n <- 160
strategia <- factor(rep(c("czytanie", "testowanie"), each = 80), levels = c("czytanie", "testowanie"))
godziny <- pmin(pmax(round(rnorm(n, 8, 3.5)), 0), 20)
wynik <- 55 + 1.0 * (godziny - 8) + 5 * (strategia == "testowanie") +
  1.2 * (godziny - 8) * (strategia == "testowanie") + rnorm(n, sd = 9)
wynik <- pmin(pmax(round(wynik), 0), 100)
dane <- data.frame(godziny, strategia, wynik)
aggregate(cbind(godziny, wynik) ~ strategia, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))

# Model z interakcją: godziny wycentrowane, strategia 0 = czytanie, 1 = testowanie
dane$godziny_c <- dane$godziny - mean(dane$godziny)
model <- lm(wynik ~ godziny_c * strategia, data = dane)
summary(model)
round(confint(model), 2)

# Proste nachylenia: związek godzin nauki z wynikiem w każdej grupie
sim_slopes(model, pred = godziny_c, modx = strategia, johnson_neyman = FALSE,
           confint = TRUE, digits = 3)

# Wykres interakcji z danymi i 95% CI (oś X w godzinach)
model_wykres <- lm(wynik ~ godziny * strategia, data = dane)
interact_plot(model_wykres, pred = godziny, modx = strategia, plot.points = TRUE,
              interval = TRUE, x.label = "Godziny nauki w tygodniu", y.label = "Wynik egzaminu")
Wynik w R
   strategia godziny.M godziny.SD wynik.M wynik.SD
1   czytanie      7.99       3.33   54.17     9.19
2 testowanie      7.55       3.09   59.04    10.97

Call:
lm(formula = wynik ~ godziny_c * strategia, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-22.1833  -5.7982   0.4578   6.8105  20.1798

Coefficients:
                              Estimate Std. Error t value Pr(>|t|)
(Intercept)                    53.9567     0.9674  55.775  < 2e-16 ***
godziny_c                       0.9979     0.2919   3.419 0.000802 ***
strategiatestowanie             5.5649     1.3683   4.067 7.54e-05 ***
godziny_c:strategiatestowanie   1.2153     0.4290   2.833 0.005227 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 8.634 on 156 degrees of freedom
Multiple R-squared:  0.3215,	Adjusted R-squared:  0.3084
F-statistic: 24.64 on 3 and 156 DF,  p-value: 4.185e-13

                              2.5 % 97.5 %
(Intercept)                   52.05  55.87
godziny_c                      0.42   1.57
strategiatestowanie            2.86   8.27
godziny_c:strategiatestowanie  0.37   2.06
SIMPLE SLOPES ANALYSIS

Slope of godziny_c when strategia = czytanie:

   Est.    S.E.    2.5%   97.5%   t val.       p
------- ------- ------- ------- -------- -------
  0.998   0.292   0.421   1.574    3.419   0.001

Slope of godziny_c when strategia = testowanie:

   Est.    S.E.    2.5%   97.5%   t val.       p
------- ------- ------- ------- -------- -------
  2.213   0.314   1.592   2.834    7.038   0.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- interactions (wersja 1.2.0): Long, J. A. (2024). interactions: Comprehensive, user-friendly toolkit for probing interactions [R package]. https://doi.org/10.32614/CRAN.package.interactions
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Mylenie moderacji z mediacją. Moderator zmienia związek X z Y, mediator go przenosi. Inne są hipotezy, modele i testy.
- Porównywanie istotności w podgrupach. To, że związek jest istotny w jednej grupie, a w drugiej nie, nie dowodzi moderacji – potrzebny jest test różnicy nachyleń, czyli b3. Analizę interakcji zmiennych kategorialnych i ciągłych, z przykładami w SPSS, omawia Sosnowski (2010).
- Odczytywanie b1 i b2 jako efektów głównych. W modelu z interakcją są to efekty warunkowe – przy zerze drugiej zmiennej.
- Dzielenie moderatora ilościowego medianą zamiast modelu z iloczynem – tracisz informację i moc.
- Za mała próba. Test interakcji ma zwykle mniejszą moc niż test pojedynczego predyktora, więc wymaga większej próby (zob. symulację mocy w poradniku).
- Język przyczynowy bez eksperymentu. „Strategia zwiększa korzyść z nauki” to interpretacja – w badaniu korelacyjnym pisz o związku, który zależy od moderatora.
Najczęstsze pytania
Co to jest moderacja w statystyce?
Moderacja to zależność, w której związek X z Y zmienia się wraz z poziomem trzeciej zmiennej – moderatora. W regresji testuje się ją, dodając do modelu iloczyn X i W; jego współczynnik b3 mówi, o ile zmienia się nachylenie X przy wzroście moderatora o jednostkę.
Czym różni się moderator od mediatora?
Moderator zmienia siłę lub kierunek związku X z Y (odpowiada na pytanie „kiedy?” i „dla kogo?”), a mediator przenosi wpływ X na Y (odpowiada na pytanie „dlaczego?”). Moderację testuje współczynnik interakcji, a mediację – efekt pośredni a × b.
Czy moderator musi korelować z predyktorem lub zmienną zależną?
Nie. Moderator może nie mieć żadnego związku ani z X, ani z Y – liczy się tylko to, czy zmienia związek między nimi. Silna korelacja moderatora z predyktorem utrudnia natomiast oddzielenie interakcji od innych efektów, więc warto ją opisać.
Jak sprawdzić moderację w SPSS?
Najprościej makrem PROCESS (model 1), które samo tworzy iloczyn, liczy proste nachylenia i przedział Johnsona–Neymana. Bez PROCESS utwórz iloczyn wycentrowanych zmiennych i dodaj go do regresji liniowej w drugim bloku. Krok po kroku pokazujemy to w poradniku analiza moderacji krok po kroku.
Co zrobić, gdy interakcja jest istotna?
Opisz jej kształt: oblicz proste nachylenia, czyli efekt X przy wybranych wartościach moderatora (w grupach albo np. przy M ± 1 SD), sprawdź przedział Johnsona–Neymana i pokaż wykres z danymi oraz 95% przedziałami ufności. Sama wartość b3 nie mówi, przy jakich wartościach moderatora efekt X jest istotny.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Moderacja – wizualizacja na obrazkach
Proste nachylenia, obszar Johnsona–Neymana, mapa przewidywań, moderator dwuwartościowy, centrowanie i moc interakcji w 1000 badań – sześć rysunków z kodem R.
Czytaj →PoradnikMoc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikModerowana mediacja i modele PROCESS w R
Modele 7, 14 i 58, indeks moderowanej mediacji, efekty warunkowe z bootstrapem, lavaan i analiza wrażliwości – z kodem R i wzorem opisu APA.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage.
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- MacKinnon, D. P., Fairchild, A. J., & Fritz, M. S. (2007). Mediation analysis. Annual Review of Psychology, 58(1), 593–614. https://doi.org/10.1146/annurev.psych.58.110405.085542 ● Otwarty dostęp: pełny tekst
- McCabe, C. J., Kim, D. S., & King, K. M. (2018). Improving present practices in the visual display of interactions. Advances in Methods and Practices in Psychological Science, 1(2), 147–165. https://doi.org/10.1177/2515245917746792 ● Otwarty dostęp: pełny tekst
- Memon, M. A., Cheah, J.-H., Ramayah, T., Ting, H., Chuah, F., & Cham, T. H. (2019). Moderation analysis: Issues and guidelines. Journal of Applied Structural Equation Modeling, 3(1), i–xi. https://doi.org/10.47263/JASEM.3(1)01 ● Otwarty dostęp
- Sosnowski, T. (2010). Analiza interakcji zmiennych kategorialnych i ciągłych. Psychologia Społeczna, 5(2–3), 162–190. https://www.ceeol.com/search/article-detail?id=229293 ● Otwarty dostęp
Cytowania BibTeX
@book{aiken1991multiple, author={Aiken, Leona S. and West, Stephen G.}, title={{Multiple regression: Testing and interpreting interactions}}, year={1991}, publisher={Sage}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@article{mackinnon2007mediation, author={MacKinnon, David P. and Fairchild, Amanda J. and Fritz, Matthew S.}, title={{Mediation analysis}}, journal={Annual Review of Psychology}, year={2007}, volume={58}, number={1}, pages={593--614}, doi={10.1146/annurev.psych.58.110405.085542}}@article{mccabe2018improving, author={McCabe, Connor J. and Kim, Dale S. and King, Kevin M.}, title={{Improving present practices in the visual display of interactions}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={147--165}, doi={10.1177/2515245917746792}}@article{memon2019moderation, author={Memon, Mumtaz Ali and Cheah, Jun-Hwa and Ramayah, T. and Ting, Hiram and Chuah, Francis and Cham, Tat Huei}, title={{Moderation analysis: Issues and guidelines}}, journal={Journal of Applied Structural Equation Modeling}, year={2019}, volume={3}, number={1}, pages={i--xi}, doi={10.47263/jasem.3(1)01}}@article{sosnowski2010analiza, author={Sosnowski, Tytus}, title={{Analiza interakcji zmiennych kategorialnych i ciągłych}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={162--190}, url={https://www.ceeol.com/search/article-detail?id=229293}}