Najpierw tabela, potem tekst
Tabela korelacji to zwykle pierwsza tabela w rozdziale wyników pracy korelacyjnej. Zbiera macierz korelacji i statystyki opisowe w jednym miejscu, więc w tekście nie musisz już przepisywać każdego współczynnika. Wzór gotowy do Worda, z wariantem z przedziałami ufności, znajdziesz w haśle tabela korelacji w APA. Tutaj zajmiemy się tym, co student zwykle robi źle: opisem tej tabeli.
Przykład: 150 osób studiujących wypełniło skale stresu, wsparcia społecznego, samooceny i zadowolenia z życia oraz podało tygodniową liczbę godzin pracy zarobkowej i wiek (dane symulowane). Tabela w stylu APA ma średnie, odchylenia standardowe, ponumerowane zmienne i współczynniki w trójkącie macierzy. Zera przed przecinkiem przy r i p się nie pisze, bo te wartości nie mogą przekroczyć 1 (American Psychological Association, 2024).
Tabela 1
Statystyki opisowe i korelacje stresu, zasobów psychologicznych, pracy zarobkowej i wieku
| Zmienna | M | SD | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|---|
| 1. Stres | 19.01 | 6.53 | — | −.45*** | −.50*** | −.49*** | .00 | −.04 |
| 2. Wsparcie społeczne | 5.09 | 0.99 | −.46*** | — | .31*** | .37*** | .07 | .04 |
| 3. Samoocena | 27.93 | 5.13 | −.52*** | .35*** | — | .50*** | .07 | .09 |
| 4. Zadowolenie z życia | 22.09 | 5.94 | −.55*** | .39*** | .50*** | — | .02 | .18* |
| 5. Praca zarobkowa (h/tydz.) | 6.89 | 11.97 | .01 | .14 | .06 | .02 | — | .30*** |
| 6. Wiek (lata) | 22.79 | 2.63 | .01 | −.05 | .07 | .17* | .19* | — |
Uwaga. N = 150. Pod przekątną współczynniki korelacji Pearsona, nad przekątną korelacje rang Spearmana. Liczba godzin pracy i wiek mają rozkłady prawoskośne (skośność 1.87 i 3.07). Gwiazdki oznaczają wartości p bez korekty na wielokrotne testowanie; po korekcie Holma dla 15 korelacji Pearsona korelacje wieku z zadowoleniem z życia i z liczbą godzin pracy nie są istotne. Dane symulowane.
* p < .05. *** p < .001.
Jak opisać tabelę: wzór, a nie lista
Tabela ma 15 korelacji. Jeśli każdą opiszesz zdaniem „r = …, p = …”, dostaniesz akapit, którego nikt nie przeczyta, a najważniejszy wynik w nim zginie. Tekst ma prowadzić czytelnika przez tabelę. W praktyce wystarczą cztery ruchy:
- Przywołaj tabelę („Statystyki opisowe i korelacje przedstawiono w Tabeli 1”). Średnich i SD nie powtarzaj w tekście.
- Opisz wzorzec, a nie pojedyncze liczby. Tu stres korelował ujemnie ze wszystkimi trzema zasobami (od −.46 do −.55), a zasoby dodatnio ze sobą (od .35 do .50). Zakres współczynników mówi więcej niż sześć osobnych zdań.
- Podaj pełny wynik z 95% przedziałem ufności tylko dla korelacji z hipotez. Jeśli hipoteza dotyczyła stresu i zadowolenia z życia, napisz: r(148) = −.55, 95% CI [−.65, −.42], p < .001. Przedział ufności pokazuje, jak precyzyjne jest oszacowanie. Jak ocenić siłę takiego związku, omawiamy we wpisie czy korelacja .30 to dużo.
- Zbiorczo opisz to, co nie wyszło. „Liczba godzin pracy zarobkowej nie była istotnie związana ze stresem ani z zasobami (|r| ≤ .14)”. Takie zdanie jest uczciwsze niż przemilczenie.
Nie interpretuj korelacji przyczynowo („wsparcie obniża stres”). Pisz o związku i jego kierunku. Cały proces liczenia, od wykresu rozrzutu po zapis pojedynczej korelacji, opisuje poradnik korelacja Pearsona i Spearmana krok po kroku.
Problem wielu korelacji naraz
Każdy test przy α = .05 ma 5% szansy na fałszywy alarm. Macierz sześciu zmiennych to 15 testów, dziesięciu zmiennych już 45. Symulacja w R pokazuje, że przy sześciu zmiennych i braku jakichkolwiek prawdziwych związków co najmniej jedna „istotna” korelacja pojawia się w 55% badań (rysunek 1). To problem wielokrotnych porównań.
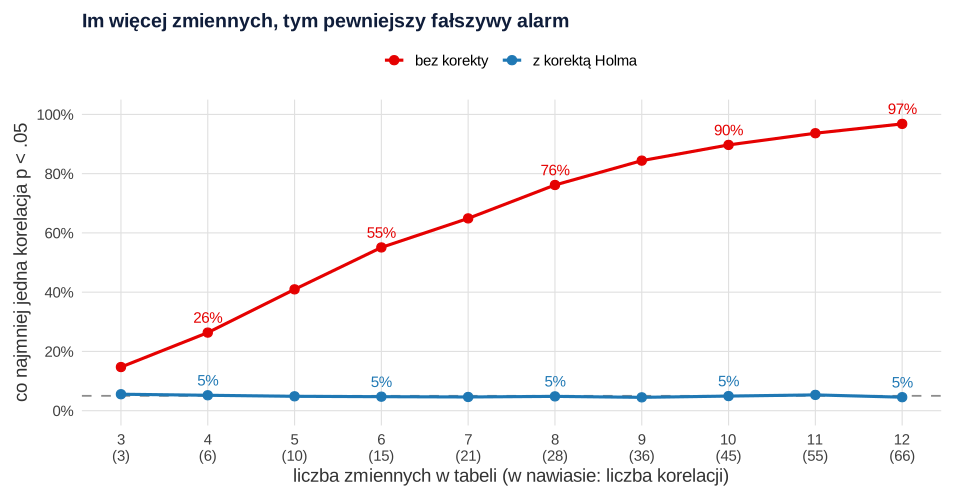
Czy więc zawsze trzeba korygować? Nie. Rubin (2021) pokazuje, że korekta ma sens wtedy, gdy wniosek opierasz na tym, że którakolwiek z wielu korelacji jest istotna, np. „zasoby wiążą się ze stresem”, jeśli wystarczy jedna. Gdy każda korelacja sprawdza osobną, wcześniej postawioną hipotezę, korekta nie jest konieczna. Szerzej odpowiadamy na to pytanie we wpisie czy muszę stosować poprawkę na wielokrotne porównania.
W praktyce:
- Oddziel korelacje z hipotez od reszty tabeli. Standardy JARS zalecają dzielenie hipotez i analiz na pierwszorzędowe, drugorzędowe i eksploracyjne (Appelbaum i in., 2018). Pozostałe korelacje opisz jako eksploracyjne.
- Jeśli testujesz całą macierz bez hipotez, użyj korekty Holma (1979) albo kontroli odsetka fałszywych odkryć, FDR (Benjamini i Hochberg, 1995). W przykładzie bez korekty istotnych było 8 z 15 korelacji, po korekcie Holma 6, a po korekcie FDR 7. Korelacja wieku z liczbą godzin pracy (p = .019) przestała być istotna po korekcie Holma (p = .175), ale przetrwała korektę FDR (p = .042). Korelacja wieku z zadowoleniem z życia (p = .041) nie przetrwała żadnej z nich.
- Napisz w nocie, czy gwiazdki uwzględniają korektę. Bez tego czytelnik nie wie, jak je czytać.
Pearson i Spearman w jednej tabeli
Liczba godzin pracy jest silnie prawoskośna: 56% osób nie pracuje wcale, a najdłuższy tydzień pracy to 40 godzin. Przy takich zmiennych r Pearsona zależy od kilku skrajnych osób. De Winter i in. (2016) pokazują, że przy rozkładach o grubych ogonach i obserwacjach odstających korelacja Spearmana jest stabilniejsza. W naszej tabeli różnice są wyraźne: dla pracy i wieku r = .19, a ρ = .30, a dla wsparcia i pracy r = .14, a ρ = .07.
Masz trzy rozwiązania:
- Dwa trójkąty. Pearson pod przekątną, Spearman nad nią, jak w Tabeli 1. Czytelnik od razu widzi, gdzie miary się rozchodzą.
- Jedna miara dla całej tabeli. Gdy większość zmiennych to krótkie skale porządkowe lub skośne wskaźniki, podaj samego Spearmana.
- Oznaczenie w komórkach. Pearson wszędzie, a dla par ze zmienną skośną Spearman z indeksem a i wyjaśnieniem w nocie.
Miarę wybierz przed analizą, na podstawie rozkładu zmiennych, a nie po sprawdzeniu, która daje istotny wynik. Wybieranie współczynnika „pod istotność” to forma p-hackingu.
Jak to opisać w pracy
Wzór dla Tabeli 1, przy założeniu, że hipotezy dotyczyły związków stresu z trzema zasobami:
Inne tabele do rozdziału wyników, np. statystyk opisowych czy regresji, zebraliśmy w poradniku tabele APA w pracy z psychologii, a kolejność całego rozdziału opisuje przewodnik statystyka w pracy dyplomowej.
Tabela korelacji w R
Kod odtwarza liczby z tabeli i tekstu: średnie, SD i skośność, korelacje Pearsona z 95% CI i p (pakiet psych), korelacje Spearmana oraz liczbę korelacji istotnych bez korekty, po korekcie Holma i po korekcie FDR.
Macierz korelacji Pearsona i Spearmana z korektą na wielokrotne testowanie
R
# B168 – tabela korelacji w stylu APA: M, SD, r Pearsona z 95% CI, rho Spearmana,
# korekta Holma i liczba korelacji istotnych przed korektą i po niej
# Dane symulowane: 150 osób studiujących, sześć zmiennych.
library(MASS)
library(psych)
set.seed(2473)
R <- matrix(c( 1.00, -.40, -.45, -.42,  .22,  .00,
              -.40,  1.00, .35,  .40, -.05,  .05,
              -.45,  .35, 1.00,  .50, -.10,  .12,
              -.42,  .40,  .50, 1.00, -.15,  .05,
               .22, -.05, -.10, -.15, 1.00,  .25,
               .00,  .05,  .12,  .05,  .25, 1.00), 6)
z <- mvrnorm(150, rep(0, 6), R)
dane <- data.frame(
  stres     = pmin(40, pmax(0, round(19 + 6 * z[, 1]))),          # PSS-10, 0–40
  wsparcie  = round(pmin(7, pmax(1, 5.2 + 1.1 * z[, 2])), 2),     # MSPSS, 1–7
  samoocena = pmin(40, pmax(10, round(28 + 5 * z[, 3]))),         # RSES, 10–40
  zadowol   = pmin(35, pmax(5, round(22 + 6 * z[, 4]))),          # SWLS, 5–35
  praca     = pmin(40, round(pmax(0, 12 * (exp(0.9 * z[, 5]) - 1.2)))),     # godziny pracy zarobkowej / tydzień
  wiek      = round(19 + 3 * exp(0.6 * z[, 6])))                  # wiek w latach
nazwy <- c("1. Stres", "2. Wsparcie", "3. Samoocena", "4. Zadowolenie", "5. Praca (h/tydz.)", "6. Wiek")

# 1. Statystyki opisowe i skośność
round(data.frame(M = sapply(dane, mean), SD = sapply(dane, sd),
                 skosnosc = sapply(dane, skew)), 2)
# praca zarobkowa: odsetek osób, które nie pracują, mediana i maksimum godzin
c(nie_pracuje_proc = round(100 * mean(dane$praca == 0), 1), mediana = median(dane$praca),
  max = max(dane$praca))

# 2. Korelacje Pearsona z 95% CI i p (bez korekty)
kp <- corr.test(dane, method = "pearson", adjust = "none")
round(kp$r, 2)
ci <- kp$ci[, c("lower", "r", "upper", "p")]
round(ci, 3)

# 3. Korelacje Spearmana (rho) – do górnego trójkąta tabeli
ks <- corr.test(dane, method = "spearman", adjust = "none")
round(ks$r, 2)
round(ks$p, 3)

# 4. Ile korelacji jest istotnych? 15 testów: bez korekty, z korektą Holma i FDR (Benjamini–Hochberg)
p <- kp$p[lower.tri(kp$p)]
c(liczba_testow = length(p), bez_korekty = sum(p < .05),
  holm = sum(p.adjust(p, "holm") < .05), fdr_bh = sum(p.adjust(p, "BH") < .05))
# które korelacje tracą istotność po korekcie Holma?
para <- outer(nazwy, nazwy, paste, sep = " – ")[lower.tri(kp$p)]
tab <- data.frame(para, r = round(kp$r[lower.tri(kp$r)], 2), p = round(p, 3),
                  p_holm = round(p.adjust(p, "holm"), 3), p_fdr = round(p.adjust(p, "BH"), 3))
tab[order(tab$p), ]
Wynik w R
              M    SD skosnosc
stres     19.01  6.53     0.06
wsparcie   5.09  0.99    -0.01
samoocena 27.93  5.13    -0.53
zadowol   22.09  5.94    -0.07
praca      6.89 11.97     1.87
wiek      22.79  2.63     3.07
nie_pracuje_proc          mediana              max
              56                0               40
          stres wsparcie samoocena zadowol praca  wiek
stres      1.00    -0.46     -0.52   -0.55  0.01  0.01
wsparcie  -0.46     1.00      0.35    0.39  0.14 -0.05
samoocena -0.52     0.35      1.00    0.50  0.06  0.07
zadowol   -0.55     0.39      0.50    1.00  0.02  0.17
praca      0.01     0.14      0.06    0.02  1.00  0.19
wiek       0.01    -0.05      0.07    0.17  0.19  1.00
             lower      r  upper     p
stres-wsprc -0.575 -0.456 -0.319 0.000
stres-samcn -0.624 -0.515 -0.387 0.000
stres-zadwl -0.649 -0.546 -0.422 0.000
stres-praca -0.154  0.007  0.167 0.937
stres-wiek  -0.154  0.007  0.167 0.934
wsprc-samcn  0.206  0.355  0.487 0.000
wsprc-zadwl  0.248  0.393  0.521 0.000
wsprc-praca -0.018  0.142  0.296 0.083
wsprc-wiek  -0.209 -0.050  0.111 0.540
samcn-zadwl  0.373  0.503  0.614 0.000
samcn-praca -0.103  0.058  0.217 0.478
samcn-wiek  -0.092  0.069  0.227 0.402
zadwl-praca -0.139  0.022  0.181 0.792
zadwl-wiek   0.007  0.167  0.319 0.041
praca-wiek   0.031  0.191  0.341 0.019
          stres wsparcie samoocena zadowol praca  wiek
stres      1.00    -0.45     -0.50   -0.49  0.00 -0.04
wsparcie  -0.45     1.00      0.31    0.37  0.07  0.04
samoocena -0.50     0.31      1.00    0.50  0.07  0.09
zadowol   -0.49     0.37      0.50    1.00  0.02  0.18
praca      0.00     0.07      0.07    0.02  1.00  0.30
wiek      -0.04     0.04      0.09    0.18  0.30  1.00
          stres wsparcie samoocena zadowol praca  wiek
stres     0.000    0.000     0.000   0.000 0.955 0.595
wsparcie  0.000    0.000     0.000   0.000 0.397 0.639
samoocena 0.000    0.000     0.000   0.000 0.372 0.274
zadowol   0.000    0.000     0.000   0.000 0.777 0.030
praca     0.955    0.397     0.372   0.777 0.000 0.000
wiek      0.595    0.639     0.274   0.030 0.000 0.000
liczba_testow   bez_korekty          holm        fdr_bh
           15             8             6             7
                                  para     r     p p_holm p_fdr
1               2. Wsparcie – 1. Stres -0.46 0.000  0.000 0.000
2              3. Samoocena – 1. Stres -0.52 0.000  0.000 0.000
3            4. Zadowolenie – 1. Stres -0.55 0.000  0.000 0.000
6           3. Samoocena – 2. Wsparcie  0.35 0.000  0.000 0.000
7         4. Zadowolenie – 2. Wsparcie  0.39 0.000  0.000 0.000
10       4. Zadowolenie – 3. Samoocena  0.50 0.000  0.000 0.000
15        6. Wiek – 5. Praca (h/tydz.)  0.19 0.019  0.175 0.042
14            6. Wiek – 4. Zadowolenie  0.17 0.041  0.330 0.077
8     5. Praca (h/tydz.) – 2. Wsparcie  0.14 0.083  0.578 0.138
12              6. Wiek – 3. Samoocena  0.07 0.402  1.000 0.603
11   5. Praca (h/tydz.) – 3. Samoocena  0.06 0.478  1.000 0.651
9                6. Wiek – 2. Wsparcie -0.05 0.540  1.000 0.675
13 5. Praca (h/tydz.) – 4. Zadowolenie  0.02 0.792  1.000 0.913
5                   6. Wiek – 1. Stres  0.01 0.934  1.000 0.937
4        5. Praca (h/tydz.) – 1. Stres  0.01 0.937  1.000 0.937
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje corr.test() i skew() z pakietu psych, mvrnorm() z pakietu MASS, p.adjust() z pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy w tekście trzeba opisać każdą korelację z tabeli?
Nie. Przywołaj tabelę, opisz ogólny wzorzec (np. zakres współczynników w grupie zmiennych), a pełny zapis r(df), 95% CI i p podaj tylko dla korelacji, których dotyczą hipotezy. Korelacje nieistotne możesz streścić jednym zdaniem z największą wartością |r|.
Czy przy macierzy korelacji trzeba stosować poprawkę Bonferroniego?
Tylko wtedy, gdy wniosek opierasz na tym, że którakolwiek z wielu korelacji jest istotna, np. przy eksploracji całej macierzy bez hipotez. Wtedy lepiej użyć korekty Holma, mocniejszej od Bonferroniego, albo kontroli FDR. Korelacje, które sprawdzają osobne, wcześniej postawione hipotezy, możesz raportować bez korekty, jeśli tak zapisano w planie analizy.
Jak pokazać korelacje Pearsona i Spearmana w jednej tabeli?
Najprościej dać współczynniki Pearsona pod przekątną, a korelacje rang Spearmana nad nią, i napisać to w nocie pod tabelą. Możesz też podać jedną miarę dla wszystkich par albo oznaczyć indeksem pary, dla których podajesz Spearmana. Miarę wybierz przed analizą, na podstawie rozkładów zmiennych.
Co oznaczają gwiazdki w tabeli korelacji?
Gwiazdki oznaczają poziom istotności: zwykle * p < .05, ** p < .01 i *** p < .001. Ich znaczenie trzeba wyjaśnić w nocie pod tabelą, łącznie z informacją, czy uwzględniają korektę na wielokrotne testowanie. Zamiast gwiazdek możesz podać 95% przedziały ufności.
Powiązane hasła
Przeczytaj też
Korelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikCzy korelacja .30 to dużo?
Jak ocenić r = .30: konwencja Cohena a typowe korelacje w psychologii, R² = .09, przedział ufności przy różnej liczebności próby i wzór opisu APA.
Czytaj →Masz tabelę korelacji i nie wiesz, co z niej opisać?
Sprawdzimy macierz korelacji, dobór miary i korektę na wielokrotne testowanie, a potem wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- de Winter, J. C. F., Gosling, S. D., & Potter, J. (2016). Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data. Psychological Methods, 21(3), 273–290. https://doi.org/10.1037/met0000079 ● Otwarty dostęp: pełny tekst
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Rubin, M. (2021). When to adjust alpha during multiple testing: A consideration of disjunction, conjunction, and individual testing. Synthese, 199(3–4), 10969–11000. https://doi.org/10.1007/s11229-021-03276-4 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{dewinter2016comparing, author={de Winter, Joost C. F. and Gosling, Samuel D. and Potter, Jeff}, title={{Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data}}, journal={Psychological Methods}, year={2016}, volume={21}, number={3}, pages={273--290}, doi={10.1037/met0000079}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{rubin2021when, author={Rubin, Mark}, title={{When to adjust alpha during multiple testing: A consideration of disjunction, conjunction, and individual testing}}, journal={Synthese}, year={2021}, volume={199}, number={3–4}, pages={10969--11000}, doi={10.1007/s11229-021-03276-4}}