Do czego służy test t w SPSS
Test t porównuje dwie średnie. W SPSS masz do tego dwie procedury, a wybór zależy od tego, kogo porównujesz. Test t dla prób niezależnych zestawia dwie różne grupy osób, np. dwie metody nauki. Test t dla prób zależnych porównuje dwa pomiary tych samych osób, np. przed kursem i po nim. Logikę testu, założenia i obliczenia w R omawia poradnik test t Studenta krok po kroku. Tutaj zajmujemy się tylko SPSS: przygotowaniem pliku, oknami obu procedur, opcjami wielkości efektu, jednostronnym p i składnią.
Ścieżki menu, nazwy opcji i składnię sprawdziliśmy w oficjalnej dokumentacji IBM SPSS Statistics 32 (IBM Corp., b.d.-a, b.d.-b, b.d.-c, b.d.-d). Podajemy je po angielsku, a polskie – według polskiej dokumentacji IBM; w interfejsie mogą się nieco różnić. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
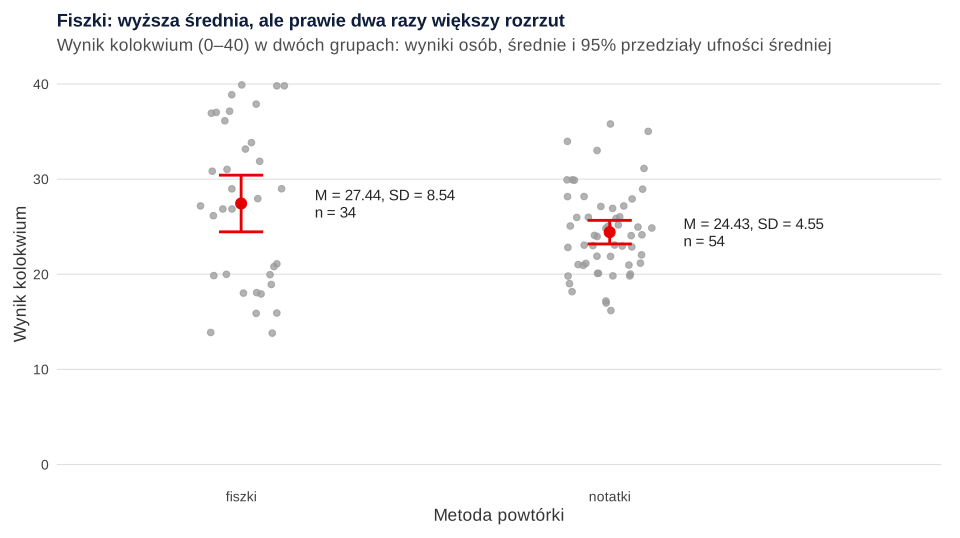
Wszystkie liczby pochodzą z jednego zbioru symulowanego. 88 osób studiujących powtarzało materiał przed kolokwium ze statystyki jedną z dwóch metod: fiszkami (n = 34) albo z notatek (n = 54). Zmienna wynik to liczba punktów z kolokwium (0–40). Te same osoby oceniły swój lęk przed statystyką (skala 1–5) przed kursem (lek_przed) i po nim (lek_po). Trzy osoby nie wypełniły skali po kursie. Mniejsza grupa ma celowo prawie dwa razy większy rozrzut wyników.
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV. Format SPSS wyjaśnia hasło plik .sav.
Przygotowanie danych: dwa układy pliku
Obie procedury wymagają innego układu danych (zob. format długi i szeroki danych):
- Próby niezależne – format długi. Wynik jest w jednej kolumnie, a druga kolumna zawiera kod grupy. Zmienna grupująca może być liczbowa (np. 1 i 2) albo krótkim tekstem (np. „tak” i „nie”) (IBM Corp., b.d.-b). Bezpieczniej użyć kodów liczbowych z etykietami wartości: 1 = fiszki, 2 = notatki.
- Próby zależne – format szeroki. Każdy pomiar to osobna kolumna, a oba pomiary jednej osoby muszą być w tym samym wierszu (IBM Corp., b.d.-c).
W widoku zmiennych (Variable View) sprawdź jeszcze, czy wynik skali jest już policzony i czy kody braków są zdefiniowane. Bez tego np. kod 99 trafi do średniej. Etykiety, braki i liczenie wyniku skali krok po kroku pokazuje wpis przygotowanie danych w SPSS.
Test t dla prób niezależnych krok po kroku
- Analyze → Compare Means → Independent-Samples T Test (w polskiej dokumentacji: Analiza → Porównanie średnich → Test t dla prób niezależnych). W nowszych wersjach menu nazywa się Compare Means and Proportions (IBM Corp., b.d.-a). Przenieś
wynikdo listy zmiennych testowanych, ametodado pola zmiennej grupującej. - Define Groups (Definiuj grupy). Wpisz 1 jako Group 1 i 2 jako Group 2. Obserwacje z innymi kodami SPSS pominie. Druga możliwość, Cutpoint, dzieli zmienną ilościową na dwie grupy: wartości mniejsze od punktu podziału trafiają do jednej grupy, a równe mu lub większe – do drugiej (IBM Corp., b.d.-b).
- Estimate effect sizes (Szacuj wielkości efektów). Zaznacz, żeby dostać tabelę wielkości efektu. Podkomendę wielkości efektu wprowadzono w wersji 27 (IBM Corp., b.d.-d), więc w starszych wersjach tej opcji nie ma.
- Homogeneity of variance test (Test jednorodności wariancji). Opcja dodaje osobną tabelę z testem Levene’a liczonym od średniej, od mediany i od średniej przyciętej (IBM Corp., b.d.-b, b.d.-d). Nie jest konieczna, bo klasyczny test Levene’a i tak jest w tabeli głównej.
- Options. Poziom przedziału ufności zostaw na 95%. Przy brakach domyślne Exclude cases analysis by analysis oznacza, że każdy test bierze wszystkie osoby z ważnymi danymi dla danej zmiennej (IBM Corp., b.d.-b).
- Paste zamiast OK. SPSS wklei składnię do edytora. Zapisz ją z danymi.
Wydruk: próby niezależne
Tabele niżej mają układ tabel wynikowych SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Pogrubiono liczby, które trafią do pracy.
| metoda | N | Mean | Std. Deviation | Std. Error Mean |
|---|---|---|---|---|
| fiszki | 34 | 27.441 | 8.536 | 1.464 |
| notatki | 54 | 24.426 | 4.550 | .619 |
| Levene’s Test for Equality of Variances | t-test for Equality of Means | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| F | Sig. | t | df | One-Sided p | Two-Sided p | Mean Difference | Std. Error Difference | 95% CI Lower | 95% CI Upper | |
| Equal variances assumed | 25.545 | .000 | 2.158 | 86 | .017 | .034 | 3.015 | 1.397 | .238 | 5.792 |
| Equal variances not assumed | 1.897 | 44.967 | .032 | .064 | 3.015 | 1.589 | −.186 | 6.217 | ||
Najpierw sprawdź N: 34 + 54 = 88, czyli wszyscy. Potem zauważ, że tabela główna zawiera dwa testy dla tych samych danych. Według dokumentacji polecenia T-TEST pierwszy wiersz to test z wariancją wspólną dla obu grup, a drugi – z wariancjami oddzielnymi (IBM Corp., b.d.-d). Drugi wiersz to test Welcha, stąd ułamkowe stopnie swobody (44.967).
W tym przykładzie wybór wiersza zmienia wniosek. Test Studenta daje p = .034, a test Welcha p = .064. Przedział ufności różnicy z wiersza Welcha obejmuje zero. Przyczynę widać na rysunku 1: mniejsza grupa ma dużo większe SD (8.54 wobec 4.55), a test Studenta uśrednia wariancje z wagą liczebności, więc jego p wychodzi za małe. Test Levene’a potwierdza różnicę wariancji, F = 25.55, p < .001. Nie wybieraj jednak wiersza na jego podstawie. Procedura dwuetapowa „najpierw Levene, potem wiersz” nie chroni poziomu istotności. Lepiej bez warunków stosować test dla nierównych wariancji (Zimmerman, 2004). Delacre i in. (2017) zalecają test Welcha jako domyślny, bo przy równych wariancjach traci niewiele. Ruxton (2006) nazwał go niedocenianą alternatywą. Do pracy przepisz drugi wiersz i zapowiedz test Welcha w planie analiz.
Wielkość efektu dla prób niezależnych
Po zaznaczeniu Estimate effect sizes SPSS dodaje tabelę wielkości efektu (IBM Corp., b.d.-b). Dokumentacja tej procedury nie wymienia jednak miar, które się w niej pojawią. Przepisz więc nazwę miary dokładnie tak, jak jest w wierszu wydruku. Dla porównania w R: d Cohena ze wspólnym SD wynosi 0.47, 95% CI [0.04, 0.91], a g Hedgesa – 0.47, 95% CI [0.04, 0.90]. Ten przedział nie obejmuje zera, choć test Welcha nie był istotny. Wspólne SD opiera się na tym samym założeniu równych wariancji co pierwszy wiersz. d liczone bez wspólnego SD daje 0.44, 95% CI [−0.03, 0.90], zgodnie z testem Welcha. W pracy napisz, którą wersję podajesz. Wzory i wybór miary objaśnia Lakens (2013).
Test t dla prób zależnych krok po kroku
- Analyze → Compare Means → Paired-Samples T Test (w polskiej dokumentacji: Analiza → Porównanie średnich → Test t dla prób powiązanych; IBM Corp., b.d.-c).
- Pary zmiennych. Przenieś
lek_przedjako Variable1 ilek_pojako Variable2. Kolejność ma znaczenie: SPSS liczy różnicę „pierwsza minus druga”, więc dodatnia średnia różnic oznacza tu spadek lęku. Możesz dodać kilka par naraz. - Estimate effect sizes z wyborem mianownika (standardizer) dla d Cohena i poprawki Hedgesa (IBM Corp., b.d.-c):
- Standard deviation of the difference – SD różnic; daje dz (ustawienie domyślne);
- Corrected standard deviation of the difference – SD różnic skorygowane o korelację pomiarów; odpowiada drm u Lakensa (2013);
- Average of variances – pierwiastek ze średniej wariancji obu pomiarów; odpowiada dav.
- Options i Paste – jak wyżej. Przy brakach SPSS bierze do każdej pary tylko osoby z oboma pomiarami (IBM Corp., b.d.-d).
Wydruk: próby zależne
| Pair 1 | Mean | N | Std. Deviation | Std. Error Mean |
|---|---|---|---|---|
| lek_przed | 3.425 | 85 | .673 | .073 |
| lek_po | 3.093 | 85 | .719 | .078 |
| Pair 1 | N | Correlation | Two-Sided p |
|---|---|---|---|
| lek_przed & lek_po | 85 | .577 | .000 |
| Pair 1 | Paired Differences | t | df | One-Sided p | Two-Sided p | ||||
|---|---|---|---|---|---|---|---|---|---|
| Mean | Std. Deviation | Std. Error Mean | 95% CI Lower | 95% CI Upper | |||||
| lek_przed – lek_po | .332 | .642 | .070 | .193 | .470 | 4.764 | 84 | .000 | .000 |
N wynosi 85, a nie 88. Trzy osoby bez pomiaru po kursie wypadły z pary. Średnie bierz z pierwszej tabeli, a średnią różnicę z przedziałem ufności – z trzeciej. Korelacja .577 pokazuje tylko, że osoby z wyższym lękiem przed kursem miały go wyższy także po nim. Nie jest to test zmiany, ale dzięki niej test dla par jest czulszy niż porównanie dwóch niezależnych grup (rysunek 2).
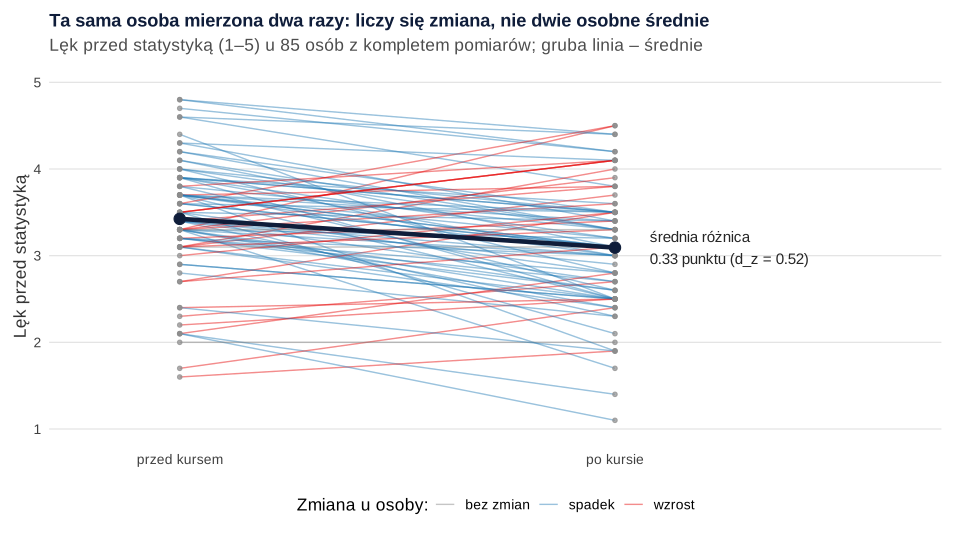
Trzy mianowniki z okna Estimate effect sizes dają w R: dz = 0.52, 95% CI [0.29, 0.74]; drm = 0.48, 95% CI [0.27, 0.68]; dav = 0.48, 95% CI [0.28, 0.67]. dz jest większe, bo dzieli przez SD różnic, które maleje, gdy pomiary są silnie skorelowane. Nie wybieraj mianownika, który daje „najładniejszy” wynik. Lakens (2013) pokazuje, że miary dla pomiarów powtarzanych różnią się tym, jak uwzględniają korelację pomiarów, a wybór zależy od celu. dav i drm łatwiej porównać z badaniami na grupach niezależnych, a dz wiąże się wprost z testem t i analizą mocy. Więcej w haśle wielkość efektu dla prób zależnych. Przedziały ufności policzyliśmy w R pakietem effectsize. SPSS może je liczyć inną metodą, więc ostatnia cyfra może się różnić.
Jednostronne p w SPSS
Aktualna dokumentacja wymienia w tabelach testu t kolumny One-Sided p i Two-Sided p (IBM Corp., b.d.-a). Starsze wydruki mają jedną kolumnę Sig. (2-tailed). Opis polecenia T-TEST wciąż podaje, że jednostronne p uzyskuje się, dzieląc dwustronne przez 2 (IBM Corp., b.d.-d). Od której wersji kolumna jest w wydruku, dokumentacja nie podaje.
W przykładzie test Welcha ma Two-Sided p = .064 i One-Sided p = .032. Drugą wartość wolno podać tylko wtedy, gdy kierunek hipotezy zapisano przed zebraniem danych, np. „fiszki dadzą wyższy wynik niż notatki”. Zmiana testu na jednostronny po obejrzeniu wyniku to ukryte podwojenie poziomu α. Sprawdź też znak Mean Difference (grupa 1 minus grupa 2). Jeśli różnica ma kierunek przeciwny do hipotezy, jednostronne p dla Twojej hipotezy wynosi 1 − p/2 i wyniku nie potwierdza. Szczegóły omawia wpis test jednostronny czy dwustronny i hasło test jednostronny i dwustronny.
Zapis wyników w stylu APA
Podaj średnie i odchylenia obu grup lub pomiarów, różnicę z 95% przedziałem ufności, t z df, dwustronne p i wielkość efektu z nazwą miary. Wzory do dostosowania:
Wynik nieistotny nie znaczy, że metody są „tak samo skuteczne”. Przedział od −0.19 do 6.22 punktu jest szeroki i zgodny zarówno z brakiem różnicy, jak i z dość dużą przewagą fiszek. Badanie przed i po bez grupy kontrolnej nie pokazuje też, że to kurs obniżył lęk (zob. schemat pretest–posttest). Wzór tabeli do pracy znajdziesz w haśle tabela testu t w APA. Zdania do innych testów przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według opisu polecenia T-TEST w Command Syntax Reference (IBM Corp., b.d.-d), ale nie uruchamialiśmy jej w SPSS. Podkomenda /ES działa od wersji 27, więc w starszej usuń ją. Usuń też wiersz /HOMOGENEITY, jeśli Twoja wersja zgłosi przy nim błąd. Przepis 2 w R tworzy pliki do pobrania i liczy wszystkie liczby z tabel tymi samymi metodami co SPSS: test Levene’a od średniej (car::leveneTest(center = mean)), wiersz Studenta i Welcha oraz test dla par z korelacją pomiarów.
1. Składnia SPSS: T-TEST dla grup i dla par
SPSS
* Test t dla prób niezależnych: wynik kolokwium a metoda powtórki (1 = fiszki, 2 = notatki).
* Składnia zgodna z opisem T-TEST w Command Syntax Reference; nie była uruchamiana w SPSS.
T-TEST GROUPS=metoda(1,2)
  /VARIABLES=wynik
  /HOMOGENEITY DISPLAY(TRUE)
  /ES DISPLAY(TRUE)
  /MISSING=ANALYSIS
  /CRITERIA=CI(.95).

* Test t dla prób zależnych: lęk przed statystyką przed kursem i po nim.
* STANDARDIZER: SD (d_z), CORRECTED_SD (d_rm) albo AVERAGE (d_av).
T-TEST PAIRS=lek_przed WITH lek_po (PAIRED)
  /ES DISPLAY(TRUE) STANDARDIZER(SD)
  /MISSING=ANALYSIS
  /CRITERIA=CI(.95).
2. Te same liczby w R i pliki .sav oraz CSV
R
# B264 – test t w SPSS: liczby do tabel w układzie SPSS (próby niezależne i zależne)
# Dane symulowane, set.seed(2649): 88 osób studiujących, dwie metody powtórki przed kolokwium
# (1 = fiszki, 2 = notatki) i wynik kolokwium 0–40; lęk przed statystyką (1–5) przed kursem i po nim.
# Metody jak w procedurach Independent-Samples i Paired-Samples T Test w SPSS: test Levene'a od średniej,
# wiersz Studenta (wariancje równe) i Welcha (wariancje nierówne), p jedno- i dwustronne,
# korelacja pomiarów w parze, braki wykluczane „analiza po analizie” (para po parze).
suppressPackageStartupMessages({ library(haven); library(car); library(effectsize) })
set.seed(2649)
n_gr <- c(34, 54)
metoda <- rep(1:2, n_gr)
wynik <- round(pmin(40, pmax(0, rnorm(sum(n_gr), c(27.5, 24.5)[metoda], c(7.4, 4.4)[metoda]))))
lek_przed <- round(pmin(5, pmax(1, rnorm(sum(n_gr), 3.3, 0.75))), 1)
lek_po <- round(pmin(5, pmax(1, 0.55 * lek_przed + 1.24 + rnorm(sum(n_gr), 0, 0.55))), 1)
lek_po[c(9, 47, 71)] <- NA                      # trzy osoby nie wypełniły skali po kursie
dane <- data.frame(id = seq_along(metoda), metoda, wynik, lek_przed, lek_po)

# Krok 1. Plik .sav z etykietami zmiennych i wartości – i ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$metoda <- labelled(sav$metoda, labels = c("fiszki" = 1, "notatki" = 2), label = "Metoda powtórki")
sav$wynik <- labelled(sav$wynik, label = "Wynik kolokwium (0–40)")
sav$lek_przed <- labelled(sav$lek_przed, label = "Lęk przed statystyką – przed kursem (1–5)")
sav$lek_po <- labelled(sav$lek_po, label = "Lęk przed statystyką – po kursie (1–5)")
write_sav(sav, "../test-t-spss-dane-przyklad.sav")
write.csv(dane, "../test-t-spss-dane-przyklad.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")
f3 <- function(x) formatC(x, format = "f", digits = 3)

# Krok 2. Group Statistics: N, Mean, Std. Deviation, Std. Error Mean
gs <- t(sapply(split(dane$wynik, dane$metoda), function(x)
  c(N = length(x), Mean = mean(x), SD = sd(x), SE = sd(x) / sqrt(length(x)))))
rownames(gs) <- c("fiszki", "notatki"); round(gs, 3)

# Krok 3. Independent Samples Test: Levene od średniej + wiersz Studenta i Welcha
lev <- leveneTest(wynik ~ factor(metoda), data = dane, center = mean)
c(F = lev$`F value`[1], Sig = lev$`Pr(>F)`[1])
wiersz <- function(tt) {
  t <- unname(tt$statistic); p2 <- tt$p.value
  c(t = t, df = unname(tt$parameter), one_sided_p = p2 / 2, two_sided_p = p2,
    mean_diff = unname(-diff(tt$estimate)), se_diff = unname(tt$stderr),
    lower = tt$conf.int[1], upper = tt$conf.int[2])
}
x1 <- dane$wynik[dane$metoda == 1]; x2 <- dane$wynik[dane$metoda == 2]
ist <- rbind(equal_variances_assumed = wiersz(t.test(x1, x2, var.equal = TRUE)),
             equal_variances_not_assumed = wiersz(t.test(x1, x2, var.equal = FALSE)))
round(ist, 3)

# Krok 4. Homogeneity of Variances (opcja Homogeneity of variance test): Levene od średniej, mediany i średniej przyciętej 5%
rbind(mean = unlist(leveneTest(wynik ~ factor(metoda), dane, center = mean)[1, 2:3]),
      median = unlist(leveneTest(wynik ~ factor(metoda), dane, center = median)[1, 2:3]),
      trimmed = unlist(leveneTest(wynik ~ factor(metoda), dane, center = mean, trim = 0.05)[1, 2:3]))

# Krok 5. Wielkość efektu: d Cohena (wspólne SD) i g Hedgesa z 95% CI; d przy SD liczonym osobno (do porównania)
print(cohens_d(x1, x2, pooled_sd = TRUE), digits = 3)
print(hedges_g(x1, x2, pooled_sd = TRUE), digits = 3)
print(cohens_d(x1, x2, pooled_sd = FALSE), digits = 3)

# Krok 6. Próby zależne: SPSS bierze osoby z kompletem obu pomiarów (para po parze)
pr <- na.omit(dane[, c("lek_przed", "lek_po")])
c(N_para = nrow(pr), wykluczone = nrow(dane) - nrow(pr))
round(t(sapply(pr, function(x) c(Mean = mean(x), N = length(x), SD = sd(x), SE = sd(x) / sqrt(length(x))))), 3)
kor <- cor.test(pr$lek_przed, pr$lek_po)
round(c(N = nrow(pr), Correlation = unname(kor$estimate), two_sided_p = kor$p.value), 3)
roz <- pr$lek_przed - pr$lek_po                 # Pair 1: pierwsza zmienna minus druga
tp <- t.test(pr$lek_przed, pr$lek_po, paired = TRUE)
round(c(Mean = mean(roz), SD = sd(roz), SE = sd(roz) / sqrt(length(roz)), lower = tp$conf.int[1],
        upper = tp$conf.int[2], t = unname(tp$statistic), df = unname(tp$parameter),
        one_sided_p = tp$p.value / 2, two_sided_p = tp$p.value), 3)
format.pval(tp$p.value, digits = 3)

# Krok 7. Wielkość efektu dla par: trzy mianowniki z okna Estimate effect sizes
# SD różnic (d_z), SD różnic skorygowane o korelację (d_rm), średnia wariancji (d_av); bez poprawki Hedgesa
r <- unname(kor$estimate)
round(c(d_z = mean(roz) / sd(roz),
        d_rm = mean(roz) / (sd(roz) / sqrt(2 * (1 - r))),
        d_av = mean(roz) / sqrt((var(pr$lek_przed) + var(pr$lek_po)) / 2)), 3)
for (m in c("z", "rm", "av"))
  print(repeated_measures_d(pr$lek_przed, pr$lek_po, method = m, adjust = FALSE), digits = 3)
Wynik w R
         N   Mean    SD    SE
fiszki  34 27.441 8.536 1.464
notatki 54 24.426 4.550 0.619
           F          Sig
2.554509e+01 2.405866e-06
                                t     df one_sided_p two_sided_p mean_diff se_diff  lower upper
equal_variances_assumed     2.158 86.000       0.017       0.034     3.015   1.397  0.238 5.792
equal_variances_not_assumed 1.897 44.967       0.032       0.064     3.015   1.589 -0.186 6.217
         F value       Pr(>F)
mean    25.54509 2.405866e-06
median  25.41117 2.538122e-06
trimmed 25.55675 2.394693e-06
Cohen's d |         95% CI
--------------------------
0.473     | [0.036, 0.906]

- Estimated using pooled SD.Hedges' g |         95% CI
--------------------------
0.468     | [0.036, 0.898]

- Estimated using pooled SD.Cohen's d |          95% CI
---------------------------
0.441     | [-0.026, 0.903]

- Estimated using un-pooled SD.    N_para wykluczone
        85          3
           Mean  N    SD    SE
lek_przed 3.425 85 0.673 0.073
lek_po    3.093 85 0.719 0.078
          N Correlation two_sided_p
     85.000       0.577       0.000
       Mean          SD          SE       lower       upper           t          df one_sided_p
      0.332       0.642       0.070       0.193       0.470       4.764      84.000       0.000
two_sided_p
      0.000
[1] "7.85e-06"
  d_z  d_rm  d_av
0.517 0.476 0.476
d (z) |         95% CI
----------------------
0.517 | [0.290, 0.743]
d (rm) |         95% CI
-----------------------
0.476  | [0.269, 0.682]
d (av) |         95% CI
-----------------------
0.476  | [0.280, 0.672]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. Składni SPSS nie uruchamialiśmy. W pracy podaj wersję programu, którego faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Dane przed i po w jednej kolumnie z „grupą” 1 = przed, 2 = po i test dla prób niezależnych. Te same osoby to próby zależne.
- Pierwszy wiersz, „bo jest pierwszy”. W przykładzie dałby istotną różnicę, której test Welcha nie potwierdza.
- F i Sig. testu Levene’a przepisane jako wynik testu t. Te liczby dotyczą wariancji, nie średnich.
- Jednostronne p wybrane po obejrzeniu wyniku.
- Nieopisany spadek N w teście dla par albo niezdefiniowany kod braku liczony jako wynik.
- Wielkość efektu bez nazwy miary, np. samo „d = 0.52” bez informacji, że to dz.
- „Sig. = .000” przepisane dosłownie. W pracy pisz p < .001 (zob. wartość p).
Przy skośnych wynikach i małych grupach przeczytaj wpis test t przy rozkładzie innym niż normalny. Gdy potrzebujesz testu nieparametrycznego, sięgnij po test Manna–Whitneya albo test Wilcoxona. Przy trzech lub więcej grupach użyj ANOVA – krok po kroku pokazuje ją wpis ANOVA w SPSS. Jeśli nie wiesz, który test pasuje do hipotezy, skorzystaj z kreatora doboru testu. Pozostałe wpisy z serii o SPSS to alfa Cronbacha w SPSS i korelacja i regresja w SPSS.
Najczęstsze pytania
Gdzie w SPSS jest test t dla prób niezależnych i dla prób zależnych?
Oba testy są w menu Analyze → Compare Means (w nowszych wersjach Compare Means and Proportions): Independent-Samples T Test porównuje dwie grupy osób, a Paired-Samples T Test – dwa pomiary tych samych osób. W polskiej dokumentacji IBM odpowiadają im pozycje Analiza → Porównanie średnich → Test t dla prób niezależnych i Test t dla prób powiązanych.
Jak w SPSS wybrać dwie grupy do testu t, gdy zmienna ma więcej kodów?
W oknie Define Groups wpisz kody dwóch grup, które chcesz porównać, np. 1 i 3. Obserwacje z innymi kodami SPSS pominie w tym teście. Opcja Cutpoint dzieli z kolei zmienną ilościową na dwie grupy według punktu podziału, ale przy zmiennej ciągłej oznacza to utratę informacji.
Czy SPSS podaje jednostronną wartość p w teście t?
Aktualna dokumentacja IBM wymienia w tabelach testu t kolumny One-Sided p i Two-Sided p, a starsze wydruki mają tylko Sig. (2-tailed), które dzieli się przez 2. Jednostronne p podaj tylko wtedy, gdy kierunek hipotezy zapisałeś przed zebraniem danych i różnica ma przewidywany znak.
Który mianownik wielkości efektu wybrać w teście t dla prób zależnych w SPSS?
SPSS proponuje SD różnic (dz), SD różnic skorygowane o korelację (drm) i średnią wariancji pomiarów (dav). W przykładzie dały 0.52, 0.48 i 0.48. Wybierz miarę przed analizą, zgodnie z celem, i nazwij ją w tekście, bo przy silnej korelacji pomiarów dz jest wyraźnie większe.
Dlaczego w teście t dla prób zależnych SPSS ma mniej osób niż w pliku?
Bo do pary wchodzą tylko osoby, które mają oba pomiary. Przy domyślnym ustawieniu braków każda para używa wszystkich kompletnych obserwacji, więc osoba bez drugiego pomiaru wypada z testu. W przykładzie z 88 osób zostało 85 – napisz o tym w opisie wyników.
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikTest t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikPrzygotowanie danych w SPSS
Variable View, kody braków 99 i 999, pozycje odwrócone w Recode into Different Variables i wynik skali z MEAN.5 – z tabelami kontrolnymi, składnią i plikiem .sav.
Czytaj →Masz wydruk testu t z SPSS i nie wiesz, który wiersz przepisać?
Sprawdzimy układ danych, wybór testu i wielkości efektu oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- IBM Corp. (b.d.-a). Curated Help for T-Tests. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=help-curated-t-tests ● Otwarty dostęp
- IBM Corp. (b.d.-b). Independent-Samples T Test. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=test-independent-samples-t ● Otwarty dostęp
- IBM Corp. (b.d.-c). Paired-Samples T Test. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=test-paired-samples-t ● Otwarty dostęp
- IBM Corp. (b.d.-d). T-TEST. IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-t-test ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Ruxton, G. D. (2006). The unequal variance t-test is an underused alternative to Student's t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688–690. https://doi.org/10.1093/beheco/ark016
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@misc{ibmndcuratedttests32, author={{IBM Corp.}}, title={{Curated Help for T-Tests}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=help-curated-t-tests}}@misc{ibmndindependentttest32, author={{IBM Corp.}}, title={{Independent-Samples T Test}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=test-independent-samples-t}}@misc{ibmndpairedttest32, author={{IBM Corp.}}, title={{Paired-Samples T Test}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=test-paired-samples-t}}@misc{ibmndttestsyntax32, author={{IBM Corp.}}, title={{T-TEST}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-t-test}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{ruxton2006unequal, author={Ruxton, Graeme D.}, title={{The unequal variance t-test is an underused alternative to Student's t-test and the Mann–Whitney U test}}, journal={Behavioral Ecology}, year={2006}, volume={17}, number={4}, pages={688--690}, doi={10.1093/beheco/ark016}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}