Dlaczego analizie podgrup tak łatwo uwierzyć
Badanie randomizowane wyszło: program działa. Recenzent pyta jednak, czy działa u wszystkich, a zespół ma w bazie płeć, wiek, wykształcenie, wcześniejsze leczenie i kilka innych cech. Po godzinie powstaje tabela szesnastu podgrup. W jednej z nich efekt „znika”, a test interakcji daje p = .03. Gotowy nagłówek: program nie pomaga osobom mieszkającym samotnie.
Podstawy opisuje hasło analiza podgrup: o różnicy między podgrupami rozstrzyga test interakcji, a nie porównanie wartości p. Różnica między wynikiem „istotnym” i „nieistotnym” sama nie musi być istotna (Gelman i Stern, 2006). Z kolei wpis moc testu dla interakcji wyjaśnia, dlaczego taki test potrzebuje kilka razy większej próby niż efekt główny. Ten wpis idzie krok dalej. Pokazuje, ile fałszywych „odkryć” daje sprawdzanie wielu cech, dlaczego wynik zależy od skali efektu i jak ocenić wiarygodność twierdzenia o podgrupie według narzędzia ICEMAN (Schandelmaier i in., 2020).
Jedno badanie, szesnaście podgrup
Przykład. 600 osób z objawami depresji losowo przydzielono do programu internetowego albo do grupy kontrolnej (dane symulowane). Wynik to PHQ-9 po 12 tygodniach. Program obniża wynik o 2 punkty u każdego uczestnika, więc żadna cecha nie modyfikuje efektu. Ciężkie objawy i wcześniejsza terapia zmieniają tylko poziom wyniku. W całej próbie różnica średnich wyniosła −2.05 pkt, 95% CI [−2.89, −1.21], p < .001.
Następnie sprawdziliśmy osiem cech, czyli szesnaście podgrup. Dla każdej cechy policzyliśmy efekt w obu podgrupach i test interakcji grupa × cecha w jednym modelu. Rysunek 1 to wykres lasu podgrup, taki jak w wielu artykułach klinicznych.
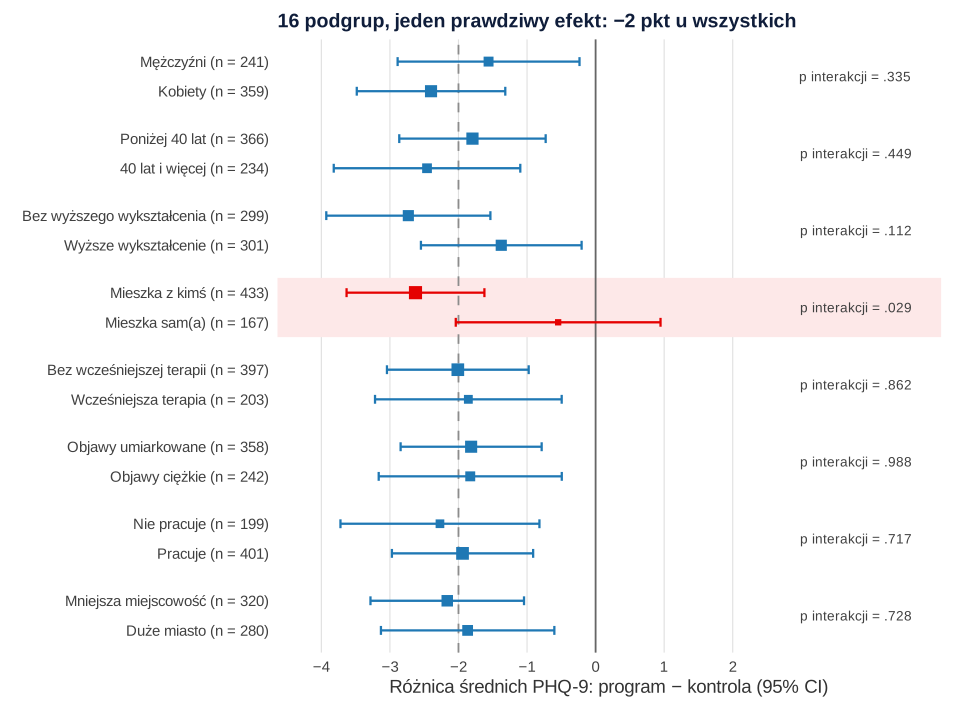
Piętnaście podgrup ma efekt istotny. W jednej, u osób mieszkających samotnie (n = 167), różnica wynosi tylko −0.55 pkt, 95% CI [−2.04, 0.95], p = .471. U osób mieszkających z kimś wynosi −2.63 pkt [−3.63, −1.62]. Test interakcji daje różnicę efektów 2.08 pkt, 95% CI [0.22, 3.94], p = .029. Tu nie chodzi już o porównanie dwóch wartości p, bo test interakcji jest poprawny i istotny. Łatwo dopisać do tego wyniku teorię: samotność, mniej wsparcia przy ćwiczeniach z programu. A jednak wiemy, że to przypadek.
Uprzedzamy uczciwie: ziarno losowania wybraliśmy tak, żeby w przykładzie pojawiła się dokładnie jedna taka „interakcja”. Następna sekcja pokazuje, jak często zdarza się to bez żadnego wybierania. Po poprawce Holma na osiem testów interakcji p dla mieszkania samotnie rośnie do .459.
Ile „odkryć” daje sam przypadek
Powtórzyliśmy to badanie 2000 razy, za każdym razem z dwudziestoma niezależnymi cechami i bez żadnej heterogeniczności efektu. W każdym powtórzeniu liczyliśmy testy interakcji dla pierwszych K cech. Wynik pokazuje rysunek 2.
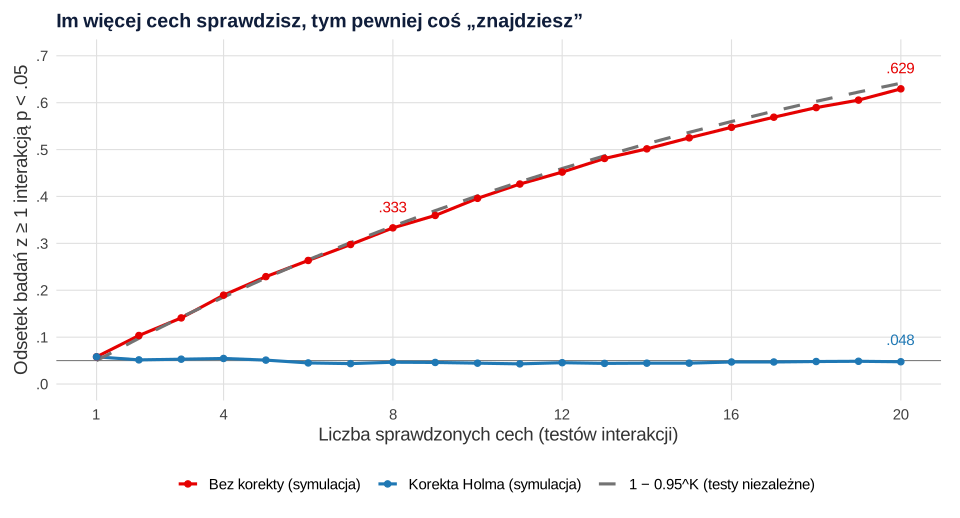
Przy ośmiu cechach co najmniej jedna „istotna” interakcja pojawiła się w 33.3% badań, a przy dwudziestu – w 62.9%. To niemal dokładnie 1 − 0.95K, czyli wzór dla niezależnych testów (zob. problem wielokrotnych porównań). Korekta Holma utrzymywała ten odsetek w okolicy 5% (.048 przy dwudziestu cechach; błąd Monte Carlo do .011). Jeszcze gorzej wypada porównywanie p w podgrupach. Wzór „istotne w jednej podgrupie, nieistotne w drugiej” przy co najmniej jednej z ośmiu cech wystąpił w 48.4% badań. Brookes i in. (2004) opisali ten mechanizm w symulacjach wcześniej.
Prawdziwy modyfikator nie rozwiązuje problemu. Dodaliśmy cechę, przy której efekt wynosi −2.5 pkt w jednej połowie próby i −1.5 w drugiej (różnica 1 pkt). Test interakcji wykrył ją tylko w 24.2% badań. Gdy już wyszedł istotny, średnie oszacowanie różnicy wynosiło 2.09 pkt, czyli było ponad dwa razy zawyżone. Przy różnicy 2 pkt moc wynosiła .696, a zawyżenie 1.21 raza. To błąd typu M: istotna interakcja z badania o małej mocy przeszacowuje różnicę między podgrupami. Pierwsza replikacja zwykle pokazuje więc efekt mniejszy, a podgrupa „przestaje działać”.
Skala addytywna czy multiplikatywna
Przy wyniku binarnym pytanie „czy efekt różni się między podgrupami” nie jest kompletne. Trzeba dodać: na jakiej skali. Hasło czynnik zakłócający a modyfikator efektu sygnalizuje ten problem. Tutaj pokazujemy go na liczbach.
Przykład. 4000 osób po leczeniu depresji (dane symulowane), wynik to nawrót w ciągu roku. Połowa ma niskie ryzyko wyjściowe (10% nawrotów bez programu), połowa wysokie (40%). Program obniża ryzyko o 25% w obu podgrupach, czyli ryzyko względne wynosi 0.75 u wszystkich.
| Miara | Niskie ryzyko | Wysokie ryzyko | Test interakcji |
|---|---|---|---|
| Nawroty: kontrola / program | 11.4% / 7.9% | 40.9% / 30.0% | – |
| Różnica ryzyka (95% CI) | −3.5 pp [−6.1, −0.9] | −10.9 pp [−15.1, −6.7] | z = −2.96, p = .003 |
| Ryzyko względne (RR) | 0.69 | 0.73 | z = 0.37, p = .709 |
| Iloraz szans (OR) | 0.67 | 0.62 | z = −0.41, p = .683 |
| NNT (zaokrąglone w górę) | 29 | 10 | – |
Na skali multiplikatywnej (RR, iloraz szans, regresja logistyczna) nie ma interakcji. Na skali addytywnej (różnica ryzyka) interakcja jest wyraźna: osoby z wysokim ryzykiem zyskują ponad trzy razy więcej, a NNT spada z 29 do 10. Oba wyniki są prawdziwe naraz, bo odpowiadają na różne pytania. Rysunek 3 pokazuje to samo graficznie.
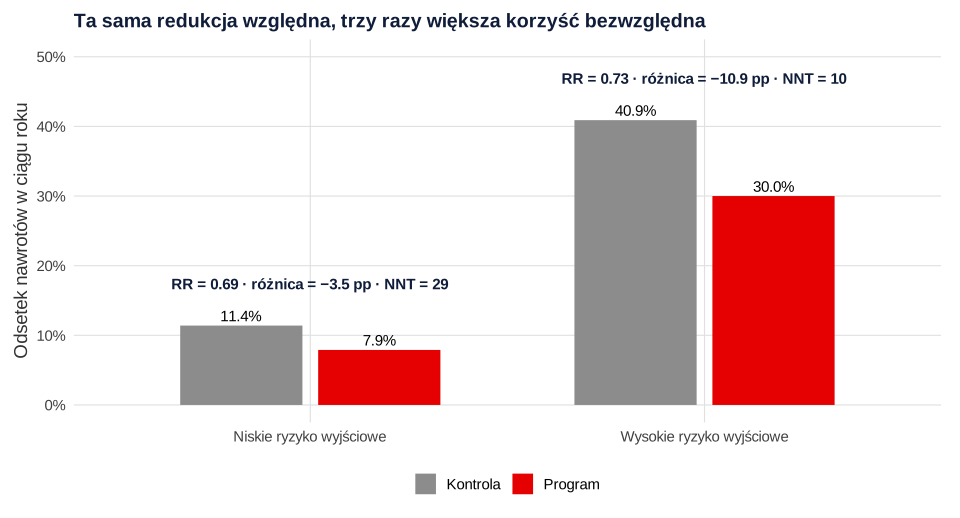
Wynikają z tego trzy praktyczne zasady:
- Nazwij skalę w planie analizy. Brak interakcji w regresji logistycznej nie znaczy, że korzyść bezwzględna jest jednakowa. Istotna interakcja na jednej skali bywa artefaktem innego ryzyka wyjściowego.
- Raportuj obie skale. Knol i VanderWeele (2012) zalecają podawać efekty w każdej warstwie, miary efektu wewnątrz warstw oraz miary interakcji na skali addytywnej i multiplikatywnej, a także listę zmiennych, o które korygowano.
- Do decyzji klinicznych liczy się skala bezwzględna. Deklaracja PATH (Kent i in., 2020) definiuje heterogeniczność efektu zawsze względem wybranej skali i uznaje bezwzględny efekt leczenia za najważniejszy dla decyzji klinicznych. Zamiast badać podgrupy „po jednej zmiennej” proponuje podejście predykcyjne. Najpierw model ryzyka wyjściowego, potem efekt w warstwach tego ryzyka, jak w naszym przykładzie.
Kryteria wiarygodności: ICEMAN
Sun i in. (2012) przejrzeli badania randomizowane opublikowane w 2007 roku w podstawowych czasopismach klinicznych indeksowanych w Medline. Na 207 badań z analizami podgrup 64 (31%) ogłaszało efekt w podgrupie dla wyniku głównego. Hipotezę jasno zaplanowało z góry 41% z nich, kierunek trafnie przewidziało 6%, a istotny test interakcji miało tylko 9%. 84% twierdzeń spełniało najwyżej cztery z dziesięciu kryteriów wiarygodności.
Dlatego warto oceniać takie twierdzenia według listy, a nie według wrażenia. ICEMAN (Instrument for assessing the Credibility of Effect Modification Analyses) powstał w badaniu konsensusu ekspertów i był testowany przez badaczy, autorów przeglądów i redaktorów (Schandelmaier i in., 2020). Wersja dla pojedynczego badania randomizowanego ma pięć pytań głównych. Każde ma cztery odpowiedzi: od „zdecydowanie obniża wiarygodność” do „zdecydowanie ją podnosi”. W tabeli stosujemy je do naszej podgrupy „mieszka sam(a)”.
| Pytanie ICEMAN (wersja dla RCT) | Nasz przykład |
|---|---|
| Czy kierunek modyfikacji efektu przewidziano trafnie z góry? | Nie, podgrupę wybrano po obejrzeniu wyników. |
| Czy modyfikację wspierają wcześniejsze dowody? | Brak takich dowodów; uzasadnienie dopisano po fakcie. |
| Czy test interakcji wskazuje, że przypadek jest mało prawdopodobnym wyjaśnieniem? | p = .029, czyli powyżej progu .01 przyjętego w narzędziu. |
| Czy sprawdzono tylko kilka modyfikatorów albo uwzględniono ich liczbę w analizie? | Osiem cech bez korekty; po korekcie Holma p = .459. |
| Czy przy modyfikatorze ciągłym uniknięto arbitralnych punktów podziału? | Nie dotyczy (cecha dwuwartościowa). |
Nasza ocena: wiarygodność bardzo niska. ICEMAN kończy się ogólną oceną w czterech kategoriach, od bardzo niskiej do wysokiej. Autorzy przybliżają je do prawdopodobieństwa, że modyfikacja istnieje: poniżej 25%, 25–50%, 51–75% i powyżej 75%. Progi p interakcji w narzędziu to .05, .01 i .005. Autorzy zaznaczają, że p waży tyle samo co inne pytania. Twierdzenie z granicznym p może więc być umiarkowanie wiarygodne, a oparte tylko na bardzo małym p – mało wiarygodne. Wstępna część narzędzia ostrzega też przed modyfikatorami mierzonymi po randomizacji (np. adherencja). Podział według nich nie zachowuje porównywalności grup; takim pytaniom służy stratyfikacja główna. Autorzy ICEMAN przypominają też, że próby replikacji modyfikacji efektu w badaniach randomizowanych są skrajnie rzadkie.
Ta sama logika obowiązuje w metaanalizie. Tam ICEMAN ma osiem pytań, m.in. o to, czy porównanie odbywa się wewnątrz badań, czy między nimi (zob. metaregresja i analiza moderatorów).
Prespecyfikacja: co wpisać do protokołu
„Analizy podgrup zaplanowano z góry” to zdanie, które łatwo napisać. Kasenda i in. (2014) porównali 894 protokoły badań randomizowanych z publikacjami. Analizy podgrup zaplanowano w 28.2% protokołów, ale tylko 6.7% z nich zawierało jasną hipotezę, a 4.0% – przewidywany kierunek. W 81 publikacjach autorzy pisali, że podgrupy były zaplanowane, a w 28 przypadkach (34.6%) protokół tego nie potwierdzał. Spośród 86 publikacji, które ogłaszały efekt w podgrupie, tylko 36 (41.9%) miało zaplanowaną analizę podgrup w protokole.
Wiarygodna prerejestracja analizy podgrup zawiera:
- Krótką listę cech mierzonych przed randomizacją, każdą z uzasadnieniem z teorii lub wcześniejszych badań.
- Kierunek: w której podgrupie spodziewasz się większego efektu i mniej więcej o ile.
- Skalę i model: interakcja w modelu liniowym, na skali różnicy ryzyka albo ilorazu szans.
- Kodowanie: cechę ciągłą modeluj jako ciągłą, bez podziału medianą (zob. dychotomizacja zmiennych ciągłych).
- Sposób uwzględnienia liczby testów: korektę albo jawny podział na analizy konfirmacyjne i eksploracyjne.
- Analizę mocy dla interakcji albo uczciwe zdanie, że badanie jej nie ma.
Kluczowy modyfikator możesz uwzględnić w randomizacji warstwowej. Pozostałe elementy planu opisuje wpis plan analizy statystycznej i prerejestracja. Wzór fragmentu protokołu:
Moc testu interakcji policzysz wzorem albo symulacją, tak jak we wpisie o mocy testu interakcji.
Jak opisać analizę podgrup w artykule
CONSORT 2025 stawia pytanie wprost: czy efekty w podgrupach różnią się między sobą? Odpowiedź daje test interakcji z oszacowaniem różnicy i przedziałem ufności. Wytyczne przypominają, że test ten ma zwykle niską moc (Hopewell i in., 2025). Wang i in. (2007) omawiają mocne i słabe strony analizy podgrup oraz zasady ich raportowania w czasopiśmie New England Journal of Medicine. W praktyce podaj:
- wszystkie przeprowadzone analizy podgrup, nie tylko „ciekawe”, z rozróżnieniem zaplanowanych i eksploracyjnych;
- efekt w każdej podgrupie z 95% CI, najlepiej na wykresie lasu, bez gwiazdek przy podgrupach;
- różnicę efektów z 95% CI i p interakcji, przy wyniku binarnym na obu skalach;
- wynik korekty na liczbę testów albo jasne zdanie, że wyniki eksploracyjne generują hipotezy.
Wzór dla przykładu z tego wpisu:
Jeśli zamiast kilku cech interesuje Cię, komu interwencja pomaga najbardziej przy wielu cechach naraz, to inne narzędzia: model ryzyka (PATH) albo metody uczenia maszynowego opisane w haśle CATE i lasy przyczynowe. One także wymagają walidacji, a nie tylko istotnego wyniku.
Przykład w R
Trzy przepisy są niezależne i odtwarzają wszystkie liczby z tekstu. Każdy działa w podstawowej instalacji R. Pierwszy liczy efekty w 16 podgrupach jednego badania, drugi to symulacja Monte Carlo (kilka sekund), trzeci porównuje skale efektu przy wyniku binarnym. Przepisy zapisują pliki CSV, z których powstały rysunki.
1. Jedno badanie: efekty w podgrupach i testy interakcji
R
# Krok 1. Jedno badanie, osiem cech i 16 podgrup (dane symulowane)
# RCT programu internetowego: 600 osób, wynik PHQ-9 po 12 tygodniach (niższy = lepiej).
# Prawdziwy efekt programu wynosi −2 pkt u KAŻDEGO uczestnika: żadna cecha go nie modyfikuje.
# Ciężkie objawy i wcześniejsza terapia zmieniają tylko poziom wyniku (są prognostyczne).
options(width = 120)
set.seed(3595)
n <- 600
d <- data.frame(kobieta = rbinom(n, 1, .6), wiek_40_plus = rbinom(n, 1, .4), wyzsze = rbinom(n, 1, .5),
                mieszka_sam = rbinom(n, 1, .3), wczesniej_terapia = rbinom(n, 1, .35),
                ciezkie_objawy = rbinom(n, 1, .4), pracuje = rbinom(n, 1, .65), duze_miasto = rbinom(n, 1, .45))
d$grupa <- rep(0:1, n / 2)                                   # 0 = kontrola, 1 = program
d$phq <- 12 + 3 * d$ciezkie_objawy + 1 * d$wczesniej_terapia - 2 * d$grupa + rnorm(n, 0, 5)
cechy <- names(d)[1:8]

efekt <- function(dd) {                                      # różnica średnich program − kontrola
  m <- summary(lm(phq ~ grupa, data = dd))$coefficients["grupa", ]
  c(n = nrow(dd), b = m[[1]], dolna = m[[1]] - qt(.975, nrow(dd) - 2) * m[[2]],
    gorna = m[[1]] + qt(.975, nrow(dd) - 2) * m[[2]], p = m[[4]])
}
round(efekt(d), 3)                                           # efekt w całej próbie

# Efekt w każdej podgrupie i test interakcji grupa × cecha (jeden model na cechę)
wyniki <- do.call(rbind, lapply(cechy, function(v) {
  m <- lm(reformulate(c("grupa", v, paste0("grupa:", v)), "phq"), data = d)
  int <- summary(m)$coefficients[paste0("grupa:", v), ]
  ci <- confint(m)[paste0("grupa:", v), ]
  data.frame(cecha = v, poziom = c(0, 1), rbind(efekt(d[d[[v]] == 0, ]), efekt(d[d[[v]] == 1, ])),
             roznica = int[[1]], roznica_dolna = ci[[1]], roznica_gorna = ci[[2]], p_interakcji = int[[4]])
}))
wyniki$p_holm <- p.adjust(wyniki$p_interakcji, "holm")      # 8 testów interakcji (każdy powtórzony 2×)
print(cbind(wyniki[1:2], round(wyniki[-(1:2)], 3)), row.names = FALSE)
write.csv(wyniki, "podgrupy-jedno-badanie.csv", row.names = FALSE)

# Ile testów interakcji wyszło p < .05 i ile podgrup ma efekt istotny, a ile nie?
c(interakcje_p_ponizej_05 = sum(wyniki$p_interakcji[wyniki$poziom == 0] < .05),
  podgrupy_istotne = sum(wyniki$p < .05), podgrupy_nieistotne = sum(wyniki$p >= .05))
Wynik w R
      n       b   dolna   gorna       p
600.000  -2.049  -2.885  -1.213   0.000
             cecha poziom   n      b  dolna  gorna     p roznica roznica_dolna roznica_gorna p_interakcji p_holm
           kobieta      0 241 -1.561 -2.888 -0.235 0.021  -0.839        -2.547         0.869        0.335  1.000
           kobieta      1 359 -2.400 -3.483 -1.317 0.000  -0.839        -2.547         0.869        0.335  1.000
      wiek_40_plus      0 366 -1.796 -2.864 -0.728 0.001  -0.663        -2.382         1.056        0.449  1.000
      wiek_40_plus      1 234 -2.459 -3.819 -1.098 0.000  -0.663        -2.382         1.056        0.449  1.000
            wyzsze      0 299 -2.731 -3.928 -1.534 0.000   1.355        -0.316         3.027        0.112  1.000
            wyzsze      1 301 -1.376 -2.548 -0.204 0.022   1.355        -0.316         3.027        0.112  1.000
       mieszka_sam      0 433 -2.627 -3.632 -1.622 0.000   2.081         0.218         3.944        0.029  0.459
       mieszka_sam      1 167 -0.546 -2.039  0.947 0.471   2.081         0.218         3.944        0.029  0.459
 wczesniej_terapia      0 397 -2.010 -3.043 -0.976 0.000   0.154        -1.587         1.894        0.862  1.000
 wczesniej_terapia      1 203 -1.856 -3.217 -0.495 0.008   0.154        -1.587         1.894        0.862  1.000
    ciezkie_objawy      0 358 -1.815 -2.844 -0.787 0.001  -0.013        -1.675         1.649        0.988  1.000
    ciezkie_objawy      1 242 -1.828 -3.164 -0.493 0.007  -0.013        -1.675         1.649        0.988  1.000
           pracuje      0 199 -2.270 -3.721 -0.819 0.002   0.329        -1.452         2.111        0.717  1.000
           pracuje      1 401 -1.941 -2.971 -0.911 0.000   0.329        -1.452         2.111        0.717  1.000
       duze_miasto      0 320 -2.164 -3.283 -1.044 0.000   0.297        -1.382         1.977        0.728  1.000
       duze_miasto      1 280 -1.866 -3.131 -0.602 0.004   0.297        -1.382         1.977        0.728  1.000
interakcje_p_ponizej_05        podgrupy_istotne     podgrupy_nieistotne
                      1                      15                       1
2. Symulacja: fałszywe interakcje i zawyżone oszacowania
R
# Krok 2. Ile „odkryć” daje analiza podgrup, gdy efekt jest jednakowy? (dane symulowane)
# 2000 badań jak w kroku 1 (N = 600, efekt −2 pkt, SD = 5), 20 niezależnych cech dwuwartościowych.
# W każdym badaniu test interakcji grupa × cecha dla kolejnych K = 1, …, 20 cech.
set.seed(3571)
R <- 2000; n <- 600; K_max <- 20
p_int <- matrix(NA, R, K_max)                                # p interakcji: badanie × cecha
wzor_podgrup <- logical(R)                                   # „istotne w jednej podgrupie, w drugiej nie” (8 cech)
p_lm <- function(X, y, j) {                                  # p dla kolumny j z modelu liniowego
  m <- lm.fit(X, y); s2 <- sum(m$residuals^2) / (length(y) - ncol(X))
  2 * pt(-abs(m$coefficients[j] / sqrt(s2 * solve(crossprod(X))[j, j])), length(y) - ncol(X))
}
for (r in 1:R) {
  grupa <- rep(0:1, n / 2)
  cechy <- matrix(rbinom(n * K_max, 1, runif(K_max, .3, .6)), n, K_max, byrow = TRUE)
  y <- 12 - 2 * grupa + rnorm(n, 0, 5)
  p_int[r, ] <- sapply(1:K_max, function(k) p_lm(cbind(1, grupa, cechy[, k], grupa * cechy[, k]), y, 4))
  wzor_podgrup[r] <- any(sapply(1:8, function(k) {
    p0 <- p_lm(cbind(1, grupa[cechy[, k] == 0]), y[cechy[, k] == 0], 2)
    p1 <- p_lm(cbind(1, grupa[cechy[, k] == 1]), y[cechy[, k] == 1], 2)
    (p0 < .05) != (p1 < .05)
  }))
}
falszywe <- data.frame(K = 1:K_max,
  bez_korekty = sapply(1:K_max, function(k) mean(apply(p_int[, 1:k, drop = FALSE] < .05, 1, any))),
  holm = sapply(1:K_max, function(k) mean(apply(p_int[, 1:k, drop = FALSE], 1, function(p) any(p.adjust(p, "holm") < .05)))),
  wzor = 1 - .95^(1:K_max))
write.csv(falszywe, "falszywe-interakcje.csv", row.names = FALSE)
print(round(falszywe[c(1, 4, 8, 12, 16, 20), ], 3), row.names = FALSE)
c(osiem_cech_wzor_podgrup = round(mean(wzor_podgrup), 3),
  blad_MC_przy_.40 = round(sqrt(.4 * .6 / R), 3))

# Prawdziwy modyfikator: efekt −3 pkt w jednej podgrupie i −1 pkt w drugiej (różnica 2) albo −2.5 i −1.5 (różnica 1).
# Moc testu interakcji i średnie oszacowanie różnicy w badaniach, w których wyszło p < .05.
set.seed(3572)
modyfikator <- t(sapply(c(1, 2), function(roznica) {
  est <- t(replicate(R, {
    grupa <- rep(0:1, n / 2); x <- rep(rep(0:1, each = n / 4), 2)
    y <- 12 - 2 * grupa - roznica * grupa * (x - .5) + rnorm(n, 0, 5)
    X <- cbind(1, grupa, x, grupa * x); m <- lm.fit(X, y)
    c(b = -m$coefficients[[4]], p = p_lm(X, y, 4))
  }))
  istotne <- est[, "p"] < .05
  c(prawdziwa_roznica = roznica, moc = mean(istotne), srednia_gdy_istotne = mean(abs(est[istotne, "b"])),
    przeszacowanie = mean(abs(est[istotne, "b"])) / roznica)
}))
round(modyfikator, 3)
Wynik w R
  K bez_korekty  holm  wzor
  1       0.058 0.058 0.050
  4       0.190 0.054 0.185
  8       0.333 0.046 0.337
 12       0.452 0.046 0.460
 16       0.547 0.047 0.560
 20       0.629 0.048 0.642
osiem_cech_wzor_podgrup        blad_MC_przy_.40
                  0.484                   0.011
     prawdziwa_roznica   moc srednia_gdy_istotne przeszacowanie
[1,]                 1 0.242               2.085          2.085
[2,]                 2 0.696               2.418          1.209
3. Ta sama interwencja na trzech skalach
R
# Krok 3. Ta sama interwencja na trzech skalach: różnica ryzyka, RR i OR (dane symulowane)
# RCT 4000 osób, wynik binarny: nawrót depresji w ciągu roku. Połowa uczestników ma niskie ryzyko
# wyjściowe (10% nawrotów bez programu), połowa wysokie (40%). Program obniża ryzyko o 25% w obu: RR = 0.75.
set.seed(3573)
n <- 4000
d <- data.frame(grupa = rep(0:1, n / 2), ryzyko = rep(c("niskie", "wysokie"), each = n / 2))
p_kontrola <- ifelse(d$ryzyko == "niskie", .10, .40)
d$nawrot <- rbinom(n, 1, p_kontrola * ifelse(d$grupa == 1, .75, 1))

skale <- function(dd) {                                      # p1 = program, p0 = kontrola
  x1 <- sum(dd$nawrot[dd$grupa == 1]); n1 <- sum(dd$grupa == 1)
  x0 <- sum(dd$nawrot[dd$grupa == 0]); n0 <- sum(dd$grupa == 0)
  p1 <- x1 / n1; p0 <- x0 / n0
  c(p0 = p0, p1 = p1, RD = p1 - p0, se_RD = sqrt(p1 * (1 - p1) / n1 + p0 * (1 - p0) / n0),
    logRR = log(p1 / p0), se_logRR = sqrt(1 / x1 - 1 / n1 + 1 / x0 - 1 / n0),
    logOR = log(p1 / (1 - p1) / (p0 / (1 - p0))), se_logOR = sqrt(1 / x1 + 1 / (n1 - x1) + 1 / x0 + 1 / (n0 - x0)))
}
s <- sapply(split(d, d$ryzyko), skale)
tab <- data.frame(ryzyko = colnames(s), ryzyko_kontrola = s["p0", ], ryzyko_program = s["p1", ],
                  RD = s["RD", ], RD_dolna = s["RD", ] - 1.96 * s["se_RD", ], RD_gorna = s["RD", ] + 1.96 * s["se_RD", ],
                  RR = exp(s["logRR", ]), OR = exp(s["logOR", ]), NNT = -1 / s["RD", ])
print(round(tab[-1], 3))
write.csv(tab, "skala-ryzyko.csv", row.names = FALSE)

# Test interakcji osobno na każdej skali: różnica dwóch oszacowań / jej SE (test Walda)
test_int <- function(est, se) {
  roznica <- unname(est[2] - est[1]); se_r <- sqrt(sum(se^2))
  c(roznica = roznica, z = roznica / se_r, p = 2 * pnorm(-abs(roznica / se_r)))
}
round(rbind(roznica_ryzyka = test_int(s["RD", ], s["se_RD", ]),
            log_RR = test_int(s["logRR", ], s["se_logRR", ]),
            log_OR = test_int(s["logOR", ], s["se_logOR", ])), 3)

# Sprawdzenie skali OR modelem logistycznym z interakcją (to samo p co wyżej)
m <- glm(nawrot ~ grupa * ryzyko, family = binomial, data = d)
round(summary(m)$coefficients["grupa:ryzykowysokie", ], 3)
Wynik w R
        ryzyko_kontrola ryzyko_program     RD RD_dolna RD_gorna    RR    OR    NNT
niskie            0.114          0.079 -0.035   -0.061   -0.009 0.693 0.667 28.571
wysokie           0.409          0.300 -0.109   -0.151   -0.067 0.733 0.619  9.174
               roznica      z     p
roznica_ryzyka  -0.074 -2.959 0.003
log_RR           0.057  0.373 0.709
log_OR          -0.074 -0.409 0.683
  Estimate Std. Error    z value   Pr(>|z|)
    -0.074      0.180     -0.409      0.683
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wniosek z jednej „istotnej” interakcji spośród wielu. Przy ośmiu cechach co trzecie badanie bez żadnej heterogeniczności daje taki wynik.
- Brak informacji, ile podgrup sprawdzono. Bez tej liczby czytelnik nie oceni ryzyka przypadku.
- Interakcja bez nazwanej skali. Ten sam wynik może nie mieć interakcji w regresji logistycznej, a mieć ją na skali różnicy ryzyka.
- Oszacowanie z odkrywczego badania jako pewnik. Istotna interakcja przy małej mocy była w symulacji średnio dwukrotnie zawyżona.
- Podgrupy według cech mierzonych po randomizacji. Podział według adherencji czy reakcji na leczenie łamie porównywalność grup.
- Podział cechy ciągłej po obejrzeniu danych. Szukanie progu, przy którym interakcja „wychodzi”, to ogród rozwidlających się ścieżek.
Najczęstsze pytania
Kiedy można wierzyć wynikom analizy podgrup?
Gdy różnicę potwierdza test interakcji, kierunek przewidziano przed analizą, wspierają go wcześniejsze badania, sprawdzono niewiele cech (albo uwzględniono ich liczbę) i nie dzielono cechy ciągłej arbitralnie. To pięć pytań głównych narzędzia ICEMAN dla badań randomizowanych (Schandelmaier i in., 2020). Pojedyncza interakcja z p = .03 spośród wielu sprawdzonych cech ma niską wiarygodność.
Czy przy analizie podgrup trzeba stosować poprawkę na wielokrotne testowanie?
Przy wielu podgrupach eksploracyjnych tak, albo przynajmniej jawnie podaj liczbę testów. W symulacji bez prawdziwych różnic co najmniej jedna istotna interakcja pojawiła się w 33.3% badań przy ośmiu cechach, a po korekcie Holma odsetek wrócił w okolice 5%. Jedną lub dwie podgrupy zaplanowane z góry, z kierunkiem i uzasadnieniem, możesz testować bez korekty jako hipotezy konfirmacyjne.
Na jakiej skali testować interakcję przy wyniku dwuwartościowym?
Najlepiej na obu i nazwać je w planie analizy. Gdy ryzyko wyjściowe różni się między podgrupami, efekt może być stały na skali RR lub OR, a różny na skali różnicy ryzyka. W przykładzie RR wynosił 0.69 i 0.73 (p interakcji = .709), a różnica ryzyka −3.5 i −10.9 punktu procentowego (p = .003). Do decyzji klinicznych ważniejsza jest skala bezwzględna.
Czy analiza podgrup post hoc ma jakąkolwiek wartość?
Ma, ale jako źródło hipotez, a nie dowód. Opisz ją jako eksploracyjną, podaj wszystkie sprawdzone podgrupy, efekty z przedziałami ufności i p interakcji. Pamiętaj, że istotna interakcja z badania o małej mocy zwykle przeszacowuje różnicę: w symulacji przy prawdziwej różnicy 1 pkt istotne oszacowania wynosiły średnio 2.09 pkt.
Co to jest ICEMAN?
ICEMAN (Instrument for assessing the Credibility of Effect Modification Analyses) to narzędzie do oceny wiarygodności twierdzeń o modyfikacji efektu w badaniach randomizowanych i metaanalizach. Ma rozważania wstępne, 5 pytań głównych dla pojedynczego badania i 8 dla metaanalizy, każde z czterema odpowiedziami, oraz ogólną ocenę od bardzo niskiej do wysokiej wiarygodności.
Powiązane hasła
Przeczytaj też
Analiza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →PoradnikMoc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikStatystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →Recenzent pyta o podgrupy albo chcesz zaplanować analizę modyfikacji efektu?
Pomożemy wybrać i uzasadnić podgrupy, zapisać je w planie analizy, policzyć testy interakcji na właściwej skali i opisać wyniki tak, żebyś mógł(a) samodzielnie obronić je przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Brookes, S. T., Whitely, E., Egger, M., Davey Smith, G., Mulheran, P. A., & Peters, T. J. (2004). Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test. Journal of Clinical Epidemiology, 57(3), 229–236. https://doi.org/10.1016/j.jclinepi.2003.08.009
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials. BMJ, 389, Article e081124. https://doi.org/10.1136/bmj-2024-081124 ● Otwarty dostęp
- Kasenda, B., Schandelmaier, S., Sun, X., von Elm, E., You, J., Blumle, A., Tomonaga, Y., Saccilotto, R., Amstutz, A., Bengough, T., Meerpohl, J. J., Stegert, M., Olu, K. K., Tikkinen, K. A. O., Neumann, I., Carrasco-Labra, A., Faulhaber, M., Mulla, S. M., Mertz, D., . . . Briel, M. (2014). Subgroup analyses in randomised controlled trials: Cohort study on trial protocols and journal publications. BMJ, 349, Article g4539. https://doi.org/10.1136/bmj.g4539 ● Otwarty dostęp
- Kent, D. M., Paulus, J. K., van Klaveren, D., D'Agostino, R., Goodman, S., Hayward, R., Ioannidis, J. P. A., Patrick-Lake, B., Morton, S., Pencina, M., Raman, G., Ross, J. S., Selker, H. P., Varadhan, R., Vickers, A., Wong, J. B., & Steyerberg, E. W. (2020). The Predictive Approaches to Treatment effect Heterogeneity (PATH) statement. Annals of Internal Medicine, 172(1), 35–45. https://doi.org/10.7326/m18-3667 ● Otwarty dostęp: pełny tekst
- Knol, M. J., & VanderWeele, T. J. (2012). Recommendations for presenting analyses of effect modification and interaction. International Journal of Epidemiology, 41(2), 514–520. https://doi.org/10.1093/ije/dyr218 ● Otwarty dostęp: pełny tekst
- Schandelmaier, S., Briel, M., Varadhan, R., Schmid, C. H., Devasenapathy, N., Hayward, R. A., Gagnier, J., Borenstein, M., van der Heijden, G. J. M. G., Dahabreh, I. J., Sun, X., Sauerbrei, W., Walsh, M., Ioannidis, J. P. A., Thabane, L., & Guyatt, G. H. (2020). Development of the Instrument to assess the Credibility of Effect Modification Analyses (ICEMAN) in randomized controlled trials and meta-analyses. Canadian Medical Association Journal, 192(32), E901–E906. https://doi.org/10.1503/cmaj.200077 ● Otwarty dostęp
- Sun, X., Briel, M., Busse, J. W., You, J. J., Akl, E. A., Mejza, F., Bala, M. M., Bassler, D., Mertz, D., Diaz-Granados, N., Vandvik, P. O., Malaga, G., Srinathan, S. K., Dahm, P., Johnston, B. C., Alonso-Coello, P., Hassouneh, B., Walter, S. D., Heels-Ansdell, D., . . . Guyatt, G. H. (2012). Credibility of claims of subgroup effects in randomised controlled trials: Systematic review. BMJ, 344, Article e1553. https://doi.org/10.1136/bmj.e1553 ● Otwarty dostęp
- Wang, R., Lagakos, S. W., Ware, J. H., Hunter, D. J., & Drazen, J. M. (2007). Statistics in medicine – Reporting of subgroup analyses in clinical trials. New England Journal of Medicine, 357(21), 2189–2194. https://doi.org/10.1056/nejmsr077003 ● Otwarty dostęp
Cytowania BibTeX
@article{brookes2004subgroup, author={Brookes, Sara T. and Whitely, Elise and Egger, Matthias and Davey Smith, George and Mulheran, Paul A. and Peters, Tim J.}, title={{Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test}}, journal={Journal of Clinical Epidemiology}, year={2004}, volume={57}, number={3}, pages={229--236}, doi={10.1016/j.jclinepi.2003.08.009}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{hopewell2025consort, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081124}, doi={10.1136/bmj-2024-081124}}@article{kasenda2014subgroup, author={Kasenda, B. and Schandelmaier, S. and Sun, X. and von Elm, E. and You, J. and Blumle, A. and Tomonaga, Y. and Saccilotto, R. and Amstutz, A. and Bengough, T. and Meerpohl, J. J. and Stegert, M. and Olu, K. K. and Tikkinen, K. A. O. and Neumann, I. and Carrasco-Labra, A. and Faulhaber, M. and Mulla, S. M. and Mertz, D. and Akl, E. A. and Bassler, D. and Busse, J. W. and Ferreira-Gonzalez, I. and Lamontagne, F. and Nordmann, A. and Gloy, V. and Raatz, H. and Moja, L. and Rosenthal, R. and Ebrahim, S. and Vandvik, P. O. and Johnston, B. C. and Walter, M. A. and Burnand, B. and Schwenkglenks, M. and Hemkens, L. G. and Bucher, H. C. and Guyatt, G. H. and Briel, M.}, title={{Subgroup analyses in randomised controlled trials: Cohort study on trial protocols and journal publications}}, journal={BMJ}, year={2014}, volume={349}, eid={g4539}, doi={10.1136/bmj.g4539}}@article{kent2020predictive, author={Kent, David M. and Paulus, Jessica K. and van Klaveren, David and D'Agostino, Ralph and Goodman, Steve and Hayward, Rodney and Ioannidis, John P. A. and Patrick-Lake, Bray and Morton, Sally and Pencina, Michael and Raman, Gowri and Ross, Joseph S. and Selker, Harry P. and Varadhan, Ravi and Vickers, Andrew and Wong, John B. and Steyerberg, Ewout W.}, title={{The Predictive Approaches to Treatment effect Heterogeneity (PATH) statement}}, journal={Annals of Internal Medicine}, year={2020}, volume={172}, number={1}, pages={35--45}, doi={10.7326/m18-3667}}@article{knol2012recommendations, author={Knol, Mirjam J. and VanderWeele, Tyler J.}, title={{Recommendations for presenting analyses of effect modification and interaction}}, journal={International Journal of Epidemiology}, year={2012}, volume={41}, number={2}, pages={514--520}, doi={10.1093/ije/dyr218}}@article{schandelmaier2020development, author={Schandelmaier, Stefan and Briel, Matthias and Varadhan, Ravi and Schmid, Christopher H. and Devasenapathy, Niveditha and Hayward, Rodney A. and Gagnier, Joel and Borenstein, Michael and van der Heijden, Geert J. M. G. and Dahabreh, Issa J. and Sun, Xin and Sauerbrei, Willi and Walsh, Michael and Ioannidis, John P. A. and Thabane, Lehana and Guyatt, Gordon H.}, title={{Development of the Instrument to assess the Credibility of Effect Modification Analyses (ICEMAN) in randomized controlled trials and meta-analyses}}, journal={Canadian Medical Association Journal}, year={2020}, volume={192}, number={32}, pages={E901--E906}, doi={10.1503/cmaj.200077}}@article{sun2012credibility, author={Sun, X. and Briel, M. and Busse, J. W. and You, J. J. and Akl, E. A. and Mejza, F. and Bala, M. M. and Bassler, D. and Mertz, D. and Diaz-Granados, N. and Vandvik, P. O. and Malaga, G. and Srinathan, S. K. and Dahm, P. and Johnston, B. C. and Alonso-Coello, P. and Hassouneh, B. and Walter, S. D. and Heels-Ansdell, D. and Bhatnagar, N. and Altman, D. G. and Guyatt, G. H.}, title={{Credibility of claims of subgroup effects in randomised controlled trials: Systematic review}}, journal={BMJ}, year={2012}, volume={344}, eid={e1553}, doi={10.1136/bmj.e1553}}@article{wang2007statistics, author={Wang, Rui and Lagakos, Stephen W. and Ware, James H. and Hunter, David J. and Drazen, Jeffrey M.}, title={{Statistics in medicine – Reporting of subgroup analyses in clinical trials}}, journal={New England Journal of Medicine}, year={2007}, volume={357}, number={21}, pages={2189--2194}, doi={10.1056/nejmsr077003}}