Co to są ARR i RRR?
ARR (ang. absolute risk reduction, bezwzględna redukcja ryzyka) to różnica ryzyka zdarzenia między grupą kontrolną a grupą interwencji. RRR (ang. relative risk reduction, względna redukcja ryzyka) mówi, o jaką część ryzyka wyjściowego zmniejszyła się częstość zdarzenia. Gdy interwencja ryzyko zwiększa, te same wzory dają bezwzględny i względny wzrost ryzyka (ARI, RRI).
ARR = CER − EER, RRR = ARR / CER = 1 − RR
CER to odsetek zdarzeń w grupie kontrolnej, a EER – w grupie interwencji. ARR podaje się w punktach procentowych, RRR – w procentach ryzyka wyjściowego. Odwrotność ARR to NNT.
Dlaczego potrzebne są obie miary
Spadek ryzyka z 20% do 15% i z 2% do 1.5% to w obu przypadkach RRR = 25%. W pierwszym ARR wynosi jednak 5 punktów procentowych (NNT = 20), a w drugim 0.5 punktu (NNT = 200). Gigerenzer i in. (2007) opisują, że nieprzejrzyste podawanie danych w postaci samego RRR wprowadza w błąd lekarzy, pacjentów i dziennikarzy: „25% mniej zgonów” w badaniach przesiewowych oznaczało jeden zgon mniej na 1000 kobiet. Cook i Sackett (1995) zwracają uwagę, że przy stałej RRR korzyść bezwzględną można przeliczyć dla osoby o innym ryzyku wyjściowym.
Przykład
W badaniu z losowym przydziałem (dane symulowane, po 250 osób) nawrót depresji w ciągu roku wystąpił u 59 osób z grupy kontrolnej (23.6%) i u 37 z grupy terapii (14.8%). ARR = 8.8 punktu procentowego, 95% CI [1.9, 15.7], a RRR = 37.3%, 95% CI [9.0, 56.8]. NNT = 11.4: około 12 leczonych na jeden uniknięty nawrót.
Na rysunku
Rysunek pokazuje przykład z części „Dlaczego potrzebne są obie miary” (20% → 15% i 2% → 1.5%) obok wyniku badania z przykładu. Wszystkie panele mają tę samą oś pionową, więc wysokość słupków można porównywać między nimi.
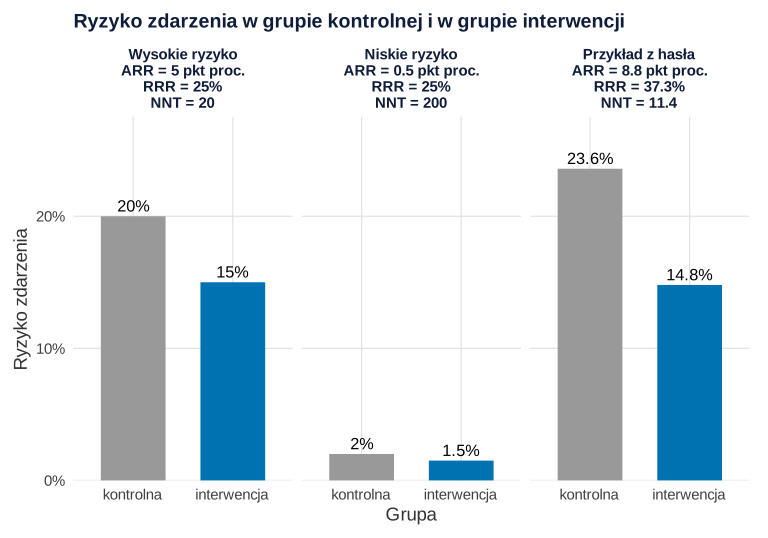
set.seed(519)).Co widać. W obu lewych panelach słupek interwencji jest o jedną czwartą niższy niż słupek grupy kontrolnej – to RRR = 25%. Różnica wysokości jest jednak dziesięć razy większa przy wysokim ryzyku: 5 punktów procentowych, czyli 50 zdarzeń mniej na 1000 leczonych, wobec 0.5 punktu, czyli 5 zdarzeń mniej na 1000. Przy niskim ryzyku słupki ledwo odrywają się od zera, a NNT rośnie z 20 do 200. Badanie z przykładu ma większą RRR (37.3%) i wysokie ryzyko wyjściowe, więc daje 88 nawrotów mniej na 1000 leczonych.
Na co uważać. Słupki pokazują same oszacowania – nie ma na nich przedziałów ufności, które w przykładzie są szerokie (ARR od 1.9 do 15.7 punktu). Lewe panele to wartości przyjęte do ilustracji, nie wynik badania. Przy bardzo rzadkich zdarzeniach słupki na wspólnej osi stają się nieczytelne; wtedy lepiej podać liczby na 1000 osób niż zmieniać skalę osi w jednym panelu, bo taka zmiana ukryłaby właśnie różnicę ARR. Jak NNT zmienia się płynnie z ryzykiem wyjściowym przy stałej RRR, pokazuje rysunek w haśle NNT.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: prosty motyw i paletę definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Kod losuje raz, z ziarnem set.seed(519) z przykładu hasła; ziarna nie zmieniano.
Kod R rysunku 1
# Rysunek 1. Ta sama względna redukcja ryzyka (RRR), różna bezwzględna (ARR)
library(ggplot2)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), panel.grid.major.x = element_blank(),
        legend.position = "bottom", plot.title = element_text(face = "bold"),
        strip.text = element_text(face = "bold"))
kolory <- c("kontrolna" = "grey60", "interwencja" = "#0072B2")   # Okabe–Ito + szary

set.seed(519)                                     # badanie z przykładu hasła, 2 × 250 osób
x_k <- rbinom(1, 250, 0.24); x_i <- rbinom(1, 250, 0.16)

scen <- data.frame(populacja = c("Wysokie ryzyko", "Niskie ryzyko", "Przykład z hasła"),
                   CER = c(0.20, 0.02, x_k / 250), EER = c(0.15, 0.015, x_i / 250))
scen$ARR <- scen$CER - scen$EER; scen$RRR <- scen$ARR / scen$CER; scen$NNT <- 1 / scen$ARR
scen$na_1000 <- 1000 * scen$ARR                   # zdarzeń mniej na 1000 leczonych
print(cbind(scen[1], round(scen[-1], 3)), row.names = FALSE)

l1 <- function(x) sub("\\.0$", "", sprintf("%.1f", x))   # jedno miejsce po kropce, bez „.0”
opis <- sprintf("%s\nARR = %s pkt proc.\nRRR = %s%%\nNNT = %s", scen$populacja,
                l1(100 * scen$ARR), l1(100 * scen$RRR), l1(scen$NNT))
scen$panel <- factor(opis, levels = opis)
dl <- data.frame(panel = rep(scen$panel, 2),
                 grupa = factor(rep(c("kontrolna", "interwencja"), each = 3), c("kontrolna", "interwencja")),
                 ryzyko = c(scen$CER, scen$EER))
dl$etykieta <- paste0(l1(100 * dl$ryzyko), "%")

p1 <- ggplot(dl, aes(grupa, ryzyko, fill = grupa)) +
  geom_col(width = 0.65) +
  geom_text(aes(label = etykieta), vjust = -0.4, size = 4.3) +
  facet_wrap(~ panel) +
  scale_fill_manual(values = kolory, guide = "none") +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.27),
                     expand = expansion(mult = c(0, 0.02))) +
  labs(title = "Ryzyko zdarzenia w grupie kontrolnej i w grupie interwencji",
       x = "Grupa", y = "Ryzyko zdarzenia") + motyw
p1   # zapis: ggsave("arr-i-rrr-redukcja-ryzyka-ta-sama-rrr.svg", p1, width = 8, height = 5.6)
Wynik w R
        populacja   CER   EER   ARR   RRR     NNT na_1000
   Wysokie ryzyko 0.200 0.150 0.050 0.250  20.000      50
    Niskie ryzyko 0.020 0.015 0.005 0.250 200.000       5
 Przykład z hasła 0.236 0.148 0.088 0.373  11.364      88
Jak opisać w pracy
CONSORT 2025 zaleca przy wyniku binarnym podawać miarę względną i bezwzględną z 95% CI, bo samo ryzyko względne prowadzi do przeceniania efektu (Hopewell i in., 2025).
Na co uważać
- Procent a punkty procentowe. „Spadek o 37%” i „o 8.8 punktu” opisują ten sam wynik.
- RRR z ilorazu szans. 1 − OR nie jest RRR; przy częstym zdarzeniu iloraz szans zawyża efekt.
- Horyzont czasowy. ARR po roku i po pięciu latach to różne liczby – zawsze go podaj.
- Szkody. Działania niepożądane opisuje NNH.
ARR i RRR w R
Funkcja miary() pokazuje dwa scenariusze o tej samej RRR i różnym ryzyku wyjściowym. Dalej kod tworzy dane badania z przykładu i liczy ARR z 95% przedziałem ufności Walda oraz RRR z przedziałem wyznaczonym na skali logarytmu RR. Liczby w tekście pochodzą z tego kodu.
ARR, RRR i NNT z przedziałami ufności
R
miary <- function(cer, eer) c(CER = cer, EER = eer, ARR = cer - eer,
                             RR = eer / cer, RRR = 1 - eer / cer, NNT = 1 / (cer - eer))
round(rbind(wysokie_ryzyko = miary(0.20, 0.15), niskie_ryzyko = miary(0.02, 0.015)), 3)
set.seed(519)                                     # badanie z losowym przydziałem, 2 × 250 osób
x_k <- rbinom(1, 250, 0.24); x_i <- rbinom(1, 250, 0.16)  # nawrót w grupie kontrolnej i interwencji
cer <- x_k / 250; eer <- x_i / 250
se_arr <- sqrt(cer * (1 - cer) / 250 + eer * (1 - eer) / 250)
se_lnrr <- sqrt(1 / x_i - 1 / 250 + 1 / x_k - 1 / 250)
round(c(x_k = x_k, x_i = x_i, CER = cer, EER = eer,
        ARR = cer - eer, ARR_dolna = cer - eer - 1.96 * se_arr, ARR_gorna = cer - eer + 1.96 * se_arr,
        NNT = 1 / (cer - eer), RRR = 1 - eer / cer, RRR_dolna = 1 - exp(log(eer / cer) + 1.96 * se_lnrr),
        RRR_gorna = 1 - exp(log(eer / cer) - 1.96 * se_lnrr)), 3)
Wynik w R
                CER   EER   ARR   RR  RRR NNT
wysokie_ryzyko 0.20 0.150 0.050 0.75 0.25  20
niskie_ryzyko  0.02 0.015 0.005 0.75 0.25 200
      x_k       x_i       CER       EER       ARR ARR_dolna ARR_gorna       NNT
   59.000    37.000     0.236     0.148     0.088     0.019     0.157    11.364
      RRR RRR_dolna RRR_gorna
    0.373     0.090     0.568
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć RRR, gdy znam ryzyko względne?
RRR = 1 − RR. Przy RR = 0.75 względna redukcja ryzyka wynosi 25%. Do ARR potrzebujesz jeszcze ryzyka w grupie kontrolnej: ARR = CER × RRR.
Dlaczego samo RRR może wprowadzać w błąd?
RRR daje duże, przekonujące liczby także przy rzadkich zdarzeniach. Spadek ryzyka z 2% do 1.5% to RRR 25%, ale ARR tylko 0.5 punktu procentowego, czyli NNT = 200.
Czy ARR to to samo co różnica ryzyka?
Tak, ARR to różnica ryzyka liczona jako ryzyko w grupie kontrolnej minus ryzyko w grupie interwencji. Gdy wynik jest ujemny, interwencja zwiększa ryzyko (ARI).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Standaryzacja (g-computation): różnica ryzyk
Od ilorazu szans do różnicy ryzyk i RR: standaryzacja w R, bootstrap i metoda delta, ATE i ATT, nieskładalność OR i porównanie z IPW.
Czytaj →PoradnikStatystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cook, R. J., & Sackett, D. L. (1995). The number needed to treat: A clinically useful measure of treatment effect. BMJ, 310(6977), 452–454. https://doi.org/10.1136/bmj.310.6977.452 ● Otwarty dostęp: pełny tekst
- Gigerenzer, G., Gaissmaier, W., Kurz-Milcke, E., Schwartz, L. M., & Woloshin, S. (2007). Helping doctors and patients make sense of health statistics. Psychological Science in the Public Interest, 8(2), 53–96. https://doi.org/10.1111/j.1539-6053.2008.00033.x ● Otwarty dostęp
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials. BMJ, 389, Article e081124. https://doi.org/10.1136/bmj-2024-081124 ● Otwarty dostęp
Cytowania BibTeX
@article{cook1995number, author={Cook, Richard J. and Sackett, David L.}, title={{The number needed to treat: A clinically useful measure of treatment effect}}, journal={BMJ}, year={1995}, volume={310}, number={6977}, pages={452--454}, doi={10.1136/bmj.310.6977.452}}@article{gigerenzer2007helping, author={Gigerenzer, Gerd and Gaissmaier, Wolfgang and Kurz-Milcke, Elke and Schwartz, Lisa M. and Woloshin, Steven}, title={{Helping doctors and patients make sense of health statistics}}, journal={Psychological Science in the Public Interest}, year={2007}, volume={8}, number={2}, pages={53--96}, doi={10.1111/j.1539-6053.2008.00033.x}}@article{hopewell2025consort, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081124}, doi={10.1136/bmj-2024-081124}}