Iloraz szans nie mówi, o ile spadnie ryzyko
Dopasowałeś regresję logistyczną z ekspozycją i zakłócaczami, w tabeli stoi OR = 0.53. Recenzent pyta: „O ile punktów procentowych program zmniejsza ryzyko nawrotu w badanej populacji?”. Współczynnik modelu na to nie odpowie. Iloraz szans jest warunkowy (dotyczy osób o tych samych wartościach zmiennych w modelu) i mierzy zmianę w skali szans, a czytelnik pyta o różnicę ryzyk w całej populacji.
Odpowiedź daje standaryzacja, nazywana też g-computation albo parametryczną g-formułą. Hasło w słowniku podaje definicję i założenia. Tu przechodzimy przez pełną analizę kohorty: od modelu do różnicy ryzyk, ryzyka względnego i NNT, z przedziałami ufności, wyborem estymandy (ATE czy ATT), liczbowym pokazem nieskładalności ilorazu szans i porównaniem z wagami IPW.
Standaryzacja w trzech krokach
Procedura jest prosta, a Snowden i in. (2011) pokazują ją krok po kroku na danych symulowanych, porównując z klasyczną regresją:
- Model wyniku. Dopasuj regresję logistyczną wyniku na ekspozycję A i zmienne zakłócające, łącznie z interakcjami, jeśli efekt może zależeć od cech osoby.
- Dwa światy kontrfaktyczne. Skopiuj dane dwa razy. W pierwszej kopii ustaw A = 1 u wszystkich, w drugiej A = 0. Dla każdej osoby policz przewidywane ryzyko w obu wersjach.
- Uśrednij. Średnia predykcji w pierwszej kopii to ryzyko „gdyby wszyscy byli leczeni”, w drugiej – „gdyby nikt nie był leczony”. Ich różnica to różnica ryzyk, iloraz – ryzyko względne.
W języku modelu potencjalnych wyników szacujesz E[Y1] i E[Y0]. Naimi i in. (2017) zaliczają tę procedurę do metod g Robinsa, które dają zgodne oszacowania kontrastów potencjalnych wyników przy łagodniejszych warunkach niż zwykła regresja. Warunki pozostają jednak poważne: brak niezmierzonego zakłócenia, dodatniość (w każdej warstwie zakłócaczy są osoby leczone i nieleczone) i poprawny model wyniku.
Rachunek jest taki sam jak przy przeciętnym efekcie krańcowym (AME) dla predyktora binarnego. Różnica leży w punkcie wyjścia. Przy AME opisujesz model, a przy standaryzacji najpierw nazywasz estymandę przyczynową i dobierasz zakłócacze, np. na grafie przyczynowym, a dopiero potem budujesz model. Zmienne kontrolne służą wtedy tylko do standaryzacji. Ich współczynników nie interpretujesz, o czym pisze wpis o błędzie tabeli 2.
Przykład: program zapobiegania nawrotom depresji
Symulowana kohorta liczy 3000 osób po leczeniu pierwszego epizodu depresji. 1401 osób trafiło do grupowego programu zapobiegania nawrotom, a w ciągu 12 miesięcy nawrót wystąpił u 675 osób. Do programu częściej kierowano osoby z cięższymi objawami, wcześniejszymi epizodami i młodsze. To klasyczne zakłócenie wskazaniem. W symulacji znamy prawdę: w populacji program obniża ryzyko z 0.310 do 0.180, czyli o 0.129 (ATE), a wśród osób, które do niego trafiły – o 0.164 (ATT).
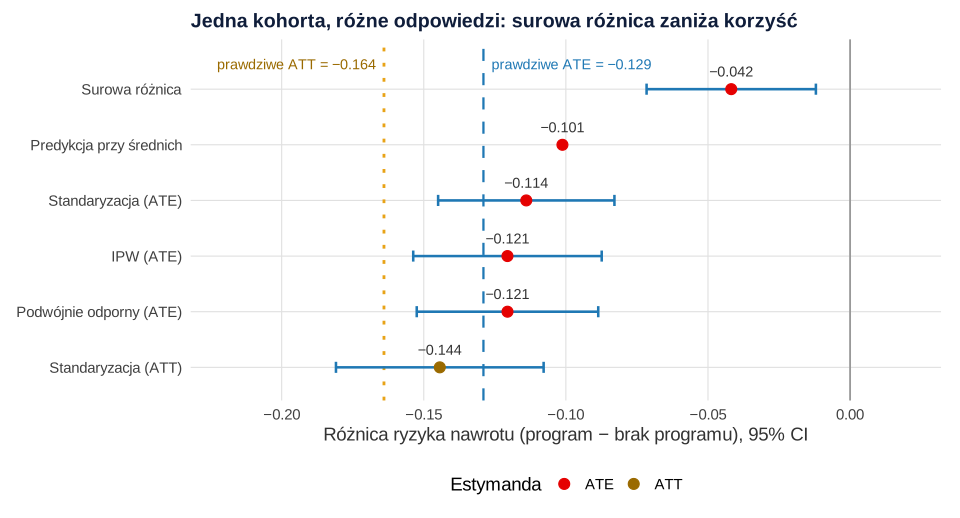
Surowe ryzyko nawrotu wynosiło 0.203 w programie i 0.245 poza nim. Surowa różnica −0.042 pokazuje około jednej trzeciej korzyści, bo do programu trafiali pacjenci z gorszym rokowaniem. Model wyniku zawierał program, nasilenie objawów na starcie (z), wcześniejsze epizody, wiek oraz interakcję programu z objawami.
| Wielkość | Oszacowanie | Co oznacza |
|---|---|---|
| Surowa różnica ryzyk | −0.042 | porównanie grup bez korekty zakłócenia |
| OR dla programu z modelu | 0.527 [0.426, 0.653] | warunkowy OR dla osoby o przeciętnym nasileniu objawów |
| Ryzyko: wszyscy w programie / nikt | 0.178 / 0.292 | standaryzacja do całej kohorty |
| RD (ATE) | −0.114 [−0.145, −0.082] | 11.4 punktu procentowego mniej nawrotów; NNT = 8.8 |
| RR (ATE) | 0.610 [0.531, 0.702] | ryzyko niższe o 39% |
| OR brzegowy (ATE) | 0.526 | OR dla całej populacji, nie dla osoby |
| RD (ATT) | −0.144 [−0.181, −0.107] | efekt wśród osób, które trafiły do programu |
| Predykcja „przy średnich” | −0.101 | efekt dla fikcyjnej osoby z 0.4 epizodu |
Przedziały w tabeli pochodzą z bootstrapu percentylowego (1000 replikacji). Standaryzowana różnica −0.114 jest blisko prawdziwej wartości −0.129, a surowa różnica – daleko od niej. Przekład na ARR i RRR jest bezpośredni: bezwzględna redukcja ryzyka to 11.4 punktu procentowego, względna – 39%.
Ostatni wiersz pokazuje częsty skrót: predykcję dla „przeciętnej osoby” z średnimi wartościami wszystkich zmiennych. Muller i MacLehose (2014) wykazali, że każda z tych metod odpowiada innej populacji docelowej. Tylko standaryzacja brzegowa uogólnia na całą populację, a predykcja przy średnich przy zmiennych binarnych opisuje warstwę bez żadnych prawdziwych osób. Tu dała −0.101 dla kogoś, kto ma „0.4 wcześniejszego epizodu”. Hanmer i Kalkan (2013) z tego samego powodu zalecają liczenie efektów na wartościach obserwowanych.
Przedział ufności: bootstrap czy metoda delta
Standaryzowane ryzyko jest nieliniową funkcją współczynników modelu, więc błąd standardowy trzeba wyprowadzić. Masz dwie drogi.
- Bootstrap. Losujesz osoby ze zwracaniem, w każdej replikacji dopasowujesz model od nowa i powtarzasz standaryzację. To podejście uwzględnia niepewność całej procedury, ale wymaga czasu przy dużych modelach. W przykładzie: RD = −0.114, SE = 0.016, 95% CI [−0.145, −0.082].
- Metoda delta. Funkcja
avg_comparisons()z pakietu marginaleffects (Arel-Bundock i in., 2024) liczy tę samą średnią różnicę predykcji i jej błąd standardowy z macierzy kowariancji współczynników. Wynik: −0.114, SE = 0.0158, 95% CI [−0.145, −0.083]. Dla RR z argumentemcomparison = "lnratioavg": 0.61 [0.531, 0.701].
Przy kilku tysiącach obserwacji obie metody dają praktycznie to samo. Bootstrap wybierz, gdy próba jest mała, wynik rzadki albo model zawiera kroki, których metoda delta nie widzi (np. wcześniejszą selekcję zmiennych lub imputację). Przy ilorazach (RR, OR brzegowy) licz przedział na skali logarytmicznej, jak robi to lnratioavg.
ATE czy ATT: kogo standaryzujesz
Standaryzacja wymaga wskazania populacji, po której uśredniasz predykcje. Wybór populacji to wybór estymandy.
- ATE – uśredniasz po całej kohorcie. Odpowiada na pytanie: co by było, gdyby program zaproponować wszystkim?
- ATT – uśredniasz tylko po osobach, które były w programie (
newdata = subset(d, A == 1)). Odpowiada na pytanie: ile zyskali ci, którzy rzeczywiście w nim byli? - ATC – uśredniasz po nieleczonych. Pytanie: co by dało rozszerzenie programu na osoby, które go nie dostały?
W przykładzie ATT (−0.144) jest wyraźnie większe niż ATE (−0.114). W symulacji program działał silniej przy cięższych objawach, a takie osoby częściej do niego trafiały. Jeśli efekt nie zależy od cech osoby w skali, w której go mierzysz, ATE i ATT są zbliżone. Przy zmiennym efekcie różnią się i trzeba wybrać, o którą wielkość pytasz. Decyzja należy do pytania badawczego, nie do oprogramowania. Ta sama logika obowiązuje przy dopasowaniu i ważeniu propensity score, gdzie wagi dla ATE i ATT też są różne.
Nieskładalność ilorazu szans: OR warunkowy ≠ OR brzegowy
Dlaczego nie wystarczy podać OR z modelu, skoro przy rzadkim wyniku jest bliski RR? Bo iloraz szans jest nieskładalny (ang. noncollapsible). OR brzegowy, uśredniony po populacji, różni się od OR warunkowego nawet wtedy, gdy w danych nie ma żadnego zakłócenia. Greenland i in. (1999) podkreślają, że nieskładalność trzeba odróżniać od zakłócenia. Mood (2010) opisuje praktyczną konsekwencję: w regresji logistycznej współczynnik ekspozycji zmienia się po dodaniu zmiennej, która wpływa na wynik, nawet gdy ta zmienna nie jest skorelowana z ekspozycją.
Prosta symulacja: badanie z losowym przydziałem (20 000 osób), silny czynnik rokowniczy L i prawdziwy OR = 0.50 w każdej warstwie L. Randomizacja wyklucza zakłócenie, a mimo to:
- OR z modelu bez L wynosi 0.606, a z L – 0.517. Obie liczby są poprawne, tylko odpowiadają na różne pytania;
- standaryzacja z modelu z L daje OR brzegowy 0.619, a różnicę ryzyk −0.097, prawie tyle samo co porównanie surowe (−0.101). Różnica ryzyk jest składalna: średnia efektów w warstwach równa się efektowi w populacji;
- w kwartylach L OR jest stale bliski 0.5 (od 0.489 do 0.554), a RD rośnie od −0.030 w najlepszym rokowaniu do −0.149 i −0.137 w dwóch najgorszych.
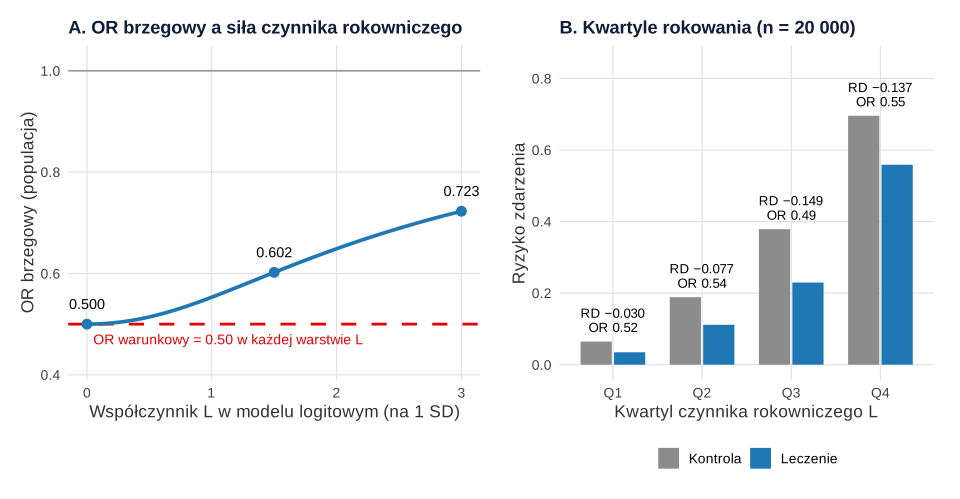
Im silniejszy czynnik rokowniczy, tym bardziej OR brzegowy oddala się od warunkowego. Przy współczynniku 1.5 na SD wynosi 0.602, a przy 3 już 0.723. Wynikają z tego trzy wnioski:
- OR z modeli z różnymi zmiennymi kontrolnymi albo z różnych badań nie są wprost porównywalne;
- „spadek OR po dodaniu zmiennej” nie dowodzi zakłócenia;
- jeśli chcesz porównywać lub łączyć wyniki, raportuj RD lub RR ze standaryzacji, bo te miary nie zależą od tego, ile prognostycznych zmiennych trafiło do modelu.
Podobne rozróżnienie efektu brzegowego i warunkowego opisuje wpis GEE czy model mieszany, tam w kontekście danych klastrowanych.
Standaryzacja, IPW i estymator podwójnie odporny
Standaryzacja modeluje wynik. Wagi IPW modelują przydział: osoba dostaje wagę 1/P(otrzymanej ekspozycji), a różnicę ryzyk liczysz w próbie ważonej. Austin i Stuart (2015) zalecają przy tym sprawdzenie równowagi zmiennych po ważeniu. W kohorcie wagi z pakietu WeightIt wynosiły od 1.02 do 19.53, a efektywna liczebność spadła z 1599 do 1180 w grupie bez programu i z 1401 do 954 w programie. IPW dało RD = −0.121, 95% CI [−0.154, −0.087], z błędem standardowym uwzględniającym oszacowanie wag.
Estymator podwójnie odporny łączy oba modele i pozostaje zgodny, gdy poprawny jest choć jeden z nich (Funk i in., 2011). Jedna z wersji to standaryzacja z modelu wyniku dopasowanego z wagami IPW. W przykładzie dała −0.121, 95% CI [−0.152, −0.089]. Inne odmiany to AIPW i TMLE.
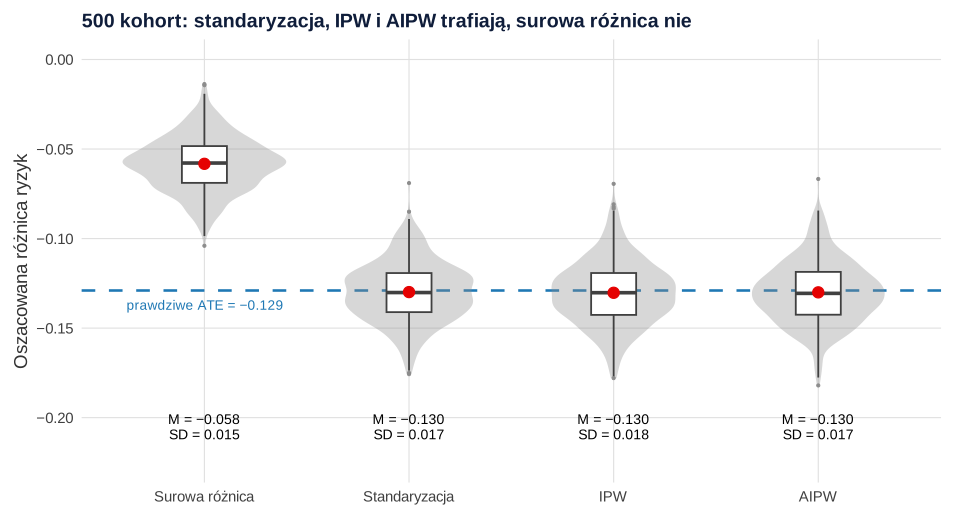
Analizowana kohorta to jedna z wielu możliwych prób. W 500 powtórzeniach tego samego mechanizmu standaryzacja, IPW i AIPW dawały średnio −0.130 przy prawdziwym ATE −0.129. SD oszacowań wynosiło 0.017, 0.018 i 0.017, a surowa różnica była obciążona o 0.071. W 16.2% powtórzeń standaryzacja dała wynik jeszcze bliższy zeru niż −0.114 z naszej kohorty, więc ten wynik mieści się w zwykłym rozrzucie próbkowym. Którą metodę wybrać?
- Standaryzacja – gdy dobrze znasz mechanizm wyniku i grupy dobrze się nakładają. Zwykle daje przedziały nie szersze niż IPW, ale cała odpowiedzialność spoczywa na modelu wyniku.
- IPW – gdy łatwiej opisać, kto dostaje ekspozycję, niż od czego zależy wynik. Skrajne wagi zdradzają problem z dodatniością.
- Podwójnie odporny – jako analiza główna albo analiza wrażliwości, gdy nie ufasz w pełni żadnemu z modeli. Nie chroni jednak przed niezmierzonym zakłóceniem. Tu pomaga E-wartość.
Jak opisać standaryzację w artykule
Podaj estymandę (ATE czy ATT, różnica czy iloraz ryzyk), model wyniku z listą zmiennych i uzasadnieniem ich wyboru, sposób liczenia przedziału oraz surową różnicę obok skorygowanej. OR z modelu możesz dodać w tabeli, ale nie jako główną miarę efektu.
Jeśli recenzent prosi o przeliczenie ilorazów szans na różnice ryzyk albo o analizę wrażliwości z wagami, możemy przygotować ją wspólnie w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (trzeci korzysta z danych i funkcji z pierwszego). Pierwszy zapisuje dane kohorty do pliku standaryzacja-kohorta.csv (możesz go pobrać tutaj). Całość liczy się kilkanaście sekund. Potrzebne pakiety: boot, marginaleffects i WeightIt.
1. Standaryzacja z modelu logistycznego: RD, RR, ATE i ATT
R
# Krok 1. Standaryzacja (g-computation): od modelu logistycznego do różnicy ryzyk (dane symulowane)
# Kohorta 3000 osób po pierwszym leczeniu depresji. A = udział w grupowym programie zapobiegania nawrotom,
# Y = nawrót w ciągu 12 miesięcy. Do programu częściej kierowano osoby z cięższymi objawami (zakłócenie wskazaniem).
library(boot)
library(marginaleffects)
generuj <- function(n) {
  objawy <- rnorm(n)                                  # nasilenie objawów na starcie (z)
  epizody <- rbinom(n, 1, 0.4)                        # wcześniejsze epizody (0/1)
  wiek <- round(pmin(pmax(rnorm(n, 45, 13), 18), 80))
  A <- rbinom(n, 1, plogis(-0.4 + 0.9 * objawy + 0.6 * epizody - 0.04 * (wiek - 45)))
  lp0 <- -1.3 + 0.9 * objawy + 0.8 * epizody + 0.03 * (wiek - 45)   # logit ryzyka bez programu
  lp1 <- lp0 - 0.7 - 0.4 * objawy                                   # program działa silniej przy cięższych objawach
  Y <- rbinom(n, 1, plogis(ifelse(A == 1, lp1, lp0)))
  data.frame(objawy = round(objawy, 3), epizody, wiek, A, Y, p1 = plogis(lp1), p0 = plogis(lp0))
}
# Prawdziwe wartości z populacji 10^6 osób (znane tylko w symulacji)
set.seed(1)
pop <- generuj(1e6)
prawda <- c(ryzyko_1 = mean(pop$p1), ryzyko_0 = mean(pop$p0), RD_ATE = mean(pop$p1 - pop$p0),
            RR_ATE = mean(pop$p1) / mean(pop$p0), RD_ATT = mean((pop$p1 - pop$p0)[pop$A == 1]))
round(prawda, 3)

set.seed(3581)
d <- generuj(3000)[, 1:5]
write.csv(d, "standaryzacja-kohorta.csv", row.names = FALSE)
c(n = nrow(d), w_programie = sum(d$A), nawroty = sum(d$Y))
# Surowe ryzyka i surowa różnica
tapply(d$Y, d$A, mean)
round(mean(d$Y[d$A == 1]) - mean(d$Y[d$A == 0]), 3)

# Model wyniku: regresja logistyczna z interakcją programu i objawów
m <- glm(Y ~ A * objawy + epizody + wiek, family = binomial, data = d)
round(exp(cbind(OR = coef(m), confint.default(m))), 3)

# Standaryzacja: każdej osobie przypisz A = 1, potem A = 0, przewiduj ryzyko i uśrednij
g_comp <- function(dane, model, kto = rep(TRUE, nrow(dane))) {
  r1 <- mean(predict(model, transform(dane[kto, ], A = 1), type = "response"))
  r0 <- mean(predict(model, transform(dane[kto, ], A = 0), type = "response"))
  c(ryzyko_1 = r1, ryzyko_0 = r0, RD = r1 - r0, RR = r1 / r0, OR_brzegowy = (r1 / (1 - r1)) / (r0 / (1 - r0)))
}
ate <- g_comp(d, m)
att <- g_comp(d, m, kto = d$A == 1)
round(rbind(ATE = ate, ATT = att), 3)
round(1 / -ate[["RD"]], 1)   # NNT: ilu osobom zaproponować program, by uniknąć jednego nawrotu

# Predykcja „przy średnich” (osoba z epizody = 0.4) – inna populacja docelowa niż standaryzacja
srednie <- data.frame(objawy = mean(d$objawy), epizody = mean(d$epizody), wiek = mean(d$wiek))
p_sr <- unname(predict(m, rbind(transform(srednie, A = 1), transform(srednie, A = 0)), type = "response"))
round(c(ryzyko_1 = p_sr[1], ryzyko_0 = p_sr[2], RD = p_sr[1] - p_sr[2]), 3)

# Przedział bootstrapowy: w każdej replikacji model dopasowany od nowa
stat <- function(dane, i) {
  b <- dane[i, ]
  mb <- glm(Y ~ A * objawy + epizody + wiek, family = binomial, data = b)
  c(g_comp(b, mb)[c("RD", "RR")], RD_ATT = g_comp(b, mb, kto = b$A == 1)[["RD"]])
}
set.seed(35811)
bt <- boot(d, stat, R = 1000)
ci <- sapply(1:3, function(k) boot.ci(bt, type = "perc", index = k)$percent[4:5])
round(rbind(oszacowanie = bt$t0, SE = apply(bt$t, 2, sd), dolna = ci[1, ], gorna = ci[2, ]), 3)

# To samo metodą delta: marginaleffects
avg_comparisons(m, variables = "A")                                       # RD, ATE
avg_comparisons(m, variables = "A", comparison = "lnratioavg", transform = "exp")   # RR, ATE
avg_comparisons(m, variables = "A", newdata = subset(d, A == 1))         # RD, ATT
Wynik w R
ryzyko_1 ryzyko_0   RD_ATE   RR_ATE   RD_ATT
   0.180    0.310   -0.129    0.582   -0.164
          n w_programie     nawroty
       3000        1401         675
        0         1
0.2445278 0.2027123
[1] -0.042
               OR 2.5 % 97.5 %
(Intercept) 0.056 0.038  0.083
A           0.527 0.426  0.653
objawy      2.389 2.061  2.767
epizody     2.260 1.875  2.724
wiek        1.034 1.026  1.041
A:objawy    0.715 0.577  0.887
    ryzyko_1 ryzyko_0     RD    RR OR_brzegowy
ATE    0.178    0.292 -0.114 0.610       0.526
ATT    0.203    0.347 -0.144 0.584       0.478
[1] 8.8
ryzyko_1 ryzyko_0       RD
   0.152    0.254   -0.101
                RD    RR RD_ATT
oszacowanie -0.114 0.610 -0.144
SE           0.016 0.044  0.019
dolna       -0.145 0.531 -0.181
gorna       -0.082 0.702 -0.107

 Estimate Std. Error    z Pr(>|z|)    S  2.5 %  97.5 %
   -0.114     0.0158 -7.2   <0.001 40.6 -0.145 -0.0829

Term: A
Type: response
Comparison: 1 - 0


 Estimate Pr(>|z|)    S 2.5 % 97.5 %
     0.61   <0.001 38.1 0.531  0.701

Term: A
Type: response
Comparison: ln(mean(1) / mean(0))


 Estimate Std. Error     z Pr(>|z|)    S  2.5 % 97.5 %
   -0.144     0.0186 -7.74   <0.001 46.6 -0.181 -0.108

Term: A
Type: response
Comparison: 1 - 0
2. Nieskładalność OR w badaniu z randomizacją
R
# Krok 2. Nieskładalność ilorazu szans: randomizacja, brak zakłócenia, a OR warunkowy ≠ OR brzegowy
# Badanie z losowym przydziałem (A ~ 50/50), silny czynnik rokowniczy L (z). Prawdziwy OR warunkowy = 0.50 w każdej warstwie L.
set.seed(3582)
n <- 20000
L <- rnorm(n)
A <- rbinom(n, 1, 0.5)
Y <- rbinom(n, 1, plogis(-1 + log(0.5) * A + 1.5 * L))
d2 <- data.frame(L, A, Y)

m_sur <- glm(Y ~ A, family = binomial, data = d2)        # bez L
m_war <- glm(Y ~ A + L, family = binomial, data = d2)    # z L
std <- function(model) {
  r1 <- mean(predict(model, transform(d2, A = 1), type = "response"))
  r0 <- mean(predict(model, transform(d2, A = 0), type = "response"))
  c(RD = r1 - r0, RR = r1 / r0, OR = (r1 / (1 - r1)) / (r0 / (1 - r0)))
}
round(rbind(OR_surowy = exp(coef(m_sur))["A"], OR_warunkowy = exp(coef(m_war))["A"]), 3)
# Standaryzacja z modelu z L i bez L daje ten sam efekt brzegowy
round(rbind(standaryzacja_bez_L = std(m_sur), standaryzacja_z_L = std(m_war)), 3)

# Ten sam OR = 0.50 w warstwach rokowania, ale różne RD (warstwy: kwartyle L)
war <- cut(L, quantile(L, 0:4 / 4), include.lowest = TRUE, labels = paste0("Q", 1:4))
round(t(sapply(split(d2, war), function(s) {
  r1 <- mean(s$Y[s$A == 1]); r0 <- mean(s$Y[s$A == 0])
  c(ryzyko_0 = r0, ryzyko_1 = r1, RD = r1 - r0, OR = (r1 / (1 - r1)) / (r0 / (1 - r0)))
})), 3)

# Prawdziwy OR brzegowy (całkowanie po rozkładzie L) przy rosnącej sile czynnika rokowniczego
or_brzegowy <- function(beta_L, b0 = -1, or_war = 0.5) {
  r <- function(a) integrate(function(l) plogis(b0 + log(or_war) * a + beta_L * l) * dnorm(l), -Inf, Inf)$value
  (r(1) / (1 - r(1))) / (r(0) / (1 - r(0)))
}
sila <- c(0, 0.5, 1, 1.5, 2, 3)
round(data.frame(beta_L = sila, OR_war_L_na_SD = exp(sila), OR_brzegowy = sapply(sila, or_brzegowy)), 3)
Wynik w R
                 A
OR_surowy    0.606
OR_warunkowy 0.517
                        RD    RR    OR
standaryzacja_bez_L -0.101 0.697 0.606
standaryzacja_z_L   -0.097 0.708 0.619
   ryzyko_0 ryzyko_1     RD    OR
Q1    0.065    0.035 -0.030 0.520
Q2    0.189    0.112 -0.077 0.540
Q3    0.379    0.230 -0.149 0.489
Q4    0.696    0.559 -0.137 0.554
  beta_L OR_war_L_na_SD OR_brzegowy
1    0.0          1.000       0.500
2    0.5          1.649       0.514
3    1.0          2.718       0.553
4    1.5          4.482       0.602
5    2.0          7.389       0.649
6    3.0         20.086       0.723
3. IPW, estymator podwójnie odporny i Monte Carlo
R
# Krok 3. Porównanie: standaryzacja, IPW i estymator podwójnie odporny (dane i funkcje z kroku 1)
library(WeightIt)
# IPW: model przydziału do programu, wagi dla ATE
W <- weightit(A ~ objawy + epizody + wiek, data = d, method = "glm", estimand = "ATE")
round(c(min_waga = min(W$weights), max_waga = max(W$weights)), 2)
round(summary(W)$effective.sample.size, 1)
# Model wyniku tylko z A, ważony; SE uwzględnia oszacowanie wag (M-estymacja)
fit_ipw <- glm_weightit(Y ~ A, data = d, weightit = W, family = binomial)
avg_comparisons(fit_ipw, variables = "A")
# Podwójnie odporny: ważony model wyniku z kowariantami + standaryzacja
fit_dr <- glm_weightit(Y ~ A * objawy + epizody + wiek, data = d, weightit = W, family = binomial)
avg_comparisons(fit_dr, variables = "A")

# Monte Carlo: 500 kohort po 3000 osób z tego samego mechanizmu; prawdziwe RD (ATE) = -0.129
estymatory <- function(dd) {
  m  <- glm(Y ~ A * objawy + epizody + wiek, family = binomial, data = dd)
  m1 <- predict(m, transform(dd, A = 1), type = "response")
  m0 <- predict(m, transform(dd, A = 0), type = "response")
  e  <- fitted(glm(A ~ objawy + epizody + wiek, family = binomial, data = dd))
  w  <- ifelse(dd$A == 1, 1 / e, 1 / (1 - e))
  c(surowa = mean(dd$Y[dd$A == 1]) - mean(dd$Y[dd$A == 0]),
    standaryzacja = mean(m1 - m0),
    IPW = weighted.mean(dd$Y[dd$A == 1], w[dd$A == 1]) - weighted.mean(dd$Y[dd$A == 0], w[dd$A == 0]),
    AIPW = mean(m1 - m0 + dd$A * (dd$Y - m1) / e - (1 - dd$A) * (dd$Y - m0) / (1 - e)))
}
set.seed(3583)
mc <- t(replicate(500, estymatory(generuj(3000))))
write.csv(round(mc, 5), "mc-estymatory.csv", row.names = FALSE)
round(rbind(srednia = colMeans(mc), obciazenie = colMeans(mc) - prawda[["RD_ATE"]], SD = apply(mc, 2, sd)), 3)
# Gdzie wypada analizowana kohorta (standaryzacja -0.114) w rozkładzie z powtórzeń
round(mean(mc[, "standaryzacja"] > ate[["RD"]]), 3)
Wynik w R
min_waga max_waga
    1.02    19.53
           Control Treated
Unweighted  1599.0  1401.0
Weighted    1179.9   954.4

 Estimate Std. Error     z Pr(>|z|)    S  2.5 %  97.5 %
   -0.121     0.0169 -7.13   <0.001 39.8 -0.154 -0.0874

Term: A
Type: probs
Comparison: 1 - 0


 Estimate Std. Error    z Pr(>|z|)    S  2.5 %  97.5 %
   -0.121     0.0163 -7.4   <0.001 42.7 -0.152 -0.0886

Term: A
Type: probs
Comparison: 1 - 0

           surowa standaryzacja    IPW   AIPW
srednia    -0.058        -0.130 -0.130 -0.130
obciazenie  0.071         0.000 -0.001 -0.001
SD          0.015         0.017  0.018  0.017
[1] 0.162
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (modele glm() z pakietu stats) z pakietami boot, marginaleffects i WeightIt; rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- WeightIt (wersja 2.1.0): Greifer, N. (2026). WeightIt: Weighting for covariate balance in observational studies (R package version 2.1.0) [Computer software]. https://doi.org/10.32614/CRAN.package.WeightIt
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- OR z modelu opisany jako „ryzyko niższe o 47%”. To iloraz szans, nie ryzyk. Przy częstym wyniku różnica jest duża, a OR jest dodatkowo warunkowy.
- Predykcja dla „przeciętnej osoby” zamiast standaryzacji. Przy zmiennych binarnych taka osoba nie istnieje, a wynik nie dotyczy populacji.
- Brak nazwanej estymandy. ATE i ATT mogą się różnić, jak w przykładzie (−0.114 i −0.144).
- Model wyniku bez interakcji, gdy efekt zależy od cech osoby. Standaryzacja nie naprawi źle określonego modelu.
- Porównywanie OR między modelami jako dowód zakłócenia. Zmiana OR po dodaniu zmiennej prognostycznej może wynikać wyłącznie z nieskładalności.
- Brak sprawdzenia dodatniości. Gdy w części warstw nie ma osób leczonych, model ekstrapoluje. Sprawdź rozkład propensity score, nawet jeśli nie używasz wag.
Najczęstsze pytania
Jak policzyć różnicę ryzyk z regresji logistycznej?
Dopasuj model wyniku z ekspozycją i zakłócaczami, potem dla każdej osoby przewidź ryzyko raz przy ekspozycji, raz bez niej i uśrednij obie predykcje. Różnica średnich to różnica ryzyk, iloraz – ryzyko względne. W R robi to marginaleffects::avg_comparisons(model, variables = "A") albo kilka linii z predict().
Czym różni się g-computation od przeciętnego efektu krańcowego (AME)?
Rachunek jest ten sam: średnia różnica przewidywanych prawdopodobieństw przy zmianie ekspozycji z 0 na 1. Różni się cel. Przy g-computation najpierw nazywasz estymandę przyczynową i dobierasz zakłócacze, np. na grafie DAG, a wynik interpretujesz jako efekt przyczynowy przy założeniu braku niezmierzonego zakłócenia.
Dlaczego OR zmienia się po dodaniu zmiennej, która nie jest zakłócaczem?
Bo iloraz szans jest nieskładalny: OR warunkowy (dla osób o tych samych wartościach zmiennych) różni się od brzegowego, gdy wynik zależy od innych zmiennych. W symulowanym badaniu z randomizacją OR wynosił 0.517 z czynnikiem rokowniczym i 0.606 bez niego, choć zakłócenia nie było. Różnica ryzyk prawie się nie zmieniła (−0.097 i −0.101).
Bootstrap czy metoda delta dla przedziału ufności po standaryzacji?
Przy dużej próbie dają praktycznie to samo: w przykładzie [−0.145, −0.082] z bootstrapu i [−0.145, −0.083] metodą delta. Bootstrap z ponownym dopasowaniem modelu wybierz przy małej próbie, rzadkim wyniku albo dodatkowych krokach analizy, np. imputacji. Przedział dla ryzyka względnego licz na skali logarytmicznej.
Kiedy wybrać standaryzację, a kiedy wagi IPW?
Standaryzacja modeluje wynik i przy poprawnym modelu jest zwykle co najmniej tak precyzyjna jak IPW. Wagi IPW modelują przydział do ekspozycji, a skrajne wagi ujawniają problemy z dodatniością. Gdy nie ufasz w pełni żadnemu modelowi, użyj estymatora podwójnie odpornego, który łączy oba. W przykładzie trzy metody dały −0.114, −0.121 i −0.121.
Powiązane hasła
Przeczytaj też
RR, OR i NNT w pracy dyplomowej
Która miara do którego schematu badania, dlaczego OR różni się od RR przy częstym zdarzeniu, przedziały ufności i NNT przez nieskończoność – z gotowymi zdaniami i przykładem w R.
Czytaj →PoradnikBłąd tabeli 2
Dlaczego współczynniki zmiennych kontrolnych to nie efekty: palenie, nadciśnienie i udar w R, DAG, osobne modele i wzór opisu tabeli w pracy.
Czytaj →PoradnikPropensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikGEE czy model mieszany?
Efekty brzegowe a warunkowe, robocza macierz korelacji, błąd kanapkowy i CR2, braki MCAR i MAR oraz QIC – na jednym przykładzie w R.
Czytaj →Recenzent prosi o różnicę ryzyk zamiast ilorazu szans?
Pomożemy nazwać estymandę, przeliczyć model logistyczny na różnicę ryzyk i RR z poprawnymi przedziałami oraz przygotować analizę wrażliwości z wagami, tak żebyś mógł(a) samodzielnie obronić wyniki przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09 ● Otwarty dostęp
- Austin, P. C., & Stuart, E. A. (2015). Moving towards best practice when using inverse probability of treatment weighting (IPTW) using the propensity score to estimate causal treatment effects in observational studies. Statistics in Medicine, 34(28), 3661–3679. https://doi.org/10.1002/sim.6607 ● Otwarty dostęp
- Funk, M. J., Westreich, D., Wiesen, C., Stürmer, T., Brookhart, M. A., & Davidian, M. (2011). Doubly robust estimation of causal effects. American Journal of Epidemiology, 173(7), 761–767. https://doi.org/10.1093/aje/kwq439 ● Otwarty dostęp
- Greenland, S., Robins, J. M., & Pearl, J. (1999). Confounding and collapsibility in causal inference. Statistical Science, 14(1), 29–46. https://doi.org/10.1214/ss/1009211805 ● Otwarty dostęp
- Hanmer, M. J., & Kalkan, K. O. (2013). Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models. American Journal of Political Science, 57(1), 263–277. https://doi.org/10.1111/j.1540-5907.2012.00602.x
- Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006 ● Otwarty dostęp: pełny tekst
- Muller, C. J., & MacLehose, R. F. (2014). Estimating predicted probabilities from logistic regression: Different methods correspond to different target populations. International Journal of Epidemiology, 43(3), 962–970. https://doi.org/10.1093/ije/dyu029 ● Otwarty dostęp
- Naimi, A. I., Cole, S. R., & Kennedy, E. H. (2017). An introduction to g methods. International Journal of Epidemiology, 46(2), 756–762. https://doi.org/10.1093/ije/dyw323 ● Otwarty dostęp
- Snowden, J. M., Rose, S., & Mortimer, K. M. (2011). Implementation of G-computation on a simulated data set: Demonstration of a causal inference technique. American Journal of Epidemiology, 173(7), 731–738. https://doi.org/10.1093/aje/kwq472 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{arelbundock2024how, author={Arel-Bundock, Vincent and Greifer, Noah and Heiss, Andrew}, title={{How to interpret statistical models using marginaleffects for R and Python}}, journal={Journal of Statistical Software}, year={2024}, volume={111}, number={9}, pages={1--32}, doi={10.18637/jss.v111.i09}}@article{austin2015moving, author={Austin, Peter C. and Stuart, Elizabeth A.}, title={{Moving towards best practice when using inverse probability of treatment weighting (IPTW) using the propensity score to estimate causal treatment effects in observational studies}}, journal={Statistics in Medicine}, year={2015}, volume={34}, number={28}, pages={3661--3679}, doi={10.1002/sim.6607}}@article{funk2011doubly, author={Funk, Michele Jonsson and Westreich, Daniel and Wiesen, Chris and Stürmer, Til and Brookhart, M. Alan and Davidian, Marie}, title={{Doubly robust estimation of causal effects}}, journal={American Journal of Epidemiology}, year={2011}, volume={173}, number={7}, pages={761--767}, doi={10.1093/aje/kwq439}}@article{greenland1999confounding, author={Greenland, Sander and Robins, James M. and Pearl, Judea}, title={{Confounding and collapsibility in causal inference}}, journal={Statistical Science}, year={1999}, volume={14}, number={1}, pages={29--46}, doi={10.1214/ss/1009211805}}@article{hanmer2013behind, author={Hanmer, Michael J. and Kalkan, Kerem Ozan}, title={{Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models}}, journal={American Journal of Political Science}, year={2013}, volume={57}, number={1}, pages={263--277}, doi={10.1111/j.1540-5907.2012.00602.x}}@article{mood2010logistic, author={Mood, Carina}, title={{Logistic regression: Why we cannot do what we think we can do, and what we can do about it}}, journal={European Sociological Review}, year={2010}, volume={26}, number={1}, pages={67--82}, doi={10.1093/esr/jcp006}}@article{muller2014estimating, author={Muller, Clemma J. and MacLehose, Richard F.}, title={{Estimating predicted probabilities from logistic regression: Different methods correspond to different target populations}}, journal={International Journal of Epidemiology}, year={2014}, volume={43}, number={3}, pages={962--970}, doi={10.1093/ije/dyu029}}@article{naimi2017introduction, author={Naimi, Ashley I. and Cole, Stephen R. and Kennedy, Edward H.}, title={{An introduction to g methods}}, journal={International Journal of Epidemiology}, year={2017}, volume={46}, number={2}, pages={756--762}, doi={10.1093/ije/dyw323}}@article{snowden2011implementation, author={Snowden, Jonathan M. and Rose, Sherri and Mortimer, Kathleen M.}, title={{Implementation of G-computation on a simulated data set: Demonstration of a causal inference technique}}, journal={American Journal of Epidemiology}, year={2011}, volume={173}, number={7}, pages={731--738}, doi={10.1093/aje/kwq472}}