Co to jest model potencjalnych wyników?
Model potencjalnych wyników (ang. potential outcomes framework, model kontrfaktyczny, model przyczynowy Rubina) definiuje efekt przyczynowy jako porównanie dwóch wyników tej samej osoby: Y(1) – wyniku, gdyby otrzymała interwencję, i Y(0) – wyniku, gdyby jej nie otrzymała. Rubin (2005) przypomina, że ujęcie to zaproponował Neyman dla eksperymentów randomizowanych, a później rozszerzono je na badania nierandomizowane (Rubin, 1974). Holland (1986) użył tego modelu do uporządkowania dyskusji o tym, kiedy z danych wolno wyciągać wnioski przyczynowe – czyli o problemie korelacji a przyczynowości.
Podstawowy problem
Każda osoba ma oba potencjalne wyniki, ale obserwujemy tylko jeden – ten, który odpowiada faktycznie otrzymanemu warunkowi. Drugi pozostaje kontrfaktyczny, więc efektu indywidualnego Y(1) − Y(0) nie da się zmierzyć. Szacuje się więc efekty przeciętne: ATE (w całej populacji) albo ATT (u leczonych). Które wyniki zobaczymy, zależy od mechanizmu przydziału (Rubin, 2005). Gdy przydział jest losowy, grupy różnią się tylko interwencją i prosta różnica średnich szacuje ATE – stąd przewaga randomizacji (Rubin, 1974). Gdy uczestnicy nie stosują się do przydziału, analiza ITT szacuje efekt samego przydziału, a nie przyjęcia interwencji.
Założenia w badaniach obserwacyjnych
- SUTVA: wynik osoby nie zależy od przydziału innych, a interwencja ma jedną wersję.
- Wymienialność (brak niezmierzonego zakłócenia): po uwzględnieniu zmierzonych zmiennych zakłócających przydział jest niezależny od potencjalnych wyników.
- Dodatniość: każda osoba ma niezerową szansę trafienia do obu grup.
Na tych założeniach opierają się propensity score, wagi IPW i grafy przyczynowe (DAG), które pomagają wybrać zmienne do korekty.
Przykład w R
W symulacji 1000 osób kurs podnosi wynik każdej z nich o 3 punkty (ATE = 3). Przy losowym przydziale różnica średnich wynosi 3.19. Gdy na kurs częściej zapisują się bardziej zmotywowani, ta sama różnica rośnie do 8.40, bo grupy różniły się już przed kursem. Regresja z kontrolą motywacji daje 3.26 – ale tylko dlatego, że w symulacji znamy jedyną zmienną zakłócającą.
Na rysunku
Rysunek pokazuje 12 symulowanych osób, dla których – inaczej niż w prawdziwym badaniu – znamy oba potencjalne wyniki. Tym razem efekt kursu nie jest jednakowy: losowano go ze średnią 3 i SD = 3 punkty. Parametry (12 osób, średnia i rozrzut efektu) ustawiono ręcznie, żeby rysunek był czytelny; ziarna (set.seed(5581)) nie zmieniano.
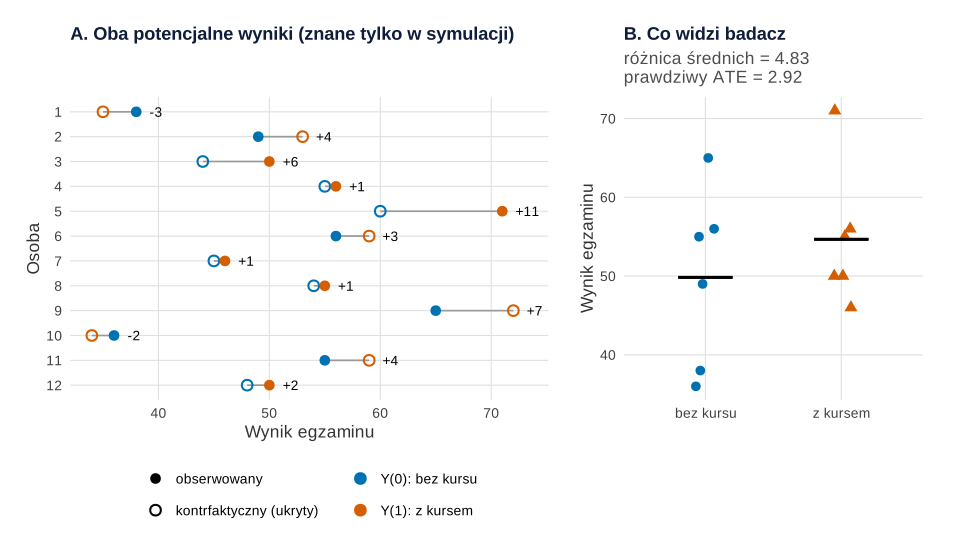
set.seed(5581)).Co widać. W panelu A każda kreska to jedna osoba, a liczba przy niej to jej efekt osobniczy Y(1) − Y(0): od −3 do +11 punktów. Średnia tych efektów to ATE = 2.92. Pełny punkt oznacza wynik, który badacz zobaczy, pusty – wynik kontrfaktyczny. Panel B pokazuje dane badacza: po jednym wyniku na osobę. Różnica średnich grup wynosi 4.83, a nie 2.92. Przydział był losowy, ale przy 6 osobach w grupie przypadek ma duży wpływ: do grupy z kursem trafiła osoba 5, która zyskała 11 punktów.
Na co uważać. Panel A da się narysować tylko w symulacji. W prawdziwych danych z panelu B nie odczytasz, kto zyskał, a kto stracił, więc nie wiesz nawet, czy efekt jest u wszystkich taki sam. Losowanie gwarantuje, że różnica średnich trafia w ATE przeciętnie, w wielu powtórzeniach badania, a nie w każdym z nich. Rozrzut wokół ATE opisuje przedział ufności. Jak losowy przydział wygląda przy różnych liczebnościach, pokazuje wpis losowy przydział w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Oba potencjalne wyniki 12 osób (A) i to, co widzi badacz po losowym przydziale (B)
library(ggplot2)
library(patchwork)

kol <- c("Y(0): bez kursu" = "#0072B2", "Y(1): z kursem" = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(5581)
n <- 12
y0 <- round(rnorm(n, mean = 50, sd = 6))     # wynik bez kursu
efekt <- round(rnorm(n, mean = 3, sd = 3))   # efekt osobniczy: różny u różnych osób
y1 <- y0 + efekt                             # wynik z kursem
a <- sample(rep(0:1, each = n / 2))          # losowy przydział: 6 osób na kurs, 6 bez
tab <- data.frame(osoba = 1:n, y0, y1, efekt, kurs = a, widzimy = ifelse(a == 1, y1, y0))
tab
round(c(ATE = mean(efekt), roznica_srednich = mean(y1[a == 1]) - mean(y0[a == 0])), 2)

# A: pełna „prawda” symulacji – oba wyniki każdej osoby; pełny punkt = wynik obserwowany
dl <- rbind(data.frame(osoba = 1:n, wynik = y0, stan = "Y(0): bez kursu", obs = a == 0),
            data.frame(osoba = 1:n, wynik = y1, stan = "Y(1): z kursem", obs = a == 1))
dl$obs <- factor(ifelse(dl$obs, "obserwowany", "kontrfaktyczny (ukryty)"),
                 c("obserwowany", "kontrfaktyczny (ukryty)"))
pA <- ggplot(dl, aes(wynik, factor(osoba, n:1))) +
  geom_line(aes(group = osoba), colour = "grey60", linewidth = 0.6) +
  geom_point(aes(colour = stan, shape = obs), size = 3, stroke = 1.1) +
  geom_text(data = tab, aes(x = pmax(y0, y1) + 1.2, y = factor(osoba, n:1),
                            label = sprintf("%+d", efekt)), hjust = 0, size = 3.6) +
  scale_colour_manual(NULL, values = kol) +
  scale_shape_manual(NULL, values = c("obserwowany" = 16, "kontrfaktyczny (ukryty)" = 1)) +
  labs(title = "A. Oba potencjalne wyniki (znane tylko w symulacji)",
       x = "Wynik egzaminu", y = "Osoba") + motyw +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))

# B: dane badacza – po jednym wyniku na osobę i średnie grup
db <- data.frame(grupa = factor(ifelse(a == 1, "z kursem", "bez kursu"), c("bez kursu", "z kursem")),
                 wynik = tab$widzimy)
sr <- aggregate(wynik ~ grupa, db, mean)
pB <- ggplot(db, aes(grupa, wynik)) +
  geom_point(aes(colour = grupa, shape = grupa), size = 3,
             position = position_jitter(width = 0.08, height = 0, seed = 1)) +
  geom_errorbar(data = sr, aes(ymin = wynik, ymax = wynik), width = 0.4, linewidth = 1) +
  scale_colour_manual(NULL, values = unname(kol), guide = "none") +
  scale_shape_manual(NULL, values = c(16, 17), guide = "none") +
  labs(title = "B. Co widzi badacz", x = NULL, y = "Wynik egzaminu",
       subtitle = sprintf("różnica średnich = %.2f\nprawdziwy ATE = %.2f",
                          diff(sr$wynik), mean(efekt))) + motyw
p1 <- pA + pB + plot_layout(widths = c(1.6, 1))
p1
Wynik w R
   osoba y0 y1 efekt kurs widzimy
1      1 38 35    -3    0      38
2      2 49 53     4    0      49
3      3 44 50     6    1      50
4      4 55 56     1    1      56
5      5 60 71    11    1      71
6      6 56 59     3    0      56
7      7 45 46     1    1      46
8      8 54 55     1    1      55
9      9 65 72     7    0      65
10    10 36 34    -2    0      36
11    11 55 59     4    0      55
12    12 48 50     2    1      50
             ATE roznica_srednich
            2.92             4.83
Jak opisać w pracy
Potencjalne wyniki w R
Kod tworzy dla każdej osoby oba potencjalne wyniki, a potem „ukrywa” jeden z nich – raz przy losowym przydziale, raz przy samodzielnym wyborze kursu.
Losowanie a samodzielny wybór
R
# Model potencjalnych wyników: każda osoba ma Y(0) i Y(1), widzimy tylko jeden z nich
set.seed(558)
n <- 1000
motywacja <- rnorm(n)                          # cecha wpływająca na wynik i na wybór kursu
y0 <- 50 + 5 * motywacja + rnorm(n, sd = 5)    # wynik bez kursu
y1 <- y0 + 3                                   # wynik z kursem: efekt = 3 pkt u każdego
round(c(ATE_prawdziwy = mean(y1 - y0)), 2)
# 1) losowy przydział
a_los <- rbinom(n, 1, 0.5)
y_los <- ifelse(a_los == 1, y1, y0)            # obserwujemy tylko jeden wynik
# 2) samodzielny wybór: bardziej zmotywowani częściej idą na kurs
a_wyb <- rbinom(n, 1, plogis(1.5 * motywacja))
y_wyb <- ifelse(a_wyb == 1, y1, y0)
round(c(roznica_losowanie = mean(y_los[a_los == 1]) - mean(y_los[a_los == 0]),
        roznica_wybor     = mean(y_wyb[a_wyb == 1]) - mean(y_wyb[a_wyb == 0]),
        wybor_z_korekta   = unname(coef(lm(y_wyb ~ a_wyb + motywacja))["a_wyb"])), 2)
Wynik w R
ATE_prawdziwy
            3
roznica_losowanie     roznica_wybor   wybor_z_korekta
             3.19              8.40              3.26
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład – bez dodatkowych pakietów; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego nie da się zmierzyć efektu u jednej osoby?
Bo ta sama osoba w tym samym czasie albo dostaje interwencję, albo nie. Widzimy tylko jeden z dwóch potencjalnych wyników, więc szacujemy efekty przeciętne w grupach.
Czym różni się ATE od ATT?
ATE to przeciętny efekt w całej populacji, a ATT – przeciętny efekt u osób, które faktycznie otrzymały interwencję. Różnią się, gdy efekt jest różny u różnych osób, a do interwencji trafiają osoby nietypowe.
Czy model potencjalnych wyników wymaga eksperymentu?
Nie. Stosuje się go też do badań obserwacyjnych, ale wtedy wniosek opiera się na założeniach, zwłaszcza o braku niezmierzonych zmiennych zakłócających, których dane nie potwierdzą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Grafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikMediacja przyczynowa i analiza wrażliwości
NDE, NIE i ACME zamiast samego ab, interakcja ekspozycja × mediator, sekwencyjna ignorowalność i analiza wrażliwości ρ – na jednym przykładzie w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Holland, P. W. (1986). Statistics and causal inference. Journal of the American Statistical Association, 81(396), 945–960. https://doi.org/10.1080/01621459.1986.10478354
- Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350 ● Otwarty dostęp: pełny tekst
- Rubin, D. B. (2005). Causal inference using potential outcomes: Design, modeling, decisions. Journal of the American Statistical Association, 100(469), 322–331. https://doi.org/10.1198/016214504000001880
Cytowania BibTeX
@article{holland1986statistics, author={Holland, Paul W.}, title={{Statistics and causal inference}}, journal={Journal of the American Statistical Association}, year={1986}, volume={81}, number={396}, pages={945--960}, doi={10.1080/01621459.1986.10478354}}@article{rubin1974estimating, author={Rubin, Donald B.}, title={{Estimating causal effects of treatments in randomized and nonrandomized studies}}, journal={Journal of Educational Psychology}, year={1974}, volume={66}, number={5}, pages={688--701}, doi={10.1037/h0037350}}@article{rubin2005causal, author={Rubin, Donald B.}, title={{Causal inference using potential outcomes: Design, modeling, decisions}}, journal={Journal of the American Statistical Association}, year={2005}, volume={100}, number={469}, pages={322--331}, doi={10.1198/016214504000001880}}