Co mediacja przyczynowa dodaje do iloczynu ab
Klasyczna analiza Barona i Kenny'ego (1986) i jej współczesna wersja z bootstrapem w makrze PROCESS (Hayes, 2022) definiują efekt pośredni jako iloczyn współczynników a × b w dwóch równaniach regresji. Jak to zrobić krok po kroku, pokazują wpisy analiza mediacji krok po kroku i mediacja i moderacja w SPSS z PROCESS. Tu zakładamy, że znasz ścieżki a, b, c′ i c, i odpowiadamy na pytanie recenzenta: co dokładnie szacuje Twój efekt pośredni i przy jakich założeniach jest przyczynowy?
Imai, Keele i Tingley (2010) wskazali trzy słabości ujęcia opartego na liniowych modelach strukturalnych: efekt pośredni nie ma definicji niezależnej od modelu, kluczowe założenie identyfikujące pozostaje niewypowiedziane, a przeniesienie metody na modele nieliniowe jest trudne. Podejście przyczynowe odwraca kolejność. Najpierw definiuje efekty jako porównania potencjalnych wyników, potem podaje warunki identyfikacji, a dopiero na końcu wybiera model do estymacji. Skutki są dwa: przy interakcji ekspozycja × mediator iloczyn ab przestaje opisywać jeden efekt, a założenie o braku zakłóceń między mediatorem a wynikiem można poddać formalnej analizie wrażliwości.
Efekty kontrfaktyczne: NDE, NIE, ACME i CDE
Niech A oznacza ekspozycję (np. udział w programie), M mediator, a Y wynik. M(a) to wartość mediatora, jaką osoba miałaby przy ekspozycji a. Y(a, m) to wynik przy ekspozycji a i mediatorze ustawionym na m. Kluczowy obiekt to wynik „złożony” Y(1, M(0)): osoba jest w programie, ale jej mediator pozostaje taki, jaki byłby bez programu. Nikt go nie obserwuje, dlatego założenia ważą tu więcej niż w zwykłej regresji.
| Efekt | Definicja (średnia w populacji) | Pytanie, na które odpowiada |
|---|---|---|
| Efekt całkowity (TE) | Y(1, M(1)) − Y(0, M(0)) | Ile daje program łącznie? |
| Naturalny efekt bezpośredni (NDE), ADE ζ(0) | Y(1, M(0)) − Y(0, M(0)) | Co by zostało, gdyby program nie zmienił mediatora? |
| Naturalny efekt pośredni (NIE), ACME δ(1) | Y(1, M(1)) − Y(1, M(0)) | Ile daje sama zmiana mediatora wywołana programem? |
| Czysty efekt pośredni, ACME δ(0) | Y(0, M(1)) − Y(0, M(0)) | To samo, ale u osób bez programu |
| Kontrolowany efekt bezpośredni CDE(m) | Y(1, m) − Y(0, m) | Efekt programu, gdyby wszystkim ustawić mediator na m |
NDE i NIE sumują się do efektu całkowitego. ACME (ang. average causal mediation effect) to nazwa Imaia i współpracowników na średni naturalny efekt pośredni, a ADE – na bezpośredni. Gdy ekspozycja i mediator nie wchodzą w interakcję, δ(0) = δ(1), CDE nie zależy od m i w modelach liniowych wszystko sprowadza się do ab i c′. Przy interakcji te wielkości się rozchodzą. Wtedy trzeba napisać, który efekt raportujesz. Robins i Greenland (1992) pokazali, że kontrola zmiennej pośredniczącej, czyli zwykły sposób szacowania efektu bezpośredniego, może dawać obciążone wyniki. Pokazali też, że przy interakcji ekspozycji z mediatorem efektów nie da się rozdzielić nawet wtedy, gdy losuje się oba czynniki. Wybór efektu to decyzja o estymandzie, a nie szczegół techniczny.
Sekwencyjna ignorowalność: czego nie daje randomizacja
Imai, Keele i Yamamoto (2010) udowodnili, że przy założeniu sekwencyjnej ignorowalności ACME jest identyfikowalne nieparametrycznie, czyli bez założeń o kształcie modelu. Założenie ma dwie części:
- Ekspozycja jest „jak wylosowana” względem mediatora i wyniku, po uwzględnieniu zmierzonych kowariantów. Randomizacja zapewnia to z założenia.
- Mediator jest „jak wylosowany” względem wyniku, przy danej ekspozycji i tych samych kowariantach. Nie może istnieć niezmierzona zmienna zakłócająca związek M–Y.
Drugiej części żaden przydział losowy nie zapewni, bo nikt nie losował mediatora. W ujęciu VanderWeele'a dochodzi jeszcze warunek, że żaden zakłócacz M–Y nie jest sam skutkiem ekspozycji (VanderWeele, 2015). Na grafie przyczynowym oznacza to brak otwartych ścieżek tylnymi drzwiami między M a Y po warunkowaniu na A i kowariantach. Pomaga pomiar w kolejności A → M → Y (schemat podłużny) i zmierzenie kandydatów na zakłócacze przed ekspozycją. Rohrer i in. (2022) podkreślają, że standardowe modele ścieżkowe dają trafne wnioski przyczynowe tylko w ograniczonych warunkach.
Przykład: program wsparcia, samotność i objawy depresji
Czterystu studentów z objawami depresji losowo przydzielono do ośmiotygodniowego programu wsparcia rówieśniczego (n = 200) albo na listę oczekujących (n = 200). Na początku zmierzono objawy (PHQ-9, 0–27). Po 4 tygodniach mierzono samotność (20–80 pkt), a po 8 tygodniach ponownie objawy depresji. Dane są symulowane (set.seed(3331)). Możesz je pobrać jako plik CSV. W modelu generującym działa też niezmierzona neurotyczność, która podnosi i samotność, i objawy depresji. Jej wartości nie ma w pliku. Dzięki temu znamy prawdziwe efekty: NDE = −1.00, NIE δ(1) = −1.15, δ(0) = −0.75 i TE = −2.15 pkt.
| Grupa | PHQ-9 na początku | Samotność (4 tyg.) | PHQ-9 (8 tyg.) |
|---|---|---|---|
| Lista oczekujących | 10.90 | 45.50 | 10.11 |
| Program | 11.20 | 40.12 | 8.12 |
Podejście PROCESS (model 4) z kontrolą wyjściowego PHQ-9 daje a = −5.67, b = 0.263, c′ = −0.71 i efekt całkowity c = −2.20. Efekt pośredni ab = −1.49, 95% CI BCa [−1.96, −1.07], z 2000 prób bootstrapu.
NDE i NIE ze wzorów regresyjnych przy interakcji
Dla ciągłego mediatora i wyniku VanderWeele i Vansteelandt (2009) wyprowadzili efekty kontrfaktyczne z dwóch modeli liniowych. Valeri i VanderWeele (2013) przenieśli to podejście do psychologii i porównali je ze standardowym podejściem przy interakcji ekspozycja × mediator:
Wzory podano dla przejścia z A = 0 na A = 1 i dla kowariantu ustalonego na średniej c. W przykładzie interakcja program × samotność wyniosła θ3 = 0.031 (SE = 0.033, p = .357). Przedziały ufności policzyliśmy bootstrapem nieparametrycznym (2000 prób, przedziały BCa; zob. przedział bootstrapowy BCa i wpis bootstrap i test permutacyjny).
| Efekt | Oszacowanie [95% CI BCa] | Prawda (symulacja) |
|---|---|---|
| TE | −2.20 [−2.95, −1.44] | −2.15 |
| NDE | −0.62 [−1.25, 0.06] | −1.00 |
| NIE, δ(1) | −1.58 [−2.15, −1.12] | −1.15 |
| Czysty efekt pośredni, δ(0) | −1.41 [−1.94, −0.99] | −0.75 |
| CDE przy samotności = 35 | −0.94 [−1.75, −0.08] | −1.80 |
| CDE przy samotności = 55 | −0.33 [−1.32, 0.61] | −0.20 |
| Odsetek zapośredniczony (NIE/TE) | 0.72 [0.52, 1.03] | 0.53 |
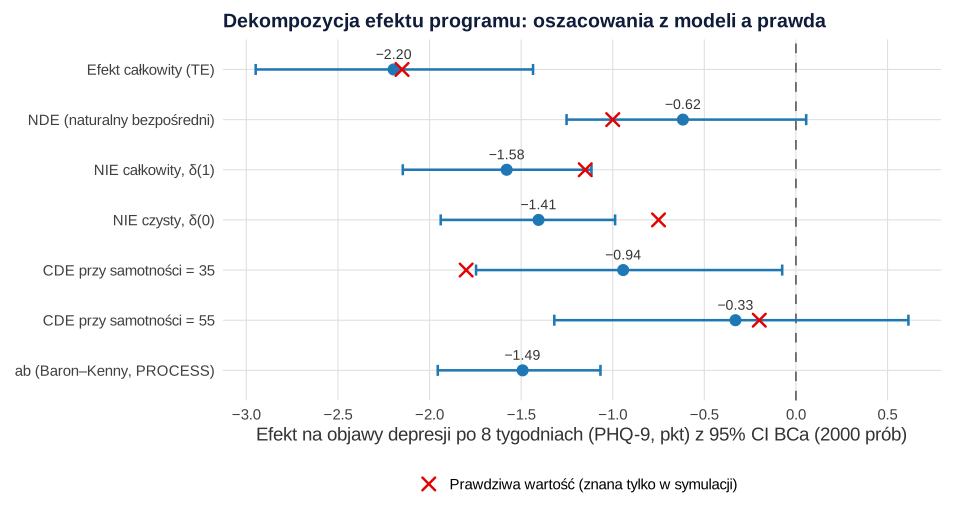
Z tej tabeli płyną dwie lekcje. Efekt całkowity jest trafny, bo program wylosowano. Podział na część bezpośrednią i pośrednią jest obciążony, choć model jest poprawnie zapisany, a próba duża. Neurotyczność łączy samotność z objawami, więc ścieżka b (0.248 w modelu z interakcją, prawda 0.15) przejmuje część efektu. Efekt pośredni rośnie (−1.58 wobec −1.15), a bezpośredni maleje (−0.62 wobec −1.00) o podobną wielkość. Mała interakcja rozdziela δ(0) i δ(1) o 0.17 pkt, ale błąd wynikający z zakłócenia jest kilkakrotnie większy. Odsetek zapośredniczony z górną granicą powyżej 1 pokazuje, dlaczego tej miary nie warto eksponować.
Analiza wrażliwości: parametr ρ
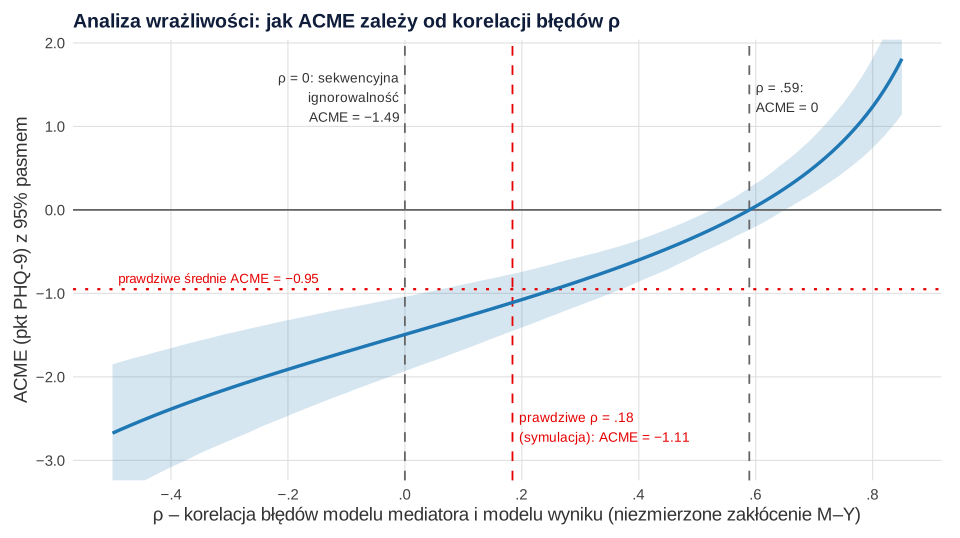
Imai, Keele i Yamamoto (2010) zaproponowali analizę wrażliwości dla liniowego modelu bez interakcji. Parametrem jest ρ, czyli korelacja błędów modelu mediatora (M ~ A + C) i modelu wyniku (Y ~ A + M + C). Przy sekwencyjnej ignorowalności ρ = 0. Niezmierzony zakłócacz, który podnosi oba poziomy, daje ρ > 0. Ponieważ błąd modelu bez mediatora (Y ~ A + C) jest sumą γ·εM i błędu modelu wyniku, z danych można wyznaczyć ACME dla każdego założonego ρ:
σ1 i σ2 to odchylenia standardowe reszt modelu Y ~ A + C i modelu mediatora, a ρ̃ – korelacja tych reszt. Wzór wyprowadziliśmy z definicji ρ (wyprowadzenie w komentarzu przepisu 3). Przy ρ = 0 daje on dokładnie ab = −1.49, a ACME = 0 osiąga przy ρ = ρ̃. W przykładzie β1 = −5.67, σ1 = 3.77, σ2 = 8.43 i ρ̃ = .589. Pakiet mediation (Tingley i in., 2014) wyraża ten sam próg także jako iloczyny R². Iloczyn części wariancji resztowej M i Y wyjaśnianych przez zakłócacz wynosi tu ρ̃² = .347. Iloczyn części wariancji całkowitej wynosi .107, np. po 33% wariancji każdej zmiennej.
| ρ | −.2 | 0 | .1 | .2 | .3 |
|---|---|---|---|---|---|
| ACME [95% pasmo] | −1.91 [−2.47, −1.32] | −1.49 [−1.93, −1.04] | −1.29 [−1.67, −0.89] | −1.08 [−1.41, −0.74] | −0.85 [−1.14, −0.56] |
Jak to czytać? Efekt pośredni znika dopiero przy ρ = .59, a pasmo zaczyna obejmować zero od ρ = .53. To silne zakłócenie, więc sam kierunek wniosku jest dość odporny. Wielkość efektu odporna już nie jest. Przy umiarkowanym ρ = .2 ACME spada o blisko 30%. Prawdziwe ρ wynosi tu .184, a ACME przy tej wartości to −1.11 wobec prawdziwego średniego ACME −0.95. Średnie ACME to średnia δ(0) i δ(1), czyli wielkość szacowana przez model bez interakcji. W realnym badaniu prawdziwego ρ nie znasz, więc raportuj próg i porównaj go z siłą zmierzonych kowariantów, podobnie jak przy E-wartości. Wzór dotyczy modelu bez interakcji. Przy wyraźnej interakcji albo nieliniowych modelach użyj procedury symulacyjnej z pakietu mediation albo modelu z jawnie zadanym zakłócaczem, jak niżej.
Symulacja: zakłócacz o zadanej sile
Drugi sposób na analizę wrażliwości to symulacja. Zakładasz zakłócacz o konkretnym wpływie na M i Y i sprawdzasz, jak zmienia on oszacowanie. Powtórzyliśmy badanie 500 razy dla pięciu sił wpływu neurotyczności na objawy (0–2.4 pkt na 1 SD), przy stałym wpływie na samotność (4 pkt na 1 SD).
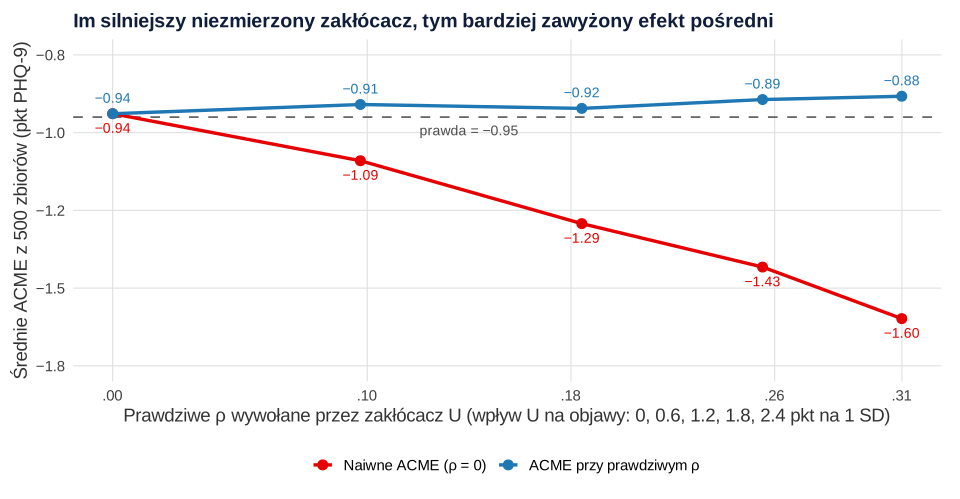
Bez zakłócenia naiwne ACME wyniosło −0.94. Przy ρ = .10 było zawyżone o 15%, przy ρ = .18 o 36%, a przy ρ = .31 o 68%. Wzór z wpisanym prawdziwym ρ przywrócił wartości od −0.88 do −0.94. Resztkowa różnica wynika m.in. z zaokrąglenia i ograniczenia skali PHQ-9 do 0–27. W praktyce zestaw kilka wiarygodnych scenariuszy z literatury („gdyby cecha X miała taki wpływ na mediator i wynik, efekt pośredni zmalałby do…”), a nie jeden skrajny. Szerszy kontekst daje wpis o analizie wrażliwości w artykule naukowym.
Jak opisać mediację przyczynową w artykule
W metodach nazwij estymandy (NDE, NIE, δ(0) lub δ(1)), modele, kowarianty i założenie sekwencyjnej ignorowalności. Napisz też, które zmienne mają je uprawdopodobnić. W wynikach podaj efekty z przedziałami i wynik analizy wrażliwości jako próg ρ. Jeśli chcesz, by ktoś niezależnie sprawdził założenia i analizę wrażliwości przed wysłaniem tekstu, opisz projekt w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R i piąty, niewykonany przykład składni. Pierwszy przepis tworzy plik mediacja-przyczynowa-dane.csv (możesz go pobrać tutaj). Potrzebny jest pakiet boot; reszta to funkcje R.
1. Dane, podejście Barona–Kenny'ego i efekty ze wzorów
R
# Dane symulowane: 400 studentów z objawami depresji losowo przydzielonych do programu wsparcia
# rówieśniczego (program = 1) albo na listę oczekujących (program = 0).
# phq0 – objawy depresji na początku (PHQ-9, 0–27), samotnosc – mediator po 4 tygodniach (20–80 pkt),
# phq8 – objawy depresji po 8 tygodniach (wynik). Neurotyczność U wpływa na samotność i na objawy,
# ale jej „nie zmierzono”: nie trafia do pliku ani do modeli.
generuj <- function(n, lam_m = 4, lam_y = 1.2, zapisz_u = FALSE) {
  program <- sample(rep(0:1, each = n / 2))
  phq0 <- round(pmin(pmax(rnorm(n, 11, 4), 0), 27))
  U <- rnorm(n)
  samotnosc <- 45 - 5 * program + 0.8 * (phq0 - 11) + lam_m * U + rnorm(n, 0, 7)
  phq8 <- 10 - 1 * program + 0.15 * (samotnosc - 45) + 0.08 * program * (samotnosc - 45) +
    0.5 * (phq0 - 11) + lam_y * U + rnorm(n, 0, 3)
  d <- data.frame(id = 1:n, program, phq0, samotnosc = round(samotnosc), phq8 = round(pmin(pmax(phq8, 0), 27)))
  if (zapisz_u) d$U <- U
  d
}
set.seed(3331)
dane <- generuj(400)
write.csv(dane, "mediacja-przyczynowa-dane.csv", row.names = FALSE)
round(sapply(split(dane[, c("phq0", "samotnosc", "phq8")], dane$program), colMeans), 2)

# Prawdziwe efekty (znane tylko w symulacji): w modelu generującym M(0) ma średnio 45 pkt, więc
# NDE = −1, czyste NIE = δ(0) = −5 × 0.15, całkowite NIE = δ(1) = −5 × (0.15 + 0.08)
prawda <- c(TE = -1 - 5 * 0.23, NDE = -1, NIE_calk = -5 * 0.23, NIE_czyste = -5 * 0.15,
            ACME_srednie = -5 * (0.15 + 0.08 / 2), CDE_M35 = -1 + 0.08 * (35 - 45), CDE_M55 = -1 + 0.08 * (55 - 45))
prawda <- c(prawda, odsetek_posr = prawda[["NIE_calk"]] / prawda[["TE"]])
round(prawda, 3)

# 1. Podejście Barona–Kenny'ego / PROCESS (model 4): ścieżki a, b, c' i iloczyn ab
m_c  <- lm(phq8 ~ program + phq0, data = dane)                # efekt całkowity c
m_a  <- lm(samotnosc ~ program + phq0, data = dane)           # ścieżka a
m_b  <- lm(phq8 ~ program + samotnosc + phq0, data = dane)    # ścieżki b i c'
round(c(c = coef(m_c)[["program"]], a = coef(m_a)[["program"]], b = coef(m_b)[["samotnosc"]],
        c_prim = coef(m_b)[["program"]], ab = coef(m_a)[["program"]] * coef(m_b)[["samotnosc"]]), 3)

# 2. Model wyniku z interakcją ekspozycja × mediator
m_y <- lm(phq8 ~ program * samotnosc + phq0, data = dane)
round(summary(m_y)$coefficients, 3)

# 3. Efekty kontrfaktyczne ze wzorów regresyjnych (VanderWeele i Vansteelandt, 2009; Valeri i VanderWeele, 2013)
#    M = b0 + b1 A + b2 C,  Y = t0 + t1 A + t2 M + t3 A·M + t4 C;  a = 1, a* = 0, C = średnia phq0
efekty <- function(d) {
  b <- coef(lm(samotnosc ~ program + phq0, data = d))
  t <- coef(lm(phq8 ~ program * samotnosc + phq0, data = d))
  m0 <- b[["(Intercept)"]] + b[["phq0"]] * mean(d$phq0)       # E[M(0) | C = średnia]
  NDE <- t[["program"]] + t[["program:samotnosc"]] * m0         # naturalny efekt bezpośredni (czysty)
  NIE <- b[["program"]] * (t[["samotnosc"]] + t[["program:samotnosc"]])  # naturalny efekt pośredni (całkowity), δ(1)
  NIE0 <- b[["program"]] * t[["samotnosc"]]                     # czysty efekt pośredni, δ(0)
  CDE <- t[["program"]] + t[["program:samotnosc"]] * c(35, 55)  # kontrolowany efekt bezpośredni przy M = 35 i 55
  c(TE = NDE + NIE, NDE = NDE, NIE_calk = NIE, NIE_czyste = NIE0,
    CDE_M35 = CDE[1], CDE_M55 = CDE[2], odsetek_posr = NIE / (NDE + NIE))
}
round(efekty(dane), 3)
Wynik w R
              0     1
phq0      10.90 11.20
samotnosc 45.50 40.12
phq8      10.11  8.12
          TE          NDE     NIE_calk   NIE_czyste ACME_srednie      CDE_M35
      -2.150       -1.000       -1.150       -0.750       -0.950       -1.800
     CDE_M55 odsetek_posr
      -0.200        0.535
     c      a      b c_prim     ab
-2.197 -5.671  0.263 -0.705 -1.492
                  Estimate Std. Error t value Pr(>|t|)
(Intercept)         -5.917      1.133  -5.221    0.000
program             -2.016      1.459  -1.382    0.168
samotnosc            0.248      0.025  10.037    0.000
phq0                 0.436      0.042  10.402    0.000
program:samotnosc    0.031      0.033   0.921    0.357
          TE          NDE     NIE_calk   NIE_czyste      CDE_M35      CDE_M55
      -2.196       -0.617       -1.579       -1.405       -0.943       -0.330
odsetek_posr
       0.719
2. Bootstrap efektów kontrfaktycznych
R
# Bootstrap nieparametryczny efektów kontrfaktycznych (wymaga obiektów z przepisu 1)
suppressPackageStartupMessages(library(boot))
set.seed(3332)
b_efekty <- boot(dane, function(d, i) efekty(d[i, ]), R = 2000)

# 95% CI: percentylowy i BCa dla każdego efektu
ci <- t(sapply(seq_along(b_efekty$t0), function(k) {
  p <- boot.ci(b_efekty, type = c("perc", "bca"), index = k)
  c(oszacowanie = b_efekty$t0[[k]], SE = sd(b_efekty$t[, k]),
    perc_dolny = p$percent[4], perc_gorny = p$percent[5], bca_dolny = p$bca[4], bca_gorny = p$bca[5])
}))
rownames(ci) <- names(b_efekty$t0)
round(ci, 3)

# Ten sam bootstrap dla iloczynu ab z modelu bez interakcji (Baron–Kenny / PROCESS, model 4)
set.seed(3333)
b_ab <- boot(dane, function(d, i) {
  d <- d[i, ]
  coef(lm(samotnosc ~ program + phq0, data = d))[["program"]] *
    coef(lm(phq8 ~ program + samotnosc + phq0, data = d))[["samotnosc"]]
}, R = 2000)
round(c(ab = b_ab$t0, boot.ci(b_ab, type = "bca")$bca[4:5]), 3)
Wynik w R
             oszacowanie    SE perc_dolny perc_gorny bca_dolny bca_gorny
TE                -2.196 0.382     -2.940     -1.423    -2.949    -1.435
NDE               -0.617 0.331     -1.266      0.031    -1.252     0.056
NIE_calk          -1.579 0.263     -2.116     -1.079    -2.146    -1.116
NIE_czyste        -1.405 0.238     -1.906     -0.959    -1.939    -0.987
CDE_M35           -0.943 0.418     -1.763     -0.104    -1.746    -0.075
CDE_M55           -0.330 0.498     -1.330      0.607    -1.319     0.614
odsetek_posr       0.719 0.127      0.520      1.021     0.524     1.034
    ab
-1.492 -1.955 -1.067
3. Analiza wrażliwości: ACME jako funkcja ρ
R
# Analiza wrażliwości ACME na niezmierzone zakłócenie M–Y według Imaia, Keele'a i Yamamoto (2010)
# ρ = korelacja błędów modelu mediatora i modelu wyniku (Y ~ A + M + C). Przy sekwencyjnej ignorowalności ρ = 0.
# Modele liniowe bez interakcji A × M. Z modeli M ~ A + C (błąd ε2) i Y ~ A + C (błąd ε1) bierzemy
# σ1, σ2 i ρ~ = cor(ε1, ε2). Ponieważ ε1 = γ ε2 + ε3, rozwiązanie dla γ przy zadanym ρ daje:
#   ACME(ρ) = β2 · σ1/σ2 · [ρ~ − ρ · sqrt((1 − ρ~²) / (1 − ρ²))]
# (wymaga obiektów z przepisów 1–2)
acme_rho <- function(d, rho) {
  m_m <- lm(samotnosc ~ program + phq0, data = d)
  m_1 <- lm(phq8 ~ program + phq0, data = d)
  r_t <- cor(resid(m_1), resid(m_m))
  coef(m_m)[["program"]] * sigma(m_1) / sigma(m_m) * (r_t - rho * sqrt((1 - r_t^2) / (1 - rho^2)))
}
m_m <- lm(samotnosc ~ program + phq0, data = dane)
m_1 <- lm(phq8 ~ program + phq0, data = dane)
round(c(beta2 = coef(m_m)[["program"]], sigma1 = sigma(m_1), sigma2 = sigma(m_m),
        rho_tylda = cor(resid(m_1), resid(m_m)),
        ACME_rho0 = acme_rho(dane, 0), ab_bez_interakcji = coef(m_a)[["program"]] * coef(m_b)[["samotnosc"]]), 3)

# ACME = 0 dokładnie wtedy, gdy ρ = ρ~. Ten sam próg jako iloczyny R² (jak w medsens):
# R*²_M · R*²_Y = ρ² (części wariancji resztowej), R~²_M · R~²_Y = ρ² (1 − R²_M)(1 − R²_Y) (części wariancji całkowitej)
rho0 <- cor(resid(m_1), resid(m_m))
round(c(rho_ACME_0 = rho0, R2_gwiazdka_iloczyn = rho0^2,
        R2_tylda_iloczyn = rho0^2 * (1 - summary(m_m)$r.squared) * (1 - summary(m_b)$r.squared)), 3)

# Siatka ρ i 95% pasmo bootstrapowe (percentylowe), te same próby dla wszystkich ρ
siatka_rho <- round(seq(-0.9, 0.9, by = 0.01), 2)
set.seed(3334)
b_rho <- boot(dane, function(d, i) acme_rho(d[i, ], siatka_rho), R = 2000)
wrazliwosc <- data.frame(rho = siatka_rho, ACME = b_rho$t0,
                         dolny = apply(b_rho$t, 2, quantile, .025), gorny = apply(b_rho$t, 2, quantile, .975))
write.csv(wrazliwosc, "b333-wrazliwosc-siatka.csv", row.names = FALSE)
# Najmniejsze ρ, przy którym pasmo obejmuje zero
round(c(rho_pasmo_obejmuje_0 = min(wrazliwosc$rho[wrazliwosc$rho > -0.5 & wrazliwosc$gorny >= 0])), 2)
print(round(wrazliwosc[wrazliwosc$rho %in% c(-0.2, 0, 0.1, 0.2, 0.3), ], 3), row.names = FALSE)

# Co wiemy tylko w symulacji: prawdziwe ρ wynikające z wpływu U na M (4) i na Y (1.2) oraz ACME przy tym ρ
rho_prawdziwe <- 4 * 1.2 / sqrt((4^2 + 7^2) * (1.2^2 + 3^2))
round(c(rho_prawdziwe = rho_prawdziwe, ACME_przy_rho_prawdziwym = acme_rho(dane, rho_prawdziwe),
        ACME_srednie_prawdziwe = prawda[["ACME_srednie"]]), 3)
Wynik w R
            beta2            sigma1            sigma2         rho_tylda
           -5.671             3.766             8.431             0.589
        ACME_rho0 ab_bez_interakcji
           -1.492            -1.492
         rho_ACME_0 R2_gwiazdka_iloczyn    R2_tylda_iloczyn
              0.589               0.347               0.107
rho_pasmo_obejmuje_0
                0.53
  rho   ACME  dolny  gorny
 -0.2 -1.910 -2.468 -1.320
  0.0 -1.492 -1.931 -1.039
  0.1 -1.287 -1.674 -0.893
  0.2 -1.075 -1.409 -0.742
  0.3 -0.849 -1.140 -0.561
           rho_prawdziwe ACME_przy_rho_prawdziwym   ACME_srednie_prawdziwe
                   0.184                   -1.109                   -0.950
4. Symulacja zakłócacza o zadanej sile
R
# Symulacja: niezmierzony zakłócacz U o zadanej sile (wymaga funkcji generuj() i acme_rho() z przepisów 1 i 3)
# U wpływa na samotność (4 pkt na 1 SD) i na objawy depresji (lam_y = 0–2.4 pkt na 1 SD).
# Prawdziwe średnie ACME nie zależy od U i wynosi −0.95. Dla każdej siły: 500 zbiorów po 400 osób.
set.seed(3335)
sily <- c(0, 0.6, 1.2, 1.8, 2.4)
symulacja <- do.call(rbind, lapply(sily, function(lam_y) {
  rho_p <- 4 * lam_y / sqrt((4^2 + 7^2) * (lam_y^2 + 3^2))     # prawdziwe ρ dla tej siły zakłócenia
  r <- t(replicate(500, {
    d <- generuj(400, lam_y = lam_y)
    c(naiwne = acme_rho(d, 0), skorygowane = acme_rho(d, rho_p), rho_tylda = cor(
      resid(lm(phq8 ~ program + phq0, data = d)), resid(lm(samotnosc ~ program + phq0, data = d))))
  }))
  data.frame(lam_y, rho_prawdziwe = rho_p, ACME_naiwne = mean(r[, "naiwne"]),
             MCSE_naiwne = sd(r[, "naiwne"]) / sqrt(500), ACME_przy_prawdziwym_rho = mean(r[, "skorygowane"]),
             przeszacowanie_proc = 100 * (mean(r[, "naiwne"]) / -0.95 - 1),
             rho_tylda_srednie = mean(r[, "rho_tylda"]))
}))
write.csv(symulacja, "b333-symulacja.csv", row.names = FALSE)
print(round(symulacja, 3), row.names = FALSE)
Wynik w R
 lam_y rho_prawdziwe ACME_naiwne MCSE_naiwne ACME_przy_prawdziwym_rho
   0.0         0.000      -0.939       0.008                   -0.939
   0.6         0.097      -1.090       0.009                   -0.909
   1.2         0.184      -1.293       0.010                   -0.922
   1.8         0.255      -1.432       0.011                   -0.893
   2.4         0.310      -1.598       0.012                   -0.883
 przeszacowanie_proc rho_tylda_srednie
              -1.153             0.448
              14.769             0.507
              36.062             0.547
              50.760             0.574
              68.225             0.588
5. To samo w pakiecie mediation (kod niewykonany)
R
# Pakiet mediation (Tingley i in., 2014) – przykład składni, kod niewykonany, bez wyników na tej stronie
library(mediation)
dane <- read.csv("mediacja-przyczynowa-dane.csv")
m_m <- lm(samotnosc ~ program + phq0, data = dane)
m_y <- lm(phq8 ~ program * samotnosc + phq0, data = dane)
med <- mediate(m_m, m_y, treat = "program", mediator = "samotnosc",
               boot = TRUE, sims = 2000)          # ACME(0), ACME(1), ADE(0), ADE(1), efekt całkowity
summary(med)
# Analiza wrażliwości wymaga modeli bez interakcji program × samotność
m_y0 <- lm(phq8 ~ program + samotnosc + phq0, data = dane)
med0 <- mediate(m_m, m_y0, treat = "program", mediator = "samotnosc", sims = 2000)
sens <- medsens(med0, rho.by = 0.01, effect.type = "indirect")
summary(sens)                                     # ρ i iloczyny R² przy ACME = 0
plot(sens, sens.par = "rho")
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm() i cor() z pakietu stats) z pakietem boot; rysunki przygotowano w pakiecie ggplot2. Kod pakietu mediation pokazano jako niewykonany przykład składni.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3.32): Canty, A., & Ripley, B. D. (2024). boot: Bootstrap R (S-Plus) functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- mediation (kod niewykonany): Tingley, D., Yamamoto, T., Hirose, K., Keele, L., & Imai, K. (2014). mediation: R package for causal mediation analysis. Journal of Statistical Software, 59(5). https://doi.org/10.18637/jss.v059.i05
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Randomizowaliśmy, więc mediacja jest przyczynowa”. Losowanie ekspozycji chroni efekt całkowity i ścieżkę a. Związek mediatora z wynikiem pozostaje obserwacyjny, jak w przykładzie, w którym NIE było zawyżone o ponad 35%.
- Iloczyn ab przy wyraźnej interakcji A × M. Wtedy ab nie jest ani δ(0), ani δ(1). Policz efekty ze wzorów i nazwij estymandę.
- Utożsamianie c′ z naturalnym efektem bezpośrednim. Przy interakcji c′ to CDE przy jednej wartości mediatora. NDE uśrednia ją po rozkładzie M(0).
- Kontrolowanie zmiennych, które są skutkiem ekspozycji. Zakłócacz M–Y zależny od A łamie założenia identyfikacji NDE i NIE nawet po jego uwzględnieniu (VanderWeele, 2015). Rozważ wtedy CDE albo metody typu g-formula.
- Brak analizy wrażliwości albo jeden skrajny scenariusz. Podaj próg ρ (lub iloczyn R²) i odnieś go do siły zmierzonych kowariantów.
- Przekrojowy pomiar A, M i Y. Bez kolejności w czasie nie ma podstaw do mediacji przyczynowej. Rozważ model cross-lagged i kolejne fale pomiaru.
Najczęstsze pytania
Czym różni się naturalny efekt pośredni od iloczynu ab?
Naturalny efekt pośredni (NIE) to średnia różnica Y(1, M(1)) − Y(1, M(0)), zdefiniowana bez odwołania do modelu. W modelach liniowych bez interakcji ekspozycja × mediator jest równy ab. Przy interakcji ab nie odpowiada ani czystemu, ani całkowitemu efektowi pośredniemu. W przykładzie ab = −1.49, a δ(0) = −1.41 i δ(1) = −1.58.
Czy randomizacja wystarcza, żeby analiza mediacji była przyczynowa?
Nie. Losowanie ekspozycji chroni efekt całkowity i ścieżkę od ekspozycji do mediatora. Związek mediatora z wynikiem pozostaje obserwacyjny, bo mediatora nikt nie losował. W symulowanym badaniu randomizowanym niezmierzona neurotyczność zawyżyła efekt pośredni z −1.15 do −1.58 pkt, choć efekt całkowity był trafny.
Jak interpretować parametr ρ w analizie wrażliwości mediacji?
ρ to korelacja błędów modelu mediatora i modelu wyniku. Według Imaia, Keele'a i Yamamoto (2010) przy braku niezmierzonych zakłóceń mediator–wynik wynosi 0. Raportuje się wartość ρ, przy której ACME spada do zera, oraz ρ, przy którym przedział zaczyna obejmować zero. Im większe są te progi, tym silniejszy zakłócacz byłby potrzebny, by podważyć wniosek. Porównaj je z siłą zmierzonych kowariantów.
Który efekt pośredni raportować przy interakcji ekspozycji z mediatorem?
Całkowity efekt pośredni δ(1) opisuje działanie mediatora u osób poddanych ekspozycji. Razem z czystym efektem bezpośrednim sumuje się do efektu całkowitego i najczęściej odpowiada pytaniu o mechanizm interwencji. Czysty efekt pośredni δ(0) dotyczy osób bez ekspozycji. Nazwij wybraną estymandę w metodach, a przy wyraźnej interakcji podaj oba efekty.
Czym jest kontrolowany efekt bezpośredni i czym różni się od naturalnego?
Kontrolowany efekt bezpośredni CDE(m) to efekt ekspozycji, gdyby wszystkim ustawić mediator na tej samej wartości m. Przy interakcji zależy od m: w przykładzie −0.94 przy samotności 35 pkt i −0.33 przy 55 pkt. Naturalny efekt bezpośredni pozostawia każdemu jego własny mediator M(0). CDE jest przydatny, gdy pytasz o skutki interwencji na samym mediatorze.
Powiązane hasła
Przeczytaj też
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikMediacja i moderacja w SPSS z PROCESS
Instalacja makra Hayesa, modele 1, 4 i 7, efekt pośredni z bootstrapem, efekty warunkowe, indeks moderowanej mediacji i zapis APA – z plikiem .sav.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →Recenzent pyta, czy Twój efekt pośredni jest przyczynowy?
Pomożemy nazwać estymandy, policzyć NDE i NIE z przedziałami bootstrapowymi i przeprowadzić analizę wrażliwości na niezmierzone zakłócenie tak, żebyś mógł(a) samodzielnie opisać i obronić wyniki.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Baron, R. M., & Kenny, D. A. (1986). The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Imai, K., Keele, L., & Tingley, D. (2010). A general approach to causal mediation analysis. Psychological Methods, 15(4), 309–334. https://doi.org/10.1037/a0020761 ● Otwarty dostęp: pełny tekst
- Imai, K., Keele, L., & Yamamoto, T. (2010). Identification, inference and sensitivity analysis for causal mediation effects. Statistical Science, 25(1), 51–71. https://doi.org/10.1214/10-sts321 ● Otwarty dostęp
- Robins, J. M., & Greenland, S. (1992). Identifiability and exchangeability for direct and indirect effects. Epidemiology, 3(2), 143–155. https://doi.org/10.1097/00001648-199203000-00013
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Tingley, D., Yamamoto, T., Hirose, K., Keele, L., & Imai, K. (2014). mediation: R package for causal mediation analysis. Journal of Statistical Software, 59(5). https://doi.org/10.18637/jss.v059.i05 ● Otwarty dostęp
- Valeri, L., & VanderWeele, T. J. (2013). Mediation analysis allowing for exposure–mediator interactions and causal interpretation: Theoretical assumptions and implementation with SAS and SPSS macros. Psychological Methods, 18(2), 137–150. https://doi.org/10.1037/a0031034 ● Otwarty dostęp
- VanderWeele, T. J. (2015). Explanation in causal inference: Methods for mediation and interaction. Oxford University Press.
- VanderWeele, T. J., & Vansteelandt, S. (2009). Conceptual issues concerning mediation, interventions and composition. Statistics and Its Interface, 2(4), 457–468. https://doi.org/10.4310/sii.2009.v2.n4.a7 ● Otwarty dostęp
Cytowania BibTeX
@article{baron1986moderator, author={Baron, Reuben M. and Kenny, David A.}, title={{The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations}}, journal={Journal of Personality and Social Psychology}, year={1986}, volume={51}, number={6}, pages={1173--1182}, doi={10.1037/0022-3514.51.6.1173}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@article{imai2010general, author={Imai, Kosuke and Keele, Luke and Tingley, Dustin}, title={{A general approach to causal mediation analysis}}, journal={Psychological Methods}, year={2010}, volume={15}, number={4}, pages={309--334}, doi={10.1037/a0020761}}@article{imai2010identification, author={Imai, Kosuke and Keele, Luke and Yamamoto, Teppei}, title={{Identification, inference and sensitivity analysis for causal mediation effects}}, journal={Statistical Science}, year={2010}, volume={25}, number={1}, pages={51--71}, doi={10.1214/10-sts321}}@article{robins1992identifiability, author={Robins, James M. and Greenland, Sander}, title={{Identifiability and exchangeability for direct and indirect effects}}, journal={Epidemiology}, year={1992}, volume={3}, number={2}, pages={143--155}, doi={10.1097/00001648-199203000-00013}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{tingley2014mediation, author={Tingley, Dustin and Yamamoto, Teppei and Hirose, Kentaro and Keele, Luke and Imai, Kosuke}, title={{mediation: R package for causal mediation analysis}}, journal={Journal of Statistical Software}, year={2014}, volume={59}, number={5}, doi={10.18637/jss.v059.i05}}@article{valeri2013mediation, author={Valeri, Linda and VanderWeele, Tyler J.}, title={{Mediation analysis allowing for exposure–mediator interactions and causal interpretation: Theoretical assumptions and implementation with SAS and SPSS macros}}, journal={Psychological Methods}, year={2013}, volume={18}, number={2}, pages={137--150}, doi={10.1037/a0031034}}@book{vanderweele2015explanation, author={VanderWeele, Tyler J.}, title={{Explanation in causal inference: Methods for mediation and interaction}}, year={2015}, publisher={Oxford University Press}}@article{vanderweele2009conceptual, author={VanderWeele, Tyler J. and Vansteelandt, Stijn}, title={{Conceptual issues concerning mediation, interventions and composition}}, journal={Statistics and Its Interface}, year={2009}, volume={2}, number={4}, pages={457--468}, doi={10.4310/sii.2009.v2.n4.a7}}