Pytanie recenzenta, na które nie odpowiesz kolejną kowariantą
W badaniu obserwacyjnym uwzględniasz w modelu wszystkie zmierzone zmienne zakłócające, najlepiej wybrane na podstawie grafu przyczynowego (DAG). Recenzent i tak zapyta: „A co ze zmienną, której nie zmierzyliście?”. Odpowiedź „uwzględniliśmy wszystko, co się dało” niczego nie mówi o tym, czy wynik przetrwałby takie zakłócenie.
E-wartość (ang. E-value) zamienia to pytanie w liczbę. Krótką definicję znajdziesz w haśle E-wartość, a miejsce E-wartości wśród innych wariantów analizy wrażliwości opisuje wpis analiza wrażliwości w artykule naukowym. Podstawowe obliczenie dla wyniku z analizy propensity score pokazujemy w kroku 7 tamtego poradnika. Tutaj idziemy dalej: E-wartość dla granicy przedziału, przeliczenia z OR i HR, współczynnik ograniczający dla konkretnych scenariuszy, porównanie ze zmierzonymi zmiennymi i krytyka metody.
Definicja i wzór
VanderWeele i Ding (2017) definiują E-wartość jako najmniejszą siłę związku, wyrażoną jako ryzyko względne, jaką niezmierzona zmienna musiałaby mieć jednocześnie z ekspozycją i z wynikiem, by całkowicie wyjaśnić obserwowany związek przy uwzględnionych kowariantach. Duża E-wartość oznacza, że do wyjaśnienia wyniku potrzebne byłoby silne zakłócenie. Mała – że wystarczyłoby słabe.
Dla RR < 1 najpierw bierzesz odwrotność (1/RR). Mathur i in. (2018) podają przykład: RR = 1.33 daje E-wartość 2. Autorzy metody zalecają liczyć ją dwa razy (VanderWeele i Ding, 2017):
- dla oszacowania punktowego – jak silne zakłócenie sprowadziłoby RR do 1;
- dla granicy przedziału ufności bliższej 1 – jak silne zakłócenie sprawiłoby, że przedział obejmie 1. Jeśli przedział już obejmuje 1, ta E-wartość wynosi 1.
Wzór nie zakłada, że zakłócenie jest binarne ani że jest tylko jedno. Wynika z nierówności, którą Ding i VanderWeele (2016) wyprowadzili bez takich założeń (wracamy do niej w sekcji o współczynniku ograniczającym).
Przykład: samotność a depresja u seniorów
W kohorcie 3000 osób w wieku 65–85 lat sprawdzamy, czy przewlekła samotność na początku badania wiąże się z nowym epizodem depresji w ciągu dwóch lat. Samotność zgłosiło 770 osób, a depresja wystąpiła u 764 (25.5%). W modelu uwzględniono wiek, płeć, liczbę chorób przewlekłych, objawy depresyjne na starcie i mieszkanie w pojedynkę. Nie zmierzono neurotyczności, która sprzyja i samotności, i depresji. Dane są symulowane (set.seed(3261)), więc wiemy, jaki jest prawdziwy efekt: RR = 1.25. Plik e-wartosc-dane.csv zawiera dane bez neurotyczności, tak jak widziałby je badacz.
Ryzyko depresji wyniosło 22.7% u osób niesamotnych i 33.4% u samotnych. Ryzyko względne oszacowano regresją Poissona z odpornym błędem standardowym:
- bez korekty: RR = 1.47, 95% CI [1.29, 1.66];
- po korekcie o zmierzone zmienne: RR = 1.30, 95% CI [1.14, 1.48].
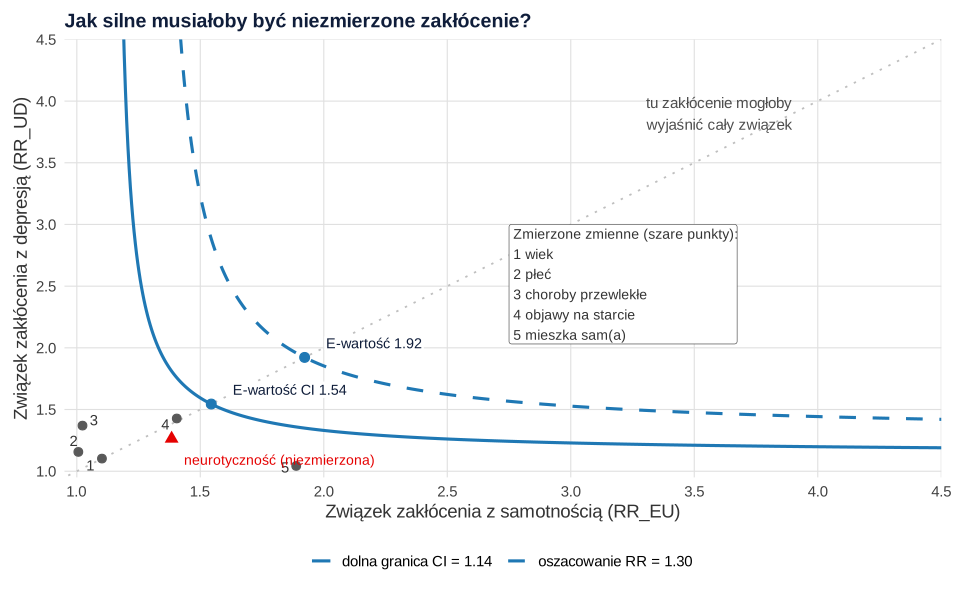
E-wartość dla oszacowania wynosi 1.92, a dla dolnej granicy przedziału – 1.54. Odczytanie: niezmierzone zakłócenie związane zarówno z samotnością, jak i z depresją ryzykiem względnym 1.92 mogłoby sprowadzić RR do 1. Słabsze nie mogłoby tego zrobić. Do przesunięcia przedziału tak, by objął 1, wystarczyłyby związki o sile 1.54.
Iloraz szans i iloraz hazardów
E-wartość jest określona na skali RR, ale wiele badań raportuje iloraz szans z regresji logistycznej albo iloraz hazardów z modelu Coxa. Reguły zależą od częstości wyniku:
- Wynik rzadki na końcu obserwacji (często przyjmuje się granicę 10%; VanderWeele, 2017): OR i HR przybliżają RR i podstawiasz je wprost do wzoru (Mathur i in., 2018). Ding i VanderWeele (2016) pokazują, że współczynnik ograniczający stosuje się wtedy także do HR.
- Wynik częsty, OR: OR odczytany jak RR wyolbrzymia efekt. VanderWeele (2017) proponuje jako przybliżenie RR pierwiastek z OR, np. OR = 4 daje 2.
- Wynik częsty, HR albo wynik ciągły: istnieją przybliżone przekształcenia, które liczą pakiet EValue i kalkulator online (Mathur i in., 2018). Nie podajemy tu ich wzorów, bo nie sprawdziliśmy ich w pełnym tekście źródła. Skorzystaj z narzędzia autorów i podaj w metodzie, jakiego przybliżenia użyłeś.
W naszym przykładzie depresja dotyczy co czwartej osoby. Regresja logistyczna daje OR = 1.47, 95% CI [1.21, 1.78]. Potraktowany jak RR, dałby E-wartość 2.30 (1.72 dla granicy przedziału), czyli obraz wyraźnie bardziej odporny niż w rzeczywistości. Pierwiastek z OR wynosi 1.21, 95% CI [1.10, 1.33], i daje E-wartości 1.72 i 1.43. Jest bliżej wyniku z RR, ale go nie odtwarza. Jeśli masz surowe dane, oszacuj RR wprost. Przeliczenia zostaw do wyników z cudzych publikacji.
E-wartości dla typowych wyników
Tabela pokazuje, jak liczyć E-wartość z wyników, które znajdziesz w artykułach. Wszystkie liczby policzono w R ze wzoru.
| Opublikowany wynik (95% CI) | RR do wzoru | E-wartość: oszacowanie | E-wartość: granica CI |
|---|---|---|---|
| RR = 1.10 [1.02, 1.19] | 1.10 | 1.43 | 1.16 |
| RR = 1.50 [1.20, 1.88] | 1.50 | 2.37 | 1.69 |
| RR = 3.00 [1.80, 5.00] | 3.00 | 5.45 | 3.00 |
| RR = 0.70 [0.55, 0.89] (efekt ochronny) | 1/0.70 | 2.21 | 1.50 |
| HR = 1.40 [1.15, 1.70], wynik rzadki | 1.40 | 2.15 | 1.57 |
| OR = 2.00 [1.40, 2.86], wynik częsty | √2.00 = 1.41 | 2.18 | 1.65 |
| RR = 1.25 [0.92, 1.70] | 1.25 | 1.81 | 1.00 |
Zwróć uwagę na dwie rzeczy. Przy efekcie ochronnym granicą bliższą 1 jest górna granica (0.89), a nie dolna. W ostatnim wierszu przedział obejmuje 1, więc E-wartość granicy wynosi 1: brak związku jest zgodny z danymi nawet bez żadnego zakłócenia.
Współczynnik ograniczający i konkretne scenariusze
E-wartość to jeden punkt: obie siły zakłócenia są równe. W praktyce zakłócenie może silnie wiązać się z wynikiem, a słabo z ekspozycją. Ding i VanderWeele (2016) pokazali, że zakłócenie o sile RREU (z ekspozycją) i RRUD (z wynikiem) może obniżyć obserwowane RR najwyżej przez podzielenie go przez:
Dzieląc RR i granice przedziału przez B, dostajesz najniższą wartość, do jakiej takie zakłócenie mogłoby zepchnąć efekt. W przykładzie przy RREU = RRUD = 1.5 mamy B = 1.12, więc RR spada najwyżej do 1.15, a dolna granica – do 1.02. Przy (2, 1.5) B = 1.20, RR = 1.08, a dolna granica 0.95 już obejmuje 1. Przy (2, 2) B = 1.33 i RR spada do 0.97, czyli efekt mógłby zniknąć. Zbiór takich par autorzy proponują pokazać na wykresie (rysunek 1).
Punkt odniesienia: zmierzone zmienne
Sama liczba 1.92 nic nie znaczy, dopóki nie wiesz, jak silne bywają zakłócenia w Twojej dziedzinie. VanderWeele i Mathur (2020) radzą podać obok siłę związków zmierzonych zmiennych z wynikiem (zmienne ciągłe można podzielić medianą). W przykładzie najsilniejsze są objawy depresyjne na starcie: RREU = 1.40, RRUD = 1.43 (B = 1.09). Mieszkanie w pojedynkę silnie wiąże się z samotnością (1.89), ale prawie wcale z depresją po korekcie (1.04). Żadna zmierzona zmienna nie zbliża się do krzywej, więc niezmierzony czynnik musiałby być silniejszy niż wszystko, co zmierzono.
Co pokazuje symulacja
W symulacji znamy neurotyczność. Po podziale medianą jej siła wynosi RREU = 1.38 i RRUD = 1.26 (B = 1.06), daleko od E-wartości. Mimo to po dodaniu jej do modelu RR spadło z 1.30 do 1.20, 95% CI [1.06, 1.37], blisko prawdziwego 1.25. To ważna lekcja: zakłócenie słabsze od E-wartości nie usuwa efektu, ale może go wyraźnie zmniejszyć. Spadek był większy, niż przewiduje B dla podziału medianą (1.30 / 1.06 = 1.22), bo neurotyczność jest ciągła. Parametry RREU i RRUD dotyczą największego ilorazu między dowolnymi jej poziomami (Ding i VanderWeele, 2016), a podział medianą tę siłę zaniża.
Ograniczenia i krytyka
Ioannidis i in. (2019) zwracają uwagę na kilka problemów:
- E-wartość rośnie monotonicznie i prawie liniowo z oszacowaniem (rysunek 2), więc nie dodaje informacji ponad sam efekt i jego przedział;
- nie ma ogólnej reguły, jaka E-wartość jest „wystarczająco duża”;
- dziedziczy problemy oszacowania: wybiórcze raportowanie, zależność od wybranego kontrastu ekspozycji i poziomu ufności;
- dotyczy tylko zakłócenia, a nie błędu selekcji czy błędu pomiaru;
- automatyczne liczenie może zwalniać z myślenia o zakłóceniu.
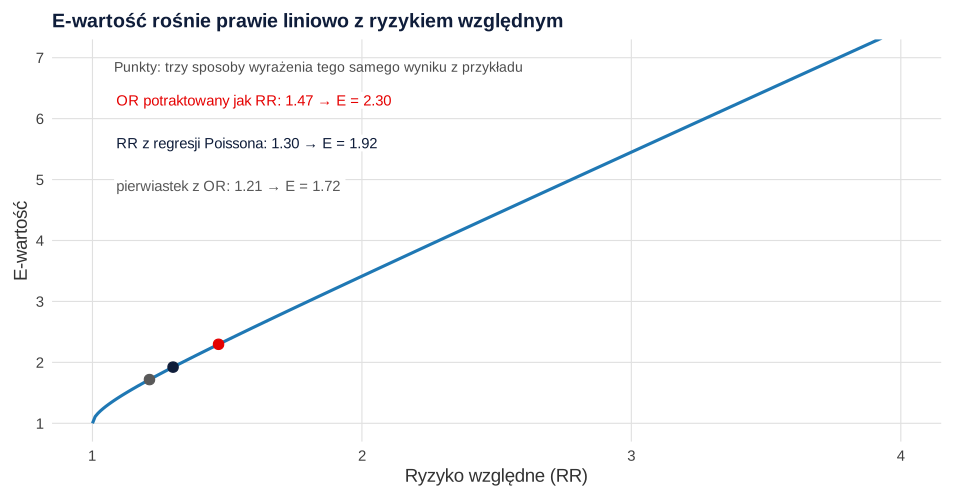
Blum i in. (2020) przejrzeli 87 artykułów z 516 E-wartościami. Tylko 14 uznało, że zakłócenie zagraża wnioskom, a 19 odniosło E-wartości do siły znanych zakłóceń. Mediany E-wartości były podobne niezależnie od tego, co autorzy wnioskowali. VanderWeele i Mathur (2020) odpowiadają, że E-wartość nie jest wolna od kontekstu: trzeba nazwać prawdopodobne niezmierzone zakłócenia, porównać ją ze zmierzonymi zmiennymi i zawsze podać wartość dla granicy przedziału.
Jeśli wynik jest ciągły i analizujesz regresję liniową, rozważ alternatywę opartą na cząstkowym R², z formalnym porównaniem ze zmierzonymi kowariantami (Cinelli i Hazlett, 2020). Błąd pomiaru zmiennej kontrolnej też zostawia rezydualne zakłócenie, o czym piszemy we wpisie o błędzie pomiaru w regresji.
Jak opisać E-wartość w artykule
W metodzie podaj, na jakiej skali policzono E-wartość i czy użyto przybliżenia (pierwiastek z OR, HR przy wyniku rzadkim). W wynikach podaj obie E-wartości. W dyskusji odnieś je do siły zmierzonych zmiennych i nazwij konkretne niezmierzone zakłócenia, a następnie opisz to w części o ograniczeniach badania. Listę elementów raportu badania obserwacyjnego znajdziesz we wpisie o wytycznych STROBE, CONSORT i TRIPOD.
Gdy recenzent kwestionuje analizę wrażliwości, przydadzą się gotowe zdania z poradnika odpowiedź recenzentom. Jeśli chcesz, żeby ktoś sprawdził cały plan analizy badania obserwacyjnego, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pakiet EValue nie jest potrzebny: E-wartość i współczynnik ograniczający liczymy ze wzorów, a odporne błędy standardowe – w pakiecie sandwich. Pierwszy przepis zapisuje plik e-wartosc-dane.csv.
1. Dane, ryzyko względne i iloraz szans
R
# Dane symulowane: samotność a nowy epizod depresji w ciągu 2 lat w kohorcie osób 65+ (set.seed(3261)).
# Zmienne zakłócające zmierzone: wiek, płeć, liczba chorób przewlekłych, objawy depresyjne na starcie (GDS-15),
# mieszkanie w pojedynkę. Neurotyczność (neuro) też wpływa na samotność i depresję, ale „nie została zmierzona”:
# trzymamy ją w danych tylko po to, by na końcu porównać E-wartość z prawdziwą siłą tego zakłócenia.
suppressPackageStartupMessages(library(sandwich))
set.seed(3261)
n <- 3000
wiek <- round(runif(n, 65, 85))
kobieta <- rbinom(n, 1, .58)
choroby <- rpois(n, 1.5)                                    # liczba chorób przewlekłych
neuro <- rnorm(n)                                           # neurotyczność (niezmierzona)
gds0 <- pmin(pmax(round(rnorm(n, 3.5 + 0.8 * neuro + 0.3 * choroby, 2)), 0), 15)
sam <- rbinom(n, 1, .32)                                    # mieszka sam(a)
samotnosc <- rbinom(n, 1, plogis(-1.6 + 1.0 * sam + 0.15 * (gds0 - 4) + 0.45 * neuro + 0.03 * (wiek - 75)))
ryzyko <- pmin(exp(log(.17) + log(1.25) * samotnosc + 0.09 * (gds0 - 4) + 0.10 * choroby +
                   0.25 * neuro + 0.015 * (wiek - 75) + 0.15 * kobieta), 1)   # prawdziwy RR samotności = 1.25
depresja <- rbinom(n, 1, ryzyko)
dane <- data.frame(id = 1:n, wiek, kobieta, choroby, gds0, sam, samotnosc, depresja)
write.csv(dane, "e-wartosc-dane.csv", row.names = FALSE)  # plik do pobrania (bez zmiennej neuro)

c(n = n, samotni = sum(samotnosc), depresja = sum(depresja)); round(mean(depresja), 3)
round(tapply(depresja, samotnosc, mean), 3)                 # ryzyko depresji: nie-samotni, samotni

# 1. Ryzyko względne: zmodyfikowana regresja Poissona (log-link) z odpornym SE (HC0)
rr_glm <- function(formula, d) {
  m <- glm(formula, family = poisson, data = d)
  se <- sqrt(diag(vcovHC(m, type = "HC0")))["samotnosc"]
  b <- coef(m)["samotnosc"]
  unname(exp(c(RR = b, dolny = b - 1.96 * se, gorny = b + 1.96 * se)))
}
rr_surowy <- rr_glm(depresja ~ samotnosc, dane)
rr_skor <- rr_glm(depresja ~ samotnosc + wiek + kobieta + choroby + gds0 + sam, dane)
round(rbind(surowy = rr_surowy, skorygowany = rr_skor), 2)

# 2. Iloraz szans z regresji logistycznej (te same zmienne) – wynik nie jest rzadki
m_or <- glm(depresja ~ samotnosc + wiek + kobieta + choroby + gds0 + sam, family = binomial, data = dane)
or_skor <- unname(exp(c(coef(m_or)["samotnosc"], confint.default(m_or)["samotnosc", ])))
round(or_skor, 2)
Wynik w R
       n  samotni depresja
    3000      770      764
[1] 0.255
    0     1
0.227 0.334
            [,1] [,2] [,3]
surowy      1.47 1.29 1.66
skorygowany 1.30 1.14 1.48
[1] 1.47 1.21 1.78
2. E-wartości, współczynnik ograniczający i punkt odniesienia
R
# E-wartość ze wzoru VanderWeele i Dinga (2017) – kontynuacja przepisu 1 (pakiet EValue nie jest potrzebny).
e_wartosc <- function(rr) {
  rr <- ifelse(rr < 1, 1 / rr, rr)                          # dla RR < 1 najpierw odwrotność
  rr + sqrt(rr * (rr - 1))
}
# E-wartość dla oszacowania i dla granicy CI bliższej 1 (gdy CI obejmuje 1, E-wartość granicy = 1)
e_ci <- function(est, dolny, gorny) {
  granica <- if (est >= 1) dolny else gorny
  e_gr <- if (dolny <= 1 && gorny >= 1) 1 else e_wartosc(granica)
  c(oszacowanie = e_wartosc(est), granica_CI = e_gr)
}
round(e_ci(rr_skor[1], rr_skor[2], rr_skor[3]), 2)          # analiza główna (RR)
round(e_ci(or_skor[1], or_skor[2], or_skor[3]), 2)          # błąd: OR potraktowany jak RR przy częstym wyniku
round(sqrt(or_skor), 2)                                     # pierwiastek z OR jako przybliżenie RR
round(e_ci(sqrt(or_skor[1]), sqrt(or_skor[2]), sqrt(or_skor[3])), 2)

# Tabela przykładów (wyniki „z publikacji”): RR, RR < 1, CI obejmujący 1, rzadki HR, OR przy częstym wyniku
przyklady <- data.frame(
  wynik = c("RR = 1.10 [1.02, 1.19]", "RR = 1.50 [1.20, 1.88]", "RR = 3.00 [1.80, 5.00]", "RR = 0.70 [0.55, 0.89]",
            "HR = 1.40 [1.15, 1.70], wynik rzadki", "OR = 2.00 [1.40, 2.86], wynik częsty"),
  est = c(1.10, 1.50, 3.00, 0.70, 1.40, sqrt(2.00)),        # przy częstym wyniku: pierwiastek z OR (VanderWeele, 2017)
  dolny = c(1.02, 1.20, 1.80, 0.55, 1.15, sqrt(1.40)),
  gorny = c(1.19, 1.88, 5.00, 0.89, 1.70, sqrt(2.86)))
e_tab <- t(mapply(e_ci, przyklady$est, przyklady$dolny, przyklady$gorny))
print(cbind(przyklady[1], RR = round(przyklady$est, 2), round(e_tab, 2)), row.names = FALSE)
round(e_ci(1.25, 0.92, 1.70), 2)                            # CI obejmuje 1

# Współczynnik ograniczający B (Ding i VanderWeele, 2016) i RR „po korekcie”
B <- function(rr_eu, rr_ud) rr_eu * rr_ud / (rr_eu + rr_ud - 1)
siatka <- expand.grid(RR_EU = c(1.5, 2, 3), RR_UD = c(1.5, 2, 3))
siatka$B <- B(siatka$RR_EU, siatka$RR_UD)
siatka$RR_po <- rr_skor[1] / siatka$B
siatka$dolny_po <- rr_skor[2] / siatka$B
print(round(siatka, 2), row.names = FALSE)

# Punkt odniesienia: siła związków zmierzonych zmiennych (podzielonych medianą, jeśli ciągłe)
dych <- with(dane, data.frame(wiek = as.integer(wiek > median(wiek)), kobieta, choroby = as.integer(choroby >= 2),
                              gds0 = as.integer(gds0 > median(gds0)), sam))
odniesienie <- t(sapply(names(dych), function(v) {
  x <- dych[[v]]
  p1 <- mean(x[dane$samotnosc == 1]); p0 <- mean(x[dane$samotnosc == 0])
  rr_eu <- max(p1 / p0, (1 - p1) / (1 - p0))                # max iloraz rozkładów zmiennej w grupach ekspozycji
  inne <- setdiff(names(dych), v)
  d2 <- cbind(dych, samotnosc = dane$samotnosc, depresja = dane$depresja)
  m <- glm(reformulate(c(v, "samotnosc", inne), "depresja"), family = poisson, data = d2)
  rr_ud <- exp(abs(coef(m)[v]))
  c(RR_EU = rr_eu, RR_UD = unname(rr_ud), B = B(rr_eu, unname(rr_ud)))
}))
round(odniesienie, 2)

# Co wiemy tylko w symulacji: siła niezmierzonej neurotyczności (wysoka = powyżej mediany) i RR po jej uwzględnieniu
neuro_wys <- as.integer(neuro > median(neuro))
p1 <- mean(neuro_wys[samotnosc == 1]); p0 <- mean(neuro_wys[samotnosc == 0])
rr_eu_n <- max(p1 / p0, (1 - p1) / (1 - p0))
m_n <- glm(depresja ~ neuro_wys + samotnosc + wiek + kobieta + choroby + gds0 + sam, family = poisson)
rr_ud_n <- unname(exp(coef(m_n)["neuro_wys"]))
round(c(RR_EU = rr_eu_n, RR_UD = rr_ud_n, B = B(rr_eu_n, rr_ud_n), RR_po_B = rr_skor[1] / B(rr_eu_n, rr_ud_n)), 2)
round(rr_glm(depresja ~ samotnosc + wiek + kobieta + choroby + gds0 + sam + neuro, cbind(dane, neuro)), 2)
Wynik w R
oszacowanie  granica_CI
       1.92        1.54
oszacowanie  granica_CI
       2.30        1.72
[1] 1.21 1.10 1.33
oszacowanie  granica_CI
       1.72        1.43
                                wynik   RR oszacowanie granica_CI
               RR = 1.10 [1.02, 1.19] 1.10        1.43       1.16
               RR = 1.50 [1.20, 1.88] 1.50        2.37       1.69
               RR = 3.00 [1.80, 5.00] 3.00        5.45       3.00
               RR = 0.70 [0.55, 0.89] 0.70        2.21       1.50
 HR = 1.40 [1.15, 1.70], wynik rzadki 1.40        2.15       1.57
 OR = 2.00 [1.40, 2.86], wynik częsty 1.41        2.18       1.65
oszacowanie  granica_CI
       1.81        1.00
 RR_EU RR_UD    B RR_po dolny_po
   1.5   1.5 1.12  1.15     1.02
   2.0   1.5 1.20  1.08     0.95
   3.0   1.5 1.29  1.01     0.89
   1.5   2.0 1.20  1.08     0.95
   2.0   2.0 1.33  0.97     0.86
   3.0   2.0 1.50  0.87     0.76
   1.5   3.0 1.29  1.01     0.89
   2.0   3.0 1.50  0.87     0.76
   3.0   3.0 1.80  0.72     0.63
        RR_EU RR_UD    B
wiek     1.10  1.10 1.01
kobieta  1.01  1.16 1.00
choroby  1.02  1.37 1.01
gds0     1.40  1.43 1.09
sam      1.89  1.04 1.02
  RR_EU   RR_UD       B RR_po_B
   1.38    1.26    1.06    1.22
[1] 1.20 1.06 1.37
3. To samo w pakiecie EValue (kod niewykonany)
R
# Wymaga pakietu EValue – kod niewykonany, bez wyników na tej stronie
library(EValue)
evalues.RR(est = 1.30, lo = 1.14, hi = 1.48)              # ryzyko względne
evalues.OR(est = 1.47, lo = 1.21, hi = 1.78, rare = FALSE) # OR przy częstym wyniku
evalues.HR(est = 1.40, lo = 1.15, hi = 1.70, rare = TRUE)  # HR przy rzadkim wyniku
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje glm(), confint.default() z pakietu stats) i pakietu sandwich (vcovHC()); rysunki przygotowano w pakietach ggplot2 i ggrepel.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
Najczęstsze błędy
- Tylko E-wartość dla oszacowania. Bez wartości dla granicy przedziału czytelnik nie wie, jak łatwo zakłócenie usunęłoby istotność.
- OR przy częstym wyniku podstawiony jak RR. W przykładzie zawyża E-wartość z 1.92 do 2.30.
- Próg „E > 2 to wynik odporny”. Takiego progu nie ma. Porównaj E-wartość ze zmierzonymi zmiennymi i z literaturą dziedziny.
- „E-wartość wykazała brak zakłócenia”. Pokazuje tylko, jak silne zakłócenie usunęłoby cały efekt. Słabsze może go wyraźnie zmniejszyć, jak w symulacji.
- E-wartość jako jedyna analiza wrażliwości. Nie dotyczy błędu selekcji, błędu pomiaru ani złego doboru kowariantów. Nie zastąpi też projektu badania i przemyślanego DAG ani zastrzeżeń, że korelacja to nie przyczynowość.
Najczęstsze pytania
Co oznacza E-wartość równa 2?
Niezmierzone zakłócenie związane zarówno z ekspozycją, jak i z wynikiem ryzykiem względnym 2 mogłoby całkowicie wyjaśnić obserwowany związek, a słabsze – nie. Nie znaczy to, że takiego zakłócenia nie ma ani że słabsze nie zmieni wyniku. Zakłócenie słabsze od E-wartości może wyraźnie zmniejszyć efekt.
Od jakiej E-wartości wynik badania obserwacyjnego można uznać za odporny?
Nie ma uniwersalnego progu. Autorzy metody celowo go nie podali, bo ocena zależy od dziedziny i od tego, co już uwzględniono w modelu. Porównaj E-wartość z siłą związków zmierzonych zmiennych z ekspozycją i wynikiem oraz z literaturą o prawdopodobnych zakłóceniach.
Czy można policzyć E-wartość dla ilorazu szans z regresji logistycznej?
Tak. Gdy wynik jest rzadki na końcu obserwacji, OR przybliża RR i podstawiasz go wprost do wzoru. Gdy wynik jest częsty, najpierw weź pierwiastek z OR jako przybliżenie RR (VanderWeele, 2017). Jeśli masz surowe dane, lepiej oszacuj RR wprost, np. regresją Poissona z odpornym błędem standardowym.
Dlaczego liczy się E-wartość dla granicy przedziału ufności?
Mówi, jak silne zakłócenie wystarczyłoby, by przedział objął brak efektu. Ta wartość jest zawsze mniejsza od E-wartości dla oszacowania i lepiej oddaje niepewność wyniku. Jeśli przedział już obejmuje 1, E-wartość granicy wynosi 1.
Jak policzyć E-wartość bez pakietu EValue?
Wystarczy jedna linijka: dla RR ≥ 1 policz RR + √(RR × (RR − 1)), a dla RR < 1 zastosuj ten sam wzór do 1/RR. Powtórz obliczenie dla granicy przedziału bliższej 1. Kod w R znajdziesz w sekcji Przykład w R.
Powiązane hasła
Przeczytaj też
Analiza wrażliwości w artykule naukowym
Jak dobrać warianty, policzyć je w R (braki danych, obserwacje odstające, specyfikacje), zbudować krzywą specyfikacji i opisać wyniki w artykule.
Czytaj →PoradnikPropensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →Recenzent pyta o niezmierzone zakłócenie w Twoim badaniu obserwacyjnym?
Pomożemy oszacować ryzyko względne, policzyć E-wartości i scenariusze zakłócenia oraz opisać analizę wrażliwości tak, żebyś mógł(a) ją samodzielnie obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Blum, M. R., Tan, Y. J., & Ioannidis, J. P. A. (2020). Use of E-values for addressing confounding in observational studies—an empirical assessment of the literature. International Journal of Epidemiology, 49(5), 1482–1494. https://doi.org/10.1093/ije/dyz261 ● Otwarty dostęp
- Cinelli, C., & Hazlett, C. (2020). Making sense of sensitivity: Extending omitted variable bias. Journal of the Royal Statistical Society Series B: Statistical Methodology, 82(1), 39–67. https://doi.org/10.1111/rssb.12348 ● Otwarty dostęp
- Ding, P., & VanderWeele, T. J. (2016). Sensitivity analysis without assumptions. Epidemiology, 27(3), 368–377. https://doi.org/10.1097/ede.0000000000000457 ● Otwarty dostęp
- Ioannidis, J. P. A., Tan, Y. J., & Blum, M. R. (2019). Limitations and misinterpretations of E-values for sensitivity analyses of observational studies. Annals of Internal Medicine, 170(2), 108–111. https://doi.org/10.7326/m18-2159
- Mathur, M. B., Ding, P., Riddell, C. A., & VanderWeele, T. J. (2018). Web site and R package for computing E-values. Epidemiology, 29(5), e45–e47. https://doi.org/10.1097/ede.0000000000000864 ● Otwarty dostęp: pełny tekst
- VanderWeele, T. J. (2017). On a square-root transformation of the odds ratio for a common outcome. Epidemiology, 28(6), e58–e60. https://doi.org/10.1097/ede.0000000000000733 ● Otwarty dostęp: pełny tekst
- VanderWeele, T. J., & Ding, P. (2017). Sensitivity analysis in observational research: Introducing the E-value. Annals of Internal Medicine, 167(4), 268–274. https://doi.org/10.7326/m16-2607 ● Otwarty dostęp: pełny tekst
- VanderWeele, T. J., & Mathur, M. B. (2020). Commentary: Developing best-practice guidelines for the reporting of E-values. International Journal of Epidemiology, 49(5), 1495–1497. https://doi.org/10.1093/ije/dyaa094 ● Otwarty dostęp
Cytowania BibTeX
@article{blum2020use, author={Blum, Manuel R. and Tan, Yuan Jin and Ioannidis, John P. A.}, title={{Use of E-values for addressing confounding in observational studies—an empirical assessment of the literature}}, journal={International Journal of Epidemiology}, year={2020}, volume={49}, number={5}, pages={1482--1494}, doi={10.1093/ije/dyz261}}@article{cinelli2020making, author={Cinelli, Carlos and Hazlett, Chad}, title={{Making sense of sensitivity: Extending omitted variable bias}}, journal={Journal of the Royal Statistical Society Series B: Statistical Methodology}, year={2020}, volume={82}, number={1}, pages={39--67}, doi={10.1111/rssb.12348}}@article{ding2016sensitivity, author={Ding, Peng and VanderWeele, Tyler J.}, title={{Sensitivity analysis without assumptions}}, journal={Epidemiology}, year={2016}, volume={27}, number={3}, pages={368--377}, doi={10.1097/ede.0000000000000457}}@article{ioannidis2019limitations, author={Ioannidis, John P. A. and Tan, Yuan Jin and Blum, Manuel R.}, title={{Limitations and misinterpretations of E-values for sensitivity analyses of observational studies}}, journal={Annals of Internal Medicine}, year={2019}, volume={170}, number={2}, pages={108--111}, doi={10.7326/m18-2159}}@article{mathur2018web, author={Mathur, Maya B. and Ding, Peng and Riddell, Corinne A. and VanderWeele, Tyler J.}, title={{Web site and R package for computing E-values}}, journal={Epidemiology}, year={2018}, volume={29}, number={5}, pages={e45--e47}, doi={10.1097/ede.0000000000000864}}@article{vanderweele2017square, author={VanderWeele, Tyler J.}, title={{On a square-root transformation of the odds ratio for a common outcome}}, journal={Epidemiology}, year={2017}, volume={28}, number={6}, pages={e58--e60}, doi={10.1097/ede.0000000000000733}}@article{vanderweele2017sensitivity, author={VanderWeele, Tyler J. and Ding, Peng}, title={{Sensitivity analysis in observational research: Introducing the E-value}}, journal={Annals of Internal Medicine}, year={2017}, volume={167}, number={4}, pages={268--274}, doi={10.7326/m16-2607}}@article{vanderweele2020commentary, author={VanderWeele, Tyler J. and Mathur, Maya B.}, title={{Commentary: Developing best-practice guidelines for the reporting of E-values}}, journal={International Journal of Epidemiology}, year={2020}, volume={49}, number={5}, pages={1495--1497}, doi={10.1093/ije/dyaa094}}