Co to jest iloraz hazardów?
Iloraz hazardów (ang. hazard ratio, HR) to stosunek hazardów w dwóch grupach, czyli chwilowego tempa występowania zdarzenia wśród osób, u których jeszcze do niego nie doszło. HR = 1 oznacza takie samo tempo, HR < 1 – wolniejsze, a HR > 1 – szybsze niż w grupie odniesienia. Stosuje się go w analizie przeżycia, gdy wynikiem jest czas do zdarzenia, np. nawrotu albo rezygnacji z terapii. Test log-rank mówi tylko, czy krzywe przeżycia się różnią; wielkość różnicy z przedziałem ufności opisuje dopiero HR (Bland i Altman, 2004).
HR w modelu Coxa
W modelu proporcjonalnych hazardów Coxa (1972) hazard jest iloczynem nieznanej funkcji czasu h0(t) i funkcji predyktorów, więc β to logarytm HR. Dla predyktora ilościowego HR opisuje zmianę tempa zdarzeń przy wzroście predyktora o jedną jednostkę, a w modelu z kilkoma predyktorami – przy stałych pozostałych. Model zakłada, że HR jest stały w czasie. Sprawdź to testem reszt Schoenfelda i na krzywych Kaplana–Meiera, które nie powinny się przecinać.
Przykład
Trzysta osób losowo przydzielono do 12-tygodniowego internetowego programu terapii z cotygodniowym kontaktem z terapeutą albo w formie samopomocy, po 150 osób (dane symulowane). Zrezygnowało odpowiednio 41 (27.3%) i 70 osób (46.7%). Model Coxa dał HR = 0.50, 95% CI [0.34, 0.74], p < .001: w każdym tygodniu programu osoby ze wsparciem rezygnowały w tempie mniej więcej o połowę niższym. Odwrotność, HR = 1.99, opisuje ten sam wynik z perspektywy samopomocy. Test założenia nie wskazał odstępstw, χ²(1) = 0.09, p = .768.
HR to nie ryzyko względne: iloraz odsetków rezygnacji po 12 tygodniach wynosi 27.3 / 46.7 = 0.59, a nie 0.50.
Na rysunku
Ten sam model Coxa dopasowano do dwóch zestawów danych. Panel A to dane z przykładu, w których hazard w obu grupach jest stały. W panelu B parametry ustawiono ręcznie tak, by hazard rósł w czasie w samopomocy, a malał przy wsparciu terapeuty. Ziarna nie zmieniano.
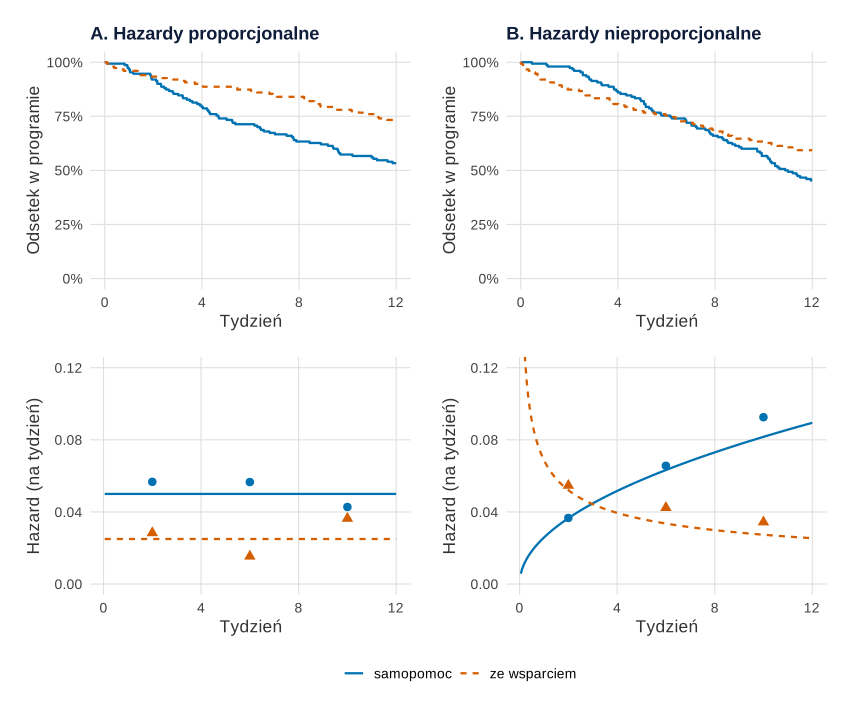
set.seed(861)).Co widać. W panelu A linie hazardu są poziome: hazard przy wsparciu jest w każdym tygodniu o połowę niższy. Model daje HR = 0.50, 95% CI [0.34, 0.74], a test reszt Schoenfelda nie wykrywa odstępstw, χ²(1) = 0.09, p = .768. W panelu B hazardy się przecinają. Iloraz hazardów z danych wynosi 1.49 w tygodniach 0–4, 0.65 w tygodniach 4–8 i 0.37 w tygodniach 8–12. Mimo to model zwraca jedną liczbę, HR = 0.74, 95% CI [0.53, 1.03], która nie opisuje żadnego z tych okresów. Test wykrywa brak proporcjonalności, χ²(1) = 14.82, p < .001 (zob. reszty Schoenfelda).
Na co uważać. Hazard z krótkich przedziałów jest bardzo niestabilny. W panelu A prawdziwy iloraz wynosi 0.5 w każdym tygodniu, a z danych wyszło kolejno 0.50, 0.27 i 0.85. Pojedynczy „dziwny” punkt nie dowodzi więc nieproporcjonalności. Krzywe przeżycia też nie pokazują hazardu wprost: w panelu B przewaga samopomocy na krzywej utrzymuje się jeszcze długo po tym, jak jej hazard stał się wyższy. Przy wyraźnym braku proporcjonalności podaj HR w okresach, model ze zmienną zależną od czasu albo różnicę RMST.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Ten sam model Coxa przy hazardach proporcjonalnych (A) i nieproporcjonalnych (B)
library(survival)
library(ggplot2)
library(patchwork)

kol <- c("samopomoc" = "#0072B2", "ze wsparciem" = "#D55E00")   # Okabe–Ito, czytelne przy deuteranopii
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(861)                                    # ziarno z przykładu w haśle, ustalone raz
n <- 150; grupa <- factor(rep(c("samopomoc", "ze wsparciem"), each = n))
# A: dane z przykładu – hazardy stałe w czasie (0.05 i 0.025 na tydzień, HR = 0.5)
t_A <- rexp(2 * n, rate = ifelse(grupa == "ze wsparciem", 0.025, 0.05))
# B: parametry dobrane ręcznie – hazard rosnący w samopomocy (Weibull, kształt 1.5),
#    malejący przy wsparciu (kształt 0.6), tak by krzywe przeżycia się przecięły
ksztalt <- c("samopomoc" = 1.5, "ze wsparciem" = 0.6); skala <- c("samopomoc" = 15, "ze wsparciem" = 37)
t_B <- rweibull(2 * n, shape = ksztalt[as.character(grupa)], scale = skala[as.character(grupa)])
dane <- rbind(data.frame(scen = "A", grupa, t = t_A), data.frame(scen = "B", grupa, t = t_B))
dane$czas <- pmin(dane$t, 12); dane$zd <- as.numeric(dane$t <= 12)   # program trwa 12 tygodni

# Model Coxa i test proporcjonalności w każdym scenariuszu
p_apa <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0", "", sprintf("%.3f", p)))
for (s in c("A", "B")) {
  m <- coxph(Surv(czas, zd) ~ grupa, data = subset(dane, scen == s))
  z <- cox.zph(m)$table
  cat(sprintf("Scenariusz %s: HR = %.2f [%.2f, %.2f], test Schoenfelda chi2(1) = %.2f, %s\n", s,
              exp(coef(m)), exp(confint(m))[1], exp(confint(m))[2], z[1, 1], p_apa(z[1, 3])))
}

# Krzywe Kaplana–Meiera jako schodki
km_df <- function(d) {
  f <- survfit(Surv(czas, zd) ~ grupa, data = d)
  g <- rep(levels(d$grupa), f$strata)
  rbind(data.frame(grupa = levels(d$grupa), czas = 0, S = 1), data.frame(grupa = g, czas = f$time, S = f$surv))
}
km <- do.call(rbind, lapply(c("A", "B"), function(s) cbind(scen = s, km_df(subset(dane, scen == s)))))

# Hazard z danych: zdarzenia / osobotygodnie w przedziałach 4-tygodniowych
brzegi <- seq(0, 12, 4)
haz <- do.call(rbind, lapply(split(dane, list(dane$scen, dane$grupa)), function(d) {
  do.call(rbind, lapply(1:3, function(i) {
    a <- brzegi[i]; b <- brzegi[i + 1]
    data.frame(scen = d$scen[1], grupa = d$grupa[1], srodek = (a + b) / 2,
               hazard = sum(d$zd == 1 & d$czas >= a & d$czas < b) / sum(pmax(0, pmin(d$czas, b) - a)))
  }))
}))
# Iloraz hazardów (ze wsparciem / samopomoc) w kolejnych przedziałach
ilorazy <- with(haz, tapply(hazard, list(scen, srodek, grupa), identity))
hr_okresy <- ilorazy[, , "ze wsparciem"] / ilorazy[, , "samopomoc"]
colnames(hr_okresy) <- c("tyg. 0-4", "tyg. 4-8", "tyg. 8-12")
round(hr_okresy, 2)

# Hazard teoretyczny (linie) – z parametrów symulacji
tt <- seq(0.05, 12, length.out = 200)
teor <- rbind(data.frame(scen = "A", grupa = rep(levels(grupa), each = 200), czas = tt,
                         hazard = rep(c(0.05, 0.025), each = 200)),
              data.frame(scen = "B", grupa = rep(levels(grupa), each = 200), czas = tt,
                         hazard = c(dweibull(tt, 1.5, 15) / pweibull(tt, 1.5, 15, lower.tail = FALSE),
                                    dweibull(tt, 0.6, 37) / pweibull(tt, 0.6, 37, lower.tail = FALSE))))

tytul <- c(A = "A. Hazardy proporcjonalne", B = "B. Hazardy nieproporcjonalne")
rysuj <- function(s) {
  g1 <- ggplot(subset(km, scen == s), aes(czas, S, colour = grupa, linetype = grupa)) +
    geom_step(linewidth = 0.8) +
    scale_y_continuous("Odsetek w programie", limits = c(0, 1), labels = function(x) paste0(100 * x, "%")) +
    scale_x_continuous("Tydzień", breaks = seq(0, 12, 4)) + labs(title = tytul[[s]])
  g2 <- ggplot(subset(haz, scen == s), aes(srodek, hazard, colour = grupa, shape = grupa)) +
    geom_line(data = subset(teor, scen == s), aes(czas, hazard, linetype = grupa), linewidth = 0.8) +
    geom_point(size = 2.6, show.legend = FALSE) +   # punkty: kółko = samopomoc, trójkąt = ze wsparciem
    scale_y_continuous("Hazard (na tydzień)", breaks = seq(0, 0.12, 0.04)) +
    coord_cartesian(ylim = c(0, 0.12)) +
    scale_x_continuous("Tydzień", breaks = seq(0, 12, 4))
  g1 / g2
}
p1 <- (rysuj("A") | rysuj("B")) + plot_layout(guides = "collect") &
  scale_colour_manual(NULL, values = kol) & scale_linetype_manual(NULL, values = c("solid", "22")) &
  scale_shape_manual(NULL, values = c(16, 17)) & motyw
p1
Wynik w R
Scenariusz A: HR = 0.50 [0.34, 0.74], test Schoenfelda chi2(1) = 0.09, p = .768
Scenariusz B: HR = 0.74 [0.53, 1.03], test Schoenfelda chi2(1) = 14.82, p < .001
  tyg. 0-4 tyg. 4-8 tyg. 8-12
A     0.50     0.27      0.85
B     1.49     0.65      0.37
Jak zapisać w pracy
Obok HR podaj odsetki zdarzeń w ustalonym momencie. Czytanie HR w badaniach klinicznych omawia poradnik statystyka dla lekarza, a raportowanie – statystyka w publikacji medycznej.
Na co uważać
- „HR = 0.50, czyli o połowę mniej rezygnacji”. HR porównuje tempo zdarzeń, a nie odsetek osób ze zdarzeniem na koniec obserwacji (tu 27.3% wobec 46.7%).
- Jeden HR przy nieproporcjonalnych hazardach. Gdy HR zmienia się w czasie, pojedyncza wartość jest rodzajem średniej z okresu obserwacji i zależy od jego długości. HR ma też wbudowane obciążenie selekcją, bo w kolejnych momentach porównuje tylko osoby jeszcze bez zdarzenia (Hernán, 2010).
- Wniosek przyczynowy bez losowego przydziału. W badaniu obserwacyjnym HR opisuje związek, który może wynikać ze zmiennych zakłócających.
Iloraz hazardów w R
Kod tworzy dane z przykładu, dopasowuje model Coxa w pakiecie survival i sprawdza założenie proporcjonalnych hazardów testem reszt Schoenfelda (cox.zph()). Liczby w tekście pochodzą z tego kodu.
Model Coxa: HR z 95% CI i proporcjonalność hazardów
R
library(survival)
set.seed(861)
grupa <- factor(rep(c("samopomoc", "ze wsparciem"), each = 150))         # samopomoc = grupa odniesienia
t_rez <- rexp(300, rate = ifelse(grupa == "ze wsparciem", 0.025, 0.05))  # tygodnie do rezygnacji
czas <- pmin(t_rez, 12); rezygnacja <- as.numeric(t_rez <= 12)          # program trwa 12 tygodni
table(grupa, rezygnacja)                                                  # 0 = ukończył program (obserwacja ucięta)
cox <- coxph(Surv(czas, rezygnacja) ~ grupa)
round(summary(cox)$coefficients, 4)                                       # exp(coef) = HR
round(summary(cox)$conf.int, 3)                                           # HR z 95% CI
cox.zph(cox)                                                              # test proporcjonalności hazardów
Wynik w R
              rezygnacja
grupa            0   1
  samopomoc     80  70
  ze wsparciem 109  41
                     coef exp(coef) se(coef)       z Pr(>|z|)
grupaze wsparciem -0.6901    0.5015    0.197 -3.5039    5e-04
                  exp(coef) exp(-coef) lower .95 upper .95
grupaze wsparciem     0.502      1.994     0.341     0.738
        chisq df    p
grupa  0.0868  1 0.77
GLOBAL 0.0868  1 0.77
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival; rysunek 1 – także pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Co oznacza iloraz hazardów mniejszy od 1?
W grupie porównywanej zdarzenie występuje wolniej niż w grupie odniesienia. HR = 0.50 oznacza, że w każdym momencie obserwacji tempo zdarzeń jest o połowę niższe, jeśli hazardy są proporcjonalne.
Czy iloraz hazardów to to samo co ryzyko względne?
Nie. Ryzyko względne porównuje odsetki osób ze zdarzeniem do ustalonego momentu, a HR – tempo zdarzeń w czasie. W przykładzie HR = 0.50, a iloraz odsetków rezygnacji po 12 tygodniach – 0.59.
Jak sprawdzić założenie proporcjonalnych hazardów?
Obejrzyj krzywe Kaplana–Meiera, które nie powinny się przecinać, i wykonaj test reszt Schoenfelda, w R: cox.zph(model). Istotny wynik oznacza, że jeden HR źle opisuje efekt w całym okresie obserwacji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikStatystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (2004). The logrank test. BMJ, 328(7447), 1073. https://doi.org/10.1136/bmj.328.7447.1073 ● Otwarty dostęp
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. https://doi.org/10.1097/ede.0b013e3181c1ea43 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bland2004logrank, author={Bland, J. Martin and Altman, Douglas G.}, title={{The logrank test}}, journal={BMJ}, year={2004}, volume={328}, number={7447}, pages={1073}, doi={10.1136/bmj.328.7447.1073}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{hernan2010hazards, author={Hernán, Miguel A.}, title={{The hazards of hazard ratios}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={13--15}, doi={10.1097/ede.0b013e3181c1ea43}}