Co to jest g-formuła?
G-formuła (ang. g-formula, g-computation, standaryzacja parametryczna) to sposób szacowania efektu przyczynowego w danych obserwacyjnych. Najpierw budujesz model wyniku zależny od ekspozycji i zmiennych zakłócających. Potem każdej osobie przypisujesz kolejno A = 1 i A = 0, liczysz przewidywane wyniki i uśredniasz je w całej próbie. Różnica tych średnich to oszacowanie przeciętnego efektu leczenia (ATE) w ujęciu modelu potencjalnych wyników. Snowden i in. (2011) pokazują tę procedurę krok po kroku na danych symulowanych i porównują ją ze zwykłą regresją.
Po co, skoro jest regresja?
Współczynnik regresji logistycznej to warunkowy iloraz szans, a g-formuła daje efekt brzegowy na wybranej skali – różnicę lub iloraz ryzyk dla całej populacji. Rachunek przypomina przeciętny efekt krańcowy, ale cel jest przyczynowy: najpierw nazywasz estymandę, potem ją szacujesz. Naimi i in. (2017) zaliczają g-formułę do metod g Robinsa, które dają zgodne oszacowania kontrastów potencjalnych wyników przy mniej restrykcyjnych warunkach identyfikacji niż standardowa regresja. Szczególnie przydają się przy ekspozycjach zmiennych w czasie.
Założenia
- Brak niezmierzonego zakłócenia (wymienność warunkowa).
- Dodatniość: w każdej warstwie zakłócaczy są osoby leczone i nieleczone.
- Poprawnie określony model wyniku – to główna słabość metody.
Alternatywą, która modeluje przydział zamiast wyniku, są wagi IPW. Połączenie obu modeli daje estymację podwójnie odporną, a jej odmianą jest TMLE.
Przykład
W symulacji 2000 osób leczenie podawano częściej chorym w cięższym stanie (L = 1). Surowa różnica ryzyk wyniosła −0.053, bo leczeni byli w gorszym stanie. G-formuła z modelem logistycznym dała ryzyko 0.271 przy leczeniu wszystkich i 0.408 bez leczenia, czyli różnicę −0.137, 95% CI [−0.177, −0.097] z bootstrapu. Prawdziwa różnica w symulacji wynosiła −0.120.
Na rysunku
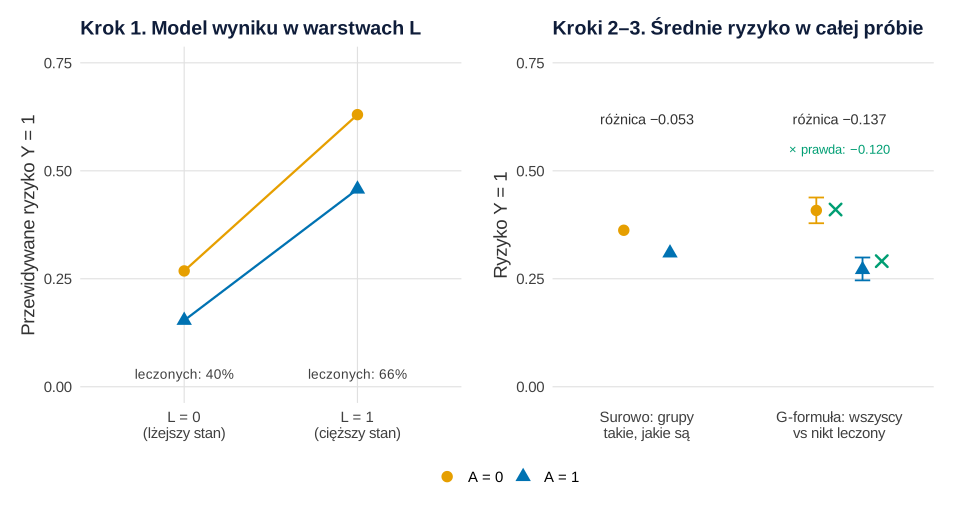
Co widać. W lewym panelu leczenie obniża przewidywane ryzyko w obu warstwach: z 0.268 do 0.154 przy L = 0 i z 0.630 do 0.458 przy L = 1. Leczonych jest jednak 40% w lżejszym stanie i 66% w cięższym, więc wśród leczonych L = 1 ma 51.3% osób, a wśród nieleczonych 26.0%. Surowe porównanie w prawym panelu (0.310 wobec 0.362, różnica −0.053) zestawia więc grupy o różnym stanie wyjściowym. G-formuła przypisuje każdej osobie najpierw A = 1, potem A = 0, i uśrednia przewidywania przy tym samym rozkładzie L w całej próbie (61.3% L = 0, 38.7% L = 1). Daje to ryzyka 0.271, 95% CI [0.246, 0.299], i 0.408 [0.379, 0.438] oraz różnicę −0.137. Prawdziwe ryzyka z parametrów symulacji to 0.291 i 0.410 (różnica −0.120); oba leżą w 95% przedziałach bootstrapowych.
Na co uważać. Przy jednym dwuwartościowym zakłócaczu g-formuła to zwykła standaryzacja, ta sama co w standaryzacji względem wieku. Przy wielu ciągłych zmiennych liczy się kształt modelu wyniku. Tu model bez interakcji A × L był poprawny, bo tak wygenerowano dane; w prawdziwych danych tego nie wiadomo. Rysunek nie pokazuje też zakłócaczy, których nie zmierzono. Jak zmienna zakłócająca odwraca porównanie surowe, pokazuje wpis Zmienna zakłócająca i collider – wizualizacja, a przedziały bootstrapowe – Bootstrap – wizualizacja na obrazkach. Dane, parametry i ziarno 58101 są te same co w przykładzie; niczego nie zmieniano.
Podpis do pracy:
Kod R rysunku 1
# Rysunek 1: g-formuła krok po kroku na danych z przykładu (te same dane i ten sam bootstrap)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(A0 = "#E69F00", A1 = "#0072B2", prawda = "#009E73")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        plot.background = element_rect(fill = "white", colour = NA))

set.seed(58101)                                  # dane i bootstrap jak w przykładzie
n <- 2000
L <- rbinom(n, 1, 0.4)
A <- rbinom(n, 1, plogis(-0.5 + 1.2 * L))
Y <- rbinom(n, 1, plogis(-1 - 0.6 * A + 1.5 * L))
d <- data.frame(L, A, Y)
gform <- function(d) {
  m <- glm(Y ~ A + L, family = binomial, data = d)
  r1 <- mean(predict(m, transform(d, A = 1), type = "response"))
  r0 <- mean(predict(m, transform(d, A = 0), type = "response"))
  c(ryzyko_A1 = r1, ryzyko_A0 = r0, roznica = r1 - r0)
}
est <- gform(d)
boot <- t(replicate(1000, gform(d[sample(n, replace = TRUE), ])))

# Krok 1: model wyniku; przewidywane ryzyko w każdej warstwie L przy A = 1 i A = 0
m <- glm(Y ~ A + L, family = binomial, data = d)
warstwy <- expand.grid(L = 0:1, A = 0:1)
warstwy$ryzyko <- predict(m, warstwy, type = "response")
warstwy$udzial_leczonych <- with(d, tapply(A, L, mean))[warstwy$L + 1]
warstwy$udzial_L <- with(d, mean(L == 1))^warstwy$L * with(d, mean(L == 0))^(1 - warstwy$L)
warstwy$grupa <- factor(warstwy$A, levels = 0:1, labels = c("A = 0", "A = 1"))
warstwy$stan <- factor(warstwy$L, levels = 0:1, labels = c("L = 0\n(lżejszy stan)", "L = 1\n(cięższy stan)"))
print(transform(warstwy[1:5], ryzyko = round(ryzyko, 3), udzial_leczonych = round(udzial_leczonych, 3),
                udzial_L = round(udzial_L, 3)), row.names = FALSE)

# Krok 2–3: średnie przewidywania w całej próbie (standaryzacja) vs surowe ryzyka w grupach
surowe <- with(d, tapply(Y, A, mean))
wyn <- data.frame(
  analiza = factor(rep(c("Surowo: grupy\ntakie, jakie są", "G-formuła: wszyscy\nvs nikt leczony"), each = 2),
                   levels = c("Surowo: grupy\ntakie, jakie są", "G-formuła: wszyscy\nvs nikt leczony")),
  A = factor(rep(c("A = 0", "A = 1"), 2)),
  ryzyko = c(surowe[["0"]], surowe[["1"]], est[["ryzyko_A0"]], est[["ryzyko_A1"]]),
  lo = c(NA, NA, quantile(boot[, "ryzyko_A0"], .025), quantile(boot[, "ryzyko_A1"], .025)),
  hi = c(NA, NA, quantile(boot[, "ryzyko_A0"], .975), quantile(boot[, "ryzyko_A1"], .975)))
prawda <- c(A0 = 0.6 * plogis(-1) + 0.4 * plogis(0.5), A1 = 0.6 * plogis(-1.6) + 0.4 * plogis(-0.1))
round(c(surowe_A0 = surowe[["0"]], surowe_A1 = surowe[["1"]], est[1:2],
        prawdziwe_A0 = prawda[["A0"]], prawdziwe_A1 = prawda[["A1"]]), 3)
round(c(udzial_L1_wsrod_leczonych = mean(d$L[d$A == 1]), udzial_L1_wsrod_nieleczonych = mean(d$L[d$A == 0])), 3)
print(data.frame(scenariusz = c("nikt leczony", "wszyscy leczeni"), ryzyko = round(wyn$ryzyko[3:4], 3),
                 ci_low = round(wyn$lo[3:4], 3), ci_high = round(wyn$hi[3:4], 3)), row.names = FALSE)

p_a <- ggplot(warstwy, aes(stan, ryzyko, colour = grupa, shape = grupa)) +
  geom_line(aes(group = grupa), linewidth = 0.8, show.legend = FALSE) +
  geom_point(size = 3.6) +
  geom_text(data = subset(warstwy, A == 1), aes(y = 0.03, label = sprintf("leczonych: %.0f%%", 100 * udzial_leczonych)),
            colour = "grey25", size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = unname(kol[c("A0", "A1")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_y_continuous(limits = c(0, 0.75), breaks = seq(0, 0.75, 0.25)) +
  labs(title = "Krok 1. Model wyniku w warstwach L", x = NULL, y = "Przewidywane ryzyko Y = 1") + motyw

wyn$x <- as.numeric(wyn$analiza) + ifelse(wyn$A == "A = 0", -0.12, 0.12)
pr <- data.frame(x = wyn$x[3:4] + 0.1, ryzyko = c(prawda[["A0"]], prawda[["A1"]]))
minus <- function(x) sub("-", "\u2212", sprintf("%.3f", x))
p_b <- ggplot(wyn, aes(x, ryzyko, colour = A, shape = A)) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = 0.08, na.rm = TRUE, show.legend = FALSE) +
  geom_point(size = 3.6) +
  geom_point(data = pr, aes(x, ryzyko), inherit.aes = FALSE,
             shape = 4, size = 3.2, stroke = 1.3, colour = kol[["prawda"]]) +
  annotate("text", x = 1:2, y = 0.62, size = 3.8, colour = "grey20",
           label = paste("różnica", minus(c(surowe[["1"]] - surowe[["0"]], est[["roznica"]])))) +
  annotate("text", x = 2, y = 0.55, size = 3.4, colour = kol[["prawda"]],
           label = paste("× prawda:", minus(prawda[["A1"]] - prawda[["A0"]]))) +
  scale_x_continuous(breaks = 1:2, labels = levels(wyn$analiza), limits = c(0.6, 2.4)) +
  scale_colour_manual(values = unname(kol[c("A0", "A1")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_y_continuous(limits = c(0, 0.75), breaks = seq(0, 0.75, 0.25)) +
  labs(title = "Kroki 2–3. Średnie ryzyko w całej próbie", x = NULL, y = "Ryzyko Y = 1") + motyw +
  theme(panel.grid.major.x = element_blank())

p1 <- p_a + p_b + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("g-formula-kroki.svg", p1, width = 10, height = 5.4)
Wynik w R
 L A ryzyko udzial_leczonych udzial_L
 0 0  0.268            0.397    0.613
 1 0  0.630            0.664    0.387
 0 1  0.154            0.397    0.613
 1 1  0.458            0.664    0.387
   surowe_A0    surowe_A1    ryzyko_A1    ryzyko_A0 prawdziwe_A0 prawdziwe_A1
       0.362        0.310        0.271        0.408        0.410        0.291
   udzial_L1_wsrod_leczonych udzial_L1_wsrod_nieleczonych
                       0.513                        0.260
      scenariusz ryzyko ci_low ci_high
    nikt leczony  0.408  0.379   0.438
 wszyscy leczeni  0.271  0.246   0.299
Rysunek na stronie powstał z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Jak opisać w pracy
G-formuła w R
Kod szacuje model wyniku, przewiduje ryzyko przy A = 1 i A = 0 dla wszystkich osób, uśrednia je i liczy przedział bootstrapowy. Na końcu podaje prawdziwą różnicę z parametrów symulacji.
Standaryzacja przewidywań i bootstrap
R
# G-formuła: standaryzacja przewidywań modelu wyniku (dane symulowane)
set.seed(58101)
n <- 2000
L <- rbinom(n, 1, 0.4)                          # czynnik zakłócający (np. cięższy stan)
A <- rbinom(n, 1, plogis(-0.5 + 1.2 * L))       # leczenie częstsze przy L = 1
Y <- rbinom(n, 1, plogis(-1 - 0.6 * A + 1.5 * L))
d <- data.frame(L, A, Y)
gform <- function(d) {
  m <- glm(Y ~ A + L, family = binomial, data = d)        # model wyniku
  r1 <- mean(predict(m, transform(d, A = 1), type = "response"))
  r0 <- mean(predict(m, transform(d, A = 0), type = "response"))
  c(ryzyko_A1 = r1, ryzyko_A0 = r0, roznica = r1 - r0)
}
naiwna <- with(d, mean(Y[A == 1]) - mean(Y[A == 0]))
est <- gform(d)
boot_rd <- replicate(1000, gform(d[sample(n, replace = TRUE), ])["roznica"])
round(c(naiwna_roznica = naiwna, est, ci_low = quantile(boot_rd, 0.025, names = FALSE),
        ci_high = quantile(boot_rd, 0.975, names = FALSE)), 3)
# prawdziwa różnica ryzyka w populacji (z parametrów symulacji, P(L = 1) = 0.4)
round(0.6 * (plogis(-1.6) - plogis(-1)) + 0.4 * (plogis(-0.1) - plogis(0.5)), 3)
Wynik w R
naiwna_roznica      ryzyko_A1      ryzyko_A0        roznica         ci_low
        -0.053          0.271          0.408         -0.137         -0.177
       ci_high
        -0.097
[1] -0.12
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów); rysunek wykonano w pakiecie ggplot2, panele połączono pakietem patchwork, a plik zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym g-formuła różni się od zwykłej regresji z kontrolą zmiennych?
Regresja podaje efekt warunkowy, np. iloraz szans przy stałych zakłócaczach. G-formuła używa tego modelu tylko do przewidywań i uśrednia je w całej próbie, więc daje efekt brzegowy, np. różnicę ryzyk dla populacji.
Jak policzyć przedział ufności dla g-formuły?
Najprościej bootstrapem: losujesz próby ze zwracaniem, w każdej powtarzasz dopasowanie modelu i standaryzację, a granice przedziału bierzesz z percentyli rozkładu oszacowań.
Kiedy g-formuła daje obciążony wynik?
Gdy pominięto ważny zakłócacz albo model wyniku jest źle określony, np. brakuje interakcji lub nieliniowości. Wtedy warto porównać wynik z wagami IPW lub estymatorem podwójnie odpornym.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Standaryzacja (g-computation): różnica ryzyk
Od ilorazu szans do różnicy ryzyk i RR: standaryzacja w R, bootstrap i metoda delta, ATE i ATT, nieskładalność OR i porównanie z IPW.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikPropensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Naimi, A. I., Cole, S. R., & Kennedy, E. H. (2017). An introduction to g methods. International Journal of Epidemiology, 46(2), 756–762. https://doi.org/10.1093/ije/dyw323 ● Otwarty dostęp
- Snowden, J. M., Rose, S., & Mortimer, K. M. (2011). Implementation of G-computation on a simulated data set: Demonstration of a causal inference technique. American Journal of Epidemiology, 173(7), 731–738. https://doi.org/10.1093/aje/kwq472 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{naimi2017introduction, author={Naimi, Ashley I. and Cole, Stephen R. and Kennedy, Edward H.}, title={{An introduction to g methods}}, journal={International Journal of Epidemiology}, year={2017}, volume={46}, number={2}, pages={756--762}, doi={10.1093/ije/dyw323}}@article{snowden2011implementation, author={Snowden, Jonathan M. and Rose, Sherri and Mortimer, Kathleen M.}, title={{Implementation of G-computation on a simulated data set: Demonstration of a causal inference technique}}, journal={American Journal of Epidemiology}, year={2011}, volume={173}, number={7}, pages={731--738}, doi={10.1093/aje/kwq472}}