Jedna tabela, pięć liczb – a tylko część z nich wolno podać
Masz dwie grupy i wynik typu tak/nie: odleżyna lub jej brak, powikłanie, przerwanie karmienia piersią. Z takiej tabeli krzyżowej kalkulator tabeli 2 × 2 policzy w kilka sekund ryzyko, różnicę ryzyk, ryzyko względne, iloraz szans i NNT. Program nie sprawdzi jednak, czy dana liczba ma sens w Twoim badaniu. O tym decyduje schemat badania, czyli sposób, w jaki osoby trafiły do tabeli. Druga rzecz to częstość zdarzenia: gdy zdarzenie jest częste, iloraz szans przestaje przypominać ryzyko względne.
Definicje i wzory znajdziesz w hasłach słownika, a rachunki do ćwiczenia w zbiorze zadań ze statystyki medycznej i w zadaniu 6 w zadaniach ze statystyki. Tutaj zajmujemy się decyzją: którą miarę wybrać, czego nie liczyć i jak to zapisać.
Przykład przewodni (wymyślony, dane symulowane, bez znaczenia klinicznego). W badaniu z losowym przydziałem 300 położnic trafiło po równo do telefonicznego wsparcia laktacyjnego albo opieki standardowej. Zdarzenie to przerwanie wyłącznego karmienia piersią przed końcem 6. tygodnia.
Tabela 2 × 2 i pięć miar
Ułóż tabelę zawsze tak samo: w wierszach grupa (badana u góry), w kolumnach zdarzenie (tak po lewej). Dzięki temu a, b, c, d znaczą to samo we wszystkich wzorach.
| Grupa | Przerwała | Nie przerwała | Razem | Ryzyko | Szansa |
|---|---|---|---|---|---|
| Wsparcie laktacyjne | a = 59 | b = 91 | 150 | 59/150 = 39.3% | 59/91 = 0.648 |
| Opieka standardowa | c = 78 | d = 72 | 150 | 78/150 = 52.0% | 78/72 = 1.083 |
Różnica jest statystycznie istotna, χ²(1, N = 300) = 4.85, p = .028, ale to tylko odpowiedź „czy”. Odpowiedź „jak bardzo” daje miara efektu, a z jednej tabeli powstaje ich kilka:
| Miara | Wzór | Wynik | 95% CI | Jak to przeczytać |
|---|---|---|---|---|
| Ryzyko w grupach | a/(a+b), c/(c+d) | 39.3% i 52.0% | – | Odsetek osób ze zdarzeniem do końca 6. tygodnia |
| Różnica ryzyk (RD) | ryzyko₁ − ryzyko₀ | −12.7 pp | [−23.8, −1.5] | O 12.7 punktu procentowego mniej przerwań |
| Ryzyko względne (RR) | ryzyko₁ / ryzyko₀ | 0.76 | [0.59, 0.97] | Ryzyko stanowi 76% ryzyka w grupie standardowej (o 24% niższe) |
| Iloraz szans (OR) | (a·d) / (b·c) | 0.60 | [0.38, 0.95] | Szansa przerwania jest o 40% niższa – nie ryzyko |
| NNT | 1 / ARR | 7.9 | [4.2, 67.3] | Około 8 kobiet objętych wsparciem na jedno dodatkowe uniknięte przerwanie w 6 tygodni |
RR i OR opisują ten sam wynik w innych jednostkach, a różnice są duże: przy zdarzeniu tak częstym jak tutaj RR mówi o spadku o 24%, a OR – o 40%. Różnica ryzyk i NNT dodają to, czego nie widać w miarach względnych: ile zdarzeń faktycznie ubywa. ARR i RRR to te same liczby pod innymi nazwami: ARR = 12.7 punktu, RRR = 1 − RR = 24.4%.
Która miara do którego schematu
Zadaj jedno pytanie: czy to badacz ustalił, ilu osób ze zdarzeniem jest w tabeli? Jeśli tak, odsetek zdarzeń w próbie nie jest ryzykiem i nie liczysz żadnej miary opartej na ryzyku.
| Schemat | Jak osoby trafiają do tabeli | Co mówi odsetek zdarzeń | Podaj | Nie podawaj |
|---|---|---|---|---|
| Eksperyment z losowym przydziałem (RCT) | Losowo do grup, potem obserwacja wyniku | Ryzyko | Ryzyka, RR i RD razem; NNT jako dodatek | Samego RR bez miary bezwzględnej |
| Kohorta | Według ekspozycji, potem obserwacja | Ryzyko (przy podobnym czasie obserwacji) | Ryzyka, RR, RD; przy różnym czasie – współczynniki zapadalności | NNT bez zastrzeżenia, że związek może być zakłócony |
| Kliniczno-kontrolne | Według wyniku: badacz dobiera przypadki i kontrole | Nic – zależy od liczby dobranych kontroli | Tylko OR | Ryzyka, RR, RD, NNT |
| Przekrojowe | Jeden pomiar ekspozycji i wyniku | Chorobowość, nie ryzyko | Chorobowość, iloraz chorobowości (PR), różnica chorobowości | Słowa „ryzyko”, NNT |
Przy RCT wytyczne są jednoznaczne: CONSORT 2025 zaleca przy wyniku binarnym podawać miarę względną i bezwzględną z przedziałami ufności, bo samo ryzyko względne prowadzi do przeceniania efektu, a NNT traktuje jako pomocny dodatek (Hopewell i in., 2025). Listę dla swojego schematu wybierzesz we wpisie STROBE, CONSORT i TRIPOD. W kohorcie liczysz te same miary, ale każda opisuje związek, nie efekt: przed „NNT” stoi założenie, że usunięcie ekspozycji usunęłoby nadmiar zdarzeń, a czynniki zakłócające mogą to założenie obalić. Szczegóły czasu obserwacji i zapadalności opisuje wpis badanie kohortowe w pracy dyplomowej.
Dlaczego w badaniu kliniczno-kontrolnym tylko iloraz szans
W tym schemacie zaczynasz od wyniku: zbierasz przypadki, a kontrole dobierasz z tej samej populacji, niezależnie od badanej ekspozycji (Schulz i Grimes, 2002). Liczbę kontroli wybierasz sam(a), więc to Ty ustalasz odsetek „chorych” w tabeli. Można porównać szanse ekspozycji u przypadków i kontroli, a matematycznie iloraz szans jest taki sam, niezależnie od tego, czy porównasz szanse ekspozycji, czy szanse zdarzenia. Ryzyka policzyć się nie da.
Symulacja to pokazuje. W sztucznej populacji 200 000 pacjentów po operacji cukrzyca występowała u około 25%, a zakażenie rany wystąpiło u 9.94% osób z cukrzycą i 4.95% bez niej: prawdziwe RR = 2.01, OR = 2.12. Z tej populacji wylosowaliśmy 300 przypadków i 600 kontroli. Cukrzycę miało 118 przypadków (39.3%) i 144 kontrole (24.0%), więc OR = 2.05, 95% CI [1.52, 2.77]. Gdyby policzyć „ryzyko” z wierszy, wyszłoby 45.0% wobec 28.5%, czyli rzekome RR = 1.58. Rysunek 1 pokazuje, że ta liczba zależy od decyzji badacza: przy 4000 powtórzeń „RR” wynosiło 1.42 przy kontrolach 1:1, 1.61 przy 1:2, 1.79 przy 1:4 i 1.92 przy 1:8, a OR za każdym razem około 2.12.
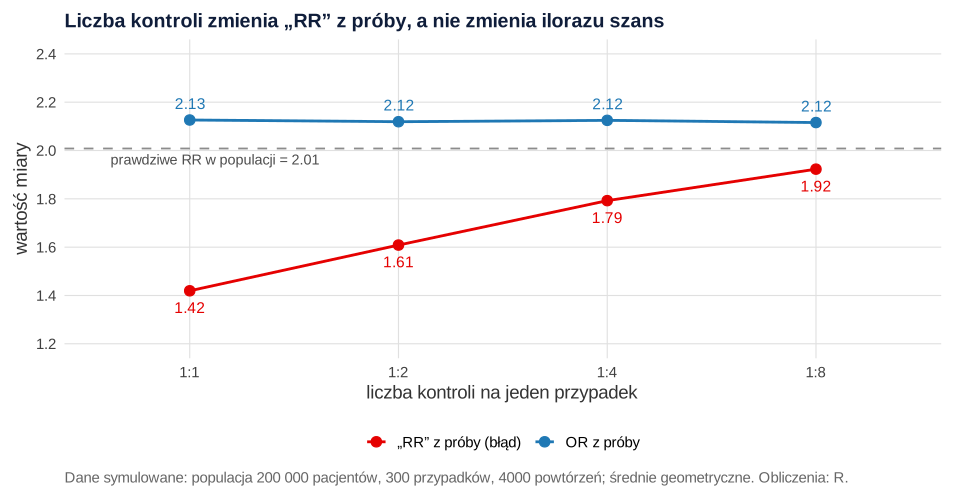
Tu zdarzenie jest dość rzadkie, więc OR leży blisko RR. Nie jest to reguła: przy częstym zdarzeniu OR z tej samej populacji oddali się od RR, o czym w następnej sekcji. Dobór kontroli, dopasowanie i analizę opisuje wpis badanie kliniczno-kontrolne krok po kroku.
Badanie przekrojowe: iloraz chorobowości
Ankieta jednorazowa pokazuje, kto ma daną cechę, a nie u kogo wystąpiła ona w czasie obserwacji. Dlatego liczysz chorobowość, a porównanie grup zapisujesz jako PR (iloraz chorobowości). Wzór i przedział są identyczne jak przy RR, inne jest tylko to, czego dotyczą. W symulowanej ankiecie ból krzyża zgłosiło 90 z 240 pielęgniarek z dyżurami nocnymi (37.5%) i 92 z 360 bez dyżurów (25.6%): PR = 1.47, 95% CI [1.15, 1.87], różnica 11.9 punktu procentowego, 95% CI [4.3, 19.5].
Z tych samych danych iloraz szans chorobowości (POR) wynosi 1.75. Thompson i in. (1998) pokazali, że POR trudno interpretować bez restrykcyjnych założeń, a gdy PR > 1, POR jest zawsze od niego większy. W pracy podaj więc PR, a jeżeli używasz regresji logistycznej, wyraźnie napisz „iloraz szans chorobowości”. Przykład z korektą na wiek znajdziesz we wpisie o statystyce w pracy ze zdrowia publicznego.
OR a RR, gdy zdarzenie jest częste
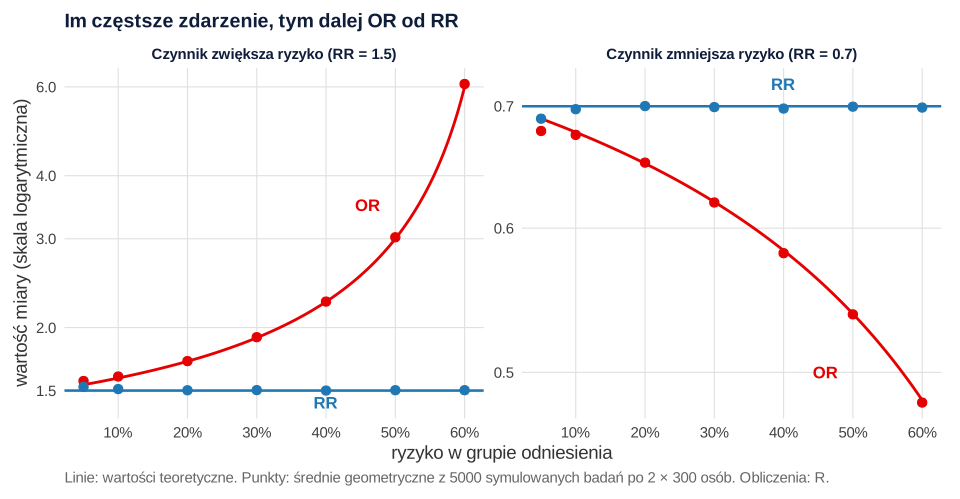
Iloraz szans czytany jak ryzyko względne zawsze przecenia efekt: jest większy od RR, gdy OR > 1, i mniejszy, gdy OR < 1, a rozbieżność rośnie wraz z ryzykiem wyjściowym i siłą związku (Davies i in., 1998). Zhang i Yu (1998) oraz McNutt i in. (2003) za granicę przyjmują częstość około 10%: powyżej niej OR przestaje przybliżać RR. Davies i in. dodają, że poważna rozbieżność dotyczy dużych efektów w grupach wysokiego ryzyka, więc nie każdy OR przy częstym zdarzeniu jest bezwartościowy. Problem pojawia się, gdy opisujesz go słowami o ryzyku.
W symulacji ustaliliśmy prawdziwe RR (1.5 albo 0.7) i zmienialiśmy ryzyko w grupie odniesienia od 5% do 60%, po 5000 badań z 2 × 300 osobami dla każdej wartości. RR trafiało w prawdę niezależnie od częstości zdarzenia, a OR nie (rysunek 2).
| Ryzyko w grupie odniesienia | OR przy RR = 1.5 | 95% CI dla OR obejmuje RR = 1.5 | OR przy RR = 0.7 | 95% CI dla OR obejmuje RR = 0.7 |
|---|---|---|---|---|
| 5% | 1.54 | 95.0% prób | 0.69 | 95.9% |
| 10% | 1.59 | 94.6% | 0.68 | 95.2% |
| 20% | 1.71 | 90.1% | 0.65 | 94.8% |
| 30% | 1.91 | 71.7% | 0.62 | 90.1% |
| 50% | 3.00 | 2.1% | 0.54 | 64.6% |
Trzecia i piąta kolumna mówią to, co zwykle umyka. Przedział dla OR jest poprawnym przedziałem dla OR, ale jeśli przeczytasz go jak przedział dla RR, przy częstym zdarzeniu chybi. Przy ryzyku wyjściowym 50% i prawdziwym RR = 1.5 tylko w 2.1% badań przedział OR obejmował 1.5. Przedział liczony dla RR obejmował prawdziwą wartość w 94.6–95.9% badań we wszystkich wariantach symulacji, jak powinien.
Znając ryzyko w grupie odniesienia, surowy OR przeliczysz na RR wzorem Zhanga i Yu: RR = OR / (1 − r0 + r0 · OR). W przykładzie: 0.598 / (1 − 0.520 + 0.520 · 0.598) = 0.756, czyli tyle, ile RR z tabeli. Działa to jednak dokładnie tylko bez innych zmiennych w modelu. McNutt i in. (2003) krytykują stosowanie tego wzoru do skorygowanych OR, zwłaszcza że istnieją metody, które szacują RR wprost.
Przedziały ufności
Dla RR i OR liczysz przedział ufności na skali logarytmicznej i wracasz do skali wyjściowej. Metodę logarytmiczną dla RR zalecili Katz i in. (1978) na podstawie symulacji:
W przykładzie ln RR = −0.279, SE = 0.128, co daje [0.59, 0.97]. Przedział jest niesymetryczny wokół RR i tak powinien wyglądać. Dla OR wynik jest identyczny z przedziałem Walda z regresji logistycznej bez dodatkowych zmiennych. Dla różnicy ryzyk prosty przedział Walda daje [−23.8, −1.5] punktu procentowego; w małych próbach albo przy odsetkach bliskich 0 lub 100% użyj przedziału Newcombe’a, a porównanie odsetków w całości opisuje wpis jak porównać odsetki w dwóch grupach. Gdy jedna z komórek wynosi 0, wzory logarytmiczne nie działają: dodaj 0.5 do wszystkich komórek albo sięgnij po test dokładny Fishera i metody dokładne.
NNT: granice to odwrotności granic ARR
Przedział dla NNT powstaje przez odwrócenie granic przedziału dla bezwzględnej różnicy ryzyk (Altman, 1998). Tu ARR = 12.7 punktu, 95% CI [1.5, 23.8], więc NNT = 7.9, 95% CI [4.2, 67.3]. Szerokość jest ogromna, bo dolna granica ARR leży tuż nad zerem: 1 / 0.015 to już około 67 kobiet. Czytelnikowi podaj NNT zaokrąglone w górę, tu 8; w tabeli wystarczy jedno miejsce po przecinku. NNT zawsze opisuj z horyzontem czasowym i rodzajem grupy porównawczej, bo zmieniając je, zmieniasz liczbę. Zależy ona też od ryzyka wyjściowego: przy tym samym RR = 0.70 NNT wynosi 66.7 przy ryzyku 5%, 16.7 przy 20% i 6.7 przy 50%. Jak czytać NNT w cudzych badaniach, wyjaśnia statystyka dla lekarza.
NNT, gdy przedział różnicy ryzyk obejmuje zero
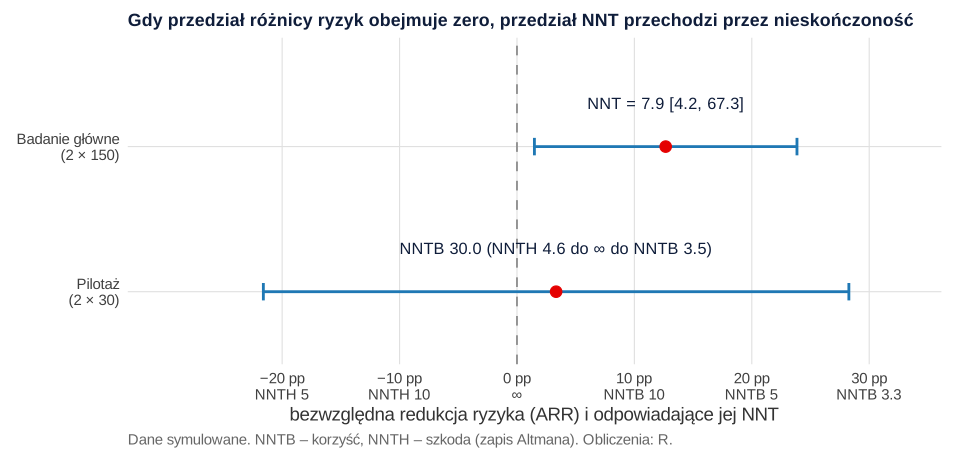
W pilotażu tego samego programu (2 × 30 osób) przerwało 12 kobiet w grupie wsparcia (40.0%) i 13 w grupie standardowej (43.3%). ARR = 3.3 punktu procentowego, 95% CI [−21.6, 28.3]. Punktowo wychodzi NNT = 30, ale granice ARR leżą po dwóch stronach zera, a przy zerowej różnicy NNT jest nieskończone. Zapis „NNT = 30, 95% CI [−4.6, 3.5]” nie ma sensu i wygląda, jakby 30 leżało poza przedziałem. Altman (1998) zaproponował oznaczenia NNTB (korzyść) i NNTH (szkoda), które w tym przykładzie dają zapis NNTB 30.0 (NNTH 4.6 do ∞ do NNTB 3.5). Rysunek 3 pokazuje, jak jedna ciągła oś ARR przekłada się na tę nietypową skalę. Często uczciwiej jest w ogóle nie eksponować NNT i podać samo ARR z przedziałem. Więcej w haśle o NNH.
Gdy w modelu są zmienne kontrolne
Wszystko powyżej dotyczy tabeli bez korekty. Po dołączeniu zmiennych kontrolnych regresja logistyczna daje skorygowany OR, którego nadal nie wolno czytać jak ryzyka. Przy częstym zdarzeniu masz trzy drogi:
- Skorygowane RR lub PR – zmodyfikowana regresja Poissona z odpornym błędem (Zou, 2004) albo model log-dwumianowy.
- Skorygowana różnica ryzyk i NNT – standaryzacja z modelu; pokazujemy ją krok po kroku we wpisie standaryzacja (g-computation).
- Skorygowany OR – jeśli chcesz zostać przy regresji logistycznej, zostaw go, ale pisz o szansach.
Gotowe zdania do pracy
Zawsze podaj liczebności i odsetki, potem miarę z przedziałem i kierunek. Wpisz grupę odniesienia i horyzont czasowy. Metodę możesz opisać jednym zdaniem:
Eksperyment z losowym przydziałem:
Badanie kliniczno-kontrolne (bez słowa „ryzyko”):
Badanie przekrojowe:
NNT, gdy przedział obejmuje zero:
Najczęstsze błędy
- „OR = 0.60, czyli ryzyko spadło o 40%”. Spadły szanse; ryzyko spadło o 24%.
- RR z badania kliniczno-kontrolnego. Liczba zależy od tego, ile kontroli dobrałeś(-aś).
- Samo RR. RR = 0.76 to zarówno spadek z 52% do 39%, jak i z 1% do 0.8%. Pokaż ryzyka i różnicę.
- NNT bez horyzontu i bez nazwy grupy porównawczej.
- NNT przy przedziale ARR obejmującym zero podane jako zwykły przedział z liczbami ujemnymi.
- „Ryzyko” w badaniu przekrojowym. Masz chorobowość, więc piszesz PR albo POR.
- 1 − OR jako RRR. Względna redukcja ryzyka to 1 − RR.
- Przeliczanie skorygowanego OR wzorem na RR. Lepiej oszacować RR wprost.
- RR bez uwzględnienia różnego czasu obserwacji. Wtedy porównuj współczynniki zapadalności.
Jeżeli promotor pyta, dlaczego podano akurat tę miarę, odwołaj się do schematu badania. Jeśli wolisz policzyć tabelę bez kodu, użyj kalkulatora tabeli 2 × 2. Jeśli chcesz, by ktoś sprawdził z Tobą dobór miary i zapis wyników, zobacz pomoc w analizie dla studentów.
RR, OR i NNT w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy dane badania z przydziałem losowym i zapisuje je w pliku CSV w folderze nadrzędnym (../), drugi dotyczy badania kliniczno-kontrolnego i przekrojowego, trzeci to symulacja porównująca OR z RR. Przepisy uruchamiaj po kolei z jednego folderu. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane możesz pobrać: ryzyko-wzgledne-iloraz-szans-nnt-dane.csv (300 kobiet: identyfikator, grupa, przerwanie 0/1).
Tabela 2 × 2, pięć miar, pilotaż i NNT
R
# B450 – jedna tabela 2 × 2, pięć miar: ryzyko, różnica ryzyk, RR, OR, NNT z 95% CI
# Dane symulowane: badanie z losowym przydziałem, po 150 położnic w grupie.
set.seed(4501)

n <- 150
dane <- data.frame(id = 1:(2 * n),
                   grupa = factor(rep(c("wsparcie", "standard"), each = n),
                                  levels = c("standard", "wsparcie")))
# Zdarzenie: przerwanie wyłącznego karmienia piersią przed końcem 6. tygodnia (1 = tak)
dane$przerwanie <- rbinom(2 * n, 1, ifelse(dane$grupa == "wsparcie", .34, .50))
write.csv(dane, "../ryzyko-wzgledne-iloraz-szans-nnt-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

miary_2x2 <- function(a, n1, c, n0, poziom = .95) {
  # a z n1 – zdarzenia w grupie badanej; c z n0 – w grupie odniesienia
  b <- n1 - a; d <- n0 - c; z <- qnorm(1 - (1 - poziom) / 2)
  r1 <- a / n1; r0 <- c / n0
  rd <- r1 - r0                                   # różnica ryzyk (badana − odniesienia)
  se_rd <- sqrt(r1 * (1 - r1) / n1 + r0 * (1 - r0) / n0)
  ci_rd <- rd + c(-1, 1) * z * se_rd
  rr <- r1 / r0
  se_lrr <- sqrt(1 / a - 1 / n1 + 1 / c - 1 / n0)  # metoda log (Katz i in., 1978)
  ci_rr <- exp(log(rr) + c(-1, 1) * z * se_lrr)
  or <- (a * d) / (b * c)
  se_lor <- sqrt(1 / a + 1 / b + 1 / c + 1 / d)
  ci_or <- exp(log(or) + c(-1, 1) * z * se_lor)
  list(a = a, b = b, c = c, d = d, r1 = r1, r0 = r0, rd = rd, ci_rd = ci_rd, se_rd = se_rd,
       rr = rr, se_lrr = se_lrr, ci_rr = ci_rr, or = or, se_lor = se_lor, ci_or = ci_or)
}

pokaz <- function(m) {
  cat(sprintf("a = %d, b = %d, c = %d, d = %d\n", m$a, m$b, m$c, m$d))
  cat(sprintf("Ryzyko: grupa badana %.3f, grupa odniesienia %.3f\n", m$r1, m$r0))
  cat(sprintf("Szansa: grupa badana %.3f, grupa odniesienia %.3f\n", m$a / m$b, m$c / m$d))
  cat(sprintf("Różnica ryzyk = %.3f, 95%% CI [%.3f, %.3f], SE = %.4f\n", m$rd, m$ci_rd[1], m$ci_rd[2], m$se_rd))
  cat(sprintf("RR = %.3f, ln RR = %.3f, 95%% CI [%.3f, %.3f], SE(ln RR) = %.4f\n", m$rr, log(m$rr), m$ci_rr[1], m$ci_rr[2], m$se_lrr))
  cat(sprintf("OR = %.3f, 95%% CI [%.3f, %.3f], SE(ln OR) = %.4f\n", m$or, m$ci_or[1], m$ci_or[2], m$se_lor))
  cat(sprintf("1 - RR (względna redukcja ryzyka) = %.3f\n", 1 - m$rr))
  arr <- -m$rd; g <- sort(-m$ci_rd)              # ARR = ryzyko odniesienia − ryzyko badane
  cat(sprintf("ARR = %.3f, 95%% CI [%.3f, %.3f]\n", arr, g[1], g[2]))
  if (g[1] > 0) {
    cat(sprintf("NNT = %.2f, 95%% CI [%.2f, %.2f]\n", 1 / arr, 1 / g[2], 1 / g[1]))
  } else {
    cat(sprintf("NNT punktowe = %.2f; przedział ARR obejmuje 0:\n", 1 / arr))
    cat(sprintf("  NNTB %.1f (NNTH %.1f do nieskończoności do NNTB %.1f)\n", 1 / arr, 1 / abs(g[1]), 1 / g[2]))
  }
}

tab <- table(dane$grupa, dane$przerwanie)
print(tab)
glowne <- miary_2x2(tab["wsparcie", "1"], n, tab["standard", "1"], n)
cat("\nBadanie główne (2 × 150):\n"); pokaz(glowne)

ch <- chisq.test(tab, correct = FALSE)
cat(sprintf("chi^2(%d, N = %d) = %.2f, p = %s\n", ch$parameter, sum(tab), ch$statistic,
            sub("^0", "", sprintf("%.3f", ch$p.value))))

# Sprawdzenie: OR z regresji logistycznej bez kowariantów to OR z tabeli
fit <- glm(przerwanie ~ grupa, family = binomial, data = dane)
cat(sprintf("Regresja logistyczna: OR = %.3f, 95%% CI (Wald) [%.3f, %.3f]\n", exp(coef(fit)[2]),
            exp(confint.default(fit)[2, 1]), exp(confint.default(fit)[2, 2])))

# Pilotaż tego samego programu: 2 × 30 osób
set.seed(45011)
a_p <- rbinom(1, 30, .34); c_p <- rbinom(1, 30, .50)
cat("\nPilotaż (2 × 30):\n"); pokaz(miary_2x2(a_p, 30, c_p, 30))

# NNT przy tym samym RR i różnym ryzyku w grupie odniesienia
cat("\nTo samo RR = 0.70, różne ryzyko w grupie odniesienia:\n")
r0 <- c(.05, .20, .50)
print(data.frame(ryzyko_odniesienia = r0, ryzyko_badane = .7 * r0, ARR = .3 * r0, NNT = round(1 / (.3 * r0), 1)),
      row.names = FALSE)
Wynik w R
            0  1
  standard 72 78
  wsparcie 91 59

Badanie główne (2 × 150):
a = 59, b = 91, c = 78, d = 72
Ryzyko: grupa badana 0.393, grupa odniesienia 0.520
Szansa: grupa badana 0.648, grupa odniesienia 1.083
Różnica ryzyk = -0.127, 95% CI [-0.238, -0.015], SE = 0.0571
RR = 0.756, ln RR = -0.279, 95% CI [0.588, 0.972], SE(ln RR) = 0.1282
OR = 0.598, 95% CI [0.378, 0.946], SE(ln OR) = 0.2338
1 - RR (względna redukcja ryzyka) = 0.244
ARR = 0.127, 95% CI [0.015, 0.238]
NNT = 7.89, 95% CI [4.19, 67.35]
chi^2(1, N = 300) = 4.85, p = .028
Regresja logistyczna: OR = 0.598, 95% CI (Wald) [0.378, 0.946]

Pilotaż (2 × 30):
a = 12, b = 18, c = 13, d = 17
Ryzyko: grupa badana 0.400, grupa odniesienia 0.433
Szansa: grupa badana 0.667, grupa odniesienia 0.765
Różnica ryzyk = -0.033, 95% CI [-0.283, 0.216], SE = 0.1272
RR = 0.923, ln RR = -0.080, 95% CI [0.507, 1.681], SE(ln RR) = 0.3059
OR = 0.872, 95% CI [0.312, 2.435], SE(ln OR) = 0.5241
1 - RR (względna redukcja ryzyka) = 0.077
ARR = 0.033, 95% CI [-0.216, 0.283]
NNT punktowe = 30.00; przedział ARR obejmuje 0:
  NNTB 30.0 (NNTH 4.6 do nieskończoności do NNTB 3.5)

To samo RR = 0.70, różne ryzyko w grupie odniesienia:
 ryzyko_odniesienia ryzyko_badane   ARR  NNT
               0.05         0.035 0.015 66.7
               0.20         0.140 0.060 16.7
               0.50         0.350 0.150  6.7
Badanie kliniczno-kontrolne i przekrojowe
R
# B450 – co wolno policzyć w jakim schemacie: kliniczno-kontrolne i przekrojowe
# Dane symulowane: populacja źródłowa pacjentów po operacji i badanie ankietowe.
set.seed(4502)

N <- 200000
cukrzyca <- rbinom(N, 1, .25)
zakazenie <- rbinom(N, 1, ifelse(cukrzyca == 1, .10, .05))

r1 <- mean(zakazenie[cukrzyca == 1]); r0 <- mean(zakazenie[cukrzyca == 0])
rr_pop <- r1 / r0
or_pop <- (r1 / (1 - r1)) / (r0 / (1 - r0))
cat(sprintf("Populacja: N = %d, zakażenia %d (%.1f%%)\n", N, sum(zakazenie), 100 * mean(zakazenie)))
cat(sprintf("Ryzyko: z cukrzycą %.4f, bez cukrzycy %.4f; RR = %.3f, OR = %.3f\n", r1, r0, rr_pop, or_pop))

E_prz <- sum(cukrzyca == 1 & zakazenie == 1); NE_prz <- sum(cukrzyca == 0 & zakazenie == 1)
E_kon <- sum(cukrzyca == 1 & zakazenie == 0); NE_kon <- sum(cukrzyca == 0 & zakazenie == 0)

# Jedno badanie: 300 przypadków i 600 kontroli
n_prz <- 300; m <- 2
a <- rhyper(1, E_prz, NE_prz, n_prz); c <- n_prz - a
b <- rhyper(1, E_kon, NE_kon, m * n_prz); d <- m * n_prz - b
or <- (a * d) / (b * c)
se <- sqrt(1 / a + 1 / b + 1 / c + 1 / d)
ci <- exp(log(or) + c(-1, 1) * qnorm(.975) * se)
cat(sprintf("\nJedno badanie 1:%d: przypadki z cukrzycą %d z %d (%.1f%%), kontrole z cukrzycą %d z %d (%.1f%%)\n",
            m, a, n_prz, 100 * a / n_prz, b, m * n_prz, 100 * b / (m * n_prz)))
cat(sprintf("OR = %.2f, 95%% CI [%.2f, %.2f]\n", or, ci[1], ci[2]))
cat(sprintf("Odsetek „zakażeń” w próbie: z cukrzycą %.1f%%, bez cukrzycy %.1f%% (wynika z proporcji 1:%d)\n",
            100 * a / (a + b), 100 * c / (c + d), m))
cat(sprintf("Błędne „RR” z tej tabeli = %.2f\n", (a / (a + b)) / (c / (c + d))))

# Powtórzenia dla różnej liczby kontroli na przypadek
B <- 4000
wyn <- do.call(rbind, lapply(c(1, 2, 4, 8), function(m) {
  a <- rhyper(B, E_prz, NE_prz, n_prz); c <- n_prz - a
  b <- rhyper(B, E_kon, NE_kon, m * n_prz); d <- m * n_prz - b
  data.frame(kontrole_na_przypadek = m,
             OR = exp(mean(log((a * d) / (b * c)))),
             pozorne_RR = exp(mean(log((a / (a + b)) / (c / (c + d))))),
             odsetek_przypadkow = 100 / (1 + m))
}))
cat("\nŚrednie geometryczne z", B, "powtórzeń (300 przypadków):\n")
print(format(wyn, digits = 3), row.names = FALSE)
write.csv(transform(wyn, RR_pop = rr_pop, OR_pop = or_pop), "b450-kliniczno-kontrolne.csv", row.names = FALSE)

# Badanie przekrojowe: ból krzyża a praca na nocnych dyżurach
set.seed(45021)
n1 <- 240; n0 <- 360
a <- rbinom(1, n1, .40); c <- rbinom(1, n0, .25)
b <- n1 - a; d <- n0 - c
p1 <- a / n1; p0 <- c / n0
z <- qnorm(.975)
pr <- p1 / p0; ci_pr <- exp(log(pr) + c(-1, 1) * z * sqrt(1 / a - 1 / n1 + 1 / c - 1 / n0))
por <- (a * d) / (b * c); ci_por <- exp(log(por) + c(-1, 1) * z * sqrt(1 / a + 1 / b + 1 / c + 1 / d))
rd <- p1 - p0; ci_rd <- rd + c(-1, 1) * z * sqrt(p1 * (1 - p1) / n1 + p0 * (1 - p0) / n0)
cat(sprintf("\nPrzekrojowe: nocne dyżury %d z %d (%.1f%%), bez nocnych %d z %d (%.1f%%)\n",
            a, n1, 100 * p1, c, n0, 100 * p0))
cat(sprintf("PR = %.2f, 95%% CI [%.2f, %.2f]\n", pr, ci_pr[1], ci_pr[2]))
cat(sprintf("POR = %.2f, 95%% CI [%.2f, %.2f]\n", por, ci_por[1], ci_por[2]))
cat(sprintf("Różnica chorobowości = %.1f pp, 95%% CI [%.1f, %.1f]\n", 100 * rd, 100 * ci_rd[1], 100 * ci_rd[2]))
Wynik w R
Populacja: N = 200000, zakażenia 12405 (6.2%)
Ryzyko: z cukrzycą 0.0994, bez cukrzycy 0.0495; RR = 2.008, OR = 2.120

Jedno badanie 1:2: przypadki z cukrzycą 118 z 300 (39.3%), kontrole z cukrzycą 144 z 600 (24.0%)
OR = 2.05, 95% CI [1.52, 2.77]
Odsetek „zakażeń” w próbie: z cukrzycą 45.0%, bez cukrzycy 28.5% (wynika z proporcji 1:2)
Błędne „RR” z tej tabeli = 1.58

Średnie geometryczne z 4000 powtórzeń (300 przypadków):
 kontrole_na_przypadek   OR pozorne_RR odsetek_przypadkow
                     1 2.13       1.42               50.0
                     2 2.12       1.61               33.3
                     4 2.12       1.79               20.0
                     8 2.12       1.92               11.1

Przekrojowe: nocne dyżury 90 z 240 (37.5%), bez nocnych 92 z 360 (25.6%)
PR = 1.47, 95% CI [1.15, 1.87]
POR = 1.75, 95% CI [1.23, 2.49]
Różnica chorobowości = 11.9 pp, 95% CI [4.3, 19.5]
OR a RR przy rzadkim i częstym zdarzeniu
R
# B450 – iloraz szans a ryzyko względne przy rzadkim i częstym zdarzeniu (symulacja)
set.seed(4503)

n <- 300; B <- 5000
ryzyka <- c(.05, .10, .20, .30, .40, .50, .60)
siatka <- expand.grid(RR = c(1.5, .7), p0 = ryzyka)

wyn <- do.call(rbind, lapply(seq_len(nrow(siatka)), function(i) {
  rr <- siatka$RR[i]; p0 <- siatka$p0[i]; p1 <- rr * p0
  a <- rbinom(B, n, p1); c <- rbinom(B, n, p0)
  ok <- a > 0 & c > 0 & a < n & c < n
  a <- a[ok]; c <- c[ok]; b <- n - a; d <- n - c
  l_rr <- log((a / n) / (c / n)); se_rr <- sqrt(1 / a - 1 / n + 1 / c - 1 / n)
  l_or <- log((a * d) / (b * c)); se_or <- sqrt(1 / a + 1 / b + 1 / c + 1 / d)
  z <- qnorm(.975)
  data.frame(RR = rr, p0 = p0, p1 = p1,
             OR_teoria = (p1 / (1 - p1)) / (p0 / (1 - p0)),
             sr_RR = exp(mean(l_rr)), sr_OR = exp(mean(l_or)),
             pokrycie_RR_przez_CI_RR = mean(abs(l_rr - log(rr)) <= z * se_rr),
             pokrycie_RR_przez_CI_OR = mean(abs(l_or - log(rr)) <= z * se_or),
             odrzucone = sum(!ok))
}))
print(format(wyn, digits = 3), row.names = FALSE)
write.csv(wyn, "b450-or-a-rr.csv", row.names = FALSE)

# Przeliczenie OR na RR wzorem Zhanga i Yu (działa dokładnie tylko bez korekty na inne zmienne)
przelicz <- function(or, p0) or / (1 - p0 + p0 * or)
dane <- read.csv("../ryzyko-wzgledne-iloraz-szans-nnt-dane.csv", fileEncoding = "UTF-8")
tab <- table(dane$grupa, dane$przerwanie)
r0 <- tab["standard", "1"] / sum(tab["standard", ])
or <- (tab["wsparcie", "1"] * tab["standard", "0"]) / (tab["wsparcie", "0"] * tab["standard", "1"])
cat(sprintf("\nBadanie główne: OR = %.3f, ryzyko odniesienia = %.3f, RR ze wzoru = %.3f\n", or, r0, przelicz(or, r0)))
Wynik w R
  RR   p0    p1 OR_teoria sr_RR sr_OR pokrycie_RR_przez_CI_RR
 1.5 0.05 0.075     1.541 1.525 1.567                   0.952
 0.7 0.05 0.035     0.689 0.689 0.678                   0.959
 1.5 0.10 0.150     1.588 1.510 1.599                   0.953
 0.7 0.10 0.070     0.677 0.697 0.675                   0.951
 1.5 0.20 0.300     1.714 1.502 1.716                   0.951
 0.7 0.20 0.140     0.651 0.700 0.652                   0.956
 1.5 0.30 0.450     1.909 1.503 1.914                   0.953
 0.7 0.30 0.210     0.620 0.699 0.620                   0.952
 1.5 0.40 0.600     2.250 1.500 2.252                   0.958
 0.7 0.40 0.280     0.583 0.698 0.581                   0.948
 1.5 0.50 0.750     3.000 1.502 3.020                   0.948
 0.7 0.50 0.350     0.538 0.700 0.538                   0.950
 1.5 0.60 0.900     6.000 1.502 6.081                   0.946
 0.7 0.60 0.420     0.483 0.699 0.481                   0.953
 pokrycie_RR_przez_CI_OR odrzucone
                  0.9498         0
                  0.9586         1
                  0.9460         0
                  0.9524         0
                  0.9012         0
                  0.9476         0
                  0.7174         0
                  0.9008         0
                  0.3228         0
                  0.8152         0
                  0.0206         0
                  0.6456         0
                  0.0000         0
                  0.3792         0

Badanie główne: OR = 0.598, ryzyko odniesienia = 0.520, RR ze wzoru = 0.756
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bazowy R); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy iloraz szans 0.60 oznacza, że ryzyko spadło o 40%?
Nie. Spadły szanse. W przykładzie z wpisu OR = 0.60, ale ryzyko spadło z 52.0% do 39.3%, czyli o 24%, bo RR = 0.76. Oba wyniki są poprawne, tylko dotyczą innych wielkości. Jeśli piszesz o szansach, używaj słowa „szanse”, a przy częstym zdarzeniu podaj także RR lub różnicę ryzyk.
Czy w ankiecie przekrojowej mogę podać ryzyko względne?
Nie w sensie ryzyka, bo jednorazowy pomiar daje chorobowość, a nie zapadalność. Policz taki sam iloraz dwóch odsetków i nazwij go ilorazem chorobowości (PR). Thompson i in. (1998) wskazują, że iloraz szans chorobowości trudno interpretować bez restrykcyjnych założeń, więc to PR jest zwykle czytelniejszy. Przy korekcie na zmienne użyj zmodyfikowanej regresji Poissona.
Od jakiej częstości zdarzenia nie należy czytać OR jak RR?
Zwykle przyjmuje się 10% (Zhang i Yu, 1998; McNutt i in., 2003). Rozbieżność zależy jednak też od siły efektu. Przy RR = 1.5 i ryzyku wyjściowym 5% OR wynosi 1.54, przy 30% – 1.91, a przy 50% – 3.00. Sprawdź więc ryzyko w grupie odniesienia i oblicz RR z tabeli, zamiast polegać na samej regule.
Czy NNT można podać w badaniu obserwacyjnym albo kliniczno-kontrolnym?
W kliniczno-kontrolnym nie, bo z samej próby nie znasz ryzyka. W kohorcie możesz policzyć odwrotność różnicy ryzyk, ale to zawsze opis związku, a nie efektu: wymaga założenia, że usunięcie ekspozycji usunęłoby nadmiar zdarzeń. Po korekcie na zakłócacze NNT najlepiej liczyć z różnicy ryzyk po standaryzacji.
Co zrobić, gdy w jednej komórce tabeli 2 × 2 jest zero?
Wzory logarytmiczne na przedział ufności wymagają dodatnich komórek. Najprostsze rozwiązanie to dodanie 0.5 do wszystkich czterech komórek przed obliczeniem RR lub OR. W małych próbach użyj testu dokładnego Fishera i przedziałów dokładnych, a różnicę ryzyk podaj z przedziałem Newcombe’a.
Powiązane hasła
Przeczytaj też
Kalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →PoradnikStandaryzacja (g-computation): różnica ryzyk
Od ilorazu szans do różnicy ryzyk i RR: standaryzacja w R, bootstrap i metoda delta, ATE i ATT, nieskładalność OR i porównanie z IPW.
Czytaj →PoradnikStatystyka medyczna – zadania z rozwiązaniami
Dziesięć zadań dla pielęgniarstwa i kierunków medycznych: RR, OR, NNT, czułość i PPV, Fisher, McNemar, zapadalność, Kaplan–Meier i Wilcoxon – krok po kroku.
Czytaj →PoradnikBadanie kliniczno-kontrolne krok po kroku
Definicja przypadku, baza źródłowa, dobór kontroli i nadmierne dopasowanie, regresja warunkowa a zwykła, liczebność i opis wg STROBE – z symulacją w R.
Czytaj →PoradnikBadanie kohortowe w pracy dyplomowej
Czas zero, czas obserwacji, osobolata, RR i IRR z regresji Poissona z offsetem oraz analiza utraty z obserwacji – na przykładzie 400 pacjentów w R.
Czytaj →Nie wiesz, którą miarę efektu podać w swojej pracy?
Pomożemy dobrać miarę do schematu badania, policzyć przedziały ufności w R lub SPSS i zapisać wyniki tak, żebyś umiał(a) samodzielnie je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G. (1998). Confidence intervals for the number needed to treat. BMJ, 317(7168), 1309–1312. https://doi.org/10.1136/bmj.317.7168.1309 ● Otwarty dostęp: pełny tekst
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989 ● Otwarty dostęp: pełny tekst
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials. BMJ, 389, Article e081124. https://doi.org/10.1136/bmj-2024-081124 ● Otwarty dostęp
- Katz, D., Baptista, J., Azen, S. P., & Pike, M. C. (1978). Obtaining confidence intervals for the risk ratio in cohort studies. Biometrics, 34(3), 469–474. https://doi.org/10.2307/2530610
- McNutt, L.-A., Wu, C., Xue, X., & Hafner, J. P. (2003). Estimating the relative risk in cohort studies and clinical trials of common outcomes. American Journal of Epidemiology, 157(10), 940–943. https://doi.org/10.1093/aje/kwg074
- Schulz, K. F., & Grimes, D. A. (2002). Case-control studies: Research in reverse. The Lancet, 359(9304), 431–434. https://doi.org/10.1016/s0140-6736(02)07605-5
- Thompson, M. L., Myers, J. E., & Kriebel, D. (1998). Prevalence odds ratio or prevalence ratio in the analysis of cross sectional data: What is to be done? Occupational and Environmental Medicine, 55(4), 272–277. https://doi.org/10.1136/oem.55.4.272 ● Otwarty dostęp
- Zhang, J., & Yu, K. F. (1998). What's the relative risk? JAMA, 280(19), 1690. https://doi.org/10.1001/jama.280.19.1690
- Zou, G. (2004). A modified Poisson regression approach to prospective studies with binary data. American Journal of Epidemiology, 159(7), 702–706. https://doi.org/10.1093/aje/kwh090
Cytowania BibTeX
@article{altman1998confidence, author={Altman, Douglas G.}, title={{Confidence intervals for the number needed to treat}}, journal={BMJ}, year={1998}, volume={317}, number={7168}, pages={1309--1312}, doi={10.1136/bmj.317.7168.1309}}@article{davies1998when, author={Davies, Huw T. O. and Crombie, Iain K. and Tavakoli, Manouchehr}, title={{When can odds ratios mislead?}}, journal={BMJ}, year={1998}, volume={316}, number={7136}, pages={989--991}, doi={10.1136/bmj.316.7136.989}}@article{hopewell2025consort, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081124}, doi={10.1136/bmj-2024-081124}}@article{katz1978obtaining, author={Katz, D. and Baptista, J. and Azen, S. P. and Pike, M. C.}, title={{Obtaining confidence intervals for the risk ratio in cohort studies}}, journal={Biometrics}, year={1978}, volume={34}, number={3}, pages={469--474}, doi={10.2307/2530610}}@article{mcnutt2003estimating, author={McNutt, Louise-Anne and Wu, Chuntao and Xue, Xiaonan and Hafner, Jean Paul}, title={{Estimating the relative risk in cohort studies and clinical trials of common outcomes}}, journal={American Journal of Epidemiology}, year={2003}, volume={157}, number={10}, pages={940--943}, doi={10.1093/aje/kwg074}}@article{schulz2002case, author={Schulz, Kenneth F. and Grimes, David A.}, title={{Case-control studies: Research in reverse}}, journal={The Lancet}, year={2002}, volume={359}, number={9304}, pages={431--434}, doi={10.1016/s0140-6736(02)07605-5}}@article{thompson1998prevalence, author={Thompson, M. L. and Myers, J. E. and Kriebel, D.}, title={{Prevalence odds ratio or prevalence ratio in the analysis of cross sectional data: What is to be done?}}, journal={Occupational and Environmental Medicine}, year={1998}, volume={55}, number={4}, pages={272--277}, doi={10.1136/oem.55.4.272}}@article{zhang1998whats, author={Zhang, Jun and Yu, Kai F.}, title={{What's the relative risk?}}, journal={JAMA}, year={1998}, volume={280}, number={19}, pages={1690}, doi={10.1001/jama.280.19.1690}}@article{zou2004modified, author={Zou, Guangyong}, title={{A modified Poisson regression approach to prospective studies with binary data}}, journal={American Journal of Epidemiology}, year={2004}, volume={159}, number={7}, pages={702--706}, doi={10.1093/aje/kwh090}}