Co to jest model log-dwumianowy?
Model log-dwumianowy (ang. log-binomial model) to uogólniony model liniowy dla wyniku binarnego z rozkładem dwumianowym i logarytmiczną funkcją łączącą: log P(Y = 1) = b0 + b1x1 + … Wykładnik współczynnika, exp(b), to wprost ryzyko względne (RR) skorygowane o inne zmienne. Wacholder (1986) pokazał, że zmieniając funkcję łączącą w modelu dwumianowym, można szacować RR i różnicę ryzyka zamiast ilorazu szans z regresji logistycznej.
Barros i Hirakata (2003) uzyskali w badaniach przekrojowych poprawne ilorazy chorobowości z tego modelu, podobnie jak z regresji Poissona z odpornym błędem.
Problemy zbieżności
Logit przekształca każdą liczbę w prawdopodobieństwo, ale logarytm nie: kombinacja liniowa musi być ujemna dla każdej obserwacji, inaczej przewidywane ryzyko przekracza 1. Gdy maksimum wiarygodności leży blisko tej granicy, algorytm IRLS się gubi. Williamson, Eliasziw i Fick (2013) pokazali, że częstą przyczyną jest zawodzący algorytm, choć funkcja wiarygodności ma jedno skończone maksimum. Pomagają wartości startowe, inne algorytmy optymalizacji albo zmodyfikowana regresja Poissona.
Przykład
W symulowanych danych 500 osób (prawdziwe RR = 1.8) model log-dwumianowy zbiegł po 6 iteracjach: RR = 1.69, 95% CI [1.30, 2.20]. Zmodyfikowany Poisson dał prawie to samo: 1.71 [1.31, 2.22]. W drugim zbiorze, z silnym predyktorem ciągłym, glm() zatrzymał się z błędem o braku poprawnych współczynników, a z wartościami startowymi – z ostrzeżeniem o dywergencji. Model Poissona dopasował się, ale przewidział „ryzyko” do 1.33. Algorytm CEM z pakietu logbin znalazł maksimum na granicy: RR = 1.20 na jednostkę x, ryzyko do 1.00.
Na rysunku
Rysunek używa obu zbiorów z przykładu (te same dane, set.seed(638)): w panelu A zbioru z silnym predyktorem ciągłym, w panelu B zbioru 500 osób z ekspozycją binarną.
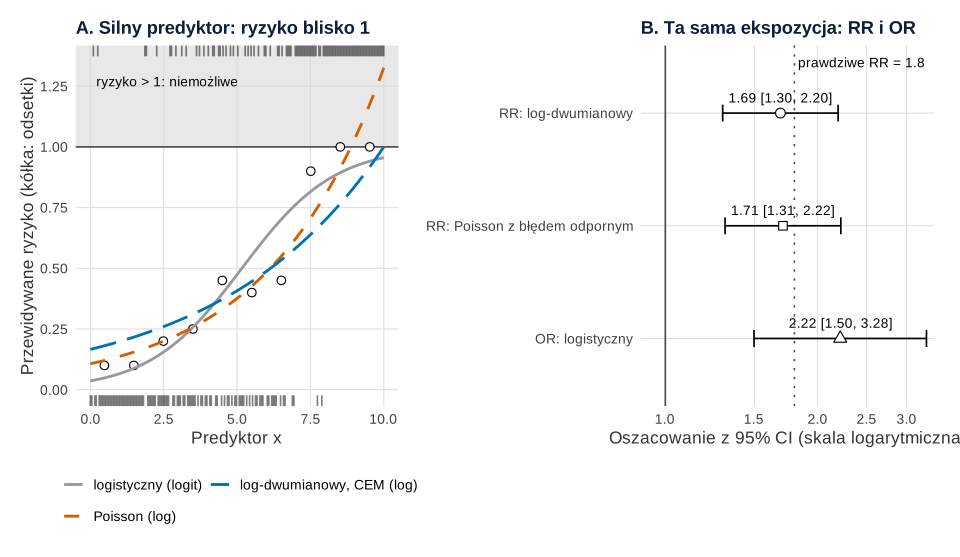
set.seed(638)).Co widać. W panelu A logarytm sprawia, że ryzyko rośnie wykładniczo i nic go nie zatrzymuje przed 1. Model Poissona przekracza 1 od x = 8.88, u 23 z 200 osób, aż do 1.33. Model log-dwumianowy musi zostać w dopuszczalnym obszarze, więc maksimum wiarygodności leży na jego granicy: przewidywane ryzyko równa się dokładnie 1 przy x = 10. Właśnie wtedy glm() nie zbiega. Logit zakrzywia się przy 1 (maksymalnie 0.96), ale jego współczynnik to OR, nie RR. Panel B to wykres współczynników dla zbioru, w którym model zbiegł: oba RR są prawie równe (1.69 i 1.71), a OR = 2.22 leży dalej od 1, bo wynik wystąpił u 30.2% osób.
Na co uważać. Panel A nie mówi, który model jest „prawdziwy” – dane wygenerowano z ryzyka obciętego na 1, więc żaden nie pasuje idealnie. Zgodność RR w panelu B dotyczy jednego zbioru; nie pokazuje, jak często model log-dwumianowy zawodzi w innych danych. Krzywą logistyczną w skali prawdopodobieństwa omawia szerzej wpis Regresja logistyczna w obrazkach.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tych samych obiektów pa i pb z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Przewidywane ryzyko z trzech modeli przy silnym predyktorze (A) i RR vs OR dla ekspozycji (B)
suppressPackageStartupMessages({library(sandwich); library(logbin); library(ggplot2); library(patchwork)})

# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw); modele różnią się też typem linii i kształtem
kol <- c("logistyczny (logit)" = "#999999", "Poisson (log)" = "#D55E00", "log-dwumianowy, CEM (log)" = "#0072B2")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Te same dane co w przykładzie hasła (ten sam ciąg losowań po set.seed(638))
set.seed(638)
n <- 500
eksp <- rbinom(n, 1, 0.4)
wiek <- round(runif(n, 20, 70))
y <- rbinom(n, 1, exp(log(0.20) + log(1.8) * eksp + 0.012 * (wiek - 45)))   # zbiór 1: prawdziwe RR = 1.8
x <- seq(0, 10, length.out = 200)
y2 <- rbinom(200, 1, pmin(exp(-2.5 + 0.3 * x), 1))                         # zbiór 2: silny predyktor

# A: zbiór 2 – trzy modele dla tego samego wyniku 0/1
m_logit <- glm(y2 ~ x, family = binomial)
m_poi <- glm(y2 ~ x, family = poisson)
m_cem <- suppressWarnings(logbin(y2 ~ x, method = "cem"))
siatka <- data.frame(x = seq(0, 10, by = 0.05))
b_cem <- coef(m_cem)
krzywe <- rbind(
  data.frame(x = siatka$x, p = predict(m_logit, siatka, type = "response"), model = names(kol)[1]),
  data.frame(x = siatka$x, p = predict(m_poi, siatka, type = "response"), model = names(kol)[2]),
  data.frame(x = siatka$x, p = exp(b_cem[1] + b_cem[2] * siatka$x), model = names(kol)[3]))
krzywe$model <- factor(krzywe$model, names(kol))
koszyk <- cut(x, breaks = seq(0, 10, by = 1), include.lowest = TRUE)       # odsetki w 10 przedziałach x
obs <- data.frame(x = tapply(x, koszyk, mean), p = tapply(y2, koszyk, mean))
round(c(max_logit = max(fitted(m_logit)), max_Poisson = max(fitted(m_poi)), max_CEM = max(fitted(m_cem)),
        x_gdzie_Poisson_1 = -coef(m_poi)[[1]] / coef(m_poi)[[2]], n_Poisson_powyzej_1 = sum(fitted(m_poi) > 1)), 3)

pa <- ggplot(krzywe, aes(x, p)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = 1, ymax = Inf, fill = "grey85", alpha = 0.6) +
  annotate("text", x = 0.2, y = 1.27, hjust = 0, size = 3.6, label = "ryzyko > 1: niemożliwe") +
  geom_hline(yintercept = 1, colour = "grey30") +
  geom_rug(data = data.frame(x = x[y2 == 1]), aes(x = x), inherit.aes = FALSE, sides = "t", alpha = 0.5) +
  geom_rug(data = data.frame(x = x[y2 == 0]), aes(x = x), inherit.aes = FALSE, sides = "b", alpha = 0.5) +
  geom_point(data = obs, aes(x, p), shape = 21, fill = "white", size = 2.6) +
  geom_line(aes(colour = model, linetype = model), linewidth = 1) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "longdash"), name = NULL) +
  scale_y_continuous(breaks = seq(0, 1.25, 0.25)) +
  coord_cartesian(ylim = c(0, 1.35)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "A. Silny predyktor: ryzyko blisko 1", x = "Predyktor x",
       y = "Przewidywane ryzyko (kółka: odsetki)") + motyw

# B: zbiór 1 – RR i OR dla ekspozycji z 95% CI (Wald), skorygowane o wiek
m_lb <- glm(y ~ eksp + wiek, family = binomial(link = "log"))
m_p1 <- glm(y ~ eksp + wiek, family = poisson)
se_rob <- sqrt(vcovHC(m_p1, type = "HC0")["eksp", "eksp"])
m_lo <- glm(y ~ eksp + wiek, family = binomial)
est <- data.frame(
  miara = c("RR: log-dwumianowy", "RR: Poisson z błędem odpornym", "OR: logistyczny"),
  b = c(coef(m_lb)["eksp"], coef(m_p1)["eksp"], coef(m_lo)["eksp"]),
  se = c(sqrt(vcov(m_lb)["eksp", "eksp"]), se_rob, sqrt(vcov(m_lo)["eksp", "eksp"])))
est$est <- exp(est$b); est$dolna <- exp(est$b - 1.96 * est$se); est$gorna <- exp(est$b + 1.96 * est$se)
est$miara <- factor(est$miara, rev(est$miara))
print(cbind(est["miara"], round(est[c("est", "dolna", "gorna")], 3)), row.names = FALSE)
round(c(odsetek_y = mean(y)), 3)

pb <- ggplot(est, aes(est, miara)) +
  geom_vline(xintercept = 1, colour = "grey30") +
  geom_vline(xintercept = 1.8, linetype = "dotted", colour = "grey30") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, orientation = "y") +
  geom_point(aes(shape = miara), size = 3, fill = "white") +
  geom_text(aes(label = sprintf("%.2f [%.2f, %.2f]", est, dolna, gorna)), vjust = -1.1, size = 3.6) +
  scale_shape_manual(values = c(24, 22, 21), guide = "none") +
  annotate("text", x = 1.83, y = 3.45, hjust = 0, size = 3.6, label = "prawdziwe RR = 1.8") +
  scale_x_log10(breaks = c(1, 1.5, 2, 2.5, 3)) +
  coord_cartesian(xlim = c(0.95, 3.2)) +
  labs(title = "B. Ta sama ekspozycja: RR i OR", x = "Oszacowanie z 95% CI (skala logarytmiczna)", y = NULL) + motyw

p1 <- pa + pb + plot_layout(widths = c(1.1, 1))
p1   # zapis: ggsave("model-log-dwumianowy-ryzyko-powyzej-1.svg", p1, width = 10, height = 5.8)
Wynik w R
          max_logit         max_Poisson             max_CEM   x_gdzie_Poisson_1
              0.956               1.326               1.000               8.880
n_Poisson_powyzej_1
             23.000
                         miara   est dolna gorna
            RR: log-dwumianowy 1.689 1.298 2.196
 RR: Poisson z błędem odpornym 1.709 1.313 2.224
               OR: logistyczny 2.218 1.498 3.284
odsetek_y
    0.302
Jak opisać w pracy
Na co uważać
- Brak zbieżności to nie wynik. Zgłoś, jak go rozwiązano, i porównaj RR z innym modelem.
- Nie podawaj wyniku, który zbiegł „na granicy” bez sprawdzenia przewidywanych ryzyk (maksimum blisko 1).
- Nie przeliczaj OR na RR wzorem, gdy zależy ci na korekcie o zmienne – dopasuj model, który szacuje RR.
Model log-dwumianowy w R
Kod dopasowuje model log-dwumianowy funkcją glm(family = binomial(link = "log")), porównuje RR ze zmodyfikowaną regresją Poissona, a na drugim zbiorze pokazuje brak zbieżności, przewidywania Poissona większe od 1 i maksimum na granicy znalezione przez logbin(). Liczby w tekście pochodzą z tego kodu.
RR z modelu log-dwumianowego i brak zbieżności
R
# Model log-dwumianowy: RR wprost z glm(binomial(link = "log")) i problem zbieżności (dane symulowane)
suppressPackageStartupMessages({library(sandwich); library(lmtest)})
set.seed(638)
n <- 500
eksp <- rbinom(n, 1, 0.4)                                        # ekspozycja binarna
wiek <- round(runif(n, 20, 70))                                  # zmienna kontrolna
p <- exp(log(0.20) + log(1.8) * eksp + 0.012 * (wiek - 45))      # prawdziwe RR = 1.8
y <- rbinom(n, 1, p)
d <- data.frame(y, eksp, wiek)
m_lb <- glm(y ~ eksp + wiek, family = binomial(link = "log"), data = d)   # model log-dwumianowy
m_poi <- glm(y ~ eksp + wiek, family = poisson, data = d)                 # zmodyfikowany Poisson
rob <- coeftest(m_poi, vcov = vcovHC(m_poi, type = "HC0"))
rbind(log_dwumianowy = round(exp(c(coef(m_lb)["eksp"], confint.default(m_lb)["eksp", ])), 3),
      Poisson_odporny = round(exp(rob["eksp", 1] + c(0, -1.96, 1.96) * rob["eksp", 2]), 3))
round(c(max_p_log_dwum = max(fitted(m_lb)), iteracje = m_lb$iter), 3)
# Problem zbieżności: silny predyktor ciągły, ryzyko bliskie 1 dla części osób
x <- seq(0, 10, length.out = 200)
y2 <- rbinom(200, 1, pmin(exp(-2.5 + 0.3 * x), 1))
tryCatch(glm(y2 ~ x, family = binomial(link = "log")),
         error = function(e) conditionMessage(e))                 # błąd zamiast wyniku
tryCatch(glm(y2 ~ x, family = binomial(link = "log"), start = c(-3, 0.25)),
         warning = function(w) conditionMessage(w))               # wartości startowe nie pomagają
m2_poi <- glm(y2 ~ x, family = poisson)
round(c(RR_na_jednostke = exp(unname(coef(m2_poi)["x"])), max_p_Poisson = max(fitted(m2_poi))), 3)
# Algorytm CEM (pakiet logbin) znajduje maksimum wiarygodności także na granicy przestrzeni parametrów
suppressPackageStartupMessages(library(logbin))
m2_lb <- suppressWarnings(logbin(y2 ~ x, method = "cem"))
round(c(RR_logbin = exp(unname(coef(m2_lb)["x"])), max_p_logbin = max(fitted(m2_lb)), na_granicy = m2_lb$boundary), 3)
Wynik w R
                 eksp 2.5 % 97.5 %
log_dwumianowy  1.689 1.298  2.196
Poisson_odporny 1.709 1.313  2.224
max_p_log_dwum       iteracje
         0.544          6.000
[1] "no valid set of coefficients has been found: please supply starting values"
[1] "step size truncated due to divergence"
RR_na_jednostke   max_p_Poisson
          1.287           1.326
   RR_logbin max_p_logbin   na_granicy
       1.197        1.000        1.000
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety sandwich 3.1.1, lmtest 0.9.40 i logbin 2.0.6). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- logbin (wersja 2.0.6): Donoghoe, M. W., & Marschner, I. C. (2018). logbin: An R package for relative risk regression using the log-binomial model. Journal of Statistical Software, 86(9), 1–22. https://doi.org/10.18637/jss.v086.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego R zgłasza „no valid set of coefficients has been found”?
Algorytm IRLS trafił na współczynniki, przy których przewidywane ryzyko przekracza 1, i nie umie wrócić do dozwolonego obszaru. Zdarza się to, gdy część osób ma ryzyko bliskie 1, zwłaszcza przy predyktorach ciągłych. Spróbuj wartości startowych, innego algorytmu albo zmodyfikowanej regresji Poissona i porównaj wyniki.
Czym model log-dwumianowy różni się od zmodyfikowanej regresji Poissona?
Oba szacują ryzyko względne. Model log-dwumianowy korzysta z prawdziwej wariancji dwumianowej i zawsze daje przewidywane ryzyka ≤ 1, ale bywa trudny do dopasowania. Zmodyfikowany Poisson dopasowuje się prawie zawsze, lecz wymaga odpornego błędu i może przewidzieć ryzyko większe od 1.
Czy model dwumianowy może dać różnicę ryzyka?
Tak, jeśli zamiast łącznika logarytmicznego użyjesz tożsamościowego (identity). Wacholder (1986) pokazał, że w modelu dwumianowym zmiana funkcji łączącej pozwala szacować ryzyko względne albo różnicę ryzyka skorygowane o inne zmienne. Ten wariant ma podobne problemy ze zbieżnością.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Barros, A. J. D., & Hirakata, V. N. (2003). Alternatives for logistic regression in cross-sectional studies: An empirical comparison of models that directly estimate the prevalence ratio. BMC Medical Research Methodology, 3(1), Article 21. https://doi.org/10.1186/1471-2288-3-21 ● Otwarty dostęp
- Wacholder, S. (1986). Binomial regression in GLIM: Estimating risk ratios and risk differences. American Journal of Epidemiology, 123(1), 174–184. https://doi.org/10.1093/oxfordjournals.aje.a114212
- Williamson, T., Eliasziw, M., & Fick, G. H. (2013). Log-binomial models: Exploring failed convergence. Emerging Themes in Epidemiology, 10(1), Article 14. https://doi.org/10.1186/1742-7622-10-14 ● Otwarty dostęp
Cytowania BibTeX
@article{barros2003alternatives, author={Barros, Aluísio J. D. and Hirakata, Vânia N.}, title={{Alternatives for logistic regression in cross-sectional studies: An empirical comparison of models that directly estimate the prevalence ratio}}, journal={BMC Medical Research Methodology}, year={2003}, volume={3}, number={1}, eid={21}, doi={10.1186/1471-2288-3-21}}@article{wacholder1986binomial, author={Wacholder, Sholom}, title={{Binomial regression in GLIM: Estimating risk ratios and risk differences}}, journal={American Journal of Epidemiology}, year={1986}, volume={123}, number={1}, pages={174--184}, doi={10.1093/oxfordjournals.aje.a114212}}@article{williamson2013log, author={Williamson, Tyler and Eliasziw, Misha and Fick, Gordon Hilton}, title={{Log-binomial models: Exploring failed convergence}}, journal={Emerging Themes in Epidemiology}, year={2013}, volume={10}, number={1}, eid={14}, doi={10.1186/1742-7622-10-14}}