Co to jest zmodyfikowana regresja Poissona?
Zmodyfikowana regresja Poissona (ang. modified Poisson regression) to zwykła regresja Poissona dopasowana do wyniku binarnego 0/1, ale z odpornym (sandwich) estymatorem wariancji. Zou (2004) zaproponował ją do bezpośredniego szacowania ryzyka względnego (RR) w badaniach prospektywnych, takich jak badanie kohortowe czy badanie z randomizacją. Wykładnik współczynnika, exp(b), to RR skorygowane o pozostałe zmienne w modelu.
Model Poissona źle opisuje wariancję wyniku 0/1: zakłada, że jest równa średniej p, a naprawdę wynosi p(1 − p). Dlatego zwykłe błędy standardowe są zawyżone. Odporne błędy standardowe usuwają ten problem bez zmiany samego oszacowania. W ograniczonej symulacji Zou metoda działała wiarygodnie już przy łącznej liczebności 100.
Kiedy zamiast regresji logistycznej
Przy częstym wyniku iloraz szans z regresji logistycznej zawsze leży dalej od 1 niż RR, czasem wyraźnie (McNutt i in., 2003). Barros i Hirakata (2003) w badaniach przekrojowych uzyskali poprawne ilorazy chorobowości zarówno z regresji Poissona z odpornym błędem, jak i z modelu log-dwumianowego. Ten drugi daje RR wprost, ale często nie zbiega; wariant Zou praktycznie zawsze da się dopasować.
Przykład
W symulowanej kohorcie 600 osób wynik wystąpił u 29.0% badanych: u 36.8% eksponowanych i 26.3% nieeksponowanych. Po uwzględnieniu wieku RR = 1.34, 95% CI [1.03, 1.74], a OR z regresji logistycznej = 1.54 [1.03, 2.29]. Zwykły błąd standardowy z modelu Poissona (0.165) jest większy od odpornego (0.134), więc przedział bez korekty byłby niepotrzebnie szeroki: [0.97, 1.85].
Na rysunku
Symulacja 1000 badań dla każdego z siedmiu poziomów ryzyka w grupie nieeksponowanej (od 5% do 60%). W każdym badaniu jest 300 osób eksponowanych i 300 nieeksponowanych, prawdziwe RR = 1.6, a model zawiera tylko ekspozycję. Parametry ustawiono ręcznie; ziarno (set.seed(2004)) ustalono raz i nie zmieniano.
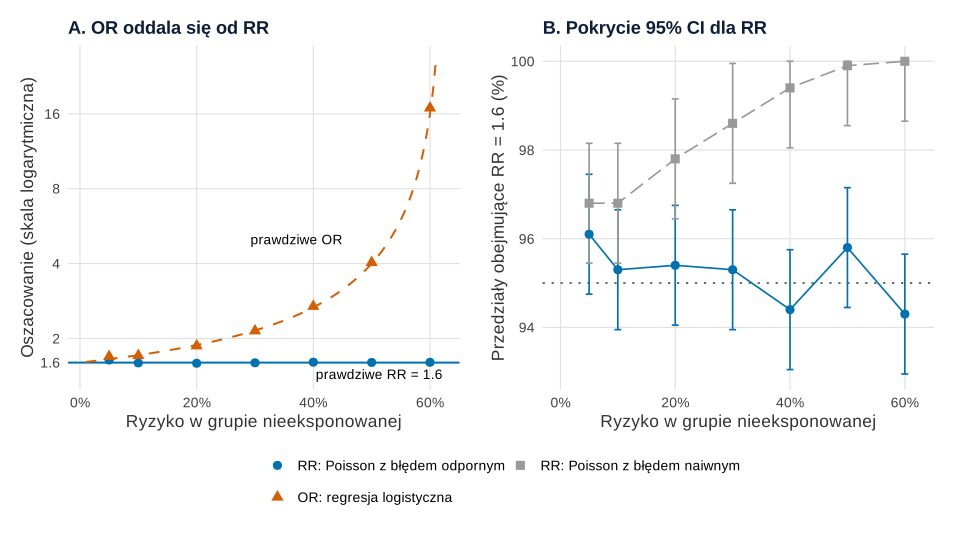
set.seed(2004)).Co widać. W panelu A regresja Poissona trafia w RR na całym zakresie: średnie oszacowania wynoszą od 1.59 do 1.64. Iloraz szans przy rzadkim wyniku jest blisko RR (1.69 przy 5%), ale potem szybko się oddala: 2.15 przy 30%, 4.04 przy 50% i 16.9 przy 60%. OR nie jest „błędny” (prawdziwe OR przy 60% wynosi 16.0) – to inna miara, którą łatwo odczytać jako RR. Panel B pokazuje, po co jest błąd odporny. Jego 95% przedziały obejmowały RR w 94.3–96.1% badań, czyli zgodnie z deklaracją (błąd Monte Carlo 0.7 pp). Przedziały z naiwnym błędem Poissona są za szerokie, i to tym bardziej, im częstszy wynik: pokrycie rośnie od 96.8% do 100%.
Na co uważać. Za wysokie pokrycie nie jest zaletą: przedział jest niepotrzebnie szeroki, a test ma mniejszą moc. Rysunek pokazuje najprostszy przypadek z jedną ekspozycją binarną, bez zmiennych kontrolnych i bez grupowania danych. Nie pokazuje przewidywanych ryzyk powyżej 1, które mogą się pojawić przy predyktorach ciągłych. Model Poissona dla zliczeń, z innym rodzajem wyniku, opisuje wpis Regresja Poissona – wizualizacja.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu (około 25 s). Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tych samych obiektów pa i pb z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. OR i RR przy rosnącej częstości wyniku (A) i pokrycie 95% CI dla RR z błędem odpornym i naiwnym (B)
suppressPackageStartupMessages({library(sandwich); library(ggplot2); library(patchwork)})

# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw); serie różnią się też kształtem i typem linii
kol <- c("RR: Poisson z błędem odpornym" = "#0072B2", "OR: regresja logistyczna" = "#D55E00",
         "RR: Poisson z błędem naiwnym" = "#999999")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# 1000 badań dla każdego ryzyka w grupie nieeksponowanej; 300 + 300 osób, prawdziwe RR = 1.6
set.seed(2004)
RR <- 1.6; n <- 300; R <- 1000
p0 <- c(0.05, 0.10, 0.20, 0.30, 0.40, 0.50, 0.60)
eksp <- rep(0:1, each = n)
jedno <- function(p) {
  y <- rbinom(2 * n, 1, ifelse(eksp == 1, RR * p, p))
  m_poi <- glm(y ~ eksp, family = poisson)
  b <- unname(coef(m_poi)[2])
  se_rob <- sqrt(vcovHC(m_poi, type = "HC0")[2, 2]); se_naiw <- sqrt(vcov(m_poi)[2, 2])
  c(logRR = b, logOR = unname(coef(glm(y ~ eksp, family = binomial))[2]),
    pokr_rob = abs(b - log(RR)) < 1.96 * se_rob, pokr_naiw = abs(b - log(RR)) < 1.96 * se_naiw)
}
sym <- do.call(rbind, lapply(p0, function(p) {
  w <- t(replicate(R, jedno(p)))
  data.frame(p0 = p, RR_sr = exp(mean(w[, "logRR"])), OR_sr = exp(mean(w[, "logOR"])),
             OR_prawdziwe = RR * (1 - p) / (1 - RR * p),
             pokrycie_odporny = mean(w[, "pokr_rob"]), pokrycie_naiwny = mean(w[, "pokr_naiw"]))
}))
sym$blad_MC <- sqrt(0.95 * 0.05 / R)
print(round(sym, 3))

# A: średnie oszacowania (średnia geometryczna z 1000 badań) i wartości prawdziwe
krzywa <- data.frame(p0 = seq(0.01, 0.61, by = 0.005))
krzywa$OR <- RR * (1 - krzywa$p0) / (1 - RR * krzywa$p0)
punkty <- rbind(data.frame(p0 = sym$p0, est = sym$RR_sr, seria = names(kol)[1]),
                data.frame(p0 = sym$p0, est = sym$OR_sr, seria = names(kol)[2]))
punkty$seria <- factor(punkty$seria, names(kol))
pa <- ggplot(punkty, aes(p0, est)) +
  geom_hline(yintercept = RR, colour = kol[[1]], linewidth = 0.7) +
  geom_line(data = krzywa, aes(p0, OR), colour = kol[[2]], linetype = "dashed", linewidth = 0.7) +
  geom_point(aes(colour = seria, shape = seria), size = 2.8, show.legend = TRUE) +
  annotate("text", x = c(0.62, 0.45), y = c(RR * 0.9, 5), hjust = 1, size = 3.6,
           label = c("prawdziwe RR = 1.6", "prawdziwe OR")) +
  scale_y_log10(breaks = c(1.6, 2, 4, 8, 16), labels = as.character) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  scale_colour_manual(values = kol, name = NULL, drop = FALSE) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL, drop = FALSE) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "A. OR oddala się od RR", x = "Ryzyko w grupie nieeksponowanej",
       y = "Oszacowanie (skala logarytmiczna)") + motyw

# B: pokrycie 95% CI dla RR (odsetek z 1000 badań, słupki = ±1.96 błędu Monte Carlo)
pokr <- rbind(data.frame(p0 = sym$p0, pokrycie = sym$pokrycie_odporny, seria = names(kol)[1]),
              data.frame(p0 = sym$p0, pokrycie = sym$pokrycie_naiwny, seria = names(kol)[3]))
pokr$seria <- factor(pokr$seria, names(kol))
pb <- ggplot(pokr, aes(p0, 100 * pokrycie, colour = seria, shape = seria)) +
  geom_hline(yintercept = 95, linetype = "dotted", colour = "grey30") +
  geom_errorbar(aes(ymin = 100 * (pokrycie - 1.96 * sym$blad_MC[1]), ymax = 100 * pmin(1, pokrycie + 1.96 * sym$blad_MC[1])),
                width = 0.012, show.legend = FALSE) +
  geom_line(aes(linetype = seria), show.legend = FALSE) + geom_point(size = 2.8) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.62)) +
  scale_colour_manual(values = kol, name = NULL, drop = FALSE) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL, drop = FALSE) +
  scale_linetype_manual(values = c("solid", "dashed", "longdash"), drop = FALSE) +
  labs(title = "B. Pokrycie 95% CI dla RR", x = "Ryzyko w grupie nieeksponowanej",
       y = "Przedziały obejmujące RR = 1.6 (%)") + motyw + theme(legend.position = "none")

p1 <- pa + pb + plot_layout(guides = "collect") + plot_annotation(theme = theme(legend.position = "bottom"))
p1   # zapis: ggsave("zmodyfikowana-regresja-poissona-or-rr.svg", p1, width = 10, height = 5.6)
Wynik w R
    p0 RR_sr  OR_sr OR_prawdziwe pokrycie_odporny pokrycie_naiwny blad_MC
1 0.05 1.638  1.693        1.652            0.961           0.968   0.007
2 0.10 1.596  1.707        1.714            0.953           0.968   0.007
3 0.20 1.590  1.868        1.882            0.954           0.978   0.007
4 0.30 1.597  2.146        2.154            0.953           0.986   0.007
5 0.40 1.606  2.693        2.667            0.944           0.994   0.007
6 0.50 1.602  4.039        4.000            0.958           0.999   0.007
7 0.60 1.604 16.866       16.000            0.943           1.000   0.007
Jak opisać w pracy
Na co uważać
- Bez odpornego błędu przedziały są za szerokie. Samo RR jest poprawne, ale wnioskowanie już nie.
- Przewidywane ryzyka mogą przekroczyć 1. Model ich nie ogranicza. W przykładzie mieściły się w zakresie 0.22–0.42, ale przy silnych predyktorach sprawdź to zawsze.
- To nie jest model zliczeń. Nie nazywaj wyniku IRR i nie oceniaj nadmiernej dyspersji – wariancję i tak przejmuje estymator sandwich.
- Dane skupione (szkoły, oddziały) wymagają błędów odpornych na klastrowanie.
Zmodyfikowana regresja Poissona w R
Kod symuluje kohortę z częstym wynikiem binarnym, dopasowuje regresję Poissona z odpornym błędem HC0 (sandwich) i porównuje ją ze zwykłym błędem z modelu Poissona oraz z ilorazem szans z regresji logistycznej. Liczby w tekście pochodzą z tego kodu.
RR z odpornym błędem, błąd naiwny i OR
R
# Zmodyfikowana regresja Poissona (Zou): RR dla częstego wyniku binarnego (dane symulowane)
suppressPackageStartupMessages({library(sandwich); library(lmtest)})
set.seed(637)
n <- 600
wiek <- round(runif(n, 20, 70))                                  # zmienna kontrolna
eksp <- rbinom(n, 1, plogis(-1 + 0.03 * (wiek - 45)))            # ekspozycja (np. praca zmianowa)
p <- exp(log(0.25) + log(1.6) * eksp + 0.01 * (wiek - 45))       # prawdziwe RR = 1.6
y <- rbinom(n, 1, p)                                             # wynik binarny (częsty)
d <- data.frame(y, eksp, wiek)
round(c(odsetek_y = mean(y), ryzyko_eksp = mean(y[eksp == 1]), ryzyko_nieeksp = mean(y[eksp == 0])), 3)
m_poi <- glm(y ~ eksp + wiek, family = poisson, data = d)        # model Poissona dla 0/1
rob <- coeftest(m_poi, vcov = vcovHC(m_poi, type = "HC0"))       # odporny (sandwich) błąd standardowy
naiw <- coeftest(m_poi)                                          # zwykły błąd z modelu Poissona
m_log <- glm(y ~ eksp + wiek, family = binomial, data = d)       # regresja logistyczna
ci <- function(b, se) round(c(est = exp(b), dolna = exp(b - 1.96 * se), gorna = exp(b + 1.96 * se)), 3)
rbind(RR_odporny = ci(rob["eksp", 1], rob["eksp", 2]),
      RR_naiwny  = ci(naiw["eksp", 1], naiw["eksp", 2]),
      OR_logist  = ci(coef(m_log)["eksp"], sqrt(vcov(m_log)["eksp", "eksp"])))
round(c(SE_odporny = rob["eksp", 2], SE_naiwny = naiw["eksp", 2]), 4)
round(range(fitted(m_poi)), 3)                                   # przewidywane ryzyka (czy < 1?)
Wynik w R
     odsetek_y    ryzyko_eksp ryzyko_nieeksp
         0.290          0.368          0.263
             est dolna gorna
RR_odporny 1.338 1.028 1.740
RR_naiwny  1.338 0.967 1.850
OR_logist  1.535 1.031 2.285
SE_odporny  SE_naiwny
    0.1342     0.1653
[1] 0.218 0.422
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety sandwich 3.1.1 i lmtest 0.9.40). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy zmodyfikowaną regresję Poissona można stosować w badaniu przekrojowym?
Tak. W danych przekrojowych exp(b) oznacza iloraz chorobowości (PR), a nie ryzyko względne. Barros i Hirakata (2003) uzyskali w takich danych poprawne oszacowania PR z regresji Poissona z odpornym błędem, podczas gdy OR z regresji logistycznej mógł go znacznie zawyżać.
Który odporny błąd wybrać: HC0 czy HC3?
Klasyczny estymator sandwich to HC0 i tak zwykle liczy się metodę Zou. Funkcja vcovHC() w R domyślnie zwraca HC3, który w małych próbach daje nieco szersze przedziały. Podaj w pracy, którego wariantu użyto.
Czy tym modelem można oszacować różnicę ryzyka?
Nie bezpośrednio, bo łącznik logarytmiczny daje ilorazy. Różnicę ryzyka daje model z łącznikiem tożsamościowym (np. regresja liniowa na wyniku 0/1 z odpornym błędem) albo przeliczenie przewidywanych ryzyk z modelu na różnicę średnich efektów brzegowych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w pracy z BHP i ergonomii
Klimat bezpieczeństwa w brygadach, NASA-TLX, wypadki na roboczogodziny, dolegliwości i percentyle antropometryczne: modele, efekty, zdania APA i kod R.
Czytaj →PoradnikStatystyka w pracy ze zdrowia publicznego
Chorobowość z CI, iloraz szans a iloraz chorobowości, standaryzacja względem wieku, ważenie próby i trend z rejestrów: analizy, APA i kod R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Barros, A. J. D., & Hirakata, V. N. (2003). Alternatives for logistic regression in cross-sectional studies: An empirical comparison of models that directly estimate the prevalence ratio. BMC Medical Research Methodology, 3(1), Article 21. https://doi.org/10.1186/1471-2288-3-21 ● Otwarty dostęp
- McNutt, L.-A., Wu, C., Xue, X., & Hafner, J. P. (2003). Estimating the relative risk in cohort studies and clinical trials of common outcomes. American Journal of Epidemiology, 157(10), 940–943. https://doi.org/10.1093/aje/kwg074
- Zou, G. (2004). A modified Poisson regression approach to prospective studies with binary data. American Journal of Epidemiology, 159(7), 702–706. https://doi.org/10.1093/aje/kwh090
Cytowania BibTeX
@article{barros2003alternatives, author={Barros, Aluísio J. D. and Hirakata, Vânia N.}, title={{Alternatives for logistic regression in cross-sectional studies: An empirical comparison of models that directly estimate the prevalence ratio}}, journal={BMC Medical Research Methodology}, year={2003}, volume={3}, number={1}, eid={21}, doi={10.1186/1471-2288-3-21}}@article{mcnutt2003estimating, author={McNutt, Louise-Anne and Wu, Chuntao and Xue, Xiaonan and Hafner, Jean Paul}, title={{Estimating the relative risk in cohort studies and clinical trials of common outcomes}}, journal={American Journal of Epidemiology}, year={2003}, volume={157}, number={10}, pages={940--943}, doi={10.1093/aje/kwg074}}@article{zou2004modified, author={Zou, Guangyong}, title={{A modified Poisson regression approach to prospective studies with binary data}}, journal={American Journal of Epidemiology}, year={2004}, volume={159}, number={7}, pages={702--706}, doi={10.1093/aje/kwh090}}