Pięć typowych projektów w pracy z BHP i ergonomii
Prace dyplomowe z bezpieczeństwa i higieny pracy oraz z ergonomii łączą dane bardzo różnego rodzaju. W jednym zakładzie możesz rozdać ankietę o klimacie bezpieczeństwa, poprosić operatorów o ocenę obciążenia przy trzech wersjach stanowiska, przepisać z dokumentacji liczbę wypadków w działach, zapytać o bóle krzyża i zmierzyć wysokość podkolanową pracowników. Każdy z tych typów danych wymaga innej analizy: wynik skali zebrany w brygadach – modelu, który uwzględnia brygady; ocena tych samych osób w kilku warunkach – analizy pomiarów powtarzanych; liczba wypadków – modelu dla zliczeń z czasem narażenia; dolegliwość tak/nie – regresji dla wyniku binarnego; wymiar ciała – percentyli z przedziałem ufności. Tabela porządkuje pięć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Klimat bezpieczeństwa | Czy klimat bezpieczeństwa różni się między typami stanowisk? | wynik skali 1–5, pracownicy w brygadach | model wielopoziomowy (losowy wyraz wolny brygady) | b z 95% CI, ICC, efekt schematu |
| 2. Obciążenie pracą (NASA-TLX) | Czy nowa wersja stanowiska zmniejsza subiektywne obciążenie? | wynik 0–100, te same osoby w trzech wariantach | ANOVA z powtarzanymi pomiarami, porównania parami | ηp², różnice średnich z CI |
| 3. Wypadki przy pracy | Gdzie wypadki zdarzają się najczęściej w przeliczeniu na czas pracy? | liczba wypadków i roboczogodziny w działach | regresja Poissona / ujemna dwumianowa z offsetem | iloraz częstości (IRR) z 95% CI, wskaźnik na 100 000 h |
| 4. Dolegliwości mięśniowo-szkieletowe | Czy dźwiganie wiąże się z bólem odcinka lędźwiowego? | tak/nie w ciągu 12 miesięcy, czynniki obciążenia | regresja logistyczna i zmodyfikowana regresja Poissona | OR i iloraz chorobowości (PR) z 95% CI |
| 5. Pomiary antropometryczne | Jaki zakres regulacji wysokości siedziska obejmie większość pracowników? | wymiary ciała w cm | percentyle (P5, P50, P95) z bootstrapowym CI | szerokość przedziału, odsetek osób „mieszczących się” |
Wszystkie dane w przykładach są symulowane, a liczby nie opisują żadnego rzeczywistego zakładu. Pełny kod znajdziesz w sekcji Przykład w R, a dane z projektu 3 możesz pobrać jako plik CSV (60 działów). Jeśli nie wiesz, który test pasuje do Twojej hipotezy, zacznij od kreatora doboru testu, a cały proces od pytania badawczego do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej. Gdy praca dotyczy raczej psychospołecznych warunków pracy niż bezpieczeństwa technicznego, zajrzyj do wpisu o kwestionariuszu COPSOQ.
Zanim zaczniesz: dane z zakładu pracy
Dokumentacja wypadków nie jest pełnym obrazem zdarzeń. Rejestr wypadków, karty zdarzeń i protokoły to wygodne źródło danych do pracy, ale zawierają tylko to, co zgłoszono. Probst i in. (2008) porównali w 38 firmach budowlanych urazy zgłoszone do oficjalnego rejestru z danymi z roszczeń medycznych. Zgłoszony wskaźnik wynosił 3.11 urazu na 100 pracowników rocznie, a urazów, które powinny trafić do rejestru, ale nie trafiły, było 10.90 na 100 pracowników. W firmach o słabym klimacie bezpieczeństwa nie zgłoszono 81% takich urazów, a w firmach o dobrym – 47%. Dla Twojej pracy wynika z tego ważna rzecz: jeśli porównujesz działy o różnej kulturze zgłaszania, różnica w liczbie wypadków może częściowo odzwierciedlać różnicę w zgłaszaniu. Napisz o tym w ograniczeniach, a jeśli to możliwe, zbierz osobno zdarzenia potencjalnie wypadkowe i drobne urazy.
Badasz tylko tych, którzy wciąż pracują. W ankiecie rozdanej na zmianie nie ma osób, które odeszły z pracy z powodu dolegliwości, ani tych, których nie przyjęto ze względu na stan zdrowia. Li i Sung (1999) wskazują dwa główne źródła takiego efektu zdrowego pracownika: wykluczanie osób mniej zdrowych przy zatrudnieniu i badanie wyłącznie aktywnych pracowników. Konsekwencja jest praktyczna: związek obciążenia z dolegliwościami w badaniu przekrojowym może być słabszy niż w rzeczywistości, bo osoby najbardziej obciążone i chore już odeszły ze stanowiska. Zwróć też uwagę, że w badaniu przekrojowym nie ustalisz kolejności zdarzeń, więc pisz o związkach, a nie o przyczynach.
Anonimowość w małych działach. W zakładzie łatwo rozpoznać osobę po kombinacji działu, stanowiska, zmiany i stażu. Nie pokazuj wyników dla grup kilkuosobowych, łącz rzadkie kategorie i uzgodnij z pracodawcą, kto zobaczy surowe dane. Jeśli we wstępie przywołujesz liczbę wypadków w Polsce albo w branży, cytuj konkretną publikację lub oficjalną statystykę z datą odczytu i napisz, jaką definicję wypadku stosuje to źródło.
Projekt 1. Klimat bezpieczeństwa w brygadach
Klimat bezpieczeństwa to wspólne postrzeganie przez pracowników tego, jak ważne jest bezpieczne zachowanie w ich miejscu pracy. Zohar (1980) zbudował i zwalidował pierwszą miarę tego konstruktu w 20 zakładach przemysłowych i pokazał dwie rzeczy ważne dla analizy. Po pierwsze, pracownicy tej samej firmy zgadzali się w swoich ocenach, więc klimat jest cechą grupy, a nie tylko pojedynczej osoby. Po drugie, najważniejsze dla poziomu klimatu okazały się postrzegane postawy kierownictwa wobec bezpieczeństwa i znaczenie bezpieczeństwa w codziennym procesie produkcji. Zohar i Luria (2005) dodali poziom grupy roboczej: klimat organizacji i klimat grup są ze sobą zgodne, ale w obrębie jednej organizacji grupy wyraźnie się różnią, bo przełożeni w różny sposób wdrażają te same procedury.
Przykład: 360 pracowników z 24 brygad (po 15 osób) wypełniło 8-pozycyjną skalę klimatu bezpieczeństwa (1 – zdecydowanie się nie zgadzam, 5 – zdecydowanie się zgadzam). Brygady pracowały na trzech typach stanowisk: produkcja, magazyn i utrzymanie ruchu (po 8 brygad). Wynik skali to średnia pozycji, M = 2.93, SD = 0.77. Spójność wewnętrzna była dobra: α = .87, a omega McDonalda z modelu jednoczynnikowego również wyniosła .87.
Dlaczego brygady zmieniają analizę
Pytanie „czy klimat różni się między typami stanowisk” brzmi jak zadanie dla jednoczynnikowej ANOVA. Problem w tym, że typ stanowiska przypisany jest do brygady, a nie do osoby. Masz więc 24 jednostki z informacją o stanowisku, a nie 360 niezależnych obserwacji. Ile to zmienia, pokazuje współczynnik korelacji wewnątrzklasowej z modelu pustego: ICC(1) = .17, czyli 17% zmienności wyniku przypada na różnice między brygadami. Przy 15 osobach w brygadzie efekt schematu wynosi 1 + (15 − 1) × .168 = 3.35 (w obliczeniu użyj ICC przed zaokrągleniem), a efektywna liczebność próby to około 107 osób, a nie 360.
Zwykła ANOVA na osobach dała F(2, 357) = 1.32, p = .269. Model wielopoziomowy z losowym wyrazem wolnym brygady, w którym stanowisko jest predyktorem na poziomie brygady, dał F(2, 21) = 0.37, p = .696 – zwróć uwagę na 21 stopni swobody mianownika zamiast 357. Średnie były zbliżone: produkcja M = 2.84 (SD = 0.82), magazyn M = 3.00 (SD = 0.75), utrzymanie ruchu M = 2.96 (SD = 0.73). Różnica magazynu względem produkcji wyniosła b = 0.15 (SE = 0.19), t(21) = 0.82, p = .419.
W tym przykładzie obie analizy prowadzą do tego samego wniosku, ale to przypadek. W symulacji 500 badań o tej samej strukturze, w których typ stanowiska nie miał żadnego związku z klimatem, zwykła ANOVA na osobach dała p < .05 w 46.4% badań, a model wielopoziomowy w 6.0% (blisko nominalnych 5%). Ignorowanie brygad prawie w co drugim badaniu „znajdowało” różnicę, której nie było. Krok po kroku – z modelem pustym, ICC i predyktorami na dwóch poziomach – przeprowadzi Cię wpis model wielopoziomowy krok po kroku.
Jeśli brygad jest mało (np. pięć), model wielopoziomowy ma słabe oszacowanie wariancji między grupami. Wtedy rozsądniej opisać wyniki brygad osobno albo policzyć średnie brygad i porównać je jako 5 obserwacji, z wyraźnym zastrzeżeniem o małej liczbie jednostek.
Projekt 2. Obciążenie pracą przy trzech wariantach stanowiska
Typowa praca z ergonomii porównuje kilka wersji stanowiska albo organizacji zadania. Gdy te same osoby pracują w każdym wariancie, każda jest „swoją własną kontrolą”, a zmienność między osobami nie zaciera efektu. Subiektywne obciążenie najczęściej mierzy się kwestionariuszem NASA-TLX. Jak policzyć jego wynik, czy ważyć podskale i jak opisać licencję – omawiamy w osobnym wpisie NASA-TLX: jak policzyć wynik. Tutaj ważne jest jedno: Hart (2006) w przeglądzie zastosowań narzędzia zauważa, że wersja bez ważenia (Raw TLX) bywała w porównaniach bardziej, mniej albo tak samo czuła jak wersja ważona, więc wybór wersji zapisz w planie przed zebraniem danych.
Przykład: 24 operatorów wykonało to samo zadanie montażowe przy stanowisku standardowym, przy stanowisku z regulowaną wysokością blatu i przy stanowisku z manipulatorem, w kolejności zrównoważonej między osobami. Po każdym wariancie wypełnili NASA-TLX (Raw TLX, 0–100). Średnie wynosiły 57.6 (SD = 10.7) przy stanowisku standardowym, 54.1 (SD = 14.2) przy regulowanej wysokości i 48.9 (SD = 12.9) przy manipulatorze.
ANOVA z powtarzanymi pomiarami i porównania parami
Przy trzech pomiarach tej samej osoby użyj ANOVA z powtarzanymi pomiarami. Test Mauchly'ego nie wskazał naruszenia sferyczności, W = 0.94, p = .480, a poprawka Greenhouse'a–Geissera była niewielka (ε = .94). Wariant stanowiska różnicował obciążenie, F(1.88, 43.21) = 6.91, p = .003, ηp² = .23. W porównaniach parami z poprawką Holma obciążenie przy manipulatorze było niższe niż przy stanowisku standardowym o 8.62 punktu, 95% CI [2.59, 14.66], p = .004, i niższe niż przy regulowanej wysokości o 5.16 punktu, 95% CI [−0.16, 10.48], p = .039. Różnica między stanowiskiem standardowym a regulowanym (3.46 punktu) była nieistotna, p = .192.
Zwróć uwagę na pozorną sprzeczność w drugim porównaniu: p = .039, a przedział obejmuje 0. To nie błąd. Przedziały policzono z poprawką Bonferroniego, a wartości p – metodą Holma, która jest mniej zachowawcza. W pracy napisz, jaką poprawkę zastosowałeś do przedziałów, a jaką do p, albo podaj przedziały bez poprawki z wyraźną adnotacją. Jeśli w Twoim badaniu ktoś opuści jeden wariant, zamiast usuwać tę osobę z całej analizy rozważ model mieszany, który wykorzysta pozostałe pomiary tej osoby. Tę samą analizę w programie z menu pokazuje ANOVA w jamovi, a do przećwiczenia odczytu tabel przydadzą się zadania z ANOVA z rozwiązaniami.
Projekt 3. Wypadki przy pracy: liczba zdarzeń i czas narażenia
To najbardziej „BHP-owy” typ danych i jednocześnie ten, w którym najłatwiej o błąd. Liczba wypadków w dziale zależy nie tylko od tego, jak bezpieczna jest praca, ale też od tego, ile tej pracy wykonano: dział z 60 osobami przepracuje kilka razy więcej godzin niż dział z 10 osobami i nawet przy tym samym ryzyku będzie miał więcej wypadków. Dlatego porównuj nie liczby, lecz częstości – liczbę zdarzeń na jednostkę czasu narażenia, np. na 100 000 roboczogodzin. Frome (1983) opisał modele regresji dla takich częstości oparte na rozkładzie Poissona; czas narażenia wchodzi do nich jako offset, czyli logarytm roboczogodzin ze współczynnikiem ustalonym na 1.
Przykład: z dokumentacji zakładu przepisano dane 60 działów z trzech lat – typ działu (produkcja, magazyn, utrzymanie ruchu), liczbę przepracowanych roboczogodzin, odsetek godzin na zmianie nocnej, średni wynik klimatu bezpieczeństwa w dziale (1–5) i liczbę zarejestrowanych wypadków przy pracy. Łącznie odnotowano 251 wypadków.
Krok 1. Liczby a częstości
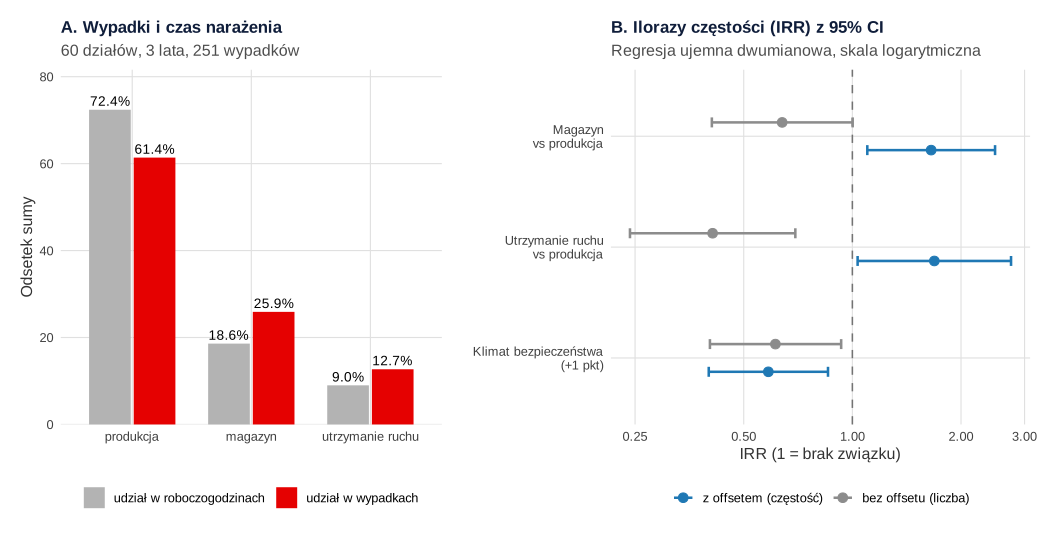
Produkcja odpowiadała za 61.4% wszystkich wypadków, więc na pierwszy rzut oka to ona jest problemem. Ale przepracowano w niej 72.4% wszystkich roboczogodzin. Magazyn miał 25.9% wypadków przy 18.6% godzin, a utrzymanie ruchu 12.7% wypadków przy 9.0% godzin. W przeliczeniu na czas pracy wskaźnik wynosił 2.28 wypadku na 100 000 roboczogodzin w produkcji, 3.74 w magazynie i 3.83 w utrzymaniu ruchu. Porównanie samych liczb odwraca więc wniosek.
Krok 2. Regresja Poissona z offsetem i nadmierne rozproszenie
Średnio dział miał 4.18 wypadku przy wariancji 14.02, a pięć działów nie miało żadnego. Regresja Poissona z offsetem log(roboczogodziny / 100 000) i trzema predyktorami dała współczynnik rozproszenia (suma kwadratów reszt Pearsona przez liczbę stopni swobody) równy 1.84. To sygnał nadmiernej dyspersji: działy różnią się między sobą bardziej, niż przewiduje model Poissona, np. z powodu niezmierzonych cech maszyn czy kierowników. W takiej sytuacji model Poissona zaniża błędy standardowe.
Krok 3. Regresja ujemna dwumianowa
Regresja ujemna dwumianowa z tym samym offsetem była lepiej dopasowana: test ilorazu wiarygodności χ²(1) = 15.39, p < .001 (wartość p podzielono przez 2, bo parametr rozproszenia leży na granicy dopuszczalnych wartości), AIC spadło z 294.5 do 281.1, a parametr θ wyniósł 5.01. Szczegółowe porównanie modeli, z liczbą przewidywanych zer i modelem z nadmiarem zer, opisuje poradnik regresja dla zliczeń krok po kroku.
| Predyktor | IRR [95% CI] – ujemna dwumianowa | z | p | IRR [95% CI] – Poisson |
|---|---|---|---|---|
| Magazyn vs produkcja | 1.65 [1.10, 2.49] | 2.42 | .016 | 1.64 [1.22, 2.20] |
| Utrzymanie ruchu vs produkcja | 1.69 [1.03, 2.75] | 2.09 | .036 | 1.68 [1.15, 2.46] |
| Zmiana nocna (+10 punktów procentowych godzin) | 1.03 [0.85, 1.24] | 0.27 | .784 | 1.02 [0.89, 1.17] |
| Klimat bezpieczeństwa działu (+1 punkt) | 0.59 [0.40, 0.86] | −2.76 | .006 | 0.56 [0.43, 0.74] |
Krok 4. Interpretacja ilorazów częstości
Wykładnik współczynnika to iloraz częstości (IRR). IRR = 1.65 dla magazynu oznacza, że przy tym samym udziale zmian nocnych i tym samym klimacie bezpieczeństwa wypadki zdarzały się w magazynie średnio 1.65 raza częściej na roboczogodzinę niż w produkcji. IRR = 0.59 dla klimatu oznacza, że dział o klimacie wyższym o 1 punkt miał częstość wypadków niższą o około 41%. Przewidywane wartości obrazują to w jednostkach zrozumiałych dla działu BHP: przy średnim udziale zmian nocnych (20%) i średnim klimacie (3.43) model przewidywał 2.21 wypadku na 100 000 roboczogodzin w produkcji, 3.65 w magazynie i 3.72 w utrzymaniu ruchu. Odsetek godzin nocnych nie wiązał się z częstością wypadków, ale przy 60 działach i małej zmienności tej zmiennej to wynik mało informatywny, a nie dowód braku związku.
Pamiętaj o ograniczeniu z początku wpisu: związek klimatu z częstością wypadków w danych z dokumentacji może częściowo wynikać z tego, że działy o słabym klimacie rzadziej zgłaszają zdarzenia (Probst i in., 2008). W tym kierunku zaniżanie działałoby przeciwko obserwowanemu związkowi, ale przy innych zmiennych może go tworzyć – zawsze rozważ oba scenariusze w dyskusji.
Krok 5. Co się stanie bez offsetu
Ten sam model ujemny dwumianowy bez offsetu, czyli analiza samej liczby wypadków, dał dla magazynu IRR = 0.64, 95% CI [0.41, 1.00], p = .051, a dla utrzymania ruchu IRR = 0.41, 95% CI [0.24, 0.70], p < .001 – jakby te działy były bezpieczniejsze od produkcji. Rysunek 1B pokazuje to odwrócenie. Zliczenia bez czasu narażenia mówią, gdzie pracuje najwięcej ludzi, a nie gdzie praca jest najbardziej ryzykowna. Opis gotowego modelu możesz porównać z wynikiem generatora opisu wyników APA.
Projekt 4. Dolegliwości mięśniowo-szkieletowe
Pytanie o dolegliwości w ciągu ostatnich 12 miesięcy to standard w badaniach ergonomicznych. Kuorinka i in. (1987) opracowali w tym celu standaryzowane kwestionariusze nordyckie: pytania z wymuszonym wyborem o objawy w poszczególnych okolicach ciała, do samodzielnego wypełnienia albo do wywiadu. Autorzy ocenili ich rzetelność jako akceptowalną. Jeśli korzystasz z polskiej wersji, podaj w pracy, skąd ją wziąłeś i kto ją adaptował – nie zakładaj, że każde tłumaczenie znalezione w internecie jest wersją sprawdzoną.
Przykład: 420 pracowników produkcji i magazynu odpowiedziało, czy w ciągu ostatnich 12 miesięcy odczuwało dolegliwości odcinka lędźwiowego. Dolegliwości zgłosiło 35.7% osób: 48.7% wśród osób, które codziennie dźwigają ciężary, i 25.3% wśród pozostałych. Predyktory to dźwiganie (tak/nie), praca w pochyleniu dłużej niż 2 godziny dziennie (tak/nie), wiek (na 10 lat) i płeć.
Iloraz szans czy iloraz chorobowości
Regresja logistyczna to domyślny wybór dla wyniku tak/nie. Dźwiganie wiązało się z wyższymi szansami dolegliwości, OR = 2.50, 95% CI [1.64, 3.82], p < .001, podobnie praca w pochyleniu, OR = 1.92, 95% CI [1.26, 2.94], p = .002. Wiek (OR = 1.19 na 10 lat, p = .068) i płeć (OR = 1.00, p = .992) nie były istotne. Gdy dolegliwość jest częsta (tu ponad jedna trzecia osób), iloraz szans wyraźnie odbiega od tego, jak czytelnik intuicyjnie rozumie „ile razy częściej”. Thompson i in. (1998) pokazali, że w danych przekrojowych iloraz szans chorobowości jest trudny do interpretacji, a przy związku dodatnim zawsze większy niż iloraz chorobowości (PR).
Jeśli chcesz podać „ile razy częściej”, oszacuj PR zmodyfikowaną regresją Poissona – regresją Poissona dla wyniku 0/1 z odpornym błędem standardowym (Zou, 2004). Na tych samych danych dźwiganie wiązało się z chorobowością wyższą 1.76 raza, 95% CI [1.35, 2.31], p < .001, a praca w pochyleniu – 1.48 raza, 95% CI [1.14, 1.93], p = .003. Wniosek o kierunku i istotności jest ten sam, ale „2.50” i „1.76” to bardzo różne komunikaty dla pracodawcy. Wybierz miarę przed analizą i nie opisuj OR słowami „ryzyko większe 2.5 raza”. Pełną procedurę regresji logistycznej z diagnostyką opisuje wpis regresja logistyczna krok po kroku, wersję z menu – regresja logistyczna w jamovi, a ćwiczenia z odczytu OR – zadania z regresji logistycznej.
Projekt 5. Pomiary antropometryczne i percentyle
W ergonomii stanowiska wymiary ciała użytkowników służą do ustalenia zakresu regulacji: wysokości siedziska, blatu, zasięgu. Często projektuje się tak, by stanowisko obsłużyło osoby od 5. do 95. percentyla wymiaru w populacji użytkowników. Statystycznie oznacza to trzy pytania: jak policzyć percentyl z próby, jak dokładne jest to oszacowanie i co się dzieje, gdy wymiarów jest kilka.
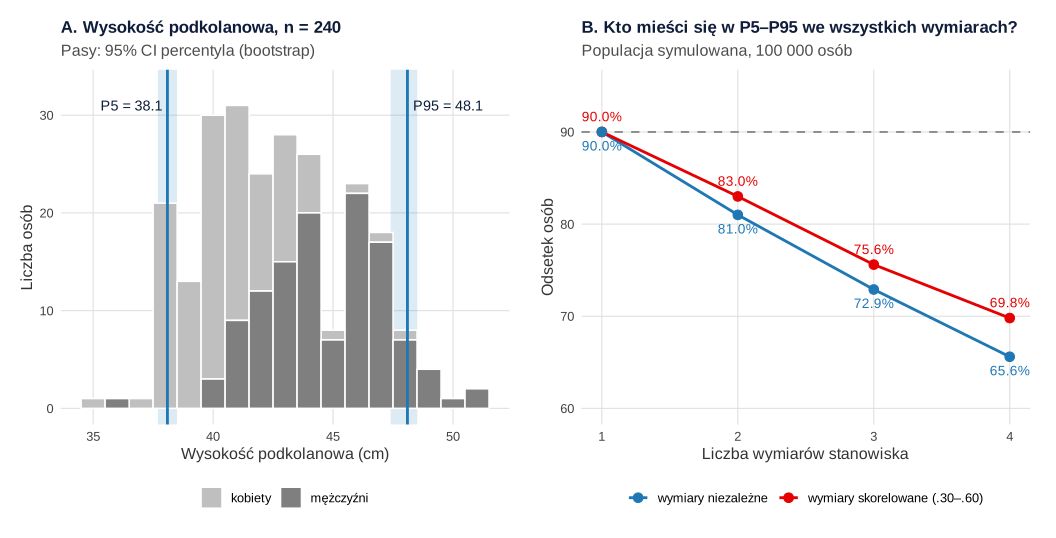
Przykład: zmierzono wysokość podkolanową w pozycji siedzącej u 240 pracowników (120 kobiet i 120 mężczyzn). W całej próbie P5 = 38.1 cm, mediana = 42.5 cm, a P95 = 48.1 cm.
Którą definicję percentyla wybrać i jak dokładny jest wynik
Hyndman i Fan (1996) pokazali, że programy statystyczne stosują wiele różnych definicji kwantyla z próby, czasem inną w obliczeniach, a inną na wykresie. W tym przykładzie cztery popularne definicje dały P5 od 38.00 do 38.09 cm i P95 równe 48.10 cm, więc przy 240 osobach różnice są pomijalne. Przy 30 osobach mogą już mieć znaczenie – w pracy napisz, jakiego programu i jakiej metody użyłeś.
Ważniejsza od definicji jest niepewność. Bootstrapowy 95% przedział ufności wynosił [37.7, 38.5] cm dla P5 i [47.4, 48.5] cm dla P95. Skrajne percentyle opierają się na nielicznych osobach z ogona rozkładu, więc przy małej próbie przedział jest szeroki. Jeśli celem jest bezpieczny projekt, rozważ granice przedziału, a nie samą wartość punktową.
Zwróć też uwagę, kim są użytkownicy. W próbie mieszanej percentyle zależą od proporcji kobiet i mężczyzn: P5 u kobiet wynosił 37.7 cm, a P95 u mężczyzn 48.6 cm, podczas gdy P5 i P95 łącznej próby – 38.1 i 48.1 cm. Jeśli na stanowisku mogą pracować obie płcie, zakres regulacji lepiej oprzeć na P5 kobiet i P95 mężczyzn niż na percentylach próby, w której przypadkiem przeważa jedna płeć.
Kilka wymiarów naraz
Zakres P5–P95 w jednym wymiarze obejmuje 90% osób. Stanowisko ma jednak kilka wymiarów, a osoba z 95. percentylem wysokości podkolanowej nie musi mieć 95. percentyla długości uda. W symulowanej populacji 100 000 osób z czterema wymiarami skorelowanymi na poziomie .30–.60 w przedziale P5–P95 we wszystkich czterech wymiarach naraz mieściło się 69.8% osób, a przy dwóch wymiarach – 83.0%. Gdyby wymiary były niezależne, odsetek spadłby do 65.6%. „Stanowisko dla 90% użytkowników” zaprojektowane wymiar po wymiarze obejmuje w praktyce mniej osób. W pracy policz więc odsetek osób z Twojej próby, które mieszczą się we wszystkich zakresach naraz, zamiast powtarzać „od P5 do P95”.
Pomiar antropometryczny ma też swój błąd: przy dwóch pomiarach tej samej osoby wynik nie jest identyczny. Jeśli mierzy kilku badaczy, oceń zgodność współczynnikiem ICC na podwójnych pomiarach części osób.
Jak opisać analizę statystyczną w pracy z BHP
Rozdział metodologiczny powinien pozwolić innej osobie powtórzyć badanie. W pracy z BHP opisz dodatkowo źródło danych o zdarzeniach (rejestr, karty, ankieta), sposób liczenia czasu narażenia i strukturę danych (pracownicy w brygadach, pomiary powtarzane). Poniżej wzór akapitu dla projektów 1, 3 i 4.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: wypadki z czasem narażenia i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1 z pełną analizą wypadków: od porównania liczb i częstości, przez regresję Poissona z offsetem i regresję ujemną dwumianową, po ilorazy częstości, model bez offsetu i przewidywane wskaźniki na 100 000 roboczogodzin. Przepis 1 zapisuje też dane do pobrania (CSV). Przepis 2 zawiera pozostałe projekty, a przepis 3 – rysunki. Każdy projekt tworzy własne dane symulowane.
1. Projekt 3: wypadki w działach – offset, nadmierna dyspersja, regresja ujemna dwumianowa i IRR
R
# Projekt 3: wypadki przy pracy w działach zakładu – liczba zdarzeń i czas narażenia (dane symulowane).
# 60 działów, okres 3 lat; zmienne: typ działu, przepracowane roboczogodziny, odsetek godzin
# na zmianie nocnej, średni wynik klimatu bezpieczeństwa w dziale (1–5).
suppressPackageStartupMessages(library(MASS))
set.seed(41803)
n <- 60
typ <- factor(rep(c("produkcja", "magazyn", "utrzymanie ruchu"), times = c(28, 18, 14)),
              levels = c("produkcja", "magazyn", "utrzymanie ruchu"))
pracownicy <- round(ifelse(typ == "produkcja", runif(n, 25, 70), ifelse(typ == "magazyn", runif(n, 8, 30), runif(n, 6, 20))))
godziny <- round(pracownicy * 3 * runif(n, 1550, 1750))          # roboczogodziny w ciągu 3 lat
nocne <- round(pmin(.5, pmax(0, rnorm(n, .2, .1))), 2)             # odsetek godzin na zmianie nocnej
klimat <- round(pmin(5, pmax(1, rnorm(n, 3.4, .45))), 2)           # średni klimat bezpieczeństwa działu
log_tempo <- log(2.2) + c(0, .55, .35)[as.integer(typ)] + 1.2 * (nocne - .2) - .45 * (klimat - 3.4)
wypadki <- rnbinom(n, mu = exp(log_tempo) * godziny / 1e5, size = 6)
dzialy <- data.frame(dzial = sprintf("D%02d", 1:n), typ, pracownicy, godziny, nocne, klimat, wypadki)
write.csv(dzialy, "../bhp-wypadki-dzialy-dane.csv", row.names = FALSE)

# Krok 1. Liczba wypadków a wskaźnik na 100 000 roboczogodzin w typach działów
agr <- aggregate(cbind(wypadki, godziny) ~ typ, data = dzialy, FUN = sum)
agr$na_100_tys_h <- round(1e5 * agr$wypadki / agr$godziny, 2)
agr$udzial_wypadkow_proc <- round(100 * agr$wypadki / sum(agr$wypadki), 1)
agr$udzial_godzin_proc <- round(100 * agr$godziny / sum(agr$godziny), 1)
print(agr, row.names = FALSE)
round(c(M = mean(dzialy$wypadki), Wariancja = var(dzialy$wypadki), Zera = sum(dzialy$wypadki == 0)), 2)

# Krok 2. Regresja Poissona z offsetem log(roboczogodziny / 100 000) i współczynnik rozproszenia
m_pois <- glm(wypadki ~ typ + nocne + klimat + offset(log(godziny / 1e5)), family = poisson, data = dzialy)
round(sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois), 2)

# Krok 3. Regresja ujemna dwumianowa z tym samym offsetem; test ilorazu wiarygodności (p / 2 – granica)
m_nb <- glm.nb(wypadki ~ typ + nocne + klimat + offset(log(godziny / 1e5)), data = dzialy)
lr <- as.numeric(2 * (logLik(m_nb) - logLik(m_pois)))
signif(c(LR = lr, p = pchisq(lr, 1, lower.tail = FALSE) / 2, theta = m_nb$theta,
         AIC_Poisson = AIC(m_pois), AIC_NB = AIC(m_nb)), 4)

# Krok 4. Ilorazy częstości (IRR) z 95% CI (Wald); klimat i nocne przeskalowane na sensowne przyrosty
irr <- function(m) {
  b <- coef(m)[-1]; se <- sqrt(diag(vcov(m)))[-1]
  skala <- ifelse(names(b) == "nocne", .1, 1)                   # nocne: +10 punktów procentowych
  data.frame(IRR = round(exp(b * skala), 3), CI_d = round(exp((b - 1.96 * se) * skala), 3),
             CI_g = round(exp((b + 1.96 * se) * skala), 3), z = round(b / se, 2), p = signif(2 * pnorm(-abs(b / se)), 3))
}
cat("Poisson:\n"); print(irr(m_pois))
cat("Ujemna dwumianowa:\n"); print(irr(m_nb))

# Krok 5. Błąd: model bez offsetu (liczba wypadków zamiast częstości)
m_bez <- glm.nb(wypadki ~ typ + nocne + klimat, data = dzialy)
cat("Bez offsetu:\n"); print(irr(m_bez))

# Krok 6. Przewidywany wskaźnik na 100 000 roboczogodzin (NB) przy średnich wartościach nocne i klimat
nowe <- data.frame(typ = factor(levels(typ), levels = levels(typ)), nocne = mean(dzialy$nocne),
                   klimat = mean(dzialy$klimat), godziny = 1e5)
print(data.frame(typ = nowe$typ, na_100_tys_h = round(predict(m_nb, nowe, type = "response"), 2)), row.names = FALSE)
round(c(nocne_M = mean(dzialy$nocne), klimat_M = mean(dzialy$klimat)), 2)
Wynik w R
              typ wypadki godziny na_100_tys_h udzial_wypadkow_proc udzial_godzin_proc
        produkcja     154 6753572         2.28                 61.4               72.4
          magazyn      65 1738458         3.74                 25.9               18.6
 utrzymanie ruchu      32  835634         3.83                 12.7                9.0
        M Wariancja      Zera
     4.18     14.02      5.00
[1] 1.84
         LR           p       theta AIC_Poisson      AIC_NB
  1.539e+01   4.378e-05   5.006e+00   2.945e+02   2.811e+02
Poisson:
                      IRR  CI_d  CI_g     z        p
typmagazyn          1.636 1.217 2.198  3.26 0.001100
typutrzymanie ruchu 1.680 1.146 2.464  2.66 0.007890
nocne               1.021 0.893 1.169  0.31 0.757000
klimat              0.563 0.430 0.738 -4.17 0.000031
Ujemna dwumianowa:
                      IRR  CI_d  CI_g     z      p
typmagazyn          1.653 1.100 2.485  2.42 0.0156
typutrzymanie ruchu 1.687 1.034 2.752  2.09 0.0364
nocne               1.027 0.848 1.244  0.27 0.7840
klimat              0.585 0.400 0.856 -2.76 0.0058
Bez offsetu:
                      IRR  CI_d  CI_g     z        p
typmagazyn          0.639 0.408 1.002 -1.95 0.051100
typutrzymanie ruchu 0.410 0.242 0.695 -3.32 0.000916
nocne               0.970 0.783 1.201 -0.28 0.778000
klimat              0.612 0.403 0.931 -2.29 0.021900
              typ na_100_tys_h
        produkcja         2.21
          magazyn         3.65
 utrzymanie ruchu         3.72
 nocne_M klimat_M
    0.20     3.43
2. Projekty 1, 2, 4 i 5
R
# Pozostałe projekty z wpisu (dane symulowane): klimat bezpieczeństwa w brygadach, NASA-TLX
# w trzech wariantach stanowiska, dolegliwości odcinka lędźwiowego i percentyle antropometryczne.
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(psych); library(afex)
  library(emmeans); library(sandwich); library(lmtest); library(boot) })

# ---- Projekt 1. Klimat bezpieczeństwa: 360 pracowników w 24 brygadach, trzy typy stanowisk ----
set.seed(41811)
k <- 24; m <- 15
brygada <- factor(rep(sprintf("B%02d", 1:k), each = m))
stanowisko <- factor(rep(rep(c("produkcja", "magazyn", "utrzymanie ruchu"), each = 8), each = m),
                     levels = c("produkcja", "magazyn", "utrzymanie ruchu"))
u_bryg <- rep(rnorm(k, 0, .45), each = m)                          # wspólny „klimat” brygady
efekt_st <- c(0, -.25, .10)[as.integer(stanowisko)]
latent <- efekt_st + u_bryg + rnorm(k * m, 0, .85)
lad <- c(.75, .70, .72, .68, .65, .74, .60, .70)
pozycje <- sapply(lad, function(l) {
  y <- l * latent + rnorm(k * m, 0, .7)
  as.integer(cut(y, breaks = c(-Inf, -1.5, -.5, .4, 1.3, Inf)))   # odpowiedzi 1–5
})
colnames(pozycje) <- paste0("kb", 1:8)
klimat <- data.frame(brygada, stanowisko, pozycje)
klimat$wynik <- rowMeans(pozycje)
round(c(M = mean(klimat$wynik), SD = sd(klimat$wynik), alfa = psych::alpha(pozycje)$total$raw_alpha), 2)
l1 <- psych::fa(pozycje, nfactors = 1)$loadings[, 1]
round(c(omega = sum(l1)^2 / (sum(l1)^2 + sum(1 - l1^2))), 2)
# ICC(1) z modelu pustego i efekt schematu
m0 <- lmer(wynik ~ 1 + (1 | brygada), data = klimat)
vc <- as.data.frame(VarCorr(m0))$vcov
icc <- vc[1] / sum(vc)
deff <- 1 + (m - 1) * icc
round(c(ICC1 = icc, deff = deff, n_efektywne = k * m / deff), 3)
# Błąd: zwykła ANOVA na osobach (ignoruje brygady) vs model mieszany (stanowisko na poziomie brygady)
print(summary(aov(wynik ~ stanowisko, data = klimat)))
m1 <- lmer(wynik ~ stanowisko + (1 | brygada), data = klimat)
print(anova(m1))
print(round(summary(m1)$coefficients, 3))
print(aggregate(wynik ~ stanowisko, data = klimat, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2)))
# Symulacja: 500 badań bez żadnej różnicy między stanowiskami – jak często każda analiza daje p < .05?
set.seed(41819)
odrzucenia <- replicate(500, {
  y <- rep(rnorm(k, 0, .45), each = m) + rnorm(k * m, 0, .85)
  d <- data.frame(y, stanowisko, brygada)
  c(anova_osoby = summary(aov(y ~ stanowisko, data = d))[[1]][1, 5] < .05,
    model_mieszany = anova(lmer(y ~ stanowisko + (1 | brygada), data = d))[1, 6] < .05)
})
round(100 * rowMeans(odrzucenia), 1)

# ---- Projekt 2. NASA-TLX (Raw TLX, 0–100) u 24 operatorów w trzech wariantach stanowiska ----
set.seed(41812)
n2 <- 24
osoba <- rnorm(n2, 0, 9)
war <- c("standardowe", "regulowana wysokość", "z manipulatorem")
tlx <- data.frame(id = factor(rep(1:n2, times = 3)), wariant = factor(rep(war, each = n2), levels = war),
                  tlx = round(pmin(100, pmax(0, 55 + rep(osoba, 3) + rep(c(0, -4, -9), each = n2) +
                                   rnorm(3 * n2, 0, rep(c(6, 7, 9), each = n2)))), 1))
print(aggregate(tlx ~ wariant, data = tlx, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 1)))
a2 <- aov_ez("id", "tlx", data = tlx, within = "wariant", anova_table = list(correction = "GG", es = "pes"))
print(a2)
sf <- suppressWarnings(summary(a2))
print(round(sf$sphericity.tests, 3))
print(round(sf$pval.adjustments[, "GG eps", drop = FALSE], 3))
ph <- as.data.frame(summary(pairs(emmeans(a2, ~ wariant), adjust = "holm"), infer = TRUE))
ph[, -1] <- round(ph[, -1], 3)
print(ph, row.names = FALSE)                                       # CI z korektą Bonferroniego, p – Holma

# ---- Projekt 4. Dolegliwości odcinka lędźwiowego w ostatnich 12 miesiącach (tak/nie), n = 420 ----
set.seed(41814)
n4 <- 420
dzwiganie <- rbinom(n4, 1, .45)
pochylenie <- rbinom(n4, 1, .35 + .2 * dzwiganie)
wiek <- round(runif(n4, 20, 62))
kobieta <- rbinom(n4, 1, .4)
p_true <- pmin(.95, .22 * 1.55^dzwiganie * 1.35^pochylenie * exp(.012 * (wiek - 40)) * 1.1^kobieta)
ledzwie <- rbinom(n4, 1, p_true)
msk <- data.frame(ledzwie, dzwiganie, pochylenie, wiek, kobieta)
round(c(odsetek_proc = 100 * mean(msk$ledzwie)), 1)
print(round(100 * prop.table(table(dzwiganie = msk$dzwiganie, ledzwie = msk$ledzwie), 1), 1))
m_log <- glm(ledzwie ~ dzwiganie + pochylenie + I(wiek / 10) + kobieta, family = binomial, data = msk)
or <- cbind(OR = exp(coef(m_log)), exp(confint.default(m_log)))[-1, ]
print(round(or, 2)); print(signif(summary(m_log)$coefficients[-1, 4], 3))
# Zmodyfikowana regresja Poissona (Zou, 2004): iloraz chorobowości (PR) z odpornym SE
m_pr <- glm(ledzwie ~ dzwiganie + pochylenie + I(wiek / 10) + kobieta, family = poisson, data = msk)
ct <- coeftest(m_pr, vcov = vcovHC(m_pr, type = "HC0"))
pr <- cbind(PR = exp(ct[, 1]), CI_d = exp(ct[, 1] - 1.96 * ct[, 2]), CI_g = exp(ct[, 1] + 1.96 * ct[, 2]))[-1, ]
print(round(pr, 2)); print(signif(ct[-1, 4], 3))

# ---- Projekt 5. Percentyle antropometryczne: wysokość podkolanowa w pozycji siedzącej (cm), n = 240 ----
set.seed(41815)
plec <- rep(c("K", "M"), each = 120)
podkol <- round(ifelse(plec == "K", rnorm(240, 40.5, 2.1), rnorm(240, 44.6, 2.4)), 1)
print(round(quantile(podkol, c(.05, .5, .95), type = 7), 1))
print(round(sapply(c(4, 6, 7, 8), function(t) quantile(podkol, c(.05, .95), type = t)), 2))
print(round(tapply(podkol, plec, quantile, probs = c(.05, .95)) |> simplify2array(), 1))
b <- boot(podkol, function(x, i) quantile(x[i], c(.05, .95)), R = 2000)
print(round(rbind(P5 = boot.ci(b, type = "perc", index = 1)$percent[4:5],
                  P95 = boot.ci(b, type = "perc", index = 2)$percent[4:5]), 1))
# Ile osób mieści się w przedziale P5–P95 we wszystkich czterech wymiarach naraz?
# Populacja symulowana: 4 wymiary stanowiska, korelacje .30–.60 (rozkład normalny wielowymiarowy)
R <- matrix(c(1, .6, .3, .5, .6, 1, .4, .4, .3, .4, 1, .3, .5, .4, .3, 1), 4)
pop <- MASS::mvrnorm(1e5, rep(0, 4), R)
w_przedziale <- abs(pop) <= qnorm(.95)
round(100 * sapply(1:4, function(j) mean(apply(w_przedziale[, 1:j, drop = FALSE], 1, all))), 1)
round(100 * .9^(1:4), 1)                                            # gdyby wymiary były niezależne
Wynik w R
   M   SD alfa
2.93 0.77 0.87
omega
 0.87
       ICC1        deff n_efektywne
      0.168       3.352     107.400
             Df Sum Sq Mean Sq F value Pr(>F)
stanowisko    2   1.54  0.7724   1.317  0.269
Residuals   357 209.42  0.5866
Type III Analysis of Variance Table with Satterthwaite's method
            Sum Sq Mean Sq NumDF DenDF F value Pr(>F)
stanowisko 0.36239  0.1812     2    21  0.3682 0.6964
                           Estimate Std. Error df t value Pr(>|t|)
(Intercept)                   2.844      0.132 21  21.507    0.000
stanowiskomagazyn             0.154      0.187 21   0.824    0.419
stanowiskoutrzymanie ruchu    0.116      0.187 21   0.618    0.543
        stanowisko wynik.M wynik.SD
1        produkcja    2.84     0.82
2          magazyn    3.00     0.75
3 utrzymanie ruchu    2.96     0.73
   anova_osoby model_mieszany
          46.4            6.0
              wariant tlx.M tlx.SD
1         standardowe  57.6   10.7
2 regulowana wysokość  54.1   14.2
3     z manipulatorem  48.9   12.9
Anova Table (Type 3 tests)

Response: tlx
   Effect          df   MSE       F  pes p.value
1 wariant 1.88, 43.21 69.61 6.91 ** .231    .003
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
        Test statistic p-value
wariant          0.936    0.48
        GG eps
wariant  0.939
 contrast                              estimate    SE df lower.CL upper.CL t.ratio p.value
 standardowe - regulowana.wysokość        3.462 2.577 23   -3.191   10.116   1.344  0.1920
 standardowe - z.manipulatorem            8.625 2.338 23    2.588   14.662   3.689  0.0040
 regulowana.wysokość - z.manipulatorem    5.163 2.060 23   -0.156   10.481   2.506  0.0390

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 3 estimates
P value adjustment: holm method for 3 tests
odsetek_proc
        35.7
         ledzwie
dzwiganie    0    1
        0 74.7 25.3
        1 51.3 48.7
             OR 2.5 % 97.5 %
dzwiganie  2.50  1.64   3.82
pochylenie 1.92  1.26   2.94
I(wiek/10) 1.19  0.99   1.42
kobieta    1.00  0.65   1.55
 dzwiganie pochylenie I(wiek/10)    kobieta
  2.22e-05   2.48e-03   6.78e-02   9.92e-01
             PR CI_d CI_g
dzwiganie  1.76 1.35 2.31
pochylenie 1.48 1.14 1.93
I(wiek/10) 1.10 0.99 1.23
kobieta    1.00 0.77 1.30
 dzwiganie pochylenie I(wiek/10)    kobieta
  3.72e-05   3.12e-03   6.64e-02   9.91e-01
  5%  50%  95%
38.1 42.5 48.1
    [,1]  [,2]  [,3]  [,4]
5%  38.0 38.01 38.09 38.03
95% 48.1 48.10 48.10 48.10
       K    M
5%  37.7 40.9
95% 44.2 48.6
    [,1] [,2]
P5  37.7 38.5
P95 47.4 48.5
[1] 90.0 83.0 75.6 69.8
[1] 90.0 81.0 72.9 65.6
3. Rysunki
R
# Rysunki do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b418-rysunki.R > b418-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
pdf(NULL)
invisible(capture.output({ for (f in c("b418-1-wypadki-offset.R", "b418-2-pozostale-projekty.R")) source(f) }))

# Rysunek 1: wypadki – udział w wypadkach i w roboczogodzinach (A) oraz IRR z offsetem i bez (B)
d1 <- rbind(data.frame(typ = agr$typ, miara = "udział w wypadkach", proc = agr$udzial_wypadkow_proc),
            data.frame(typ = agr$typ, miara = "udział w roboczogodzinach", proc = agr$udzial_godzin_proc))
d1$miara <- factor(d1$miara, levels = c("udział w roboczogodzinach", "udział w wypadkach"))
print(d1, row.names = FALSE)
rA <- ggplot(d1, aes(typ, proc, fill = miara)) + geom_col(position = position_dodge(.75), width = .7) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), position = position_dodge(.75), vjust = -.4, size = 3.6) +
  scale_fill_manual(values = c("udział w roboczogodzinach" = "grey70", "udział w wypadkach" = KOLORY[["akcent"]]), name = NULL) +
  scale_y_continuous(limits = c(0, 80), expand = expansion(mult = c(0, .02))) +
  labs(title = "A. Wypadki i czas narażenia", subtitle = "60 działów, 3 lata, 251 wypadków",
       x = NULL, y = "Odsetek sumy") + theme_metodolog(12)
ir <- rbind(cbind(model = "z offsetem (częstość)", irr(m_nb), zm = rownames(irr(m_nb))),
            cbind(model = "bez offsetu (liczba)", irr(m_bez), zm = rownames(irr(m_bez))))
ir <- ir[ir$zm %in% c("typmagazyn", "typutrzymanie ruchu", "klimat"), ]
ir$zm <- factor(ir$zm, levels = c("klimat", "typutrzymanie ruchu", "typmagazyn"),
                labels = c("Klimat bezpieczeństwa\n(+1 pkt)", "Utrzymanie ruchu\nvs produkcja", "Magazyn\nvs produkcja"))
ir$model <- factor(ir$model, levels = c("z offsetem (częstość)", "bez offsetu (liczba)"))
print(ir[, c("model", "zm", "IRR", "CI_d", "CI_g", "p")], row.names = FALSE)
pos <- position_dodge(width = .5)
rB <- ggplot(ir, aes(IRR, zm, colour = model)) + geom_vline(xintercept = 1, colour = "grey45", linetype = 2) +
  geom_errorbar(aes(xmin = CI_d, xmax = CI_g), width = .18, orientation = "y", linewidth = .9, position = pos) +
  geom_point(size = 3, position = pos) + scale_x_log10(breaks = c(.25, .5, 1, 2, 3)) +
  scale_colour_manual(values = c("z offsetem (częstość)" = KOLORY[["drugi"]], "bez offsetu (liczba)" = "grey55"), name = NULL) +
  labs(title = "B. Ilorazy częstości (IRR) z 95% CI", subtitle = "Regresja ujemna dwumianowa, skala logarytmiczna",
       x = "IRR (1 = brak związku)", y = NULL) + theme_metodolog(12)
zapisz_svg(rA + rB + plot_layout(widths = c(1, 1.1)), "../statystyka-bhp-wypadki-offset.svg", szer = 11, wys = 5.6)

# Rysunek 2: antropometria – rozkład wysokości podkolanowej z P5 i P95 (A) i odsetek osób mieszczących się
# w przedziale P5–P95 jednocześnie w 1–4 wymiarach (B)
q <- quantile(podkol, c(.05, .95), type = 7)
ci <- rbind(boot.ci(b, type = "perc", index = 1)$percent[4:5], boot.ci(b, type = "perc", index = 2)$percent[4:5])
dA <- data.frame(podkol, plec = factor(plec, labels = c("kobiety", "mężczyźni")))
rA2 <- ggplot(dA, aes(podkol, fill = plec)) +
  annotate("rect", xmin = ci[, 1], xmax = ci[, 2], ymin = -Inf, ymax = Inf, fill = KOLORY[["drugi"]], alpha = .15) +
  geom_histogram(binwidth = 1, colour = "white", position = "stack") +
  geom_vline(xintercept = q, colour = KOLORY[["drugi"]], linewidth = 1) +
  annotate("text", x = q, y = 31, label = sprintf(c("P5 = %.1f", "P95 = %.1f"), q), hjust = c(1.08, -.08), size = 3.8, colour = KOLORY[["granat"]]) +
  scale_fill_manual(values = c("kobiety" = "grey75", "mężczyźni" = "grey50"), name = NULL) +
  scale_y_continuous(limits = c(0, 33)) +
  labs(title = "A. Wysokość podkolanowa, n = 240", subtitle = "Pasy: 95% CI percentyla (bootstrap)",
       x = "Wysokość podkolanowa (cm)", y = "Liczba osób") + theme_metodolog(12)
dB <- data.frame(k = rep(1:4, 2), proc = c(round(100 * sapply(1:4, function(j) mean(apply(w_przedziale[, 1:j, drop = FALSE], 1, all))), 1),
                                            round(100 * .9^(1:4), 1)),
                 zal = rep(c("wymiary skorelowane (.30–.60)", "wymiary niezależne"), each = 4))
print(dB, row.names = FALSE)
rB2 <- ggplot(dB, aes(k, proc, colour = zal)) + geom_hline(yintercept = 90, colour = "grey45", linetype = 2) +
  geom_line(linewidth = 1) + geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), vjust = ifelse(dB$zal == "wymiary niezależne", 1.9, -1.1), size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = c("wymiary skorelowane (.30–.60)" = KOLORY[["akcent"]], "wymiary niezależne" = KOLORY[["drugi"]]), name = NULL) +
  scale_y_continuous(limits = c(60, 95)) +
  labs(title = "B. Kto mieści się w P5–P95 we wszystkich wymiarach?", subtitle = "Populacja symulowana, 100 000 osób",
       x = "Liczba wymiarów stanowiska", y = "Odsetek osób") + theme_metodolog(12)
zapisz_svg(rA2 + rB2 + plot_layout(widths = c(1, 1)), "../statystyka-bhp-percentyle-antropometria.svg", szer = 11, wys = 5.6)
Wynik w R
              typ                     miara proc
        produkcja        udział w wypadkach 61.4
          magazyn        udział w wypadkach 25.9
 utrzymanie ruchu        udział w wypadkach 12.7
        produkcja udział w roboczogodzinach 72.4
          magazyn udział w roboczogodzinach 18.6
 utrzymanie ruchu udział w roboczogodzinach  9.0
                 model                              zm   IRR  CI_d  CI_g        p
 z offsetem (częstość)           Magazyn\nvs produkcja 1.653 1.100 2.485 0.015600
 z offsetem (częstość)  Utrzymanie ruchu\nvs produkcja 1.687 1.034 2.752 0.036400
 z offsetem (częstość) Klimat bezpieczeństwa\n(+1 pkt) 0.585 0.400 0.856 0.005800
  bez offsetu (liczba)           Magazyn\nvs produkcja 0.639 0.408 1.002 0.051100
  bez offsetu (liczba)  Utrzymanie ruchu\nvs produkcja 0.410 0.242 0.695 0.000916
  bez offsetu (liczba) Klimat bezpieczeństwa\n(+1 pkt) 0.612 0.403 0.931 0.021900
Zapisano ../statystyka-bhp-wypadki-offset.svg: w HTML width="1100" height="560" (15 KB)
 k proc                           zal
 1 90.0 wymiary skorelowane (.30–.60)
 2 83.0 wymiary skorelowane (.30–.60)
 3 75.6 wymiary skorelowane (.30–.60)
 4 69.8 wymiary skorelowane (.30–.60)
 1 90.0            wymiary niezależne
 2 81.0            wymiary niezależne
 3 72.9            wymiary niezależne
 4 65.6            wymiary niezależne
Zapisano ../statystyka-bhp-percentyle-antropometria.svg: w HTML width="1100" height="560" (19 KB)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje glm(), aov(), quantile() i predict() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- afex (wersja 1.5-1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. S. (2025). afex: Analysis of factorial experiments (R package version 1.5-1) [Computer software]. https://doi.org/10.32614/CRAN.package.afex
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.emmeans
- sandwich (wersja 3.1-1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9-40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z BHP i ergonomii
- Porównywanie liczby wypadków między działami bez czasu narażenia. W przykładzie produkcja miała najwięcej wypadków, a najniższą częstość na roboczogodzinę; model bez offsetu odwrócił kierunek różnic.
- Regresja Poissona bez sprawdzenia nadmiernej dyspersji – zbyt wąskie przedziały ufności i zbyt małe wartości p.
- Dane z rejestru traktowane jak pełny obraz zdarzeń, bez wzmianki o niezgłaszaniu i o tym, że może ono zależeć od klimatu bezpieczeństwa działu.
- Pracownicy z brygad analizowani jak niezależne osoby. Przy ICC(1) = .17 i 15 osobach w brygadzie zwykła ANOVA w symulacji dawała fałszywie istotny wynik w 46.4% badań.
- Iloraz szans opisany jako „ryzyko większe X razy” przy częstej dolegliwości; OR = 2.50 odpowiadał tu ilorazowi chorobowości 1.76.
- Wnioski przyczynowe z badania przekrojowego i pominięcie efektu zdrowego pracownika – osoby z najsilniejszymi dolegliwościami mogły już odejść ze stanowiska.
- Kilka wariantów stanowiska porównanych testami t bez poprawki albo pominięcie tego, że oceny pochodzą od tych samych osób.
- Percentyle bez przedziału ufności, z próby, w której jedna płeć przypadkiem przeważa, i „90% użytkowników” policzone wymiar po wymiarze.
- Dane o wypadkach w kraju lub branży we wstępie bez źródła i bez definicji wypadku.
- Wyniki dla kilkuosobowych działów, które pozwalają rozpoznać konkretnych pracowników.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy dyplomowej z BHP?
Zależy to od rodzaju danych. Liczbę wypadków analizuj regresją Poissona albo ujemną dwumianową z czasem narażenia jako offsetem, dolegliwość tak/nie – regresją logistyczną, wynik skali zebranej w brygadach – modelem wielopoziomowym, a oceny tych samych osób w kilku wariantach stanowiska – ANOVA z powtarzanymi pomiarami. Przy każdej analizie podaj wielkość efektu z 95% CI: IRR, OR, b albo ηp².
Jak policzyć wskaźnik wypadków na roboczogodziny w pracy magisterskiej?
Podziel liczbę wypadków przez liczbę przepracowanych roboczogodzin i pomnóż np. przez 100 000. Aby porównać działy z kontrolą innych zmiennych, użyj regresji Poissona albo ujemnej dwumianowej z offsetem log(roboczogodziny). Wyniki podaj jako ilorazy częstości (IRR) z 95% CI i jako przewidywaną liczbę wypadków na 100 000 roboczogodzin.
Czy ankietę klimatu bezpieczeństwa z kilku brygad można analizować zwykłą ANOVA?
Zwykle nie, jeśli porównujesz cechy brygad, np. typ stanowiska. Pracownicy jednej brygady odpowiadają podobnie, więc nie są niezależnymi obserwacjami. Policz ICC z modelu pustego i użyj modelu wielopoziomowego z losowym wyrazem wolnym brygady. W symulacji z tego wpisu zwykła ANOVA dawała fałszywie istotny wynik w prawie połowie badań.
Iloraz szans czy iloraz chorobowości przy dolegliwościach mięśniowo-szkieletowych?
Gdy dolegliwość jest częsta, iloraz szans jest wyraźnie większy niż iloraz chorobowości i nie oznacza „ile razy częściej”. Możesz podać OR z regresji logistycznej, ale opisz go jako iloraz szans. Jeśli chcesz mówić o krotności chorobowości, oszacuj PR zmodyfikowaną regresją Poissona z odpornym błędem standardowym.
Jak wyznaczyć 5. i 95. percentyl wymiarów ciała do projektu stanowiska?
Policz percentyle w próbie użytkowników i podaj metodę ich wyznaczania oraz przedział ufności, np. z bootstrapu. Przy próbie mieszanej sprawdź percentyle osobno dla kobiet i mężczyzn. Pamiętaj, że zakres P5–P95 w każdym z kilku wymiarów osobno obejmuje razem mniej niż 90% osób – policz, ilu pracowników mieści się we wszystkich zakresach naraz.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z logistyki
Czasy dostaw i percentyle, błędy kompletacji na 1000 linii, przerwany szereg czasowy w magazynie, dostawcy jako skupienia i prognoza popytu: analizy, zdania APA i kod R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikNASA-TLX – obciążenie zadaniem: jak policzyć wynik
Oceny 0–100, wagi z 15 porównań parami, wynik ważony i Raw TLX według źródeł NASA oraz porównanie warunków zadania na profilu podskal – z przykładem w R i wzorem opisu.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z BHP lub ergonomii i nie wiesz, jak policzyć wyniki?
Pomożemy dobrać analizy do Twoich danych – wypadków, ankiety klimatu bezpieczeństwa, NASA-TLX albo pomiarów – policzyć je z wielkością efektu i wyjaśnić tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Frome, E. L. (1983). The analysis of rates using Poisson regression models. Biometrics, 39(3), 665–674. https://doi.org/10.2307/2531094
- Hart, S. G. (2006). NASA-Task Load Index (NASA-TLX); 20 years later. Proceedings of the Human Factors and Ergonomics Society Annual Meeting, 50(9), 904–908. https://doi.org/10.1177/154193120605000909
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Kuorinka, I., Jonsson, B., Kilbom, A., Vinterberg, H., Biering-Sørensen, F., Andersson, G., & Jørgensen, K. (1987). Standardised Nordic questionnaires for the analysis of musculoskeletal symptoms. Applied Ergonomics, 18(3), 233–237. https://doi.org/10.1016/0003-6870(87)90010-x
- Li, C.-Y., & Sung, F.-C. (1999). A review of the healthy worker effect in occupational epidemiology. Occupational Medicine, 49(4), 225–229. https://doi.org/10.1093/occmed/49.4.225
- Probst, T. M., Brubaker, T. L., & Barsotti, A. (2008). Organizational injury rate underreporting: The moderating effect of organizational safety climate. Journal of Applied Psychology, 93(5), 1147–1154. https://doi.org/10.1037/0021-9010.93.5.1147
- Thompson, M. L., Myers, J. E., & Kriebel, D. (1998). Prevalence odds ratio or prevalence ratio in the analysis of cross sectional data: What is to be done? Occupational and Environmental Medicine, 55(4), 272–277. https://doi.org/10.1136/oem.55.4.272 ● Otwarty dostęp
- Zohar, D. (1980). Safety climate in industrial organizations: Theoretical and applied implications. Journal of Applied Psychology, 65(1), 96–102. https://doi.org/10.1037/0021-9010.65.1.96
- Zohar, D., & Luria, G. (2005). A multilevel model of safety climate: Cross-level relationships between organization and group-level climates. Journal of Applied Psychology, 90(4), 616–628. https://doi.org/10.1037/0021-9010.90.4.616
- Zou, G. (2004). A modified Poisson regression approach to prospective studies with binary data. American Journal of Epidemiology, 159(7), 702–706. https://doi.org/10.1093/aje/kwh090
Cytowania BibTeX
@article{frome1983analysis, author={Frome, Edward L.}, title={{The analysis of rates using Poisson regression models}}, journal={Biometrics}, year={1983}, volume={39}, number={3}, pages={665--674}, doi={10.2307/2531094}}@article{hart2006nasa, author={Hart, Sandra G.}, title={{NASA-Task Load Index (NASA-TLX); 20 years later}}, journal={Proceedings of the Human Factors and Ergonomics Society Annual Meeting}, year={2006}, volume={50}, number={9}, pages={904--908}, doi={10.1177/154193120605000909}}@article{hyndman1996sample, author={Hyndman, Rob J. and Fan, Yanan}, title={{Sample quantiles in statistical packages}}, journal={The American Statistician}, year={1996}, volume={50}, number={4}, pages={361--365}, doi={10.1080/00031305.1996.10473566}}@article{kuorinka1987standardised, author={Kuorinka, I. and Jonsson, B. and Kilbom, A. and Vinterberg, H. and Biering-Sørensen, F. and Andersson, G. and Jørgensen, K.}, title={{Standardised Nordic questionnaires for the analysis of musculoskeletal symptoms}}, journal={Applied Ergonomics}, year={1987}, volume={18}, number={3}, pages={233--237}, doi={10.1016/0003-6870(87)90010-x}}@article{li1999review, author={Li, C.-Y. and Sung, F.-C.}, title={{A review of the healthy worker effect in occupational epidemiology}}, journal={Occupational Medicine}, year={1999}, volume={49}, number={4}, pages={225--229}, doi={10.1093/occmed/49.4.225}}@article{probst2008organizational, author={Probst, Tahira M. and Brubaker, Ty L. and Barsotti, Anthony}, title={{Organizational injury rate underreporting: The moderating effect of organizational safety climate}}, journal={Journal of Applied Psychology}, year={2008}, volume={93}, number={5}, pages={1147--1154}, doi={10.1037/0021-9010.93.5.1147}}@article{thompson1998prevalence, author={Thompson, M. L. and Myers, J. E. and Kriebel, D.}, title={{Prevalence odds ratio or prevalence ratio in the analysis of cross sectional data: What is to be done?}}, journal={Occupational and Environmental Medicine}, year={1998}, volume={55}, number={4}, pages={272--277}, doi={10.1136/oem.55.4.272}}@article{zohar1980safety, author={Zohar, Dov}, title={{Safety climate in industrial organizations: Theoretical and applied implications}}, journal={Journal of Applied Psychology}, year={1980}, volume={65}, number={1}, pages={96--102}, doi={10.1037/0021-9010.65.1.96}}@article{zohar2005multilevel, author={Zohar, Dov and Luria, Gil}, title={{A multilevel model of safety climate: Cross-level relationships between organization and group-level climates}}, journal={Journal of Applied Psychology}, year={2005}, volume={90}, number={4}, pages={616--628}, doi={10.1037/0021-9010.90.4.616}}@article{zou2004modified, author={Zou, Guangyong}, title={{A modified Poisson regression approach to prospective studies with binary data}}, journal={American Journal of Epidemiology}, year={2004}, volume={159}, number={7}, pages={702--706}, doi={10.1093/aje/kwh090}}