Czym jest COPSOQ
Kopenhaski Kwestionariusz Psychospołeczny COPSOQ (Copenhagen Psychosocial Questionnaire) mierzy psychospołeczne warunki pracy: wymagania, wpływ na własną pracę, relacje z przełożonym i współpracownikami, zaufanie i sprawiedliwość w organizacji, a także stres, wypalenie i samopoczucie. To nie jest jedna skala, tylko zestaw kilkudziesięciu wymiarów. Każdy wymiar ma własny wynik.
Narzędzie pojawia się najczęściej w pracach z zarządzania, psychologii pracy, bezpieczeństwa i higieny pracy (BHP) oraz zdrowia publicznego, a w pielęgniarstwie – w badaniach warunków pracy na oddziałach. Ogólny warsztat tych kierunków opisują wpisy statystyka w pracy z zarządzania i ekonomii, statystyka dla psychologa, statystyka w pracy ze zdrowia publicznego i statystyka w pracy z pielęgniarstwa.
Pierwszą wersję opisali Kristensen, Hannerz, Høgh i Borg (2005). Opracowali ją na reprezentatywnej próbie 1858 duńskich pracowników w trzech długościach: długiej do badań naukowych (141 pytań, 30 wymiarów), średniej dla specjalistów BHP (95 pytań, 26 wymiarów) i krótkiej dla zakładów pracy (44 pytania, 8 wymiarów). Obecnie rozwija go międzynarodowa sieć COPSOQ. Trzecią wersję, COPSOQ III, przetestowano u 23 361 pracowników w sześciu krajach (Burr i in., 2019). Jej najważniejsza zmiana to obowiązkowe pozycje rdzeniowe (core items). Muszą się znaleźć w każdej wersji krajowej i są uzupełniane innymi pozycjami w wersji krótkiej, średniej albo długiej.
Jeśli interesuje Cię tylko wypalenie, sprawdź też CBI i OLBI. Zaangażowanie mierzy UWES-9, a zadowolenie z pracy – skala JSS.
Budowa i stan weryfikacji klucza
Treści pozycji nie przytaczamy. Burr i in. (2019) grupują wymiary COPSOQ III w obszary: wymagania w pracy, organizacja i treść pracy, relacje interpersonalne i przywództwo, styk pracy z życiem osobistym, kapitał społeczny, konflikty i zachowania obraźliwe oraz zdrowie i samopoczucie. Część wymiarów to skale wielopozycyjne, a część – pojedyncze pytania. Tabela pokazuje, które elementy klucza potwierdziliśmy i gdzie.
| Element | Co potwierdziliśmy | Źródło |
|---|---|---|
| Zakres wyniku | każdy wymiar w przedziale 0–100 | Burr i in. (2019) |
| Kierunek | każda skala punktowana w kierunku swojej nazwy: wyższy wynik = więcej tego, co nazwa opisuje | Burr i in. (2019); Berthelsen i in. (2020) |
| Punkty za odpowiedź | pięć odpowiedzi o wartościach 0, 25, 50, 75 i 100; wyjątek – pytanie o ogólny stan zdrowia ze skalą dziesięciostopniową | Lincke i in. (2021), wersja niemiecka, współautorzy COPSOQ III |
| Wynik skali | średnia punktów pozycji | Berthelsen i in. (2020); Lincke i in. (2021) |
| Braki | wynik liczony, gdy wypełniono co najmniej połowę pozycji skali | Berthelsen i in. (2020); Lincke i in. (2021) |
| Które odpowiedzi dają 0, a które 100 w danej pozycji | nie podajemy – zależy od brzmienia pozycji w Twojej wersji | dokumentacja wersji krajowej albo wytyczne sieci COPSOQ |
| Wynik ogólny, progi diagnostyczne | nie istnieją; sieć nie przyjmuje „prawdziwych” punktów odcięcia | Lincke i in. (2021) |
Kristensen i in. (2005) i Burr i in. (2019) to publikacje twórców narzędzia. Lincke i in. (2021) oraz Berthelsen i in. (2020) to walidacje wersji krajowych napisane przez współautorów COPSOQ III. Pełnego tekstu artykułu z 2005 r. nie czytaliśmy, dlatego reguły liczenia podajemy za nowszymi pracami.
Jak policzyć wynik krok po kroku
- Ustal wersję i listę wymiarów. Zapisz, czy używasz wersji krótkiej, średniej czy długiej, której wersji językowej i które wymiary weszły do ankiety. Wybierz wymiary potrzebne do pytań badawczych i zachowaj ich pozycje rdzeniowe.
- Przelicz odpowiedzi na punkty. Każdej z pięciu odpowiedzi przypisz 0, 25, 50, 75 albo 100 punktów, tak by wyższa liczba oznaczała więcej tego, co mówi nazwa skali. Przy części pozycji kolejność odpowiedzi w formularzu może być odwrotna – sprawdź to w dokumentacji swojej wersji.
- Policz średnią każdej skali. Wynik skali to średnia punktów jej pozycji, więc też mieści się w przedziale 0–100. Średnia, a nie suma, pozwala porównywać skale o różnej liczbie pozycji. Więcej o tym wyborze mówi hasło wynik skali: średnia czy suma.
- Zastosuj regułę połowy. Wynik skali liczysz, gdy osoba odpowiedziała na co najmniej połowę jej pozycji. W przeciwnym razie wynik to brak danych. Pozostałe decyzje o brakach opisuje wpis braki danych w ankiecie.
- Nie licz wyniku ogólnego. Wymiary mają różny kierunek: wysoki wynik wymagań jest niekorzystny, a wysoki wynik wsparcia – korzystny. Suma takich skal nie ma sensu.
Przekodowanie odpowiedzi na punkty w różnych programach pokazuje poradnik jak policzyć wynik kwestionariusza. Zapis 0–100 przypomina POMP, ale tu wynika z punktacji odpowiedzi, a nie z przeliczenia sumy.
Interpretacja: bez progów, z wartościami odniesienia
Wynik czytaj w kierunku nazwy skali. 60 punktów w wymaganiach ilościowych oznacza większe wymagania niż 40 punktów. 60 punktów we wsparciu od przełożonego oznacza więcej wsparcia.
Nie ma progów diagnostycznych. Lincke i in. (2021) piszą, że wytyczne COPSOQ nie traktują żadnych wartości odcięcia jako „prawdziwych”. Wynik porównuje się z wartościami odniesienia, czyli średnimi z badań populacyjnych w danym kraju. Takie wartości podają walidacje krajowe, np. szwedzka (Berthelsen i in., 2020). Nie przenoś ich do innego kraju bez komentarza i nie twórz własnych przedziałów „niski–wysoki” (zob. niski, przeciętny, wysoki wynik).
Jak duża różnica ma znaczenie? Pejtersen, Bjorner i Hasle (2010) wyznaczyli minimalnie ważne różnice dla skal pierwszej wersji. Zalecają m.in. 0.3 SD dla wymagań ilościowych, 0.2 SD dla wpływu w pracy, 0.7 SD dla wsparcia od przełożonego i 0.5 SD dla skal, dla których nie mieli danych z kotwicą. To punkt wyjścia do interpretacji różnic między grupami, a nie kryterium istotności.
Uważaj na sufit i podłogę. Burr i in. (2019) opisali efekty sufitu powyżej 15% m.in. dla wsparcia od przełożonego (25%) i poczucia wspólnoty w pracy (30%), a efekty podłogi dla niepewności zatrudnienia (19%). Przy takich skalach średnia i test t bywają mylące. Więcej w haśle efekt sufitu i podłogi.
Licencja i polska wersja
Według oficjalnej strony sieci COPSOQ kwestionariusz jest bezpłatny na licencji Creative Commons CC BY-NC-ND 4.0 (COPSOQ International Network, b.d.; stan na 1 listopada 2026 r.). Warunki: trzeba właściwie wskazać narzędzie i nie sugerować, że sieć popiera Twoje badanie. Zmienionej wersji nie wolno rozpowszechniać pod nazwą „COPSOQ”. Nie wolno pobierać opłat za sam kwestionariusz, ale można za analizy, doradztwo i szkolenia. Gdy narzędzie jest używane w zakładzie pracy, badanie ma być częścią procesu zgodnego z wytycznymi sieci. Przed tłumaczeniem lub adaptacją trzeba sprawdzić, czy w kraju działa członek sieci albo istnieje zwalidowana wersja, i skontaktować się z tą osobą. Przeczytaj je przy pobieraniu formularza. Ogólnie o licencjach pisze hasło licencja narzędzia badawczego.
Polską wersję COPSOQ II zbadali m.in. Baka, Prusik, Pejtersen i Grala (2022) w rocznym badaniu 599 pracowników usług społecznych. Analiza CFA potwierdziła oryginalną strukturę. Tu nie podajemy polskich norm ani wyników tej pracy. Pamiętaj, że COPSOQ II i COPSOQ III to różne wersje. W opisie narzędzia podaj, której używasz. O tłumaczeniu narzędzi pisze wpis adaptacja kulturowa kwestionariusza.
Przykład: 240 osób w 12 zespołach
Dane są symulowane i możesz je pobrać jako plik CSV. Mamy 240 pracowników z 12 zespołów (np. oddziałów szpitala) i cztery skale: wymagania ilościowe, wpływ w pracy, wsparcie od przełożonego i wypalenie. Kolumny są już przeliczone na punkty 0–100 w kierunku nazwy skali. Liczba kolumn na skalę to założenie symulacji, a nie przydział pozycji z formularza. Dwie osoby wypełniły mniej niż połowę pozycji jednej skali, więc do analizy weszło 238 osób.
| Skala | M (SD) | Me | Wynik 0 | Wynik 100 | α [95% CI] | ω | ICC(1) |
|---|---|---|---|---|---|---|---|
| Wymagania ilościowe | 53.7 (20.7) | 50.0 | 0.4% | 3.4% | .75 [.69, .80] | .75 | .063 |
| Wpływ w pracy | 48.9 (21.4) | 50.0 | 1.3% | 0.0% | .78 [.74, .83] | .79 | .042 |
| Wsparcie od przełożonego | 76.6 (23.3) | 83.3 | 0.0% | 29.0% | .83 [.79, .87] | .84 | .108 |
| Wypalenie | 43.8 (21.5) | 43.8 | 1.7% | 0.4% | .83 [.79, .86] | .83 | .056 |
Rozkłady i efekt sufitu
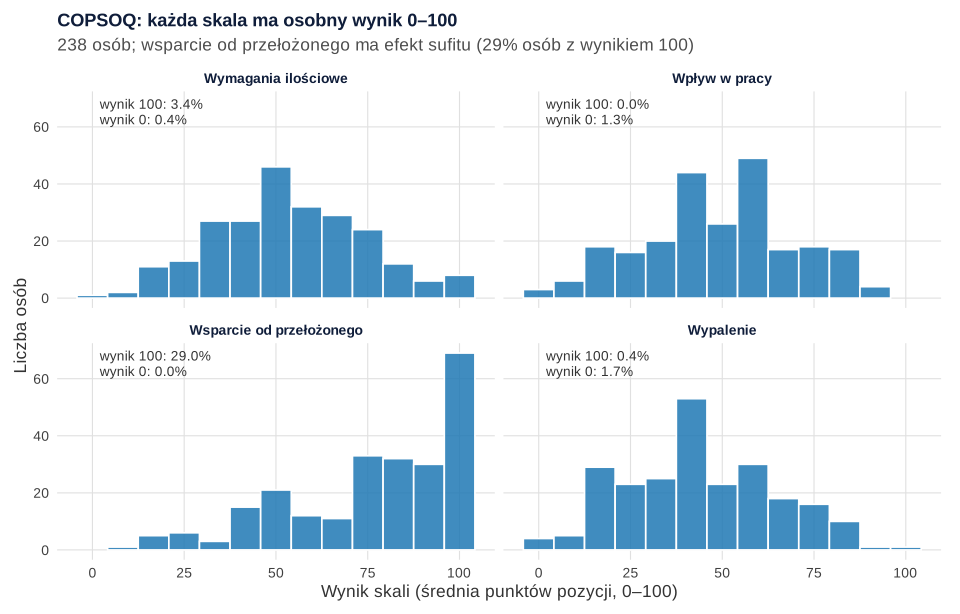
Wsparcie od przełożonego ma wyraźny efekt sufitu: 29.0% osób uzyskało 100 punktów, a mediana (83.3) jest wyższa od średniej (76.6). Berthelsen i in. (2020), za Terwee i in. (2007), uznają za efekt sufitu sytuację, gdy ponad 15% osób wybiera najwyższe odpowiedzi. Tę skalę lepiej opisać medianą i odsetkiem wyników maksymalnych. W porównaniach grup rozważ regresję porządkową albo test nieparametryczny. Pozostałe skale nie skupiają się na krańcach (rysunek 1).
Rzetelność
Alfę i omegę liczymy osobno dla każdej skali. Wszystkie cztery skale przekroczyły .70 (tabela). Alfa zakłada równe ładunki pozycji, dlatego obok niej podajemy omegę McDonalda. Dla wymiarów jednopozycyjnych rzetelności spójności wewnętrznej się nie liczy.
Czy skale różnicują zespoły?
COPSOQ często służy do oceny warunków w działach, a nie tylko u pojedynczych osób. Wtedy trzeba sprawdzić, czy uśrednianie wyników w zespołach ma sens. Służą do tego dwa wskaźniki z modelu pustego. ICC(1) to część wariancji wyjaśniana przynależnością do zespołu. ICC(2) to rzetelność średniej zespołu. Berthelsen i in. (2020) przyjmują tradycyjne kryterium ICC(1) ≥ .05 oraz ICC(2) < .50 jako słabą, .50–.75 jako umiarkowaną, a powyżej .75 jako dobrą rzetelność średnich.
W przykładzie (średnio 19.8 osoby na zespół) wymagania ilościowe miały ICC(1) = .063 i ICC(2) = .57, a wsparcie od przełożonego ICC(1) = .108 i ICC(2) = .71. Wpływ w pracy (ICC(1) = .042, ICC(2) = .47) różnicował zespoły słabiej. Średnie zespołów w wymaganiach ilościowych wahały się od 38.3 do 60.7 punktu, a przedziały ufności mocno na siebie zachodzą (rysunek 2). Przy 20 osobach w zespole średnia ma szeroki przedział, więc nie ustawiaj rankingu działów na podstawie samych średnich. Agregację opisuje hasło agregacja danych, a rzetelność na dwóch poziomach – rzetelność wielopoziomowa.
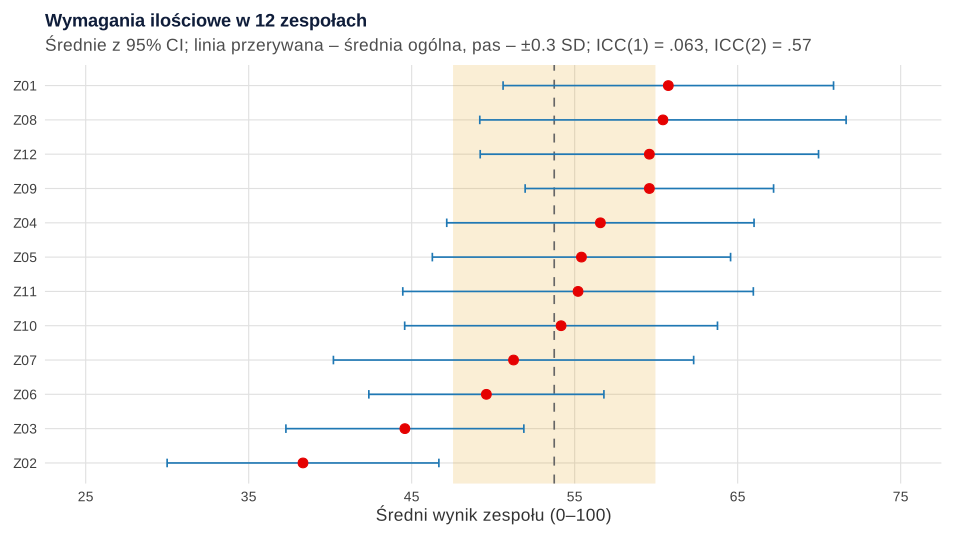
Odchylenie standardowe wymagań ilościowych wyniosło 20.7 punktu, więc 0.3 SD według zaleceń Pejtersena i in. (2010) to około 6.2 punktu. Rozstęp średnich zespołów (22.4 punktu) jest większy, ale tylko kilka zespołów wyraźnie odstaje od średniej.
Wypalenie a warunki pracy
Pracownicy są zagnieżdżeni w zespołach, więc użyliśmy modelu wielopoziomowego z losowym wyrazem wolnym dla zespołu. Predyktory wycentrowaliśmy i podzieliliśmy przez 10, więc współczynnik oznacza zmianę wypalenia na każde 10 punktów skali. Wzrost wymagań ilościowych o 10 punktów wiązał się z wyższym wypaleniem o 3.75 punktu, 95% CI [2.52, 4.99]. Wsparcie od przełożonego wiązało się z niższym wypaleniem, b = −1.44 [−2.54, −0.33]. Wpływ w pracy nie miał wyraźnego związku, b = −0.30 [−1.49, 0.88]. Model z trzema predyktorami pasował lepiej niż model pusty, χ²(3) = 36.19, p < .001. Dane są przekrojowe, a wzór związków wpisaliśmy w symulację.
Jak opisać COPSOQ w pracy
Wzory zawierają liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a inne narzędzia z instrukcją liczenia – w katalogu narzędzi badawczych.
COPSOQ w R: skale 0–100, sufit, rzetelność, ICC i model wielopoziomowy
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Wynik skali to średnia punktów 0–100 przy wypełnieniu co najmniej połowy pozycji. Alfę z przedziałem Feldta liczy pakiet psych, omegę – lavaan, a ICC i model wielopoziomowy – lme4.
Wynik COPSOQ krok po kroku
R
# B303 – COPSOQ: wyniki skal 0–100, reguła połowy pozycji, efekt sufitu i podłogi, rzetelność,
# ICC(1) i ICC(2) dla zespołów oraz model wielopoziomowy (dane symulowane, set.seed(3031)).
# Treści pozycji nie podajemy. Kolumny są JUŻ przeliczone na punkty 0, 25, 50, 75, 100 i ustawione
# w kierunku nazwy skali według dokumentacji używanej wersji COPSOQ. Liczba kolumn na skalę
# to założenie symulacji, a nie przydział pozycji z formularza.
# 240 pracowników w 12 zespołach; cztery skale: wymagania ilościowe (wi), wpływ w pracy (wp),
# wsparcie od przełożonego (wsp) i wypalenie (wyp).
suppressPackageStartupMessages({ library(psych); library(lavaan); library(lme4) })
set.seed(3031)
n_z <- 12; n_os <- 20; n <- n_z * n_os
zespol <- rep(sprintf("Z%02d", 1:n_z), each = n_os)
u <- function(sd) rep(rnorm(n_z, 0, sd), each = n_os)          # efekt zespołu
F_wi  <- u(0.45) + rnorm(n)
F_wp  <- u(0.30) + rnorm(n)
F_wsp <- u(0.35) + rnorm(n)
F_wyp <- 0.35 * F_wi - 0.15 * F_wp - 0.20 * F_wsp + u(0.10) + rnorm(n, 0, 0.85)
pozycje <- function(F, lam, progi, nazwa) {
  m <- sapply(lam, function(l) 25 * findInterval(l * scale(F)[, 1] + rnorm(n, 0, sqrt(1 - l^2)), progi))
  colnames(m) <- paste0(nazwa, seq_along(lam)); m
}
dane <- data.frame(id = 1:n, zespol,
  pozycje(F_wi,  c(.78, .74, .70),      c(-1.6, -0.6, 0.4, 1.3), "wi"),
  pozycje(F_wp,  c(.72, .76, .70, .66), c(-1.3, -0.4, 0.5, 1.4), "wp"),
  pozycje(F_wsp, c(.86, .84, .80),      c(-2.0, -1.3, -0.6, 0.1), "wsp"),
  pozycje(F_wyp, c(.80, .78, .74, .72), c(-1.1, -0.2, 0.7, 1.6), "wyp"))
dane$wi2[c(14, 77, 150)] <- NA; dane$wi3[c(77, 201)] <- NA
dane$wp4[c(33, 120)] <- NA; dane$wsp1[c(9, 188)] <- NA; dane$wsp2[c(9, 61)] <- NA; dane$wsp3[9] <- NA
dane$wyp1[c(45, 230)] <- NA
write.csv(dane, "../copsoq-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania
skale <- list(wi = paste0("wi", 1:3), wp = paste0("wp", 1:4), wsp = paste0("wsp", 1:3), wyp = paste0("wyp", 1:4))

# Krok 1. Kontrola kodowania: dozwolone tylko 0, 25, 50, 75, 100 albo brak
all(as.matrix(dane[, unlist(skale)]) %in% c(0, 25, 50, 75, 100, NA))

# Krok 2. Wynik skali = średnia pozycji, gdy odpowiedziano na co najmniej połowę pozycji skali
wynik_0_100 <- function(x) ifelse(rowSums(!is.na(x)) >= ncol(x) / 2, rowMeans(x, na.rm = TRUE), NA)
for (s in names(skale)) dane[[s]] <- wynik_0_100(dane[, skale[[s]]])
colSums(is.na(dane[, names(skale)]))
d <- dane[complete.cases(dane[, names(skale)]), ]
nrow(d)

# Krok 3. Opis skal: M, SD, mediana oraz odsetek osób z wynikiem 0 (podłoga) i 100 (sufit)
opis <- t(sapply(names(skale), function(s) { x <- d[[s]]
  round(c(M = mean(x), SD = sd(x), Me = median(x), proc_0 = 100 * mean(x == 0), proc_100 = 100 * mean(x == 100)), 1) }))
opis

# Krok 4. Rzetelność osobno dla każdej skali: alfa z 95% CI Feldta i omega z modelu jednoczynnikowego
rzet <- function(v) {
  a <- suppressMessages(psych::alpha(d[, v], warnings = FALSE))
  f <- cfa(paste("F =~", paste(v, collapse = " + ")), data = d, std.lv = TRUE, missing = "fiml")
  st <- standardizedSolution(f); lam <- st$est.std[st$op == "=~"]
  th <- st$est.std[st$op == "~~" & st$lhs %in% v & st$lhs == st$rhs]
  round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]],
          omega = sum(lam)^2 / (sum(lam)^2 + sum(th))), 2)
}
t(sapply(skale, rzet))

# Krok 5. Czy skala różnicuje zespoły? ICC(1) z modelu pustego i ICC(2) – rzetelność średniej zespołu
k <- mean(table(d$zespol))
icc <- t(sapply(names(skale), function(s) {
  m0 <- lmer(as.formula(paste(s, "~ 1 + (1 | zespol)")), data = d, REML = TRUE)
  vc <- as.data.frame(VarCorr(m0)); icc1 <- vc$vcov[1] / sum(vc$vcov)
  round(c(ICC1 = icc1, ICC2 = k * icc1 / (1 + (k - 1) * icc1)), 3) }))
round(k, 1); icc

# Krok 6. Średnie zespołów dla wymagań ilościowych (95% CI z rozkładu t) i 0.3 SD jako różnica minimalnie ważna
zesp <- do.call(rbind, lapply(split(d$wi, d$zespol), function(x)
  c(n = length(x), M = mean(x), lo = mean(x) - qt(.975, length(x) - 1) * sd(x) / sqrt(length(x)),
    hi = mean(x) + qt(.975, length(x) - 1) * sd(x) / sqrt(length(x)))))
round(zesp[order(zesp[, "M"]), ], 1)
round(c(M_ogolem = mean(d$wi), SD = sd(d$wi), MID_0.3SD = 0.3 * sd(d$wi),
        rozstep_zespolow = diff(range(zesp[, "M"]))), 1)

# Krok 7. Wypalenie a warunki pracy: model z losowym wyrazem wolnym dla zespołu, predyktory na 10 punktów
d$wi10 <- (d$wi - mean(d$wi)) / 10; d$wp10 <- (d$wp - mean(d$wp)) / 10; d$wsp10 <- (d$wsp - mean(d$wsp)) / 10
m1 <- lmer(wyp ~ wi10 + wp10 + wsp10 + (1 | zespol), data = d, REML = FALSE)
m0 <- lmer(wyp ~ 1 + (1 | zespol), data = d, REML = FALSE)
wsp <- cbind(b = fixef(m1), confint(m1, method = "Wald")[-(1:2), ])
round(wsp, 2)
lr <- anova(m0, m1); round(c(chi2 = lr$Chisq[2], df = lr$Df[2]), 2); format.pval(lr$`Pr(>Chisq)`[2], digits = 3)
Wynik w R
[1] TRUE
 wi  wp wsp wyp
  1   0   1   0
[1] 238
       M   SD   Me proc_0 proc_100
wi  53.7 20.7 50.0    0.4      3.4
wp  48.9 21.4 50.0    1.3      0.0
wsp 76.6 23.3 83.3    0.0     29.0
wyp 43.8 21.5 43.8    1.7      0.4
    alfa   lo   hi omega
wi  0.75 0.69 0.80  0.75
wp  0.78 0.74 0.83  0.79
wsp 0.83 0.79 0.87  0.84
wyp 0.83 0.79 0.86  0.83
[1] 19.8
     ICC1  ICC2
wi  0.063 0.570
wp  0.042 0.467
wsp 0.108 0.705
wyp 0.056 0.542
     n    M   lo   hi
Z02 20 38.3 30.0 46.7
Z03 20 44.6 37.3 51.9
Z06 20 49.6 42.4 56.8
Z07 20 51.2 40.2 62.3
Z10 20 54.2 44.6 63.8
Z11 20 55.2 44.5 66.0
Z05 20 55.4 46.3 64.6
Z04 19 56.6 47.2 66.0
Z09 20 59.6 52.0 67.2
Z12 20 59.6 49.2 70.0
Z08 20 60.4 49.2 71.7
Z01 19 60.7 50.6 70.9
        M_ogolem               SD        MID_0.3SD rozstep_zespolow
            53.7             20.7              6.2             22.4
                b 2.5 % 97.5 %
(Intercept) 43.79 40.48  47.10
wi10         3.75  2.52   4.99
wp10        -0.30 -1.49   0.88
wsp10       -1.44 -2.54  -0.33
 chi2    df
36.19  3.00
[1] "6.82e-08"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy COPSOQ
- Suma wszystkich skal. Wymiary mają różny kierunek i treść. Analizuj każdą skalę osobno.
- Kodowanie 1–5 zamiast 0–100. Wyniki nie dają się wtedy porównać z publikacjami i wartościami odniesienia.
- Kierunek „z formularza”, a nie z nazwy skali. Wysoki wynik ma znaczyć więcej tego, co mówi nazwa skali. Sprawdź kolejność odpowiedzi w dokumentacji swojej wersji.
- Własne progi „złych warunków”. COPSOQ nie ma progów diagnostycznych. Porównuj z wartościami odniesienia ze źródła i podaj je z cytowaniem.
- Usunięte pozycje rdzeniowe. Skrócenie skali poniżej rdzenia narusza zasady COPSOQ III i utrudnia porównania.
- Ranking zespołów bez ICC. Przy małych zespołach różnice średnich mogą być przypadkowe. Najpierw sprawdź ICC(1) i ICC(2).
- Zwykła regresja przy danych z zespołów. Pomija zależność obserwacji i zaniża błędy standardowe. Użyj modelu wielopoziomowego.
Całą ścieżkę od kodowania po rzetelność porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie COPSOQ w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik skali COPSOQ?
Każdej z pięciu odpowiedzi przypisz 0, 25, 50, 75 lub 100 punktów, tak by wyższa liczba oznaczała więcej tego, co mówi nazwa skali. Wynik skali to średnia punktów jej pozycji, liczona, gdy osoba odpowiedziała na co najmniej połowę pozycji (Berthelsen i in., 2020; Lincke i in., 2021). Które odpowiedzi dają 0, a które 100, sprawdź w dokumentacji swojej wersji.
Czy COPSOQ ma wynik ogólny albo punkt odcięcia?
Nie. Wymiary mają różny kierunek, więc ich suma nie ma sensu. Lincke i in. (2021) piszą, że wytyczne COPSOQ nie przyjmują żadnych wartości odcięcia jako „prawdziwych”. Wyniki porównuje się z krajowymi wartościami odniesienia, podając ich źródło.
Czy COPSOQ jest darmowy do pracy magisterskiej?
Tak. Według strony sieci COPSOQ kwestionariusz jest bezpłatny na licencji CC BY-NC-ND 4.0 (stan na 1 listopada 2026 r.). Trzeba wskazać źródło, nie wolno rozpowszechniać zmienionej wersji pod nazwą COPSOQ ani pobierać opłat za sam kwestionariusz. Przed tłumaczeniem skontaktuj się z członkiem sieci w swoim kraju.
Czy mogę wybrać tylko kilka skal COPSOQ?
Tak, COPSOQ III zakłada wersje różnej długości. Każda wersja musi jednak zawierać obowiązkowe pozycje rdzeniowe (Burr i in., 2019). Wybierz wymiary zgodne z pytaniami badawczymi, nie skracaj ich poniżej rdzenia i podaj w pracy, które skale weszły do ankiety.
Jak analizować COPSOQ, gdy badani pracują w różnych zespołach?
Najpierw policz ICC(1) i ICC(2) z modelu pustego, żeby sprawdzić, czy zespoły się różnią i czy ich średnie są rzetelne. Związki z wypaleniem czy satysfakcją badaj w modelu wielopoziomowym z losowym wyrazem wolnym dla zespołu. Zwykła regresja zaniża błędy standardowe.
Powiązane hasła
Przeczytaj też
CBI – jak policzyć wynik wypalenia
Trzy skale wypalenia, przeliczenie odpowiedzi na 0–100, pozycja odwrócona, braki, licencja i rzetelność – z przykładem w R na danych pielęgniarek i wzorem opisu.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikUWES-9 – jak policzyć wynik zaangażowania
Wigor, oddanie i pochłonięcie jako średnie 0–6, wynik ogólny, warunki użycia i struktura czynnikowa – z przykładem w R na danych pielęgniarek i wzorem opisu.
Czytaj →Badasz warunki pracy kwestionariuszem COPSOQ i nie wiesz, jak policzyć skale?
Sprawdzimy przeliczenie odpowiedzi na 0–100, braki, rzetelność skal i dobór analiz dla danych z zespołów, a potem wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baka, Ł., Prusik, M., Pejtersen, J. H., & Grala, K. (2022). Full evaluation of the psychometric properties of COPSOQ II. One-year longitudinal study on Polish human service staff. PLOS ONE, 17(1), Article e0262266. https://doi.org/10.1371/journal.pone.0262266 ● Otwarty dostęp
- Berthelsen, H., Westerlund, H., Bergström, G., & Burr, H. (2020). Validation of the Copenhagen Psychosocial Questionnaire version III and establishment of benchmarks for psychosocial risk management in Sweden. International Journal of Environmental Research and Public Health, 17(9), Article 3179. https://doi.org/10.3390/ijerph17093179 ● Otwarty dostęp
- Burr, H., Berthelsen, H., Moncada, S., Nübling, M., Dupret, E., Demiral, Y., Oudyk, J., Kristensen, T. S., Llorens, C., Navarro, A., Lincke, H.-J., Bocéréan, C., Sahan, C., Smith, P., & Pohrt, A. (2019). The third version of the Copenhagen Psychosocial Questionnaire. Safety and Health at Work, 10(4), 482–503. https://doi.org/10.1016/j.shaw.2019.10.002 ● Otwarty dostęp
- COPSOQ International Network. (b.d.). Licence, guidelines & questionnaire. Pobrano 1 listopada 2026 z https://www.copsoq-network.org/licence-guidelines-and-questionnaire ● Otwarty dostęp
- Kristensen, T. S., Hannerz, H., Høgh, A., & Borg, V. (2005). The Copenhagen Psychosocial Questionnaire—A tool for the assessment and improvement of the psychosocial work environment. Scandinavian Journal of Work, Environment & Health, 31(6), 438–449. https://doi.org/10.5271/sjweh.948 ● Otwarty dostęp
- Lincke, H.-J., Vomstein, M., Lindner, A., Nolle, I., Häberle, N., Haug, A., & Nübling, M. (2021). COPSOQ III in Germany: Validation of a standard instrument to measure psychosocial factors at work. Journal of Occupational Medicine and Toxicology, 16(1), Article 50. https://doi.org/10.1186/s12995-021-00331-1 ● Otwarty dostęp
- Pejtersen, J. H., Bjorner, J. B., & Hasle, P. (2010). Determining minimally important score differences in scales of the Copenhagen Psychosocial Questionnaire. Scandinavian Journal of Public Health, 38(3_suppl), 33–41. https://doi.org/10.1177/1403494809347024
- Terwee, C. B., Bot, S. D. M., de Boer, M. R., van der Windt, D. A. W. M., Knol, D. L., Dekker, J., Bouter, L. M., & de Vet, H. C. W. (2007). Quality criteria were proposed for measurement properties of health status questionnaires. Journal of Clinical Epidemiology, 60(1), 34–42. https://doi.org/10.1016/j.jclinepi.2006.03.012 ● Otwarty dostęp
Cytowania BibTeX
@article{baka2022full, author={Baka, Łukasz and Prusik, Monika and Pejtersen, Jan Hyld and Grala, Krzysztof}, title={{Full evaluation of the psychometric properties of COPSOQ II. One-year longitudinal study on Polish human service staff}}, journal={PLOS ONE}, year={2022}, volume={17}, number={1}, eid={e0262266}, doi={10.1371/journal.pone.0262266}}@article{berthelsen2020validation, author={Berthelsen, Hanne and Westerlund, Hugo and Bergström, Gunnar and Burr, Hermann}, title={{Validation of the Copenhagen Psychosocial Questionnaire version III and establishment of benchmarks for psychosocial risk management in Sweden}}, journal={International Journal of Environmental Research and Public Health}, year={2020}, volume={17}, number={9}, eid={3179}, doi={10.3390/ijerph17093179}}@article{burr2019third, author={Burr, Hermann and Berthelsen, Hanne and Moncada, Salvador and Nübling, Matthias and Dupret, Emilie and Demiral, Yucel and Oudyk, John and Kristensen, Tage S. and Llorens, Clara and Navarro, Albert and Lincke, Hans-Joachim and Bocéréan, Christine and Sahan, Ceyda and Smith, Peter and Pohrt, Anne}, title={{The third version of the Copenhagen Psychosocial Questionnaire}}, journal={Safety and Health at Work}, year={2019}, volume={10}, number={4}, pages={482--503}, doi={10.1016/j.shaw.2019.10.002}}@misc{copsoqnetworknd, author={{COPSOQ International Network}}, title={{Licence, guidelines \& questionnaire}}, howpublished={COPSOQ International Network}, url={https://www.copsoq-network.org/licence-guidelines-and-questionnaire}}@article{kristensen2005copsoq, author={Kristensen, Tage S. and Hannerz, Harald and Høgh, Annie and Borg, Vilhelm}, title={{The Copenhagen Psychosocial Questionnaire—A tool for the assessment and improvement of the psychosocial work environment}}, journal={Scandinavian Journal of Work, Environment \& Health}, year={2005}, volume={31}, number={6}, pages={438--449}, doi={10.5271/sjweh.948}}@article{lincke2021copsoq, author={Lincke, Hans-Joachim and Vomstein, Martin and Lindner, Alexandra and Nolle, Inga and Häberle, Nicola and Haug, Ariane and Nübling, Matthias}, title={{COPSOQ III in Germany: Validation of a standard instrument to measure psychosocial factors at work}}, journal={Journal of Occupational Medicine and Toxicology}, year={2021}, volume={16}, number={1}, eid={50}, doi={10.1186/s12995-021-00331-1}}@article{pejtersen2010determining, author={Pejtersen, Jan Hyld and Bjorner, Jakob Bue and Hasle, Peter}, title={{Determining minimally important score differences in scales of the Copenhagen Psychosocial Questionnaire}}, journal={Scandinavian Journal of Public Health}, year={2010}, volume={38}, number={3_suppl}, pages={33--41}, doi={10.1177/1403494809347024}}@article{terwee2007quality, author={Terwee, Caroline B. and Bot, Sandra D. M. and de Boer, Michael R. and van der Windt, Daniëlle A. W. M. and Knol, Dirk L. and Dekker, Joost and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{Quality criteria were proposed for measurement properties of health status questionnaires}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={1}, pages={34--42}, doi={10.1016/j.jclinepi.2006.03.012}}