Czym jest CBI
CBI (Copenhagen Burnout Inventory), czyli Kopenhaski Kwestionariusz Wypalenia, to narzędzie samoopisowe do pomiaru wypalenia. Opracowali je Kristensen i in. (2005) w Narodowym Centrum Badań Środowiska Pracy w Kopenhadze (NFA) jako alternatywę dla Maslach Burnout Inventory. Autorzy krytykowali MBI w kilku punktach i oparli nowe narzędzie na jednym rdzeniu: zmęczeniu i wyczerpaniu. Wyczerpanie mierzą w trzech obszarach życia, więc CBI składa się z trzech skal: wypalenia osobistego, zawodowego i związanego z klientem.
Narzędzie powstało w badaniu PUMA, które objęło pracowników usług społecznych: szpitali, opieki domowej, urzędów i więziennictwa (Borritz i in., 2006). Dlatego CBI pojawia się często w pracach z pielęgniarstwa, położnictwa i ratownictwa, ale także w badaniach nauczycieli i pracowników biurowych. Większość badań nad wypaleniem dotyczy zresztą zawodów pomocowych, zwłaszcza ochrony zdrowia (Maslach i Leiter, 2016).
Wpis pokazuje, jak przeliczyć odpowiedzi na skalę 0–100, jak obsłużyć pozycję odwróconą i braki, co wolno powiedzieć o wyniku i jak opisać CBI w pracy. Treści pozycji nie przytaczamy.
Budowa: 19 pozycji i trzy skale
Pełna wersja CBI ma 19 pozycji. W badaniach walidacyjnych opisano ją jako trzy części: 6 pozycji wypalenia osobistego, 7 pozycji wypalenia zawodowego i 6 pozycji wypalenia związanego z klientem (Montgomery i in., 2021; Sestili i in., 2018). Każda skala jest osobną podskalą z własnym wynikiem.
| Skala | Pozycje | Czego dotyczy (opis własny) | Kto odpowiada |
|---|---|---|---|
| Wypalenie osobiste (personal burnout) | 6 | zmęczenie i wyczerpanie fizyczne oraz psychiczne, bez odniesienia do pracy | każdy, także osoby niepracujące |
| Wypalenie zawodowe (work-related burnout) | 7 | wyczerpanie, które osoba przypisuje swojej pracy | osoby pracujące |
| Wypalenie związane z klientem (client-related burnout) | 6 | wyczerpanie przypisywane pracy z klientami, pacjentami, uczniami | osoby pracujące z ludźmi |
Słowo „klient” zastępuje się w praktyce nazwą grupy, z którą pracują badani: pacjenci, studenci, dzieci. Tak zrobili np. Sestili i in. (2018) w badaniu nauczycieli akademickich i Piperac i in. (2021) w badaniu nauczycielek przedszkoli. Taką zmianę opisz w pracy, bo to modyfikacja narzędzia.
Odpowiedzi mają pięć kategorii. Większość pozycji pyta o częstość (od „zawsze” do „nigdy lub prawie nigdy”), a część o stopień (od „w bardzo dużym stopniu” do „w bardzo małym stopniu”) (Sestili i in., 2018). Obie wersje kategorii przelicza się tak samo.
Licencja i wersje językowe
CBI jest swobodnie dostępny. Według strony NFA kwestionariusza można używać bezpłatnie do celów niekomercyjnych i komercyjnych, pod warunkiem że wyraźnie wskażesz źródło. Strona prosi o cytowanie pracy Borritz i in. (2006). Na tej samej stronie są do pobrania skale z badania PUMA i dokument z danymi normatywnymi z Danii (Det Nationale Forskningscenter for Arbejdsmiljø, b.d.). Montgomery i in. (2021) podkreślają ten brak kosztów licencji jako zaletę CBI w badaniach pielęgniarek. W pracy zacytuj więc zarówno Kristensena i in. (2005), jak i Borritz i in. (2006).
Kristensen i in. (2005) podawali, że CBI ma przekłady na osiem języków, a dziś jest ich więcej. W polskich badaniach używa się przekładów CBI. Jeśli korzystasz z polskiej wersji, zacytuj jej źródło i sprawdź, jak powstała. Polskich norm ani właściwości polskich wersji ten wpis nie omawia. Ogólne zasady doboru narzędzi opisuje wpis gdzie znaleźć kwestionariusze psychologiczne.
Jak policzyć wynik krok po kroku
Krok 1. Zapisz odpowiedzi jednolicie
Najprościej zapisać numer zaznaczonej odpowiedzi: 1 to pierwsza kategoria („zawsze” albo „w bardzo dużym stopniu”), a 5 to ostatnia. Tak zapisane dane zwykle przychodzą z formularza online. Sprawdź, czy każda kolumna ma tylko wartości 1–5 albo brak, i zapisz kodowanie w książce kodowej. Przygotowanie danych omawia wpis jak przygotować bazę danych do analizy.
Krok 2. Przelicz odpowiedzi na punkty 0–100
Według instrukcji autorów, na którą powołują się badania walidacyjne, kolejne kategorie dostają 100, 75, 50, 25 i 0 punktów (Piperac i in., 2021; Sestili i in., 2018). Pierwsza kategoria, czyli najczęstsze lub najsilniejsze odczucie, to 100. Ostatnia to 0. Przy kodowaniu 1–5 wzór ma postać:
Krok 3. Odwróć jedną pozycję skali zawodowej
W skali wypalenia zawodowego jest jedna pozycja odwrócona. Dotyczy tego, czy po pracy zostaje energia na rodzinę i przyjaciół. Częsta odpowiedź oznacza tu mniej wypalenia, więc punkty odwracasz: 100 − punkty (Sestili i in., 2018). Numer tej pozycji zależy od wersji formularza, dlatego sprawdź go w dokumencie skal na stronie NFA. W przykładzie to kolumna z7. Na danych z przykładu pominięcie odwrócenia obniżyło alfę skali zawodowej z .89 do .70. Taki spadek to dobry sygnał kontrolny.
Krok 4. Policz średnią każdej skali i ustal regułę braków
Wynik skali to średnia punktów jej pozycji, więc mieści się w zakresie 0–100 (Piperac i in., 2021). Wyższy wynik oznacza silniejsze wypalenie. Nie sumuj punktów. Średnia pozwala porównywać skale o 6 i 7 pozycjach i zostaje na skali 0–100 nawet przy brakach (zob. wynik skali: średnia czy suma).
W cytowanych źródłach nie znaleźliśmy oficjalnej reguły dla braków. Sprawdź ją w dokumentach NFA, a jeśli jej tam nie ma, ustal regułę przed analizą i opisz ją. W przykładzie średnią liczymy, gdy osoba odpowiedziała na co najmniej połowę pozycji skali. To nasza decyzja, nie zalecenie autorów (zob. braki danych).
Krok 5. Zdecyduj, czy potrzebujesz wyniku łącznego
Kristensen i in. (2005) opisują trzy skale do różnych obszarów, a nie jeden wynik ogólny. Część badań liczy także średnią trzech skal (Piperac i in., 2021). Jeśli to robisz, uzasadnij decyzję i podaj źródło. W większości prac dyplomowych lepiej analizować skale osobno, bo każda odpowiada na inne pytanie. Skali związanej z klientem nie dawaj osobom, które nie pracują z ludźmi.
Interpretacja: wyższy wynik, ale bez oficjalnego progu
Wynik CBI to stopień wyczerpania w danym obszarze na skali 0–100. Opisuj go jako wynik ciągły: średnią, odchylenie standardowe, medianę. W cytowanych źródłach nie ma oficjalnego punktu odcięcia, który dzieliłby badanych na wypalonych i niewypalonych. Jeśli w literaturze spotkasz takie kategorie, sprawdź, skąd pochodzą, i podawaj je tylko z cytowaniem. Dzielenie wyniku na grupy traci informację i moc analizy, a wybór granicy bywa arbitralny (zob. niski, przeciętny, wysoki wynik).
Wysoki wynik CBI nie jest też diagnozą. Pokazuje, że osoba zgłasza silne zmęczenie i wyczerpanie. Do porównań możesz użyć wyników z badań opublikowanych w podobnych grupach zawodowych. W badaniu PUMA położne i opiekunki domowe miały wysokie wyniki wypalenia zawodowego i związanego z klientem, a pracownicy biurowi niskie (Borritz i in., 2006).
Przykład: 280 pielęgniarek i pielęgniarzy
W badaniu symulowanym 280 pielęgniarek i pielęgniarzy z oddziałów szpitalnych wypełniło CBI. Część z nich pracowała w systemie dyżurów 12-godzinnych. Dane są w pliku CSV. Pojedyncze braki nie wykluczały nikogo, ale 2 osoby pominęły cztery z siedmiu pozycji skali zawodowej, a 3 pominęły całą skalę pacjentów. Wynik wypalenia osobistego ma więc 280 osób, zawodowego 278, a związanego z pacjentem 277.
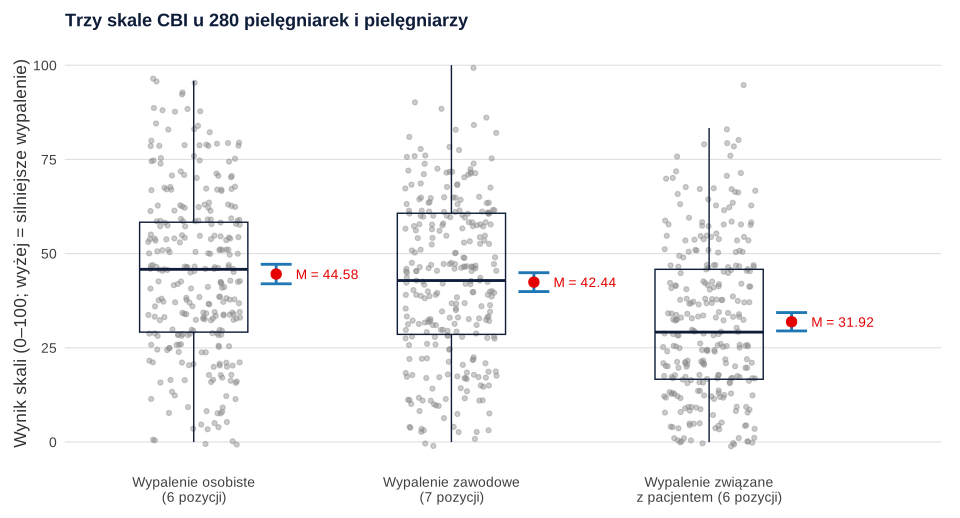
Średnie wyniosły: wypalenie osobiste M = 44.58 (SD = 22.00), zawodowe M = 42.44 (SD = 21.20), związane z pacjentem M = 31.92 (SD = 20.58; Me = 29.17). Ostatnia skala ma lekką skośność prawostronną (0.43), co widać na rysunku 1. Skale łączą się ze sobą, ale nie są tym samym. Wypalenie osobiste korelowało z zawodowym r = .72, 95% CI [.65, .77], a z wypaleniem związanym z pacjentem tylko r = .30, 95% CI [.18, .40]. Skale zawodowa i pacjentów korelowały r = .45, 95% CI [.35, .54] (zob. korelacja Pearsona).
Dyżury 12-godzinne a wypalenie zawodowe
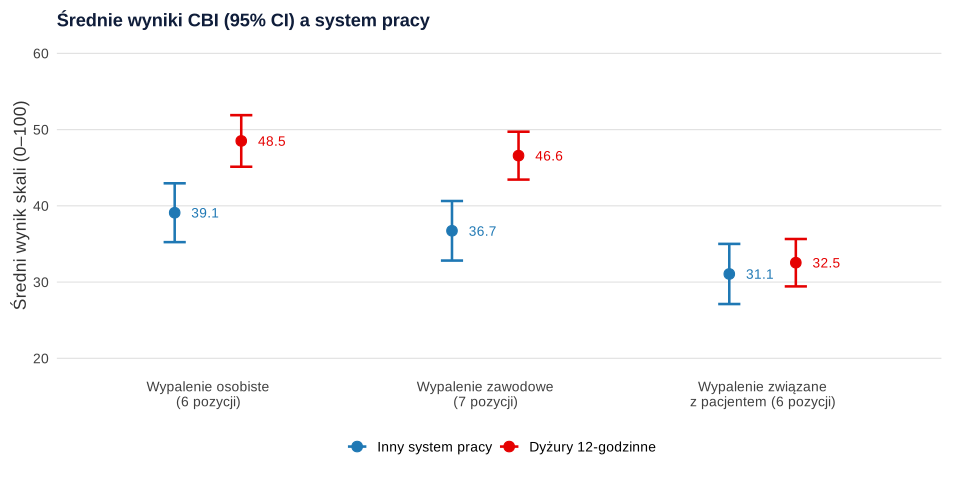
Osoby na dyżurach 12-godzinnych (n = 161) miały wyższy wynik wypalenia zawodowego niż pozostałe (n = 117): M = 46.58 (SD = 20.18) wobec 36.73 (SD = 21.33). Test t Welcha dał t(241.84) = 3.89, p < .001. Różnica wyniosła 9.86 punktu, 95% CI [4.87, 14.85], a d Cohena = 0.48, 95% CI [0.24, 0.72]. Rysunek 2 pokazuje, że podobna różnica dotyczy wypalenia osobistego, a w skali pacjentów grupy prawie się nie różnią. Badanie jest przekrojowe, więc nie wiemy, czy dyżury zwiększają wypalenie (zob. schemat przekrojowy). Mogą to tłumaczyć np. różnice między oddziałami.
Rzetelność: licz ją osobno dla każdej skali
Kristensen i in. (2005) opisali bardzo wysoką spójność wewnętrzną wszystkich trzech skal i mały odsetek braków. U 928 pielęgniarek i pielęgniarzy alfa Cronbacha wyniosła .91 dla wypalenia osobistego, .89 dla zawodowego i .92 dla związanego z klientem (Montgomery i in., 2021). W próbie serbskich nauczycielek przedszkoli skala zawodowa miała niższą alfę, .765 (Piperac i in., 2021). Dlatego nie przepisuj rzetelności z literatury, tylko policz ją we własnych danych.
W przykładzie, na 273 pełnych rekordach, alfa i omega McDonalda wyniosły .89 dla skali osobistej, .89 dla zawodowej i .88 dla skali pacjentów. Korelacje pozycji z resztą skali mieściły się w przedziale .64–.75. Licz rzetelność na punktach po odwróceniu pozycji, osobno dla każdej skali, a nie dla wszystkich 19 pozycji razem. Dlaczego warto podać omegę obok alfy, wyjaśnia McNeish (2018), a interpretację alfy – wpis alfa Cronbacha.
Jak opisać CBI w pracy
Pierwszy wzór opisuje narzędzie w rozdziale metodologicznym, drugi – wyniki. W nawiasach kwadratowych uzupełnij dane własnego badania. Budowę takiego akapitu omawia wzór opisu narzędzia badawczego.
CBI w R: punkty 0–100, trzy skale i rzetelność
Kod odtwarza wszystkie liczby z tekstu i rysunków, a na początku zapisuje plik CSV do pobrania. Kolumny o1–o6, z1–z7 i k1–k6 to numery zaznaczonych odpowiedzi (1–5). Kod przelicza je na punkty, odwraca pozycję z7, liczy średnie skal z regułą braków, rzetelność, korelacje i porównanie grup. Alfę i model czynnikowy liczy pakiet psych, a d z CI – pakiet DescTools.
CBI krok po kroku
R
# B164 – CBI: trzy skale wypalenia (osobiste, zawodowe, związane z klientem), przeliczenie odpowiedzi na 0–100,
# pozycja odwrócona, braki, rzetelność i porównanie grup (dane symulowane, set.seed(1641)).
# 280 pielęgniarek i pielęgniarzy z oddziałów szpitalnych; część pracuje w systemie dyżurów 12-godzinnych.
# Odpowiedzi zapisano jako numer odpowiedzi na formularzu: 1 = pierwsza (zawsze / w bardzo dużym stopniu)
# … 5 = ostatnia (nigdy lub prawie nigdy / w bardzo małym stopniu). Treści pozycji nie odtwarzamy.
# o1–o6 – wypalenie osobiste, z1–z7 – zawodowe, k1–k6 – związane z klientem (pacjentem).
# z7 to w tym zbiorze pozycja odwrócona; jej numer w Twojej wersji sprawdź w oficjalnym formularzu.
suppressPackageStartupMessages({ library(psych); library(DescTools) })
set.seed(1641)
n <- 280
dyzur12 <- rbinom(n, 1, 0.55)
osob <- rnorm(n, 0.30 * dyzur12, 1)                        # ukryte nasilenie wyczerpania
zaw  <- 0.75 * osob + rnorm(n, 0.10 * dyzur12, 0.62)
klie <- 0.55 * zaw + rnorm(n, 0, 0.85)
pozycje <- function(cecha, k, lad, przes) {
  sapply(1:k, function(j) {
    y <- lad * cecha + rnorm(n, 0, 0.75) + przes[j] - 0.6
    5 - findInterval(y, c(-1.6, -0.5, 0.5, 1.6))          # numer odpowiedzi 1–5 (1 = zawsze)
  })
}
O <- pozycje(osob, 6, 0.95, c(0.5, 0.3, 0.2, -0.2, 0.1, -0.1))
Z <- pozycje(zaw, 7, 0.95, c(0.4, 0.3, -0.3, 0.0, 0.2, -0.2, 0))
Z[, 7] <- 6 - Z[, 7]                                       # pozycja odwrócona: na formularzu „w drugą stronę”
K <- pozycje(klie, 6, 0.95, c(-0.2, -0.4, -0.1, -0.5, -0.3, -0.6))
colnames(O) <- paste0("o", 1:6); colnames(Z) <- paste0("z", 1:7); colnames(K) <- paste0("k", 1:6)
dane <- data.frame(id = 1:n, dyzur_12h = ifelse(dyzur12 == 1, "tak", "nie"), O, Z, K)
dane[sample(n, 7), "o4"] <- NA; dane[sample(n, 5), "z3"] <- NA; dane[sample(n, 4), "k2"] <- NA
dane[sample(n, 3), paste0("k", 1:6)] <- NA                 # 3 osoby pominęły całą skalę pacjentów
dane[sample(n, 2), paste0("z", 1:4)] <- NA                 # 2 osoby przerwały skalę zawodową
write.csv(dane, "../cbi-dane-przyklad.csv", row.names = FALSE, na = "")
o <- paste0("o", 1:6); z <- paste0("z", 1:7); k <- paste0("k", 1:6)

# Krok 1. Kontrola: każda odpowiedź to 1–5 albo brak
all(as.matrix(dane[, c(o, z, k)]) %in% c(1:5, NA))

# Krok 2. Przeliczenie na punkty 0–100: pierwsza odpowiedź = 100, ostatnia = 0; pozycja odwrócona odwrotnie
na_punkty <- function(x) (5 - x) * 25
pkt <- as.data.frame(lapply(dane[, c(o, z, k)], na_punkty))
pkt$z7 <- 100 - pkt$z7                                    # pozycja odwrócona
table(odpowiedz = dane$z1, punkty = pkt$z1)
table(odpowiedz = dane$z7, punkty = pkt$z7)

# Krok 3. Wynik skali = średnia punktów jej pozycji; tu: gdy odpowiedziano na co najmniej połowę pozycji
wynik_skali <- function(m) { ile <- rowSums(!is.na(m)); ifelse(ile >= ncol(m) / 2, rowMeans(m, na.rm = TRUE), NA) }
dane$osobiste  <- wynik_skali(pkt[, o])
dane$zawodowe  <- wynik_skali(pkt[, z])
dane$pacjenci  <- wynik_skali(pkt[, k])
sk <- c("osobiste", "zawodowe", "pacjenci")
sapply(dane[, sk], function(v) c(wazne = sum(!is.na(v)), braki = sum(is.na(v))))
sapply(list(osobiste = o, zawodowe = z, pacjenci = k), function(p) sum(rowSums(is.na(dane[, p])) > 0))

# Krok 4. Statystyki opisowe trzech skal (0–100; wyżej = silniejsze wypalenie)
round(t(sapply(dane[, sk], function(v) { v <- na.omit(v)
  c(M = mean(v), SD = sd(v), Me = median(v), Q1 = quantile(v, .25, names = FALSE), Q3 = quantile(v, .75, names = FALSE),
    min = min(v), max = max(v), skosnosc = skew(v)) })), 2)

# Krok 5. Rzetelność każdej skali: alfa i omega (model jednoczynnikowy), na punktach 0–100 po odwróceniu
omega1 <- function(m) { l <- as.numeric(fa(m, nfactors = 1)$loadings); sum(l)^2 / (sum(l)^2 + sum(1 - l^2)) }
round(t(sapply(list(osobiste = o, zawodowe = z, pacjenci = k), function(p) { m <- na.omit(pkt[, p])
  a <- suppressMessages(psych::alpha(m, warnings = FALSE))
  c(n = nrow(m), alfa = a$total$raw_alpha, omega = omega1(m), r_poz_min = min(a$item.stats$r.drop),
    r_poz_max = max(a$item.stats$r.drop)) })), 2)
# kontrola: alfa skali zawodowej, gdyby zapomnieć o odwróceniu z7
pkt_bez <- pkt; pkt_bez$z7 <- 100 - pkt_bez$z7
round(suppressMessages(psych::alpha(na.omit(pkt_bez[, z]), warnings = FALSE))$total$raw_alpha, 2)

# Krok 6. Korelacje między skalami (Pearson, 95% CI)
pary <- list(c("osobiste", "zawodowe"), c("osobiste", "pacjenci"), c("zawodowe", "pacjenci"))
round(t(sapply(pary, function(p) { ct <- cor.test(dane[[p[1]]], dane[[p[2]]])
  c(r = unname(ct$estimate), lo = ct$conf.int[1], hi = ct$conf.int[2], n = unname(ct$parameter) + 2) })), 2)

# Krok 7. Dyżury 12-godzinne a wypalenie zawodowe: test t Welcha i d Cohena z 95% CI
d <- dane[!is.na(dane$zawodowe), ]
round(sapply(sk, function(s) tapply(dane[[s]], dane$dyzur_12h, mean, na.rm = TRUE)), 2)
sapply(split(d$zawodowe, d$dyzur_12h), function(v) round(c(n = length(v), M = mean(v), SD = sd(v)), 2))
tt <- t.test(zawodowe ~ dyzur_12h, d)                     # znak t: grupa „nie” minus „tak”
round(c(t = unname(tt$statistic), df = unname(tt$parameter), roznica = unname(diff(tt$estimate)),
        lo = -tt$conf.int[2], hi = -tt$conf.int[1]), 2)
format.pval(tt$p.value, digits = 3)
round(CohenD(d$zawodowe[d$dyzur_12h == "tak"], d$zawodowe[d$dyzur_12h == "nie"], conf.level = .95)[1:3], 2)
Wynik w R
[1] TRUE
         punkty
odpowiedz  0 25 50 75 100
        1  0  0  0  0  21
        2  0  0  0 73   0
        3  0  0 96  0   0
        4  0 58  0  0   0
        5 30  0  0  0   0
         punkty
odpowiedz  0 25 50 75 100
        1 47  0  0  0   0
        2  0 80  0  0   0
        3  0  0 98  0   0
        4  0  0  0 49   0
        5  0  0  0  0   6
      osobiste zawodowe pacjenci
wazne      280      278      277
braki        0        2        3
osobiste zawodowe pacjenci
       7        7        7
             M    SD    Me    Q1    Q3 min    max skosnosc
osobiste 44.58 22.00 45.83 29.17 58.33   0  95.83     0.14
zawodowe 42.44 21.20 42.86 28.57 60.71   0 100.00    -0.02
pacjenci 31.92 20.58 29.17 16.67 45.83   0  95.83     0.43
           n alfa omega r_poz_min r_poz_max
osobiste 273 0.89  0.89      0.68      0.75
zawodowe 273 0.89  0.89      0.64      0.71
pacjenci 273 0.88  0.88      0.65      0.72
[1] 0.7
        r   lo   hi   n
[1,] 0.72 0.65 0.77 278
[2,] 0.30 0.18 0.40 277
[3,] 0.45 0.35 0.54 275
    osobiste zawodowe pacjenci
nie    39.10    36.73    31.06
tak    48.51    46.58    32.54
      nie    tak
n  117.00 161.00
M   36.73  46.58
SD  21.33  20.18
      t      df roznica      lo      hi
  -3.89  241.84    9.86    4.87   14.85
[1] "0.000129"
     d lwr.ci upr.ci
  0.48   0.24   0.72
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy CBI
- Suma zamiast średniej. Wynik skali to średnia punktów 0–100. Suma zależy od liczby pozycji i nie da się jej porównać z literaturą.
- Brak odwrócenia pozycji o energii po pracy. Zaniża rzetelność skali zawodowej i przesuwa wynik. Sprawdź numer tej pozycji w swojej wersji formularza.
- Jeden wynik z 19 pozycji bez uzasadnienia. CBI zaprojektowano jako trzy skale. Wynik łączny podawaj tylko ze źródłem i obok wyników skal.
- Skala pacjentów u osób, które nie pracują z ludźmi. Te pozycje nie mają wtedy sensu, a odpowiedzi zniekształcą wynik.
- Progi „z internetu”. Nie dziel badanych na grupy według granic bez źródła. Raportuj wynik ciągły.
- „30% pielęgniarek ma wypalenie”. CBI nie stawia diagnozy. Pisz o nasileniu wyczerpania w samoopisie.
- Zmiana słowa „klient” bez informacji. Zastąpienie go słowem „pacjent” jest typowe, ale trzeba to opisać w metodzie.
Plan całej analizy kwestionariusza, od czyszczenia danych po rzetelność, znajdziesz w przewodniku po analizie kwestionariusza. Porównanie grup krok po kroku omawia wpis test t Studenta krok po kroku. Jeśli chcesz, żeby ktoś sprawdził przeliczenie CBI i dobór analiz w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik CBI?
Każdą odpowiedź przelicz na punkty: pierwsza kategoria (zawsze, w bardzo dużym stopniu) to 100, kolejne 75, 50, 25, a ostatnia 0. Jedną pozycję skali zawodowej, o energii na rodzinę i przyjaciół po pracy, odwróć (100 − punkty). Wynik każdej z trzech skal to średnia punktów jej pozycji, w zakresie 0–100.
Czy CBI ma punkt odcięcia dla wypalenia?
W źródłach cytowanych we wpisie nie ma oficjalnego progu, który dzieliłby badanych na wypalonych i niewypalonych. Analizuj wynik 0–100 jako zmienną ciągłą. Jeśli używasz kategorii z literatury, podaj ich źródło i pamiętaj, że to nie diagnoza.
Czy Kopenhaski Kwestionariusz Wypalenia jest darmowy?
Tak. Według strony duńskiego Narodowego Centrum Badań Środowiska Pracy (NFA) CBI można używać bezpłatnie do celów niekomercyjnych i komercyjnych, jeśli wyraźnie wskażesz źródło: Borritz i in. (2006). W pracy zacytuj też artykuł Kristensena i in. (2005). Polską wersję cytuj według jej źródła.
Czy wyniki trzech skal CBI można zsumować w jeden wynik?
Autorzy opisali trzy skale do różnych obszarów, a nie jeden wynik ogólny. Niektóre badania liczą średnią trzech skal, ale wtedy trzeba to uzasadnić i podać źródło. W pracy dyplomowej zwykle lepiej analizować skale osobno.
Jaka jest rzetelność CBI u pielęgniarek?
W badaniu 928 pielęgniarek i pielęgniarzy alfa Cronbacha wyniosła .91 dla wypalenia osobistego, .89 dla zawodowego i .92 dla związanego z klientem (Montgomery i in., 2021). W pracy policz jednak rzetelność we własnej próbie, osobno dla każdej skali.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikAnaliza kwestionariusza – przewodnik
Od wyboru skali i pilotażu przez czyszczenie danych, wynik i rzetelność do opisu narzędzia: poradniki, hasła i kalkulatory na każdy etap.
Czytaj →Badasz wypalenie personelu i nie masz pewności, czy dobrze liczysz CBI?
Sprawdzimy przeliczenie odpowiedzi, odwrócenie pozycji, obsługę braków i dobór analiz oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Borritz, M., Rugulies, R., Bjorner, J. B., Villadsen, E., Mikkelsen, O. A., & Kristensen, T. S. (2006). Burnout among employees in human service work: Design and baseline findings of the PUMA study. Scandinavian Journal of Public Health, 34(1), 49–58. https://doi.org/10.1080/14034940510032275
- Det Nationale Forskningscenter for Arbejdsmiljø. (b.d.). Copenhagen Burnout Inventory – CBI. NFA. Pobrano 27 października 2026 z https://nfa.dk/vaerktoejer/spoergeskemaer/spoergeskema-til-maaling-af-udbraendthed-cbi/copenhagen-burnout-inventory-cbi ● Otwarty dostęp
- Kristensen, T. S., Borritz, M., Villadsen, E., & Christensen, K. B. (2005). The Copenhagen Burnout Inventory: A new tool for the assessment of burnout. Work & Stress, 19(3), 192–207. https://doi.org/10.1080/02678370500297720
- Maslach, C., & Leiter, M. P. (2016). Understanding the burnout experience: Recent research and its implications for psychiatry. World Psychiatry, 15(2), 103–111. https://doi.org/10.1002/wps.20311 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Montgomery, A. P., Azuero, A., & Patrician, P. A. (2021). Psychometric properties of Copenhagen Burnout Inventory among nurses. Research in Nursing & Health, 44(2), 308–318. https://doi.org/10.1002/nur.22114
- Piperac, P., Todorovic, J., Terzic-Supic, Z., Maksimovic, A., Karic, S., Pilipovic, F., & Soldatovic, I. (2021). The validity and reliability of the Copenhagen Burnout Inventory for examination of burnout among preschool teachers in Serbia. International Journal of Environmental Research and Public Health, 18(13), Article 6805. https://doi.org/10.3390/ijerph18136805 ● Otwarty dostęp
- Sestili, C., Scalingi, S., Cianfanelli, S., Mannocci, A., Del Cimmuto, A., De Sio, S., Chiarini, M., Di Muzio, M., Villari, P., De Giusti, M., & La Torre, G. (2018). Reliability and use of Copenhagen Burnout Inventory in Italian sample of university professors. International Journal of Environmental Research and Public Health, 15(8), Article 1708. https://doi.org/10.3390/ijerph15081708 ● Otwarty dostęp
Cytowania BibTeX
@article{borritz2006burnout, author={Borritz, Marianne and Rugulies, Reiner and Bjorner, Jakob B. and Villadsen, Ebbe and Mikkelsen, Ole A. and Kristensen, Tage S.}, title={{Burnout among employees in human service work: Design and baseline findings of the PUMA study}}, journal={Scandinavian Journal of Public Health}, year={2006}, volume={34}, number={1}, pages={49--58}, doi={10.1080/14034940510032275}}@misc{cbinfand, author={{Det Nationale Forskningscenter for Arbejdsmiljø}}, title={{Copenhagen Burnout Inventory – CBI}}, publisher={NFA}, url={https://nfa.dk/vaerktoejer/spoergeskemaer/spoergeskema-til-maaling-af-udbraendthed-cbi/copenhagen-burnout-inventory-cbi}}@article{kristensen2005copenhagen, author={Kristensen, Tage S. and Borritz, Marianne and Villadsen, Ebbe and Christensen, Karl B.}, title={{The Copenhagen Burnout Inventory: A new tool for the assessment of burnout}}, journal={Work \& Stress}, year={2005}, volume={19}, number={3}, pages={192--207}, doi={10.1080/02678370500297720}}@article{maslach2016understanding, author={Maslach, Christina and Leiter, Michael P.}, title={{Understanding the burnout experience: Recent research and its implications for psychiatry}}, journal={World Psychiatry}, year={2016}, volume={15}, number={2}, pages={103--111}, doi={10.1002/wps.20311}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{montgomery2021psychometric, author={Montgomery, Aoyjai P. and Azuero, Andres and Patrician, Patricia A.}, title={{Psychometric properties of Copenhagen Burnout Inventory among nurses}}, journal={Research in Nursing \& Health}, year={2021}, volume={44}, number={2}, pages={308--318}, doi={10.1002/nur.22114}}@article{piperac2021validity, author={Piperac, Pavle and Todorovic, Jovana and Terzic-Supic, Zorica and Maksimovic, Aleksandra and Karic, Svetlana and Pilipovic, Filip and Soldatovic, Ivan}, title={{The validity and reliability of the Copenhagen Burnout Inventory for examination of burnout among preschool teachers in Serbia}}, journal={International Journal of Environmental Research and Public Health}, year={2021}, volume={18}, number={13}, eid={6805}, doi={10.3390/ijerph18136805}}@article{sestili2018reliability, author={Sestili, Cristina and Scalingi, Stefania and Cianfanelli, Sara and Mannocci, Alice and Del Cimmuto, Angela and De Sio, Simone and Chiarini, Massimiliano and Di Muzio, Marco and Villari, Paolo and De Giusti, Maria and La Torre, Giuseppe}, title={{Reliability and use of Copenhagen Burnout Inventory in Italian sample of university professors}}, journal={International Journal of Environmental Research and Public Health}, year={2018}, volume={15}, number={8}, eid={1708}, doi={10.3390/ijerph15081708}}