Czym jest OLBI
OLBI (Oldenburg Burnout Inventory), czyli Oldenburski Kwestionariusz Wypalenia, to samoopisowe narzędzie do pomiaru wypalenia zawodowego. Opracowali je Evangelia Demerouti i współpracownicy (Halbesleben i Demerouti, 2005). Jedną z pierwszych publikacji z OLBI jest artykuł o modelu wymagań i zasobów pracy (JD-R), w którym potwierdzono dwa wymiary wypalenia: wyczerpanie i dystansowanie się od pracy (Demerouti i in., 2001).
OLBI spotkasz najczęściej w pracach z zarządzania (zasoby ludzkie, obciążenie pracą, styl kierowania), pielęgniarstwa (personel oddziałów, praca zmianowa) i psychologii pracy (zob. statystyka dla psychologa). Używa się go też w badaniach studentów: Reis i in. (2015) pokazali, że ta sama dwuczynnikowa struktura sprawdza się przy wypaleniu zawodowym i akademickim.
Wpis pokazuje, jak odwrócić pozycje, policzyć dwie podskale, sprawdzić rzetelność i strukturę oraz opisać OLBI w pracy. Treści pozycji nie przytaczamy.
OLBI a CBI i MBI
W serwisie jest osobny wpis o Kopenhaskim Kwestionariuszu Wypalenia (CBI). Oba narzędzia powstały jako alternatywa dla Maslach Burnout Inventory, ale mierzą co innego. CBI opisuje tylko wyczerpanie, za to w trzech obszarach: osobistym, zawodowym i w pracy z klientem. OLBI ma dwa wymiary: wyczerpanie, ujęte szerzej niż w MBI (Halbesleben i Demerouti, 2005), oraz dystansowanie się od pracy, czyli – w naszym opisie – negatywny, obojętny stosunek do pracy i jej treści.
Druga różnica dotyczy sformułowań. MBI krytykowano m.in. za brzmienie pozycji (Halbesleben i Demerouti, 2005). W OLBI każda podskala ma pozycje sformułowane w stronę wypalenia i w stronę zaangażowania, a autorzy proponowali nawet uzupełnić MBI o pozytywnie sformułowane pozycje OLBI (Demerouti i in., 2003). Ogranicza to wpływ tendencji do zgadzania się, ale wymaga odwracania punktacji. Ponieważ OLBI ma też „pozytywny” biegun, bywa używany obok skal zaangażowania, np. UWES-9. Demerouti i in. (2010) pokazali jednak, że wyczerpanie i wigor są silnie powiązane, ale nie są dwoma końcami jednego wymiaru.
Budowa: 16 pozycji, dwie podskale
Według publikacji z udziałem autorki narzędzia OLBI ma 16 pozycji: po 8 w każdej podskali, w tym po 4 sformułowane negatywnie (w stronę wypalenia) i 4 pozytywnie. Odpowiedzi udziela się na 4-stopniowej skali zgody (Yacoubian i in., 2023). Każda podskala to osobna podskala z własnym wynikiem.
| Podskala | Pozycje | W stronę wypalenia / zaangażowania | Czego dotyczy (opis własny) |
|---|---|---|---|
| Wyczerpanie (exhaustion) | 8 | 4 / 4 | zmęczenie po pracy i w czasie pracy, potrzeba odpoczynku, poczucie przeciążenia |
| Dystansowanie się od pracy (disengagement) | 8 | 4 / 4 | negatywne myśli o pracy, mechaniczne jej wykonywanie, utrata zainteresowania |
Polskie nazwy podskal to nasze opisowe tłumaczenie; w polskiej wersji mogą brzmieć inaczej. Numerów pozycji odwróconych tu nie podajemy. Weź je z formularza wersji, której używasz, i zapisz w książce kodowej.
Licencja i polska wersja
Nie znaleźliśmy oficjalnej strony autorów z warunkami użycia OLBI (sprawdzono 1 listopada 2026 r.). Artykuł współautorstwa Demerouti podaje, że narzędzie jest dostępne do niekomercyjnego użytku badawczego (Yacoubian i in., 2023). W pracy dyplomowej możesz więc go użyć, ale zacytuj publikacje źródłowe: Demerouti i in. (2001) i, przy wersji angielskiej, Halbesleben i Demerouti (2005). Przy zastosowaniu komercyjnym, np. w płatnym audycie firmy, zapytaj autorów o zgodę.
Polską wersję opisali Baka i Basińska (2016) na trzech próbach pracowników. Potwierdzili dwa czynniki, ale ich skład różnił się od oryginału, a w każdym wymiarze wyodrębniły się po dwie podskale. Rzetelność sprawdzono alfą i metodą test–retest. Jeśli korzystasz z tej wersji, zacytuj ją i sprawdź jej klucz. Norm z tej pracy tu nie przytaczamy. Ogólne zasady szukania narzędzi opisuje wpis gdzie znaleźć kwestionariusze psychologiczne.
Jak policzyć wynik krok po kroku
Krok 1. Ustal kierunek kodowania odpowiedzi
Formularze OLBI bywają drukowane w dwóch kierunkach. Yacoubian i in. (2023) opisują kodowanie 1 = zdecydowanie się zgadzam, …, 4 = zdecydowanie się nie zgadzam. W przykładzie zapisujemy zgodę rosnąco: 1 = zdecydowanie się nie zgadzam, 4 = zdecydowanie się zgadzam. Oba zapisy są poprawne, jeśli trzymasz się jednej zasady: po przekodowaniu wyższa liczba oznacza więcej wypalenia. Sprawdź też, czy każda kolumna ma tylko wartości 1–4 albo brak.
Krok 2. Odwróć pozycje o przeciwnym kierunku
Przy zapisie rosnącej zgody odwracasz pozycje sformułowane w stronę zaangażowania: zgoda z nimi oznacza mniej wypalenia. Wzór to max + min − x, czyli 5 − odpowiedź (zob. pozycja odwrócona). Przy kodowaniu odwrotnym odwracasz drugą połowę pozycji. W kluczu z publikacji pozycje do odwrócenia są oznaczone, ale oznaczenie dotyczy kodowania użytego w tej publikacji.
Krok 3. Policz średnią każdej podskali
Wynik podskali to średnia jej 8 pozycji (Yacoubian i in., 2023), więc mieści się w zakresie 1–4. Średnia zostaje na skali odpowiedzi i pozwala porównać obie podskale (zob. wynik skali: średnia czy suma). Jeśli wolisz sumę (8–32), podaj to wprost, bo literatura raportuje głównie średnie.
Krok 4. Ustal regułę braków
W cytowanych źródłach nie ma oficjalnej reguły dla braków. W przykładzie liczymy średnią, gdy osoba odpowiedziała na co najmniej 6 z 8 pozycji. To nasza decyzja, którą trzeba opisać w metodzie (zob. braki danych).
Krok 5. Dwa wyniki zamiast jednego
OLBI zaprojektowano jako dwa wymiary, które wiążą się z innymi warunkami pracy (Demerouti i in., 2001). W hipotezach i analizach używaj więc dwóch podskal. Średnią z 16 pozycji podawaj tylko wtedy, gdy wskażesz źródło, które tak robi, i zawsze obok podskal. Ogólną procedurę liczenia wyniku opisuje wpis jak policzyć wynik kwestionariusza.
Interpretacja: wynik ciągły, bez oficjalnego progu
Wyższa średnia oznacza silniejsze wyczerpanie albo silniejsze dystansowanie się od pracy. W publikacjach źródłowych, które sprawdziliśmy, nie ma punktu odcięcia dla „wypalenia”. Niektóre badania dzielą osoby na grupy według obu wymiarów. Peterson i in. (2008) wyodrębnili cztery grupy: bez wypalenia, zdystansowani, wyczerpani i wypaleni. Progi takich podziałów różnią się jednak między pracami, więc ich nie podajemy. Jeśli ich używasz, zacytuj pracę, z której pochodzą, i pokaż także wyniki ciągłe. Podział na grupy traci informację (zob. niski, przeciętny, wysoki wynik). OLBI nie służy do diagnozy.
Przykład: 320 pracowników centrum obsługi klienta
W badaniu symulowanym 320 pracowników centrum obsługi klienta wypełniło OLBI i dwie krótkie skale warunków pracy: obciążenia pracą (wymagania) i autonomii (zasoby). Dane są w pliku CSV. Pojedyncze braki nie wykluczały nikogo, ale 3 osoby pominęły całą podskalę dystansowania się. Wynik wyczerpania ma więc 320 osób, a dystansowania się 317.
Średnie wyniosły: wyczerpanie M = 2.47 (SD = 0.61; Me = 2.50), dystansowanie się M = 2.44 (SD = 0.56; Me = 2.43). Oba rozkłady są prawie symetryczne. Podskale korelowały r = .38, 95% CI [.28, .47]. Są więc powiązane, ale to nie jest jedna cecha.
Co się stanie bez odwrócenia pozycji
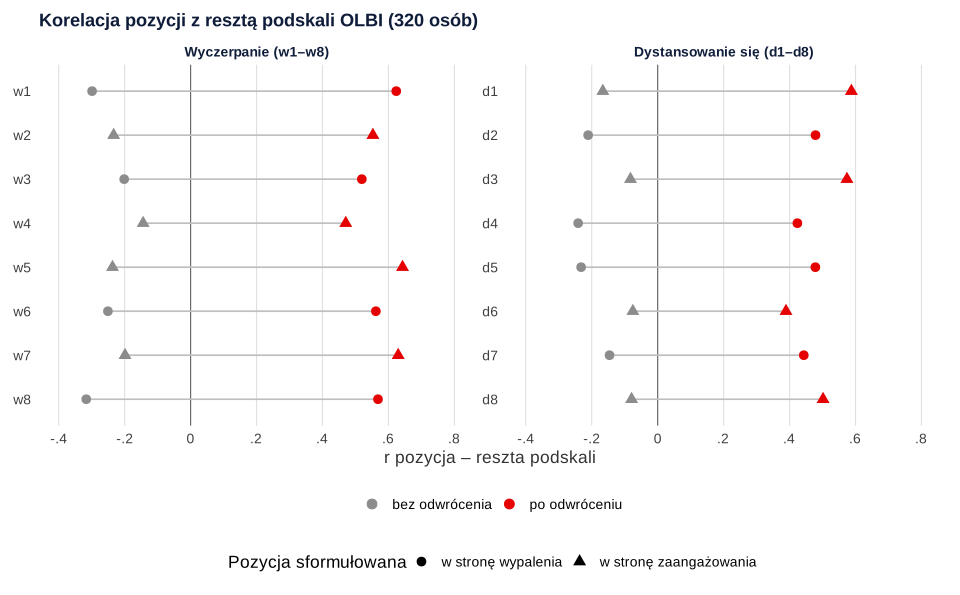
Rysunek 1 pokazuje korelację każdej pozycji z resztą podskali. Bez odwrócenia wszystkie korelacje są ujemne (od −.32 do −.08), bo w podskali są dwie grupy pozycji o przeciwnym kierunku. Alfa wyniosła wtedy −1.05 dla wyczerpania i −.62 dla dystansowania się. Ujemna alfa prawie zawsze oznacza błąd w kluczu. Po odwróceniu korelacje wyniosły .39–.64.
Rzetelność i struktura dwuczynnikowa
Halbesleben i Demerouti (2005) opisali akceptowalną spójność wewnętrzną i stabilność test–retest. Rzetelność trzeba jednak policzyć we własnych danych, osobno dla każdej podskali i na pozycjach po odwróceniu. W przykładzie alfa i omega McDonalda wyniosły .84 dla wyczerpania (n = 314) i .79 dla dystansowania się (n = 308). Dlaczego warto podać omegę obok alfy, wyjaśnia McNeish (2018). Interpretację alfy omawia wpis alfa Cronbacha.
Strukturę sprawdziliśmy konfirmacyjną analizą czynnikową z estymatorem WLSMV, bo odpowiedzi mają tylko cztery kategorie. Na 302 pełnych rekordach model dwuczynnikowy był dobrze dopasowany: χ²(103) = 114.82, CFI = .994, TLI = .993, RMSEA = .020, SRMR = .046. Model jednoczynnikowy wypadł wyraźnie gorzej: χ²(104) = 555.73, CFI = .767, RMSEA = .120, SRMR = .112. Orientacyjne progi dopasowania podają Hu i Bentler (1999). Ładunki standaryzowane mieściły się w przedziale .46–.77, a korelacja czynników wyniosła .46, 95% CI [.35, .58].
Wymagania, zasoby i dwie podskale
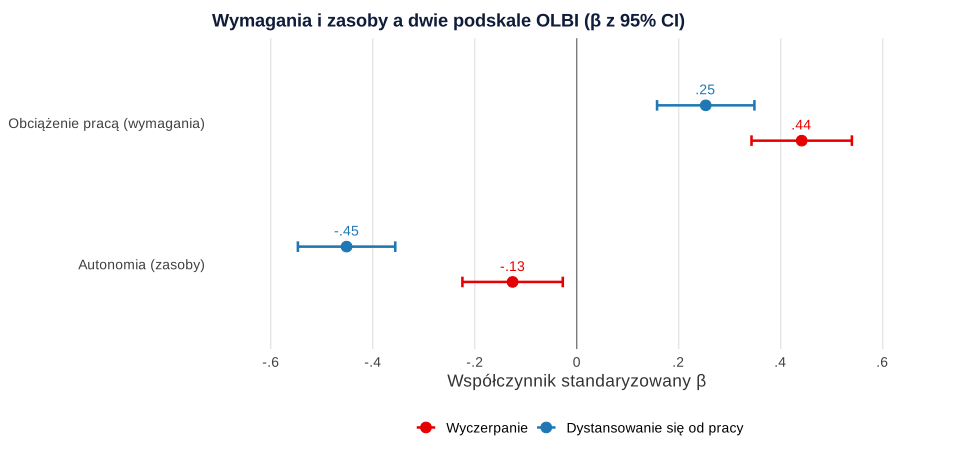
Model JD-R przewiduje, że wymagania pracy wiążą się głównie z wyczerpaniem, a brak zasobów z dystansowaniem się (Demerouti i in., 2001). W przykładzie każdą podskalę wyjaśnialiśmy regresją wieloraką z obciążeniem pracą i autonomią. Współczynniki standaryzowane pokazuje rysunek 2.
Wyczerpanie zależało przede wszystkim od obciążenia, β = .44, 95% CI [.34, .54], t(317) = 8.82, p < .001, a słabiej od autonomii, β = −.13, 95% CI [−.22, −.03], t(317) = −2.51, p = .012. Model wyjaśnił R² = .21 wariancji, F(2, 317) = 41.52, p < .001. Przy dystansowaniu się układ był odwrotny. Autonomia, β = −.45, 95% CI [−.55, −.36], t(314) = −9.30, p < .001, ważyła więcej niż obciążenie, β = .25, 95% CI [.16, .35], t(314) = 5.21, p < .001; R² = .26, F(2, 314) = 55.59, p < .001. Badanie jest przekrojowe, więc nie dowodzi przyczynowości.
Jak opisać OLBI w pracy
Pierwszy wzór opisuje narzędzie w rozdziale metodologicznym, drugi – wyniki. W nawiasach kwadratowych wpisz dane własnego badania. Budowę takiego akapitu omawia wzór opisu narzędzia badawczego.
OLBI w R: odwracanie, dwie podskale, rzetelność i CFA
Kod odtwarza wszystkie liczby z tekstu i rysunków, a na początku zapisuje plik CSV do pobrania. Kolumny w1–w8 i d1–d8 zawierają odpowiedzi 1–4 (zgoda rosnąco). Wektor pozytywne wskazuje pozycje do odwrócenia w tym zbiorze. Alfę liczy pakiet psych, a CFA – pakiet lavaan.
OLBI krok po kroku
R
# B252 – OLBI: dwie podskale (wyczerpanie, dystansowanie się od pracy), pozycje o przeciwnym kierunku,
# średnia 1–4, braki, rzetelność (alfa, omega), CFA i model wymagań–zasobów (dane symulowane, set.seed(25201)).
# 320 pracowników centrum obsługi klienta. Odpowiedzi zapisano rosnąco: 1 = zdecydowanie się nie zgadzam,
# 2 = nie zgadzam się, 3 = zgadzam się, 4 = zdecydowanie się zgadzam. Treści pozycji nie odtwarzamy.
# w1–w8 – wyczerpanie, d1–d8 – dystansowanie się od pracy. W każdej podskali 4 pozycje są sformułowane
# w stronę wypalenia, a 4 w stronę zaangażowania. Które to kolumny, ustalono tylko dla tego zbioru –
# w Twojej wersji sprawdź to w oficjalnym formularzu.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(25201)
n <- 320
wymagania <- round(pmin(pmax(rnorm(n, 3.1, 0.75), 1), 5), 2)  # obciążenie pracą, średnia 1–5 (inna skala)
zasoby    <- round(pmin(pmax(rnorm(n, 3.3, 0.70), 1), 5), 2)  # autonomia w pracy, średnia 1–5
zw <- as.numeric(scale(wymagania)); zz <- as.numeric(scale(zasoby))
wycz <- 0.50 * zw - 0.15 * zz + rnorm(n, 0, 0.85)              # ukryte wyczerpanie
dyst <- 0.40 * wycz + 0.10 * zw - 0.45 * zz + rnorm(n, 0, 0.75)  # ukryte dystansowanie się
pozycje <- function(cecha, lad, przes) {
  sapply(seq_along(lad), function(j) {
    y <- lad[j] * as.numeric(scale(cecha)) + rnorm(n, 0, sqrt(1 - lad[j]^2)) + przes[j]
    1 + findInterval(y, c(-1.0, 0.1, 1.2))                     # odpowiedź 1–4 w stronę wypalenia
  })
}
W <- pozycje(wycz, c(.72, .60, .68, .55, .74, .58, .66, .62), c(.2, -.1, .3, 0, .1, -.2, .2, 0))
D <- pozycje(dyst, c(.66, .58, .70, .52, .64, .60, .56, .68), c(0, .1, -.2, .2, -.1, 0, .1, -.1))
colnames(W) <- paste0("w", 1:8); colnames(D) <- paste0("d", 1:8)
pozytywne <- c("w2", "w4", "w5", "w7", "d1", "d3", "d6", "d8")  # sformułowane w stronę zaangażowania
dane <- data.frame(id = 1:n, wymagania, zasoby, W, D)
for (p in pozytywne) dane[[p]] <- 5 - dane[[p]]                 # na formularzu „zgoda” = mniej wypalenia
dane[sample(n, 6), "w3"] <- NA; dane[sample(n, 5), "d5"] <- NA; dane[sample(n, 4), "d2"] <- NA
dane[sample(n, 3), paste0("d", 1:8)] <- NA                      # 3 osoby pominęły całą drugą stronę
write.csv(dane, "../olbi-dane-przyklad.csv", row.names = FALSE, na = "")
w <- paste0("w", 1:8); d <- paste0("d", 1:8)

# Krok 1. Kontrola: każda odpowiedź to 1–4 albo brak
all(as.matrix(dane[, c(w, d)]) %in% c(1:4, NA))

# Krok 2. Odwrócenie pozycji sformułowanych w stronę zaangażowania: 5 − odpowiedź (max + min − x)
pkt <- dane[, c(w, d)]
for (p in pozytywne) pkt[[p]] <- 5 - pkt[[p]]
table(odpowiedz = dane$w2, po_odwroceniu = pkt$w2)

# Krok 3. Wynik podskali = średnia jej 8 pozycji (zakres 1–4; wyżej = więcej wypalenia);
# tu: gdy osoba odpowiedziała na co najmniej 6 z 8 pozycji (nasza decyzja, nie zalecenie autorów)
srednia_podskali <- function(m, min_odp = 6) {
  ile <- rowSums(!is.na(m)); ifelse(ile >= min_odp, rowMeans(m, na.rm = TRUE), NA)
}
dane$wyczerpanie   <- srednia_podskali(pkt[, w])
dane$dystansowanie <- srednia_podskali(pkt[, d])
sk <- c("wyczerpanie", "dystansowanie")
sapply(dane[, sk], function(v) c(wazne = sum(!is.na(v)), braki = sum(is.na(v))))

# Krok 4. Statystyki opisowe
round(t(sapply(dane[, sk], function(v) { v <- na.omit(v)
  c(M = mean(v), SD = sd(v), Me = median(v), min = min(v), max = max(v), skosnosc = skew(v)) })), 2)

# Krok 5. Rzetelność: alfa i omega (model jednoczynnikowy) każdej podskali po odwróceniu pozycji
omega1 <- function(m) { l <- as.numeric(fa(m, nfactors = 1)$loadings); sum(l)^2 / (sum(l)^2 + sum(1 - l^2)) }
rzet <- function(m) { m <- na.omit(m); a <- suppressMessages(psych::alpha(m, warnings = FALSE, check.keys = FALSE))
  c(n = nrow(m), alfa = a$total$raw_alpha, omega = omega1(m),
    r_min = min(a$item.stats$r.drop), r_max = max(a$item.stats$r.drop)) }
round(rbind(wyczerpanie = rzet(pkt[, w]), dystansowanie = rzet(pkt[, d])), 2)
# kontrola: alfa, gdyby zapomnieć o odwróceniu pozycji
alfa_bez <- function(m) suppressWarnings(suppressMessages(psych::alpha(na.omit(m), warnings = FALSE, check.keys = FALSE)))$total$raw_alpha
round(c(wyczerpanie = alfa_bez(dane[, w]), dystansowanie = alfa_bez(dane[, d])), 2)

# Krok 6. Korelacja pozycji z resztą podskali bez odwrócenia i po odwróceniu (dane do rysunku 1)
r_reszta <- function(m) sapply(colnames(m), function(j) cor(m[[j]], rowMeans(m[, setdiff(colnames(m), j)], na.rm = TRUE),
                                                          use = "complete.obs"))
rr <- data.frame(pozycja = c(w, d), bez = c(r_reszta(dane[, w]), r_reszta(dane[, d])),
                 po = c(r_reszta(pkt[, w]), r_reszta(pkt[, d])))
rr$kierunek <- ifelse(rr$pozycja %in% pozytywne, "w stronę zaangażowania", "w stronę wypalenia")
print(rr, digits = 2, row.names = FALSE)

# Krok 7. CFA: dwa czynniki a jeden czynnik (WLSMV, odpowiedzi jako porządkowe)
m2 <- paste("wycz =~", paste(w, collapse = " + "), "\n dyst =~", paste(d, collapse = " + "))
m1 <- paste("wyp =~", paste(c(w, d), collapse = " + "))
f2 <- cfa(m2, data = pkt, ordered = c(w, d), estimator = "WLSMV")
f1 <- cfa(m1, data = pkt, ordered = c(w, d), estimator = "WLSMV")
miary <- c("chisq.scaled", "df.scaled", "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr")
round(rbind(dwa_czynniki = fitMeasures(f2, miary), jeden_czynnik = fitMeasures(f1, miary)), 3)
lavInspect(f2, "nobs")
st <- standardizedSolution(f2)
round(st[st$op == "~~" & st$lhs == "wycz" & st$rhs == "dyst", c("est.std", "ci.lower", "ci.upper")], 2)
round(range(st$est.std[st$op == "=~"]), 2)                 # zakres ładunków standaryzowanych

# Krok 8. Korelacja podskal (Pearson, 95% CI)
ct <- cor.test(dane$wyczerpanie, dane$dystansowanie)
round(c(r = unname(ct$estimate), lo = ct$conf.int[1], hi = ct$conf.int[2], n = unname(ct$parameter) + 2), 2)

# Krok 9. Model wymagań–zasobów: obie podskale ~ obciążenie pracą + autonomia (współczynniki standaryzowane)
beta <- function(y) {
  dd <- na.omit(data.frame(y = dane[[y]], wymagania = dane$wymagania, zasoby = dane$zasoby))
  dz <- as.data.frame(scale(dd)); m <- lm(y ~ wymagania + zasoby, dz); s <- summary(m)
  ci <- confint(m)[-1, ]
  out <- data.frame(wynik = y, predyktor = c("wymagania", "zasoby"), beta = coef(m)[-1], lo = ci[, 1], hi = ci[, 2],
                    t = s$coefficients[-1, "t value"], p = s$coefficients[-1, "Pr(>|t|)"], row.names = NULL)
  attr(out, "fit") <- c(n = nrow(dd), R2 = s$r.squared, F = unname(s$fstatistic[1]), df1 = unname(s$fstatistic[2]),
                        df2 = unname(s$fstatistic[3]))
  out
}
b_w <- beta("wyczerpanie"); b_d <- beta("dystansowanie")
jdr <- rbind(b_w, b_d)
print(transform(jdr, p = format.pval(p, digits = 3, eps = .001)), digits = 3, row.names = FALSE)
round(rbind(wyczerpanie = attr(b_w, "fit"), dystansowanie = attr(b_d, "fit")), 3)
Wynik w R
[1] TRUE
         po_odwroceniu
odpowiedz   1   2   3   4
        1   0   0   0  33
        2   0   0 109   0
        3   0 122   0   0
        4  56   0   0   0
      wyczerpanie dystansowanie
wazne         320           317
braki           0             3
                 M   SD   Me  min  max skosnosc
wyczerpanie   2.47 0.61 2.50 1.00 4.00     0.02
dystansowanie 2.44 0.56 2.43 1.12 3.88     0.03
                n alfa omega r_min r_max
wyczerpanie   314 0.84  0.84  0.47  0.64
dystansowanie 308 0.79  0.79  0.39  0.60
  wyczerpanie dystansowanie
        -1.05         -0.62
 pozycja    bez   po               kierunek
      w1 -0.299 0.62     w stronę wypalenia
      w2 -0.233 0.55 w stronę zaangażowania
      w3 -0.201 0.52     w stronę wypalenia
      w4 -0.144 0.47 w stronę zaangażowania
      w5 -0.237 0.64 w stronę zaangażowania
      w6 -0.251 0.56     w stronę wypalenia
      w7 -0.199 0.63 w stronę zaangażowania
      w8 -0.316 0.57     w stronę wypalenia
      d1 -0.166 0.59 w stronę zaangażowania
      d2 -0.211 0.48     w stronę wypalenia
      d3 -0.082 0.57 w stronę zaangażowania
      d4 -0.241 0.42     w stronę wypalenia
      d5 -0.232 0.48     w stronę wypalenia
      d6 -0.075 0.39 w stronę zaangażowania
      d7 -0.146 0.44     w stronę wypalenia
      d8 -0.079 0.50 w stronę zaangażowania
              chisq.scaled df.scaled cfi.scaled tli.scaled rmsea.scaled  srmr
dwa_czynniki       114.816       103      0.994      0.993         0.02 0.046
jeden_czynnik      555.732       104      0.767      0.731         0.12 0.112
[1] 302
   est.std ci.lower ci.upper
83    0.46     0.35     0.58
[1] 0.46 0.77
     r     lo     hi      n
  0.38   0.28   0.47 317.00
         wynik predyktor   beta     lo      hi     t      p
   wyczerpanie wymagania  0.441  0.343  0.5395  8.82 <0.001
   wyczerpanie    zasoby -0.126 -0.224 -0.0274 -2.51 0.0124
 dystansowanie wymagania  0.253  0.157  0.3484  5.21 <0.001
 dystansowanie    zasoby -0.451 -0.547 -0.3559 -9.30 <0.001
                n    R2      F df1 df2
wyczerpanie   320 0.208 41.522   2 317
dystansowanie 317 0.261 55.590   2 314
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy OLBI
- Brak odwrócenia połowy pozycji. Daje ujemne lub bardzo niskie korelacje pozycji i alfę bliską zeru albo ujemną. To najczęstszy błąd przy OLBI.
- Odwrócenie „nie tych” pozycji. Oznaczenia w kluczu dotyczą konkretnego kierunku kodowania. Najpierw ustal, czy 1 to zgoda, czy brak zgody.
- Jeden wynik z 16 pozycji bez uzasadnienia. OLBI ma dwa wymiary o różnych korelatach. Wynik łączny podawaj tylko ze źródłem i obok podskal.
- Progi bez źródła. Nie pisz „42% badanych jest wypalonych” na podstawie granic z internetu. Raportuj średnie i rozkłady.
- Mieszanie wersji. Polska wersja ma inną strukturę niż oryginał. Klucz, rzetelność i porównania odnoś do wersji, której użyłeś.
- Wnioski przyczynowe z badania przekrojowego. Związek obciążenia z wyczerpaniem nie dowodzi, że to obciążenie wywołuje wypalenie.
Plan całej analizy kwestionariusza znajdziesz w przewodniku po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził klucz OLBI i dobór analiz w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Które pozycje OLBI trzeba odwrócić?
Odwracasz pozycje sformułowane w stronę zaangażowania albo w stronę wypalenia – zależy to od kierunku kodowania odpowiedzi. Zasada jest jedna: po przekodowaniu wyższa liczba ma oznaczać więcej wypalenia. Numery pozycji weź z formularza swojej wersji, bo oznaczenia w kluczu dotyczą kodowania użytego przez autorów publikacji.
Dlaczego alfa Cronbacha dla OLBI wyszła ujemna?
Prawie zawsze dlatego, że nie odwrócono pozycji o przeciwnym kierunku. W przykładzie na danych symulowanych alfa bez odwrócenia wyniosła −1.05 dla wyczerpania, a po odwróceniu .84. Sprawdź korelacje pozycji z resztą podskali: ujemne wskazują pozycje do przekodowania.
Czy OLBI można policzyć jako jeden wynik wypalenia?
Narzędzie zaprojektowano jako dwa wymiary, które wiążą się z różnymi warunkami pracy, a w przykładzie na danych symulowanych model jednoczynnikowy pasował wyraźnie gorzej niż dwuczynnikowy. W pracy dyplomowej analizuj dwie podskale. Średnią z 16 pozycji podawaj tylko ze źródłem i obok podskal.
Czy OLBI nadaje się do badania wypalenia u studentów?
Tak, w badaniach używa się wersji dostosowanej do kontekstu studiów. Reis i in. (2015) potwierdzili dwuczynnikową strukturę u studentów z Niemiec i Grecji. Opisz w metodzie, że użyłeś wersji dla studentów, i podaj jej źródło.
Czy na użycie OLBI w pracy magisterskiej potrzebna jest zgoda?
Nie znaleźliśmy oficjalnej strony z warunkami użycia. Artykuł współautorstwa Demerouti (2023) podaje, że narzędzie jest dostępne do niekomercyjnego użytku badawczego. Zacytuj publikacje źródłowe, a przy użyciu komercyjnym zapytaj autorów o zgodę.
Powiązane hasła
Przeczytaj też
CBI – jak policzyć wynik wypalenia
Trzy skale wypalenia, przeliczenie odpowiedzi na 0–100, pozycja odwrócona, braki, licencja i rzetelność – z przykładem w R na danych pielęgniarek i wzorem opisu.
Czytaj →PoradnikUWES-9 – jak policzyć wynik zaangażowania
Wigor, oddanie i pochłonięcie jako średnie 0–6, wynik ogólny, warunki użycia i struktura czynnikowa – z przykładem w R na danych pielęgniarek i wzorem opisu.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →Badasz wypalenie zawodowe i nie masz pewności, czy dobrze liczysz OLBI?
Sprawdzimy kierunek kodowania, odwrócenie pozycji, obsługę braków i dobór analiz oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baka, Ł., & Basińska, B. (2016). Psychometric properties of the Polish version of the Oldenburg Burnout Inventory (OLBI). Medycyna Pracy, 67(1), 29–41. https://doi.org/10.13075/mp.5893.00353 ● Otwarty dostęp
- Demerouti, E., Bakker, A. B., Nachreiner, F., & Schaufeli, W. B. (2001). The job demands-resources model of burnout. Journal of Applied Psychology, 86(3), 499–512. https://doi.org/10.1037/0021-9010.86.3.499 ● Otwarty dostęp: pełny tekst
- Demerouti, E., Bakker, A. B., Vardakou, I., & Kantas, A. (2003). The convergent validity of two burnout instruments. European Journal of Psychological Assessment, 19(1), 12–23. https://doi.org/10.1027//1015-5759.19.1.12
- Demerouti, E., Mostert, K., & Bakker, A. B. (2010). Burnout and work engagement: A thorough investigation of the independency of both constructs. Journal of Occupational Health Psychology, 15(3), 209–222. https://doi.org/10.1037/a0019408
- Halbesleben, J. R. B., & Demerouti, E. (2005). The construct validity of an alternative measure of burnout: Investigating the English translation of the Oldenburg Burnout Inventory. Work & Stress, 19(3), 208–220. https://doi.org/10.1080/02678370500340728
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Peterson, U., Demerouti, E., Bergström, G., Samuelsson, M., Åsberg, M., & Nygren, Å. (2008). Burnout and physical and mental health among Swedish healthcare workers. Journal of Advanced Nursing, 62(1), 84–95. https://doi.org/10.1111/j.1365-2648.2007.04580.x
- Reis, D., Xanthopoulou, D., & Tsaousis, I. (2015). Measuring job and academic burnout with the Oldenburg Burnout Inventory (OLBI): Factorial invariance across samples and countries. Burnout Research, 2(1), 8–18. https://doi.org/10.1016/j.burn.2014.11.001 ● Otwarty dostęp
- Yacoubian, A., Demerouti, E., Degheili, J. A., & El Hajj, A. (2023). A survey-based study about burnout among postgraduate medical trainees: Implications for leaders in healthcare management. Frontiers in Public Health, 11, Article 1209191. https://doi.org/10.3389/fpubh.2023.1209191 ● Otwarty dostęp
Cytowania BibTeX
@article{baka2016psychometric, author={Baka, Łukasz and Basińska, Beata}, title={{Psychometric properties of the Polish version of the Oldenburg Burnout Inventory (OLBI)}}, journal={Medycyna Pracy}, year={2016}, volume={67}, number={1}, pages={29--41}, doi={10.13075/mp.5893.00353}}@article{demerouti2001job, author={Demerouti, Evangelia and Bakker, Arnold B. and Nachreiner, Friedhelm and Schaufeli, Wilmar B.}, title={{The job demands-resources model of burnout}}, journal={Journal of Applied Psychology}, year={2001}, volume={86}, number={3}, pages={499--512}, doi={10.1037/0021-9010.86.3.499}}@article{demerouti2003convergent, author={Demerouti, Evangelia and Bakker, Arnold B. and Vardakou, Ioanna and Kantas, Aristotelis}, title={{The convergent validity of two burnout instruments}}, journal={European Journal of Psychological Assessment}, year={2003}, volume={19}, number={1}, pages={12--23}, doi={10.1027//1015-5759.19.1.12}}@article{demerouti2010burnout, author={Demerouti, Evangelia and Mostert, Karina and Bakker, Arnold B.}, title={{Burnout and work engagement: A thorough investigation of the independency of both constructs}}, journal={Journal of Occupational Health Psychology}, year={2010}, volume={15}, number={3}, pages={209--222}, doi={10.1037/a0019408}}@article{halbesleben2005construct, author={Halbesleben, Jonathon R. B. and Demerouti, Evangelia}, title={{The construct validity of an alternative measure of burnout: Investigating the English translation of the Oldenburg Burnout Inventory}}, journal={Work \& Stress}, year={2005}, volume={19}, number={3}, pages={208--220}, doi={10.1080/02678370500340728}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{peterson2008burnout, author={Peterson, Ulla and Demerouti, Evangelia and Bergström, Gunnar and Samuelsson, Mats and Åsberg, Marie and Nygren, Åke}, title={{Burnout and physical and mental health among Swedish healthcare workers}}, journal={Journal of Advanced Nursing}, year={2008}, volume={62}, number={1}, pages={84--95}, doi={10.1111/j.1365-2648.2007.04580.x}}@article{reis2015measuring, author={Reis, Dorota and Xanthopoulou, Despoina and Tsaousis, Ioannis}, title={{Measuring job and academic burnout with the Oldenburg Burnout Inventory (OLBI): Factorial invariance across samples and countries}}, journal={Burnout Research}, year={2015}, volume={2}, number={1}, pages={8--18}, doi={10.1016/j.burn.2014.11.001}}@article{yacoubian2023survey, author={Yacoubian, Aline and Demerouti, Evangelia and Degheili, Jad A. and El Hajj, Albert}, title={{A survey-based study about burnout among postgraduate medical trainees: Implications for leaders in healthcare management}}, journal={Frontiers in Public Health}, year={2023}, volume={11}, eid={1209191}, doi={10.3389/fpubh.2023.1209191}}