Czym jest UWES-9
UWES (Utrecht Work Engagement Scale) mierzy zaangażowanie w pracę. Autorzy rozumieją je jako pozytywny stan spełnienia w pracy, na który składają się trzy wymiary: wigor, oddanie i pochłonięcie pracą. Schaufeli, Bakker i Salanova (2006) skrócili 17-pozycyjną wersję skali do 9 pozycji na danych z 10 krajów (N = 14 521). Trzy wyniki skróconej wersji miały dobrą spójność wewnętrzną i stabilność w czasie. W tym samym badaniu autorzy opisali zaangażowanie jako pozytywny biegun przeciwny wypaleniu.
UWES-9 to częsty wybór w pracach z psychologii pracy, zarządzania i pielęgniarstwa: w badaniach pielęgniarek, nauczycieli, pracowników biur i firm usługowych. Warsztat analityczny tych kierunków opisują wpisy statystyka dla psychologa, statystyka w pracy z zarządzania i ekonomii oraz statystyka w pracy z pielęgniarstwa. Jeśli badasz wypalenie, zobacz też wpisy o CBI i OLBI. UWES mierzy inne zjawisko i ma inny sposób liczenia.
Budowa: 9 pozycji, trzy podskale, skala 0–6
Każda podskala ma trzy pozycje (Tatha i in., 2024). Odpowiedzi dotyczą częstości odczuć związanych z pracą na siedmiostopniowej skali od 0 (nigdy) do 6 (zawsze, codziennie). Taką skalę opisują publikacje współtworzone przez autora narzędzia (Carmona-Halty i in., 2019; Tatha i in., 2024). Treści pozycji nie przytaczamy. Formularz pobierzesz ze strony autora, także w wersji polskiej.
| Wynik | Liczba pozycji | Sposób liczenia | Zakres |
|---|---|---|---|
| Wigor (vigor) | 3 | średnia pozycji | 0–6 |
| Oddanie (dedication) | 3 | średnia pozycji | 0–6 |
| Pochłonięcie (absorption) | 3 | średnia pozycji | 0–6 |
| Wynik ogólny | 9 | średnia wszystkich pozycji | 0–6 |
Pozycje trzech podskal są w formularzu wymieszane. Przypisanie pozycji do podskal weź z oficjalnego formularza. Nie przepisuj go z cudzej pracy, bo numery w wersji 9-pozycyjnej różnią się od numerów w UWES-17. W publikacjach autora, które sprawdziliśmy, nie ma pozycji odwróconych. Wszystkie pozycje opisują zaangażowanie wprost, a wyższy wynik oznacza większe zaangażowanie.
Istnieją też inne wersje: pełna UWES-17, wersja dla studentów (UWES-9S, Carmona-Halty i in., 2019) i ultrakrótka UWES-3. Według Schaufelego i in. (2019) UWES-3 dzieli z wersją 9-pozycyjną 86–92% wariancji. Autorzy proponują ją jako alternatywę np. w krajowych i międzynarodowych sondażach warunków pracy. Tatha i in. (2024) pominęli UWES-3, bo nie jest zalecana do badań akademickich. W pracy dyplomowej zostań więc przy UWES-9 albo UWES-17.
Licencja i warunki użycia
Według strony autora użycie skal jest bezpłatne wyłącznie do celów akademickich. Jako przykłady strona podaje prace doktorskie i artykuły naukowe. Do wszystkich innych celów potrzebna jest umowa (Schaufeli, b.d.). Pobierając formularz, zgadzasz się też na przekazanie autorom części danych. Chodzi o surowe odpowiedzi na pozycje w oryginalnym formacie i kolejności, wiek, płeć i zawód, jeśli je zbierasz, oraz krótki opis próby (liczebność, zawody, język, kraj). Autorzy wykorzystują te dane do dalszej walidacji UWES, m.in. do aktualizacji norm i porównań międzynarodowych (Schaufeli, b.d.).
Ten warunek ma skutki etyczne. Jeśli zamierzasz przekazać dane, napisz w informacji dla uczestników, że zanonimizowane odpowiedzi trafią do autorów narzędzia. Na stronie autora są formularze w wielu językach, w tym polskie wersje UWES-17 i UWES-9. Podręczniki testu są dostępne w kilku językach, ale nie po polsku. Polskich norm nie podajemy.
Jak policzyć wynik krok po kroku
Krok 1. Sprawdź kodowanie 0–6
Formularze online często zapisują odpowiedzi jako 1–7. Wtedy każda średnia jest zawyżona o 1 punkt. Sprawdź, czy w danych są tylko wartości 0–6.
Krok 2. Policz średnie podskal
Wynik podskali to średnia jej pozycji, a nie suma (Tatha i in., 2024). Dzięki temu podskale i wynik ogólny mają tę samą skalę 0–6, co ułatwia porównanie z publikacjami. Wybór między średnią a sumą opisuje hasło wynik skali: średnia czy suma, a przekodowanie w różnych programach poradnik jak policzyć wynik kwestionariusza.
Krok 3. Policz wynik ogólny
Wynik ogólny to średnia wszystkich 9 pozycji, również w zakresie 0–6 (Tatha i in., 2024). Kiedy wystarczy jeden wynik, a kiedy trzeba trzech, omawiamy w części o interpretacji. Ogólne zasady łączenia pozycji opisuje hasło podskala i wynik ogólny.
Krok 4. Ustal regułę dla braków
W źródłach, które sprawdziliśmy, nie znaleźliśmy reguły dla brakujących odpowiedzi. W przykładzie liczymy wynik podskali, gdy osoba odpowiedziała na co najmniej 2 z 3 pozycji. Wynik ogólny liczymy, gdy wszystkie trzy podskale mają wynik. To decyzja badacza, którą trzeba opisać w pracy. Podręcznik testu ze strony autora może zawierać własne zalecenia, więc sprawdź go przed analizą.
Interpretacja: trzy podskale czy jeden wynik?
Wyższy wynik oznacza silniejsze zaangażowanie. Najczęstsze pytanie w pracach brzmi, czy analizować trzy podskale, czy jeden wynik. Kulikowski (2017) przejrzał 21 badań struktury czynnikowej UWES-9 i UWES-17. W 6 badaniach lepszy był model trzech czynników, w 6 model jednego czynnika, a w 8 oba uznano za równoważne. Tatha i in. (2024), wśród których jest autor skali, uznali, że zaangażowanie najlepiej mierzy wynik ogólny, choć wymiary można też oceniać osobno. Podskale korelowały tam bardzo silnie. Praktyczna rada: gdy hipoteza dotyczy zaangażowania ogólnie, użyj wyniku ogólnego. Gdy dotyczy konkretnego wymiaru, np. wigoru, raportuj podskale i pamiętaj, że silnie się pokrywają.
Średnia 0–6 ma prostą interpretację: wynik 4 oznacza odpowiedzi przeciętnie w okolicy czwartego stopnia skali częstości. Publikacje, które sprawdziliśmy, nie podają punktów odcięcia. Carmona-Halty i in. (2019) wymieniają ustalenie progów wysokiego i niskiego zaangażowania jako zadanie na przyszłość. Podręcznik testu może zawierać dane normatywne z innych krajów, ale to nie są normy dla polskich pielęgniarek czy menedżerów. Jeśli z nich korzystasz, zacytuj podręcznik i napisz, z jakiej populacji pochodzą.
Przykład: 320 pielęgniarek i pielęgniarzy
Dane są symulowane i możesz je pobrać jako plik CSV. Kolumny w1–w3, o1–o3 i p1–p3 są już nazwane według podskal. Plik zawiera też ocenę wsparcia przełożonego (średnia 1–5). Sześć osób pominęło jedną pozycję, a dwie osoby dwie pozycje pochłonięcia, więc nie mają wyniku tej podskali ani wyniku ogólnego.
| Wynik | n | M (SD) | α [95% CI] | ω |
|---|---|---|---|---|
| Wigor | 320 | 3.96 (1.13) | .86 [.83, .88] | .86 |
| Oddanie | 320 | 4.13 (1.15) | .87 [.84, .89] | .87 |
| Pochłonięcie | 318 | 3.34 (1.15) | .81 [.78, .85] | .82 |
| Wynik ogólny | 318 | 3.81 (1.01) | .91 [.90, .93] | .91 |
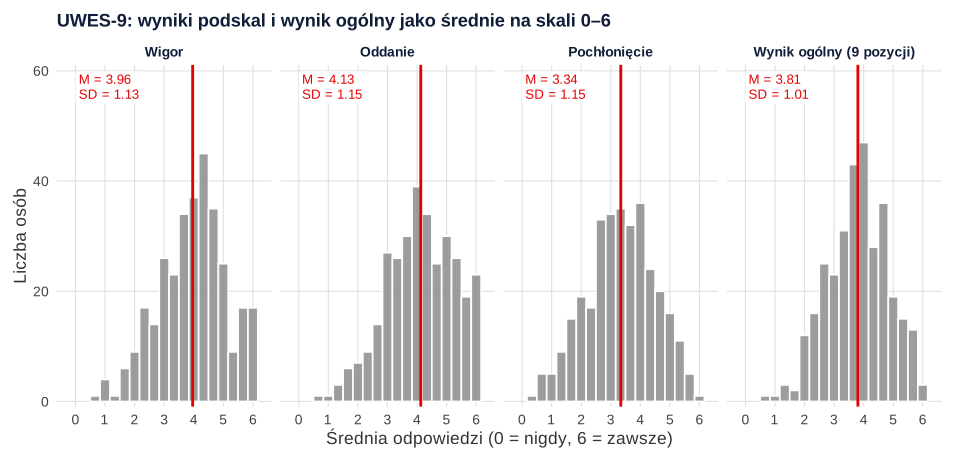
Rozkłady są lekko lewostronnie skośne (skośność od −0.30 do −0.16), a pochłonięcie ma najniższą średnią. Gdyby zamiast średnich policzyć sumy, wigor miałby średnią 11.93 (zakres 0–18), a wynik ogólny 34.42 (0–54). Takich liczb nie da się porównać z publikacjami, które podają średnie 0–6.
Rzetelność i struktura
Alfy i omegi przekroczyły .80 dla każdej podskali i wynosiły .91 dla wyniku ogólnego (tabela). Alfa zakłada równe ładunki pozycji (McNeish, 2018), więc obok niej podaj omegę McDonalda. Omegę z ładunków policzysz też w kalkulatorze alfy i omegi. W 312 osobach z kompletem wyników korelacje Pearsona podskal wyniosły r = .76 (wigor–oddanie), .60 (wigor–pochłonięcie) i .63 (oddanie–pochłonięcie).
Porównaliśmy dwa modele CFA z estymatorem MLR. Model jednoczynnikowy był słabo dopasowany: χ²(27) = 173.50, CFI = .912, RMSEA = .131, SRMR = .062. Model trzech skorelowanych czynników pasował dobrze: χ²(24) = 19.30, CFI = 1.000, RMSEA = .000, SRMR = .020. Różnica była istotna, Δχ²(3) = 148.76, p < .001, a AIC niższy dla trzech czynników (7786 wobec 7933). Korelacje czynników wyniosły jednak .73–.88, a wigor i oddanie korelowały .88. W tych danych podskale są więc rozróżnialne, ale mocno się pokrywają. To ten sam obraz, który opisują Kulikowski (2017) i Tatha i in. (2024). Pozycje 0–6 możesz też potraktować jako porządkowe. Opisuje to wpis kategorialna CFA w lavaan, a model łączący czynnik ogólny z wymiarami wpis model bifactor i ESEM.
Zaangażowanie a wsparcie przełożonego
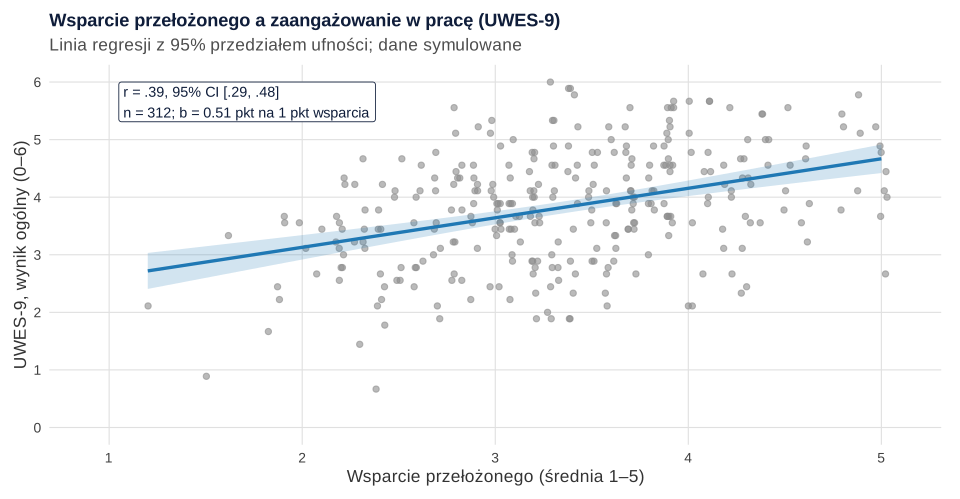
Wynik ogólny korelował ze wsparciem przełożonego r = .39, 95% CI [.29, .48], p < .001. W regresji liniowej wzrost wsparcia o 1 punkt wiązał się z wyższym zaangażowaniem o 0.51 punktu, 95% CI [0.38, 0.65], R² = .15. Dla podskal korelacje wyniosły od .29 (wigor) do .39 (oddanie). Oba pomiary pochodzą z jednej ankiety samoopisowej, więc część związku może wynikać ze wspólnej wariancji metody.
Jak opisać UWES-9 w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o rzetelności we wzorze raportowania alfy Cronbacha.
UWES-9 w R: średnie podskal, rzetelność i struktura
Kod odtwarza liczby z tekstu i zapisuje plik CSV z danymi. Funkcja srednia() liczy wynik podskali przy minimalnej liczbie odpowiedzi, którą ustalasz sam(a). Alfę liczy pakiet psych, a omegi i modele CFA – lavaan.
Wynik UWES-9 krok po kroku
R
# B251 – UWES-9: wigor, oddanie i pochłonięcie pracą, wynik ogólny, rzetelność i struktura (dane symulowane, set.seed(2511)).
# 320 pielęgniarek i pielęgniarzy; odpowiedzi 0–6 (0 = nigdy, 6 = zawsze). Treści pozycji nie podajemy.
# Pozycje nazwano według podskal: w1–w3 (wigor), o1–o3 (oddanie), p1–p3 (pochłonięcie);
# w prawdziwych danych przypisz pozycje do podskal według oficjalnego formularza ze strony autora.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(2511)
n <- 320
wsparcie <- round(pmin(pmax(rnorm(n, 3.4, 0.8), 1), 5), 1)        # wsparcie przełożonego, średnia 1–5
E <- 0.40 * as.numeric(scale(wsparcie)) + rnorm(n, 0, 0.92)        # ogólne zaangażowanie
spec <- cbind(W = rnorm(n), O = rnorm(n), P = rnorm(n))
lad_g <- c(.78, .80, .74,  .84, .82, .76,  .66, .70, .62)
lad_s <- c(.30, .32, .28,  .30, .34, .26,  .45, .42, .40)
pod <- rep(c("W", "O", "P"), each = 3)
prz <- c(0.35, 0.10, 0.25,  0.45, 0.55, 0.30,  0.05, -0.10, -0.35)  # różna „trudność” pozycji
odp <- sapply(1:9, function(j) {
  y <- lad_g[j] * E + lad_s[j] * spec[, pod[j]] + rnorm(n, 0, sqrt(1 - lad_g[j]^2 - lad_s[j]^2)) + prz[j]
  findInterval(y, c(-2.3, -1.5, -0.8, -0.1, 0.7, 1.5)) })           # 0–6
colnames(odp) <- c(paste0("w", 1:3), paste0("o", 1:3), paste0("p", 1:3))
dane <- data.frame(id = 1:n, wsparcie, odp)
dane$w2[c(15, 88, 241)] <- NA; dane$p3[c(60, 199)] <- NA; dane$o1[c(132)] <- NA   # pojedyncze braki
dane[c(77, 280), c("p1", "p2")] <- NA                                               # dwa braki w jednej podskali
write.csv(dane, "../uwes-9-dane-przyklad.csv", row.names = FALSE, na = "")
poz <- list(wigor = paste0("w", 1:3), oddanie = paste0("o", 1:3), pochloniecie = paste0("p", 1:3))

# Krok 1. Kontrola kodowania: tylko 0–6 albo brak
all(as.matrix(dane[, unlist(poz)]) %in% c(0:6, NA))
sapply(poz, function(p) table(factor(rowSums(is.na(dane[, p])), levels = 0:2)))

# Krok 2. Wynik podskali = średnia pozycji (0–6); tu: przy co najmniej 2 z 3 odpowiedzi (decyzja badacza)
srednia <- function(p, min_odp) ifelse(rowSums(!is.na(dane[, p])) >= min_odp, rowMeans(dane[, p], na.rm = TRUE), NA)
for (s in names(poz)) dane[[s]] <- srednia(poz[[s]], 2)
# wynik ogólny = średnia 9 pozycji, gdy wszystkie trzy podskale mają wynik
dane$uwes9 <- ifelse(complete.cases(dane[, names(poz)]), rowMeans(dane[, unlist(poz)], na.rm = TRUE), NA)
sk <- c(names(poz), "uwes9")
colSums(is.na(dane[, sk]))
round(t(sapply(dane[, sk], function(v) { v <- na.omit(v)
  c(n = length(v), M = mean(v), SD = sd(v), Me = median(v), min = min(v), max = max(v), skosnosc = skew(v)) })), 2)
# Typowy błąd: suma zamiast średniej – inna skala (0–18 i 0–54), nieporównywalna z publikacjami
round(c(suma_wigor_M = mean(rowSums(dane[, poz$wigor]), na.rm = TRUE), suma_9_M = mean(rowSums(dane[, unlist(poz)]), na.rm = TRUE)), 2)

# Krok 3. Korelacje podskal (Pearson)
pel <- na.omit(dane[, c("wsparcie", unlist(poz), sk)])
nrow(pel)
round(cor(pel[, names(poz)]), 2)

# Krok 4. Rzetelność: alfa (95% CI Feldta) i omega z modelu jednoczynnikowego dla każdej podskali i całej skali
omega1 <- function(p) { f <- cfa(paste("F =~", paste(p, collapse = " + ")), data = pel, std.lv = TRUE)
  s <- standardizedSolution(f); l <- s$est.std[s$op == "=~"]; e <- s$est.std[s$op == "~~" & s$lhs %in% p & s$lhs == s$rhs]
  sum(l)^2 / (sum(l)^2 + sum(e)) }
round(t(sapply(c(poz, list(uwes9 = unlist(poz))), function(p) { a <- psych::alpha(pel[, p], warnings = FALSE)
  c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]], omega = omega1(p)) })), 2)

# Krok 5. Struktura: jeden czynnik a trzy skorelowane czynniki (CFA, MLR)
m1 <- paste("ZAA =~", paste(unlist(poz), collapse = " + "))
m3 <- "WIG =~ w1 + w2 + w3\nODD =~ o1 + o2 + o3\nPOCH =~ p1 + p2 + p3"
f1 <- cfa(m1, data = pel, estimator = "MLR", std.lv = TRUE)
f3 <- cfa(m3, data = pel, estimator = "MLR", std.lv = TRUE)
ind <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr", "aic")
round(rbind(jeden_czynnik = fitMeasures(f1, ind), trzy_czynniki = fitMeasures(f3, ind)), 3)
lavTestLRT(f1, f3)
round(lavInspect(f3, "cor.lv"), 2)

# Krok 6. Zaangażowanie a wsparcie przełożonego: korelacja Pearsona z 95% CI dla wyniku ogólnego i podskal
round(t(sapply(sk, function(s) { ct <- cor.test(pel$wsparcie, pel[[s]])
  c(r = unname(ct$estimate), lo = ct$conf.int[1], hi = ct$conf.int[2]) })), 2)
format.pval(sapply(sk, function(s) cor.test(pel$wsparcie, pel[[s]])$p.value), digits = 3)
reg <- lm(uwes9 ~ wsparcie, pel)
round(c(b = coef(reg)[[2]], confint(reg)[2, ], R2 = summary(reg)$r.squared), 2)
Wynik w R
[1] TRUE
  wigor oddanie pochloniecie
0   317     319          316
1     3       1            2
2     0       0            2
       wigor      oddanie pochloniecie        uwes9
           0            0            2            2
               n    M   SD   Me  min max skosnosc
wigor        320 3.96 1.13 4.00 0.67   6    -0.30
oddanie      320 4.13 1.15 4.00 0.67   6    -0.30
pochloniecie 318 3.34 1.15 3.33 0.33   6    -0.16
uwes9        318 3.81 1.01 3.89 0.67   6    -0.20
suma_wigor_M     suma_9_M
       11.93        34.42
[1] 312
             wigor oddanie pochloniecie
wigor         1.00    0.76         0.60
oddanie       0.76    1.00         0.63
pochloniecie  0.60    0.63         1.00
             alfa   lo   hi omega
wigor        0.86 0.83 0.88  0.86
oddanie      0.87 0.84 0.89  0.87
pochloniecie 0.81 0.78 0.85  0.82
uwes9        0.91 0.90 0.93  0.91
              chisq.scaled df.scaled cfi.robust rmsea.robust  srmr      aic
jeden_czynnik      173.503        27      0.912        0.131 0.062 7932.959
trzy_czynniki       19.303        24      1.000        0.000 0.020 7785.982

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the robust test that
   should be reported per model. A robust difference test is a function of two standard (not
   robust) statistics.

   Df  AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
f3 24 7786 7864.6  19.05
f1 27 7933 8000.3 172.03     148.76 0.40018       3  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
      WIG  ODD POCH
WIG  1.00
ODD  0.88 1.00
POCH 0.73 0.74 1.00
                r   lo   hi
wigor        0.29 0.19 0.39
oddanie      0.39 0.29 0.48
pochloniecie 0.34 0.23 0.43
uwes9        0.39 0.29 0.48
[1] "1.37e-07" "9.66e-13" "1.16e-09" "1.64e-12"
     b  2.5 % 97.5 %     R2
  0.51   0.38   0.65   0.15
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy UWES-9
- Sumy zamiast średnich. Wynik 0–54 nie da się porównać z publikacjami, które podają średnie 0–6.
- Kodowanie 1–7. Każda średnia rośnie o 1 punkt. Przed liczeniem odejmij 1 od każdej odpowiedzi.
- Numery pozycji z UWES-17. Przypisanie do podskal w wersji 9-pozycyjnej sprawdź w jej własnym formularzu.
- Trzy podskale w jednym modelu regresji. Przy korelacjach rzędu .6–.9 współczynniki stają się niestabilne. Najpierw zdecyduj, czy hipoteza dotyczy wyniku ogólnego, czy konkretnego wymiaru.
- Kategorie „wysokie” i „niskie” bez źródła. Publikacje, które sprawdziliśmy, nie podają progów. Dane normatywne z podręcznika nie są polskimi normami.
- Pominięcie warunków użycia. Bezpłatne użycie obejmuje cele akademickie i wiąże się z przekazaniem autorom części danych. Uwzględnij to w zgodzie uczestników.
Całą ścieżkę analizy narzędzia porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie UWES-9 w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy wynik UWES-9 to suma czy średnia odpowiedzi?
Średnia. Wynik każdej podskali to średnia jej trzech pozycji, a wynik ogólny to średnia dziewięciu pozycji, zawsze w zakresie 0–6. Sumy (0–18 i 0–54) są nieporównywalne z publikacjami, w których podaje się średnie, więc jeśli je policzysz, podziel przez liczbę pozycji.
Czy w UWES-9 analizować trzy podskale, czy wynik ogólny?
Zależy od hipotezy. Przegląd Kulikowskiego (2017) pokazał, że w części badań lepszy jest model trzech czynników, a w części jednego. Podskale korelują bardzo silnie. Gdy hipoteza dotyczy zaangażowania ogólnie, użyj wyniku ogólnego. Gdy dotyczy np. wigoru, raportuj podskale i nie wprowadzaj wszystkich trzech naraz do jednej regresji.
Czy na użycie UWES-9 w pracy magisterskiej potrzebna jest zgoda autora?
Strona autora podaje, że użycie do celów akademickich jest bezpłatne. Pobierając skalę, akceptujesz warunki, w tym przekazanie autorom surowych odpowiedzi i podstawowych danych o próbie. Do innych celów potrzebna jest umowa. Uwzględnij przekazanie danych w informacji dla uczestników badania.
Od jakiego wyniku zaangażowanie w UWES-9 jest wysokie?
Publikacje, które sprawdziliśmy, nie podają punktów odcięcia, a autorzy wersji studenckiej wskazują progi jako zadanie na przyszłość. Analizuj wynik ciągły 0–6. Jeśli korzystasz z danych normatywnych z podręcznika testu, zacytuj go i zaznacz, że to nie są normy polskie.
Czym różni się UWES-9 od UWES-17 i UWES-3?
UWES-17 to pełna wersja z 17 pozycjami, UWES-9 to jej skrót z trzema pozycjami na podskalę, a UWES-3 ma tylko trzy pozycje. UWES-3 dzieli z UWES-9 większość wariancji, ale jest przeznaczona głównie do dużych sondaży. W pracy dyplomowej wybierz UWES-9 lub UWES-17 i nie mieszaj numeracji pozycji między wersjami.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →Badasz zaangażowanie w pracę i chcesz dobrze policzyć UWES-9?
Sprawdzimy kodowanie i przypisanie pozycji, średnie podskal, obsługę braków i strukturę skali oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Carmona-Halty, M. A., Schaufeli, W. B., & Salanova, M. (2019). The Utrecht Work Engagement Scale for Students (UWES–9S): Factorial validity, reliability, and measurement invariance in a Chilean sample of undergraduate university students. Frontiers in Psychology, 10, Article 1017. https://doi.org/10.3389/fpsyg.2019.01017 ● Otwarty dostęp
- Kulikowski, K. (2017). Do we all agree on how to measure work engagement? Factorial validity of Utrecht Work Engagement Scale as a standard measurement tool – A literature review. International Journal of Occupational Medicine and Environmental Health, 30(2), 161–175. https://doi.org/10.13075/ijomeh.1896.00947 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Schaufeli, W. B. (b.d.). Tests and conditions of use – Utrecht Work Engagement Scale (UWES). Wilmar Schaufeli (strona autora). Pobrano 1 listopada 2026 z https://www.wilmarschaufeli.nl/downloads/ ● Otwarty dostęp
- Schaufeli, W. B., Bakker, A. B., & Salanova, M. (2006). The measurement of work engagement with a short questionnaire: A cross-national study. Educational and Psychological Measurement, 66(4), 701–716. https://doi.org/10.1177/0013164405282471
- Schaufeli, W. B., Shimazu, A., Hakanen, J., Salanova, M., & De Witte, H. (2019). An ultra-short measure for work engagement: The UWES-3 validation across five countries. European Journal of Psychological Assessment, 35(4), 577–591. https://doi.org/10.1027/1015-5759/a000430 ● Otwarty dostęp: pełny tekst
- Tatha, O., Shimazu, A., Watanabe, K., Kawakami, N., & Schaufeli, W. B. (2024). Measuring work engagement in Thailand: Development and validation testing of the Utrecht Work Engagement Scale-Thai version (UWES-TH). Industrial Health, 62(3), Article 2023-0017. https://doi.org/10.2486/indhealth.2023-0017 ● Otwarty dostęp
Cytowania BibTeX
@article{carmonahalty2019utrecht, author={Carmona-Halty, Marcos A. and Schaufeli, Wilmar B. and Salanova, Marisa}, title={{The Utrecht Work Engagement Scale for Students (UWES–9S): Factorial validity, reliability, and measurement invariance in a Chilean sample of undergraduate university students}}, journal={Frontiers in Psychology}, year={2019}, volume={10}, eid={1017}, doi={10.3389/fpsyg.2019.01017}}@article{kulikowski2017do, author={Kulikowski, Konrad}, title={{Do we all agree on how to measure work engagement? Factorial validity of Utrecht Work Engagement Scale as a standard measurement tool – A literature review}}, journal={International Journal of Occupational Medicine and Environmental Health}, year={2017}, volume={30}, number={2}, pages={161--175}, doi={10.13075/ijomeh.1896.00947}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@misc{schaufeliuwesnd, author={Schaufeli, Wilmar B.}, title={{Tests and conditions of use – Utrecht Work Engagement Scale (UWES)}}, publisher={Wilmar Schaufeli (strona autora)}, url={https://www.wilmarschaufeli.nl/downloads/}}@article{schaufeli2006measurement, author={Schaufeli, Wilmar B. and Bakker, Arnold B. and Salanova, Marisa}, title={{The measurement of work engagement with a short questionnaire: A cross-national study}}, journal={Educational and Psychological Measurement}, year={2006}, volume={66}, number={4}, pages={701--716}, doi={10.1177/0013164405282471}}@article{schaufeli2019ultra, author={Schaufeli, Wilmar B. and Shimazu, Akihito and Hakanen, Jari and Salanova, Marisa and De Witte, Hans}, title={{An ultra-short measure for work engagement: The UWES-3 validation across five countries}}, journal={European Journal of Psychological Assessment}, year={2019}, volume={35}, number={4}, pages={577--591}, doi={10.1027/1015-5759/a000430}}@article{tatha2024measuring, author={Tatha, Oraphan and Shimazu, Akihito and Watanabe, Kazuhiro and Kawakami, Norito and Schaufeli, Wilmar B.}, title={{Measuring work engagement in Thailand: Development and validation testing of the Utrecht Work Engagement Scale-Thai version (UWES-TH)}}, journal={Industrial Health}, year={2024}, volume={62}, number={3}, pages={182--194}, eid={2023-0017}, doi={10.2486/indhealth.2023-0017}}