Sześć typowych projektów w pracy z logistyki
Praca dyplomowa z logistyki rzadko opiera się na jednej ankiecie. Zwykle student ma dostęp do danych z systemu magazynowego albo transportowego: czasów realizacji zamówień, liczby błędów kompletacji, terminów dostaw od dostawców, wielkości sprzedaży w kolejnych miesiącach. Do tego dochodzi ankieta wśród pracowników lub klientów. Każdy z tych typów danych ma swoją pułapkę. Czasy dostaw są prawoskośne, więc sama średnia ukrywa to, co dla klienta najważniejsze – długi ogon spóźnień. Błędy kompletacji to zliczenia, które trzeba odnieść do liczby skompletowanych linii. Dane „przed i po” zmianie procesu tworzą szereg czasowy z trendem i sezonem. A dostawy od jednego dostawcy nie są niezależnymi obserwacjami. Tabela porządkuje sześć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Jednostka analizy i dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Czas realizacji i dostawy | Który przewoźnik dostarcza szybciej i pewniej? | przesyłka; godziny od nadania do doręczenia | mediana i percentyle z bootstrapem, test Manna–Whitneya, odsetek w terminie | różnica median i P90/P95 z 95% CI, różnica odsetków |
| 2. Błędy kompletacji | Czy w strefie lub na zmianie błędów jest więcej? | tydzień, zmiana lub strefa; liczba błędów i liczba linii | regresja Poissona lub ujemna dwumianowa z offsetem, karta kontrolna u | iloraz częstości (IRR), błędy na 1000 linii |
| 3. Zmiana procesu przed–po | Czy nowa procedura zmniejszyła liczbę błędów? | tydzień w jednym magazynie; 52 tygodnie przed, 26 po | przerwany szereg czasowy: regresja segmentowa z offsetem, sezonem i kontrolą autokorelacji | IRR zmiany poziomu z 95% CI, częstość przewidywana a kontrfaktyczna |
| 4. Dostawcy i przewoźnicy | Czy dostawcy zagraniczni spóźniają się bardziej niż krajowi? | dostawa zagnieżdżona w dostawcy | model mieszany z losowym wyrazem wolnym dostawcy albo analiza średnich dostawców | różnica średnich z 95% CI, ICC, efekt schematu |
| 5. Ankieta pracowników lub klientów | Czy zaufanie do dostawcy wiąże się z oceną współpracy? | respondent; skala Likerta | rzetelność skali, korelacja, regresja | r lub b z 95% CI |
| 6. Prognoza popytu | Która prosta metoda lepiej prognozuje sprzedaż? | miesiąc; szereg sprzedaży | porównanie metod na okresie testowym | MAE, MAPE, MASE |
Wszystkie dane w przykładach są symulowane i nie opisują żadnej rzeczywistej firmy. Pełny kod znajdziesz w sekcji Przykład w R, a tygodniowe dane z projektów 2 i 3 możesz pobrać jako plik CSV (78 tygodni). Jeśli nie wiesz, który test pasuje do Twojej hipotezy, zacznij od kreatora doboru testu, a cały proces od pytania do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej. Ankiety wśród pracowników i modele ekonometryczne na danych wtórnych omawia szerzej wpis o statystyce w pracy z zarządzania i ekonomii – tutaj skupiamy się na tym, co jest specyficzne dla magazynu, transportu i zaopatrzenia.
Zanim zaczniesz: dane z firmy
Jednostka analizy decyduje o wszystkim. W logistyce ta sama baza może zawierać linie zamówień, zamówienia, przesyłki, dostawy, dni, tygodnie, dostawców i magazyny. Zanim policzysz cokolwiek, zapisz, co jest jednym wierszem i co jest jednostką, o której chcesz wnioskować. Jeśli pytasz o przewoźników, a masz trzech przewoźników i 2000 przesyłek, to masz trzy jednostki porównania, a nie 2000. Jeśli pytasz o zmianę procesu w jednym magazynie, to masz jeden magazyn obserwowany przez wiele tygodni – i to jest szereg czasowy, a nie dwie niezależne próby.
Zgoda firmy i tajemnica handlowa. Dane z systemu magazynowego należą do firmy. Zanim zaczniesz je przetwarzać, uzyskaj zgodę na piśmie i ustal, co wolno pokazać w pracy. Praktyczne wskazówki, jak napisać taką prośbę, znajdziesz we wpisie o zgodzie placówki na badanie. W pracy zwykle nie podaje się nazw klientów, dostawców, cen ani wolumenów, które pozwalają odtworzyć wyniki handlowe. Często wystarczy pokazać wskaźniki względne (błędy na 1000 linii, odsetek dostaw w terminie) i zakodować dostawców jako D01, D02 itd. Dane pracowników, np. identyfikatory kompletujących, przed analizą zastąp kodami – zasady opisuje hasło anonimizacja i pseudonimizacja danych. Jeśli badasz firmę, w której pracujesz, przeczytaj też wpis o badaniu we własnym miejscu pracy: wiesz, kto popełnia błędy, a współpracownicy wiedzą, że to Ty zbierasz dane.
Definicje z systemu to też pomiar. „Dostawa w terminie” może oznaczać termin potwierdzony przez dostawcę, termin z zamówienia albo okno godzinowe na rampie. „Błąd kompletacji” może oznaczać każdą reklamację klienta albo tylko błędy wykryte na kontroli wyjściowej. Zmiana definicji w trakcie badanego okresu (np. nowa wersja systemu) potrafi stworzyć „efekt”, którego nie było. Opisz definicje w rozdziale metodologicznym i sprawdź, czy nie zmieniały się w czasie.
Projekt 1. Czas realizacji zamówienia i czas dostawy
Czas od złożenia zamówienia do wysyłki, czas od nadania do doręczenia, czas rozładunku na rampie – to zmienne ciągłe, ale prawie nigdy symetryczne. Większość przesyłek dociera w typowym czasie, a niewielka część spóźnia się bardzo: rozkład jest prawoskośny. Dla klienta ten ogon często jest ważniejszy niż średnia, bo to on decyduje o zapasie bezpieczeństwa i o reklamacjach.
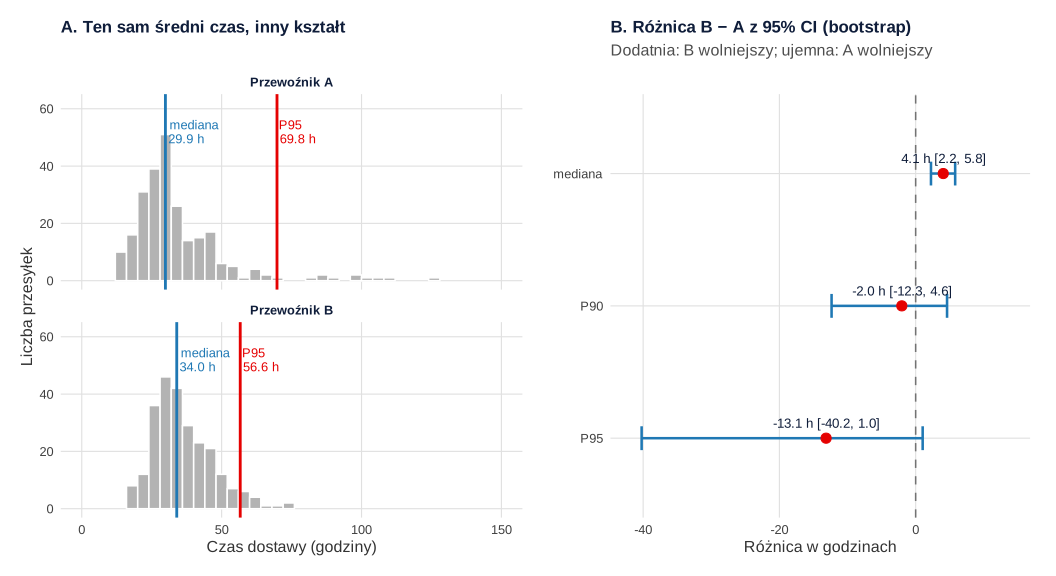
Przykład: porównujemy dwóch przewoźników, po 250 przesyłek każdego (dane fikcyjne). Średnie są prawie równe: 35.93 godziny (SD = 22.82) u przewoźnika A i 36.19 godziny (SD = 10.62) u przewoźnika B. Test Welcha nie pokazuje różnicy, t(351.98) = −0.17, p = .868. Gdyby na tym skończyć, wniosek brzmiałby: przewoźnicy są tacy sami. Rozkłady są jednak zupełnie inne. Mediana wynosi 29.90 godziny u A i 33.95 godziny u B, a 95. percentyl – 69.78 i 56.64 godziny. Skośność rozkładu u A to 4.32, a u B 0.88. Przewoźnik A dostarcza typową przesyłkę szybciej, ale część jego przesyłek spóźnia się bardzo.
Co porównywać zamiast samej średniej
Najpierw opisz rozkład: medianę, percentyle (P90, P95), odsetek przesyłek w terminie i dopiero potem średnią z odchyleniem standardowym. Porównanie median z przedziałem ufności z bootstrapu pokazało, że przewoźnik B dostarcza typową przesyłkę wolniej o 4.05 godziny, 95% CI [2.25, 5.80]. Różnica w 95. percentylu wyniosła −13.14 godziny na korzyść B, ale z bardzo szerokim przedziałem, 95% CI [−40.22, 1.03]. To ważna lekcja: skrajne percentyle opierają się na nielicznych przesyłkach, więc nawet przy 250 przesyłkach na przewoźnika różnica w ogonie jest oszacowana słabo. Test Manna–Whitneya wskazał różnicę rozkładów, W = 25193, p < .001. Odsetek przesyłek doręczonych do 48 godzin był prawie taki sam: 87.6% u A i 86.8% u B, różnica 0.8 punktu procentowego, 95% CI [−5.5, 7.1], p = .894.
Jeśli chcesz kontrolować inne zmienne, np. odległość, dzień tygodnia czy wagę przesyłki, użyj regresji kwantylowej dla mediany i 90. percentyla – krok po kroku pokazuje ją wpis regresja kwantylowa krok po kroku. Inną drogą jest logarytm czasu: współczynnik regresji na log(czasie) po przekształceniu wykładniczym to iloraz średnich geometrycznych („przesyłki B trwają średnio o x% dłużej”). Logarytm nie usunie jednak problemu długiego ogona, jeśli to właśnie on jest pytaniem badawczym.
Projekt 2. Błędy kompletacji jako zliczenia i odsetki
Kompletacja zamówień to w magazynie czynność szczególnie pracochłonna. De Koster i in. (2007) w przeglądzie literatury o projektowaniu i sterowaniu kompletacją przytaczają opinię, że jest to najbardziej pracochłonna i kosztowna czynność niemal każdego magazynu, a słabe wyniki kompletacji przekładają się na niezadowalającą obsługę i wysokie koszty. Dlatego liczba błędów kompletacji (zła pozycja, zła ilość, brak pozycji) to jeden z najczęstszych wskaźników w pracach z logistyki magazynowej.
Statystycznie to zliczenia. Tydzień, w którym skompletowano 25 tysięcy linii, będzie miał więcej błędów niż tydzień z 15 tysiącami linii, nawet jeśli ludzie pracowali tak samo starannie. Porównuj więc częstości – błędy na 1000 linii – a w modelu regresji wprowadź liczbę linii jako offset. Frome (1983) opisał modele regresji dla częstości zdarzeń oparte na rozkładzie Poissona; ten sam mechanizm w pracy z BHP służy do liczenia wypadków na roboczogodziny (zob. statystyka w pracy z BHP i ergonomii). Gdy dane są bardziej rozproszone, niż przewiduje rozkład Poissona, użyj quasi-Poissona albo regresji ujemnej dwumianowej – porównanie modeli opisuje poradnik regresja dla zliczeń krok po kroku.
Jeśli pytanie dotyczy zamówień („jaki odsetek zamówień zawierał przynajmniej jeden błąd”), wynik jest binarny i analizujesz odsetki. Zwróć uwagę, że odsetek zamówień z błędem zależy od liczby linii w zamówieniu: duże zamówienia mają więcej okazji do pomyłki. Porównując strefy z różnym profilem zamówień, dodaj liczbę linii do modelu albo pracuj na poziomie linii.
Karta kontrolna jako opis procesu
W praktyce magazynowej wskaźnik błędów często śledzi się na karcie kontrolnej. Benneyan i in. (2003) opisują statystyczne sterowanie procesem jako połączenie analizy szeregów czasowych z wykresem, który pozwala odróżnić naturalną zmienność od zmian w procesie bez agregowania pomiarów w czasie. Dla błędów na 1000 linii odpowiednia jest karta u: linia centralna to łączna częstość z okresu bazowego, a granice zależą od liczby linii w danym tygodniu (węższe w tygodniach z dużym wolumenem). W naszym przykładzie linia centralna z 52 tygodni przed zmianą wynosiła 2.76 błędu na 1000 linii, a poza granicami ±3 SE znalazły się 2 tygodnie. Karta to dobre narzędzie opisu stabilności procesu w rozdziale empirycznym, ale nie zastępuje modelu, który oszacuje wielkość zmiany z przedziałem ufności – o tym w projekcie 3.
Projekt 3. Zmiana procesu w jednym magazynie: przerwany szereg czasowy
To najczęstszy i najbardziej zdradliwy typ pracy z logistyki: firma wprowadziła nową procedurę (skanowanie, nowy układ lokalizacji, system WMS, szkolenie), a student ma porównać wyniki „przed” i „po”. Pokusa jest prosta: wziąć wszystkie dni sprzed zmiany, wszystkie dni po zmianie i zrobić test t. Taka analiza ma trzy wady. Po pierwsze, kolejne dni nie są niezależne – tygodnie podobne do siebie dają autokorelację reszt, a test t traktuje każdy dzień jak nową, niezależną informację. Po drugie, wskaźnik mógł spadać już wcześniej (pracownicy nabierają wprawy, firma poprawia inne rzeczy), a test przypisze cały spadek nowej procedurze. Po trzecie, w logistyce prawie zawsze jest sezonowość: szczyt przed świętami, wakacje, inwentaryzacja.
Właściwy plan to przerwany szereg czasowy: wiele pomiarów przed zmianą i po niej, model z trendem i sezonem oraz porównanie z trendem przedłużonym z okresu sprzed zmiany. Wagner i in. (2002) nazywają ten schemat najsilniejszym quasi-eksperymentalnym podejściem do oceny podłużnych efektów interwencji, a regresję segmentową – skuteczną metodą szacowania tych efektów. Lopez Bernal i in. (2016) w samouczku podkreślają, że kształt spodziewanego wpływu (skok, zmiana nachylenia, opóźnienie) trzeba określić przed analizą, i omawiają nadmierną dyspersję, autokorelację oraz korektę sezonowości. Szczegóły kodowania zmiennych czasu i interpretacji współczynników znajdziesz we wpisie regresja segmentowa i przerwany szereg czasowy, a ogólną listę sposobów wzmocnienia planu bez grupy porównawczej – w poradniku badanie bez grupy kontrolnej. Tu pokazujemy, jak to wygląda na danych z magazynu.
Przykład (fikcyjny): magazyn od 53. tygodnia wprowadził obowiązkowe skanowanie każdej linii zamówienia. Mamy 78 tygodni po 5 dni roboczych: 52 tygodnie przed zmianą i 26 po. Łącznie skompletowano 1 522 508 linii i odnotowano 3770 błędów. Liczbę linii symulowano z szczytem pod koniec roku, a częstość błędów – ze spontanicznym spadkiem o 0.4% tygodniowo, sezonowością i prawdziwym skokiem w dół o 22% (IRR = 0.78) w chwili zmiany. Te parametry ustawiliśmy ręcznie, żeby znać prawdziwy efekt.
Krok 1. Naiwne porównanie dni
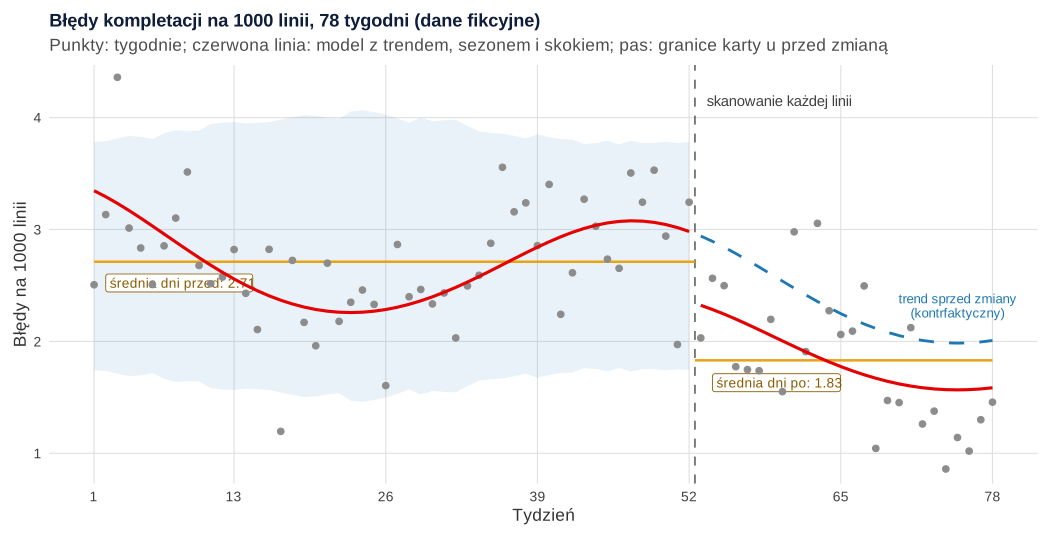
Średnia dzienna częstość wynosiła 2.71 błędu na 1000 linii (SD = 1.06, 260 dni) przed zmianą i 1.83 (SD = 1.01, 130 dni) po zmianie. Test Welcha: t(270.22) = 8.01, p < .001, spadek o 32.5%. Wynik wygląda przekonująco, ale zawyża efekt (prawdziwy spadek to 22%) i ma zbyt małą wartość p, bo liczy 390 dni jako niezależne obserwacje.
Krok 2. Model segmentowy z offsetem
Dane zsumowaliśmy do tygodni: liczba błędów i liczba linii. Model ustalony przed analizą to regresja Poissona z offsetem log(linie / 1000), trendem liniowym, zmienną „po” (0 przed, 1 od 53. tygodnia) i parą funkcji sinus–cosinus dla sezonu rocznego. Spodziewaliśmy się skoku, bo skanowanie działa od pierwszego dnia, więc zmianę nachylenia zostawiliśmy do analizy wrażliwości.
Diagnostyka: współczynnik rozproszenia (suma kwadratów reszt Pearsona przez stopnie swobody) wyniósł 1.92, czyli tygodnie różniły się bardziej, niż przewiduje rozkład Poissona – zwykłe błędy standardowe byłyby za małe. Autokorelacja reszt była niewielka: korelacja z poprzednim tygodniem .02, test Ljunga–Boxa dla 8 opóźnień Q(8) = 5.93, p = .655. Dlatego ten sam model oszacowaliśmy jako quasi-Poisson, który powiększa błędy standardowe o nadmierne rozproszenie: błąd standardowy współczynnika zmiany poziomu wzrósł z 0.086 do 0.119. Gdyby test Ljunga–Boxa wskazał autokorelację, kolejnym krokiem byłyby błędy standardowe odporne na autokorelację (Neweya–Westa) albo model z błędem autoregresyjnym, opisany we wpisie o regresji segmentowej.
Krok 3. Wynik i jego uczciwy opis
Po uwzględnieniu trendu i sezonu częstość błędów po wprowadzeniu skanowania była niższa o około 21% niż przewidywana z trendu sprzed zmiany: IRR = 0.79, 95% CI [0.62, 1.00], p = .051. Trend przed zmianą: IRR = 0.99 na 4 tygodnie, 95% CI [0.97, 1.01]. W ostatnim tygodniu model przewidywał 1.59 błędu na 1000 linii, a przedłużony trend bez zmiany – 2.01. Rysunek 2 pokazuje, skąd bierze się różnica między analizami: część spadku widocznego w naiwnym porównaniu to sezon (26 tygodni po zmianie przypada na okres roku o sezonowo niższej częstości błędów) i spontaniczny trend.
Wynik jest na granicy istotności i tak trzeba go opisać: oszacowany spadek o około 21% przy przedziale od 38% do braku zmiany. Nie pisz o „tendencji do istotności” ani nie zmieniaj modelu, aż p spadnie poniżej .05. W analizie wrażliwości z dodaną zmianą nachylenia skok wyniósł IRR = 0.84, 95% CI [0.65, 1.07], p = .155, a zmiana trendu IRR = 0.96 na 4 tygodnie, 95% CI [0.91, 1.02], p = .208 – kierunek się nie zmienia, ale dwa parametry dzielą między siebie tę samą informację.
Czy 26 tygodni po zmianie wystarcza? W 200 powtórzeniach tego samego scenariusza (prawdziwy spadek o 22%) naiwne porównanie dni dawało średnio iloraz 0.64, czyli „spadek o 36%”. Model segmentowy dawał średnio 0.80 (80% wyników między 0.68 a 0.92), przedział ufności obejmował prawdziwą wartość w 93.0% powtórzeń, ale efekt wykryto (górna granica CI poniżej 1) tylko w 56.5%. Jeden magazyn i pół roku obserwacji to mało, żeby wiarygodnie oszacować 20-procentową zmianę wskaźnika, który i tak waha się z tygodnia na tydzień. Jeśli możesz, wydłuż okres po zmianie, dodaj szereg porównawczy (inny magazyn bez zmiany) albo wskaźnik, na który zmiana nie powinna działać.
Projekt 4. Porównanie dostawców i przewoźników: wiele dostaw od jednego dostawcy
Typowa praca z zaopatrzenia porównuje grupy dostawców: krajowych i zagranicznych, z umową ramową i bez, nowych i stałych. Dane wyglądają jak duża próba – setki dostaw – ale każda dostawa pochodzi od konkretnego dostawcy, a dostawy jednego dostawcy są do siebie podobne: ten sam magazyn nadania, ten sam przewoźnik, ta sama organizacja pracy. Cecha, którą porównujesz (typ dostawcy), jest przypisana do dostawcy, nie do dostawy. To ten sam problem, co przy uczniach w klasach czy pracownikach w brygadach – pseudoreplikacja.
Przykład (fikcyjny): 493 dostawy od 24 dostawców (po 12 krajowych i zagranicznych), średnio 20.5 dostawy na dostawcę. Zmienna zależna to opóźnienie w dniach względem terminu. Średnie opóźnienie wynosiło 0.51 dnia (SD = 1.92) u dostawców krajowych i 0.99 dnia (SD = 2.13) u zagranicznych. Zwykły test t na dostawach: t(491) = −2.59, p = .010 – „dostawcy zagraniczni istotnie częściej się spóźniają”.
Tymczasem współczynnik korelacji wewnątrzklasowej z modelu pustego wyniósł ICC = .33: jedna trzecia zmienności opóźnień to stałe różnice między dostawcami. Killip i in. (2004) wyjaśniają, że podobieństwo obserwacji w grupie zmniejsza efektywną liczebność próby, a zwiększanie liczby grup podnosi moc skuteczniej niż zwiększanie liczby obserwacji w grupie. Przy średnio 20.5 dostawy na dostawcę efekt schematu wynosi 7.53, a efektywna liczebność to około 65 dostaw zamiast 493. Model mieszany z losowym wyrazem wolnym dostawcy dał różnicę 0.55 dnia, 95% CI [−0.46, 1.56], t(21.79) = 1.07, p = .298. Prostsza analiza na 24 średnich dostawców daje ten sam obraz, t(22) = −1.08, p = .292. Wniosek „dostawcy zagraniczni spóźniają się bardziej” nie ma oparcia w tych danych – 24 dostawców to po prostu mało, by go wykazać. Model krok po kroku opisuje wpis model wielopoziomowy krok po kroku.
Projekt 5. Ankieta wśród pracowników lub klientów
Drugą nogą wielu prac jest ankieta: zaufanie do dostawcy, ocena współpracy, satysfakcja klientów z obsługi, postrzegane przyczyny błędów wśród kompletujących. Malhotra i Grover (1998), oceniając badania sondażowe w zarządzaniu produkcją i operacjami, zwracają uwagę na potrzebę konstruktów mierzonych wieloma pozycjami, oceny trafności treściowej i sprawdzenia skal w pilotażu. Dla pracy dyplomowej przekłada się to na prostą zasadę: zamiast jednego pytania „Czy ufasz dostawcy?” użyj kilku pozycji z istniejącej skali i podaj jej rzetelność.
Przykład (fikcyjny): 160 klientów firmy dystrybucyjnej oceniło zaufanie do dostawcy na czterech pozycjach (1–5) i ogólną ocenę współpracy (1–7). Rzetelność skali zaufania: α = .83, wynik skali M = 3.05, SD = 0.91; ocena współpracy M = 4.53, SD = 1.37. Zaufanie korelowało z oceną współpracy, r = .48, 95% CI [.35, .59], p < .001; korelacja Spearmana była praktycznie taka sama (ρ = .48). Czy wolno liczyć średnie z odpowiedzi Likerta – omawia wpis skala Likerta: średnia czy mediana.
Specyficzny dla logistyki problem to ta sama osoba ocenia obie zmienne. Gdy kierownik zakupów ocenia i „zaufanie do dostawcy”, i „wyniki współpracy”, część korelacji może wynikać z samej metody pomiaru. Podsakoff i in. (2003) przeglądają źródła takiego błędu wspólnej metody oraz proceduralne i statystyczne sposoby jego ograniczania. W pracy logistycznej najprostszy sposób proceduralny to połączenie ankiety z danymi obiektywnymi: zamiast pytać o terminowość dostawcy, weź odsetek dostaw w terminie z systemu. Wtedy jednostką analizy staje się dostawca (albo klient), a nie odpowiedź na pytanie. Jeśli ankietę wypełniają pracownicy jednego magazynu, a wyniki chcesz pokazywać w podziale na zmiany, pamiętaj o anonimowości w małych grupach.
Projekt 6. Prognoza popytu – krótko
Prace z prognozowania popytu to osobny świat (modele wygładzania wykładniczego, ARIMA, modele z czynnikami zewnętrznymi). Jeśli Twoja praca nie jest pracą z prognozowania, wystarczy uczciwie porównać dwie lub trzy proste metody. Kluczowe zasady: model dopasuj na części danych, a trafność sprawdź na okresie, którego model nie widział; zawsze porównaj z metodą naiwną (dla danych sezonowych: wartość z tego samego miesiąca rok wcześniej); używaj kilku miar błędu prognozy. Hyndman i Koehler (2006) pokazali, że wiele popularnych miar trafności jest nieodpowiednich albo zdegenerowanych w często spotykanych sytuacjach, i zaproponowali średni bezwzględny błąd skalowany (MASE) jako standard porównań. Przykład takiej sytuacji: MAPE jest nieokreślony, gdy sprzedaż w którymś okresie wynosi zero, a to w danych o pojedynczych indeksach magazynowych zdarza się często.
Przykład (fikcyjny): miesięczna sprzedaż z 48 miesięcy; modele dopasowano na 36 miesiącach i sprawdzono na ostatnich 12. Sezonowa metoda naiwna miała MAE = 86.50 sztuki, MAPE = 5.72% i MASE = 0.94, a model Holta–Wintersa MAE = 62.75, MAPE = 4.21% i MASE = 0.68. MASE poniżej 1 oznacza, że prognoza była dokładniejsza niż sezonowa metoda naiwna w okresie uczącym. Nie obiecuj jednak w pracy, że model „będzie prognozował z dokładnością 4%” – to wynik jednego, krótkiego okresu testowego. Więcej o modelach znajdziesz we wpisie szeregi czasowe i ARIMA w praktyce, a zadania z szeregów i indeksów – w zbiorze statystyka w ekonomii – zadania z rozwiązaniami.
Jak opisać analizę statystyczną w pracy z logistyki
Rozdział metodologiczny w pracy z logistyki ma kilka elementów, których nie ma w typowej pracy ankietowej: źródło danych (system, okres, zakres eksportu), definicje wskaźników (co jest błędem, co jest dostawą w terminie, od kiedy liczony jest czas), jednostkę analizy i strukturę danych (dostawy w dostawcach, tygodnie w szeregu), a także zasady anonimizacji danych firmy. Poniżej wzór akapitu dla projektów 1, 3 i 4. Gotowy opis pojedynczego wyniku możesz porównać z wynikiem generatora opisu wyników APA.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: przerwany szereg czasowy w magazynie i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1: od naiwnego porównania dni, przez dane tygodniowe, kartę u i model segmentowy z offsetem, po analizę wrażliwości i 200 powtórzeń symulacji. Przepis 1 zapisuje też dane do pobrania (CSV). Przepis 2 zawiera projekty 1, 4, 5 i 6. Parametry symulacji (częstość bazowa, trend, sezon, prawdziwy skok, rozrzut) ustawiono ręcznie, by przykłady odpowiadały opisanym sytuacjom. Kod rysunków nie jest pokazany – rysunki przedstawiają liczby z tych dwóch przepisów.
1. Projekty 2 i 3: błędy kompletacji, karta u i przerwany szereg czasowy
R
# Projekty 2 i 3: błędy kompletacji w jednym magazynie przed i po zmianie procesu (dane fikcyjne).
# 78 tygodni po 5 dni roboczych: 52 tygodnie przed wprowadzeniem skanowania każdej linii zamówienia
# i 26 tygodni po. Liczba skompletowanych linii zmienia się sezonowo (szczyt pod koniec roku).
# Parametry ustawione ręcznie: 3 błędy na 1000 linii na starcie, spontaniczny spadek o 0.4% tygodniowo,
# sezonowość, skok w dół o 22% (IRR = 0.78) od 53. tygodnia, wspólne wahania tygodni AR(1).
tyg <- 78; start <- 53                                     # skanowanie od 53. tygodnia
generuj <- function() {
  dni <- data.frame(tydzien = rep(1:tyg, each = 5), dzien = rep(1:5, times = tyg))
  sezon <- cos(2 * pi * (dni$tydzien - 48) / 52)           # maksimum w 48. tygodniu roku
  dni$linie <- round(rnorm(nrow(dni), 4000 + 900 * sezon, 300))
  u <- as.numeric(arima.sim(list(ar = .5), n = tyg, sd = .05))   # wspólne wahania z tygodnia na tydzień
  log_tempo <- log(3) - .004 * (dni$tydzien - 1) + .15 * sezon + log(.78) * (dni$tydzien >= start) + u[dni$tydzien]
  dni$bledy <- rnbinom(nrow(dni), mu = exp(log_tempo) * dni$linie / 1000, size = 30)
  dni$na_1000 <- 1000 * dni$bledy / dni$linie
  dni$okres <- factor(ifelse(dni$tydzien >= start, "po", "przed"), levels = c("przed", "po"))
  dni
}
tygodniowo <- function(dni) {
  tydz <- aggregate(cbind(bledy, linie) ~ tydzien, data = dni, FUN = sum)
  tydz$czas <- tydz$tydzien
  tydz$po <- as.integer(tydz$tydzien >= start)
  tydz$czas_po <- pmax(0, tydz$tydzien - start + 1)          # 1 w pierwszym tygodniu skanowania
  tydz$sin52 <- sin(2 * pi * tydz$tydzien / 52); tydz$cos52 <- cos(2 * pi * tydz$tydzien / 52)
  tydz$na_1000 <- round(1000 * tydz$bledy / tydz$linie, 3)
  tydz
}
set.seed(52301)
dni <- generuj()

# Krok 1. Naiwne porównanie dni przed i po (BŁĄD: dni nie są niezależne, a trend i sezon są pominięte)
print(aggregate(na_1000 ~ okres, data = dni, FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2)))
tt <- t.test(na_1000 ~ okres, data = dni)
round(c(t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value,
        zmiana_proc = 100 * (mean(dni$na_1000[dni$okres == "po"]) / mean(dni$na_1000[dni$okres == "przed"]) - 1)), 4)

# Krok 2. Dane tygodniowe: liczba błędów i liczba linii (ekspozycja); zapis do CSV
tydz <- tygodniowo(dni)
write.csv(tydz[, c("tydzien", "linie", "bledy", "na_1000", "po")], "logistyka-kompletacja-tygodnie-dane.csv",
          row.names = FALSE)
round(c(tygodnie = nrow(tydz), bledy = sum(tydz$bledy), linie = sum(tydz$linie)), 0)

# Krok 3. Karta kontrolna u dla okresu przed zmianą (błędy na 1000 linii, granice ±3 SE dla każdego tygodnia)
przed <- tydz[tydz$po == 0, ]
u_bar <- 1000 * sum(przed$bledy) / sum(przed$linie)
gr <- 3 * sqrt(u_bar / (przed$linie / 1000))
round(c(linia_centralna = u_bar, poza_granicami = sum(przed$na_1000 > u_bar + gr | przed$na_1000 < u_bar - gr)), 2)

# Krok 4. Model ustalony przed analizą: regresja Poissona z offsetem log(linie / 1000), trend, skok
# poziomu po zmianie i sezonowość (sin, cos); diagnostyka rozproszenia i autokorelacji reszt
m <- glm(bledy ~ czas + po + sin52 + cos52 + offset(log(linie / 1000)), family = poisson, data = tydz)
round(c(rozproszenie = sum(residuals(m, type = "pearson")^2) / df.residual(m)), 2)
r <- residuals(m, type = "pearson")
round(c(acf_lag1 = acf(r, plot = FALSE)$acf[2]), 3)
lb <- Box.test(r, lag = 8, type = "Ljung-Box")
round(c(Q = unname(lb$statistic), df = unname(lb$parameter), p = lb$p.value), 3)

# Krok 5. Ten sam model jako quasi-Poisson (błędy standardowe powiększone o nadmierne rozproszenie);
# IRR z 95% CI (rozkład t), zmienne czasu przeliczone na 4 tygodnie
irr_tab <- function(m, wiersze) {
  ct <- summary(m)$coefficients[wiersze, , drop = FALSE]
  skala <- ifelse(grepl("czas", wiersze), 4, 1); kw <- qt(.975, df.residual(m))   # przedział z rozkładu t
  data.frame(IRR = exp(ct[, 1] * skala), CI_d = exp((ct[, 1] - kw * ct[, 2]) * skala),
             CI_g = exp((ct[, 1] + kw * ct[, 2]) * skala), t = ct[, 3], p = ct[, 4])
}
mq <- update(m, family = quasipoisson)
print(round(irr_tab(mq, c("czas", "po")), 3))
round(c(SE_po_Poisson = summary(m)$coefficients["po", 2], SE_po_quasi = summary(mq)$coefficients["po", 2],
        df_reszt = df.residual(mq)), 3)

# Krok 6. Przewidywana częstość w ostatnim tygodniu: model a przedłużony trend sprzed zmiany
ost <- tydz[tydz$tydzien == tyg, ]
round(c(model = unname(predict(mq, transform(ost, linie = 1000), type = "response")),
        bez_zmiany = unname(predict(mq, transform(ost, linie = 1000, po = 0), type = "response"))), 2)

# Krok 7. Analiza wrażliwości: model ze zmianą poziomu i zmianą trendu
mq2 <- update(mq, . ~ . + czas_po)
print(round(irr_tab(mq2, c("po", "czas_po")), 3))

# Krok 8. 200 powtórzeń tego samego magazynu: naiwna zmiana a oszacowanie z szeregu (prawda: IRR = 0.78)
set.seed(52302)
pow <- t(replicate(200, {
  d <- generuj(); w <- tygodniowo(d)
  mm <- glm(bledy ~ czas + po + sin52 + cos52 + offset(log(linie / 1000)), family = quasipoisson, data = w)
  ct <- summary(mm)$coefficients["po", ]
  ci <- exp(ct[1] + c(-1, 1) * qt(.975, df.residual(mm)) * ct[2])
  c(naiwnie = mean(d$na_1000[d$okres == "po"]) / mean(d$na_1000[d$okres == "przed"]),
    ITS = unname(exp(ct[1])), pokrycie = ci[1] <= .78 & ci[2] >= .78, wykryto = ci[2] < 1)
}))
round(c(naiwnie_sr = mean(pow[, "naiwnie"]), ITS_sr = mean(pow[, "ITS"]), ITS_P10 = unname(quantile(pow[, "ITS"], .1)),
        ITS_P90 = unname(quantile(pow[, "ITS"], .9)), pokrycie_proc = 100 * mean(pow[, "pokrycie"]),
        wykryto_proc = 100 * mean(pow[, "wykryto"])), 3)
Wynik w R
  okres na_1000.M na_1000.SD na_1000.n
1 przed      2.71       1.06    260.00
2    po      1.83       1.01    130.00
          t          df           p zmiana_proc
     8.0076    270.2166      0.0000    -32.4877
tygodnie    bledy    linie
      78     3770  1522508
linia_centralna  poza_granicami
           2.76            2.00
rozproszenie
        1.92
acf_lag1
    0.02
    Q    df     p
5.931 8.000 0.655
      IRR  CI_d  CI_g      t     p
czas 0.99 0.973 1.008 -1.132 0.262
po   0.79 0.623 1.001 -1.982 0.051
SE_po_Poisson   SE_po_quasi      df_reszt
        0.086         0.119        73.000
     model bez_zmiany
      1.59       2.01
          IRR  CI_d  CI_g      t     p
po      0.835 0.650 1.072 -1.438 0.155
czas_po 0.962 0.905 1.022 -1.272 0.208
   naiwnie_sr        ITS_sr       ITS_P10       ITS_P90 pokrycie_proc
        0.641         0.799         0.681         0.915        93.000
 wykryto_proc
       56.500
2. Projekty 1, 4, 5 i 6
R
# Pozostałe projekty z wpisu (dane fikcyjne): czasy dostaw dwóch przewoźników, opóźnienia dostaw
# w podziale na dostawców, ankieta klientów o zaufaniu do dostawcy i krótka prognoza popytu.
# Parametry rozkładów ustawiono ręcznie tak, by przykłady odpowiadały opisanym sytuacjom.
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(psych) })

# ---- Projekt 1. Czas dostawy (godziny od nadania do doręczenia), przewoźnik A i B, po 250 przesyłek ----
set.seed(52311)
nA <- 250; nB <- 250
czasA <- round(rlnorm(nA, log(29), .30) + ifelse(runif(nA) < .15, rexp(nA, 1 / 48), 0), 1)  # 15% przesyłek z dodatkowym opóźnieniem
czasB <- round(rlnorm(nB, log(34), .28), 1)
dost <- data.frame(przewoznik = factor(rep(c("A", "B"), c(nA, nB))), godziny = c(czasA, czasB))
opis <- function(x) c(M = mean(x), SD = sd(x), Me = median(x), P90 = unname(quantile(x, .9)),
                      P95 = unname(quantile(x, .95)), skosnosc = mean((x - mean(x))^3) / sd(x)^3,
                      do_48h_proc = 100 * mean(x <= 48))
print(round(sapply(split(dost$godziny, dost$przewoznik), opis), 2))
tm <- t.test(godziny ~ przewoznik, data = dost)               # test Welcha na średnich
round(c(t = unname(tm$statistic), df = unname(tm$parameter), p = tm$p.value), 3)
w <- wilcox.test(godziny ~ przewoznik, data = dost)
round(c(W = unname(w$statistic), p = w$p.value), 4)
pt <- prop.test(c(sum(czasA <= 48), sum(czasB <= 48)), c(nA, nB))
round(c(chi2 = unname(pt$statistic), p = pt$p.value, roznica_A_B_pp = unname(100 * (pt$estimate[1] - pt$estimate[2])),
        CI_d = 100 * pt$conf.int[1], CI_g = 100 * pt$conf.int[2]), 3)
# Różnica B − A w medianie, 90. i 95. percentylu z 95% CI (bootstrap percentylowy, 2000 prób)
roznica_q <- function(p) {
  obs <- quantile(czasB, p) - quantile(czasA, p)
  b <- replicate(2000, quantile(sample(czasB, replace = TRUE), p) - quantile(sample(czasA, replace = TRUE), p))
  c(percentyl = 100 * p, roznica_B_A = unname(obs), CI_d = unname(quantile(b, .025)), CI_g = unname(quantile(b, .975)))
}
tab_q <- rbind(roznica_q(.5), roznica_q(.9), roznica_q(.95))
print(round(tab_q, 2))

# ---- Projekt 4. Opóźnienie dostaw (dni względem terminu) u 24 dostawców krajowych i zagranicznych ----
set.seed(52314)
k <- 24
n_dost <- sample(8:30, k, replace = TRUE)                     # liczba dostaw od dostawcy w roku
typ_d <- rep(c("krajowy", "zagraniczny"), each = k / 2)
efekt_dostawcy <- rnorm(k, 0, 1.2)                            # stała „solidność” dostawcy
dd <- data.frame(dostawca = factor(rep(sprintf("D%02d", 1:k), n_dost)), typ = factor(rep(typ_d, n_dost)))
dd$opoznienie <- round(.8 + .5 * (dd$typ == "zagraniczny") + efekt_dostawcy[as.integer(dd$dostawca)] +
                       rnorm(nrow(dd), 0, 1.6), 1)
round(c(dostaw = nrow(dd), dostawcow = k, srednio_na_dostawce = mean(n_dost)), 1)
print(aggregate(opoznienie ~ typ, data = dd, FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2)))
naiw <- t.test(opoznienie ~ typ, data = dd, var.equal = TRUE)   # BŁĄD: każda dostawa jak osobny dostawca
round(c(t = unname(naiw$statistic), df = unname(naiw$parameter), p = naiw$p.value), 3)
m0 <- lmer(opoznienie ~ 1 + (1 | dostawca), data = dd)
vc <- as.data.frame(VarCorr(m0))$vcov
icc <- vc[1] / sum(vc)
deff <- 1 + (mean(n_dost) - 1) * icc
round(c(ICC = icc, efekt_schematu = deff, n_efektywne = nrow(dd) / deff), 3)
m1 <- lmer(opoznienie ~ typ + (1 | dostawca), data = dd)
print(round(summary(m1)$coefficients, 3))
ci1 <- confint(m1, parm = "typzagraniczny", method = "Wald")
round(ci1, 2)
sr <- aggregate(opoznienie ~ dostawca + typ, data = dd, FUN = mean)   # analiza na średnich dostawców
ts <- t.test(opoznienie ~ typ, data = sr, var.equal = TRUE)
round(c(t = unname(ts$statistic), df = unname(ts$parameter), p = ts$p.value), 3)

# ---- Projekt 5. Ankieta: 4 pozycje zaufania do dostawcy (1–5) i ocena współpracy (1–7), 160 klientów ----
set.seed(52315)
n5 <- 160
z <- rnorm(n5)
zauf <- sapply(c(.8, .75, .7, .65), function(l) as.integer(cut(l * z + rnorm(n5, 0, .65),
                                                       c(-Inf, -1.4, -.5, .4, 1.2, Inf))))
colnames(zauf) <- paste0("zauf", 1:4)
ocena <- pmin(7, pmax(1, round(4.6 + .7 * z + rnorm(n5, 0, 1.1))))
wynik <- rowMeans(zauf)
round(c(alfa = psych::alpha(zauf)$total$raw_alpha, M = mean(wynik), SD = sd(wynik),
        ocena_M = mean(ocena), ocena_SD = sd(ocena)), 2)
kp <- cor.test(wynik, ocena)
ks <- suppressWarnings(cor.test(wynik, ocena, method = "spearman"))
round(c(r = unname(kp$estimate), CI = kp$conf.int, p = kp$p.value, rho = unname(ks$estimate), p_rho = ks$p.value), 3)

# ---- Projekt 6. Prognoza popytu: 48 miesięcy, model na 36, sprawdzenie na ostatnich 12 ----
set.seed(52316)
mies <- 1:48
popyt <- round(1200 + 6 * mies + 180 * sin(2 * pi * (mies - 3) / 12) + rnorm(48, 0, 70))
y <- ts(popyt, frequency = 12)
ucz <- window(y, end = c(3, 12)); test <- window(y, start = c(4, 1))
p_naiw <- as.numeric(window(y, start = c(3, 1), end = c(3, 12)))      # sezonowa naiwna: ten sam miesiąc rok wcześniej
hw <- HoltWinters(ucz, seasonal = "additive")
p_hw <- as.numeric(predict(hw, n.ahead = 12))
skala <- mean(abs(diff(as.numeric(ucz), lag = 12)))                   # mianownik MASE (sezonowa naiwna w próbie uczącej)
miary <- function(p) { e <- as.numeric(test) - p
  c(MAE = mean(abs(e)), RMSE = sqrt(mean(e^2)), MAPE = 100 * mean(abs(e) / as.numeric(test)), MASE = mean(abs(e)) / skala) }
print(round(rbind(sezonowa_naiwna = miary(p_naiw), Holt_Winters = miary(p_hw)), 2))
Wynik w R
                A     B
M           35.93 36.19
SD          22.82 10.62
Me          29.90 33.95
P90         51.66 49.63
P95         69.78 56.64
skosnosc     4.32  0.88
do_48h_proc 87.60 86.80
      t      df       p
 -0.167 351.981   0.868
         W          p
25193.0000     0.0002
          chi2              p roznica_A_B_pp           CI_d           CI_g
         0.018          0.894          0.800         -5.456          7.056
     percentyl roznica_B_A   CI_d CI_g
[1,]        50        4.05   2.25 5.80
[2,]        90       -2.03 -12.34 4.61
[3,]        95      -13.14 -40.22 1.03
             dostaw           dostawcow srednio_na_dostawce
              493.0                24.0                20.5
          typ opoznienie.M opoznienie.SD opoznienie.n
1     krajowy         0.51          1.92       226.00
2 zagraniczny         0.99          2.13       267.00
      t      df       p
 -2.592 491.000   0.010
           ICC efekt_schematu    n_efektywne
         0.334          7.527         65.495
               Estimate Std. Error     df t value Pr(>|t|)
(Intercept)       0.262      0.367 22.233   0.714    0.483
typzagraniczny    0.551      0.517 21.794   1.066    0.298
               2.5 % 97.5 %
typzagraniczny -0.46   1.56
     t     df      p
-1.079 22.000  0.292
    alfa        M       SD  ocena_M ocena_SD
    0.83     3.05     0.91     4.53     1.37
    r   CI1   CI2     p   rho p_rho
0.476 0.346 0.587 0.000 0.481 0.000
                  MAE   RMSE MAPE MASE
sezonowa_naiwna 86.50 110.12 5.72 0.94
Holt_Winters    62.75  75.82 4.21 0.68
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje glm(), t.test(), wilcox.test(), prop.test(), Box.test(), quantile() i HoltWinters() z pakietu stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z logistyki
- Test t na dniach przed i po zmianie procesu. W przykładzie dawał spadek o 32.5% i p < .001, a model z trendem i sezonem – około 21% z przedziałem sięgającym 1.00.
- Brak określenia kształtu efektu przed analizą i próbowanie kolejnych modeli (skok, nachylenie, opóźnienie), aż któryś da p < .05.
- Same średnie czasów dostaw. Przy rozkładzie prawoskośnym średnie mogą być równe, a mediany i ogony – wyraźnie różne. Podaj medianę, percentyle i odsetek w terminie.
- Skrajne percentyle bez przedziału ufności. Różnica w 95. percentylu przy 250 przesyłkach na przewoźnika miała przedział szeroki na ponad 40 godzin.
- Liczba błędów zamiast częstości. Strefa lub tydzień z większym wolumenem zawsze będzie mieć więcej błędów; porównuj błędy na 1000 linii i używaj offsetu.
- Dostawy traktowane jak niezależne obserwacje, gdy porównujesz cechy dostawców. Przy ICC = .33 test na 493 dostawach dał p = .010, a model mieszany p = .298.
- Ankieta i wskaźnik oceniane przez tę samą osobę bez wzmianki o błędzie wspólnej metody, gdy można było użyć danych z systemu.
- Prognoza oceniana na tych samych danych, na których dopasowano model, bez porównania z metodą naiwną i z obietnicą „dokładności” na przyszłość.
- Nazwy klientów, dostawców i wolumeny w pracy bez zgody firmy; brak opisu definicji wskaźników i ich zmian w czasie.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy dyplomowej z logistyki?
Zależy to od danych. Czasy dostaw opisz medianą i percentylami, a grupy porównaj testem Manna–Whitneya i różnicami percentyli z bootstrapem. Liczbę błędów analizuj regresją Poissona lub ujemną dwumianową z offsetem liczby linii, zmianę procesu w czasie – przerwanym szeregiem czasowym, a dostawy od wielu dostawców – modelem mieszanym. Przy każdej analizie podaj wielkość efektu z 95% CI.
Czy mogę porównać czas dostawy dwóch przewoźników testem t?
Możesz, ale sam test t na średnich zwykle nie wystarcza, bo czasy dostaw są prawoskośne. W przykładzie średnie różniły się o 0.26 godziny, a mediana była krótsza o 4.05 godziny u jednego przewoźnika, który jednocześnie miał dłuższy ogon spóźnień. Podaj medianę, 90. lub 95. percentyl i odsetek przesyłek w terminie.
Jak ocenić, czy zmiana procedury w magazynie zmniejszyła liczbę błędów?
Zbierz dane z wielu tygodni przed zmianą i po niej, licz błędy na liczbę skompletowanych linii i zastosuj regresję segmentową z trendem, sezonowością i offsetem. Kształt efektu ustal przed analizą i sprawdź autokorelację reszt. Test t na dniach przed i po zwykle zawyża efekt i daje za małą wartość p.
Ile dostawców potrzeba, żeby porównać dostawców krajowych i zagranicznych?
Liczy się przede wszystkim liczba dostawców, a nie liczba dostaw, bo typ dostawcy jest cechą dostawcy. Przy ICC = .33 i średnio 20.5 dostawy na dostawcę 493 dostawy dawały efektywnie około 65 obserwacji. Jeśli możesz, zwiększ liczbę dostawców, a w analizie użyj modelu mieszanego albo średnich dostawców.
Czy w pracy z logistyki mogę podać nazwy klientów i dane sprzedażowe firmy?
Tylko za pisemną zgodą firmy i w zakresie, który firma zaakceptuje. Zwykle wystarczy podać wskaźniki względne, np. błędy na 1000 linii czy odsetek dostaw w terminie, i zakodować dostawców symbolami. Identyfikatory pracowników zastąp kodami przed analizą.
Powiązane hasła
Przeczytaj też
Kalkulator ICC i efektu schematu
ICC z modelu pustego, ANOVA lub wyniku binarnego, efekt schematu z poprawką na nierówne grupy i liczba grup potrzebna w badaniu klastrowym.
Czytaj →PoradnikTesty nieparametryczne – zadania
Dziesięć zadań jak na kolokwium: Mann–Whitney, test znaków, Wilcoxon, Kruskal–Wallis z Dunnem, Friedman i Spearman – z rangami i rozwiązaniami krok po kroku.
Czytaj →PoradnikJak napisać pracę z zarządzania i ekonomii
Luka, jedna rama teoretyczna, model z hipotezami H1a/H1b, skale anglojęzyczne, wspólna metoda, panel firm i implikacje menedżerskie – z przykładami do poprawienia.
Czytaj →PoradnikObsada infolinii – Erlang C i symulacja
Infolinia dostawcy energii: test Poissona, czas rozmowy, Erlang C ręcznie, symulacja kolejki z rozłączeniami i grafik w kwadransach – sześć rysunków z kodem R.
Czytaj →PoradnikModel gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →PoradnikAnaliza ABC/XYZ asortymentu
Hurtownia części: krzywa Lorenza, umowne progi ABC, CV popytu i tygodnie bez sprzedaży, macierz ABC × XYZ i stabilność klas – pięć rysunków z kodem R.
Czytaj →Piszesz pracę z logistyki i nie wiesz, jak policzyć wyniki?
Pomożemy dobrać analizy do danych z magazynu, transportu lub ankiety – czasów dostaw, błędów kompletacji, danych przed i po zmianie procesu – policzyć je z wielkością efektu i wyjaśnić tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Benneyan, J. C., Lloyd, R. C., & Plsek, P. E. (2003). Statistical process control as a tool for research and healthcare improvement. Quality and Safety in Health Care, 12(6), 458–464. https://doi.org/10.1136/qhc.12.6.458 ● Otwarty dostęp
- de Koster, R., Le-Duc, T., & Roodbergen, K. J. (2007). Design and control of warehouse order picking: A literature review. European Journal of Operational Research, 182(2), 481–501. https://doi.org/10.1016/j.ejor.2006.07.009 ● Otwarty dostęp: pełny tekst
- Frome, E. L. (1983). The analysis of rates using Poisson regression models. Biometrics, 39(3), 665–674. https://doi.org/10.2307/2531094
- Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001 ● Otwarty dostęp: pełny tekst
- Killip, S., Mahfoud, Z., & Pearce, K. (2004). What is an intracluster correlation coefficient? Crucial concepts for primary care researchers. Annals of Family Medicine, 2(3), 204–208. https://doi.org/10.1370/afm.141 ● Otwarty dostęp
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2016). Interrupted time series regression for the evaluation of public health interventions: A tutorial. International Journal of Epidemiology, 46(1), 348–355. https://doi.org/10.1093/ije/dyw098 ● Otwarty dostęp
- Malhotra, M. K., & Grover, V. (1998). An assessment of survey research in POM: From constructs to theory. Journal of Operations Management, 16(4), 407–425. https://doi.org/10.1016/s0272-6963(98)00021-7
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Wagner, A. K., Soumerai, S. B., Zhang, F., & Ross-Degnan, D. (2002). Segmented regression analysis of interrupted time series studies in medication use research. Journal of Clinical Pharmacy and Therapeutics, 27(4), 299–309. https://doi.org/10.1046/j.1365-2710.2002.00430.x
Cytowania BibTeX
@article{benneyan2003statistical, author={Benneyan, James C. and Lloyd, Robert C. and Plsek, Paul E.}, title={{Statistical process control as a tool for research and healthcare improvement}}, journal={Quality and Safety in Health Care}, year={2003}, volume={12}, number={6}, pages={458--464}, doi={10.1136/qhc.12.6.458}}@article{dekoster2007design, author={de Koster, René and Le-Duc, Tho and Roodbergen, Kees Jan}, title={{Design and control of warehouse order picking: A literature review}}, journal={European Journal of Operational Research}, year={2007}, volume={182}, number={2}, pages={481--501}, doi={10.1016/j.ejor.2006.07.009}}@article{frome1983analysis, author={Frome, Edward L.}, title={{The analysis of rates using Poisson regression models}}, journal={Biometrics}, year={1983}, volume={39}, number={3}, pages={665--674}, doi={10.2307/2531094}}@article{hyndman2006another, author={Hyndman, Rob J. and Koehler, Anne B.}, title={{Another look at measures of forecast accuracy}}, journal={International Journal of Forecasting}, year={2006}, volume={22}, number={4}, pages={679--688}, doi={10.1016/j.ijforecast.2006.03.001}}@article{killip2004what, author={Killip, Shersten and Mahfoud, Ziyad and Pearce, Kevin}, title={{What is an intracluster correlation coefficient? Crucial concepts for primary care researchers}}, journal={Annals of Family Medicine}, year={2004}, volume={2}, number={3}, pages={204--208}, doi={10.1370/afm.141}}@article{lopezbernal2016interrupted, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{Interrupted time series regression for the evaluation of public health interventions: A tutorial}}, journal={International Journal of Epidemiology}, year={2016}, volume={46}, number={1}, pages={348--355}, doi={10.1093/ije/dyw098}}@article{malhotra1998assessment, author={Malhotra, Manoj K. and Grover, Varun}, title={{An assessment of survey research in POM: From constructs to theory}}, journal={Journal of Operations Management}, year={1998}, volume={16}, number={4}, pages={407--425}, doi={10.1016/s0272-6963(98)00021-7}}@article{podsakoff2003common, author={Podsakoff, Philip M. and MacKenzie, Scott B. and Lee, Jeong-Yeon and Podsakoff, Nathan P.}, title={{Common method biases in behavioral research: A critical review of the literature and recommended remedies}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={5}, pages={879--903}, doi={10.1037/0021-9010.88.5.879}}@article{wagner2002segmented, author={Wagner, A. K. and Soumerai, S. B. and Zhang, F. and Ross-Degnan, D.}, title={{Segmented regression analysis of interrupted time series studies in medication use research}}, journal={Journal of Clinical Pharmacy and Therapeutics}, year={2002}, volume={27}, number={4}, pages={299--309}, doi={10.1046/j.1365-2710.2002.00430.x}}