Przykład: hurtownia części i 2000 indeksów
Fikcyjna hurtownia części samochodowych zaopatruje warsztaty w regionie. W systemie ma 2000 indeksów (pozycji asortymentu) w ośmiu grupach: filtry, hamulce, oleje i płyny, akumulatory, oświetlenie, zawieszenie, rozrząd i wycieraczki. Kierownik magazynu pyta: którymi indeksami zajmować się codziennie, które zamawiać automatycznie, a które w ogóle trzymać na półce? Klasyczna odpowiedź to analiza ABC (ile indeks wnosi do obrotu) połączona z analizą XYZ (jak równo się sprzedaje). Obie to proste statystyki opisowe z pułapkami, które widać na rysunkach.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy udział grup, typowe ceny (od 30 zł w oświetleniu do 480 zł w rozrządzie) i marże (od 15% do 38%). Średni popyt indeksu losowaliśmy z rozkładu lognormalnego, a tygodniową sprzedaż – z rozkładu ujemnego dwumianowego, od popytu równego po „grudkowy”. Akumulatory mają szczyt w styczniu, wycieraczki – jesienią. Dane obejmują dwa lata (104 tygodnie); w roku 2 popyt każdego indeksu trochę się zmienia, jak przy starzeniu się modeli aut. Pełną listę parametrów podajemy przy kodzie. Poziom popytu podnieśliśmy raz, po pierwszym uruchomieniu, bo do klasy X trafiało tylko 8 indeksów; ziarna 650 nie zmienialiśmy. Dane: abc-xyz-hurtownia-czesci.csv (wiersz = indeks: grupa, cena, marża, sprzedaż w tygodniach t001–t104).
W roku 2 hurtownia miała 88.49 mln zł obrotu; w 27.7% par „indeks × tydzień” nie sprzedano nic. Analizujemy rok 2, a rok 1 posłuży do sprawdzenia stabilności klas.
Rysunek 1: krzywa Lorenza i klasy ABC
Analiza ABC sortuje indeksy od największego obrotu i liczy skumulowany udział: pierwsze 80% obrotu to klasa A, kolejne 15% – B, ostatnie 5% – C. To ten sam rachunek co w wykresie Pareto: słupki posortowane malejąco i linia sum skumulowanych (Wilkinson, 2006). Linia jest zarazem krzywą Lorenza (Lorenz, 1905), tylko „obróconą”: klasyczna krzywa zaczyna od najmniejszych wartości, tu zaczynamy od największych.
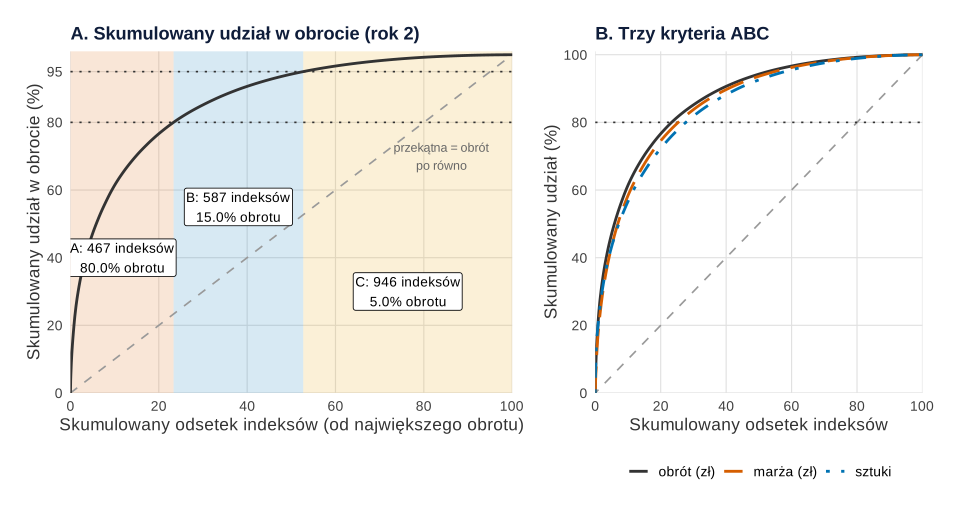
set.seed(650)).Co widać – panel A. 467 indeksów (23.4%) daje 80.0% obrotu, a 946 (47.3%) – 5.0%. 20% największych indeksów ma 76.6% obrotu, dolna połowa – 5.7%. Pole między przekątną a krzywą daje indeks Giniego: G = .734, czyli bardzo silną koncentrację.
Progi są umowne. 80/15/5 to zwyczaj, a nie wynik statystyczny. Te same dane przy innych progach:
| Progi A/B/C (% obrotu) | A | B | C |
|---|---|---|---|
| 70/20/10 | 297 | 475 | 1228 |
| 75/20/5 | 372 | 682 | 946 |
| 80/15/5 | 467 | 587 | 946 |
| 85/10/5 | 595 | 459 | 946 |
| 90/8/2 | 772 | 592 | 636 |
Klasa A ma od 297 do 772 indeksów zależnie od umowy, a 87 indeksów leży między 78% a 82% skumulowanego obrotu – kilka sztuk przesuwa je między A i B. Granica to linia na gładkiej krzywej, a nie przerwa w danych.
Jak może zmylić. Indeks wprowadzony w listopadzie trafi do C, bo sprzedawał się dwa miesiące – nowości oznacz osobno.
Podpis do pracy:
Zdanie do Wyników:
Obrót, sztuki czy marża?
Co widać – panel B. Krzywe dla obrotu, marży i sztuk prawie się pokrywają, ale krzywa pokazuje tylko kształt koncentracji, a nie to, które indeksy są na górze. Klasę według obrotu i według sztuk ma tę samą tylko 59.6% indeksów, a według obrotu i marży – 87.2%. 24 indeksy z klasy A według obrotu są w klasie C według sztuk (drogie, rzadko sprzedawane części), a 44 indeksy A według sztuk są w C według obrotu (tania drobnica).
Zmienia się też obraz grup: w klasie A według obrotu jest 88 indeksów rozrządu, według sztuk – 22; w oświetleniu odwrotnie, 28 i 110. Obrót mówi, gdzie leży kapitał zamrożony w zapasie, sztuki – co obciąża magazyn, marża – co zarabia. W pracy napisz, które kryterium wybrałeś i dlaczego.
Rysunek 2: zmienność popytu – CV, zera i popyt sporadyczny
Analiza XYZ dzieli indeksy według zmienności tygodniowego popytu. Miarą jest współczynnik zmienności (CV), czyli odchylenie standardowe podzielone przez średnią sprzedaży z 52 tygodni. Przyjęliśmy popularne, ale umowne progi: X – CV ≤ 0.5, Y – od 0.5 do 1.0, Z – powyżej 1.0. Wynik: 231 indeksów X, 803 Y, 964 Z i 2 bez sprzedaży, dla których CV nie istnieje (dzielenie przez zero) – to osobna kategoria, a nie „Z”.
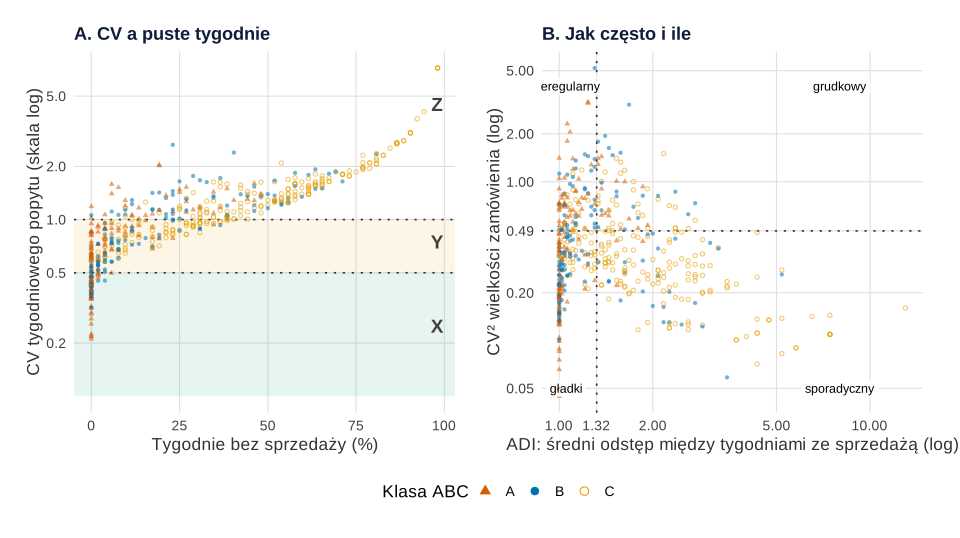
set.seed(650)).Co widać – panel A. Punkty układają się prawie w jedną krzywą: CV mierzy głównie to, ile jest tygodni bez sprzedaży. Korelacja rang CV z odsetkiem pustych tygodni wynosi ρ = .91. Mediana pustych tygodni to 0.0% w klasie X, 7.7% w Y i 48.1% w Z (mediany CV: 0.41, 0.75 i 1.39). W hurtowni części to typowe: wiele indeksów pasuje tylko do kilku modeli aut.
Co widać – panel B. Popyt z zerami lepiej opisać dwiema liczbami: średnim odstępem między tygodniami ze sprzedażą (ADI) i kwadratem CV wielkości sprzedaży w tygodniach, w których coś sprzedano (CV²). Syntetos i in. (2005) wyznaczyli taki podział z porównania błędów prognoz różnych metod, a nie arbitralnie, i sprawdzili go na 3000 szeregów z branży motoryzacyjnej. W oprogramowaniu spotkasz progi ADI = 1.32 i CV² = 0.49 – tak też podzieliliśmy dane. Z 964 indeksów Z aż 562 ma popyt sporadyczny (rzadko, w podobnych ilościach), 240 – grudkowy (rzadko i w różnych ilościach), a tylko 156 – nieregularny (co tydzień, ale w skaczących ilościach). Dla 6 indeksów, które sprzedały się w jednym tygodniu, CV² nie istnieje.
Croston (1972) pokazał, że zwykłe wygładzanie wykładnicze przy popycie sporadycznym daje niewłaściwe zapasy, i zaproponował prognozować osobno wielkość popytu i odstęp między popytami. Syntetos i Boylan (2005) porównali na 3000 takich szeregów średnią ruchomą, wygładzanie wykładnicze, metodę Crostona i jej poprawioną wersję, która wypadła najlepiej. „Z” to więc zwykle nie chaos, tylko rzadki popyt z własnymi metodami prognozy.
Jak może zmylić – sezonowość. Wycieraczki sprzedają się jesienią, więc ich CV jest wysokie, choć szczyt da się przewidzieć. Po podzieleniu sprzedaży przez indeks sezonowości policzony z roku 1 mediana CV wycieraczek spada z 0.95 do 0.89, a odsetek indeksów X rośnie z 1.1% do 14.7% (akumulatory: z 0.0% do 4.1%). XYZ liczone na surowej sprzedaży myli przewidywalny rytm ze zmiennością.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: macierz ABC × XYZ
Połączenie obu podziałów daje tabelę krzyżową 3 × 3. W każdej komórce liczymy indeksy i ich udział w obrocie.
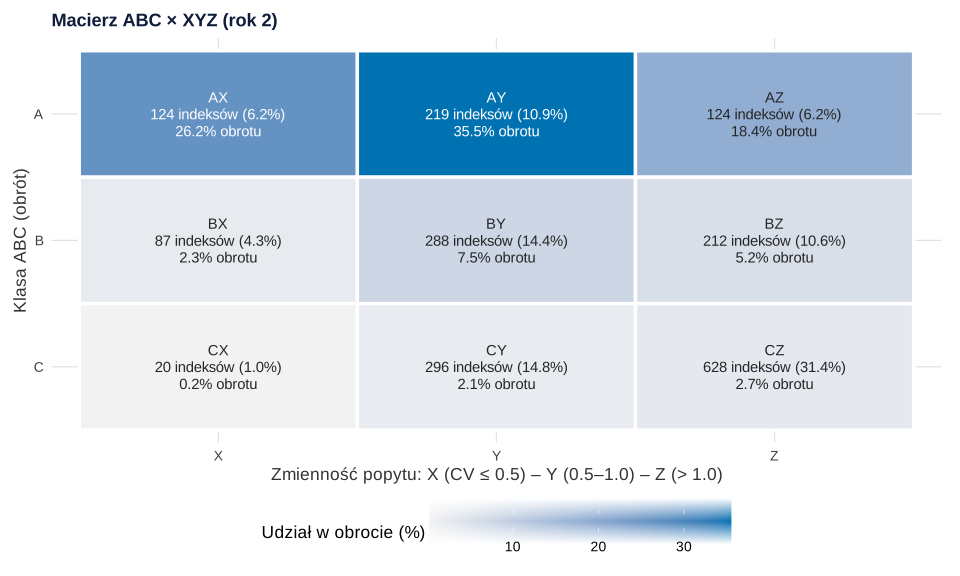
set.seed(650)).Co widać. Najwięcej obrotu daje AY: 219 indeksów i 35.5% obrotu. AX to 124 indeksy i 26.2% obrotu, AZ – 124 indeksy i 18.4%. Razem 53.9% obrotu przypada na indeksy A ze zmiennym albo sporadycznym popytem – tych nie da się obsłużyć prostą automatyczną regułą. Największa liczebnie jest komórka CZ: 628 indeksów (31.4% asortymentu) i tylko 2.7% obrotu.
Jak może zmylić. W CZ mogą być części, bez których warsztat nie odda auta – krytyczności macierz nie widzi.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: czy klasy są stabilne – macierz przejść
Klasy ABC i XYZ policzyliśmy też dla roku 1 i zestawiliśmy z rokiem 2 w macierzy przejść (jak w łańcuchu Markowa: wiersz = klasa w roku 1, liczby = odsetek indeksów, które trafiły do danej klasy w roku 2). Ale ile zmian to prawdziwa zmiana popytu, a ile przypadek? Żeby to sprawdzić, 1000 razy wylosowaliśmy dwa lata z tymi samymi średnimi, rozrzutem i sezonowością, bez zmiany w roku 2 (ziarno 651).
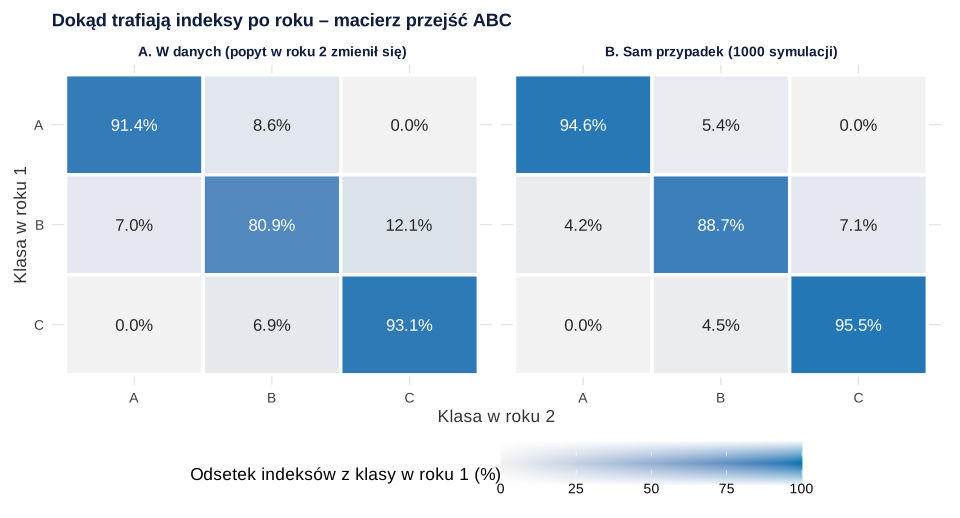
set.seed(650) i set.seed(651)).Co widać. W danych klasę ABC zachowało 89.0% indeksów, w tym 91.4% indeksów A; z klasy B 7.0% awansowało, a 12.1% spadło do C. Skoków A ↔ C nie było. Gdy popyt się nie zmienia, klasę zachowuje średnio 93.3% indeksów (95% symulacji: 92.4–94.2%). Czyli z 11.0% indeksów, które zmieniły klasę, ok. 6.7 punktu procentowego to sam przypadek. Najbardziej ruchliwa jest klasa B, leżąca między dwiema granicami. W XYZ klasę zachowało 84.6% indeksów, a przy samym przypadku – 86.3% (85.0–87.6%): zmiany XYZ to tu prawie wyłącznie szum. Obie klasy zachowało 75.6% indeksów.
Jak może zmylić. Symulacja zna prawdziwe parametry popytu, firma – nie. Daje jednak punkt odniesienia: zmiana klasy jednego indeksu sama w sobie nic nie znaczy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: co zrobić z każdą komórką
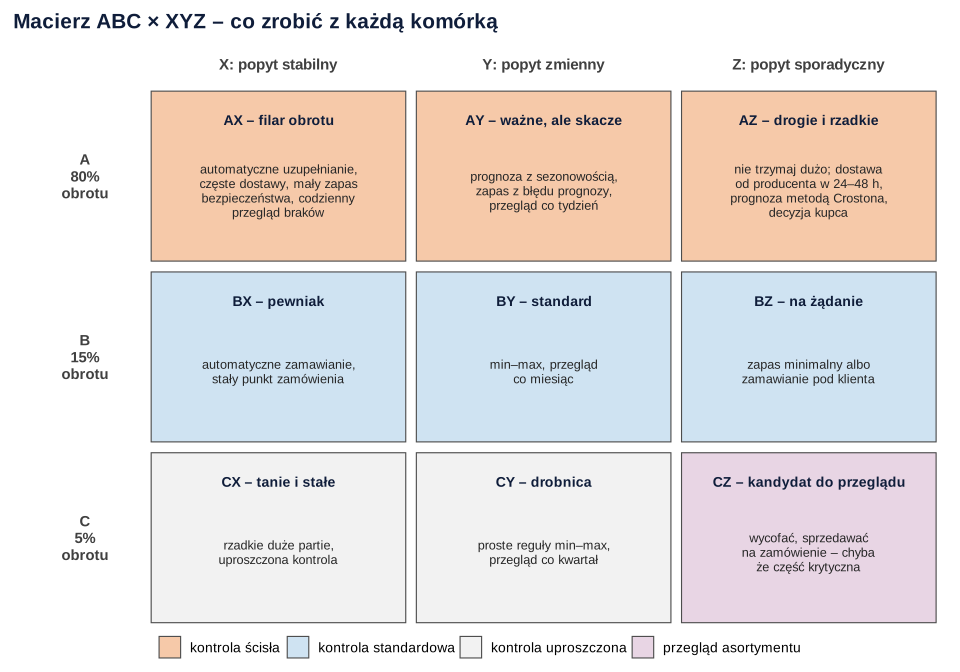
Co widać. Wiersz mówi, ile uwagi poświęcić indeksowi (kolor: kontrola ścisła, standardowa, uproszczona, przegląd), a kolumna – jak planować: X automatycznie, Y z prognozą i zapasem z błędu prognozy, Z metodami dla popytu sporadycznego albo na zamówienie. To propozycja, a nie norma – koszty i czasy dostaw są w każdej firmie inne.
Podpis do pracy:
Co z tym zrobić w firmie
- Dobierz kryterium ABC do decyzji: zapas – obrót w cenach zakupu, praca magazynu – sztuki lub linie zamówień, asortyment – marża.
- Nie ustawiaj poziomu obsługi tylko według klasy ABC. Teunter i in. (2010) pokazali na trzech dużych zbiorach danych, że stały poziom obsługi w klasach wyznaczonych według wartości lub wolumenu daje rozwiązania dalekie od kosztowo optymalnych; lepsze jest kryterium uwzględniające koszt i krytyczność indeksu.
- Zapas bezpieczeństwa dla A i B licz z błędu prognozy, a nie z samego CV sprzedaży – zob. zapasy przy niepewnym popycie – model gazeciarza i zapas bezpieczeństwa i miary błędu prognozy.
- Dla Z rozdziel „jak często” i „ile” (ADI i CV²). Popyt sporadyczny prognozuj metodą Crostona lub jej wariantem, a nie średnią z tygodni z zerami.
- Usuń sezonowość przed XYZ albo licz CV z błędów prognozy z modelu sezonowego – zob. prognoza sprzedaży: sezonowość, święta i promocje.
- Przeliczaj klasy raz na kwartał lub pół roku i nie reaguj na pojedyncze przejścia. W przykładzie ponad połowa zmian klas była szumem; klasę indeksu zmieniaj dopiero po dwóch przeliczeniach z rzędu.
- CZ przeglądaj z działem handlowym przed wycofaniem – część to pozycje krytyczne dla stałych klientów.
Koncentrację obrotu u klientów (a nie w asortymencie) liczy się tak samo – zob. wartość klienta w czasie (CLV).
Jak opisać w pracy
W Metodzie podaj okres i jednostkę czasu, kryterium i progi ABC, miarę zmienności i progi XYZ oraz to, co zrobiłeś z indeksami bez sprzedaży, nowymi i sezonowymi. Inne typowe projekty opisuje wpis statystyka w pracy z logistyki, a strukturę całej pracy – jak napisać pracę z zarządzania i ekonomii.
Jeśli potrzebujesz pomocy przy takiej analizie na danych z firmy: analizy statystyczne dla studentów.
Kod R: ABC, XYZ, macierz i stabilność klas
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne (przepisy 6 i 7 są samodzielne). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane, set.seed(650)) i 5 (symulacja, set.seed(651)); ziaren nie zmienialiśmy. Ręcznie ustalono: udział ośmiu grup, typowe ceny i marże, rozrzut cen (SD logarytmu 0.45) i marż (SD 0.05), średni popyt tygodniowy (mediana 2.5 szt. × (cena typowa / 100 zł)−0.4, SD logarytmu 1.4), parametr rozproszenia od 0.4 do 40, sezonowość akumulatorów (amplituda 0.7, szczyt w 3. tygodniu) i wycieraczek (0.6, szczyt w 44. tygodniu), zmianę popytu w roku 2 (SD logarytmu 0.25), progi ABC (80/95%) i XYZ (0.5 i 1.0) oraz liczbę symulacji (1000). Poziom popytu i zakres rozproszenia podniesiono raz po pierwszym uruchomieniu (wcześniej mediana 1.2 szt. i zakres 0.3–5). Symulacja liczy się ok. 30 sekund.
1. Paleta i dane hurtowni
R
# Dane: fikcyjna hurtownia części samochodowych – 2000 indeksów, 104 tygodnie sprzedaży (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey60", ciemny = "grey20")
kol_abc <- c(A = "#D55E00", B = "#0072B2", C = "#E69F00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie: 8 grup towarowych, ich udział w asortymencie, typowa cena (zł) i marża
set.seed(650)
n <- 2000; tyg <- 104                                     # rok 1 = tygodnie 1–52, rok 2 = tygodnie 53–104
grupy <- c("filtry", "hamulce", "oleje i płyny", "akumulatory", "oświetlenie", "zawieszenie", "rozrząd", "wycieraczki")
udzial <- c(0.18, 0.16, 0.10, 0.06, 0.14, 0.16, 0.10, 0.10)
cena_typowa <- c(45, 160, 70, 420, 30, 180, 480, 45)
marza_typowa <- c(0.32, 0.25, 0.18, 0.15, 0.38, 0.24, 0.22, 0.35)
grupa <- sample(grupy, n, replace = TRUE, prob = udzial)
g <- match(grupa, grupy)
cena <- round(cena_typowa[g] * exp(rnorm(n, 0, 0.45)), 2)
marza <- round(pmin(pmax(marza_typowa[g] + rnorm(n, 0, 0.05), 0.05), 0.60), 3)
# Średni popyt tygodniowy (szt.): bardzo nierówny między indeksami, tańsze części schodzą częściej
mu <- exp(rnorm(n, log(2.5) - 0.4 * log(cena_typowa[g] / 100), 1.4))
# Rozrzut wielkości zamówień (parametr rozproszenia ujemnego dwumianowego: mały = „grudkowy” popyt)
rozprosz <- exp(runif(n, log(0.4), log(40)))
# Sezonowość: akumulatory – szczyt w styczniu, wycieraczki – w październiku i listopadzie
w <- rep(1:tyg, each = n)                               # tydzień dla każdej komórki macierzy n × 104
gr_w <- rep(grupa, times = tyg)                         # grupa towarowa dla każdej komórki
sezon <- ifelse(gr_w == "akumulatory", 1 + 0.7 * cos(2 * pi * (w - 3) / 52),
         ifelse(gr_w == "wycieraczki", 1 + 0.6 * cos(2 * pi * (w - 44) / 52), 1))
# W roku 2 popyt każdego indeksu zmienia się trochę (np. starzenie się modeli aut): mnożnik ~ lognormalny, SD 0.25
zmiana <- exp(rnorm(n, 0, 0.25))
mu_tyg <- mu * sezon * ifelse(w > 52, zmiana, 1)
sprzedaz <- matrix(rnbinom(n * tyg, size = rozprosz, mu = mu_tyg), nrow = n, ncol = tyg)
indeks <- sprintf("CZ-%04d", 1:n)

hurtownia <- data.frame(indeks, grupa, cena, marza, sprzedaz)
names(hurtownia)[-(1:4)] <- sprintf("t%03d", 1:tyg)
write.csv(hurtownia, "abc-xyz-hurtownia-czesci.csv", row.names = FALSE)

# Przegląd: liczba indeksów w grupach, sprzedaż w sztukach i obrót w roku 2
rok2 <- 53:104
szt2 <- rowSums(sprzedaz[, rok2])
wartosc2 <- szt2 * cena
aggregate(cbind(indeksy = 1, sztuki = szt2, obrot_tys_zl = wartosc2 / 1000) ~ grupa, FUN = function(x) round(sum(x)))
data.frame(indeksy = n, tygodnie = tyg, obrot_rok2_mln_zl = round(sum(wartosc2) / 1e6, 2),
           bez_sprzedazy_rok2 = sum(szt2 == 0),
           proc_tygodni_zerowych = round(100 * mean(sprzedaz[, rok2] == 0), 1))
Wynik w R
          grupa indeksy sztuki obrot_tys_zl
1   akumulatory     122  31860        15361
2        filtry     366 164728         8083
3       hamulce     340 134308        21045
4 oleje i płyny     193  94595         5758
5   oświetlenie     284 144882         4773
6       rozrząd     205  31892        16475
7   wycieraczki     184  82879         4288
8   zawieszenie     306  65870        12707
  indeksy tygodnie obrot_rok2_mln_zl bez_sprzedazy_rok2 proc_tygodni_zerowych
1    2000      104             88.49                  2                  27.7
2. Klasy ABC i krzywa Lorenza: Rysunek 1
R
# Rysunek 1. Analiza ABC: krzywa koncentracji obrotu (A) i trzy kryteria – obrót, sztuki, marża (B)
# Korzysta z obiektów przepisu 1: sprzedaz, cena, marza, grupa, n, kol, kol_abc, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

# Klasy ABC: sortuj malejąco, licz skumulowany udział; indeks należy do A, jeśli przed nim
# skumulowany udział był < 80%, do B, jeśli < 95%, pozostałe do C (progi 80/15/5)
klasy_abc <- function(x, progi = c(0.80, 0.95)) {
  o <- order(-x)
  przed <- c(0, head(cumsum(x[o]) / sum(x), -1))
  k <- character(length(x))
  k[o] <- ifelse(przed < progi[1], "A", ifelse(przed < progi[2], "B", "C"))
  factor(k, levels = c("A", "B", "C"))
}
rok1 <- 1:52; rok2 <- 53:104
szt1 <- rowSums(sprzedaz[, rok1]); szt2 <- rowSums(sprzedaz[, rok2])
obrot1 <- szt1 * cena; obrot2 <- szt2 * cena           # obrót w zł (cena sprzedaży × sztuki)
zysk2 <- obrot2 * marza                               # marża w zł
abc <- klasy_abc(obrot2)

# Liczba indeksów i udział w obrocie w klasach
tab <- data.frame(klasa = levels(abc), indeksy = as.vector(table(abc)),
                  proc_indeksow = round(100 * as.vector(table(abc)) / n, 1),
                  proc_obrotu = round(100 * tapply(obrot2, abc, sum) / sum(obrot2), 1))
tab
# Koncentracja: udział 20% i 50% indeksów o największym obrocie oraz indeks Giniego (z krzywej Lorenza)
x <- sort(obrot2)                                     # rosnąco – klasyczna krzywa Lorenza
L <- c(0, cumsum(x) / sum(x)); F <- (0:n) / n
gini <- 1 - sum((F[-1] - F[-(n + 1)]) * (L[-1] + L[-(n + 1)]))
data.frame(udzial_top20_proc = round(100 * (1 - L[n * 0.8 + 1]), 1),
           udzial_top50_proc = round(100 * (1 - L[n * 0.5 + 1]), 1),
           udzial_dolnych50_proc = round(100 * L[n * 0.5 + 1], 1), gini = round(gini, 3))

# Arbitralność progów: ile indeksów trafia do A, B i C przy różnych progach
progi <- list("70/20/10" = c(0.70, 0.90), "75/20/5" = c(0.75, 0.95), "80/15/5" = c(0.80, 0.95),
              "85/10/5" = c(0.85, 0.95), "90/8/2" = c(0.90, 0.98))
t(sapply(progi, function(p) table(klasy_abc(obrot2, p))))
# Indeksy „na granicy”: skumulowany udział między 78% a 82% (o włos od zmiany klasy A/B)
o <- order(-obrot2); skum <- cumsum(obrot2[o]) / sum(obrot2)
c(na_granicy_A_B = sum(skum > 0.78 & skum < 0.82))

# Trzy kryteria: obrót (zł), sztuki, marża (zł) – jak często dają tę samą klasę
abc_szt <- klasy_abc(szt2); abc_zysk <- klasy_abc(zysk2)
table(obrot = abc, sztuki = abc_szt)
data.frame(zgodnosc_obrot_sztuki_proc = round(100 * mean(abc == abc_szt), 1),
           zgodnosc_obrot_marza_proc = round(100 * mean(abc == abc_zysk), 1),
           A_obrot_C_sztuki = sum(abc == "A" & abc_szt == "C"),
           A_sztuki_C_obrot = sum(abc_szt == "A" & abc == "C"))
# Które grupy towarowe zyskują, a które tracą, gdy zamiast obrotu liczysz sztuki (liczba indeksów A)
rbind(A_wg_obrotu = table(grupa[abc == "A"]), A_wg_sztuk = table(grupa[abc_szt == "A"]))

# Rysunek 1A: krzywa koncentracji (krzywa Lorenza „obrócona”: indeksy od największego obrotu)
krzywa <- function(v, nazwa) {
  s <- sort(v, decreasing = TRUE)
  d <- data.frame(kryterium = nazwa, x = c(0, (1:n) / n) * 100, y = c(0, cumsum(s) / sum(s)) * 100)
  d[c(1:41, seq(45, n + 1, by = 5), n + 1), ]       # do rysunku: pierwsze 40 indeksów i potem co piąty
}
k_obrot <- krzywa(obrot2, "obrót (zł)")
granice <- 100 * c(0, sum(abc == "A"), sum(abc != "C"), n) / n
pasy <- data.frame(klasa = c("A", "B", "C"), xmin = granice[1:3], xmax = granice[2:4])
p1a <- ggplot(k_obrot, aes(x, y)) +
  geom_rect(data = pasy, aes(xmin = xmin, xmax = xmax, ymin = -Inf, ymax = Inf, fill = klasa),
            inherit.aes = FALSE, alpha = 0.16) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = kol[["szary"]]) +
  geom_hline(yintercept = c(80, 95), linetype = "dotted", colour = kol[["ciemny"]]) +
  geom_line(linewidth = 1, colour = kol[["ciemny"]]) +
  annotate("label", x = (granice[1:3] + granice[2:4]) / 2, y = c(40, 55, 30), size = 3.6,
           label = sprintf("%s: %d indeksów\n%.1f%% obrotu", tab$klasa, tab$indeksy, tab$proc_obrotu)) +
  annotate("text", x = 84, y = 70, label = "przekątna = obrót\npo równo", colour = "grey40", size = 3.3) +
  scale_fill_manual(values = kol_abc, guide = "none") +
  scale_x_continuous(breaks = seq(0, 100, 20), expand = c(0, 0)) +
  scale_y_continuous(breaks = c(0, 20, 40, 60, 80, 95), expand = c(0, 0), limits = c(0, 101)) +
  labs(title = "A. Skumulowany udział w obrocie (rok 2)", x = "Skumulowany odsetek indeksów (od największego obrotu)",
       y = "Skumulowany udział w obrocie (%)") + motyw

# Rysunek 1B: te same krzywe dla sztuk i marży
k3 <- rbind(k_obrot, krzywa(szt2, "sztuki"), krzywa(zysk2, "marża (zł)"))
k3$kryterium <- factor(k3$kryterium, levels = c("obrót (zł)", "marża (zł)", "sztuki"))
p1b <- ggplot(k3, aes(x, y, colour = kryterium, linetype = kryterium)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = kol[["szary"]]) +
  geom_hline(yintercept = 80, linetype = "dotted", colour = kol[["ciemny"]]) +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = c("obrót (zł)" = kol[["ciemny"]], "marża (zł)" = kol[["cynober"]],
                                 "sztuki" = kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("obrót (zł)" = "solid", "marża (zł)" = "longdash", "sztuki" = "dotdash"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 100, 20), expand = c(0, 0)) +
  scale_y_continuous(breaks = c(0, 20, 40, 60, 80, 100), expand = c(0, 0), limits = c(0, 101)) +
  labs(title = "B. Trzy kryteria ABC", x = "Skumulowany odsetek indeksów", y = "Skumulowany udział (%)") + motyw

p1 <- p1a + p1b + plot_layout(widths = c(1.35, 1))
p1   # zapis: ggsave("abc-xyz-krzywa-lorenza.svg", p1, width = 10, height = 5.4)
Wynik w R
  klasa indeksy proc_indeksow proc_obrotu
A     A     467          23.4          80
B     B     587          29.4          15
C     C     946          47.3           5
  udzial_top20_proc udzial_top50_proc udzial_dolnych50_proc  gini
1              76.6              94.3                   5.7 0.734
           A   B    C
70/20/10 297 475 1228
75/20/5  372 682  946
80/15/5  467 587  946
85/10/5  595 459  946
90/8/2   772 592  636
na_granicy_A_B
            87
     sztuki
obrot   A   B   C
    A 307 136  24
    B 203 226 158
    C  44 243 659
  zgodnosc_obrot_sztuki_proc zgodnosc_obrot_marza_proc A_obrot_C_sztuki
1                       59.6                      87.2               24
  A_sztuki_C_obrot
1               44
            akumulatory filtry hamulce oleje i płyny oświetlenie rozrząd
A_wg_obrotu          62     46     110            27          28      88
A_wg_sztuk           23    129      91            55         110      22
            wycieraczki zawieszenie
A_wg_obrotu          27          79
A_wg_sztuk           70          54
3. Klasy XYZ, popyt sporadyczny i sezonowość: Rysunek 2
R
# Rysunek 2. Analiza XYZ: współczynnik zmienności tygodniowego popytu a tygodnie bez sprzedaży (A)
# i podział popytu według częstości i wielkości zamówień (B)
# Korzysta z obiektów przepisów 1–2: sprzedaz, grupa, n, rok1, rok2, abc, kol, kol_abc, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

# XYZ: CV = SD / średnia tygodniowej sprzedaży w sztukach (52 tygodnie roku 2)
# Progi przyjęte umownie: X ≤ 0.5, Y ≤ 1.0, Z > 1.0; indeks bez sprzedaży – osobna kategoria
klasy_xyz <- function(y) {
  m <- rowMeans(y); cv <- apply(y, 1, sd) / m
  k <- ifelse(m == 0, "brak", ifelse(cv <= 0.5, "X", ifelse(cv <= 1.0, "Y", "Z")))
  list(cv = cv, klasa = factor(k, levels = c("X", "Y", "Z", "brak")))
}
y2 <- sprzedaz[, rok2]
xyz_wynik <- klasy_xyz(y2); cv <- xyz_wynik$cv; xyz <- xyz_wynik$klasa
zera <- rowMeans(y2 == 0)                              # odsetek tygodni bez sprzedaży
table(xyz)
# Mediana CV i odsetka tygodni bez sprzedaży w klasach
aggregate(cbind(cv = round(cv, 2), tygodnie_bez_sprzedazy_proc = round(100 * zera, 1)) ~ xyz,
          data = data.frame(cv, zera, xyz)[xyz != "brak", ], FUN = median)
# Jak mocno CV zależy od samych zer: korelacja rang CV z odsetkiem pustych tygodni
round(cor(cv[xyz != "brak"], zera[xyz != "brak"], method = "spearman"), 2)

# Popyt sporadyczny: ADI (średni odstęp między tygodniami ze sprzedażą) i CV² wielkości niezerowych zamówień
adi <- ncol(y2) / rowSums(y2 > 0)
cv2_niezer <- apply(y2, 1, function(v) { v <- v[v > 0]; if (length(v) < 2) NA else (sd(v) / mean(v))^2 })
typ <- ifelse(adi <= 1.32, ifelse(cv2_niezer <= 0.49, "gładki", "nieregularny"),
              ifelse(cv2_niezer <= 0.49, "sporadyczny", "grudkowy"))
typ <- factor(typ, levels = c("gładki", "nieregularny", "sporadyczny", "grudkowy"))
table(typ_popytu = typ, xyz = xyz, useNA = "ifany")

# Sezonowość udaje zmienność: CV akumulatorów i wycieraczek przed i po podzieleniu przez indeks sezonowy
# (indeks sezonowy grupy liczony z roku 1, czyli bez zaglądania w rok oceny)
sezon_ind <- function(gr) { s <- colSums(sprzedaz[grupa == gr, rok1]); s / mean(s) }
porownaj_sezon <- function(gr) {
  sel <- grupa == gr & xyz != "brak"                     # indeksy tej grupy, które w roku 2 coś sprzedały
  y <- sweep(y2[sel, , drop = FALSE], 2, sezon_ind(gr), "/")
  cv_s <- apply(y, 1, sd) / rowMeans(y)
  data.frame(grupa = gr, indeksy = sum(sel), mediana_cv = round(median(cv[sel]), 2),
             mediana_cv_bez_sezonu = round(median(cv_s), 2), X_proc = round(100 * mean(cv[sel] <= 0.5), 1),
             X_bez_sezonu_proc = round(100 * mean(cv_s <= 0.5), 1))
}
rbind(porownaj_sezon("akumulatory"), porownaj_sezon("wycieraczki"))

# Rysunek 2A: CV a odsetek tygodni bez sprzedaży (kolor i kształt = klasa ABC)
# Na rysunku co czwarty indeks (500 z 2000), żeby plik był lekki; wszystkie liczby wyżej – z całości
d2 <- data.frame(cv, zera = 100 * zera, abc, adi, cv2_niezer)[xyz != "brak" & seq_len(n) %% 4 == 1, ]
p2a <- ggplot(d2, aes(zera, cv, colour = abc, shape = abc)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = 0.1, ymax = 0.5, fill = kol[["zielony"]], alpha = 0.10) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = 0.5, ymax = 1, fill = kol[["pomarancz"]], alpha = 0.10) +
  geom_hline(yintercept = c(0.5, 1), linetype = "dotted", colour = kol[["ciemny"]]) +
  geom_point(size = 1.1, alpha = 0.55) +
  annotate("text", x = 98, y = c(0.25, 0.75, 4.5), label = c("X", "Y", "Z"), fontface = "bold", size = 5, colour = "grey25") +
  scale_colour_manual(values = kol_abc, name = "Klasa ABC") +
  scale_shape_manual(values = c(A = 17, B = 16, C = 1), name = "Klasa ABC") +
  scale_y_log10(breaks = c(0.2, 0.5, 1, 2, 5)) +
  labs(title = "A. CV a puste tygodnie", x = "Tygodnie bez sprzedaży (%)", y = "CV tygodniowego popytu (skala log)") +
  guides(colour = guide_legend(override.aes = list(size = 2.6, alpha = 1))) + motyw

# Rysunek 2B: ADI × CV² – częstość i wielkość zamówień osobno
p2b <- ggplot(d2[!is.na(d2$cv2_niezer) & d2$cv2_niezer > 0, ], aes(adi, cv2_niezer, colour = abc, shape = abc)) +
  geom_vline(xintercept = 1.32, linetype = "dotted", colour = kol[["ciemny"]]) +
  geom_hline(yintercept = 0.49, linetype = "dotted", colour = kol[["ciemny"]]) +
  geom_point(size = 1.1, alpha = 0.55) +
  annotate("label", x = c(1.05, 1.05, 8, 8), y = c(0.05, 4, 0.05, 4), size = 3.3, linewidth = 0,
           label = c("gładki", "nieregularny", "sporadyczny", "grudkowy"), fill = "white", alpha = 0.85) +
  scale_colour_manual(values = kol_abc, name = "Klasa ABC") +
  scale_shape_manual(values = c(A = 17, B = 16, C = 1), name = "Klasa ABC") +
  scale_x_log10(breaks = c(1, 1.32, 2, 5, 10, 20)) + scale_y_log10(breaks = c(0.05, 0.2, 0.49, 1, 2, 5)) +
  labs(title = "B. Jak często i ile", x = "ADI: średni odstęp między tygodniami ze sprzedażą (log)",
       y = "CV² wielkości zamówienia (log)") +
  guides(colour = guide_legend(override.aes = list(size = 2.6, alpha = 1))) + motyw

p2 <- (p2a + p2b) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("abc-xyz-zmiennosc-popytu.svg", p2, width = 10, height = 5.6)
Wynik w R
xyz
   X    Y    Z brak
 231  803  964    2
  xyz   cv tygodnie_bez_sprzedazy_proc
1   X 0.41                         0.0
2   Y 0.75                         7.7
3   Z 1.39                        48.1
[1] 0.91
              xyz
typ_popytu       X   Y   Z brak
  gładki       231 511   0    0
  nieregularny   0 193 156    0
  sporadyczny    0  98 562    0
  grudkowy       0   1 240    0
  <NA>           0   0   6    2
        grupa indeksy mediana_cv mediana_cv_bez_sezonu X_proc X_bez_sezonu_proc
1 akumulatory     121       1.20                  1.11    0.0               4.1
2 wycieraczki     184       0.95                  0.89    1.1              14.7
4. Macierz ABC × XYZ: Rysunek 3
R
# Rysunek 3. Macierz ABC × XYZ: liczba indeksów i udział w obrocie w każdej komórce
# Korzysta z obiektów przepisów 1–3: abc, xyz, obrot2, zysk2, n, motyw. Niczego nie losuje.
library(ggplot2)

m <- data.frame(abc, xyz, obrot2, zysk2)[xyz != "brak", ]
m$xyz <- droplevels(m$xyz)
komorki <- aggregate(cbind(indeksy = 1, obrot = obrot2, marza = zysk2) ~ abc + xyz, data = m, FUN = sum)
komorki$proc_indeksow <- round(100 * komorki$indeksy / n, 1)
komorki$proc_obrotu <- round(100 * komorki$obrot / sum(obrot2), 1)
komorki[order(komorki$abc, komorki$xyz), c("abc", "xyz", "indeksy", "proc_indeksow", "proc_obrotu")]
# Ile obrotu przypada na indeksy A ze zmiennym lub sporadycznym popytem (AY + AZ)
round(sum(komorki$proc_obrotu[komorki$abc == "A" & komorki$xyz != "X"]), 1)

komorki$etykieta <- sprintf("%s%s\n%d indeksów (%.1f%%)\n%.1f%% obrotu", komorki$abc, komorki$xyz,
                            komorki$indeksy, komorki$proc_indeksow, komorki$proc_obrotu)
p3 <- ggplot(komorki, aes(xyz, abc, fill = proc_obrotu)) +
  geom_tile(colour = "white", linewidth = 1.2) +
  geom_text(aes(label = etykieta, colour = proc_obrotu > 20), size = 3.9, lineheight = 0.95) +
  scale_fill_gradient(low = "#F2F2F2", high = "#0072B2", name = "Udział w obrocie (%)") +
  scale_colour_manual(values = c("TRUE" = "white", "FALSE" = "grey15"), guide = "none") +
  scale_y_discrete(limits = c("C", "B", "A")) +
  labs(title = "Macierz ABC × XYZ (rok 2)", x = "Zmienność popytu: X (CV ≤ 0.5) – Y (0.5–1.0) – Z (> 1.0)",
       y = "Klasa ABC (obrót)") +
  motyw + theme(panel.grid = element_blank(), legend.key.width = unit(1.6, "cm"))
p3   # zapis: ggsave("abc-xyz-macierz.svg", p3, width = 10, height = 6)
Wynik w R
  abc xyz indeksy proc_indeksow proc_obrotu
1   A   X     124           6.2        26.2
4   A   Y     219          10.9        35.5
7   A   Z     124           6.2        18.4
2   B   X      87           4.3         2.3
5   B   Y     288          14.4         7.5
8   B   Z     212          10.6         5.2
3   C   X      20           1.0         0.2
6   C   Y     296          14.8         2.1
9   C   Z     628          31.4         2.7
[1] 53.9
5. Macierz przejść i symulacja: Rysunek 4
R
# Rysunek 4. Stabilność klas: macierz przejść ABC z roku 1 do roku 2 – w danych (A)
# i w 1000 symulacjach, w których popyt się nie zmienia, a działa tylko przypadek (B)
# Korzysta z obiektów przepisów 1–3: sprzedaz, mu, rozprosz, sezon, n, tyg, rok1, rok2, obrot1, cena, abc,
# klasy_abc, klasy_xyz, xyz, kol, motyw. Losuje – ma własne ziarno.
library(ggplot2)
library(patchwork)

abc1 <- klasy_abc(obrot1)
xyz1 <- klasy_xyz(sprzedaz[, rok1])$klasa
przejscia <- table(rok1 = abc1, rok2 = abc)
przejscia
round(100 * prop.table(przejscia, 1), 1)              # odsetki w wierszach: dokąd trafiły indeksy z klasy roku 1
data.frame(abc_bez_zmiany_proc = round(100 * mean(abc1 == abc), 1),
           xyz_bez_zmiany_proc = round(100 * mean(xyz1 == xyz), 1),
           obie_bez_zmiany_proc = round(100 * mean(abc1 == abc & xyz1 == xyz), 1),
           skok_A_do_C = sum(abc1 == "A" & abc == "C"), skok_C_do_A = sum(abc1 == "C" & abc == "A"))

# Symulacja: te same średnie, rozrzut i sezonowość w obu latach (bez zmiany popytu w roku 2) – 1000 powtórzeń
set.seed(651)
R <- 1000
mu_stale <- mu * sezon                                 # wektor n × 104 (kolumnami), jak w przepisie 1, ale bez „zmiany”
cv_szybko <- function(y) { s <- rowSums(y); m <- s / ncol(y)
  sqrt(pmax(rowSums(y^2) - s^2 / ncol(y), 0) / (ncol(y) - 1)) / m }
xyz_szybko <- function(y) { m <- rowMeans(y); cv <- cv_szybko(y)
  factor(ifelse(m == 0, "brak", ifelse(cv <= 0.5, "X", ifelse(cv <= 1, "Y", "Z"))), levels = c("X", "Y", "Z", "brak")) }
stale_abc <- stale_xyz <- numeric(R)
suma_przejsc <- matrix(0, 3, 3)
for (r in 1:R) {
  y <- matrix(rnbinom(n * tyg, size = rozprosz, mu = mu_stale), nrow = n)
  a1 <- klasy_abc(rowSums(y[, rok1]) * cena); a2 <- klasy_abc(rowSums(y[, rok2]) * cena)
  stale_abc[r] <- mean(a1 == a2)
  stale_xyz[r] <- mean(xyz_szybko(y[, rok1]) == xyz_szybko(y[, rok2]))
  suma_przejsc <- suma_przejsc + table(a1, a2)
}
sym_przejscia <- suma_przejsc / R
dimnames(sym_przejscia) <- list(rok1 = c("A", "B", "C"), rok2 = c("A", "B", "C"))
round(100 * prop.table(sym_przejscia, 1), 1)
data.frame(miara = c("ABC bez zmiany (%)", "XYZ bez zmiany (%)"),
           srednia = round(100 * c(mean(stale_abc), mean(stale_xyz)), 1),
           p2.5 = round(100 * c(quantile(stale_abc, 0.025), quantile(stale_xyz, 0.025)), 1),
           p97.5 = round(100 * c(quantile(stale_abc, 0.975), quantile(stale_xyz, 0.975)), 1),
           blad_MC = round(100 * c(sd(stale_abc), sd(stale_xyz)) / sqrt(R), 2))

# Rysunek 4: dwie macierze przejść (odsetki w wierszach)
do_ramki <- function(tb, panel) {
  p <- 100 * prop.table(tb, 1)
  data.frame(panel, rok1 = rep(c("A", "B", "C"), 3), rok2 = rep(c("A", "B", "C"), each = 3), proc = as.vector(p))
}
dp <- rbind(do_ramki(przejscia, "A. W danych (popyt w roku 2 zmienił się)"),
            do_ramki(sym_przejscia, "B. Sam przypadek (1000 symulacji)"))
p4 <- ggplot(dp, aes(rok2, rok1, fill = proc)) +
  geom_tile(colour = "white", linewidth = 1.2) +
  geom_text(aes(label = sprintf("%.1f%%", proc), colour = proc > 55), size = 4.4) +
  facet_wrap(~ panel) +
  scale_fill_gradient(low = "#F2F2F2", high = "#0072B2", limits = c(0, 100), name = "Odsetek indeksów z klasy w roku 1 (%)") +
  scale_colour_manual(values = c("TRUE" = "white", "FALSE" = "grey15"), guide = "none") +
  scale_y_discrete(limits = c("C", "B", "A")) +
  labs(title = "Dokąd trafiają indeksy po roku – macierz przejść ABC", x = "Klasa w roku 2", y = "Klasa w roku 1") +
  motyw + theme(panel.grid = element_blank(), legend.key.width = unit(1.6, "cm"))
p4   # zapis: ggsave("abc-xyz-macierz-przejsc.svg", p4, width = 10, height = 5.4)
Wynik w R
    rok2
rok1   A   B   C
   A 425  40   0
   B  42 482  72
   C   0  65 874
    rok2
rok1    A    B    C
   A 91.4  8.6  0.0
   B  7.0 80.9 12.1
   C  0.0  6.9 93.1
  abc_bez_zmiany_proc xyz_bez_zmiany_proc obie_bez_zmiany_proc skok_A_do_C
1                  89                84.6                 75.6           0
  skok_C_do_A
1           0
    rok2
rok1    A    B    C
   A 94.6  5.4  0.0
   B  4.2 88.7  7.1
   C  0.0  4.5 95.5
               miara srednia p2.5 p97.5 blad_MC
1 ABC bez zmiany (%)    93.3 92.4  94.2    0.01
2 XYZ bez zmiany (%)    86.3 85.0  87.6    0.02
6. Grafika: karta decyzji (Rysunek 5)
R
# Rysunek 5. Grafika: karta decyzji dla dziewięciu komórek macierzy ABC × XYZ w hurtowni części
# Samodzielny przepis: niczego nie losuje i nie korzysta z innych przepisów.
library(ggplot2)

karta <- expand.grid(xyz = c("X", "Y", "Z"), abc = c("A", "B", "C"), stringsAsFactors = FALSE)
karta$x <- match(karta$xyz, c("X", "Y", "Z"))
karta$y <- 4 - match(karta$abc, c("A", "B", "C"))
karta$tytul <- paste0(karta$abc, karta$xyz, c(
  " – filar obrotu", " – ważne, ale skacze", " – drogie i rzadkie",
  " – pewniak", " – standard", " – na żądanie",
  " – tanie i stałe", " – drobnica", " – kandydat do przeglądu"))
karta$opis <- c(
  "automatyczne uzupełnianie,\nczęste dostawy, mały zapas\nbezpieczeństwa, codzienny\nprzegląd braków",
  "prognoza z sezonowością,\nzapas z błędu prognozy,\nprzegląd co tydzień",
  "nie trzymaj dużo; dostawa\nod producenta w 24–48 h,\nprognoza metodą Crostona,\ndecyzja kupca",
  "automatyczne zamawianie,\nstały punkt zamówienia",
  "min–max, przegląd\nco miesiąc",
  "zapas minimalny albo\nzamawianie pod klienta",
  "rzadkie duże partie,\nuproszczona kontrola",
  "proste reguły min–max,\nprzegląd co kwartał",
  "wycofać, sprzedawać\nna zamówienie – chyba\nże część krytyczna")
karta$priorytet <- factor(c("wysoki", "wysoki", "wysoki", "średni", "średni", "średni", "niski", "niski", "uwaga"),
                          levels = c("wysoki", "średni", "niski", "uwaga"))
p5 <- ggplot(karta) +
  geom_tile(aes(x, y, fill = priorytet), width = 0.96, height = 0.94, colour = "grey30", linewidth = 0.4) +
  geom_text(aes(x, y + 0.31, label = tytul), fontface = "bold", size = 3.7, colour = "#0f1d3a") +
  geom_text(aes(x, y - 0.08, label = opis), size = 3.35, lineheight = 0.95, colour = "grey15") +
  annotate("text", x = 1:3, y = 3.62, label = c("X: popyt stabilny", "Y: popyt zmienny", "Z: popyt sporadyczny"),
           fontface = "bold", size = 4, colour = "grey25") +
  annotate("text", x = 0.27, y = 3:1, label = c("A\n80%\nobrotu", "B\n15%\nobrotu", "C\n5%\nobrotu"), fontface = "bold",
           size = 3.9, colour = "grey25", lineheight = 0.95) +
  scale_fill_manual(values = c("wysoki" = "#F6C9A9", "średni" = "#CFE3F2", "niski" = "#F2F2F2", "uwaga" = "#E8D5E4"),
                    labels = c("wysoki" = "kontrola ścisła", "średni" = "kontrola standardowa",
                               "niski" = "kontrola uproszczona", "uwaga" = "przegląd asortymentu"), name = NULL) +
  coord_cartesian(xlim = c(0, 3.5), ylim = c(0.5, 3.75), expand = FALSE) +
  labs(title = "Macierz ABC × XYZ – co zrobić z każdą komórką") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p5   # zapis: ggsave("abc-xyz-karta-decyzji.svg", p5, width = 10, height = 7)
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (klasa A / B)" = c("#D55E00", "#0072B2"),
             "cynober – pomarańczowy (klasa A / C)" = c("#D55E00", "#E69F00"),
             "niebieski – pomarańczowy (klasa B / C)" = c("#0072B2", "#E69F00"),
             "ciemnoszary – cynober (obrót / marża)" = c("#333333", "#D55E00"),
             "jasnopomarańczowy – jasnoniebieski (karta: ścisła / standardowa)" = c("#F6C9A9", "#CFE3F2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                 widzenie_typowe
cynober – niebieski (klasa A / B)                                          114.6
cynober – pomarańczowy (klasa A / C)                                        33.4
niebieski – pomarańczowy (klasa B / C)                                     120.2
ciemnoszary – cynober (obrót / marża)                                       83.4
jasnopomarańczowy – jasnoniebieski (karta: ścisła / standardowa)            35.4
czerwony – zielony (do unikania)                                           121.7
                                                                 deuteranopia
cynober – niebieski (klasa A / B)                                       108.3
cynober – pomarańczowy (klasa A / C)                                     18.4
niebieski – pomarańczowy (klasa B / C)                                  121.5
ciemnoszary – cynober (obrót / marża)                                    72.7
jasnopomarańczowy – jasnoniebieski (karta: ścisła / standardowa)         34.6
czerwony – zielony (do unikania)                                         21.1
                                                                 protanopia
cynober – niebieski (klasa A / B)                                      91.9
cynober – pomarańczowy (klasa A / C)                                   24.9
niebieski – pomarańczowy (klasa B / C)                                109.3
ciemnoszary – cynober (obrót / marża)                                  59.9
jasnopomarańczowy – jasnoniebieski (karta: ścisła / standardowa)       29.9
czerwony – zielony (do unikania)                                       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, sortowanie, klasy, macierze przejść i symulacja – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Progi 80/15/5 jako prawo natury. Klasa A miała od 297 do 772 indeksów zależnie od progów. Uzasadnij progi decyzją (np. pojemnością zespołu zakupów), a nie zwyczajem.
- Jedno kryterium bez uzasadnienia. Obrót, sztuki i marża dały tę samą klasę tylko części indeksów (obrót a sztuki: 59.6%).
- CV liczone z zerami. Przy popycie sporadycznym mierzy głównie liczbę pustych tygodni; indeks bez sprzedaży nie ma CV.
- Za krótki okres i zła jednostka czasu. CV z miesięcy jest mniejsze niż z tygodni, a z dni – większe. Podaj jednostkę i licz klasy na pełnym roku albo na porównywalnych okresach.
Najczęstsze pytania
Jak zrobić analizę ABC krok po kroku?
Policz wartość dla każdego indeksu (np. obrót = sztuki × cena) za ten sam okres, posortuj malejąco i policz skumulowany udział w sumie. Indeksy do 80% skumulowanego udziału to klasa A, kolejne 15% to B, reszta to C. Progi są umowne – podaj je w pracy i uzasadnij. Wykres skumulowanego udziału to obrócona krzywa Lorenza.
Jakie progi współczynnika zmienności przyjąć w analizie XYZ?
Najczęściej spotkasz X dla CV ≤ 0.5, Y dla CV od 0.5 do 1.0 i Z powyżej 1.0, ale to konwencja, a nie wynik statystyczny. CV zależy od jednostki czasu: z tygodni wychodzi większe niż z miesięcy. Podaj progi, okres i jednostkę czasu, a indeksy bez sprzedaży wyodrębnij osobno, bo nie mają CV.
Co zrobić z indeksami, które w wielu tygodniach nie mają sprzedaży?
Przy takim popycie CV mierzy głównie liczbę zer. Opisz go dwiema liczbami: średnim odstępem między okresami ze sprzedażą (ADI) i zmiennością wielkości sprzedaży, gdy już wystąpi (CV²). Do prognozy użyj metody Crostona lub jej wariantu, który prognozuje osobno wielkość i odstęp (Croston, 1972; Syntetos i Boylan, 2005).
Według czego robić analizę ABC – obrotu, ilości czy marży?
To zależy od decyzji: obrót pokazuje kapitał zamrożony w zapasie, ilość – obciążenie magazynu, marża – zysk. Krzywe koncentracji mogą wyglądać podobnie, a mimo to obejmować inne indeksy: w przykładzie obrót i sztuki dały tę samą klasę tylko 59.6% indeksów. Stały poziom obsługi dla klas wyznaczonych według wartości lub wolumenu bywa daleki od kosztowo optymalnego (Teunter i in., 2010).
Jak często przeliczać klasy ABC/XYZ?
Zwykle raz na kwartał lub pół roku, na danych z pełnego roku. Część zmian klas to przypadek: w symulacji bez zmiany popytu klasę ABC zmieniało ok. 7% indeksów, a XYZ ok. 14%. Dlatego nie reaguj na pojedyncze przejście indeksu przez granicę – porównaj macierz przejść z tym, czego można się spodziewać po samym szumie.
Powiązane hasła
Przeczytaj też
Model gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →PoradnikStatystyka w pracy z logistyki
Czasy dostaw i percentyle, błędy kompletacji na 1000 linii, przerwany szereg czasowy w magazynie, dostawcy jako skupienia i prognoza popytu: analizy, zdania APA i kod R.
Czytaj →PoradnikWartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →Robisz analizę ABC/XYZ w pracy z logistyki?
Pomożemy przygotować dane z systemu magazynowego, dobrać kryterium i progi, opisać popyt sporadyczny i sezonowy oraz zapisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Croston, J. D. (1972). Forecasting and stock control for intermittent demands. Journal of the Operational Research Society, 23(3), 289–303. https://doi.org/10.1057/jors.1972.50
- Lorenz, M. O. (1905). Methods of measuring the concentration of wealth. Publications of the American Statistical Association, 9(70), 209–219. https://doi.org/10.1080/15225437.1905.10503443
- Syntetos, A. A., & Boylan, J. E. (2005). The accuracy of intermittent demand estimates. International Journal of Forecasting, 21(2), 303–314. https://doi.org/10.1016/j.ijforecast.2004.10.001 ● Otwarty dostęp: pełny tekst
- Syntetos, A. A., Boylan, J. E., & Croston, J. D. (2005). On the categorization of demand patterns. Journal of the Operational Research Society, 56(5), 495–503. https://doi.org/10.1057/palgrave.jors.2601841 ● Otwarty dostęp
- Teunter, R. H., Babai, M. Z., & Syntetos, A. A. (2010). ABC classification: Service levels and inventory costs. Production and Operations Management, 19(3), 343–352. https://doi.org/10.1111/j.1937-5956.2009.01098.x ● Otwarty dostęp: pełny tekst
- Wilkinson, L. (2006). Revising the Pareto chart. The American Statistician, 60(4), 332–334. https://doi.org/10.1198/000313006x152243
Cytowania BibTeX
@article{croston1972forecasting, author={Croston, J. D.}, title={{Forecasting and stock control for intermittent demands}}, journal={Journal of the Operational Research Society}, year={1972}, volume={23}, number={3}, pages={289--303}, doi={10.1057/jors.1972.50}}@article{lorenz1905methods, author={Lorenz, M. O.}, title={{Methods of measuring the concentration of wealth}}, journal={Publications of the American Statistical Association}, year={1905}, volume={9}, number={70}, pages={209--219}, doi={10.1080/15225437.1905.10503443}}@article{syntetos2005accuracy, author={Syntetos, Aris A. and Boylan, John E.}, title={{The accuracy of intermittent demand estimates}}, journal={International Journal of Forecasting}, year={2005}, volume={21}, number={2}, pages={303--314}, doi={10.1016/j.ijforecast.2004.10.001}}@article{syntetos2005categorization, author={Syntetos, A. A. and Boylan, J. E. and Croston, J. D.}, title={{On the categorization of demand patterns}}, journal={Journal of the Operational Research Society}, year={2005}, volume={56}, number={5}, pages={495--503}, doi={10.1057/palgrave.jors.2601841}}@article{teunter2010abc, author={Teunter, Ruud H. and Babai, M. Zied and Syntetos, Aris A.}, title={{ABC classification: Service levels and inventory costs}}, journal={Production and Operations Management}, year={2010}, volume={19}, number={3}, pages={343--352}, doi={10.1111/j.1937-5956.2009.01098.x}}@article{wilkinson2006revising, author={Wilkinson, Leland}, title={{Revising the Pareto chart}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={332--334}, doi={10.1198/000313006x152243}}