Co to jest łańcuch Markowa?
Łańcuch Markowa (ang. Markov chain) to model ciągu stanów, w którym prawdopodobieństwo następnego stanu zależy tylko od stanu obecnego, a nie od wcześniejszej historii (własność Markowa). W wersji z czasem dyskretnym i skończoną liczbą stanów cały model opisuje macierz przejść P: element pij to prawdopodobieństwo przejścia ze stanu i do j w jednym kroku, a każdy wiersz sumuje się do 1. Norris (1997) zauważa, że dla łańcuchów Markowa wiele interesujących wielkości da się policzyć wprost. W badaniach społecznych stanami bywają np. status zatrudnienia, poziom objawów albo kategoria odpowiedzi w kolejnych falach.
Jak liczyć
Z obserwowanego ciągu liczy się przejścia w tabeli krzyżowej „stan w t × stan w t + 1”. Estymatorem największej wiarygodności jest pij = nij/ni, czyli udział przejść do j w wierszu i. Anderson i Goodman (1957) podali rozkład asymptotyczny tych estymatorów oraz testy ilorazu wiarygodności i χ² dla stałości przejść, niezależności kolejnych obserwacji i rzędu łańcucha. Prawdopodobieństwa po n krokach daje macierz Pn, a rozkład stacjonarny π spełnia π = πP.
Przykład
Zasymulowaliśmy 300 tygodni poziomu stresu (niski, średni, wysoki). Ze 108 przejść ze stanu „niski” 72 zostały w nim, więc p̂ = 0.667 (prawdziwe 0.70). Rozkład stacjonarny prawdziwej macierzy to .351, .404 i .246, a w próbie stany zajmowały 36.3%, 40.0% i 23.7% tygodni. Osoba ze stresem niskim ma za cztery tygodnie stres wysoki z prawdopodobieństwem .197; średni czas dojścia do stanu wysokiego wynosi 9.29 tygodnia ze stanu niskiego i 7.14 ze średniego. Test własności Markowa (rząd 1 wobec 2): G² = 14.02, df = 12, p = .299.
Na rysunku
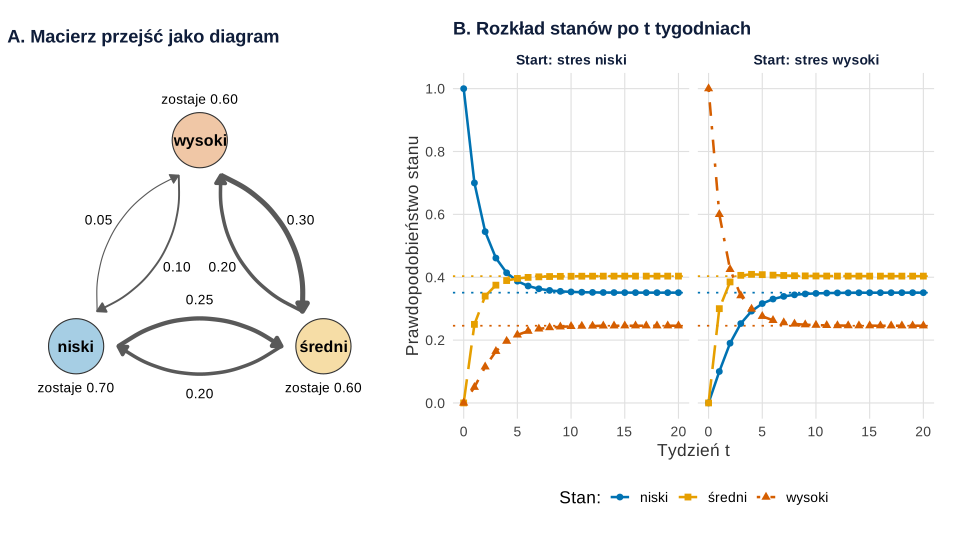
Co widać. Panel A to ta sama macierz przejść P co w przykładzie, narysowana jako diagram. Grubość strzałki rośnie z prawdopodobieństwem przejścia, a pod węzłem jest szansa pozostania w stanie (przekątna macierzy). Panel B pokazuje rozkład stanu po t tygodniach, czyli odpowiedni wiersz macierzy Pt. Po czterech tygodniach od stresu niskiego szansa stresu wysokiego wynosi .197 – tak jak w przykładzie. Przy starcie ze stresu niskiego i ze stresu wysokiego linie zbiegają do tych samych poziomów: .351, .404 i .246. To rozkład stacjonarny π. Po 8 tygodniach żadne prawdopodobieństwo nie różni się od niego o więcej niż 0.01, niezależnie od stanu startowego. Łańcuch „zapomina”, skąd wyszedł.
Na co uważać. Szybkie zbieganie wynika z tej konkretnej macierzy. Przy wartościach na przekątnej bliskich 1 łańcuch zapomina start dużo wolniej, a przy stanie pochłaniającym (np. zgon w modelu wielostanowym) rozkład stacjonarny skupia się w jednym stanie. Diagram pokazuje prawdziwe P, a nie oszacowania. Nie ma na nim liczby przejść ani niepewności, a przy rzadkich przejściach (np. niski → wysoki: 7 w danych) oszacowanie bywa nieprecyzyjne. Rysunek zakłada też, że P jest stała w czasie. Rzeczywiste przepływy osób między stanami w kolejnych falach lepiej pokazuje diagram Sankeya.
Podpis do pracy:
Kod rysunku nie losuje: liczy wszystko wprost z macierzy P z przykładu (rozkład stacjonarny jako lewy wektor własny, rozkład po t krokach przez kolejne mnożenie przez P). Ręcznie ustalono horyzont 20 tygodni i próg 0.01. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku
# Rysunek 1. Diagram przejść łańcucha z przykładu (A) i rozkład stanów po t tygodniach,
# który niezależnie od stanu startowego zbiega do rozkładu stacjonarnego (B). Bez losowania.
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(niski = "#0072B2", sredni = "#E69F00", wysoki = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
stany <- c("niski", "sredni", "wysoki")
P <- matrix(c(0.70, 0.25, 0.05,
              0.20, 0.60, 0.20,
              0.10, 0.30, 0.60), 3, byrow = TRUE, dimnames = list(stany, stany))

# rozkład stacjonarny: lewy wektor własny P dla wartości własnej 1
e <- eigen(t(P)); pi_st <- Re(e$vectors[, 1]); pi_st <- pi_st / sum(pi_st); names(pi_st) <- stany
round(pi_st, 3)
# rozkład stanu po t krokach: wiersz macierzy P^t dla stanu startowego
rozklad <- function(start, tmax = 20) {
  v <- setNames(as.numeric(stany == start), stany); out <- list()
  for (t in 0:tmax) { out[[t + 1]] <- data.frame(t, start, stan = stany, p = v); v <- v %*% P; v <- setNames(c(v), stany) }
  do.call(rbind, out)
}
dB <- rbind(rozklad("niski"), rozklad("wysoki"))
odl <- aggregate(p ~ t + start, dB, function(x) 0)              # szkielet: t × start
odl$max_roznica <- mapply(function(tt, s) max(abs(dB$p[dB$t == tt & dB$start == s] - pi_st)), odl$t, odl$start)
sapply(split(odl, odl$start), function(d) min(d$t[d$max_roznica < 0.01]))  # tygodnie do różnicy < 0.01
subset(dB, t == 4 & start == "niski", c(stan, p))               # = wiersz P^4 dla „niski”

# A. diagram: węzły w wierzchołkach trójkąta, łuki dla przejść między stanami
wezly <- data.frame(stan = stany, x = c(0, 2.4, 1.2), y = c(0, 0, 2),
                    etyk = c("niski", "średni", "wysoki"))
kraw <- expand.grid(od = stany, do = stany, stringsAsFactors = FALSE)
kraw <- subset(kraw, od != do); kraw$p <- P[cbind(kraw$od, kraw$do)]
kraw <- cbind(kraw, setNames(wezly[match(kraw$od, wezly$stan), c("x", "y")], c("x0", "y0")),
                    setNames(wezly[match(kraw$do, wezly$stan), c("x", "y")], c("x1", "y1")))
skroc <- function(a, b, f = 0.17) a + f * (b - a)                     # łuk zaczyna się i kończy przy krawędzi węzła
kraw <- transform(kraw, xs = skroc(x0, x1), ys = skroc(y0, y1), xe = skroc(x1, x0), ye = skroc(y1, y0))
kraw$xl <- (kraw$x0 + kraw$x1) / 2 - 0.19 * (kraw$y1 - kraw$y0)      # etykieta po prawej stronie kierunku łuku
kraw$yl <- (kraw$y0 + kraw$y1) / 2 + 0.19 * (kraw$x1 - kraw$x0)
petle <- data.frame(wezly, p = diag(P), yl = wezly$y + c(-0.4, -0.4, 0.4))
pA <- ggplot() +
  geom_curve(data = kraw, aes(x = xs, y = ys, xend = xe, yend = ye, linewidth = p), curvature = -0.35,
             colour = "grey35", arrow = arrow(length = unit(2.5, "mm"), type = "closed")) +
  geom_label(data = kraw, aes(xl, yl, label = sprintf("%.2f", p)), size = 3.6, linewidth = 0) +
  geom_point(data = wezly, aes(x, y, fill = stan), shape = 21, size = 19, colour = "grey20", show.legend = FALSE) +
  geom_text(data = wezly, aes(x, y, label = etyk), size = 4.2, fontface = "bold") +
  geom_text(data = petle, aes(x, yl, label = sprintf("zostaje %.2f", p)), size = 3.6) +
  scale_fill_manual(values = alpha(kol, 0.35)) + scale_linewidth(range = c(0.4, 1.8), guide = "none") +
  coord_equal(xlim = c(-0.45, 2.85), ylim = c(-0.55, 2.5)) +
  labs(title = "A. Macierz przejść jako diagram") + motyw + theme_void(base_size = 13)

etyk_start <- c(niski = "Start: stres niski", wysoki = "Start: stres wysoki")
dB$start <- factor(etyk_start[dB$start], levels = etyk_start)
pB <- ggplot(dB, aes(t, p, colour = stan, shape = stan, linetype = stan)) +
  geom_hline(data = data.frame(stan = stany, p = pi_st), aes(yintercept = p, colour = stan),
             linetype = "dotted", linewidth = 0.6, show.legend = FALSE) +
  geom_line(linewidth = 0.9) + geom_point(size = 2) +
  facet_wrap(~ start) +
  scale_colour_manual(values = kol, labels = c("niski", "średni", "wysoki"), name = "Stan:") +
  scale_shape_manual(values = c(16, 15, 17), labels = c("niski", "średni", "wysoki"), name = "Stan:") +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash"), labels = c("niski", "średni", "wysoki"), name = "Stan:") +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  labs(title = "B. Rozkład stanów po t tygodniach", x = "Tydzień t", y = "Prawdopodobieństwo stanu") +
  motyw + theme(legend.position = "bottom")
p1 <- pA + pB + plot_layout(widths = c(1, 1.25))
p1
Wynik w R
 niski sredni wysoki
 0.351  0.404  0.246
 niski wysoki
     8      8
          stan        p
niski4   niski 0.414075
sredni4 sredni 0.389375
wysoki4 wysoki 0.196550
Jak opisać w pracy
Na co uważać
- Stany obserwowane a ukryte. Gdy obserwujesz tylko wskaźniki stanu, potrzebny jest ukryty model Markowa albo podłużny wariant analizy klas latentnych.
- Czas ciągły i cenzurowanie. Przejścia między chorobą a zgonem w danych z cenzurowaniem modeluje model wielostanowy.
- Jednorodność. Stała macierz przejść to założenie; zmiany w czasie lub między grupami trzeba testować.
- Rzadkie przejścia dają nieprecyzyjne oszacowania – podawaj liczby przejść.
Łańcuch Markowa w R
Kod definiuje łańcuch o trzech stanach, symuluje z niego ciąg, szacuje macierz przejść funkcją markovchain::markovchainFit(), liczy rozkład stacjonarny, prawdopodobieństwa po czterech krokach i średnie czasy dojścia, a na końcu testuje własność Markowa. Liczby w tekście pochodzą z tego kodu.
Macierz przejść, rozkład stacjonarny i test własności Markowa
R
suppressPackageStartupMessages(library(markovchain))
set.seed(6800)
stany <- c("niski", "sredni", "wysoki")              # poziom stresu w kolejnych tygodniach
P <- matrix(c(0.70, 0.25, 0.05,
              0.20, 0.60, 0.20,
              0.10, 0.30, 0.60), 3, byrow = TRUE, dimnames = list(stany, stany))
mc <- new("markovchain", states = stany, transitionMatrix = P, name = "stres")
x <- rmarkovchain(n = 300, object = mc, t0 = "sredni")  # 300 tygodni obserwacji
table(head(x, -1), x[-1])                              # liczby przejść
fit <- markovchainFit(x, method = "mle")
round(fit$estimate@transitionMatrix, 3)                # oszacowana macierz przejść
round(steadyStates(mc), 3)                             # rozkład stacjonarny (prawdziwa P)
round(table(x) / length(x), 3)                         # udział tygodni w stanach w próbie
round((mc^4)["niski", ], 3)                            # P(stan za 4 tygodnie | dziś niski)
round(meanFirstPassageTime(mc, "wysoki"), 2)           # średni czas dojścia do „wysoki”
verifyMarkovProperty(x)                                # test własności Markowa (rzędu 1)
Wynik w R
         niski sredni wysoki
  niski     72     29      7
  sredni    30     70     20
  wysoki     7     20     44
       niski sredni wysoki
niski  0.667  0.269  0.065
sredni 0.250  0.583  0.167
wysoki 0.099  0.282  0.620
     niski sredni wysoki
[1,] 0.351  0.404  0.246
x
 niski sredni wysoki
 0.363  0.400  0.237
 niski sredni wysoki
 0.414  0.389  0.197
 niski sredni
  9.29   7.14

	Likelihood-ratio test

data:  x
G-squared = 14.024, df = 12, p-value = 0.2992
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet markovchain 1.2; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- markovchain (wersja 1.2): Spedicato, G. A. (2017). Discrete time Markov chains with R. The R Journal, 9(2), 84–104. https://doi.org/10.32614/RJ-2017-036
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak oszacować macierz przejść łańcucha Markowa z danych?
Policz przejścia między kolejnymi pomiarami w tabeli „stan w t × stan w t + 1” i podziel każdą komórkę przez sumę wiersza. To estymator największej wiarygodności; w R daje go markovchain::markovchainFit albo prop.table(table(...), 1).
Czym łańcuch Markowa różni się od ukrytego modelu Markowa?
W łańcuchu Markowa stany są obserwowane wprost. W ukrytym modelu Markowa (HMM) łańcuch dotyczy stanów nieobserwowanych, a dane to wskaźniki zależne od stanu, więc trzeba jednocześnie oszacować przejścia i prawdopodobieństwa obserwacji.
Co to jest rozkład stacjonarny łańcucha Markowa?
To rozkład stanów π, który nie zmienia się po kolejnym kroku: π = πP. W łańcuchu nieprzywiedlnym i nieokresowym prawdopodobieństwa stanów dążą do niego niezależnie od stanu początkowego, więc opisuje długookresowy udział czasu spędzanego w każdym stanie.
Powiązane hasła
Powiązane poradniki
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, T. W., & Goodman, L. A. (1957). Statistical inference about Markov chains. The Annals of Mathematical Statistics, 28(1), 89–110. https://doi.org/10.1214/aoms/1177707039 ● Otwarty dostęp
- Norris, J. R. (1997). Markov chains. Cambridge University Press. https://doi.org/10.1017/cbo9780511810633
Cytowania BibTeX
@article{anderson1957statistical, author={Anderson, T. W. and Goodman, Leo A.}, title={{Statistical inference about Markov chains}}, journal={The Annals of Mathematical Statistics}, year={1957}, volume={28}, number={1}, pages={89--110}, doi={10.1214/aoms/1177707039}}@book{norris1997markov, author={Norris, J. R.}, title={{Markov chains}}, year={1997}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511810633}}