Co to jest ukryty model Markowa?
Ukryty model Markowa (ang. hidden Markov model, HMM) to model dla szeregu obserwacji, w którym w tle działa nieobserwowany łańcuch Markowa. W każdej chwili osoba lub system jest w jednym z kilku stanów ukrytych, a obserwacja jest losową funkcją tego stanu – np. nastrój ma inną średnią w stanie „dobrym” i „obniżonym”. Rabiner (1989) wywodzi tę teorię od prac Bauma i Petriego z 1966 roku. Gdy stan ukryty jest ciągły, podobną rolę pełni model przestrzeni stanów.
Z czego składa się model
- Prawdopodobieństwa początkowe stanów.
- Macierz przejść – szansa przejścia ze stanu i do stanu j między kolejnymi pomiarami; duże wartości na przekątnej oznaczają trwałe epizody.
- Rozkłady emisji – rozkład obserwacji w każdym stanie, np. normalny z własną średnią i SD.
Rabiner opisuje trzy podstawowe problemy: wiarygodność szeregu (algorytm forward), najbardziej prawdopodobna ścieżka stanów (algorytm Viterbiego) i estymacja parametrów algorytmem Bauma–Welcha, czyli odmianą algorytmu EM. HMM przypomina analizę klas latentnych, w której przynależność do klasy zmienia się w czasie; pakiet depmixS4 szacuje oba typy modeli w jednym schemacie (Visser i Speekenbrink, 2010).
Przykład
Symulowano 300 dziennych ocen nastroju w dwóch stanach: dobrym (M = 6) i obniżonym (M = 3), z prawdopodobieństwem pozostania w stanie 0.95 i 0.90. Dwustanowy HMM odtworzył średnie 6.07 i 2.96 (SD ≈ 1.04) oraz prawdopodobieństwa pozostania 0.942 i 0.898. Ścieżka Viterbiego poprawnie przypisała 293 z 300 dni (97.7%). BIC spadło z 1221.9 dla jednego stanu do 1043.6 dla dwóch.
Na rysunku
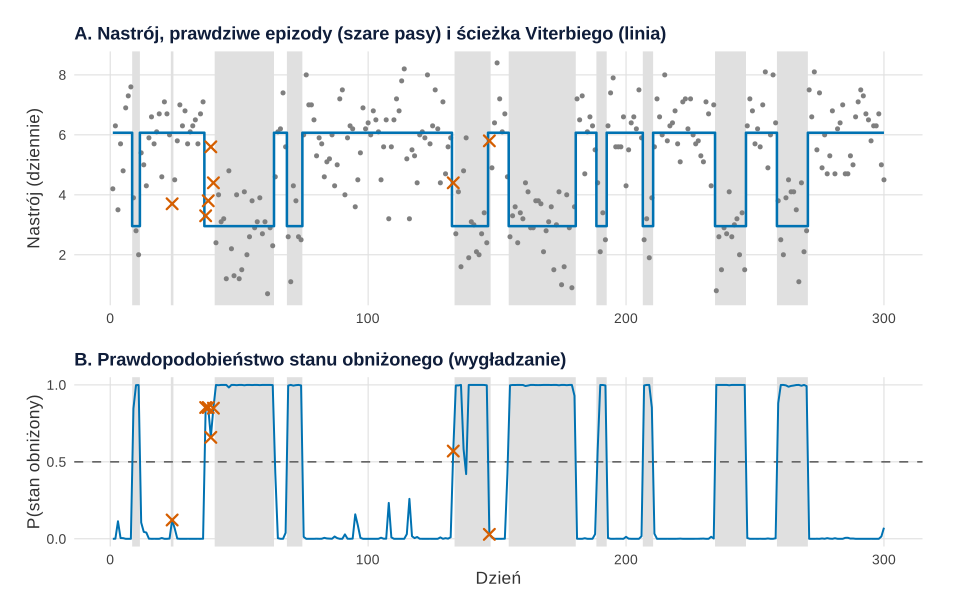
set.seed(6810)).Co widać. Szare pasy to prawdziwe epizody obniżonego nastroju, które w realnych danych byłyby nieznane. Niebieska linia w panelu A to ścieżka Viterbiego: dla każdego dnia pokazuje średnią stanu, do którego model go przypisał (6.07 albo 2.96). Ścieżka prawie pokrywa się z pasami. Krzyżyki oznaczają 7 dni z błędnym stanem (97.7% trafień). Leżą tam, gdzie zadanie jest naprawdę trudne: na granicach epizodów (dni 37–40, 133 i 147) i w epizodzie trwającym jeden dzień (dzień 24). Model „woli” trwałe stany, bo prawdopodobieństwa pozostania są wysokie. Pojedynczy niski wynik wśród dobrych dni uzna więc raczej za szum niż za zmianę stanu. Panel B pokazuje prawdopodobieństwo stanu obniżonego, liczone z całego szeregu (wygładzanie). Przez większość dni jest bliskie 0 albo 1, a tylko 19 dni ma wartość między .1 a .9.
Na co uważać. Ścieżka Viterbiego to jedna najbardziej prawdopodobna sekwencja stanów. Nie pokazuje niepewności, dlatego warto podawać obok niej prawdopodobieństwa z panelu B. Dni 37, 38 i 40 mają w panelu B wartość .85, a mimo to są błędne. Wysokie prawdopodobieństwo nie gwarantuje więc trafienia. Tu stany dobrze się rozdzielają, bo średnie różnią się o 3 SD. Przy bliższych średnich krzyżyków byłoby dużo więcej. Rysunek zakłada też, że liczba stanów (2) jest znana. W realnych danych wybiera się ją kryteriami informacyjnymi.
Podpis do pracy:
Kod rysunku używa tego samego ziarna, tych samych danych i tego samego dopasowania co przykład (set.seed(6810), ustalone raz; wartości startowe EM pochodzą z tego samego strumienia liczb losowych, więc model jest identyczny). Szare pasy z prawdziwymi stanami można narysować tylko dlatego, że dane są symulowane. Ręcznie ustalono jedynie próg .1–.9 dla „dni niepewnych”. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku
# Rysunek 1. Obserwowany nastrój z prawdziwymi epizodami obniżonego nastroju i ścieżką Viterbiego (A)
# oraz prawdopodobieństwo stanu obniżonego dla każdego dnia (B); dane i model z przykładu w haśle
suppressPackageStartupMessages({library(depmixS4); library(ggplot2); library(patchwork)})
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", szary = "grey50", tlo = "grey88")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
set.seed(6810)                                     # to samo ziarno, dane i dopasowanie co w przykładzie
n <- 300
P <- matrix(c(0.95, 0.05,
              0.10, 0.90), 2, byrow = TRUE)
stan <- numeric(n); stan[1] <- 1
for (t in 2:n) stan[t] <- sample(1:2, 1, prob = P[stan[t - 1], ])
nastroj <- round(rnorm(n, mean = c(6, 3)[stan], sd = 1), 1)   # stan 1: dobry, stan 2: obniżony
dane <- data.frame(nastroj)
fit <- fit(depmix(nastroj ~ 1, data = dane, nstates = 2, family = gaussian()), verbose = FALSE)

srednie <- sapply(1:2, function(k) getpars(fit@response[[k]][[1]])[1])   # średnie w stanach modelu
obnizony <- which.min(srednie)                     # numer stanu modelu o niższej średniej
vit <- posterior(fit, type = "viterbi")$state
p_obn <- posterior(fit, type = "smoothing")[, obnizony]   # P(stan obniżony | cały szereg)
d <- data.frame(dzien = 1:n, nastroj, prawdziwy_obn = stan == 2, vit_obn = vit == obnizony,
                srednia_vit = srednie[vit], p_obn)
d$blad <- d$prawdziwy_obn != d$vit_obn
round(srednie, 2)
c(dni_bledne = sum(d$blad), odsetek_trafien = round(100 * mean(!d$blad), 1))
d[d$blad, c("dzien", "nastroj", "prawdziwy_obn", "p_obn")] |> transform(p_obn = round(p_obn, 2))
c(dni_niepewne = sum(d$p_obn > 0.1 & d$p_obn < 0.9))   # dni z prawdopodobieństwem między .1 a .9

# epizody prawdziwego stanu obniżonego jako szare pasy
r <- rle(d$prawdziwy_obn); koniec <- cumsum(r$lengths); poczatek <- koniec - r$lengths + 1
pasy <- data.frame(od = poczatek - 0.5, do = koniec + 0.5)[r$values, ]
pA <- ggplot(d, aes(dzien, nastroj)) +
  geom_rect(data = pasy, aes(xmin = od, xmax = do, ymin = -Inf, ymax = Inf), inherit.aes = FALSE, fill = kol[["tlo"]]) +
  geom_point(aes(shape = blad), colour = kol[["szary"]], size = 1.4) +
  geom_step(aes(y = srednia_vit), colour = kol[["niebieski"]], linewidth = 0.9, direction = "mid") +
  geom_point(data = d[d$blad, ], shape = 4, size = 3, stroke = 1.2, colour = kol[["pomaranczowy"]]) +
  scale_shape_manual(values = c(`FALSE` = 16, `TRUE` = 4), guide = "none") +
  labs(title = "A. Nastrój, prawdziwe epizody (szare pasy) i ścieżka Viterbiego (linia)",
       x = NULL, y = "Nastrój (dziennie)") + motyw
pB <- ggplot(d, aes(dzien, p_obn)) +
  geom_rect(data = pasy, aes(xmin = od, xmax = do, ymin = -Inf, ymax = Inf), inherit.aes = FALSE, fill = kol[["tlo"]]) +
  geom_hline(yintercept = 0.5, linetype = "dashed", colour = "grey40") +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.7) +
  geom_point(data = d[d$blad, ], shape = 4, size = 3, stroke = 1.2, colour = kol[["pomaranczowy"]]) +
  scale_y_continuous(breaks = c(0, 0.5, 1)) +
  labs(title = "B. Prawdopodobieństwo stanu obniżonego (wygładzanie)",
       x = "Dzień", y = "P(stan obniżony)") + motyw
p1 <- pA / pB + plot_layout(heights = c(1.5, 1))
p1
Wynik w R
converged at iteration 30 with logLik: -501.8365
(Intercept) (Intercept)
       2.96        6.07
     dni_bledne odsetek_trafien
            7.0            97.7
    dzien nastroj prawdziwy_obn p_obn
24     24     3.7          TRUE  0.12
37     37     3.3         FALSE  0.85
38     38     3.8         FALSE  0.85
39     39     5.6         FALSE  0.66
40     40     4.4         FALSE  0.85
133   133     4.4         FALSE  0.57
147   147     5.8          TRUE  0.03
dni_niepewne
          19
Jak opisać w pracy
Na co uważać
- Zamiana etykiet. Numeracja stanów jest umowna: w przykładzie stan 1 modelu to stan obniżony. Nazywaj stany po parametrach, nie po numerach.
- Maksima lokalne. EM zależy od wartości startowych – dopasuj model kilkakrotnie i wybierz najwyższą wiarygodność.
- Liczba stanów. Porównuj modele kryteriami AIC i BIC, i oceniaj sens merytoryczny stanów.
- Długość szeregu. Macierz przejść szacuje się ze zmian stanu; w przykładzie było tylko 10 epizodów obniżonego nastroju, więc krótkie szeregi dają niestabilne oszacowania.
Pokrewny model bez zależności czasowej pokazuje wpis Analiza klas latentnych (LCA) krok po kroku.
Ukryty model Markowa w R
Kod symuluje szereg z dwoma stanami ukrytymi, dopasowuje dwustanowy HMM funkcją depmixS4::depmix(), odtwarza ścieżkę stanów algorytmem Viterbiego i porównuje BIC z modelem jednostanowym. Liczby w tekście pochodzą z tego kodu.
Ukryty model Markowa w R
R
suppressPackageStartupMessages(library(depmixS4))
set.seed(6810)
n <- 300                                           # 300 dni pomiaru nastroju (dane symulowane)
P <- matrix(c(0.95, 0.05,
              0.10, 0.90), 2, byrow = TRUE)        # prawdziwe prawdopodobieństwa przejść
stan <- numeric(n); stan[1] <- 1
for (t in 2:n) stan[t] <- sample(1:2, 1, prob = P[stan[t - 1], ])
nastroj <- round(rnorm(n, mean = c(6, 3)[stan], sd = 1), 1)   # stan 1: dobry, stan 2: obniżony
dane <- data.frame(nastroj)
mod <- depmix(nastroj ~ 1, data = dane, nstates = 2, family = gaussian())
fit <- fit(mod, verbose = FALSE)
summary(fit)
round(c(logLik = as.numeric(logLik(fit)), AIC = AIC(fit), BIC = BIC(fit)), 1)
st <- posterior(fit, type = "viterbi")$state       # najbardziej prawdopodobna ścieżka stanów
table(prawdziwy = stan, viterbi = st)
c(dni_w_stanie_2 = sum(stan == 2), epizody_stanu_2 = sum(diff(c(1, stan)) == 1))
fit1 <- fit(depmix(nastroj ~ 1, data = dane, nstates = 1, family = gaussian()), verbose = FALSE)
round(c(BIC_1_stan = BIC(fit1), BIC_2_stany = BIC(fit)), 1)
Wynik w R
converged at iteration 30 with logLik: -501.8365
Initial state probabilities model
pr1 pr2
  0   1

Transition matrix
        toS1  toS2
fromS1 0.898 0.102
fromS2 0.058 0.942

Response parameters
Resp 1 : gaussian
    Re1.(Intercept) Re1.sd
St1           2.955  1.035
St2           6.071  1.041
logLik    AIC    BIC
-501.8 1017.7 1043.6
         viterbi
prawdziwy   1   2
        1   5 190
        2 103   2
 dni_w_stanie_2 epizody_stanu_2
            105              10
converged at iteration 1 with logLik: -605.266
 BIC_1_stan BIC_2_stany
     1221.9      1043.6
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet depmixS4 1.5-4; rysunek 1 – także pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- depmixS4 (wersja 1.5-4): Visser, I., & Speekenbrink, M. (2010). depmixS4: An R package for hidden Markov models. Journal of Statistical Software, 36(7). https://doi.org/10.18637/jss.v036.i07
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym ukryty model Markowa różni się od łańcucha Markowa?
W łańcuchu Markowa stany są obserwowane bezpośrednio. W HMM widzimy tylko obserwacje, których rozkład zależy od stanu, a same stany i przejścia między nimi trzeba oszacować z danych.
Czym HMM różni się od analizy klas latentnych?
Analiza klas latentnych przypisuje każdą osobę do jednej klasy i traktuje obserwacje jako niezależne. HMM pozwala, by klasa (stan) zmieniała się między kolejnymi pomiarami, a zależność między pomiarami opisuje macierz przejść.
Jak dopasować ukryty model Markowa w R?
Najprościej pakietem depmixS4: depmix(y ~ 1, nstates = 2, family = gaussian()), potem fit() i posterior(..., type = "viterbi") dla ścieżki stanów. Dla obserwacji kategorialnych można też użyć pakietu HMM.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Rabiner, L. R. (1989). A tutorial on hidden Markov models and selected applications in speech recognition. Proceedings of the IEEE, 77(2), 257–286. https://doi.org/10.1109/5.18626
- Visser, I., & Speekenbrink, M. (2010). depmixS4: An R package for hidden Markov models. Journal of Statistical Software, 36(7). https://doi.org/10.18637/jss.v036.i07 ● Otwarty dostęp
Cytowania BibTeX
@article{rabiner1989tutorial, author={Rabiner, Lawrence R.}, title={{A tutorial on hidden Markov models and selected applications in speech recognition}}, journal={Proceedings of the IEEE}, year={1989}, volume={77}, number={2}, pages={257--286}, doi={10.1109/5.18626}}@article{visser2010depmixs4, author={Visser, Ingmar and Speekenbrink, Maarten}, title={{depmixS4: An R package for hidden Markov models}}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={7}, doi={10.18637/jss.v036.i07}}