Co to jest model przestrzeni stanów?
Model przestrzeni stanów (ang. state space model) opisuje szereg czasowy dwoma równaniami. Równanie obserwacji wiąże pomiar z nieobserwowanym stanem (np. „prawdziwym” poziomem zjawiska) i szumem pomiaru, a równanie stanu mówi, jak ten stan zmienia się z okresu na okres. Filtr Kalmana to rekurencyjny algorytm, który po każdej nowej obserwacji aktualizuje oszacowanie stanu i jego niepewność. Kalman (1960) zaproponował go jako metodę działającą bez zmian dla procesów stacjonarnych i niestacjonarnych, więc szereg nie musi spełniać założenia stacjonarności. Gdy stan jest dyskretny, odpowiednikiem jest ukryty model Markowa.
Jak działa filtr
Najprostszy przypadek to model lokalnego poziomu: yt = μt + εt (wariancja szumu H), μt+1 = μt + ηt (wariancja zmian poziomu Q). Filtr najpierw prognozuje poziom, a potem przesuwa go o część błędu prognozy: K = P/(P + H), gdzie P to niepewność prognozy. Wariancje szacuje się metodą największej wiarygodności. Filtr korzysta tylko z danych do chwili t; wygładzanie używa całego szeregu. W tej postaci da się zapisać m.in. modele ARIMA i wygładzanie wykładnicze.
Przykład
Dla rocznego przepływu Nilu (1871–1970, zbiór Nile) model lokalnego poziomu dał Q = 1469.1 i H = 15098.6; KFAS zwrócił te same wartości. Stosunek sygnału do szumu 0.097 daje ustalone K = 0.267. Po niskim odczycie z 1899 roku (774) filtrowany poziom spadł z 1133.1 do 1037.2, a wygładzony – liczony z całego szeregu – wynosił 950.9. Ręczna pętla odtworzyła filtr KFAS.
Na rysunku
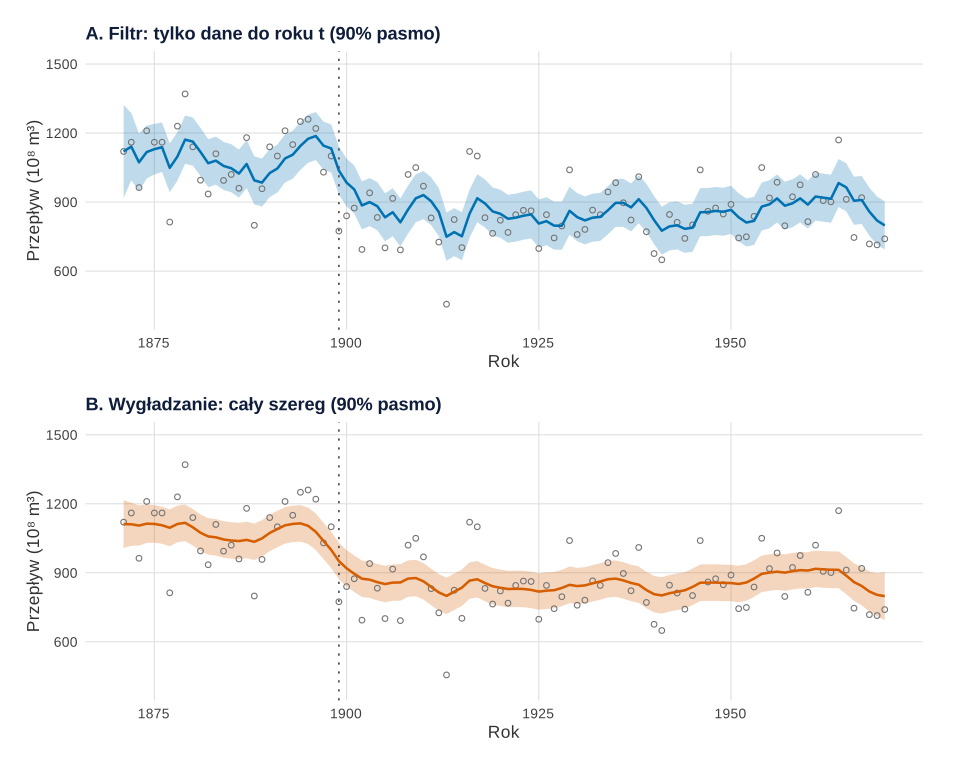
Nile).Co widać. Ten sam model co w przykładzie. Filtr (panel A) zna tylko dane do roku t, więc reaguje na każdy odczyt i spóźnia się: w 1898 roku pokazuje jeszcze 1133.1, po niskim odczycie z 1899 roku schodzi do 1037.2, a w 1901 roku nadal pokazuje 955.0. Wygładzanie (panel B) korzysta też z lat późniejszych, więc spadek „widzi” wcześniej: 999.6 w 1898 i 950.9 w 1899 roku, a w 1910 roku 863.0 wobec 930.3 z filtru. Pasmo wygładzone jest węższe – od 1876 roku średnio 159.9 wobec 209.0 dla filtru. W ostatnim roku oba pasma mają tę samą szerokość (208.9), bo po 1970 roku nie ma już danych, które mogłyby poprawić oszacowanie.
Na co uważać. Pasma dotyczą poziomu μt, a nie pojedynczych pomiarów – wiele punktów leży poza nimi i tak ma być, bo szum pomiaru (H) jest około dziesięć razy większy niż wariancja zmian poziomu. Pasma nie uwzględniają też niepewności oszacowanych wariancji Q i H. Pierwsze lata filtru (pasmo 292.4 w 1872 roku) odzwierciedlają start rozproszony, nie dane. Wykres nie sprawdza, czy model jest dobry – do tego służą innowacje i ich autokorelacja. Poziom 90% (±1.645 SD stanu) wybraliśmy ręcznie dla czytelności.
Podpis do pracy:
Dane są wbudowane w R, więc kod nic nie losuje. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Nil 1871–1970: obserwacje, poziom filtrowany i wygładzony z 90% pasmami (model lokalnego poziomu, KFAS)
suppressPackageStartupMessages({library(KFAS); library(ggplot2); library(patchwork)})
kol <- c(filtr = "#0072B2", wygl = "#D55E00", obs = "grey45")   # Okabe–Ito + szary
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
y <- Nile                                                # dane wbudowane, bez losowania
mod <- SSModel(y ~ SSMtrend(1, Q = list(matrix(NA))), H = matrix(NA))
fit <- fitSSM(mod, inits = log(c(var(y), var(y))), method = "BFGS")
out <- KFS(fit$model, smoothing = "state")
z <- qnorm(0.95)                                         # 90% pasmo: ±1.645 SD stanu
d <- data.frame(rok = 1871:1970, y = as.numeric(y),
                filtr = as.numeric(out$att), sd_f = sqrt(as.numeric(out$Ptt)),
                wygl = as.numeric(out$alphahat), sd_w = sqrt(as.numeric(out$V)))
szer_f <- 2 * z * d$sd_f; szer_w <- 2 * z * d$sd_w
round(c(szer_filtr_1872 = szer_f[2], szer_filtr_1970 = szer_f[100],
        szer_filtr_srednio_od_1876 = mean(szer_f[6:100]),
        szer_wygl_srednio_od_1876 = mean(szer_w[6:100]), szer_wygl_1970 = szer_w[100]), 1)
d[d$rok %in% c(1898, 1899, 1900, 1910), c("rok", "y", "filtr", "wygl")] |> round(1)
panel <- function(srodek, sd, kolor, tytul) {
  ggplot(d, aes(rok)) +
    geom_ribbon(aes(ymin = .data[[srodek]] - z * .data[[sd]], ymax = .data[[srodek]] + z * .data[[sd]]),
                fill = kolor, alpha = 0.25) +
    geom_point(aes(y = y), colour = kol[["obs"]], shape = 1, size = 1.6) +
    geom_line(aes(y = .data[[srodek]]), colour = kolor, linewidth = 0.9) +
    geom_vline(xintercept = 1899, linetype = "dotted", colour = "grey30") +
    coord_cartesian(ylim = c(400, 1500)) +
    labs(title = tytul, x = "Rok", y = "Przepływ (10⁸ m³)")
}
p1 <- panel("filtr", "sd_f", kol[["filtr"]], "A. Filtr: tylko dane do roku t (90% pasmo)") /
      panel("wygl", "sd_w", kol[["wygl"]], "B. Wygładzanie: cały szereg (90% pasmo)") & motyw
p1
Wynik w R (rysunek 1)
           szer_filtr_1872            szer_filtr_1970
                     292.4                      208.9
szer_filtr_srednio_od_1876  szer_wygl_srednio_od_1876
                     209.0                      159.9
            szer_wygl_1970
                     208.9
    rok    y  filtr  wygl
28 1898 1100 1133.1 999.6
29 1899  774 1037.2 950.9
30 1900  840  984.6 919.5
40 1910  969  930.3 863.0
Jak opisać w pracy
Na co uważać
- Filtr a wygładzanie. Do prognoz i bieżącego monitorowania raportuj filtr, do opisu historii – stan wygładzony.
- Diagnostyka. Standaryzowane błędy prognozy (innowacje) powinny być białym szumem; sprawdź je testem Ljunga–Boxa.
- Start filtru. Pierwsze oszacowania są bardzo niepewne; pakiety stosują start rozproszony, a ręczna pętla przybliża go dużym P.
- Brakujące składniki. Model lokalnego poziomu nie ma trendu ani sezonowości – dodaj je jako osobne stany.
Filtr Kalmana w R
Kod dopasowuje model lokalnego poziomu do szeregu Nile bazową funkcją StructTS() i pakietem KFAS, a potem liczy filtr Kalmana ręcznie, żeby pokazać wzór aktualizacji. Liczby w tekście pochodzą z tego kodu.
Filtr Kalmana w R
R
suppressPackageStartupMessages(library(KFAS))
y <- Nile                                          # roczny przepływ Nilu w Asuanie, 1871–1970 (n = 100)
fit0 <- StructTS(y, type = "level")                # model lokalnego poziomu, ML w bazowym R
round(fit0$coef, 1)                                # wariancja poziomu (level) i szumu (epsilon)
mod <- SSModel(y ~ SSMtrend(1, Q = list(matrix(NA))), H = matrix(NA))
fit <- fitSSM(mod, inits = log(c(var(y), var(y))), method = "BFGS")
round(c(H = fit$model$H[1], Q = fit$model$Q[1]), 1)  # te same wariancje z KFAS
out <- KFS(fit$model, smoothing = "state")
H <- fit$model$H[1]; Q <- fit$model$Q[1]           # filtr Kalmana ręcznie (dla ilustracji wzoru)
a <- y[1]; P <- 1e7; filt <- numeric(length(y))     # start rozproszony: bardzo duża wariancja
for (t in seq_along(y)) {
  K <- P / (P + H)                                  # wzmocnienie Kalmana
  a <- a + K * (y[t] - a); P <- P * (1 - K)         # aktualizacja po obserwacji
  filt[t] <- a; P <- P + Q                          # prognoza na kolejny rok
}
lata <- c(1897, 1898, 1899, 1900, 1901)
tab <- rbind(obserwacja = y[lata - 1870], filtr_KFAS = out$att[lata - 1870],
             filtr_recznie = filt[lata - 1870], wygladzony = out$alphahat[lata - 1870])
colnames(tab) <- lata; round(tab, 1)              # spadek przepływu po 1898 roku
round(c(K_ustalone = K, sygnal_szum = Q / H), 3)
Wynik w R
  level epsilon
 1469.1 15098.6
      H       Q
15098.7  1469.2
                1897   1898   1899  1900  1901
obserwacja    1030.0 1100.0  774.0 840.0 874.0
filtr_KFAS    1145.2 1133.1 1037.2 984.6 955.0
filtr_recznie 1145.2 1133.1 1037.2 984.6 955.0
wygladzony    1038.5  999.6  950.9 919.5 895.8
 K_ustalone sygnal_szum
      0.267       0.097
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet KFAS 1.6.0). Rysunek 1 wykonano w pakietach ggplot2 4.0.2 i patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- KFAS (wersja 1.6.0): Helske, J. (2017). KFAS: Exponential family state space models in R. Journal of Statistical Software, 78(10). https://doi.org/10.18637/jss.v078.i10
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym filtr Kalmana różni się od wygładzania wykładniczego?
W modelu lokalnego poziomu ustalone wzmocnienie Kalmana działa jak współczynnik α prostego wygładzania wykładniczego. Różnica: model przestrzeni stanów szacuje wariancje z danych, daje przedziały niepewności i łatwo przyjmuje dodatkowe składniki, np. trend, sezonowość lub predyktory.
Czy filtr Kalmana radzi sobie z brakującymi danymi?
Tak. Gdy brakuje obserwacji, filtr pomija krok aktualizacji i tylko prognozuje stan, a jego niepewność rośnie. W KFAS i StructTS wystarczy zostawić NA w szeregu.
Którą funkcję R wybrać do modelu przestrzeni stanów?
Do prostych modeli strukturalnych (poziom, trend, sezonowość) wystarczy bazowa StructTS(). Pakiet KFAS pozwala budować dowolne modele liniowe, także z obserwacjami Poissona czy dwumianowymi, i daje filtr, wygładzanie oraz diagnostykę.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Helske, J. (2017). KFAS: Exponential family state space models in R. Journal of Statistical Software, 78(10). https://doi.org/10.18637/jss.v078.i10 ● Otwarty dostęp
- Kalman, R. E. (1960). A new approach to linear filtering and prediction problems. Journal of Basic Engineering, 82(1), 35–45. https://doi.org/10.1115/1.3662552
Cytowania BibTeX
@article{helske2017kfas, author={Helske, Jouni}, title={{KFAS: Exponential family state space models in R}}, journal={Journal of Statistical Software}, year={2017}, volume={78}, number={10}, doi={10.18637/jss.v078.i10}}@article{kalman1960new, author={Kalman, Rudolf E.}, title={{A new approach to linear filtering and prediction problems}}, journal={Journal of Basic Engineering}, year={1960}, volume={82}, number={1}, pages={35--45}, doi={10.1115/1.3662552}}