Co to jest test Ljunga–Boxa?
Test Ljunga–Boxa (ang. Ljung–Box test, test typu portmanteau) sprawdza łącznie, czy pierwsze h współczynników autokorelacji szeregu albo reszt modelu jest równe zero. Hipoteza zerowa: szum biały, czyli brak autokorelacji do opóźnienia h. Test służy głównie do diagnostyki modeli ARIMA. Box i Pierce (1970) wyszli od tego, że dobrze dopasowany model zamienia dane w szum biały, więc jego dopasowanie ocenia się na podstawie autokorelacji reszt. Ljung i Box (1978) zmodyfikowali ich statystykę tak, by jej rozkład był znacznie lepiej przybliżony.
Wzór i stopnie swobody
Q = n(n + 2) Σ rk²/(n − k) dla k = 1, …, h, gdzie rk to autokorelacja przy opóźnieniu k. Przy prawdziwej H0 Q ma w przybliżeniu rozkład chi-kwadrat z h stopniami swobody. Dla reszt modelu ARMA(p, q) liczba stopni swobody wynosi h − p − q; w R podaje się ją argumentem fitdf funkcji Box.test(). Starsza wersja Boxa–Pierce’a to Q = n Σ rk².
Przykład
Do 120 miesięcy danych symulowanych z procesu AR(2) dopasowano najpierw za prosty model AR(1) (współczynnik 0.571). Dla jego reszt Q(11) = 31.32, p < .001 (12 opóźnień, fitdf = 1); wersja Boxa–Pierce’a dała 29.55, p = .002. Model AR(2) (współczynniki 0.403 i 0.312, AIC = 481.2 wobec 491.0) zostawił reszty bez wyraźnej autokorelacji: Q(10) = 12.94, p = .227.
Na rysunku
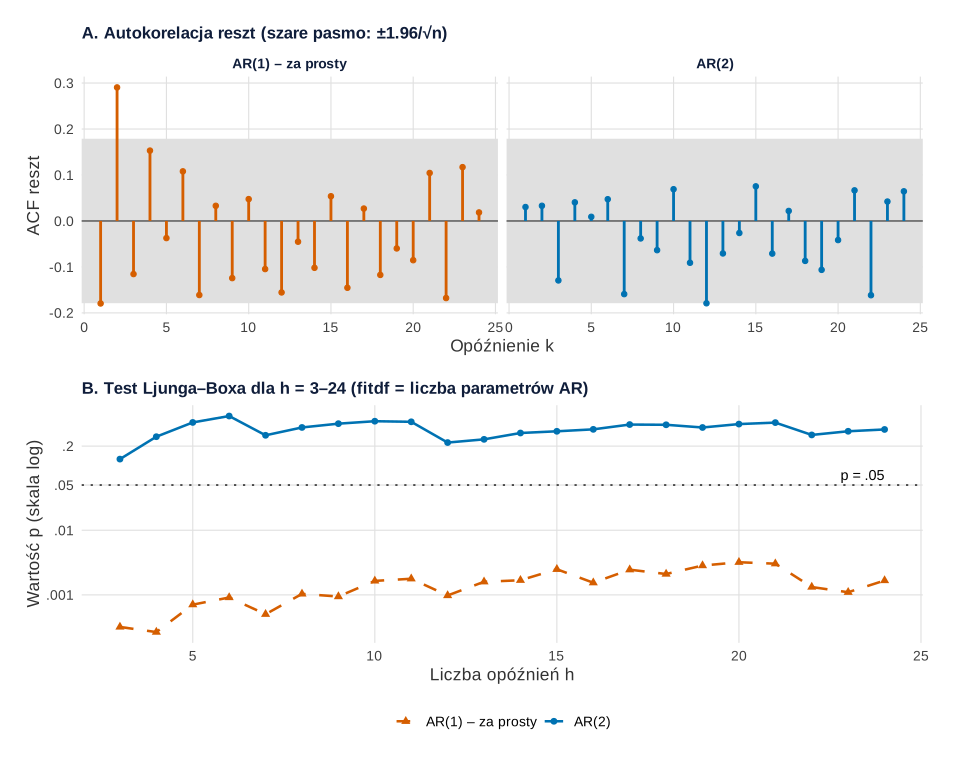
set.seed(6320)).Co widać. Te same dane i modele co w przykładzie. Reszty za prostego modelu AR(1) mają wyraźną autokorelację przy opóźnieniu 2 (0.290), czyli tam, gdzie brakuje drugiego członu AR; tuż za granicą pasma ±0.179 leży też opóźnienie 1 (−0.179). Test Ljunga–Boxa łączy te słupki w jedną liczbę i dla każdego h od 3 do 24 daje p między .0003 a .0032. Dla reszt AR(2) wartości p mieszczą się między .126 a .584, a przy h = 12 wynoszą .227, jak w przykładzie.
Na co uważać. W resztach AR(2) jeden słupek (opóźnienie 12, −0.179) dotyka granicy pasma. Przy 24 opóźnieniach i paśmie 95% około jednego takiego słupka należy się spodziewać nawet przy szumie białym, dlatego nie ocenia się pojedynczych słupków, tylko test łączny. Panel B pokazuje, że p zmienia się z h: tutaj wniosek jest ten sam dla każdego h, ale przy granicznych danych wybór h po obejrzeniu wykresu mógłby zmienić decyzję – stąd zasada, by ustalić go z góry. Pasmo ±1.96/√n to przybliżenie dla szumu białego; nie uwzględnia tego, że reszty pochodzą z dopasowanego modelu. Wysokie p nie dowodzi, że model jest dobry – test sprawdza tylko autokorelację liniową. Zakres h = 3–24 wybraliśmy ręcznie (od 3, bo przy fitdf = 2 potrzeba h > 2).
Podpis do pracy:
Ziarno set.seed(6320) to ziarno danych z przykładu; nie było zmieniane. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. ACF reszt AR(1) i AR(2) z pasmami ±1.96/√n oraz p Ljunga–Boxa w funkcji liczby opóźnień h
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("AR(1) – za prosty" = "#D55E00", "AR(2)" = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA))

set.seed(6320)                                           # te same dane co w przykładzie wyżej
n <- 120
y <- 30 + arima.sim(list(ar = c(0.5, 0.3)), n = n, sd = 2)
m1 <- arima(y, order = c(1, 0, 0))
m2 <- arima(y, order = c(2, 0, 0))
res <- list("AR(1) – za prosty" = resid(m1), "AR(2)" = resid(m2))
p_fit <- c("AR(1) – za prosty" = 1, "AR(2)" = 2)          # fitdf = liczba parametrów AR

acf_d <- do.call(rbind, lapply(names(res), function(m)
  data.frame(model = m, k = 1:24, r = acf(res[[m]], lag.max = 24, plot = FALSE)$acf[2:25])))
granica <- 1.96 / sqrt(n)
lb <- do.call(rbind, lapply(names(res), function(m) do.call(rbind, lapply(3:24, function(h)
  data.frame(model = m, h = h, p = Box.test(res[[m]], lag = h, type = "Ljung-Box", fitdf = p_fit[[m]])$p.value)))))
round(granica, 3)
transform(subset(acf_d, abs(r) > granica), r = round(r, 3))   # słupki ACF poza pasmem (k = 1–24)
zakres <- round(do.call(rbind, tapply(lb$p, lb$model, range)), 4)   # najmniejsze i największe p dla h = 3–24
colnames(zakres) <- c("p_min", "p_max"); zakres
w <- subset(lb, h %in% c(3, 6, 12, 24)); w$p <- round(w$p, 4); w

acf_d$model <- factor(acf_d$model, names(kol)); lb$model <- factor(lb$model, names(kol))
pa <- ggplot(acf_d, aes(k, r, colour = model)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = -granica, ymax = granica, fill = "grey88") +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_segment(aes(xend = k, yend = 0), linewidth = 1) + geom_point(size = 1.5) +
  facet_wrap(~ model) + scale_colour_manual(values = kol, guide = "none") +
  labs(title = "A. Autokorelacja reszt (szare pasmo: ±1.96/√n)", x = "Opóźnienie k", y = "ACF reszt")
pb <- ggplot(lb, aes(h, p, colour = model, shape = model, linetype = model)) +
  geom_hline(yintercept = 0.05, linetype = "dotted", colour = "grey20") +
  annotate("text", x = 24, y = 0.05, label = "p = .05", vjust = -0.5, hjust = 1, size = 3.8) +
  geom_line(linewidth = 0.9) + geom_point(size = 2) +
  scale_y_log10(breaks = c(0.0001, 0.001, 0.01, 0.05, 0.2, 1), labels = c(".0001", ".001", ".01", ".05", ".2", "1")) +
  scale_colour_manual(values = kol) + scale_shape_manual(values = c(17, 16)) +
  scale_linetype_manual(values = c("dashed", "solid")) +
  labs(title = "B. Test Ljunga–Boxa dla h = 3–24 (fitdf = liczba parametrów AR)",
       x = "Liczba opóźnień h", y = "Wartość p (skala log)", colour = NULL, shape = NULL, linetype = NULL)
p1 <- (pa / pb) & motyw
p1
Wynik w R (rysunek 1)
[1] 0.179
               model  k      r
1  AR(1) – za prosty  1 -0.179
2  AR(1) – za prosty  2  0.290
36             AR(2) 12 -0.179
                   p_min  p_max
AR(1) – za prosty 0.0003 0.0032
AR(2)             0.1259 0.5837
               model  h      p
1  AR(1) – za prosty  3 0.0003
4  AR(1) – za prosty  6 0.0009
10 AR(1) – za prosty 12 0.0010
22 AR(1) – za prosty 24 0.0017
23             AR(2)  3 0.1259
26             AR(2)  6 0.5837
32             AR(2) 12 0.2269
44             AR(2) 24 0.3620
Jak opisać w pracy
Na co uważać
- Liczba opóźnień zmienia wynik. Hassani i Yeganegi (2020) pokazali w symulacji, że rozmiar i moc testu zależą od h, a optymalna wartość zależy od długości szeregu i poziomu istotności. Ustal h przed analizą.
- Bez
fitdftest reszt ma za dużo stopni swobody, więc wartość p jest zawyżona i model wygląda na lepiej dopasowany. - Brak istotności to nie dowód. W krótkich szeregach test ma małą moc.
- Regresja. Test Durbina–Watsona sprawdza tylko opóźnienie 1 w resztach regresji; szersze podejście opisuje hasło autokorelacja reszt.
Test w pełnej analizie z prognozą pokazuje wpis Szeregi czasowe i ARIMA w praktyce.
Test Ljunga–Boxa w R
Kod dopasowuje do szeregu AR(2) model za prosty i właściwy, liczy statystyki Ljunga–Boxa i Boxa–Pierce’a ręcznie i porównuje je z Box.test(). Liczby w tekście pochodzą z tego kodu.
Reszty dwóch modeli AR i statystyka Q
R
set.seed(6320)
n <- 120                                            # 120 miesięcy
y <- 30 + arima.sim(list(ar = c(0.5, 0.3)), n = n, sd = 2)   # proces AR(2)
m1 <- arima(y, order = c(1, 0, 0))                  # model za prosty: AR(1)
m2 <- arima(y, order = c(2, 0, 0))                  # model zgodny z procesem: AR(2)
r <- acf(resid(m1), lag.max = 12, plot = FALSE)$acf[2:13]
h <- 12; k <- 1:h
round(c(Q_LB = n * (n + 2) * sum(r^2 / (n - k)),    # Ljung–Box ręcznie
        Q_BP = n * sum(r^2)), 2)                    # Box–Pierce ręcznie
Box.test(resid(m1), lag = 12, type = "Ljung-Box", fitdf = 1)   # df = 12 − 1
Box.test(resid(m1), lag = 12, type = "Box-Pierce", fitdf = 1)
Box.test(resid(m2), lag = 12, type = "Ljung-Box", fitdf = 2)   # df = 12 − 2
round(c(ar1 = coef(m1)[1], aic1 = AIC(m1), aic2 = AIC(m2)), 3)
round(coef(m2)[1:2], 3)
Wynik w R
 Q_LB  Q_BP
31.32 29.55

	Box-Ljung test

data:  resid(m1)
X-squared = 31.321, df = 11, p-value = 0.0009795


	Box-Pierce test

data:  resid(m1)
X-squared = 29.552, df = 11, p-value = 0.001862


	Box-Ljung test

data:  resid(m2)
X-squared = 12.942, df = 10, p-value = 0.2269

ar1.ar1    aic1    aic2
  0.571 490.957 481.192
  ar1   ar2
0.403 0.312
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko pakiety bazowe). Rysunek 1 wykonano w pakietach ggplot2 4.0.2 i patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym test Ljunga–Boxa różni się od testu Boxa–Pierce’a?
Oba sumują kwadraty autokorelacji. Ljung–Box waży je przez (n + 2)/(n − k), dzięki czemu rozkład statystyki lepiej odpowiada chi-kwadrat w krótkich szeregach. Przy dużym n wyniki są niemal takie same.
Co oznacza argument fitdf w funkcji Box.test()?
To liczba parametrów ARMA oszacowanych w modelu (p + q), odejmowana od liczby opóźnień przy wyznaczaniu stopni swobody. Dla surowego szeregu, bez dopasowanego modelu, zostaw fitdf = 0.
Co zrobić, gdy test Ljunga–Boxa odrzuca hipotezę o szumie białym w resztach?
Model nie uchwycił całej zależności czasowej. Obejrzyj ACF i PACF reszt, dodaj składniki AR, MA lub sezonowe, porównaj modele kryterium AIC i ponownie sprawdź reszty.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Box, G. E. P., & Pierce, D. A. (1970). Distribution of residual autocorrelations in autoregressive-integrated moving average time series models. Journal of the American Statistical Association, 65(332), 1509–1526. https://doi.org/10.1080/01621459.1970.10481180
- Hassani, H., & Yeganegi, M. R. (2020). Selecting optimal lag order in Ljung–Box test. Physica A: Statistical Mechanics and its Applications, 541, Article 123700. https://doi.org/10.1016/j.physa.2019.123700
- Ljung, G. M., & Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. https://doi.org/10.1093/biomet/65.2.297
Cytowania BibTeX
@article{box1970distribution, author={Box, George E. P. and Pierce, David A.}, title={{Distribution of residual autocorrelations in autoregressive-integrated moving average time series models}}, journal={Journal of the American Statistical Association}, year={1970}, volume={65}, number={332}, pages={1509--1526}, doi={10.1080/01621459.1970.10481180}}@article{hassani2020selecting, author={Hassani, Hossein and Yeganegi, Mohammad Reza}, title={{Selecting optimal lag order in Ljung–Box test}}, journal={Physica A: Statistical Mechanics and its Applications}, year={2020}, volume={541}, eid={123700}, doi={10.1016/j.physa.2019.123700}}@article{ljung1978measure, author={Ljung, Greta M. and Box, George E. P.}, title={{On a measure of lack of fit in time series models}}, journal={Biometrika}, year={1978}, volume={65}, number={2}, pages={297--303}, doi={10.1093/biomet/65.2.297}}