Co to jest algorytm EM?
Algorytm EM (ang. expectation–maximization) to iteracyjny sposób znajdowania oszacowań metodą największej wiarygodności, gdy część danych jest nieobserwowana. Dempster, Laird i Rubin (1977) opisali go jako ogólną metodę i wykazali, że wiarygodność w kolejnych krokach nie maleje. Wśród zastosowań wymienili braki danych, dane cenzurowane, modele mieszanin i analizę czynnikową.
Jak działa
- Krok E. Przy bieżących parametrach algorytm wylicza wartości oczekiwane tego, czego brakuje. Przy brakach danych są to sumy, kwadraty i iloczyny potrzebne do średnich i kowariancji.
- Krok M. Z tak uzupełnionych statystyk liczy nowe parametry, jakby dane były pełne.
- Oba kroki powtarza się, aż zmiana parametrów stanie się pomijalnie mała.
EM nie wstawia jednej „najlepszej” liczby w miejsce braku i nie traktuje jej jak pomiaru. Ta sama idea działa w analizie klas latentnych i w modelach mieszanin, gdzie nieobserwowana jest przynależność do klasy.
EM a braki danych
Schafer i Graham (2002) zaliczają metody największej wiarygodności, obok imputacji wielokrotnej, do podejść zalecanych przy brakach danych, a starsze metody doraźne w większości odradzają. Warunkiem jest mechanizm MAR (zob. MCAR, MAR i MNAR). W przykładzie z R braki w y zależą od x (27.5% braków). Średnia z dostępnych przypadków wynosi 48.24, a EM daje 50.32 przy 49.94 w pełnych danych. Usuwanie przypadków zaniża tu średnią, bo brakuje głównie osób z wysokim x.
Ograniczenia
- EM daje oszacowania parametrów, np. średnie i macierz kowariancji, ale nie daje błędów standardowych. Zbiór „uzupełniony EM” analizowany jak pełny zaniża niepewność.
- Do testów i przedziałów ufności lepiej użyć estymacji FIML w samym modelu albo imputacji wielokrotnej. Graham (2009) omawia oba podejścia i podkreśla, że zmienne pomocnicze zwiększają moc i zmniejszają obciążenie.
- Przy dużym odsetku braków zbieżność bywa powolna, a w modelach mieszanin algorytm może utknąć w maksimum lokalnym – warto startować z kilku punktów.
Na rysunku
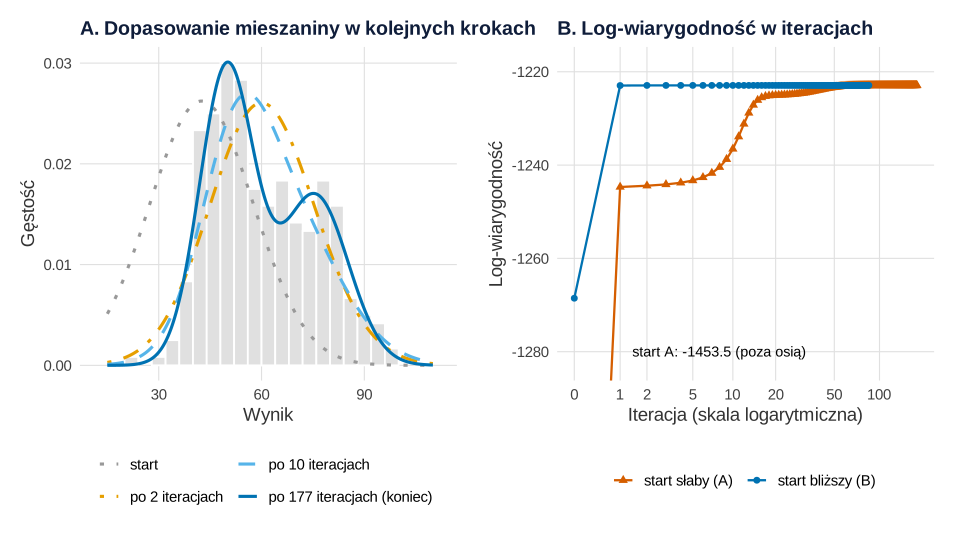
Co widać. 300 wyników pochodzi z dwóch nieoznaczonych podgrup: 180 osób z N(50, 8²) i 120 z N(75, 10²). Krok E liczy dla każdej osoby prawdopodobieństwo przynależności do podgrupy, krok M – ważone średnie, odchylenia i udział. Po 2 i 10 iteracjach krzywa ma jeszcze jeden szeroki garb, a po 177 iteracjach algorytm odtwarza obie podgrupy: udział 0.589, średnie 49.85 i 75.56, odchylenia 7.95 i 9.71. Log-wiarygodność rośnie od −1453.5 do −1222.9 i w żadnym kroku nie spada. Start bliższy rozwiązaniu dochodzi do tego samego maksimum w 85 iteracjach.
Na co uważać. Długi, prawie płaski odcinek przy słabym starcie wygląda jak zbieżność: od 1. do 8. iteracji log-wiarygodność rośnie tylko z −1244.7 do −1240.5, choć maksimum to −1222.9. Kryterium zatrzymania musi więc być ścisłe. Wykres pokazuje dwa starty; jedno maksimum nie dowodzi, że innych nie ma. Punkty startowe i parametry podgrup wybrano ręcznie; ziarna nie zmieniano.
Podpis do pracy:
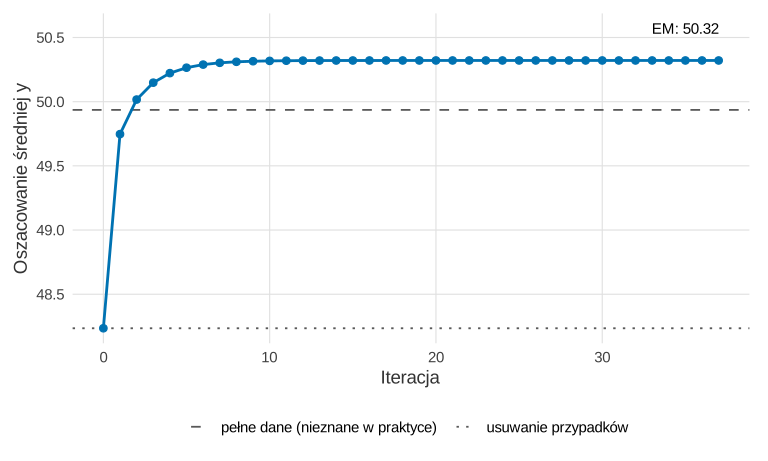
Co widać. Start to średnia z dostępnych przypadków, 48.24. Już pierwsza iteracja przesuwa oszacowanie do 49.75, po pięciu wynosi 50.27, a po 37 iteracjach zatrzymuje się na 50.32 – blisko średniej z pełnych danych (49.94), której w praktyce nie znamy.
Na co uważać. Wykres pokazuje tylko oszacowanie punktowe. Nie widać na nim niepewności – EM jej nie daje, o czym mowa wyżej. Inne sposoby rysowania braków pokazuje wpis Braki danych na wykresie.
Podpis do pracy:
Kod R rysunków
# Rysunki 1–2: EM dla mieszaniny dwóch rozkładów normalnych oraz zbieżność EM w przykładzie z brakami danych
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("#999999", "#E69F00", "#56B4E9", "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: 300 wyników z dwóch nieoznaczonych podgrup – 180 z N(50, 8²) i 120 z N(75, 10²)
set.seed(5531)
x <- c(rnorm(180, 50, 8), rnorm(120, 75, 10))
loglik <- function(th) sum(log(th$udzial * dnorm(x, th$m1, th$s1) + (1 - th$udzial) * dnorm(x, th$m2, th$s2)))
em <- function(th, maks = 500) {
  slad <- list(th); ll <- loglik(th)
  for (it in 1:maks) {
    # krok E: prawdopodobieństwo, że osoba należy do podgrupy 1, przy obecnych parametrach
    a <- th$udzial * dnorm(x, th$m1, th$s1); b <- (1 - th$udzial) * dnorm(x, th$m2, th$s2)
    w <- a / (a + b)
    # krok M: ważone średnie, odchylenia i udział podgrupy
    m1 <- sum(w * x) / sum(w); m2 <- sum((1 - w) * x) / sum(1 - w)
    th <- list(udzial = mean(w), m1 = m1, m2 = m2,
               s1 = sqrt(sum(w * (x - m1)^2) / sum(w)), s2 = sqrt(sum((1 - w) * (x - m2)^2) / sum(1 - w)))
    slad[[it + 1]] <- th; ll[it + 1] <- loglik(th)
    if (ll[it + 1] - ll[it] < 1e-8) break
  }
  list(slad = slad, ll = ll)
}
startA <- list(udzial = 0.5, m1 = 40, m2 = 45, s1 = 15, s2 = 15)   # start celowo słaby (wybrany ręcznie)
startB <- list(udzial = 0.5, m1 = 45, m2 = 80, s1 = 10, s2 = 10)   # start bliżej rozwiązania (wybrany ręcznie)
wA <- em(startA); wB <- em(startB)
kon <- wA$slad[[length(wA$slad)]]
round(c(iteracje_A = length(wA$ll) - 1, iteracje_B = length(wB$ll) - 1,
        logL_start_A = wA$ll[1], logL_po_1_A = wA$ll[2], logL_po_8_A = wA$ll[9],
        logL_koniec_A = max(wA$ll), logL_koniec_B = max(wB$ll),
        spadki_logL_A = sum(diff(wA$ll) < -1e-10), spadki_logL_B = sum(diff(wB$ll) < -1e-10)), 3)
round(unlist(kon), 3)                                         # oszacowania po zbieżności

kroki <- c(0, 2, 10, length(wA$slad) - 1)
siatka <- seq(15, 110, length.out = 300)
krzywe <- do.call(rbind, lapply(seq_along(kroki), function(j) {
  th <- wA$slad[[kroki[j] + 1]]
  data.frame(x = siatka, g = th$udzial * dnorm(siatka, th$m1, th$s1) + (1 - th$udzial) * dnorm(siatka, th$m2, th$s2),
             krok = j)
}))
etykiety <- c("start", "po 2 iteracjach", "po 10 iteracjach", paste("po", kroki[4], "iteracjach (koniec)"))
krzywe$krok <- factor(etykiety[krzywe$krok], levels = etykiety)
pA <- ggplot(data.frame(x = x), aes(x)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 4, boundary = 0, fill = "grey88", colour = "white") +
  geom_line(data = krzywe, aes(x, g, colour = krok, linetype = krok), linewidth = 1.1) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("dotted", "dotdash", "dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 2), linetype = guide_legend(ncol = 2)) +
  labs(title = "A. Dopasowanie mieszaniny w kolejnych krokach", x = "Wynik", y = "Gęstość") + motyw
sciezki <- rbind(data.frame(it = seq_along(wA$ll) - 1, ll = wA$ll, start = "start słaby (A)"),
                 data.frame(it = seq_along(wB$ll) - 1, ll = wB$ll, start = "start bliższy (B)"))
sciezki$start <- factor(sciezki$start, levels = c("start słaby (A)", "start bliższy (B)"))
pB <- ggplot(sciezki, aes(it, ll, colour = start, shape = start)) +
  geom_line(linewidth = 0.8) + geom_point(size = 2) +
  scale_colour_manual(values = c("#D55E00", "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(trans = "log1p", breaks = c(0, 1, 2, 5, 10, 20, 50, 100)) +
  coord_cartesian(ylim = c(max(wA$ll) - 60, max(wA$ll) + 5)) +
  annotate("text", x = 1.4, y = max(wA$ll) - 57, hjust = 0, size = 3.8,
           label = sprintf("start A: %.1f (poza osią)", wA$ll[1])) +
  labs(title = "B. Log-wiarygodność w iteracjach", x = "Iteracja (skala logarytmiczna)", y = "Log-wiarygodność") +
  motyw
p1 <- pA | pB

# Rysunek 2: średnia y w kolejnych iteracjach EM – przykład z hasła (te same dane i ten sam algorytm)
set.seed(55301)
n <- 200
x2 <- rnorm(n, mean = 50, sd = 10)
y <- 20 + 0.6 * x2 + rnorm(n, sd = 6)
y_obs <- y
y_obs[x2 > quantile(x2, 0.60) & runif(n) < 0.7] <- NA
brak <- is.na(y_obs)
mu <- c(mean(x2), mean(y_obs, na.rm = TRUE)); S <- cov(cbind(x2, y_obs), use = "complete.obs")
sr_y <- mu[2]
for (it in 1:200) {
  b <- S[1, 2] / S[1, 1]; s2 <- S[2, 2] - b * S[1, 2]
  ey <- ifelse(brak, mu[2] + b * (x2 - mu[1]), y_obs); ey2 <- ifelse(brak, ey^2 + s2, y_obs^2)
  mu_n <- c(mean(x2), mean(ey))
  sxy <- mean(x2 * ey) - mu_n[1] * mu_n[2]; syy <- mean(ey2) - mu_n[2]^2
  S_n <- matrix(c(mean(x2^2) - mu_n[1]^2, sxy, sxy, syy), 2)
  zmiana <- max(abs(c(mu_n - mu, S_n - S))); mu <- mu_n; S <- S_n
  sr_y[it + 1] <- mu[2]
  if (zmiana < 1e-8) break
}
round(c(iteracje = it, srednia_po_1 = sr_y[2], srednia_po_5 = sr_y[6], srednia_EM = mu[2],
        srednia_pelne = mean(y), srednia_listwise = mean(y_obs, na.rm = TRUE)), 3)
odn <- data.frame(y = c(mean(y), mean(y_obs, na.rm = TRUE)),
                  co = c("pełne dane (nieznane w praktyce)", "usuwanie przypadków"))
p2 <- ggplot(data.frame(it = seq_along(sr_y) - 1, sr = sr_y), aes(it, sr)) +
  geom_hline(data = odn, aes(yintercept = y, linetype = co), colour = "grey35") +
  geom_line(colour = "#0072B2", linewidth = 1) + geom_point(colour = "#0072B2", size = 2.2) +
  scale_linetype_manual(values = c("dashed", "dotted"), name = NULL) +
  annotate("text", x = it, y = mu[2] + 0.25, hjust = 1, size = 4, label = sprintf("EM: %.2f", mu[2])) +
  labs(x = "Iteracja", y = "Oszacowanie średniej y") + motyw

p1   # zapis: ggsave("algorytm-em-mieszanina.svg", p1, width = 10, height = 5.6)
p2   # zapis: ggsave("algorytm-em-braki.svg", p2, width = 8, height = 4.8)
Wynik w R
   iteracje_A    iteracje_B  logL_start_A   logL_po_1_A   logL_po_8_A
      177.000        85.000     -1453.514     -1244.697     -1240.456
logL_koniec_A logL_koniec_B spadki_logL_A spadki_logL_B
    -1222.922     -1222.922         0.000         0.000
udzial     m1     m2     s1     s2
 0.589 49.853 75.559  7.945  9.706
        iteracje     srednia_po_1     srednia_po_5       srednia_EM
          37.000           49.747           50.265           50.321
   srednia_pelne srednia_listwise
          49.936           48.235
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Jak opisać w pracy
Algorytm EM w R
Kod implementuje oba kroki EM dla dwóch zmiennych o rozkładzie normalnym bez dodatkowych pakietów i porównuje średnią y z pełnych danych, z usuwania przypadków i z EM.
Krok E i krok M ręcznie
R
# Algorytm EM dla dwóch zmiennych o rozkładzie normalnym; y ma braki MAR (zależne od x)
set.seed(55301)
n <- 200
x <- rnorm(n, mean = 50, sd = 10)
y <- 20 + 0.6 * x + rnorm(n, sd = 6)
y_obs <- y
y_obs[x > quantile(x, 0.60) & runif(n) < 0.7] <- NA   # braki częściej przy wysokim x
brak <- is.na(y_obs)
mu <- c(mean(x), mean(y_obs, na.rm = TRUE))           # start: średnie z dostępnych danych
S <- cov(cbind(x, y_obs), use = "complete.obs")
for (it in 1:200) {
  # krok E: oczekiwane y i y^2 dla brakujących wartości przy obecnych parametrach
  b <- S[1, 2] / S[1, 1]
  s2 <- S[2, 2] - b * S[1, 2]
  ey <- ifelse(brak, mu[2] + b * (x - mu[1]), y_obs)
  ey2 <- ifelse(brak, ey^2 + s2, y_obs^2)
  # krok M: nowe średnie i kowariancje z uzupełnionych statystyk
  mu_n <- c(mean(x), mean(ey))
  sxy <- mean(x * ey) - mu_n[1] * mu_n[2]
  syy <- mean(ey2) - mu_n[2]^2
  S_n <- matrix(c(mean(x^2) - mu_n[1]^2, sxy, sxy, syy), 2)
  zmiana <- max(abs(c(mu_n - mu, S_n - S)))
  mu <- mu_n; S <- S_n
  if (zmiana < 1e-8) break
}
round(c(odsetek_brakow = mean(brak), iteracje = it,
        srednia_y_pelne_dane = mean(y),
        srednia_y_listwise = mean(y_obs, na.rm = TRUE),
        srednia_y_EM = mu[2]), 3)
Wynik w R
      odsetek_brakow             iteracje srednia_y_pelne_dane
               0.275               37.000               49.936
  srednia_y_listwise         srednia_y_EM
              48.235               50.321
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów); rysunki wykonano w pakiecie ggplot2, panele połączono pakietem patchwork, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy algorytm EM to rodzaj imputacji?
Nie w zwykłym sensie. EM szacuje parametry (np. średnie i kowariancje) z uwzględnieniem braków, a nie tworzy zbioru do analizy. Programy pozwalają zapisać zbiór „uzupełniony EM”, ale analizowany jak pełny zaniża błędy standardowe.
Jakie założenie o brakach danych przyjmuje EM?
Zwykle MAR – braki mogą zależeć od zmiennych obserwowanych w modelu, ale nie od samej brakującej wartości. Przy brakach MNAR EM w standardowej postaci nie usuwa obciążenia.
Co wybrać: EM, FIML czy imputację wielokrotną?
EM wystarczy do opisowych średnich i kowariancji. Do testów i przedziałów ufności użyj FIML w modelu (np. SEM) albo imputacji wielokrotnej, które dają poprawne błędy standardowe.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B (Methodological), 39(1), 1–22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x ● Otwarty dostęp: pełny tekst
- Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60(1), 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
Cytowania BibTeX
@article{dempster1977maximum, author={Dempster, A. P. and Laird, N. M. and Rubin, D. B.}, title={{Maximum likelihood from incomplete data via the EM algorithm}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1977}, volume={39}, number={1}, pages={1--22}, doi={10.1111/j.2517-6161.1977.tb01600.x}}@article{graham2009missing, author={Graham, John W.}, title={{Missing data analysis: Making it work in the real world}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={549--576}, doi={10.1146/annurev.psych.58.110405.085530}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}