geom_miss_point() – u kogo brakuje, a schodek porzucenia – gdzie ankieta traci osoby. Wykresy pomagają znaleźć zmienne pomocnicze do imputacji i podważyć MCAR, ale nie dowodzą, że braki są losowe, i nie wykluczą MNAR.Po co rysować braki danych
Tabela z liczbą braków w każdej zmiennej mówi, ile brakuje. Nie mówi, czy braki występują razem, u kogo i w którym miejscu ankiety. A od tego zależy, czy wystarczy usuwanie przypadków, czy potrzebna jest imputacja wielokrotna. Ten wpis pokazuje sześć wykresów braków na jednej ankiecie. Przy każdym znajdziesz: co widać, czego wykres nie pokazuje, gotowy podpis do pracy i zdanie do Wyników. Teorię mechanizmów braków opisuje hasło braki danych MCAR, MAR i MNAR, a samą imputację – poradnik braki danych i imputacja wielokrotna w R. Tu zajmujemy się tym, co jest przed imputacją: obejrzeniem braków.
Wykresy robimy w R pakietami naniar i visdat. Naniar powstał po to, by braki dało się obsługiwać, oglądać i imputować w zwykłym toku analizy, na danych w układzie uporządkowanym (Tierney i Cook, 2023). Ogólne zasady dobrego wykresu i eksportu do pracy są we wpisach wykresy w pracy dyplomowej i tabele i rysunki do artykułu – nie powtarzamy ich.
Przykład: ankieta z trzema rodzajami braków
Dane są fikcyjne (symulowane, ziarno 564): ankieta wśród 300 studentów, 12 zmiennych w kolejności pytań. Najpierw wiek, płeć, tryb studiów i skala stresu (10–50) – bez braków. Potem sen, aktywność fizyczna, miesięczny dochód i wsparcie społeczne (1–7). Na końcu blok czterech skal (1–7): zadowolenie ze studiów, motywacja, wypalenie i zaangażowanie. Plik braki-danych-ankieta.csv pobierzesz i odtworzysz wszystkie rysunki kodem z sekcji Kod R.
Ponieważ dane symulowaliśmy, znamy prawdziwy mechanizm każdego braku. W prawdziwej ankiecie go nie znasz – i właśnie dlatego warto zobaczyć, co wykresy pokazują, a czego nie:
- sen i aktywność – pojedyncze pominięcia całkowicie losowe (MCAR);
- dochód – odmowa częstsza u studentów niestacjonarnych (MAR względem trybu);
- wsparcie – pomijane częściej przez osoby z wysokim stresem (MAR względem stresu);
- blok końcowy – część osób przerywa ankietę; ryzyko rośnie ze stresem.
Puste jest 7.9% komórek. Komplet odpowiedzi ma 161 osób, a co najmniej jeden brak – 139 osób (46.3%). Analiza samych kompletnych przypadków straciłaby więc prawie połowę próby.
Rysunek 1. Mapa braków: cały zbiór naraz
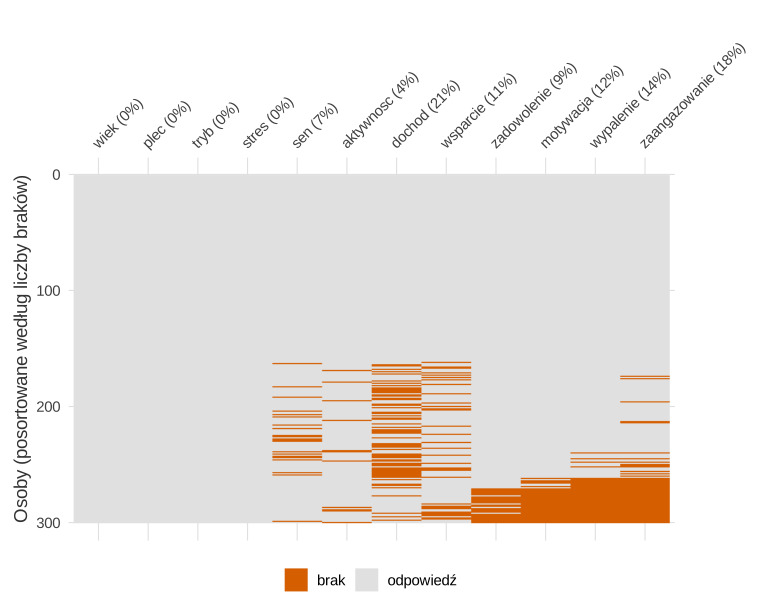
visdat::vis_miss). Każda komórka to odpowiedź jednej osoby na jedno pytanie; wiersze posortowano według liczby braków. Obliczenia: R, pakiety visdat i naniar (dane fikcyjne).Co widać. Każdy wiersz to osoba, każda kolumna – zmienna w kolejności pytań. Wiersze posortowaliśmy według liczby braków, dlatego na dole widać schodek: osoby, które przerwały ankietę, nie mają odpowiedzi w kilku ostatnich kolumnach. Braki snu, aktywności i dochodu są rozproszone pojedynczymi kreskami. W nawiasach przy nazwach kolumn vis_miss() podaje odsetek braków.
Czego ten wykres nie pokazuje. Mapa zależy od kolejności wierszy. Bez sortowania schodek rozpada się na losowe kreski i porzucenie łatwo przeoczyć. Sortowanie z kolei sugeruje porządek, którego w danych nie ma (wiersze 1–161 to po prostu komplety). Mapa nie mówi też nic o tym, od czego braki zależą.
Podpis do pracy.
Zdanie do Wyników.
Rysunek 2. Ile brakuje: zmienne i osoby
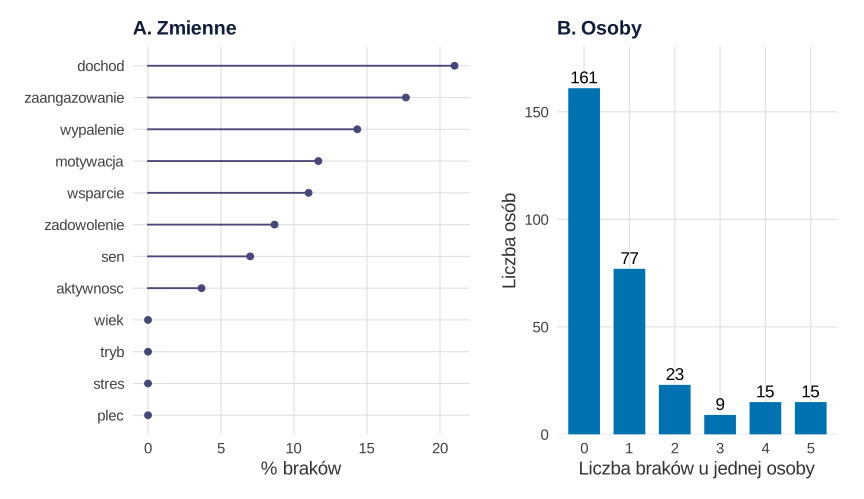
naniar::gg_miss_var) i według osób (B). Obliczenia: R, pakiety naniar i ggplot2 (dane fikcyjne).Co widać. Panel A to gg_miss_var(): najwięcej braków ma dochód (63 osoby, 21%), potem kolejne pozycje bloku końcowego – im dalej w ankiecie, tym więcej (zadowolenie 8.7%, motywacja 11.7%, wypalenie 14.3%, zaangażowanie 17.7%). Panel B pokazuje rozkład liczby braków na osobę: 77 osób ma jeden brak, ale 30 osób ma cztery lub pięć. To dwie różne sytuacje: pojedyncze pominięcia i przerwanie ankiety.
Czego ten wykres nie pokazuje. Sam odsetek braków nie mówi, czy są groźne. Kilka procent braków zależnych od wyniku może zniekształcić wnioski bardziej niż 20% braków losowych. Panel A nie pokazuje też, czy braki w różnych zmiennych dotyczą tych samych osób – do tego służy rysunek 3.
Podpis do pracy.
Zdanie do Wyników.
Rysunek 3. Wzorce braków: które zmienne brakują razem
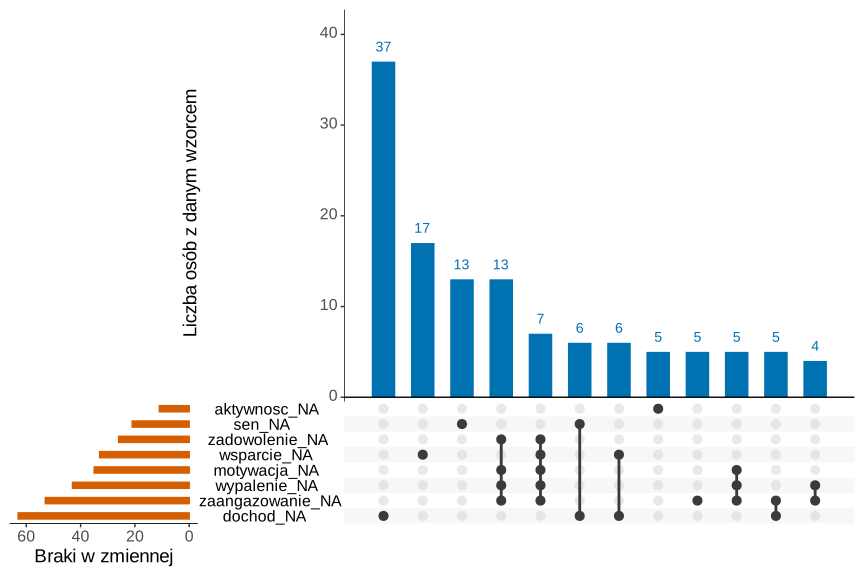
naniar::gg_miss_upset, wykres UpSet z pakietu UpSetR). Obliczenia: R (dane fikcyjne).Co widać. To wykres UpSet z funkcji gg_miss_upset(). Kropki połączone linią pod słupkiem to jeden wzorzec braków, a słupek – liczba osób z tym wzorcem. UpSet powstał jako sposób pokazywania przecięć wielu zbiorów w układzie macierzy, z liczebnością każdego przecięcia (Lex i in., 2014); tu „zbiory” to osoby z brakiem w danej zmiennej. Najczęstsze wzorce to pojedynczy brak dochodu (37 osób), wsparcia (17) i snu (13) oraz brak całego bloku końcowego (13). Wzorce bloku są monotoniczne: kto nie odpowiedział na pozycję, nie odpowiedział też na żadną dalszą.
Czego ten wykres nie pokazuje. Pokazujemy 12 najczęstszych z 23 wzorców; rzadkie kombinacje znikają. Wykres nie mówi też, czy osoby z danym wzorcem różnią się od innych. Siedem osób ma brak wsparcia i całego bloku – bez znaczników czasu nie odróżnisz, czy pominęły wsparcie, czy przerwały ankietę już na nim.
Podpis do pracy.
Zdanie do Wyników.
Rysunek 4. Braki na wykresie rozrzutu
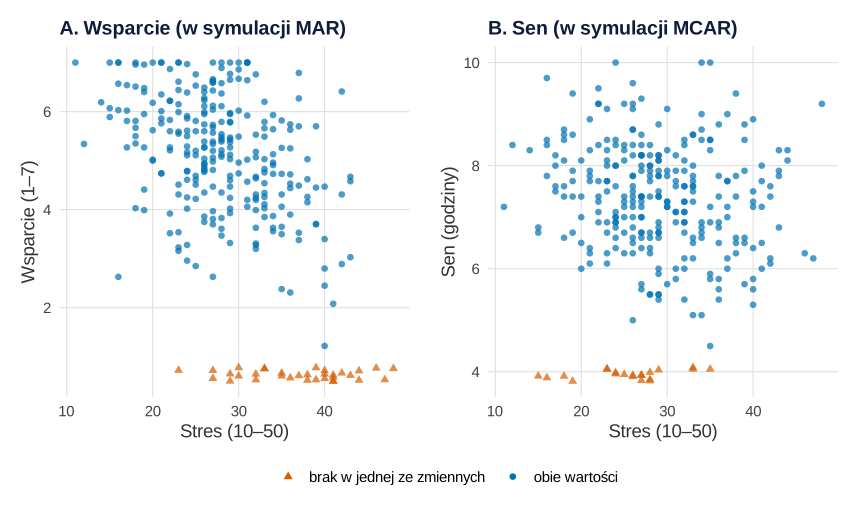
naniar::geom_miss_point). Osoby z brakiem w zmiennej na osi pionowej narysowano trójkątami pod osią. Obliczenia: R, pakiety naniar, ggplot2 i patchwork (dane fikcyjne).Co widać. Zwykły wykres rozrzutu po cichu pomija osoby z brakiem. geom_miss_point() rysuje je pod osią, 10% poniżej najmniejszej wartości. W panelu A trójkąty (brak wsparcia) skupiają się po prawej: braki dotyczą głównie osób z wysokim stresem. Potwierdza to test Welcha: średni stres osób bez wyniku wsparcia to 36.97, a osób z wynikiem – 27.79.
Czego ten wykres nie pokazuje. Panel B uczy pokory. Braki snu symulowaliśmy jako całkowicie losowe, a mimo to trójkąty leżą głównie po lewej i test Welcha jest istotny (t(25.78) = 2.95, p = .007). Przy 21 brakach przypadkowe skupienie jest łatwe, a przy wielu takich porównaniach wraca problem wielokrotnych porównań. Wykres pokazuje próbę, nie mechanizm. Pokazuje też tylko zależność od zmiennej na osi x. Zależności od samej brakującej wartości nie zobaczysz, bo tej wartości nie ma.
Podpis do pracy.
Zdanie do Wyników.
Rysunek 5. Braki w grupach
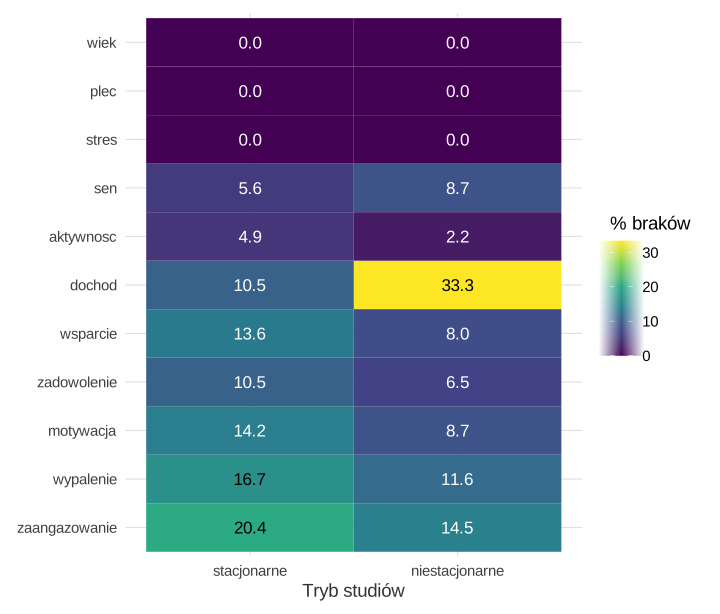
naniar::gg_miss_fct, skala viridis). Obliczenia: R, pakiety naniar i ggplot2 (dane fikcyjne).Co widać. gg_miss_fct() pokazuje odsetek braków w każdej zmiennej osobno dla grup. Dochodu nie podało 33.3% studentów niestacjonarnych i 10.5% stacjonarnych. Różnicę potwierdza test chi-kwadrat: χ²(1) = 22.08, p < .001. Wartości wpisaliśmy w komórki, bo sam kolor nie powinien nieść informacji. Skala viridis jest jednolita percepcyjnie i czytelna przy zaburzeniach widzenia barw. Tęczowe i czerwono-zielone mapy kolorów zniekształcają dane (Crameri i in., 2020).
Czego ten wykres nie pokazuje. Liczebności grup są różne (162 i 138), a odsetek przy małej grupie jest niestabilny. Mapa nie pokazuje też przedziałów ufności. Różnica między grupami nie oznacza, że tryb studiów powoduje braki: może za nim stać wiek, praca albo sam dochód (zob. dalej).
Podpis do pracy.
Zdanie do Wyników.
Rysunek 6. Schodek porzucenia ankiety
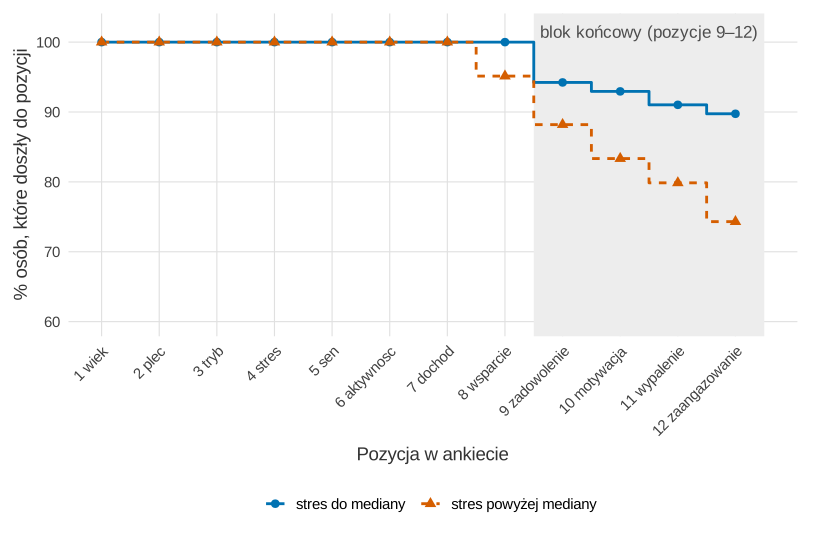
Co widać. Dla każdej pozycji ankiety liczymy, jaki odsetek osób do niej doszedł, czyli odpowiedział na nią albo na którąkolwiek dalszą. Linie pokazujemy osobno dla osób ze stresem do mediany (n = 156) i powyżej mediany (n = 144). Do ostatniego pytania doszło 89.7% osób z pierwszej grupy i tylko 74.3% z drugiej. Spadek zaczyna się w bloku końcowym. Przerwanie ankiety jest częste szczególnie w badaniach internetowych i wiąże się z budową kwestionariusza i obciążeniem respondenta (Peytchev, 2009). Przy dłuższej ankiecie odpowiedzi na dalsze pytania bywają też krótsze i bardziej jednolite (Galesic i Bosnjak, 2009) – zob. zmęczenie respondenta.
Czego ten wykres nie pokazuje. Spadek przy pozycji 8 (wsparcie) to siedem osób, które pominęły wsparcie i nie odpowiedziały już na nic dalej – bez danych o czasie i stronie ankiety nie wiesz, gdzie naprawdę przerwały. Oś pionowa zaczyna się od 60%, co powiększa różnice; podaj to w nocie. Wykres pokazuje też tylko tych, którzy ankietę rozpoczęli. Liczbę osób na każdym etapie pokazuje diagram przepływu respondentów. W badaniu podłużnym tę samą logikę stosuje się do kolejnych pomiarów (dane podłużne na wykresie).
Podpis do pracy.
Zdanie do Wyników.
Co z wykresów wolno wnioskować o mechanizmie braków
Rubin (1976) pokazał, że mechanizm powodujący braki można pominąć we wnioskowaniu, gdy braki są losowe pod warunkiem danych obserwowanych (MAR). Wykresy pomagają ocenić, od których obserwowanych zmiennych zależą braki. Na wykresach z tego wpisu widzisz trzy rzeczy:
- Wolno: stwierdzić, że braki nie są całkowicie losowe (MCAR), gdy wyraźnie zależą od zmiennej obserwowanej – tak jak wsparcie od stresu i dochód od trybu.
- Wolno: wskazać zmienne pomocnicze do imputacji i rozpoznać przerwanie ankiety po monotonicznym wzorcu.
- Nie wolno: uznać, że braki są MCAR, bo „wyglądają losowo”, ani że nie są MNAR. Nic pewnego o MNAR z danych nie wyczytasz.
Pokazuje to mini-symulacja w przepisie 8 (2000 osób, osobne ziarno). Dochód brakuje w niej albo zależnie od trybu (MAR), albo zależnie od samej wysokości dochodu (MNAR). Parametry MNAR dobraliśmy ręcznie, tak by odsetki braków w grupach były zbliżone: przy MAR 7.1% i 28.9%, przy MNAR 8.2% i 31.6% (stacjonarni i niestacjonarni). Rysunek 5 wyglądałby w obu przypadkach prawie tak samo. Różnica kryje się w brakujących wartościach. Przy MAR osoby bez podanego dochodu zarabiają w obrębie trybu tyle co pozostałe (4668 wobec 4579 zł u niestacjonarnych). Przy MNAR zarabiają wyraźnie więcej (5510 wobec 4185 zł). W prawdziwej ankiecie tych liczb nie zobaczysz.
To samo dotyczy testu MCAR Little’a. Little (1988) zaproponował jedną globalną statystykę zamiast wielu porównań osób z brakami i bez nich. W naszych danych χ²(133) = 212.71, p < .001, przy 23 wzorcach braków: MCAR odrzucamy. Test nie mówi jednak, czy braki są MAR, czy MNAR. Dlatego przy podejrzeniu MNAR zaplanuj analizę wrażliwości. Przy założeniu MAR zalecane są metoda największej wiarygodności albo imputacja wielokrotna, a nie metody doraźne (Schafer i Graham, 2002). Jak to zrobić w SPSS, pokazuje wpis braki danych i imputacja wielokrotna w SPSS.
Jak opisać braki danych w Metodzie
W Metodzie napisz, jak sprawdzałeś braki i co z nimi zrobiłeś. Wykresy zwykle trafiają do aneksu, a w tekście zostają liczby. Do pracy wybierz jeden lub dwa rysunki: mapę (rys. 1) albo wzorce (rys. 3) oraz schodek, jeśli ankietę ktoś przerywał. Decyzje dotyczące pojedynczych pominięć w skalach opisuje wpis braki danych w ankiecie – co zrobić.
Ostatnie zdanie wpisz tylko, jeśli analizę wrażliwości naprawdę wykonałeś. Gdy braki wynikają z błędów łączenia plików, a nie z odpowiedzi, zajrzyj do wpisu nie da się połączyć pomiaru przed i po. Gdy wzór braków wygląda dziwnie, na przykład puste są całe kolumny u części osób, sprawdź listę z wpisu wynik wygląda podejrzanie. Pytania pominięte przez pytanie filtrujące zakoduj osobno, zanim narysujesz mapę – inaczej wyglądają jak braki.
Kod R: wszystkie rysunki i liczby
Pobierz plik braki-danych-ankieta.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji. Kod jest samowystarczalny: motyw i paletę definiuje przepis 1, a każdy rysunek zapisuje ggsave() albo svglite(). Rysunki na tej stronie powstały tym samym kodem z motywem graficznym serwisu w miejsce funkcji motyw(); dane, geometrie i skale są identyczne, różnią się tylko krój i kolor tytułów. Dane fikcyjne wygenerowano raz z ziarnem 564, bez dobierania pod wynik; parametry MNAR w przepisie 8 dobraliśmy ręcznie (opis w tekście).
1. Dane, motyw, paleta i liczba braków
R
# Braki danych na wykresie: ankieta studencka, N = 300, 12 zmiennych (dane fikcyjne)
library(ggplot2)
library(naniar)
options(width = 100)
# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw) i krótki motyw wspólny dla rysunków
okabe <- c(pomarancz = "#E69F00", niebieski = "#0072B2", zielony = "#009E73",
           cynober = "#D55E00", blekit = "#56B4E9", fiolet = "#CC79A7", szary = "#999999")
motyw <- function(base_size = 14) {
  theme_minimal(base_size = base_size) +
    theme(panel.grid.minor = element_blank(), legend.position = "bottom",
          plot.title = element_text(face = "bold"), plot.background = element_rect(fill = "white", colour = NA))
}
dane <- read.csv("braki-danych-ankieta.csv", encoding = "UTF-8")
dane$tryb <- factor(dane$tryb, levels = c("stacjonarne", "niestacjonarne"))
dim(dane)
miss_var_summary(dane)                       # liczba i odsetek braków w każdej zmiennej
data.frame(komorki_pct = round(pct_miss(dane), 1),          # odsetek pustych komórek
           osoby_z_brakiem = n_case_miss(dane),             # osoby z co najmniej jednym brakiem
           osoby_z_brakiem_pct = round(pct_miss_case(dane), 1),
           komplet = n_case_complete(dane))
table(liczba_brakow = rowSums(is.na(dane)))  # ile braków ma jedna osoba
# kontrola palety: jak dwa główne kolory widzi osoba z deuteranopią (różnią się też jasnością)
colorspace::deutan(okabe[c("niebieski", "cynober")])
Wynik w R
[1] 300  12
# A tibble: 12 × 3
   variable      n_miss pct_miss
   <chr>          <int>    <num>
 1 dochod            63    21
 2 zaangazowanie     53    17.7
 3 wypalenie         43    14.3
 4 motywacja         35    11.7
 5 wsparcie          33    11
 6 zadowolenie       26     8.67
 7 sen               21     7
 8 aktywnosc         11     3.67
 9 wiek               0     0
10 plec               0     0
11 tryb               0     0
12 stres              0     0
  komorki_pct osoby_z_brakiem osoby_z_brakiem_pct komplet
1         7.9             139                46.3     161
liczba_brakow
  0   1   2   3   4   5
161  77  23   9  15  15
niebieski   cynober
"#3B67B1" "#9E8C00"
2. Rysunek 1: mapa braków
R
# Rysunek 1: mapa braków – każda komórka zbioru (kontynuacja: dane, okabe, motyw)
library(visdat)
# wiersze posortowane według liczby braków; bez sortowania wzorzec porzucenia ginie w szumie
dane_sort <- dane[order(rowSums(is.na(dane))), ]
p1 <- vis_miss(dane_sort) +
  scale_fill_manual(values = c("grey88", okabe[["cynober"]]), labels = c("odpowiedź", "brak"), name = NULL) +
  labs(y = "Osoby (posortowane według liczby braków)") +
  motyw() +
  theme(axis.text.x = element_text(angle = 45, hjust = 0, vjust = 0), legend.position = "bottom",
        plot.margin = margin(10, 70, 10, 10))  # miejsce na ostatnią etykietę kolumny
p1
ggsave("braki-danych-mapa-brakow.svg", p1, width = 8, height = 6.4)
3. Rysunek 2: braki według zmiennych i osób
R
# Rysunek 2: ile brakuje w każdej zmiennej i ile braków ma jedna osoba (kontynuacja: dane, okabe, motyw)
library(patchwork)
p2a <- gg_miss_var(dane, show_pct = TRUE) +
  labs(title = "A. Zmienne", x = NULL, y = "% braków") + motyw()
na_osoba <- as.data.frame(table(liczba = rowSums(is.na(dane))))
p2b <- ggplot(na_osoba, aes(x = liczba, y = Freq)) +
  geom_col(fill = okabe[["niebieski"]], width = 0.7) +
  geom_text(aes(label = Freq), vjust = -0.4, size = 4.5) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "B. Osoby", x = "Liczba braków u jednej osoby", y = "Liczba osób") + motyw()
p2 <- p2a + p2b + plot_layout(widths = c(1.2, 1))
p2
ggsave("braki-danych-zmienne-osoby.svg", p2, width = 9, height = 5.2)
4. Rysunek 3: wzorce braków (UpSet)
R
# Rysunek 3: wzorce braków – które zmienne brakują razem (kontynuacja: dane, okabe)
# gg_miss_upset() rysuje wykres UpSet pakietem UpSetR (grafika grid, nie ggplot2)
p3 <- gg_miss_upset(dane, nsets = n_var_miss(dane), nintersects = 12,
                    main.bar.color = okabe[["niebieski"]], sets.bar.color = okabe[["cynober"]],
                    mainbar.y.label = "Liczba osób z danym wzorcem", sets.x.label = "Braki w zmiennej",
                    text.scale = 1.7, point.size = 3.2, line.size = 1)
p3
svglite::svglite("braki-danych-wzorce-upset.svg", width = 9, height = 6); print(p3); invisible(dev.off())
# te same wzorce w liczbach: najczęstsze kombinacje braków
wzorce <- apply(is.na(dane), 1, function(w) paste(names(dane)[w], collapse = " + "))
wzorce[wzorce == ""] <- "(komplet)"
head(sort(table(wzorce), decreasing = TRUE), 8)
Wynik w R
wzorce
                                                     (komplet)
                                                           161
                                                        dochod
                                                            37
                                                      wsparcie
                                                            17
                                                           sen
                                                            13
           zadowolenie + motywacja + wypalenie + zaangazowanie
                                                            13
wsparcie + zadowolenie + motywacja + wypalenie + zaangazowanie
                                                             7
                                             dochod + wsparcie
                                                             6
                                                  sen + dochod
                                                             6
5. Rysunek 4: braki na wykresie rozrzutu
R
# Rysunek 4: braki widoczne na wykresie rozrzutu (kontynuacja: dane, okabe, motyw)
# geom_miss_point() rysuje osoby z brakiem w jednej zmiennej pod osią (o 10% poniżej minimum)
kolory_brak <- c("Missing" = okabe[["cynober"]], "Not Missing" = okabe[["niebieski"]])
ksztalty_brak <- c("Missing" = 17, "Not Missing" = 16)
etyk_brak <- c("Missing" = "brak w jednej ze zmiennych", "Not Missing" = "obie wartości")
rozrzut <- function(y, tytul, os_y) {
  ggplot(dane, aes(x = stres, y = .data[[y]])) +
    geom_miss_point(aes(shape = after_stat(missing)), alpha = 0.7, size = 2) +
    scale_colour_manual(values = kolory_brak, labels = etyk_brak, name = NULL) +
    scale_shape_manual(values = ksztalty_brak, labels = etyk_brak, name = NULL) +
    labs(title = tytul, x = "Stres (10–50)", y = os_y) + motyw()
}
p4 <- rozrzut("wsparcie", "A. Wsparcie (w symulacji MAR)", "Wsparcie (1–7)") +
  rozrzut("sen", "B. Sen (w symulacji MCAR)", "Sen (godziny)") +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4
ggsave("braki-danych-rozrzut.svg", p4, width = 9, height = 5.4)
# to samo w liczbach: stres u osób z brakiem i bez braku (test Welcha)
t.test(stres ~ is.na(wsparcie), data = dane)
t.test(stres ~ is.na(sen), data = dane)
Wynik w R
	Welch Two Sample t-test

data:  stres by is.na(wsparcie)
t = -7.8656, df = 40.706, p-value = 1.068e-09
alternative hypothesis: true difference in means between group FALSE and group TRUE is not equal to 0
95 percent confidence interval:
 -11.541545  -6.824815
sample estimates:
mean in group FALSE  mean in group TRUE
           27.78652            36.96970


	Welch Two Sample t-test

data:  stres by is.na(sen)
t = 2.9501, df = 25.778, p-value = 0.006676
alternative hypothesis: true difference in means between group FALSE and group TRUE is not equal to 0
95 percent confidence interval:
 1.097167 6.146049
sample estimates:
mean in group FALSE  mean in group TRUE
           29.05018            25.42857
6. Rysunek 5: braki w grupach
R
# Rysunek 5: odsetek braków w grupach (kontynuacja: dane, motyw)
p5 <- gg_miss_fct(dane, fct = tryb)
p5 <- p5 + geom_text(aes(label = sprintf("%.1f", pct_miss),
                         colour = pct_miss > 15), size = 4.5, show.legend = FALSE) +
  scale_colour_manual(values = c("TRUE" = "black", "FALSE" = "white")) +
  scale_fill_viridis_c(name = "% braków", option = "viridis") +
  scale_y_discrete(limits = rev(setdiff(names(dane), "tryb"))) +   # kolejność pytań jak w ankiecie
  labs(x = "Tryb studiów", y = NULL) + motyw() +
  theme(legend.position = "right", panel.grid = element_blank())
p5
ggsave("braki-danych-w-grupach.svg", p5, width = 7.5, height = 6.4)
# to samo w liczbach: braki dochodu według trybu
tab <- table(tryb = dane$tryb, brak_dochodu = is.na(dane$dochod))
tab
round(100 * prop.table(tab, 1), 1)
chisq.test(tab)
Wynik w R
                brak_dochodu
tryb             FALSE TRUE
  stacjonarne      145   17
  niestacjonarne    92   46
                brak_dochodu
tryb             FALSE TRUE
  stacjonarne     89.5 10.5
  niestacjonarne  66.7 33.3

	Pearson's Chi-squared test with Yates' continuity correction

data:  tab
X-squared = 22.075, df = 1, p-value = 2.622e-06
7. Rysunek 6: schodek porzucenia
R
# Rysunek 6: schodek porzucenia – ile osób dotrwało do każdej pozycji ankiety (kontynuacja: dane, okabe, motyw)
# osoba "dotrwała" do pozycji k, jeśli odpowiedziała na k albo na którąkolwiek późniejszą pozycję
pozycje <- names(dane)
dotrwal <- function(d) sapply(seq_along(pozycje), function(k)
  mean(rowSums(!is.na(d[, pozycje[k:length(pozycje)], drop = FALSE])) > 0) * 100)
dane$stres_gr <- ifelse(dane$stres > median(dane$stres), "stres powyżej mediany", "stres do mediany")
schodek <- do.call(rbind, lapply(split(dane[, pozycje], dane$stres_gr), function(d)
  data.frame(pozycja = seq_along(pozycje), pct = dotrwal(d), n = nrow(d))))
schodek$grupa <- rep(names(split(dane, dane$stres_gr)), each = length(pozycje))
transform(schodek[schodek$pozycja >= 8, ], pct = round(pct, 1))
p6 <- ggplot(schodek, aes(x = pozycja, y = pct, colour = grupa, linetype = grupa)) +
  annotate("rect", xmin = 8.5, xmax = 12.5, ymin = -Inf, ymax = Inf, fill = "grey93") +
  annotate("text", x = 10.5, y = 101.5, label = "blok końcowy (pozycje 9–12)", size = 4.5, colour = "grey30") +
  geom_step(direction = "mid", linewidth = 1) +
  geom_point(aes(shape = grupa), size = 2.6) +
  scale_colour_manual(values = c(okabe[["niebieski"]], okabe[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  scale_x_continuous(breaks = seq_along(pozycje), labels = paste(seq_along(pozycje), pozycje)) +
  scale_y_continuous(limits = c(60, 102), breaks = seq(60, 100, 10)) +
  labs(x = "Pozycja w ankiecie", y = "% osób, które doszły do pozycji") + motyw() +
  theme(axis.text.x = element_text(angle = 45, hjust = 1))
p6
ggsave("braki-danych-schodek-porzucenia.svg", p6, width = 8.5, height = 5.6)
dane$stres_gr <- NULL
Wynik w R
                         pozycja   pct   n                 grupa
stres do mediany.8             8 100.0 156      stres do mediany
stres do mediany.9             9  94.2 156      stres do mediany
stres do mediany.10           10  92.9 156      stres do mediany
stres do mediany.11           11  91.0 156      stres do mediany
stres do mediany.12           12  89.7 156      stres do mediany
stres powyżej mediany.8        8  95.1 144 stres powyżej mediany
stres powyżej mediany.9        9  88.2 144 stres powyżej mediany
stres powyżej mediany.10      10  83.3 144 stres powyżej mediany
stres powyżej mediany.11      11  79.9 144 stres powyżej mediany
stres powyżej mediany.12      12  74.3 144 stres powyżej mediany
8. Test Little’a i mini-symulacja MAR a MNAR
R
# Test MCAR Little'a i dlaczego wykres nie odróżni MAR od MNAR (kontynuacja: dane)
as.data.frame(mcar_test(dane[, c("stres", "sen", "aktywnosc", "dochod", "wsparcie",
                   "zadowolenie", "motywacja", "wypalenie", "zaangazowanie")]))
# Osobna mini-symulacja: dochód zależy od trybu studiów; dwa mechanizmy braków
# (parametry MNAR dobrane ręcznie tak, by odsetki braków w grupach były podobne jak przy MAR)
set.seed(5641)
m <- 2000
tryb_s <- sample(c("stacjonarne", "niestacjonarne"), m, replace = TRUE, prob = c(0.6, 0.4))
dochod_s <- ifelse(tryb_s == "stacjonarne", rlnorm(m, log(1800), 0.45), rlnorm(m, log(4200), 0.4))
brak_mar <- runif(m) < ifelse(tryb_s == "niestacjonarne", 0.28, 0.08)          # zależy od trybu
brak_mnar <- runif(m) < plogis(-2.8 + 2.2 * (log(dochod_s) - log(1800)))   # zależy od samego dochodu
round(100 * rbind(MAR = tapply(brak_mar, tryb_s, mean), MNAR = tapply(brak_mnar, tryb_s, mean)), 1)
# czego nie widać na wykresie: prawdziwy średni dochód osób z brakiem i bez braku w obrębie trybu
round(tapply(dochod_s, list(brak = brak_mar, tryb = tryb_s), mean))    # MAR
round(tapply(dochod_s, list(brak = brak_mnar, tryb = tryb_s), mean))   # MNAR
Wynik w R
  statistic  df      p.value missing.patterns
1  212.7133 133 1.374565e-05               23
     niestacjonarne stacjonarne
MAR            28.9         7.1
MNAR           31.6         8.2
       tryb
brak    niestacjonarne stacjonarne
  FALSE           4579        2048
  TRUE            4668        1956
       tryb
brak    niestacjonarne stacjonarne
  FALSE           4185        1947
  TRUE            5510        3090
Bibliografia oprogramowania
Wyniki i rysunki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- naniar (wersja 1.1.0): Tierney, N., & Cook, D. (2023). Expanding tidy data principles to facilitate missing data exploration, visualization and assessment of imputations. Journal of Statistical Software, 105(7), 1–31. https://doi.org/10.18637/jss.v105.i07
- visdat (wersja 0.6.0): Tierney, N. (2017). visdat: Visualising whole data frames. Journal of Open Source Software, 2(16), 355. https://doi.org/10.21105/joss.00355
- UpSetR (wersja 1.4.1): Conway, J. R., Lex, A., & Gehlenborg, N. (2017). UpSetR: An R package for the visualization of intersecting sets and their properties. Bioinformatics, 33(18), 2938–2940. https://doi.org/10.1093/bioinformatics/btx364
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridis i viridisLite (wersje 0.6.5 i 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [R package]. https://doi.org/10.5281/zenodo.4678326
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Tylko tabela odsetków – bez mapy i wzorców nie zobaczysz porzucenia ani braków występujących razem.
- Nieposortowana mapa braków – monotoniczny wzorzec przerwania ankiety ginie w szumie.
- „Braki wyglądają losowo, więc są MCAR” – wygląd wykresu niczego nie dowodzi, a MNAR nie wykluczy żaden wykres.
- Wykres rozrzutu bez osób z brakiem – domyślny ggplot2 usuwa je z ostrzeżeniem, którego nikt nie czyta.
- Kolor jako jedyny nośnik informacji – dodaj kształt, typ linii albo liczby w komórkach i sprawdź paletę w symulacji deuteranopii.
Najczęstsze pytania
Jak zrobić wykres braków danych w R?
Najprościej pakietami visdat i naniar. vis_miss() rysuje mapę braków całego zbioru, gg_miss_var() – odsetek braków w zmiennych, gg_miss_upset() – kombinacje braków, geom_miss_point() – braki na wykresie rozrzutu, a gg_miss_fct() – braki w grupach. Wiersze mapy posortuj według liczby braków, inaczej przerwanie ankiety zginie w szumie.
Czy z wykresu można poznać, że braki danych są MNAR?
Nie. Wykres pokazuje tylko zależność braków od zmiennych obserwowanych. Braki zależne od samej brakującej wartości mogą dać identyczny obraz jak braki MAR, bo tej wartości nie znasz. Gdy MNAR jest prawdopodobny, zaplanuj analizę wrażliwości.
Co pokazuje wykres UpSet dla braków danych?
Każdy słupek to jeden wzorzec braków, czyli zestaw zmiennych, w których brakuje odpowiedzi jednocześnie, a jego wysokość – liczba osób z tym wzorcem. Kropki połączone linią pod słupkiem mówią, o które zmienne chodzi. Wykres szybko odróżnia pojedyncze pominięcia od przerwania ankiety, ale pokazuje tylko najczęstsze wzorce.
Jak pokazać na wykresie przerwanie ankiety?
Dla każdej pozycji ankiety policz odsetek osób, które na nią odpowiedziały albo odpowiedziały na którąkolwiek dalszą pozycję, i narysuj to linią schodkową. Linie dla grup, np. o niższym i wyższym stresie, pokażą, czy ankietę przerywały osoby o określonych cechach. Jeśli oś nie zaczyna się od zera, napisz to w nocie.
Czy wykres braków danych wstawić do pracy?
Zwykle wystarczy jeden lub dwa rysunki w aneksie, np. mapa albo wzorce braków i schodek porzucenia, a w tekście liczby: odsetek braków, liczba osób z kompletem danych i zmienne, od których braki zależą. W Metodzie opisz też, co z brakami zrobiono.
Powiązane hasła
Przeczytaj też
Braki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikBraki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →PoradnikKorelacje na wykresie
Mapa cieplna w dobrej kolejności, korekta zamiast gwiazdek, ggpairs ujawniający próg i sufit oraz korelacje z przedziałami ufności – pięć rysunków z kodem R.
Czytaj →Masz w ankiecie dużo braków danych?
Pomożemy obejrzeć braki, wybrać zmienne pomocnicze, przeprowadzić imputację wielokrotną i opisać całość w pracy tak, żebyś umiał(a) to wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), Article 5444. https://doi.org/10.1038/s41467-020-19160-7 ● Otwarty dostęp
- Galesic, M., & Bosnjak, M. (2009). Effects of questionnaire length on participation and indicators of response quality in a web survey. Public Opinion Quarterly, 73(2), 349–360. https://doi.org/10.1093/poq/nfp031 ● Otwarty dostęp: pełny tekst
- Lex, A., Gehlenborg, N., Strobelt, H., Vuillemot, R., & Pfister, H. (2014). UpSet: Visualization of intersecting sets. IEEE Transactions on Visualization and Computer Graphics, 20(12), 1983–1992. https://doi.org/10.1109/tvcg.2014.2346248 ● Otwarty dostęp
- Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
- Peytchev, A. (2009). Survey breakoff. Public Opinion Quarterly, 73(1), 74–97. https://doi.org/10.1093/poq/nfp014
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Tierney, N., & Cook, D. (2023). Expanding tidy data principles to facilitate missing data exploration, visualization and assessment of imputations. Journal of Statistical Software, 105(7). https://doi.org/10.18637/jss.v105.i07 ● Otwarty dostęp
Cytowania BibTeX
@article{crameri2020misuse, author={Crameri, Fabio and Shephard, Grace E. and Heron, Philip J.}, title={{The misuse of colour in science communication}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5444}, doi={10.1038/s41467-020-19160-7}}@article{galesic2009effects, author={Galesic, M. and Bosnjak, M.}, title={{Effects of questionnaire length on participation and indicators of response quality in a web survey}}, journal={Public Opinion Quarterly}, year={2009}, volume={73}, number={2}, pages={349--360}, doi={10.1093/poq/nfp031}}@article{lex2014upset, author={Lex, Alexander and Gehlenborg, Nils and Strobelt, Hendrik and Vuillemot, Romain and Pfister, Hanspeter}, title={{UpSet: Visualization of intersecting sets}}, journal={IEEE Transactions on Visualization and Computer Graphics}, year={2014}, volume={20}, number={12}, pages={1983--1992}, doi={10.1109/tvcg.2014.2346248}}@article{little1988test, author={Little, Roderick J. A.}, title={{A test of missing completely at random for multivariate data with missing values}}, journal={Journal of the American Statistical Association}, year={1988}, volume={83}, number={404}, pages={1198--1202}, doi={10.1080/01621459.1988.10478722}}@article{peytchev2009survey, author={Peytchev, Andy}, title={{Survey breakoff}}, journal={Public Opinion Quarterly}, year={2009}, volume={73}, number={1}, pages={74--97}, doi={10.1093/poq/nfp014}}@article{rubin1976inference, author={Rubin, Donald B.}, title={{Inference and missing data}}, journal={Biometrika}, year={1976}, volume={63}, number={3}, pages={581--592}, doi={10.1093/biomet/63.3.581}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{tierney2023expanding, author={Tierney, Nicholas and Cook, Dianne}, title={{Expanding tidy data principles to facilitate missing data exploration, visualization and assessment of imputations}}, journal={Journal of Statistical Software}, year={2023}, volume={105}, number={7}, doi={10.18637/jss.v105.i07}}