612 wejść, 413 analizowanych – co się stało pomiędzy?
Narzędzie ankietowe pokazuje 612 rekordów, a w rozdziale wyników analizujesz 413 osób. Promotor albo recenzent zapyta wtedy: kto odpadł, z jakiego powodu i na którym etapie? Odpowiedzią jest diagram przepływu respondentów: kolumna prostokątów z liczbami osób na kolejnych etapach i boczne pola z liczbą wykluczonych oraz powodami. Bez niego czytelnik nie oceni, czy analizowana grupa nadal przypomina tę, do której kierowałeś(-aś) ankietę.
W badaniach obserwacyjnych taki opis zaleca wytyczna STROBE. W punkcie 13 każe podać liczbę osób na każdym etapie badania – od potencjalnie kwalifikujących się, przez włączonych, po analizowanych – oraz powody nieuczestniczenia na każdym etapie. Zaleca też rozważenie diagramu przepływu (Vandenbroucke i in., 2007). Ten wpis przenosi te zasady na ankietę online w pracy dyplomowej. Nie dotyczy eksperymentu z losowaniem warunków: tam diagram rozgałęzia się po losowaniu, a wykluczenia po bodźcu rządzą się innymi prawami. Opisujemy to w poradnikach wykluczanie respondentów w eksperymencie i jak opisać eksperyment ankietowy.
Przykład przewodni (wymyślony, dane symulowane). Studentka bada stres zawodowy nauczycieli szkół podstawowych. Ankieta online ma sześć stron: zgoda, pytania kwalifikujące z metryczką, dwie strony skali stresu (20 pozycji, w tym pierwsze pytanie kontrolne „zaznacz 2”), strona skali zadowolenia z pracy (10 pozycji i drugie pytanie kontrolne „zaznacz 4”) i strona końcowa. Link rozeszła dwiema drogami. Dyrektorzy 12 szkół przekazali go e-mailem 520 nauczycielom, a drugi link trafił do grup nauczycielskich w mediach społecznościowych. Dzięki osobnym linkom w danych widać kanał. Eksport zawiera wszystkie rekordy, także niedokończone.
Etapy przepływu: co liczyć i skąd wziąć liczby
Każdy etap diagramu to jedno pytanie: ile rekordów przeszło dalej i ile odpadło. Liczby bierzesz z eksportu, a nie z pamięci, dlatego potrzebujesz eksportu ze wszystkimi rekordami. Jeśli narzędzie zapisuje wyłącznie wysłane formularze, przerwanych ankiet nie policzysz – napisz to wprost w metodzie. Przydatne są paradane, przede wszystkim numer ostatniej odwiedzonej strony i informacja, czy ankietę wysłano.
| Etap | Co liczysz | Skąd w danych | Pułapka |
|---|---|---|---|
| Zaproszeni | Osoby, do których wysłano link | Lista mailingowa, informacja od dyrektorów | Przy linku w mediach społecznościowych tej liczby nie ma |
| Wejścia w link | Rekordy w eksporcie, także puste | Liczba wierszy pełnego eksportu | Eksport „tylko ukończone” ukrywa ten etap |
| Zgoda | Osoby, które zaznaczyły zgodę | Kolumna zgody | Zamknięcie strony bez odpowiedzi to też brak zgody |
| Kryteria włączenia | Osoby z grupy docelowej | Pytania kwalifikujące, pytanie filtrujące | Kryteria dopisane po obejrzeniu danych |
| Kompletność | Osoby z wystarczającą liczbą odpowiedzi | Liczba odpowiedzi w skalach, ostatnia strona | Mylenie „nie wysłał” z „nie odpowiedział” |
| Duplikaty | Drugie wypełnienia tej samej osoby | Zgodna metryczka i niemal identyczne odpowiedzi | Usunięcie pełnego rekordu zamiast niepełnego |
| Nieuważne odpowiedzi | Osoby, które odpowiadały bez czytania | Pytania kontrolne, czas, serie odpowiedzi | Próg dobrany tak, żeby „wyszło” |
| Analizowani | Osoby w analizie głównej | Wynik skryptu | Inna liczba w tabeli 1, inna w tekście |
Kolejność wierszy w tabeli nie jest przypadkowa. Odpowiada przebiegowi ankiety: najpierw zgoda, potem kwalifikacja, potem odpowiedzi. Do kolejności wrócimy, bo od niej zależą liczby w polach bocznych.
Kryteria wykluczeń zapisz przed otwarciem danych
Każde pole boczne diagramu odpowiada jednej regule. Reguły zapisz, zanim zobaczysz wyniki – w planie analizy, a najlepiej w prerejestracji. André (2022) pokazał, że każda procedura wykluczania, która nie jest ślepa na testowaną hipotezę, może zawyżać odsetek wyników fałszywie dodatnich. Wykluczanie obserwacji odstających osobno w porównywanych grupach podnosiło go w symulacjach nawet do 43%. W przykładzie studentka przyjęła pięć reguł:
- Zgoda. Analizowane są tylko rekordy z zaznaczoną zgodą.
- Kryteria włączenia. Osoba pracuje obecnie w szkole podstawowej i ma co najmniej rok stażu. Jak sformułować takie kryteria, opisuje hasło kryteria włączenia i wyłączenia.
- Kompletność. Odpowiedzi na co najmniej 80% pozycji każdej skali (16 z 20 i 8 z 10). Pojedyncze braki są potem uzupełniane regułą proporcjonalną, opisaną we wpisie braki danych w ankiecie.
- Duplikaty. Rekord jest duplikatem, jeśli ma ten sam kanał, płeć, wiek i staż co rekord wcześniejszy oraz co najmniej 90% identycznych odpowiedzi w pozycjach wypełnionych w obu (co najmniej 10 wspólnych pozycji). Zostaje rekord wcześniejszy. O wykrywaniu powtórnych zgłoszeń i botów piszemy we wpisie boty i fałszywi respondenci.
- Nieuważne odpowiedzi. Oba pytania kontrolne zaznaczone błędnie. Jeden błąd nie wystarcza – wyjaśnia to wpis o nieuważnych odpowiedziach. Ward i Meade (2023) w przeglądzie podkreślają, że nieuważne odpowiedzi trzeba nie tylko wykrywać i usuwać, lecz także raportować.
Lista CHERRIES dla ankiet internetowych wymaga dokładnie takich informacji. Pyta, jak zapobiegano powtórnym wypełnieniom albo jak usuwano duplikaty i który rekord zostawiono (pierwszy czy ostatni), czy analizowano ankiety przerwane i jaki próg czasu przyjęto, jeśli wykluczano zbyt szybkie wypełnienia (Eysenbach, 2004). Pełny przegląd czynności porządkowych, od których zależą te reguły, zawiera hasło czyszczenie danych z ankiety online.
Kolejność reguł zmienia liczby w diagramie
Diagram jest sekwencyjny: każdy rekord pojawia się w polu bocznym tylko raz, przy pierwszej regule, która go wykluczyła. Dzięki temu liczby się sumują: 612 − 38 − 49 − 81 − 6 − 25 = 413. Ceną jest to, że liczba w polu zależy od miejsca reguły w kolejce. Rysunek 1 pokazuje to na przykładzie.
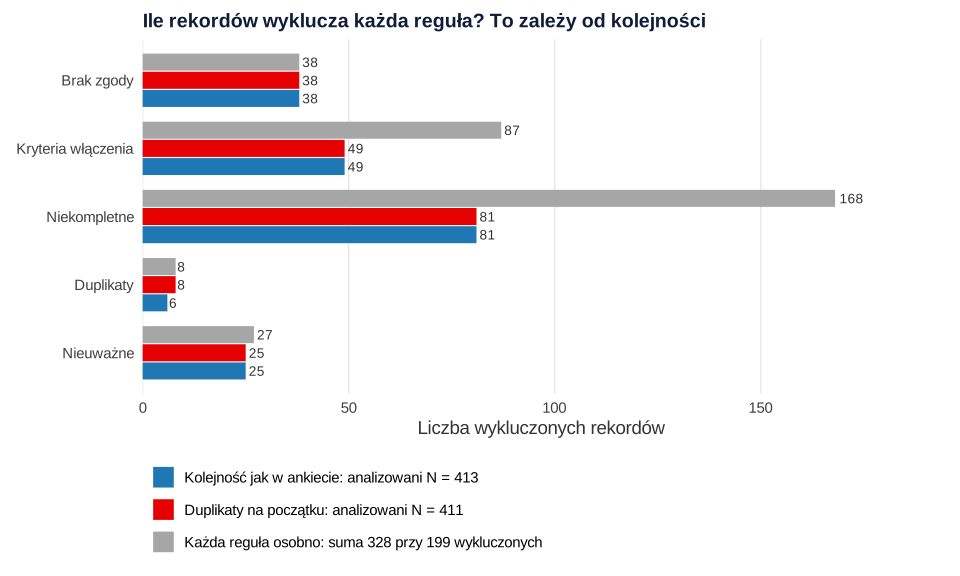
Duplikaty na początku. Ta sama lista reguł z duplikatami na pierwszym miejscu usuwa 8 rekordów zamiast 6, a do analizy trafia 411 osób zamiast 413. Dwie nauczycielki przerwały ankietę na stronie 4, a potem wypełniły ją od nowa do końca. Reguła „zostaje rekord wcześniejszy” usunęła ich pełne drugie podejście jako duplikat. Pierwsze, niekompletne, odpadło chwilę później za braki – i obie osoby zniknęły z analizy. W kolejności zgodnej z ankietą niekompletne pierwsze podejścia odpadają wcześniej, więc pełne rekordy zostają. Druga ochrona to sama reguła: z pary duplikatów zostaw rekord najbardziej kompletny, a przy równej kompletności – wcześniejszy.
Każda reguła osobno. Jeśli policzysz każdą regułę niezależnie na wszystkich rekordach, suma wyniesie 328, choć wykluczonych jest 199 rekordów. Powód: 89 rekordów spełnia co najmniej dwa kryteria naraz. Osoba bez zgody nie ma też odpowiedzi na pytania kwalifikujące ani w skalach, więc „wypada” trzy razy. Taka tabela bywa przydatna jako uzupełnienie, ale nie wstawiaj jej liczb do diagramu – nie będą się sumować.
Praktyczna zasada: stosuj reguły w kolejności, w jakiej respondent przechodził przez ankietę, a reguły, które porównują rekordy między sobą (duplikaty), dopiero wtedy, gdy zostały rekordy nadające się do analizy. Kolejność zapisz w planie analizy razem z regułami. Szczegółowe reguły kontroli wartości i dziennik zmian w danych opisuje wpis reguły kontroli danych przed analizą.
Przerwane ankiety: gdzie i kto odpadał
Największą grupą wykluczonych są zwykle osoby, które rozpoczęły ankietę i jej nie skończyły. W przykładzie to 71 osób, które przerwały przed końcem skal, i 10 osób, które doszły do końca, ale pominęły ponad 20% pozycji. Peytchev (2009) opisał przerwania jako zjawisko szczególnie częste w ankietach internetowych. Przewidywały je cechy kwestionariusza widoczne dopiero po rozpoczęciu, takie jak budowa pytań i obciążenie respondenta. Osoby przerywające nie wyglądały przy tym na nieuważne.
Dla diagramu ważne są dwie rzeczy. Po pierwsze, „przerwał” to nie to samo co „nie wysłał”. Czternaście osób odpowiedziało na wszystkie pytania obu skal, a zamknęło ankietę na stronie końcowej bez wysłania. Reguła kompletności dotyczy odpowiedzi w skalach, więc te osoby są w analizie. Napisz to w metodzie, żeby nikt nie liczył ich jako przerwań. Po drugie, sprawdź, gdzie ludzie odpadają i czy kanały się różnią (rysunek 2).
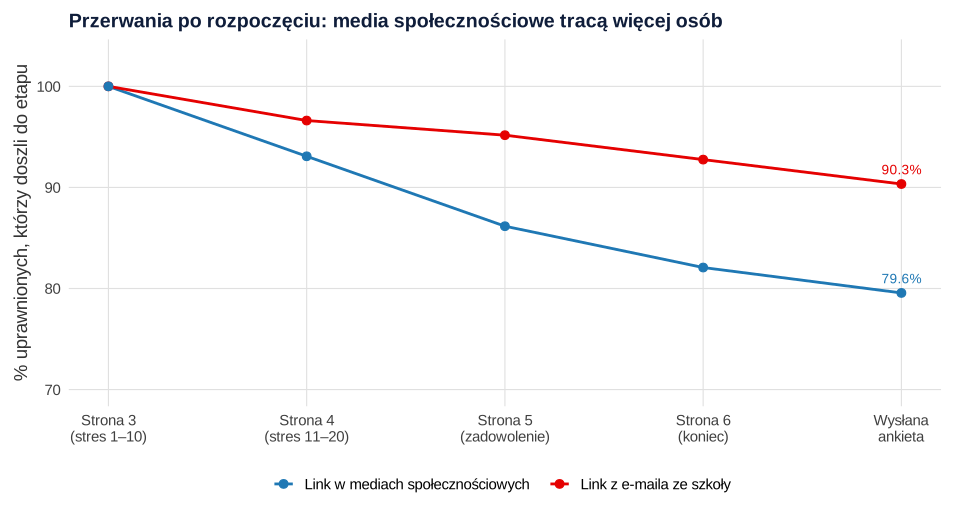
Z linku e-mailowego ankietę wysłało 90.3% uprawnionych rekordów, z mediów społecznościowych – 79.6%. W obu kanałach najwięcej osób odpadało na dwóch stronach skali stresu. Takie liczby warto podać w tekście albo w polu bocznym. Jeśli osoby przerywające różnią się od pozostałych w pytaniach, na które zdążyły odpowiedzieć, analiza samych kompletnych rekordów może być obciążona. Jak to sprawdzić, pokazuje wpis o brakach danych w ankiecie. W badaniu z kilkoma pomiarami diagram ma dodatkowe poziomy – osoby utracone między pomiarami opisuje hasło utrata uczestników.
Odsetek odpowiedzi tylko tam, gdzie znasz mianownik
Wskaźnik odpowiedzi wymaga liczby zaproszonych. Przy linku e-mailowym ją znasz, przy linku w mediach społecznościowych – nie. Nie wiesz, ile osób zobaczyło post, więc nie istnieje żaden mianownik. STROBE przypomina, że nie ma powszechnie przyjętych definicji odsetka uczestnictwa i odpowiedzi, dlatego czytelnik musi wiedzieć, jak je policzono (Vandenbroucke i in., 2007). Lista CHERRIES proponuje dla ankiet internetowych trzy wskaźniki: odsetek wyświetleń (osoby, które weszły na pierwszą stronę ankiety, wśród odwiedzających stronę z zaproszeniem), odsetek uczestnictwa (osoby, które wyraziły zgodę, wśród wchodzących na pierwszą stronę) i odsetek ukończenia (osoby, które wysłały ostatnią stronę, wśród tych, które wyraziły zgodę; Eysenbach, 2004). W przykładzie osoby niespełniające kryteriów kończyły ankietę na stronie 2, więc odsetek ukończenia liczymy wśród uprawnionych.
| Wskaźnik | Link z e-maila (12 szkół) | Link w mediach społecznościowych |
|---|---|---|
| Zaproszeni | 520 | nieznana liczba |
| Wejścia w link | 227 | 385 |
| Odsetek uczestnictwa (zgoda / wejścia) | 95.2% (216 z 227) | 93.0% (358 z 385) |
| Odsetek ukończenia (wysłane / uprawnieni) | 90.3% (187 z 207) | 79.6% (253 z 318) |
| Wskaźnik odpowiedzi (osoby, które wysłały / zaproszeni) | 35.6% (185 z 520) | nie da się policzyć |
| Analizowani | 175 (33.7% zaproszonych) | 238 |
W wskaźniku odpowiedzi liczysz osoby, a nie rekordy: z 187 wysłanych ankiet z linku e-mailowego dwie były drugim wysłaniem tej samej osoby, stąd 185. Przy linku otwartym nie pisz „odsetek odpowiedzi wyniósł 93%” – to odsetek zgód wśród osób, które same weszły w link. Taka próba to dobór wygodny, a ryzyko błędu braku odpowiedzi opisujesz w ograniczeniach. Jak zaplanować liczbę zaproszeń przy znanym odsetku odpowiedzi, pokazuje wpis ile zaproszeń wysłać.
Diagram: układ i rysowanie
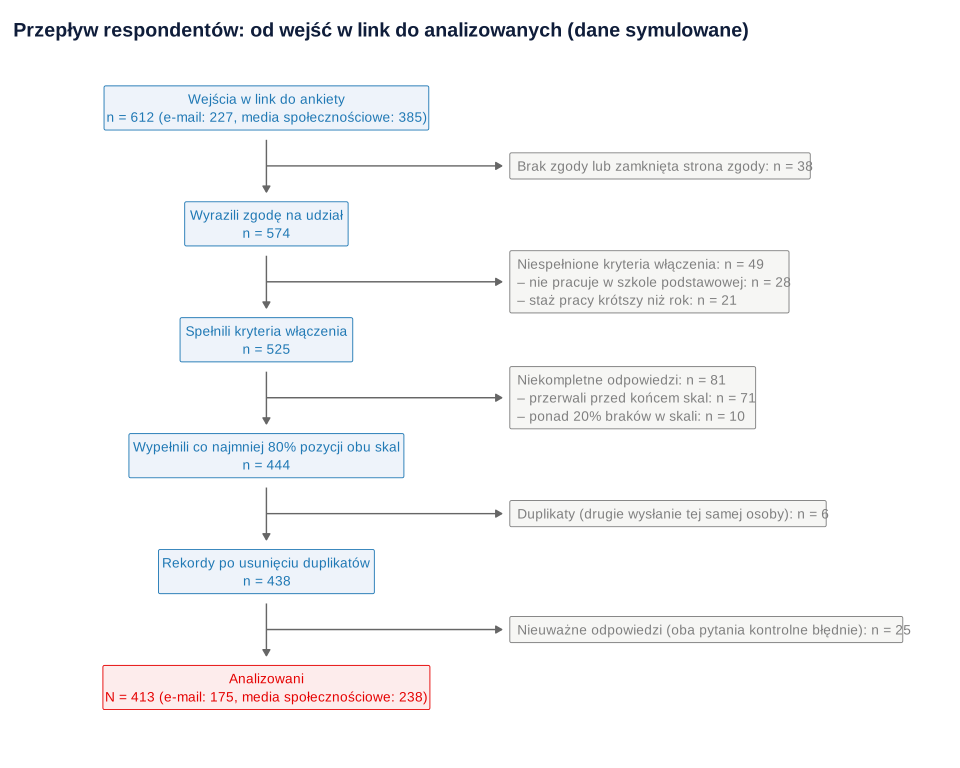
Rysunek 3 to diagram przepływu dla przykładu. Kolumna środkowa pokazuje liczby osób, które przechodzą dalej, a pola po prawej – wykluczonych z podziałem na powody. Kanał dotarcia podajemy w pierwszym i ostatnim polu, bo czytelnik od razu widzi, że analizowana grupa ma inną strukturę niż wejścia.
Zasady, które warto zachować niezależnie od programu:
- Liczby z jednego skryptu. Diagram, tabela charakterystyki próby i tekst muszą mieć te same liczby. Najprościej, gdy skrypt liczy przepływ i od razu zapisuje tabelę liczebności, z której powstaje rysunek – tak działa kod na końcu wpisu. Gotowy diagram sprawdź jeszcze raz według listy z wpisu kontrola spójności liczb przed oddaniem.
- Liczby, które się sumują. Pole górne minus wszystkie pola boczne daje pole dolne. Jeśli nie daje, gdzieś zgubiłeś(-aś) rekordy.
- Powody w polach bocznych. „Wykluczono 49 osób” to za mało. Podział na powody to dokładnie to, o co prosi STROBE.
- Nazwy etapów z Twojej ankiety. „Spełnili kryteria włączenia” zamiast „eligible”. Nie kopiuj pól z diagramu badania klinicznego, jeśli nie było losowania.
Diagram narysujesz w R (kod niżej, sam ggplot2), w programie do grafiki albo w edytorze tekstu. W badaniu klinicznym z randomizacją obowiązuje diagram CONSORT – wersja z 2025 roku to lista 30 punktów i diagram przepływu uczestników (Hopewell i in., 2025). W przeglądzie systematycznym odpowiednikiem jest diagram PRISMA. Którą listę wybrać do jakiego badania, wyjaśnia wpis STROBE, CONSORT i TRIPOD. Dla badań ankietowych powstała też lista CROSS – 40 pozycji w 19 sekcjach (Sharma i in., 2021).
Jeśli nie używasz R, ten sam diagram zrobisz w generatorze diagramu przepływu respondentów: wpisujesz etapy i powody wykluczeń, a narzędzie sprawdza sumy i daje plik SVG lub PNG.
Opis w metodach i wynikach
Diagram nie zastępuje tekstu. W metodzie opisz reguły i ich kolejność, w wynikach – liczby. Wzór na podstawie przykładu; dopasuj kryteria i liczby do swojego badania.
Opis próby po wykluczeniach (płeć, wiek, staż analizowanych) przedstaw osobno – podpowiada to wpis jak opisać charakterystykę próby. Jeśli wykluczenia były liczne, dodaj analizę wrażliwości: wynik główny bez reguły nieuważności albo z łagodniejszym progiem kompletności.
Najczęstsze błędy
- Diagram zaczyna się od ukończonych ankiet. Eksport „tylko kompletne” ukrywa przerwania – a to zwykle największa grupa wykluczonych.
- Liczby się nie sumują. Najczęściej dlatego, że reguły liczono osobno, a w diagramie wpisano ich sumy.
- Brak powodów w polach bocznych. Jedno pole „wykluczeni: 199” nie mówi, czy problemem była rekrutacja, długość ankiety czy uwaga respondentów.
- „Odsetek odpowiedzi” przy linku w mediach społecznościowych. Bez liczby zaproszonych to nie jest wskaźnik odpowiedzi.
- Duplikaty usuwane jako pierwsze z zasadą „zostaje pierwszy”. Osoba, która przerwała i zaczęła od nowa, traci pełny rekord.
- Reguły ustalane po obejrzeniu wyników. Zmiana progu nieuważności, „bo wtedy wynik jest istotny”, to p-hacking.
- Diagram CONSORT w badaniu bez losowania. Pola „przydział do grup” i „interwencja” nie mają sensu w ankiecie przekrojowej.
Jeśli chcesz, żeby ktoś sprawdził z Tobą reguły wykluczeń i liczby w diagramie, zobacz pomoc w analizie dla studentów.
Diagram przepływu respondentów w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy symulowany eksport ankiety (612 rekordów) i zapisuje go jako CSV. Drugi stosuje pięć reguł w ustalonej kolejności, porównuje ją z kolejnością „duplikaty najpierw” i z regułami liczonymi osobno, liczy wskaźniki według kanału i zapisuje tabele liczebności. Trzeci rysuje z tych tabel diagram w ggplot2. Przepisy uruchamiaj po kolei z jednego folderu. Rysunki 1 i 2 powstały w osobnym skrypcie na tych samych danych. Symulowany eksport możesz pobrać: ankieta-nauczycieli-eksport-612.csv (612 rekordów: kanał, data rozpoczęcia, zgoda, pytania kwalifikujące, metryczka, ostatnia strona, wysłanie, pozycje s01–s20 i z01–z10 w skali 1–5, pytania kontrolne k1 i k2, czas w minutach; dane fikcyjne).
Symulowany eksport ankiety: 612 wejść w link
R
# B446 – symulowany eksport ankiety online: 612 wejść w link (dane fikcyjne)
# Ankieta o stresie zawodowym nauczycieli szkół podstawowych, dwa linki: e-mail ze szkół i media społecznościowe.
# Strony: 1 zgoda, 2 pytania kwalifikujące i metryczka, 3–4 skala stresu (s01–s20, 1–5; na str. 3 pytanie
# kontrolne k1: „zaznacz 2”), 5 skala zadowolenia (z01–z10, 1–5; pytanie kontrolne k2: „zaznacz 4”), 6 koniec.
set.seed(446)

n_osob <- 598                                   # różne osoby; 14 z nich wypełni ankietę drugi raz
osoby <- data.frame(kanal = sample(c("e-mail", "media"), n_osob, replace = TRUE, prob = c(.40, .60)))
osoby$start <- as.POSIXct("2026-03-02 07:00", tz = "UTC") + sort(runif(n_osob, 0, 21 * 24 * 3600))
osoby$zgoda <- ifelse(runif(n_osob) < .05, sample(c("nie", NA), n_osob, replace = TRUE), "tak")
media <- osoby$kanal == "media"
osoby$pracuje_sp <- ifelse(runif(n_osob) < ifelse(media, .08, .02), "nie", "tak")
osoby$staz <- pmax(0, round(rgamma(n_osob, shape = 2.2, scale = 6.5)))
osoby$staz[runif(n_osob) < .03] <- 0           # osoby, które pracują krócej niż rok
osoby$plec <- sample(c("kobieta", "mężczyzna"), n_osob, replace = TRUE, prob = c(.82, .18))
osoby$wiek <- pmin(67, pmax(23, round(24 + osoby$staz + rnorm(n_osob, 4, 4))))

# Do której strony doszła osoba (6 = wysłała ankietę) i czy odpowiadała nieuważnie
dalej <- function(p) runif(n_osob) > p
strona <- rep(1, n_osob)
ok <- osoby$zgoda %in% "tak"; strona[ok] <- 2
ok <- ok & osoby$pracuje_sp == "tak" & osoby$staz >= 1; strona[ok] <- 3   # pozostali kończą na stronie 2
for (s in 3:5) {
  ok <- ok & dalej(ifelse(media, c(.09, .06, .05)[s - 2], c(.05, .03, .03)[s - 2])); strona[ok] <- s + 1
}
wyslal <- ok & dalej(.03)                        # część osób zamyka ostatnią stronę bez wysłania
nieuwazny <- runif(n_osob) < .08

# Odpowiedzi: uważni zgodnie z poziomem stresu, nieuważni losowo; braki pojedynczych pozycji
poziom <- rnorm(n_osob)
pozycje <- function(k, lat) sapply(1:k, function(j) pmin(5, pmax(1, round(3 + .9 * lat + rnorm(n_osob, 0, .9)))))
S <- pozycje(20, poziom); Z <- pozycje(10, -.6 * poziom + rnorm(n_osob, 0, .8))
S[nieuwazny, ] <- sample(1:5, sum(nieuwazny) * 20, replace = TRUE)
Z[nieuwazny, ] <- sample(1:5, sum(nieuwazny) * 10, replace = TRUE)
k1 <- ifelse(nieuwazny, ifelse(runif(n_osob) < .25, 2, sample(c(1, 3:5), n_osob, TRUE)), ifelse(runif(n_osob) < .97, 2, 3))
k2 <- ifelse(nieuwazny, ifelse(runif(n_osob) < .25, 4, sample(c(1:3, 5), n_osob, TRUE)), ifelse(runif(n_osob) < .97, 4, 5))
pomijajacy <- runif(n_osob) < .03                # pomija ok. 30% pozycji
S[matrix(runif(n_osob * 20) < ifelse(pomijajacy, .30, .01), n_osob)] <- NA
Z[matrix(runif(n_osob * 10) < ifelse(pomijajacy, .30, .01), n_osob)] <- NA
# Strony, do których osoba nie doszła, są puste; na stronie przerwania – część odpowiedzi
czesc <- function(M, kol, wiersze) { for (i in wiersze) M[i, kol[runif(length(kol)) > runif(1, .1, .7)]] <- NA; M }
S[strona < 3, ] <- NA; S[strona <= 3, 11:20] <- NA; Z[strona <= 4, ] <- NA
S <- czesc(S, 1:10, which(strona == 3)); S <- czesc(S, 11:20, which(strona == 4)); Z <- czesc(Z, 1:10, which(strona == 5))
k1[strona < 3] <- NA; k2[strona < 5] <- NA
colnames(S) <- sprintf("s%02d", 1:20); colnames(Z) <- sprintf("z%02d", 1:10)
osoby[!(osoby$zgoda %in% "tak"), c("pracuje_sp", "staz", "plec", "wiek")] <- NA
eksport <- data.frame(osoby, ostatnia_strona = strona, wyslana = as.integer(wyslal), S, k1, Z, k2,
                      czas_min = round(ifelse(nieuwazny, rlnorm(n_osob, log(4), .4), rlnorm(n_osob, log(11), .35)) *
                                         pmin(strona, 6) / 6, 1))

# Drugie wypełnienia: 8 osób przerwało i zaczęło od nowa, 6 wysłało ankietę dwa razy
pelni <- which(eksport$wyslana == 1 & !nieuwazny & !pomijajacy)
ponowni <- sample(pelni, 14)
drugie <- eksport[ponowni, ]
drugie$start <- drugie$start + runif(14, 10, 600) * 60
kol <- c(colnames(S), colnames(Z))
drugie[, kol] <- as.matrix(drugie[, kol]) + (matrix(runif(14 * 30), 14) < .02) * sample(c(-1, 1), 14 * 30, TRUE)
drugie[, kol] <- pmin(5, pmax(1, as.matrix(drugie[, kol])))
for (i in 1:8) {                                 # pierwsze podejście tych 8 osób urwało się na str. 3 lub 4
  r <- ponowni[i]; s <- sample(3:4, 1)
  eksport$ostatnia_strona[r] <- s; eksport$wyslana[r] <- 0
  eksport[r, c(if (s == 3) colnames(S)[6:20] else colnames(S)[16:20], colnames(Z), "k2")] <- NA
}
eksport <- rbind(eksport, drugie)
eksport <- eksport[order(eksport$start), ]
eksport <- data.frame(id = seq_len(nrow(eksport)), eksport, row.names = NULL)
eksport$start <- format(eksport$start, "%Y-%m-%d %H:%M")
write.csv(eksport, "ankieta-nauczycieli-eksport-612.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

cat("Rekordy w eksporcie:", nrow(eksport), "\n")
print(table(kanal = eksport$kanal, ostatnia_strona = eksport$ostatnia_strona))
cat("Wysłane ankiety:", sum(eksport$wyslana), "\n")
Wynik w R
Rekordy w eksporcie: 612
        ostatnia_strona
kanal      1   2   3   4   5   6
  e-mail  11   9   7   3   5 192
  media   27  40  22  22  13 261
Wysłane ankiety: 440
Reguły wykluczeń po kolei, liczby do diagramu i wskaźniki
R
# B446 – od 612 wejść do analizowanych: kryteria stosowane po kolei, liczby do diagramu i wskaźniki
d <- read.csv("ankieta-nauczycieli-eksport-612.csv", encoding = "UTF-8")
S <- sprintf("s%02d", 1:20); Z <- sprintf("z%02d", 1:10)

# Reguły zapisane przed analizą. Każda dostaje bieżący zbiór i zwraca TRUE dla rekordów, które zostają.
duplikat <- function(x) {                        # rekord powtarza wcześniejszy rekord z tego samego zbioru
  klucz <- paste(x$kanal, x$plec, x$wiek, x$staz); odp <- as.matrix(x[, c(S, Z)])
  powt <- rep(FALSE, nrow(x))
  for (i in seq_len(nrow(x))[-1]) {
    if (is.na(x$plec[i])) next
    for (j in which(klucz[seq_len(i - 1)] == klucz[i] & !powt[seq_len(i - 1)])) {
      oba <- !is.na(odp[i, ]) & !is.na(odp[j, ])
      if (sum(oba) >= 10 && mean(odp[i, oba] == odp[j, oba]) >= .90) { powt[i] <- TRUE; break }
    }
  }
  powt
}
reguly <- list(
  zgoda       = function(x) x$zgoda %in% "tak",
  kryteria    = function(x) x$pracuje_sp %in% "tak" & !is.na(x$staz) & x$staz >= 1,
  kompletnosc = function(x) rowSums(!is.na(x[, S])) >= 16 & rowSums(!is.na(x[, Z])) >= 8,
  duplikaty   = function(x) !duplikat(x),
  uwaga       = function(x) !(x$k1 %in% c(1, 3:5) & x$k2 %in% c(1:3, 5))   # oba pytania kontrolne błędnie
)
przeplyw <- function(x, kolejnosc) {
  wynik <- data.frame(etap = "wejścia w link", wykluczeni = NA, zostaje = nrow(x))
  for (r in kolejnosc) {
    zost <- reguly[[r]](x)
    wynik <- rbind(wynik, data.frame(etap = r, wykluczeni = sum(!zost), zostaje = sum(zost)))
    x <- x[zost, ]
  }
  attr(wynik, "dane") <- x
  wynik
}

# 1. Kolejność zgodna z przebiegiem ankiety: duplikaty szukamy dopiero wśród kompletnych rekordów
A <- przeplyw(d, c("zgoda", "kryteria", "kompletnosc", "duplikaty", "uwaga"))
print(A, row.names = FALSE)
analiz <- attr(A, "dane")
etap2 <- d[d$zgoda %in% "tak", ]
cat("Powody niespełnienia kryteriów: nie pracuje w szkole podstawowej =", sum(etap2$pracuje_sp == "nie"),
    "; staż poniżej roku =", sum(etap2$pracuje_sp == "tak" & etap2$staz < 1), "\n")
etap3 <- etap2[reguly$kryteria(etap2), ]
niekompl <- etap3[!reguly$kompletnosc(etap3), ]
cat("Niekompletni: przerwali przed końcem skal =", sum(niekompl$ostatnia_strona < 6),
    "; doszli do końca, ale > 20% braków =", sum(niekompl$ostatnia_strona == 6), "\n")
cat("Wśród analizowanych bez wysłania ostatniej strony:", sum(analiz$wyslana == 0), "\n")
write.csv(A, "b446-przeplyw.csv", row.names = FALSE)
powody <- data.frame(etap = c("kryteria", "kryteria", "kompletnosc", "kompletnosc", "wejścia", "wejścia",
                              "analizowani", "analizowani"),
                     powod = c("nie pracuje w szkole podstawowej", "staż pracy krótszy niż rok",
                               "przerwali przed końcem skal", "doszli do końca, ale ponad 20% braków",
                               "e-mail", "media", "e-mail", "media"),
                     n = c(sum(etap2$pracuje_sp == "nie"), sum(etap2$pracuje_sp == "tak" & etap2$staz < 1),
                           sum(niekompl$ostatnia_strona < 6), sum(niekompl$ostatnia_strona == 6),
                           sum(d$kanal == "e-mail"), sum(d$kanal == "media"),
                           sum(analiz$kanal == "e-mail"), sum(analiz$kanal == "media")))
write.csv(powody, "b446-powody.csv", row.names = FALSE)

# 2. Ta sama lista reguł, ale duplikaty usuwane na początku (zostaje pierwszy rekord)
B <- przeplyw(d, c("duplikaty", "zgoda", "kryteria", "kompletnosc", "uwaga"))
print(B, row.names = FALSE)
cat("Różnica w liczbie analizowanych (A − B):", nrow(analiz) - nrow(attr(B, "dane")), "\n")

# 3. Kryteria liczone niezależnie na wszystkich 612 rekordach: osoby spełniają kilka naraz
flagi <- sapply(names(reguly), function(r) !reguly[[r]](d))
print(colSums(flagi))
cat("Suma flag:", sum(flagi), "; rekordy z co najmniej jedną flagą:", sum(rowSums(flagi) > 0),
    "; z dwiema lub więcej:", sum(rowSums(flagi) >= 2), "\n")

# 4. Wskaźniki według kanału (mianownik znany tylko dla e-maili: 520 zaproszonych nauczycieli)
wsk <- function(x, kanal, zaproszeni = NA) {
  x <- x[x$kanal == kanal, ]; zg <- sum(x$zgoda %in% "tak")
  upr <- x[reguly$zgoda(x) & reguly$kryteria(x), ]
  wysl <- upr[upr$wyslana == 1, ]; osoby_wysl <- sum(!duplikat(wysl))   # bez drugich wysłań
  data.frame(kanal, zaproszeni, wejscia = nrow(x), zgoda = zg, uprawnieni = nrow(upr),
             wyslali = nrow(wysl), osoby_wysl, analizowani = sum(analiz$kanal == kanal),
             udzial_proc = round(100 * zg / nrow(x), 1),
             ukonczenie_proc = round(100 * nrow(wysl) / nrow(upr), 1),
             odpowiedzi_proc = round(100 * osoby_wysl / zaproszeni, 1),
             analiz_proc = round(100 * sum(analiz$kanal == kanal) / zaproszeni, 1))
}
print(rbind(wsk(d, "e-mail", 520), wsk(d, "media")), row.names = FALSE)
Wynik w R
           etap wykluczeni zostaje
 wejścia w link         NA     612
          zgoda         38     574
       kryteria         49     525
    kompletnosc         81     444
      duplikaty          6     438
          uwaga         25     413
Powody niespełnienia kryteriów: nie pracuje w szkole podstawowej = 28 ; staż poniżej roku = 21
Niekompletni: przerwali przed końcem skal = 71 ; doszli do końca, ale > 20% braków = 10
Wśród analizowanych bez wysłania ostatniej strony: 14
           etap wykluczeni zostaje
 wejścia w link         NA     612
      duplikaty          8     604
          zgoda         38     566
       kryteria         49     517
    kompletnosc         81     436
          uwaga         25     411
Różnica w liczbie analizowanych (A − B): 2
      zgoda    kryteria kompletnosc   duplikaty       uwaga
         38          87         168           8          27
Suma flag: 328 ; rekordy z co najmniej jedną flagą: 201 ; z dwiema lub więcej: 89
  kanal zaproszeni wejscia zgoda uprawnieni wyslali osoby_wysl analizowani
 e-mail        520     227   216        207     187        185         175
  media         NA     385   358        318     253        249         238
 udzial_proc ukonczenie_proc odpowiedzi_proc analiz_proc
        95.2            90.3            35.6        33.7
        93.0            79.6              NA          NA
Diagram przepływu w ggplot2
R
# B446 – diagram przepływu respondentów w ggplot2 z liczb policzonych w poprzednim kroku
library(ggplot2)
A <- read.csv("b446-przeplyw.csv"); P <- read.csv("b446-powody.csv")
n <- setNames(A$zostaje, A$etap); w <- setNames(A$wykluczeni, A$etap)
pw <- function(etap, powod) P$n[P$etap == etap & P$powod == powod]

glowne <- c(
  sprintf("Wejścia w link do ankiety\nn = %d (e-mail: %d, media społecznościowe: %d)", n[["wejścia w link"]],
          pw("wejścia", "e-mail"), pw("wejścia", "media")),
  sprintf("Wyrazili zgodę na udział\nn = %d", n[["zgoda"]]),
  sprintf("Spełnili kryteria włączenia\nn = %d", n[["kryteria"]]),
  sprintf("Wypełnili co najmniej 80%% pozycji obu skal\nn = %d", n[["kompletnosc"]]),
  sprintf("Rekordy po usunięciu duplikatów\nn = %d", n[["duplikaty"]]),
  sprintf("Analizowani\nN = %d (e-mail: %d, media społecznościowe: %d)", n[["uwaga"]],
          pw("analizowani", "e-mail"), pw("analizowani", "media")))
boczne <- c(
  sprintf("Brak zgody lub zamknięta strona zgody: n = %d", w[["zgoda"]]),
  sprintf("Niespełnione kryteria włączenia: n = %d\n– nie pracuje w szkole podstawowej: n = %d\n– staż pracy krótszy niż rok: n = %d",
          w[["kryteria"]], pw("kryteria", "nie pracuje w szkole podstawowej"), pw("kryteria", "staż pracy krótszy niż rok")),
  sprintf("Niekompletne odpowiedzi: n = %d\n– przerwali przed końcem skal: n = %d\n– ponad 20%% braków w skali: n = %d",
          w[["kompletnosc"]], pw("kompletnosc", "przerwali przed końcem skal"),
          pw("kompletnosc", "doszli do końca, ale ponad 20% braków")),
  sprintf("Duplikaty (drugie wysłanie tej samej osoby): n = %d", w[["duplikaty"]]),
  sprintf("Nieuważne odpowiedzi (oba pytania kontrolne błędnie): n = %d", w[["uwaga"]]))

y <- seq(11, 1, length.out = 6)                       # pola główne od góry do dołu
pola <- rbind(data.frame(x = 2.6, y = y, tekst = glowne, typ = c("start", rep("etap", 4), "koniec"), hjust = .5),
              data.frame(x = 5.6, y = head(y, -1) - 1, tekst = boczne, typ = "wykluczeni", hjust = 0))
strzalki <- rbind(data.frame(x = 2.6, xend = 2.6, y = head(y, -1) - .55, yend = y[-1] + .55),
                  data.frame(x = 2.6, xend = 5.5, y = head(y, -1) - 1, yend = head(y, -1) - 1))
granat <- "#0f1d3a"; niebieski <- "#1f78b4"; czerwony <- "#e50101"
wykres <- ggplot() +
  geom_segment(data = strzalki, aes(x = x, y = y, xend = xend, yend = yend), colour = "grey40", linewidth = .5,
               arrow = arrow(length = unit(.18, "cm"), type = "closed")) +
  geom_label(data = pola, aes(x = x, y = y, label = tekst, fill = typ, colour = typ, hjust = hjust),
             size = 3.6, lineheight = 1.1, label.padding = unit(.5, "lines"), label.r = unit(.1, "lines"),
             show.legend = FALSE) +
  scale_fill_manual(values = c(start = "#eef3fa", etap = "#eef3fa", koniec = "#fdecec", wykluczeni = "#f6f6f4")) +
  scale_colour_manual(values = c(start = niebieski, etap = niebieski, koniec = czerwony, wykluczeni = "grey50")) +
  scale_x_continuous(limits = c(0, 10.4)) + scale_y_continuous(limits = c(.4, 11.6)) +
  labs(title = "Przepływ respondentów: od wejść w link do analizowanych (dane symulowane)") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = granat, size = rel(1.05)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
ggsave("diagram-przeplywu-respondentow-ankieta.svg", wykres, width = 10, height = 8, bg = "white")

cat(glowne, sep = "\n"); cat("\n"); cat(boczne, sep = "\n")
Wynik w R
Wejścia w link do ankiety
n = 612 (e-mail: 227, media społecznościowe: 385)
Wyrazili zgodę na udział
n = 574
Spełnili kryteria włączenia
n = 525
Wypełnili co najmniej 80% pozycji obu skal
n = 444
Rekordy po usunięciu duplikatów
n = 438
Analizowani
N = 413 (e-mail: 175, media społecznościowe: 238)

Brak zgody lub zamknięta strona zgody: n = 38
Niespełnione kryteria włączenia: n = 49
– nie pracuje w szkole podstawowej: n = 28
– staż pracy krótszy niż rok: n = 21
Niekompletne odpowiedzi: n = 81
– przerwali przed końcem skal: n = 71
– ponad 20% braków w skali: n = 10
Duplikaty (drugie wysłanie tej samej osoby): n = 6
Nieuważne odpowiedzi (oba pytania kontrolne błędnie): n = 25
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; diagram narysowano w pakiecie ggplot2 i zapisano przez svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed zebraniem danych i przed analizą sprawdź…
- Czy narzędzie zapisuje rekordy przerwane i numer ostatniej strony, a eksport obejmuje wszystkie rekordy?
- Czy każdy kanał rekrutacji ma osobny link albo ukryte pole z kanałem?
- Czy znasz liczbę zaproszonych tam, gdzie da się ją ustalić?
- Czy reguły wykluczeń i ich kolejność są zapisane przed otwarciem danych?
- Czy reguła duplikatów mówi, który rekord zostaje?
- Czy liczby w diagramie sumują się od góry do dołu i zgadzają z tabelą charakterystyki próby?
- Czy w polach bocznych są powody wykluczeń, a w tekście – sposób liczenia wskaźników?
- Czy skrypt, który liczy przepływ, jest częścią materiałów do pracy (zob. pakiet replikacyjny)?
Najczęstsze pytania
Czy w diagramie przepływu podawać osoby, które tylko otworzyły link do ankiety?
Tak, jeśli narzędzie je zapisało. Pierwsze pole to wszystkie rekordy w pełnym eksporcie, także puste, a osoby bez zgody trafiają do pierwszego pola bocznego. Gdy narzędzie zapisuje tylko wysłane formularze, zacznij od nich i napisz w metodzie, że przerwań nie dało się policzyć.
W jakiej kolejności stosować kryteria wykluczenia respondentów?
W kolejności, w jakiej respondent przechodził przez ankietę: zgoda, kryteria włączenia, kompletność odpowiedzi, a dopiero potem reguły porównujące rekordy między sobą (duplikaty) i reguły jakości, np. pytania kontrolne. Każdy rekord liczysz raz, przy pierwszej regule, która go wykluczyła. Kolejność zapisz w planie analizy razem z regułami.
Jak policzyć odsetek odpowiedzi, gdy link do ankiety był udostępniony w mediach społecznościowych?
Nie da się, bo nie znasz liczby osób, które zobaczyły zaproszenie. Podaj liczbę wejść w link, odsetek osób, które wyraziły zgodę, i odsetek ukończenia wśród uprawnionych, a w ograniczeniach opisz dobór wygodny. Wskaźnik odpowiedzi licz tylko dla kanałów ze znaną liczbą zaproszonych, np. listy e-mailowej.
Czy osobę, która nie wysłała ostatniej strony ankiety, można włączyć do analizy?
Tak, jeśli reguła kompletności dotyczy odpowiedzi w analizowanych skalach, a nie samego kliknięcia „wyślij”. W przykładzie 14 osób odpowiedziało na wszystkie pozycje skal i zamknęło stronę końcową bez wysłania – zostały w analizie. Regułę ustal przed analizą i opisz w metodzie.
Gdzie w pracy dyplomowej umieścić diagram przepływu respondentów?
Na początku rozdziału wyników albo na końcu opisu procedury w rozdziale metodologicznym, przed tabelą charakterystyki próby. W tekście podaj te same liczby i odeślij do rysunku. Liczba analizowanych w diagramie musi być równa liczebności w tabeli próby.
Powiązane hasła
Przeczytaj też
Uczestnik wycofuje się po zebraniu danych
Rezygnacja czy usunięcie, ankieta anonimowa a kod: co zrobić, wzory odpowiedzi, usunięcie rekordów w R i zdania do Metody.
Czytaj →PoradnikBraki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikReguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →Nie wiesz, jak pokazać, ilu respondentów odpadło i dlaczego?
Ustalimy z Tobą reguły wykluczeń i ich kolejność, policzymy przepływ i wskaźniki w R lub SPSS, przygotujemy diagram i wyjaśnimy liczby tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- André, Q. (2022). Outlier exclusion procedures must be blind to the researcher’s hypothesis. Journal of Experimental Psychology: General, 151(1), 213–223. https://doi.org/10.1037/xge0001069 ● Otwarty dostęp: pełny tekst
- Eysenbach, G. (2004). Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES). Journal of Medical Internet Research, 6(3), Article e34. https://doi.org/10.2196/jmir.6.3.e34 ● Otwarty dostęp
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 statement: Updated guideline for reporting randomised trials. BMJ, 389, Article e081123. https://doi.org/10.1136/bmj-2024-081123 ● Otwarty dostęp
- Peytchev, A. (2009). Survey breakoff. Public Opinion Quarterly, 73(1), 74–97. https://doi.org/10.1093/poq/nfp014
- Sharma, A., Minh Duc, N. T., Luu Lam Thang, T., Nam, N. H., Ng, S. J., Abbas, K. S., Huy, N. T., Marušić, A., Paul, C. L., Kwok, J., Karbwang, J., de Waure, C., Drummond, F. J., Kizawa, Y., Taal, E., Vermeulen, J., Lee, G. H. M., Gyedu, A., To, K. G., . . . Karamouzian, M. (2021). A consensus-based Checklist for Reporting of Survey Studies (CROSS). Journal of General Internal Medicine, 36(10), 3179–3187. https://doi.org/10.1007/s11606-021-06737-1 ● Otwarty dostęp
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Initiative. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), Article e297. https://doi.org/10.1371/journal.pmed.0040297 ● Otwarty dostęp
- Ward, M. K., & Meade, A. W. (2023). Dealing with careless responding in survey data: Prevention, identification, and recommended best practices. Annual Review of Psychology, 74(1), 577–596. https://doi.org/10.1146/annurev-psych-040422-045007 ● Otwarty dostęp
Cytowania BibTeX
@article{andre2022outlier, author={André, Quentin}, title={{Outlier exclusion procedures must be blind to the researcher’s hypothesis}}, journal={Journal of Experimental Psychology: General}, year={2022}, volume={151}, number={1}, pages={213--223}, doi={10.1037/xge0001069}}@article{eysenbach2004improving, author={Eysenbach, Gunther}, title={{Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES)}}, journal={Journal of Medical Internet Research}, year={2004}, volume={6}, number={3}, eid={e34}, doi={10.2196/jmir.6.3.e34}}@article{hopewell2025consortstatement, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 statement: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081123}, doi={10.1136/bmj-2024-081123}}@article{peytchev2009survey, author={Peytchev, Andy}, title={{Survey breakoff}}, journal={Public Opinion Quarterly}, year={2009}, volume={73}, number={1}, pages={74--97}, doi={10.1093/poq/nfp014}}@article{sharma2021consensus, author={Sharma, Akash and Minh Duc, Nguyen Tran and Luu Lam Thang, Tai and Nam, Nguyen Hai and Ng, Sze Jia and Abbas, Kirellos Said and Huy, Nguyen Tien and Marušić, Ana and Paul, Christine L. and Kwok, Janette and Karbwang, Juntra and de Waure, Chiara and Drummond, Frances J. and Kizawa, Yoshiyuki and Taal, Erik and Vermeulen, Joeri and Lee, Gillian H. M. and Gyedu, Adam and To, Kien Gia and Verra, Martin L. and Jacqz-Aigrain, Évelyne M. and Leclercq, Wouter K. G. and Salminen, Simo T. and Sherbourne, Cathy Donald and Mintzes, Barbara and Lozano, Sergi and Tran, Ulrich S. and Matsui, Mitsuaki and Karamouzian, Mohammad}, title={{A consensus-based Checklist for Reporting of Survey Studies (CROSS)}}, journal={Journal of General Internal Medicine}, year={2021}, volume={36}, number={10}, pages={3179--3187}, doi={10.1007/s11606-021-06737-1}}@article{vandenbroucke2007strengthening, author={Vandenbroucke, Jan P. and von Elm, Erik and Altman, Douglas G. and Gøtzsche, Peter C. and Mulrow, Cynthia D. and Pocock, Stuart J. and Poole, Charles and Schlesselman, James J. and Egger, Matthias and {STROBE Initiative}}, title={{Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e297}, doi={10.1371/journal.pmed.0040297}}@article{ward2023dealing, author={Ward, M. K. and Meade, Adam W.}, title={{Dealing with careless responding in survey data: Prevention, identification, and recommended best practices}}, journal={Annual Review of Psychology}, year={2023}, volume={74}, number={1}, pages={577--596}, doi={10.1146/annurev-psych-040422-045007}}