Generator diagramu przepływu respondentów
Etapy, wykluczenia, rysunek i gotowy opis
Wpisz etapy i powody wykluczeń. Generator policzy kolejne liczby, ostrzeże, gdy coś się nie sumuje, i narysuje diagram do pobrania jako SVG albo PNG. Ustawienia domyślne to przykład z ankiety nauczycieli. Wszystko dzieje się w Twojej przeglądarce: nic nie jest wysyłane ani zapisywane.
Generator wymaga włączonej obsługi JavaScriptu. Diagram dla ustawień domyślnych pokazujemy w przykładzie poniżej.
Podgląd
Opis do rozdziału o metodzie
Jak ustalić etapy, kiedy stosować reguły i co liczyć z eksportu, omawiamy we wpisie o diagramie przepływu respondentów. Ta strona służy do jednego: żeby z gotowych liczb szybko zrobić poprawny rysunek i sprawdzić, czy te liczby do siebie pasują.
Jak używać generatora
- Etapy. Każdy etap to jedno pole w głównej kolumnie: nazwa i liczba rekordów. Liczbę wpisujesz tylko na pierwszym etapie, np. wszystkie wejścia w link z pełnego eksportu. Przyciskami dodajesz etap pod wybranym i usuwasz etap zbędny. Diagram może mieć od 2 do 12 etapów.
- Wykluczenia. Między etapami wpisz powody i liczby. Każdy powód musi odpowiadać jednej regule z planu analizy. Jak ją sformułować, wyjaśnia hasło kryteria włączenia i wyłączenia. Przy jednym powodzie pole boczne zawiera tylko jego nazwę i liczbę. Gdy powodów jest kilka, generator dodaje sumę, a nazwa zbiorcza, np. „Niekompletne odpowiedzi”, staje się nagłówkiem pola. Przejście przyjmuje do 8 powodów.
- Dopisek. To krótki tekst w nawiasie obok liczby, np. podział na kanały: „e-mail: 227, media społecznościowe: 385”. Podaj go w pierwszym i ostatnim polu, jeśli rekrutacja szła kilkoma drogami.
- Liczba ręczna. Domyślnie liczba etapu wynika z wykluczeń. Zaznacz „Wpisz liczbę ręcznie”, jeśli chcesz podać wartość z arkusza. Generator porówna ją z wynikiem odejmowania, a następny etap policzy już od liczby, którą wpisano.
- Pobranie i opis. Sprawdź komunikat nad podglądem, wybierz styl i pobierz plik. Napis „Liczby się sumują” pojawia się tylko wtedy, gdy każdy etap zgadza się z wykluczeniami.
Jak generator liczy i co sprawdza
Cała logika to jedno równanie, stosowane kolejno na każdym przejściu:
Równanie działa tylko wtedy, gdy każdy rekord trafia do jednego pola bocznego, przy pierwszej regule, która go wykluczyła. Liczby w polach bocznych zależą więc od kolejności reguł. Tę sprawę, z przykładem 411 zamiast 413 osób, opisuje sekcja o kolejności reguł. Generator nie widzi Twoich danych i kolejności nie sprawdzi. Pilnuje tylko arytmetyki.
Komunikaty dzielą się na dwie grupy.
- Błędy zatrzymują rysunek: brak liczby na pierwszym etapie, wartość ujemna lub ułamkowa, powód bez liczby, więcej wykluczonych, niż było rekordów.
- Ostrzeżenia nie zatrzymują rysunku, ale trzeba je przeczytać: ręczna liczba niezgodna z wykluczeniami (generator podaje różnicę i jej kierunek), przejście bez żadnych wykluczeń, etap albo powód bez nazwy. Gdy liczby się nie sumują, gotowy opis zaczyna się od znacznika „SPRAWDŹ”, żeby taki tekst nie trafił do pracy przez przypadek.
Długie nazwy zawijają się same. Skrypt szacuje szerokość tekstu z tabeli szerokości liter kroju Arial, z zapasem na różnice między krojami. Słowo dłuższe niż pole dzieli łącznikiem. Tekst w pliku SVG zostaje tekstem, więc poprawisz go w programie graficznym.
Przykład: od 612 wejść do 413 analizowanych
Ustawienia domyślne pochodzą z symulowanej ankiety nauczycieli omawianej we wpisie o diagramie przepływu. Link miał 612 wejść, a do analizy trafiło 413 rekordów, czyli 67.5% wejść. Wykluczono łącznie 199 rekordów: 612 − 38 − 49 − 81 − 6 − 25 = 413. Rysunek 1 to plik wygenerowany na tej stronie bez żadnych poprawek.
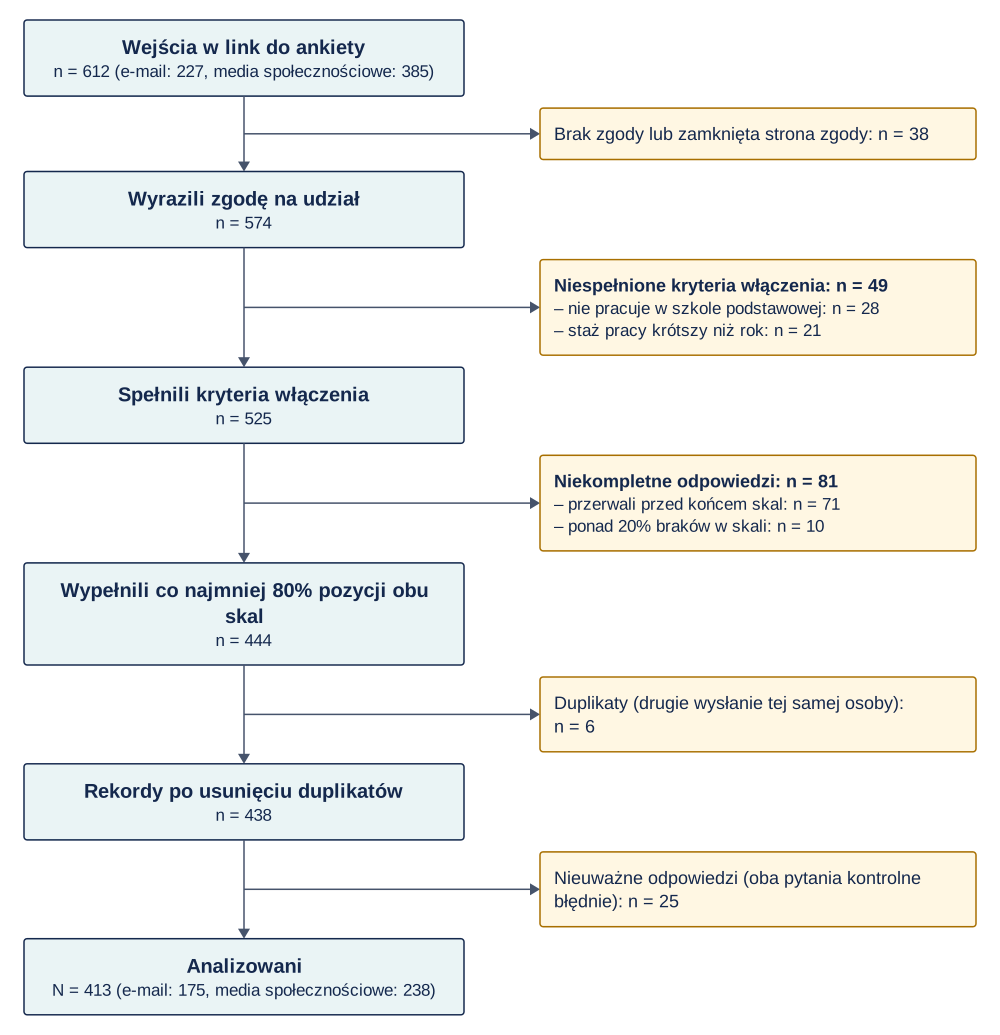
Pierwsze i ostatnie pole mają dopiski z kanałami. Czytelnik widzi od razu, że wśród wejść e-mail i media społecznościowe mają inne proporcje niż wśród analizowanych. Pola boczne z dwoma powodami mają nazwę zbiorczą i sumę. Ostatni etap oznaczamy wielką literą N, bo to liczebność całej analizowanej próby, a etapy pośrednie małą n.
Ta sama kontrola w bazowym R
Jeśli liczby powstają w skrypcie, sprawdź je tam, gdzie powstają. Funkcja porównuje liczbę na każdym etapie z liczbą wynikającą z wykluczeń, a na końcu pokazuje skutek literówki w jednym polu.
Tabela etapów, tabela wykluczeń i kolumna różnic
R
# Kontrola liczb w diagramie przepływu respondentów – bazowy R
# Liczby: przykład z ankiety nauczycieli (dane symulowane)
etapy <- data.frame(
  etap = c("Wejścia w link", "Zgoda", "Kryteria włączenia",
           "Kompletność", "Po duplikatach", "Analizowani"),
  n = c(612, 574, 525, 444, 438, 413)
)
wykluczenia <- data.frame(
  przejscie = c(1, 2, 2, 3, 3, 4, 5),      # numer przejścia: 1 = między etapem 1 i 2
  powod = c("brak zgody", "nie pracuje w szkole", "staż poniżej roku",
            "przerwali", "ponad 20% braków", "duplikaty", "nieuważni"),
  n = c(38, 28, 21, 71, 10, 6, 25)
)

sprawdz_przeplyw <- function(etapy, wykluczenia) {
  k <- nrow(etapy)
  suma <- tapply(wykluczenia$n, factor(wykluczenia$przejscie, levels = seq_len(k - 1)), sum)
  suma[is.na(suma)] <- 0
  z_wykluczen <- c(etapy$n[1], etapy$n[-k] - suma)
  data.frame(etap = etapy$etap, n = etapy$n, wykluczeni = c(NA, suma),
             z_wykluczen = z_wykluczen, roznica = etapy$n - z_wykluczen,
             proc_startu = round(100 * etapy$n / etapy$n[1], 1), row.names = NULL)
}

wynik <- sprawdz_przeplyw(etapy, wykluczenia)
print(wynik)
all(wynik$roznica == 0)                    # TRUE = liczby się sumują
sum(wykluczenia$n)                         # wszyscy wykluczeni

# Literówka w jednym polu: 530 zamiast 525 daje parę różnic +5 i −5
etapy_blad <- etapy
etapy_blad$n[3] <- 530
print(sprawdz_przeplyw(etapy_blad, wykluczenia)[, c("etap", "n", "z_wykluczen", "roznica")])

round(2000 / (16 / 2.54))                  # PNG 2000 px przy szerokości 16 cm: punkty na cal
Wynik w R
                etap   n wykluczeni z_wykluczen roznica proc_startu
1     Wejścia w link 612         NA         612       0       100.0
2              Zgoda 574         38         574       0        93.8
3 Kryteria włączenia 525         49         525       0        85.8
4        Kompletność 444         81         444       0        72.5
5     Po duplikatach 438          6         438       0        71.6
6        Analizowani 413         25         413       0        67.5
[1] TRUE
[1] 199
                etap   n z_wykluczen roznica
1     Wejścia w link 612         612       0
2              Zgoda 574         574       0
3 Kryteria włączenia 530         525       5
4        Kompletność 444         449      -5
5     Po duplikatach 438         438       0
6        Analizowani 413         413       0
[1] 318
Bibliografia oprogramowania
Wynik pochodzi z uruchomienia pokazanego kodu w R 4.5.3 (funkcje tapply(), factor() i data.frame() z pakietu base). Generator sprawdzono na 424 przypadkach testowych: liczby na etapach, różnice, sumy, komunikaty i treść opisu porównano z niezależną implementacją w Pythonie, bez różnic. Testy obejmują też mieszczenie się tekstu w polach i ucieczkę znaków w pliku SVG.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
Gdy liczby się nie sumują
Żeby sprawdzić gotowy zestaw liczb, zaznacz „Wpisz liczbę ręcznie” na wszystkich etapach i przepisz wartości z arkusza. Kierunek różnicy podpowiada przyczynę:
| Co widać | Co to zwykle znaczy | Co zrobić |
|---|---|---|
| Para różnic na sąsiednich etapach, np. +5 i −5 | Literówka w liczbie etapu środkowego | Popraw liczbę etapu (w przykładzie 530 na 525) |
| Jedna różnica dodatnia | Powody opisują za dużo rekordów, np. ten sam rekord policzono pod dwoma regułami | Licz reguły sekwencyjnie, a nie każdą osobno |
| Jedna różnica ujemna | Rekordy zniknęły bez powodu, np. usunięte ręcznie w arkuszu | Znajdź je w eksporcie i dopisz powód |
| Inna liczba analizowanych niż w tabeli próby | Diagram i tabela powstały z różnych wersji pliku | Licz jedno i drugie z tego samego skryptu |
Różnica nie jest czymś, co wypada „wyrównać”. Pole „Inne: 3” dopisane po to, żeby liczby się zgodziły, ukrywa problem przed czytelnikiem. Wróć do danych i ustal, które rekordy odpadły. Całą pracę pod tym kątem możesz przejrzeć według wpisu o kontroli spójności liczb przed oddaniem, a pojedyncze statystyki sprawdzić w kalkulatorze spójności wyników. Pomocne bywa też czyszczenie danych z ankiety online w postaci skryptu, a nie ręcznych zmian.
Wstawienie do pracy i opis
Format pliku. SVG jest grafiką wektorową, więc zachowa ostrość przy każdym powiększeniu. Word w Microsoft 365 wstawia go jak zwykły obraz. Do starszych edytorów i na slajdy użyj PNG: plik ma 2000 pikseli szerokości, co przy szerokości 16 cm daje 318 punktów na cal. Styl czarno-biały przyda się do wydruku. Ogólne zasady rysunków w pracy opisuje wpis o wykresach w pracy dyplomowej, a w artykule – tabele i rysunki do artykułu.
Opis. Przycisk „Kopiuj opis” przenosi tekst złożony z Twoich etykiet i liczb. Traktuj go jako szkic, bo generator nie zna Twoich reguł. Dopisz, jak zdefiniowano duplikaty i niekompletność i kiedy ustalono reguły. Jeśli nazwy etapów tworzą w zdaniu niezręczne zwroty, popraw je ręcznie. Numer rysunku zmień według swojej numeracji. Wzór pełniejszego opisu znajdziesz w sekcji opis w metodach i wynikach. Dla przykładu z tej strony podpis może wyglądać tak:
STROBE w punkcie 13 każe podać liczbę osób na każdym etapie oraz powody nieuczestniczenia i zaleca rozważenie diagramu (Vandenbroucke i in., 2007). Lista CHERRIES dla ankiet internetowych pyta m.in. o ankiety przerwane i o usuwanie duplikatów (Eysenbach, 2004), a lista CROSS, 40 pozycji w 19 sekcjach, dotyczy badań ankietowych w ogóle (Sharma i in., 2021). Którą wybrać, wyjaśnia wpis STROBE, CONSORT i TRIPOD. Odsetek odpowiedzi to inna liczba niż odsetek zachowanych rekordów. Licz go tylko wtedy, gdy znasz liczbę zaproszonych, zgodnie z hasłem wskaźnik odpowiedzi.
Czego generator nie robi
- Układ jest jednokolumnowy. Nie ma rozgałęzień na ramiona badania, dlatego nie zastąpi diagramu CONSORT 2025, który jest częścią wytycznej dla badań z randomizacją (Hopewell i in., 2025). Nie zastąpi też szablonów diagramu z PRISMA 2020 dla przeglądów systematycznych (Page i in., 2021). Eksperyment ankietowy opisuje wpis o wykluczaniu respondentów w eksperymencie.
- Nie sprawdza, czy reguły są rozsądne. Poprawna arytmetyka nie oznacza dobrych decyzji. Reguły ustal przed obejrzeniem wyników i zapisz w planie analizy. Pytania kontrolne i próg czasu omawia wpis o nieuważnych odpowiedziach, a odrzucanie niepełnych rekordów – wpis o brakach danych w ankiecie.
- Nie liczy niczego z surowych danych. Jeśli chcesz, żeby liczby powstawały automatycznie z eksportu, użyj kodu R z wpisu o diagramie przepływu.
- Nie zapisuje pracy. Po odświeżeniu strony wpisy znikają, dlatego liczby trzymaj w skrypcie albo arkuszu.
Jeśli liczby się nie zgadzają i nie wiesz dlaczego, możemy to przejrzeć razem. Zobacz pomoc w analizie dla studentów.
Najczęstsze pytania
Jak zrobić diagram przepływu respondentów bez R i programu graficznego?
Wpisz w generatorze etapy, liczbę rekordów na pierwszym etapie i powody wykluczeń z liczbami. Kolejne liczby policzą się same, a rysunek pobierzesz jako SVG albo PNG. Liczby weź z pełnego eksportu ankiety, a nie z pamięci.
Co oznacza różnica +5 i −5 na sąsiednich etapach diagramu przepływu?
Najczęściej literówkę w liczbie etapu środkowego. Jeśli wpisano 530 zamiast 525, ten etap ma 5 za dużo, a następny 5 za mało względem wykluczeń. Pojedyncza różnica, bez pary, wskazuje raczej na brak powodu albo podwójne policzenie rekordu.
Który format diagramu przepływu wstawić do pracy w Wordzie: SVG czy PNG?
SVG, jeśli Twoja wersja Worda go obsługuje, bo grafika wektorowa pozostaje ostra przy każdym powiększeniu. W innych przypadkach użyj PNG. Plik z generatora ma 2000 pikseli szerokości, czyli 318 punktów na cal przy szerokości 16 cm.
Czy tym generatorem zrobię diagram CONSORT albo PRISMA?
Nie. Generator ma jedną kolumnę etapów i pola boczne, więc nadaje się do ankiet i badań obserwacyjnych bez podziału na ramiona. Badanie z randomizacją wymaga rozgałęzienia po przydziale, a przegląd systematyczny ma własne szablony PRISMA 2020.
Czy liczby i nazwy wpisane do generatora są gdzieś wysyłane?
Nie. Skrypt działa w przeglądarce, nie wysyła ani nie zapisuje danych. Oznacza to też, że po odświeżeniu strony wpisy znikają, więc liczby przechowuj w skrypcie lub arkuszu.
Powiązane hasła
Przeczytaj też
Diagram przepływu respondentów
Od 612 wejść w link do 413 analizowanych: etapy, kryteria wykluczeń i ich kolejność, odsetek odpowiedzi i diagram w R.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →PoradnikKontrola spójności liczb przed oddaniem pracy
Osiem kontroli: N i sumy w tabelach, procenty, p a statystyka testu, df, przedziały ufności, GRIM i te same liczby w całej pracy – z kodem w R.
Czytaj →Liczby w diagramie się nie zgadzają albo nie wiesz, jak je opisać?
Ustalimy z Tobą reguły wykluczeń i ich kolejność, policzymy przepływ w R lub SPSS i wyjaśnimy liczby tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Eysenbach, G. (2004). Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES). Journal of Medical Internet Research, 6(3), Article e34. https://doi.org/10.2196/jmir.6.3.e34 ● Otwarty dostęp
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 statement: Updated guideline for reporting randomised trials. BMJ, 389, Article e081123. https://doi.org/10.1136/bmj-2024-081123 ● Otwarty dostęp
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., . . . Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, Article n71. https://doi.org/10.1136/bmj.n71 ● Otwarty dostęp
- Sharma, A., Minh Duc, N. T., Luu Lam Thang, T., Nam, N. H., Ng, S. J., Abbas, K. S., Huy, N. T., Marušić, A., Paul, C. L., Kwok, J., Karbwang, J., de Waure, C., Drummond, F. J., Kizawa, Y., Taal, E., Vermeulen, J., Lee, G. H. M., Gyedu, A., To, K. G., . . . Karamouzian, M. (2021). A consensus-based Checklist for Reporting of Survey Studies (CROSS). Journal of General Internal Medicine, 36(10), 3179–3187. https://doi.org/10.1007/s11606-021-06737-1 ● Otwarty dostęp
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Initiative. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), Article e297. https://doi.org/10.1371/journal.pmed.0040297 ● Otwarty dostęp
Cytowania BibTeX
@article{eysenbach2004improving, author={Eysenbach, Gunther}, title={{Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES)}}, journal={Journal of Medical Internet Research}, year={2004}, volume={6}, number={3}, eid={e34}, doi={10.2196/jmir.6.3.e34}}@article{hopewell2025consortstatement, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 statement: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081123}, doi={10.1136/bmj-2024-081123}}@article{page2021prisma, author={Page, Matthew J and McKenzie, Joanne E and Bossuyt, Patrick M and Boutron, Isabelle and Hoffmann, Tammy C and Mulrow, Cynthia D and Shamseer, Larissa and Tetzlaff, Jennifer M and Akl, Elie A and Brennan, Sue E and Chou, Roger and Glanville, Julie and Grimshaw, Jeremy M and Hróbjartsson, Asbjørn and Lalu, Manoj M and Li, Tianjing and Loder, Elizabeth W and Mayo-Wilson, Evan and McDonald, Steve and McGuinness, Luke A and Stewart, Lesley A and Thomas, James and Tricco, Andrea C and Welch, Vivian A and Whiting, Penny and Moher, David}, title={{The PRISMA 2020 statement: An updated guideline for reporting systematic reviews}}, journal={BMJ}, year={2021}, volume={372}, eid={n71}, doi={10.1136/bmj.n71}}@article{sharma2021consensus, author={Sharma, Akash and Minh Duc, Nguyen Tran and Luu Lam Thang, Tai and Nam, Nguyen Hai and Ng, Sze Jia and Abbas, Kirellos Said and Huy, Nguyen Tien and Marušić, Ana and Paul, Christine L. and Kwok, Janette and Karbwang, Juntra and de Waure, Chiara and Drummond, Frances J. and Kizawa, Yoshiyuki and Taal, Erik and Vermeulen, Joeri and Lee, Gillian H. M. and Gyedu, Adam and To, Kien Gia and Verra, Martin L. and Jacqz-Aigrain, Évelyne M. and Leclercq, Wouter K. G. and Salminen, Simo T. and Sherbourne, Cathy Donald and Mintzes, Barbara and Lozano, Sergi and Tran, Ulrich S. and Matsui, Mitsuaki and Karamouzian, Mohammad}, title={{A consensus-based Checklist for Reporting of Survey Studies (CROSS)}}, journal={Journal of General Internal Medicine}, year={2021}, volume={36}, number={10}, pages={3179--3187}, doi={10.1007/s11606-021-06737-1}}@article{vandenbroucke2007strengthening, author={Vandenbroucke, Jan P. and von Elm, Erik and Altman, Douglas G. and Gøtzsche, Peter C. and Mulrow, Cynthia D. and Pocock, Stuart J. and Poole, Charles and Schlesselman, James J. and Egger, Matthias and {STROBE Initiative}}, title={{Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e297}, doi={10.1371/journal.pmed.0040297}}